 Newshot
Main
实体器官癌症代表了一系列复杂的病理变化,其中密切相关的 TME 在疾病进展和治疗反应中起着关键作用4,5。在 TME 中,基质细胞和免疫细胞均已成为肿瘤生长、侵袭和转移的关键调节因子1,6,7,8,9,10。然而,不同研究(通常针对单一器官)显示,这些细胞在促进与抑制肿瘤生长方面发挥的作用相互矛盾11,12,13,14。TME 的异质性,无论是在单个肿瘤内部还是跨肿瘤类型之间,都对理解肿瘤相关基质细胞和免疫细胞的功能多样性构成了重大挑战3,15,16。
既往研究基于基因表达谱、空间分布和功能特征,已在 TME 中鉴定出不同的细胞亚群17,18,19,20,21。然而,这些发现主要源于孤立的单细胞 RNA 测序(scRNA-seq)研究22,23,24,随后开展的泛癌工作在规模和范围上仍然有限3,25,26,27,28。据我们所知,迄今为止最大的癌症相关成纤维细胞图谱整合了来自 10 种肿瘤类型的 1,116 个样本的数据29;最大的肿瘤内皮细胞图谱包含来自 19 种肿瘤类型的 575 个样本30;尚未生成特定的肿瘤壁细胞或神经图谱。泛癌免疫细胞图谱规模更大28,尤其是那些聚焦于单个免疫细胞谱系的图谱31,32,33;然而,这些图谱通常未考察更广泛 TME 内的免疫细胞相互作用。
在此,我们整合了来自 42 种癌症类型、258 个数据集的 3,381 个人类和小鼠样本的单细胞转录组数据,构建了一个权威的 TME 转录图谱。通过绘制这一庞大的细胞景观,我们解析了实体瘤的基质和免疫生态系统。此外,通过将富集亚群与不良临床结局相关联,我们确定了未来 TME 靶向癌症治疗的机遇。关键的计算预测随后通过体外和体内实验得到验证。最后,我们将这项工作整合为一个交互式网络图谱(tmeatlas.stanford.edu)和 R 软件包(scTME),它们将成为研究 TME 的团队的实用资源。
Curation
为了系统分析单细胞转录组数据,我们评估了 2014 年 1 月至 2025 年 7 月期间公开发表的所有 scRNA-seq 癌症研究。在单细胞转录组学的基础公共数据库——基因表达综合数据库(GEO)和 ArrayExpress——中,分别对人类和小鼠数据集独立评估了单独的查询。我们筛选了总共 3,975 个已发表数据集(图 1a)。仅针对血液或中枢神经系统癌症的研究被排除在我们的分析之外,未能满足特定架构要求的研究同样被排除(方法;见图 1a,b)。我们的全面筛选鉴定出 190 个人类数据集和 68 个小鼠数据集(补充表 1),合计包含超过 1,540 万个细胞。这些数据集共同构成了最终分析队列,涵盖 42 种独特癌症类型的 3,381 个独立 scRNA-seq 样本(图 1b 以及补充表 2 和 3)。
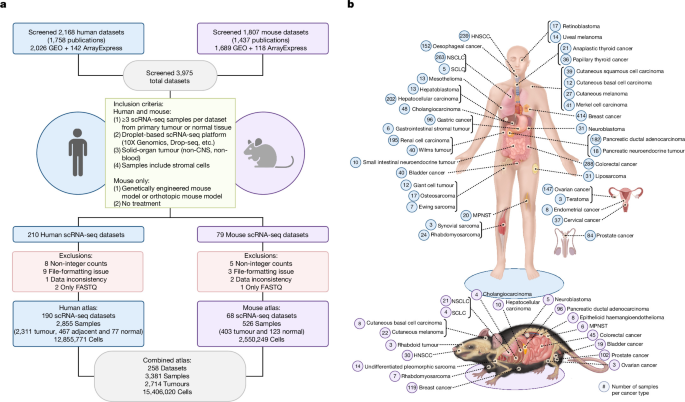
a,详细说明 scRNA-seq 数据集整理流程的系统工作流。初始筛选检查了 3,975 个数据集,过滤后保留 190 个人类和 68 个小鼠 scRNA-seq 数据集。合并的 258 个数据集包含 3,381 个样本和超过 1500 万个细胞。示意图由 BioRender 创建;Wang, H. https://biorender.com/w8x4pii (2026)。CNS,中枢神经系统。b,本研究中纳入的人类(上)和小鼠(下)所有癌症类型的示意图。HNSCC,头颈部鳞状细胞癌;MPNST,恶性外周神经鞘瘤;NSCLC,非小细胞肺癌;SCLC,小细胞肺癌。示意图由 BioRender 创建;Wang, H. https://biorender.com/p0byno1 (2026)。
人类数据集整合与注释
为处理来自 2,855 个样本和 190 个数据集的超过 1280 万个人类细胞(扩展数据图 1a,b 和补充图 1),这一规模比许多近期开创性研究3,25,26,27,28,31,32,33,34高出近一个数量级,我们使用了基于 sketch 的采样和内存读取优化(扩展数据图 1c,d)。我们应用了三种独立的数据整合方法以减少批次效应:Harmony、scVI 和 FastMNN(扩展数据图 1e 和 2a)。然后,我们将每个整合结果投影到完整数据集上(扩展数据图 2b,c)。使用四种方法——经典标记基因、估计的拷贝数变异(inferCNV)、SingleR 和 scATOMIC(扩展数据图 3 和补充图 2)——进行的监督注释,描绘了几乎所有人类癌症中七种主要细胞类型的存在(图 2a–c、扩展数据图 1e,f 和补充表 4)。这些包括主要的基质(成纤维细胞、内皮细胞、壁细胞和神经)和免疫(髓系和淋系)谱系,以及上皮细胞;上皮细胞被排除在后续表征之外,以聚焦于两个核心 TME 区室。比较三种整合方法(补充表 5)后,Harmony 表现出最稳健的整合,并被选用于所有后续评估。三种整合方法还经常对单个细胞产生不一致的细胞类型分配(扩展数据图 2d–f),凸显了依赖任何单一方法所固有的随机性和误分类风险35,36。为缓解这一点,我们暂时汇集了被三种算法中任意一种分配到特定 TME 谱系的所有细胞(扩展数据图 1g)。这些重叠池中被错误分配的细胞随后通过递归下游过滤去除(扩展数据图 1h 和补充图 3a–e),从而为六种主要 TME 细胞类型生成最终的高保真图谱(图 2d–i 和扩展数据图 1i,j)。
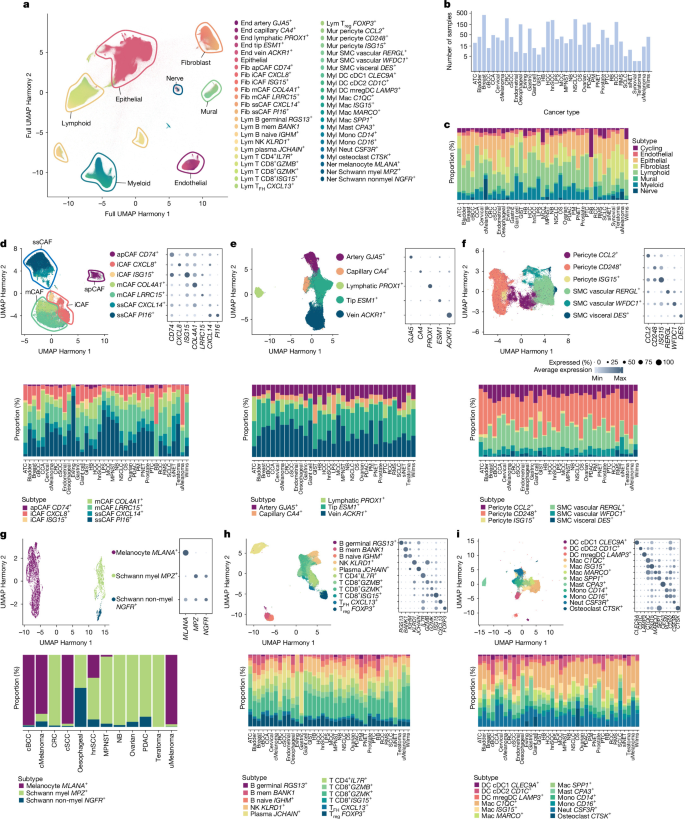
a,来自 190 项人类研究的 12,855,771 个细胞使用 Harmony 整合后的 UMAP 嵌入,并带有通过多种注释方法得到的共识七种细胞类型注释(在面板内以轮廓标出并标注)(Extended Data 图 1 和 2 以及 Supplementary 图 1–3)。单个细胞根据 d–i 图中的下游最终细胞注释进行标注。cDC,经典树突状细胞;DC,树突状细胞;End,内皮;Fib,成纤维细胞;Lym,淋巴样;Mac,巨噬细胞;mem,记忆;Mono,单核细胞;mregDC,富含免疫调节分子的成熟树突状细胞;Mur,壁;myel,髓鞘形成;Myl,髓系;Neut,中性粒细胞;NK,自然杀伤;SMC,平滑肌细胞;TFH,滤泡辅助性 T;Treg,调节性 T。b,每种癌症纳入的人类样本总数。c,仅选择未分选样本后,每种癌症的细胞类型分布。癌症名称缩写列于 Supplementary Table 2。d,CAFs 的 UMAP 嵌入,从总共七个转录上不同的亚群中手动聚类为四个母群体(在 UMAP 中以轮廓标出并标注),后者分别着色(左上)。显示左图所示七个转录上不同的 CAF 亚群特征标志物相对基因表达的点图(右上)。还显示了不同癌症类型的肿瘤样本中 CAF 亚群的分布(下;n = 328,877 个细胞)。e–i,内皮(e;n = 234,948 个细胞)、壁(f;n = 162,178 个细胞)、神经(g;n = 7,655 个细胞)、淋巴样(h;n = 1,580,785 个细胞)和髓系(i;n = 805,111 个细胞)细胞的 UMAP(左上)、点图(右上)以及在不同癌症类型肿瘤样本中的分布(下)。每种细胞类型鉴定出 3 到 12 个亚群,并且在每种细胞类型的点图中每个亚群显示一个群体定义基因(完整列表见 Supplementary Tables 6 和 7)。
癌症相关成纤维细胞
我们接下来表征了癌症相关成纤维细胞(CAFs),即 TME37 中占主导的基质群体。按照我们的递归分离策略(Extended Data 图 1h),我们 delineated 四个转录上不同的 CAF 元簇(图 2d),其表达经典标志物(PDGFRA、LUM 和 DCN),且缺乏非成纤维细胞标志物(Extended Data 图 4a 和 Supplementary 图 4)。具体而言,我们鉴定出 (1) 抗原呈递 CAFs(apCAFs;II 类 HLA+),(2) 免疫调节/炎症 CAFs(iCAFs;细胞因子+),(3) 肌成纤维细胞/机械响应 CAFs(mCAFs;细胞外基质(ECM)+、机械转导+),以及 (4) 稳态 CAFs(ssCAFs;祖细胞样标志物+;图 2d),这与我们先前工作38以及其他研究25,39,40,41的观察大致一致。高分辨率亚聚类(图 2d、Supplementary Table 6 和 7 以及 Supplementary 图 4)进一步将其分层为七个亚群:两个 iCAF(CXCL8+ 或 ISG15+)、两个 mCAF(LRRC15+ 或 COL4A1+)、两个 ssCAF(PI16+ 或 CXCL14+)和一个 apCAF。所有七个亚群在几乎所有评估的肿瘤类型和组织中均保守(图 2d,下)。值得注意的是,apCAFs 几乎普遍存在,而先前的研究仅在罕见的肿瘤亚群中发现它们6。此外,我们鉴定的人 apCAFs 不表达 MSLN 等间皮标志物,而这些标志物是小鼠 apCAFs42 的特征(Extended Data 图 4a)。
比较肿瘤组织与非恶性组织之间的相对丰度(图 3a),两个 mCAF 群体均在肿瘤中显著富集(LRRC15+ 为 3.5 倍;COL4A1+ 为 2.7 倍;Supplementary Table 8),反映了癌症诱导的促结缔组织增生37,43。类似地,iCAF 和 apCAF 在肿瘤样本中富集(ISG15+ iCAF 为 6.3 倍,CXCL8+ iCAF 为 1.3 倍,apCAF 为 2.0 倍),这与它们在诱导免疫逃逸42或分泌炎性细胞因子41中的作用一致。分析不同肿瘤分期和患者治疗反应中的丰度,我们发现 ISG15+ iCAF、LRRC15+ mCAF 和 COL4A1+ mCAF 在晚期(III–IV)肿瘤中较早期(I–II)肿瘤显著富集(分别为 1.9 倍、1.3 倍和 1.2 倍;图 3b)。治疗反应性与任何 CAF 亚群均无显著相关性(图 3c)。总体而言,ISG15+ iCAF 是最一致富集的成纤维细胞亚群,既定义恶性状态,也定义晚期疾病(图 3a–c,蓝框)。
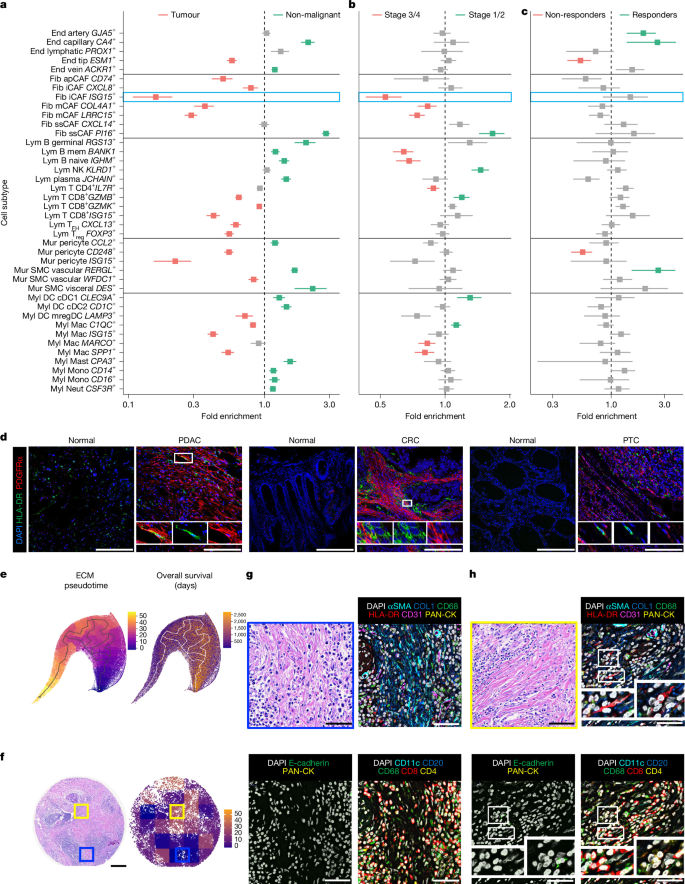
a–c,细胞亚群比例相对于其母群体的森林图,分别比较肿瘤样本与非恶性样本(a)、晚期(3–4)与早期(1–2)癌症(b),以及治疗无应答者与应答者(c)。图 a 中的蓝框突出显示 ISG15+ iCAF。非恶性样本包括切除自肿瘤邻近的组织,并与来自无肿瘤个体或动物的组织合并。点表示倍数富集,即每样本比例加权平均值的比值;重复单位是单个 scRNA-seq 样本,按其细胞数的平方根加权。误差棒显示该比值的传播标准误(见 Methods)。显著性由双侧加权 Welch t 检验确定,并在每个亲本谱系内进行 Benjamini–Hochberg 校正;颜色表示校正后 P < 0.05。所有样本均为生物学独立样本;每个亲本谱系的样本数 n = 859–1,777(a)、311–658(b)和 48–108(c)。精确 n、组均值、标准误、带 95% 置信区间的倍数富集、检验统计量和精确 P 值见 Supplementary Table 8。d,PDAC、CRC 和 PTC 肿瘤及匹配的肿瘤邻近组织中 apCAF 的免疫荧光(PDGFRα+HLA-DR+ 共染色)。白框标记共染色。n = 7 个 PDAC、3 个 CRC 和 3 个 PTC 生物学独立标本;每个标本染色并成像一次,每种肿瘤类型内模式可比。比例尺,100 µm。e,来自已发表 PDAC 数据集62的伪时间流形,黄色表示高伪时间的 ECM 区域,蓝色表示低伪时间(左)。UMAP 按总生存期着色;较高伪时间伴随较短生存期(右)。f,PDAC 组织微阵列,苏木精和伊红(H&E)染色(左)及 ECM 伪时间(右);蓝色和黄色框标记图 g,h 中显示的低伪时间和高伪时间区域。比例尺,200 µm。g,h,低基质伪时间且患者生存良好(g)以及高基质伪时间且患者生存不良(h)区域的组织学和 CODEX。H&E(左上);其余面板为指定标志物的 CODEX。白框标记推测的 apCAF:位于 COL1A1/αSMA 高表达区域、无肿瘤或其他免疫标志物的 HLA-DR+ 纺锤样细胞。CODEX 在 n = 3 个生物学独立 PDAC 标本上进行,每个标本在单次多重运行中分析一次。比例尺,50 µm。
聚焦于 iCAF 区室,我们的图谱揭示了两种不同且保守的转录状态:ISG15+ iCAFs 表现出典型的干扰素-γ(IFNγ)刺激(例如 CXCL10)44,而 CXCL8+ iCAFs 表达促炎细胞因子(例如 CXCL1)41。关键在于,与先前报道的 CXCL12+ iCAFs39 相比,这些 iCAF 亚群提供了额外的精细分辨率。近期共识框架已将 CXCL12 确定为稳态成纤维细胞标志基因之一,而非恶性肿瘤诱导的炎症性 CAF 状态所特有25。与此一致,我们的 CXCL14+ ssCAFs 高表达 CXCL12,同时维持稳态特征。丰度分析揭示了不同的 ssCAF 动态:常规 PI16+ ssCAFs(也强烈表达 CXCL12)在非恶性组织中高度富集(2.8 倍),可能代表一个祖细胞池,而 CXCL14+ 池在良性和恶性组织之间保持比例稳定(1.0 倍),典型地表现为嵌入实质的成纤维细胞。因此,我们提出传统上的“CXCL12+ iCAFs”更准确地归类为组织驻留的 CXCL14+ ssCAFs。
为阐明驱动这些不同状态的调控网络,我们使用 SCENIC 检查了转录因子活性。apCAF 群体表现出 RUNX3 和 IKZF1 的推断活性升高,二者是 MHC II 类表达的调控因子45,提示了直接与 T 细胞相互作用以及免疫治疗耐药的机制(扩展数据图 5a)。ISG15+ iCAFs 显示 ETV7 和 IRF2 的预测激活,暗示抑制性细胞因子信号在肿瘤进展中的作用46(扩展数据图 5b)。两个 mCAF 群体均富集 CREB3L1 和 NKX3-2,它们与 ECM 过表达和僵硬相关(扩展数据图 5c)。相反,ssCAF 群体表现出更高的 CEBPA 和 FOXO3 预测活性,二者分别调控谱系和氧化还原稳态,这与归因于该群体的稳态特性一致26(扩展数据图 5d)。总体而言,这些调控谱与每个 CAF 亚群被假定的功能角色大致一致。
为评估是否可通过代谢程序的差异区分特定群体,我们应用 scMetabolism 分析 scRNA-seq 数据集。值得注意的是,我们观察到 LRRC15+ mCAFs 富集与氧化磷酸化升高相关的基因,这与 ISG15+ iCAFs 的传统糖酵解程序形成对比(扩展数据图 5e、f 和补充图 5a–c)。这些谱与每种细胞类型不同的能量需求一致:iCAFs 表达与快速糖酵解 ATP 生成相关的基因,从而允许促炎细胞因子过量产生,而 mCAFs 被预测利用更高效的氧化磷酸化,使其能够维持强烈的 ECM 产生和重塑,驱动对肿瘤形成的促结缔组织增生反应47。ssCAFs 的代谢通路基因表达总体较低,强化了其相对静止的状态。
为确定这些不同的功能和代谢状态最终是否影响患者生存,我们使用 CIBERSORTx 反卷积将来自 The Cancer Genome Atlas (TCGA) 的 bulk RNA-seq 与临床结局数据配对(补充表 9 和补充图 6a,b)。在大多数癌症类型中,估计肿瘤中 apCAFs、iCAFs 或 mCAFs 丰度较高的患者总生存期更差,这与先前的观察一致48。相反,我们观察到 CXCL14+ ssCAF 比例与患者生存之间呈正相关(但不具有统计学显著性;1.3 倍,P = 0.27)。综合来看,这些结果提示,成纤维细胞分化和谱系进展可能与实体器官肿瘤的更差结局相关,反映了 apCAFs、iCAFs 和 mCAFs 的促肿瘤作用。
内皮细胞、壁细胞和神经细胞
Beyond fibroblasts,我们还检查了肿瘤内皮细胞、壁细胞和神经细胞,它们驱动血管生成、细胞因子信号传导和转移扩散1,7,8,49。对内皮细胞进行计算机模拟分离(Extended Data Fig. 1a–j)识别出五个泛癌亚群(Fig. 2e):GJA5+ 动脉、CA4+ 毛细血管、PROX1+ 淋巴管、ESM1+ 尖端和 ACKR1+ 静脉。所有这些亚群均表达经典标志物(PECAM1、VWF 和 CDH5),并缺乏非内皮特征(Extended Data Fig. 4b、Supplementary Table 6 和 Supplementary Fig. 7)。值得注意的是,血管生成性 ESM1+ 尖端细胞50 是唯一在肿瘤中相对非恶性组织显著富集的内皮亚群(1.7 倍;Fig. 3a 和 Supplementary Table 8),反映了肿瘤新生血管功能失调51。这些尖端细胞共表达 FLT1(VEGFR1)和 KDR(VEGFR2),在治疗无应答肿瘤中显著升高(1.9 倍;Fig. 3c)。此外,它们与代谢活性升高(Extended Data Fig. 5g 和 Supplementary Fig. 5d)以及大多数 TCGA 队列中较差的总生存期相关(Supplementary Fig. 6b)。这些数据强化了尖端细胞的促肿瘤作用7,52,53,它们可能通过快速启动边缘血管生成持续支持生长,从而凸显其作为多药治疗候选靶点的价值。
对泛癌壁细胞进行亚聚类分析,划分出六个不同亚群(Fig. 2f):CCL2+、CD248+ 和 ISG15+ 周细胞;RERGL+ 和 WFDC1+ 血管平滑肌细胞;以及 DES+ 内脏平滑肌细胞。所有这些亚群均表达经典标志物(RGS5、PDGFRB 和 CSPG4),并缺乏非壁细胞特征(Supplementary Table 6 和 Supplementary Fig. 8)。ISG15+ 和 CD248+ 周细胞以及 WFDC1+ 血管平滑肌细胞在肿瘤中相对非恶性组织显著富集(分别为 4.5 倍、1.8 倍和 1.2 倍;Fig. 3a 和 Supplementary Table 8),其中 ISG15+ 周细胞还表现出总体代谢活性升高(Extended Data Fig. 5h)。临床上,CD248+ 周细胞与治疗应答不佳相关(1.8 倍;Fig. 3c)。机制上,两个在肿瘤中富集的周细胞群体均表达 ECM 基因(COL1A1、COL3A1 和 COL4A1),支持其在肿瘤促结缔组织增生中的作用(Supplementary Fig. 5e,f)。值得注意的是,编码机械转导通道的 PIEZO2 在一小部分 CD248+ 周细胞中检出,而在其他壁细胞群体中未检出(Supplementary Fig. 8)。检出稀疏且表达水平低,表明这是选择性而非稳健的群体特异性表达。鉴于 PIEZO2 在细胞机械感觉中的已知作用54,我们推测,这部分促纤维化周细胞可能被硬化的 TME 激活,从而进一步上调 ECM 产生;这一可能性值得进一步研究。
最后,我们分析了肿瘤相关神经细胞,并过滤掉神经嵴癌,以避免与神经源性肿瘤发生转录组重叠49。我们的分析揭示了三个不同亚群及其经典标志物:MLANA+ 黑色素细胞、MPZ+ 髓鞘化施万细胞和 NGFR+ 非髓鞘化施万细胞(Fig. 2g、Supplementary Table 6 和 Supplementary Fig. 9)。亚群比例在不同肿瘤类型间差异显著(Fig. 2g,底部)。由于这种异质性可能既反映组织特异性神经结构,也反映标准活检中神经细胞总体稀少,这些群体被排除在后续下游分析之外。
免疫细胞
免疫细胞包含超过240万个细胞,构成了我们图谱中最大的TME区室。计算机模拟分离大致将这些细胞分为淋巴样和髓样谱系。首先聚焦淋巴样细胞——抗肿瘤免疫55的主要介导者——我们鉴定出11个亚群:CD4+(3个)和CD8+(3个)T细胞、自然杀伤细胞(1个)、B细胞(3个)和浆细胞(1个;图2h、补充表6和补充图10)。几乎所有T细胞群体在肿瘤中均显著富集(图3a)。这主要由CD8+ISG15+ IFN启动的T细胞(2.4倍)和CD8+GZMB+肿瘤反应性耗竭T(TEX)细胞(1.5倍)驱动。值得注意的是,该GZMB+群体在早期疾病中也显著富集(图3b),反映出局部抗肿瘤免疫的初始浪潮正经历快速、慢性抗原驱动的功能障碍56。此外,FOXP3+调节性T细胞(1.8倍)和CXCL13+滤泡辅助性T细胞(1.6倍)均在肿瘤中富集。相比之下,B细胞和浆细胞群体在肿瘤内相对耗竭,但在非恶性组织中富集,可能反映瘤周积聚及从肿瘤核心的免疫排斥57。
检查肿瘤髓样细胞时,我们鉴定出树突状细胞(三个群体)、单核细胞(两个群体)、巨噬细胞(四个群体)、肥大细胞、中性粒细胞和破骨细胞(图2i、补充表6和补充图11)。除组织特异性的破骨细胞外,大多数细胞跨越所有肿瘤类型(图2i,底部)。三种巨噬细胞亚型和LAMP3+成熟免疫调节性树突状细胞在肿瘤中显著富集(图3a),其中SPP1+和MARCO+亚群在晚期疾病中进一步富集(图3b)。SPP1+巨噬细胞(GPNMB+和APOC1+)是已知的促结缔组织增生和不良临床结局驱动因素32,而晚期MARCO+富集提示其在免疫抑制和吞噬受阻中具有特殊作用。相反,C1QC+巨噬细胞维持稳态、富含补体的特征(C1QA–C和FOLR2),与T细胞浸润和非耗竭TME相关58。LAMP3+成熟免疫调节性树突状细胞(IDO1+和CCR7+)代表关键调控检查点,限制细胞毒性T细胞活性以促进晚期免疫逃逸59。最后,巨噬细胞和T细胞共有的ISG15+“IFN启动”簇提示,慢性炎症的共通轴通过持续I型IFN信号驱动终末耗竭31,32。
为评估与更广泛转录共识模型的一致性,我们使用scTME软件包60通过成对表达映射,对四个泛癌参考图谱进行了定量细胞水平比较(扩展数据图6a–d)。我们的大多数亚群与数据集中的可比细胞类型表现出强双向一致性(例如,PI16+ ssCAFs、LRRC15+ mCAFs、ESM1+尖端细胞、C1QC+/SPP1+巨噬细胞和FOXP3+调节性T细胞)。这些比较还区分了我们新表征并精细划分的几个亚群。IFN启动(ISG15+)轴稳健地映射到跨谱系的类似IFN激活状态(扩展数据图6b)。此外,我们新鉴定的ISG15+周细胞映射到亲本周细胞(扩展数据图6a),但因缺乏肌成纤维细胞重叠而与更广泛TME图谱中的CD248+周细胞不同,强化了其独特状态(扩展数据图6c,d)。进一步,CXCL14+成纤维细胞主要映射到非炎性群体——不同于CXCL8+和ISG15+ iCAF亚群——支持其与经典iCAF的分离。总体而言,尽管我们的TME图谱与既有数据集广泛一致,我们的成纤维细胞和血管壁细胞亚群反映了独特精细、数据驱动的划分,并具有功能相关性。
apCAF 区室的体内映射
我们的荟萃分析在几乎所有评估的肿瘤类型中均鉴定出 apCAFs(图2d,底部),远超已在体内验证其存在的有限癌种数量6。因此,我们进行免疫组织化学以确认其在此前未表征的肿瘤类型中的存在。对膜性成纤维细胞标志物 PDGFRα 和抗原呈递标志物 HLA-DR 的共染色证实了 apCAF 存在于人胰腺导管腺癌(PDAC)对照61中,也存在于此前未验证的结直肠癌(CRC)和甲状腺乳头状癌(PTC)组织中,正如我们的图谱所预测(图3d)。为排除可能的免疫细胞误分类,我们分析了来自人 PDAC62 的多
a,CellChat对IFNγ信号通路网络的评估。热图详细展示了各个细胞群体在整体IFNγ信号网络中作为发送者、接收者、中介者和影响者的相对重要性。深绿色到黑色区域表示强信号贡献,而浅绿色到白色区域表示较弱信号。蓝色箭头突出显示感兴趣的相互作用。b,NicheNet热图显示T CD8+GZMB+向ISG15+ iCAF信号的调控潜力,y轴为优先排序的发送者配体,x轴为其对预测靶基因的调控潜力。c,示意图说明d–h面板中体外实验的策略。Tx,治疗。示意图在BioRender中创建;Wang, H. https://biorender.com/q41gtvr (2026)。d,主成分(PC)分析图显示九个bulk RNA-seq样本之间的粗略分组(三种条件;每种条件n = 3个重复培养物,均来自同一原代PDAC CAF分离物,并独立处理并测序)。e,f,火山图显示IFNγ处理(e)或LPS处理(f)细胞相对于未处理对照细胞的显著差异表达基因。每种条件n = 3个重复培养物,均来自同一原代PDAC CAF分离物,并独立处理并测序。差异表达使用DESeq2 (v1.38.4)通过双侧Wald检验评估,P值使用Benjamini–Hochberg方法对所有26,363个测试基因进行多重比较校正;log2倍数变化(log2FC)使用lfcShrink收缩。所有测试基因的确切校正P值、log2FC和标准误见补充表10。总n = 17,890个变量。g,h,条形图显示来自图谱的ISG15+ iCAF(g)和CXCL8+ iCAF(h)群体基因特征在不同细胞培养条件下的表达强度。特征源自与所有CAF相比,ISG15+ iCAF(g)或CXCL8+ iCAF(h)中前50个差异表达基因的平均校正表达。数据以均值 ± s.d.表示,每个重复的个体值以点叠加;每组n = 3个重复培养物,均来自同一原代PDAC CAF分离物,并独立处理并测序。统计显著性使用双侧非配对Student’s t检验(假设方差相等)评估,确切P值显示在相应比较条上方。
体外成纤维细胞刺激
CellChat和NicheNet发现ISG15+ iCAF推测对IFNγ有反应,这促使我们进一步探索IFNγ刺激是否能使成纤维细胞极化为ISG15+ iCAF状态。基于先前的工作,我们还假设成纤维细胞在暴露于脂多糖(LPS)或IL-1后可能被激活为CXCL8+ iCAF状态66。为检验这些假设,我们用IFNγ、LPS或溶剂对照处理培养的人原代胰腺CAF 24 h,随后进行bulk RNA-seq(图4c,d和补充图16a)。两种处理均成功上调各自经典反应通路(图4e,f,补充表10和补充图16b,c)。直接基因特征比较显示,ISG15+和CXCL8+ iCAF转录谱分别在IFNγ处理组和LPS处理组中最大程度富集(图4g,h)。尽管这种转录一致性很有说服力,但体内CAF表型无疑受到复杂、多因素微环境线索的塑造。尽管如此,这些实验支持我们鉴定的iCAF特征的生物学相关性。
小鼠scRNA-seq数据集的整合
文章标题:跨器官和跨物种的肿瘤微环境保守性
正文: 为了评估这些细胞亚群的跨物种保守性,我们将图谱扩展到小鼠模型,这是实体瘤研究的主要实验系统67。应用我们已建立的分析框架,我们评估了来自68个小鼠实体瘤数据集的526个样本中的超过250万个细胞(图1a、b和补充表1)。为应对计算规模,各个数据集均经过了先前详述的相同sketching、三向整合和全数据集投影流程(扩展数据图8a–c)。这一并行方法成功 delineated 了在人类TME中观察到的相同的七大细胞谱系(扩展数据图8d–f和9a以及补充表11),这些谱系在几乎所有小鼠癌症类型中高度保守(扩展数据图9b、c)。
小鼠基质细胞的异质性
将我们的递归整合和重新聚类流程应用于小鼠基质区室,我们评估了成纤维细胞、内皮细胞、壁细胞和神经群体的异质性(补充表12)。小鼠CAFs分离为四个宽泛的亚群,与人类TME相对应:apCAFs、iCAFs、mCAFs和ssCAFs(扩展数据图9d和10a以及补充图17)。关键在于,Isg15+ iCAF状态——我们的人类数据表明其是肿瘤反应性TEX细胞所产生慢性IFNγ的直接应答者——在小鼠中高度保守。相比之下,由于小鼠缺乏直接的CXCL8直系同源物,第二个人类iCAF状态(CXCL8+)与小鼠中功能类似的Spp1+ iCAF群体相对应。此外,我们未观察到与人类COL4A1+LRRC15− mCAF群体明确对应的小鼠等同物。两个小鼠ssCAF亚群均广泛保守;然而,人类CXCL14+状态的转录等同物在小鼠中主要由Cxcl12表达定义。值得注意的是,小鼠apCAFs表达间皮标志物如Msln42,提示与人类对应物相比可能存在不同的谱系起源(扩展数据图10a和补充图17)。
在内皮区室内,我们识别出与人类TME相匹配的亚群:动脉、毛细血管、淋巴管、静脉,以及重要的Esm1+尖端细胞(扩展数据图9e和10b以及补充图18)。这些Esm1+尖端细胞在几乎所有小鼠肿瘤类型中的保守性(扩展数据图9e′)为研究我们人类图谱中识别出的髓系驱动的血管生成轴提供了稳健的跨物种模型。壁细胞在小鼠TME中所占比例(0.46%)小于人类(1.3%),这与许多小鼠宿主中有限的招募池相一致68。尽管如此,我们识别出保守的壁细胞亚群:Ccl2+周细胞、Cd248+周细胞和一个平滑肌细胞的伞状群体(扩展数据图9f、f′和10c以及补充图19)。最后,与人类一样,髓鞘化(Mpz+)和非髓鞘化(Ngfr+)施万细胞均存在(扩展数据图9g、g′和10d以及补充图20);然而,小鼠黑色素细胞在我们的分析中不易区分。
总体而言,这些肿瘤基质亚群在小鼠癌症类型间似乎基本保守,并且它们在肿瘤中相对于非恶性样本的相对丰度与类似的人类亚群相镜像(图3a、补充表13和补充图21)。Isg15+ iCAFs、Esm1+尖端内皮细胞和Cd248+周细胞在两个物种的恶性组织中均持续富集,强化了它们作为TME功能障碍基础组成部分的保守作用。
小鼠免疫细胞的异质性
文章标题:跨器官与跨物种的肿瘤微环境保守性
正文: 与我们在人类数据集中的结果一致,免疫细胞构成了小鼠 TME 的最大组成部分,超过 749,000 个细胞被递归分离为广泛的淋系和髓系谱系(Extended Data Fig. 1g–j)。在淋系细胞中,我们鉴定出 7 个 T 细胞、2 个 B 细胞、1 个自然杀伤细胞和 1 个浆细胞群体,均与人类中鉴定出的群体高度一致(Extended Data Fig. 9h,h′ 和 Supplementary Fig. 22)。关键在于,其中包括一个保守的耗竭 T 细胞群体(Pdcd1+ TEX),证实了小鼠图谱中存在 Isg15+ iCAF 炎症轴的假定上游信号驱动因素。同样,小鼠髓系分析划分出 14 个假定亚群,主要由树突状细胞、单核细胞和巨噬细胞组成——这是髓系驱动的血管生成信号向 Esm1+ tip 细胞传递的保守来源——此外还包括肥大细胞、中性粒细胞和破骨细胞(Extended Data Fig. 9i,i′ 和 Supplementary Fig. 23)。总体而言,这些发现强调了人类与小鼠免疫微环境之间深度的转录一致性。
跨物种保守性
最后,我们评估了人类与小鼠肿瘤之间基质细胞和免疫细胞的进化保守性。对于成纤维细胞,我们首先汇集了从两个物种中分离出的全部 554,238 个 CAF,并将小鼠数据进行直系同源转换,映射到共享的人类基因空间。所得数据集中的细胞使用 Harmony 按研究逐一整合(Fig. 5a,左),表明 CAF 亚群在很大程度上是保守的(Fig. 5a,右)。具体而言,iCAF、mCAF 和 ssCAF 群体在整合后的 uniform manifold approximation and projection(UMAP)嵌入中高度重叠,而 apCAF 群体则表现出中度不一致,可能反映了与 Msln 表达相关的不同谱系来源。
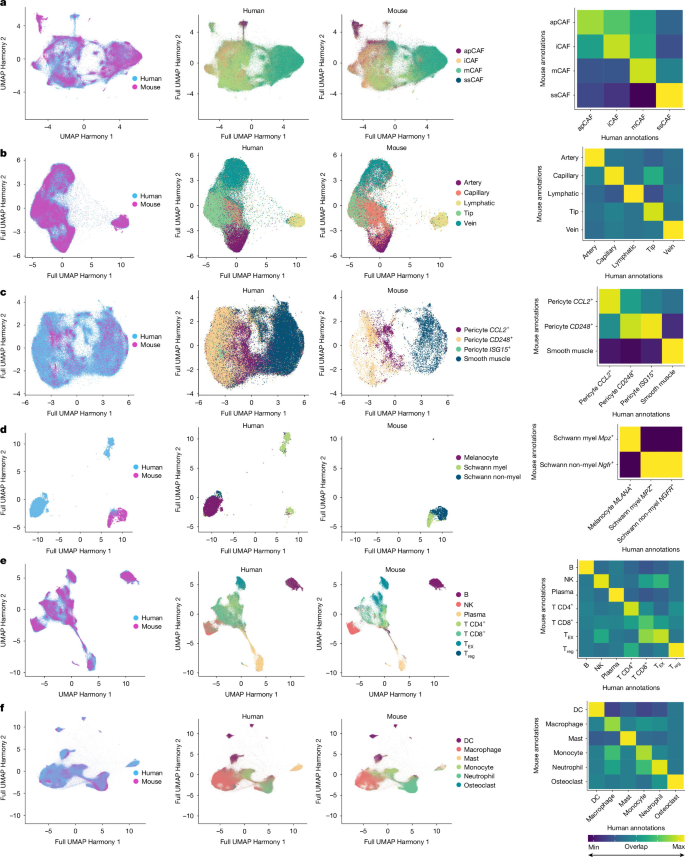
a,人类与小鼠 CAF 图谱被合并并使用 Harmony 重新整合(左),显示人类与小鼠成纤维细胞亚群之间存在大量重叠(中)。Spearman 相关性基于底层聚类之间的共现计算(右)。n = 554,238 个细胞。b–f,使用 Harmony 合并并重新整合的人类与小鼠肿瘤图谱,分别对应内皮细胞(b;n = 296,957)、壁细胞(c;n = 173,859)、神经细胞(d;n = 10,129)、淋系细胞(e;n = 1,913,684)和髓系细胞(f;n = 1,221,301),相关性矩阵按 panel a 所述方法得出。
我们同样对内皮(296,957 个细胞)、壁(173,859 个细胞)和神经(10,129 个细胞)区室进行了整合性跨物种分析(Fig. 5b–d,左)。内皮和壁细胞亚群在物种间被证明高度保守(Fig. 5b,c,右)。相比之下,在神经区室中,只有一小群 Schwann 细胞表现出种间重叠(Fig. 5d,右)。此外,对庞大的免疫 TME(1,913,684 个淋系细胞和 1,221,301 个髓系细胞;Fig. 5e,f,左)的整合揭示了两个广泛谱系中的亚群具有稳健的进化保守性(Fig. 5e,f,右)。
为了正式量化这种保守性,我们评估了共聚类整合中各群体之间的共享重叠,生成热图作为细胞转录组对齐的代理指标(Fig. 5a–f,右)。一项正交分析利用基于锚点的标签转移,将已注释的小鼠数据集投射到其人类对应物上,得到了平行结果(Supplementary Fig. 24a–f)。两项定量评估均揭示了所有非神经亚群存在显著的跨物种相关性。总之,这种跨物种整合表明,定义 TME 的核心转录组状态在人类与小鼠实体瘤之间高度保守。
讨论
肿瘤微环境在器官和物种间的保守性
在此,我们呈现了一项正式的荟萃分析,涵盖人类和小鼠 42 种实体瘤类型中超过 1500 万个细胞,为高度保守的 TME 细胞生态系统提供了前所未有的洞见。通过利用并行、半正交的整合策略,我们建立了一个高度稳健且具有包容性的框架,用于在庞大、异质的数据集中解析不同的聚类层面注释。通过这种方法,我们选择性地分离了共享基质和免疫区室内的不同细胞亚群,从而实现 TME 的泛癌图谱绘制,同时也能捕捉标准单流程方法中常丢失的过渡性和外周细胞状态。
通过将我们的图谱层面聚类与既有范式13,25,38,39,40,41 相协调,我们开发了一个统一框架,解决了文献中重叠的基质描述。对于成纤维细胞,我们划分出四个总体超级簇:apCAFs、iCAFs、mCAFs 和 ssCAFs,以及多个亚簇。该图谱的巨大规模使我们能够整合先前碎片化的命名。例如,我们将经典的 LRRC15+ 肌纤维母细胞状态和 COL4A1/SPP1+ 机械响应状态都归入统一的 mCAF 区室,反映它们共享的 ECM 重塑程序。此外,我们的正交分析一致表明,传统的 CXCL12+ iCAF 状态最好定义为组织驻留 ssCAF 群体(CXCL14/CXCL12+),其在转录上不同于真正的炎症性 iCAF。对于内皮细胞、血管壁细胞和神经细胞,我们同样提供了命名,以澄清先前较小研究8,52 中的描述。
这些精细化分类的一个结果是出现了更精确特化的细胞状态。例如,在 iCAF 区室内,我们解析出一个由 ISG15 表达定义的独特亚群。这些细胞在肿瘤中以及肿瘤性生长的各阶段均强烈富集,表现出与接收来自 T 细胞的 IFNγ 信号一致的基因表达模式,并与生存期显著缩短相关。这表明这些 ISG15+ iCAF 是免疫抑制性 TME 的重要组成部分,也是有前景的治疗靶点。
ISG15+ iCAF 的鉴定凸显了该图谱的一个主要临床意义:基质的深度保守性表明,靶向这些核心群体可能产生广泛适用的多癌种疗法。通过系统性地分离那些明显在肿瘤中富集并与不良临床结局相关的成纤维细胞、内皮细胞和血管壁细胞群体,该框架从描述性图谱转变为治疗蓝图,提供了选择性调节促肿瘤基质、同时避免传统干预常伴随的脱靶毒性的潜力。
与我们在基质中的发现一致,我们在实体瘤免疫微环境中观察到同等高度的保守性,为淋巴样和髓样群体提供了一个平行的、广泛适用的框架。尽管联合免疫疗法正被迅速采用,但其疗效从根本上取决于 TME 的许可性。然而,这些免疫群体很少在更广泛的基质多样性背景下被分析。通过在两个区室中建立一致的细胞框架,我们提供了一个统一视角,以整体评估 TME 内的抗肿瘤免疫。作为原理验证,我们通过在处理的基质细胞中诱导出预期的转录变化,为我们的荟萃分析所预测的选定免疫—基质相互作用提供了支持证据。
跨器官与物种的肿瘤微环境保守性
总体而言,本研究在范围上远大于该领域此前的重要研究。本研究还评估了 TME 内的所有细胞,而此前大多数工作要么仅孤立检查单一细胞类型,要么局限于肿瘤基质或免疫区室。通过确立人和小鼠 TME 之间高度的跨物种保守性,该图谱弥合了将临床前模型转化到人类疾病中的关键缺口。我们用体外和体内试验补充了计算框架,将预测的细胞状态与可观察的肿瘤生物学联系起来。此外,通过将这些发现编纂成公共工具
文章标题:Conservation of the tumour microenvironment across organs and species
正文:
- (5) 结合经典标记基因、估计的拷贝数变异(inferCNV,v1.14.2)78、SingleR79 和 scATOMIC27 进行监督注释与过滤,划分为七大类细胞类型:上皮细胞、成纤维细胞、内皮细胞、壁细胞、神经细胞、淋巴样细胞和髓系细胞(Extended Data Fig. 1f 和 Supplementary Fig. 2)。
结合经典标记基因、估计的拷贝数变异(inferCNV,v1.14.2)78、SingleR79 和 scATOMIC27 进行监督注释与过滤,划分为七大类细胞类型:上皮细胞、成纤维细胞、内皮细胞、壁细胞、神经细胞、淋巴样细胞和髓系细胞(Extended Data Fig. 1f 和 Supplementary Fig. 2)。
- (6) 初步汇集所有被三种方法中任意一种分配给某一给定细胞类型的细胞,允许注释重叠(即同一细胞最初被分配给不止一种细胞类型;Extended Data Fig. 1g)。
初步汇集所有被三种方法中任意一种分配给某一给定细胞类型的细胞,允许注释重叠(即同一细胞最初被分配给不止一种细胞类型;Extended Data Fig. 1g)。
- (7) 通过重新归一化、重新寻找可变特征、重新缩放数据、重新执行 PCA、使用 Harmony 重新整合(关于选择 Harmony 的理由见下文“Selection of Harmony for downstream integration”一节)、重新聚类和重新注释,迭代去除“错误分配”的细胞,以生成成纤维细胞、内皮细胞、壁细胞、神经细胞、淋巴样细胞和髓系细胞的最终“纯”图谱(Extended Data Fig. 1h),随后对每个群体进行最终注释(Fig. 2d–i、Extended Data Fig. 1i,j 和 Supplementary Tables 6 和 7)。
通过重新归一化、重新寻找可变特征、重新缩放数据、重新执行 PCA、使用 Harmony 重新整合(关于选择 Harmony 的理由见下文“Selection of Harmony for downstream integration”一节)、重新聚类和重新注释,迭代去除“错误分配”的细胞,以生成成纤维细胞、内皮细胞、壁细胞、神经细胞、淋巴样细胞和髓系细胞的最终“纯”图谱(Extended Data Fig. 1h),随后对每个群体进行最终注释(Fig. 2d–i、Extended Data Fig. 1i,j 和 Supplementary Tables 6 和 7)。
- (8) 生成最终的人和小鼠泛癌、全细胞 TME 图谱。
生成最终的人和小鼠泛癌、全细胞 TME 图谱。
- (9) 人和小鼠 TME 图谱的跨物种整合。
人和小鼠 TME 图谱的跨物种整合。
这些步骤将在以下各节中详细描述。
全面整理所有公开可用的癌症 scRNA-seq 数据集
通过检索两个功能基因组学数据库:GEO 和 ArrayExpress(Extended Data Fig. 1a),识别了公开可用的人和小鼠癌症 scRNA-seq 数据集。使用了以下检索词:
Human GEO:(‘cancer’ OR ‘tumor’ OR ‘tumour’ OR ‘carcinoma’)AND((‘single cell’ OR ‘single-cell’ OR ‘scRNA’ OR ‘sc-RNA’)OR(‘single nuc’ OR ‘single-nuc’ OR ‘snRNA’ OR ‘sn-RNA’))AND 2014/01:2025/07[Publication Date] AND ‘Homo sapiens’[organism] AND ‘expression profiling by high throughput sequencing’[DataSet Type]。
Mouse GEO:(‘cancer’ OR ‘tumor’ OR ‘tumour’ OR ‘carcinoma’)AND((‘single cell’ OR ‘single-cell’ OR ‘scRNA’ OR ‘sc-RNA’)OR(‘single nuc’ OR ‘single-nuc’ OR ‘snRNA’ OR ‘sn-RNA’))AND 2014/01:2025/07[Publication Date] AND ‘Mus musculus’[organism] AND ‘expression profiling by high throughput sequencing’[DataSet Type]。
ArrayExpress:(‘cancer’ OR ‘tumor’ OR ‘tumour’ OR ‘carcinoma’)AND((‘single cell’ OR ‘single-cell’ OR ‘scRNA’ OR ‘sc-RNA’)OR(‘single nuc’ OR ‘single-nuc’ OR ‘snRNA’ OR ‘sn-RNA’))。
共人工筛选了 2,168 个人类和 1,807 个小鼠数据集,以识别符合研究纳入标准的数据集:(1)数据集必须包含至少三个来自原发肿瘤或非恶性组织样本的 scRNA-seq 样本;(2)scRNA-seq 平台必须基于液滴(例如 10X Genomics、Drop-seq 等);(3)癌症类型必须是非中枢神经系统实体器官肿瘤;(4)scRNA-seq 样本必须至少包含一些基质细胞。小鼠数据集进一步筛选以满足另外两项纳入标准:(1)肿瘤模型必须是基因工程小鼠模型或原位癌细胞系小鼠模型;(2)荷瘤小鼠必须未接受过治疗。共有 210 个人类 scRNA-seq 数据集和 79 个小鼠 scRNA-seq 数据集符合这些纳入标准(Extended Data Fig. 1a)。
每个数据集的数据均从其公共存储库下载,并使用 R(v4.2.2)中的 read10X、read10X_h5、ReadMtx + CreateSeuratObject 或 read.table + CreateSeuratObject 函数转换为基础 Seurat 对象。随后,每个新创建的 Seurat 对象(对应单个 scRNA-seq 样本)都填充了相关的样本级元数据。具体做法是首先构建一个单一的大型 .csv 文件,其中包含:样本名称、研究名称、器官、癌症、部位(即肿瘤、肿瘤邻近或非癌)以及 FACS 分选策略(如有)。对于人类样本,如可获得,还记录了额外的临床元数据——包括患者年龄、性别、肿瘤临床分期和治疗反应。对于所有小鼠样本,还记录了精确的肿瘤模型(例如 MMTV-PyMT)和肿瘤模型类型(例如基因工程小鼠模型)。这些元数据是从所有 2,855 个人类样本和所有 526 个小鼠样本对应的数据库条目和文章中人工收集的。
单个 scRNA-seq 数据集的处理与过滤
一旦填充了上述元数据,样本随后使用 Seurat 单细胞分析流程(v4.9.9.9050)73 逐一进行质控分析。为确保数据集之间的可比性,使用 biomaRt(v2.56)将 ENSEMBL 转录本 ID 和基因同义词转换为人类或小鼠基因符号,并且仅保留在人类或小鼠参考基因组 GRCh38.p14 或 GRCm39 中发现的基因。随后,确认每个数据集的原始
人类和小鼠数据集按照相同步骤分别整合:在研究级对象上使用 Seurat (v4.9.9.9050),原始 RNA counts 进行对数归一化,并鉴定前 2,000 个可变特征(高变基因)。为提高分析跨越数百万细胞数据集的计算效率,我们基于为每个细胞计算的 leverage scores73,选择每个数据集 1,000 个细胞的代表性草图(Extended Data Fig. 1d)。使用草图数据集,重新鉴定可变特征,表达水平进行缩放,并执行 PCA(npcs = 30)。接下来,对草图数据进行整合。鉴于任何单一整合和下游分析方法都存在随机性因素,可能导致给定单个细胞被错误分类35,79,我们最初在 Seurat 中应用了三种不同的整合方法:Harmony、scVI 和 FastMNN(Extended Data Fig. 1e)。此整合的批次键为 ‘study’,三种方法均未进行协变量回归。每种整合方法后,执行 UMAP 降维(dims = 1:30, min.dist = 0.001),寻找邻居(dims = 1:30),并鉴定初始聚类(分辨率因数据集而异)。随后,
人和小鼠的泛癌成纤维细胞、壁细胞、神经、淋巴样和髓系细胞图谱也以类似方式生成:纳入被三种算法中任一算法鉴定为相应细胞类型的细胞。为生成人内皮细胞、壁细胞、神经、淋巴样和髓系细胞图谱,计算流程分别迭代了六次、五次、四次、五次和三次。类似地,为生成小鼠内皮细胞、壁细胞、神经、淋巴样和髓系细胞图谱,计算流程分别迭代了三次、三次、两次、四次和四次。细胞类型图谱中的亚群按上述方式注释(扩展数据图 1j)。由于在上皮来源癌症中区分上皮细胞与肿瘤细胞存在挑战,未对上皮细胞进行下游分析。值得注意的是,我们的方法未明确考虑用于提取转录谱的液滴中可能存在的环境 RNA83。遗憾的是,由于大多数公开可用的 scRNA-seq 数据集的格式(缺少“未过滤”计数矩阵),无法应用诸如 CellBender84 或 SoupX85 等稳健的环境 RNA 校正方法。
生成最终的泛癌全细胞 TME 图谱
随后,将来自六个独立细胞类型图谱的人细胞亚群注释和小鼠亚群注释映射回各自的全细胞图谱。在(5)中初始宽泛分类里标记为上皮细胞的细胞被注释为上皮细胞。通过迭代清洗步骤过滤掉的细胞被移除。最终,人 TME 图谱共有 45 个细胞群体,小鼠 TME 图谱共有 44 个细胞群体(图 2a 和扩展数据图 9a)。
跨物种整合
为评估人和小鼠之间 TME 内细胞亚群的保守性,在 Seurat(v4.9.9.9050)中对六种主要 TME 细胞类型分别整合了人和小鼠细胞类型图谱。为进行该整合,使用 NicheNet R 包(v2.0.4)86 中的 convert_mouse_to_human_symbols 函数进行直系同源转换,将小鼠图谱中的小鼠基因名转换为人类直系同源基因名。随后,将六个人细胞类型图谱分别与对应的小鼠细胞类型图谱合并。对于每个合并的人–小鼠图谱,使用 Seurat(v4.9.9.9050)按数据集拆分对象、标准化数据、寻找可变特征、缩放表达水平、执行 PCA(npcs = 30)、使用 Harmony 整合数据,并执行 UMAP 降维(dims = 1:30, min.dist = 0.001)。为评估细胞类型的人–小鼠保守性,绘制 UMAP 结果,使每个细胞按来自相应人细胞类型图谱或小鼠细胞类型图谱的细胞类型注释着色(图 5a–f)。为评估该跨物种分析的质量,我们使用了两种方法。第一,我们基于底层聚类之间的共现构建了相关矩阵(图 5a–f,右侧);第二,我们应用基于锚点的标签转移,将小鼠注释映射到人细胞上。后者通过在图 5a–f 所用的每种主要细胞类型中,分别对小鼠和人对象在 Seurat 中应用 SCTransform 来完成。然后,以 dimensions 为 1:30、reduction = ‘pca’ 应用 FindTransferAnchors,随后以 dimensions 为 1:30 应用 TransferData。其他默认参数未作更改。重叠热图使用 ggplot2 生成(补充图 24a–f)。
选择 Harmony 用于下游整合
基于其在使用 scIB35(补充表5)评估的生物学保守性和批次指标上的表现,Harmony 被选为所有后续下游整合的方法(在初始使用全部三种方法进行第一轮之后)。对于该分析,使用 SingleCellExperiment 库将三种方法(Harmony、scVI 和 FastMNN)各自整合的 Seurat 对象转换为 SingleCellExperiment 对象。所得对象使用 anndata2ri 包导入 Python。随后使用 scIB 中的 scib.metrics 函数集计算各项指标。
使用人类泛癌 TME 图谱进行的下游分析
人类 TME 图谱被用于进行六项下游分析:(1)细胞亚群富集分析,(2)SCENIC 分析,(3)scMetabolism 分析,(4)TCGA 生存分析,(5)CellChat 分析,以及(6)NicheNet 分析。这六项分析各自的方法详见下文。
细胞亚群富集分析
人类 scRNA-seq TME 图谱中每个细胞亚群的相对富集,针对三个临床相关元数据类别直接计算:非恶性组织样本与肿瘤样本之间;早期(I 和 II 期)与晚期(III 和 IV 期)肿瘤之间;以及治疗应答与无应答肿瘤之间。小鼠 scRNA-seq TME 图谱中每个细胞亚群的相对富集,在非恶性组织与肿瘤组织之间直接计算。如果原始文章中有这些元数据,则对每个 scRNA-seq 样本以一致方式注释。为计算每个细胞亚群的相对富集,对每个样本计算每个细胞亚群(例如 ISG15+ iCAFs)中的细胞占更广泛细胞类型(例如成纤维细胞)中所有细胞的百分比。为避免来自稀疏表示样本的不稳定比例估计,任何向给定亲本细胞类型贡献 30 个或更少细胞的样本,都被排除在该细胞类型亚群的分析之外。该标准对每个亲本谱系独立应用,因此对给定比较有贡献的样本数取决于该谱系,并且显著小于队列中的样本总数;在一个谱系内,同一组样本对每个组成亚群都有贡献。每个比较的确切 n 报告在相应的图例以及补充表8和13中。
统计显著性用于判定细胞亚群富集,采用双侧加权 Welch t 检验,针对两个独立样本(wtd.t.test,weights R package(v1.0.4),with samedata = FALSE);其中重复单位为单个 scRNA-seq 样本,检验量为每个样本的亚群比例。为考虑单细胞捕获率的高度变异,样本权重设为每个样本细胞数的平方根。自由度通过 Welch–Satterthwaite 近似获得,因此为非整数。另外,定义图中误差线的组均值的加权标准误使用 Kish 有效样本量计算,neff = (Σw)2/Σw2,这会降低细胞数过多样本的贡献。由于细胞亚群嵌套于亲本细胞类型中,Benjamini–Hochberg 校正在每个亲本谱系内分别应用,因此每个检验族对应于划分单一亲本细胞类型的一组亚群;同时计算的所有亚群 Benjamini–Hochberg 校正 P 值也额外报告以保证完整性。每个比较的完整统计输出,包括每组的确切 n、加权组均值和标准误、富集倍数及其 95% 置信区间(通过对数尺度上的 delta 方法获得)、t 统计量、自由度以及确切的原始和校正 P 值,均提供在补充表 8 和 13 中。
SCENIC 分析
SCENIC87 用于计算人类 scRNA-seq 中调控子富集的恢复曲线下面积(AUC)。生成带有 AUC 分数的 Seurat 对象,并通过运行标准 Seurat 流程进行聚类。差异表达调控子通过运行 FindAllMarkers 函数识别,并使用标准 DimPlot 函数绘制(扩展数据图 5a–d)。
scMetabolism 分析
为评估特定细胞群体是否可能与代谢程序的差异相关,我们使用了 R88 中的 scMetabolism 包。所有合并的基质细胞群体的 Seurat 对象(扩展数据图 5e)或各自单独的 Seurat 对象(扩展数据图 5f–h)使用 sc.metabolism.Seurat 函数进行评估,参数为:method = ‘AUCell’,imputation = F,ncores = 2 和 metabolism.type = ‘KEGG’。使用默认输入通路 ‘glycolysis/gluconeogenesis’、‘oxidative phosphorylation’ 和 ‘citrate cycle (TCA cycle)’,扩展数据图 5e–h 中的代谢图使用 DotPlot.metabolism 函数对每个群体分组生成。
TCGA 生存分析
TCGA2 的 bulk RNA-seq 数据用于正交计算每个细胞亚群在肿瘤邻近样本相对于肿瘤样本中的相对富集,并评估每个细胞亚群对患者生存的影响。TCGA 数据集包括 31 种实体瘤类型中的 9,880 个原发肿瘤样本和 740 个肿瘤邻近样本,数据集使用 TCGAbiolinks(v3.18)2 下载。为对 TCGA bulk RNA-seq 数据进行解卷积,我们首先生成了一个降采样的 scRNA-seq 参考,其中包含来自人类 TME 图谱的每个细胞亚群中随机选择的 1,000 个细胞。使用该降采样 scRNA-seq 参考,对 31 种 TCGA 实体器官癌症类型中的每一种,使用 CIBERSORTx 并结合 S-mode 批次校正进行 bulk 解卷积。bulk 解卷积的输出是每个样本中每个细胞亚群百分比的估计值。对每个细胞亚群,计算肿瘤样本和肿瘤邻近样本中细胞亚群比例的均值和标准误。肿瘤邻近样本相对于肿瘤样本的相对富集计算为两组之间的比值(补充图 6a)。
肿瘤微环境在器官和物种间的保守性
来自肿瘤样本的 CIBERSORTx 细胞亚群比例估计值还被用于评估每个细胞亚群对患者生存的影响。首先,对于每个细胞亚群,每种癌症类型的患者肿瘤样本根据该细胞亚群的相对比例被分为两组。例如,肿瘤样本中该亚群比例大于该亚群平均估计比例的患者被视为高丰度组,相反,肿瘤样本中该亚群比例小于平均估计比例的患者被视为低丰度组。然后,使用 survcomp R 包实现的 Cox 回归分析,利用 TCGA 的生存时间临床元数据,估计每种癌症类型中高表达者与低表达者之间的风险比。随后,通过计算 31 种癌症类型中每种癌症类型的风险比的逆方差加权平均值,估计每个细胞亚群的泛癌风险比(Supplementary Fig. 6b)。
为校正多重假设检验,对所有比较计算了 Benjamini–Hochberg 校正 P 值。完整的统计输出,包括所有临床组比较的倍数富集或风险比、加权标准误和校正 P 值,见 Supplementary Table 9。
CellChat 分析
CellChat (v1.5.0)89 用于分析我们人类 TME 图谱中细胞亚群之间推定的细胞–细胞通讯网络。为运行 CellChat,相关的 TME Seurat 对象首先被下采样至仅包含 100,000 个随机选择的细胞,每个细胞亚群至少 100 个细胞。与这些下采样数据(及其相关元数据)对应的原始计数从初始 Seurat 对象中提取,并用于填充一个新的 CellChat 对象。非神经 TME 亚群的标签被用作分组。该对象通过标准 CellChat 流程处理,随后对感兴趣的信号通路进行网络中心性分析(Fig. 4a, Extended Data Fig. 7a,c and Supplementary Fig. 15a)。
NicheNet 分析
NicheNet (v2.0.4)86 用于为 CellChat 预测的细胞–细胞通讯网络提供正交支持。Seurat 对象被下采样至 100,000 个随机选择的细胞(每个亚群至少 100 个),然后使用发送者和接收者群体(如下所述)输入 NicheNet 以评估相互作用。生成调控潜力热图以可视化这些相互作用,系统地将优先排序的发送者配体显示在 y 轴上,并将其对预测靶基因的调控潜力显示在 x 轴上。具体而言,该框架被应用于评估以下信号传递:(1) T CD8+GZMB+ 细胞到 ISG15+ iCAFs(IFNγ 信号,Fig. 4b);(2) 树突状细胞到 ISG15+ iCAFs(MIF 信号;Supplementary Fig. 15b–d);(3) 巨噬细胞–单核细胞到 ESM1+ 尖端细胞(VEGF 信号;Extended Data Fig. 7b);以及 (4) 壁细胞到 ESM1+ 尖端细胞(Extended Data Fig. 7d)。
组织学和免疫荧光染色
福尔马林固定、石蜡包埋(FFPE)的肿瘤及肿瘤邻近组织块从Stanford病理学系获取,包括7例PDAC、3例PTC和3例CRC标本。免疫荧光染色在8-µm组织切片上进行。对于免疫荧光染色,将载玻片浸入预热的柠檬酸钠缓冲液(10 mM,pH 6.0)中10分钟进行抗原修复,然后在Power Block(BioGenex)中封闭1小时。对于PDGFRα–HLA-DR共定位,将载玻片与以下一抗在4 °C下孵育过夜:抗人PDGFRα兔单克隆抗体(3174,CST;克隆D1E1E)和抗人HLA-DR小鼠单克隆抗体(327002,BioLegend;克隆LN3)。然后将载玻片与以下二抗孵育1小时:Alexa Fluor 647偶联驴抗兔多克隆抗体(A-31573,Invitrogen)和Alexa Fluor 555偶联驴抗小鼠多克隆抗体(A-31570,Invitrogen)。最后,使用含DAPI的Fluoromount-G封片剂(00-4959-52,Invitrogen)封片。使用Leica SP8倒置共聚焦显微镜以×20放大倍数获取荧光图像。
CODEX与基质结构分析
CODEX/Phenocycler是一种高度多重免疫荧光技术,先前已被我们实验室用于量化3例PDAC FFPE组织切片中30种蛋白的空间表达90。CODEX panel评估了几种成纤维细胞标志物(αSMA和COL1)、一种apCAF标志物(HLA-DR)、免疫细胞标志物(CD11c、CD20、CD68、CD8和CD4)以及上皮/肿瘤细胞标志物(E-cadherin和pan-cytokeratin(CK))的表达。另外,我们实验室开发的一种纤维量化算法先前已被用于量化85例FFPE PDAC标本的基质结构91。简言之,8-µm苏木精和伊红(H&E)染色的组织切片以×40成像,并以程序化方式生成354,838个200 × 200 µm的图像瓦片。之后,通过检查147个纤维特征来量化每个瓦片的组织学结构,并使用Monocle3进行UMAP降维和轨迹分析,为单个H&E瓦片分配伪时间值,给定患者的高平均基质伪时间与较差的患者生存相关。为了检查CODEX切片中的基质结构,先前将与CODEX切片连续的8-µm组织切片进行H&E染色,并使用纤维量化算法分析200 × 200 µm图像瓦片。使用GIMP将H&E瓦片与CODEX切片进行空间对齐,以生成三个CODEX切片各自的基质伪时间空间图。在本研究中,使用CODEX Multiplex Analysis Viewer可视化三个PDAC CODEX切片中高和低基质伪时间区域中11种蛋白标志物的多重免疫荧光染色。通过目视检查鉴定出纺锤状HLA-DR+αSMA+COL1+CD68−CD11c−CD20−CD8−CD4−E-cadherin−pan-CK−CD31−细胞。
公开可用Xenium数据分析
文章标题:跨器官和物种的肿瘤微环境保守性
正文: 为了对我们上述的免疫荧光和 CODEX 观察结果提供进一步的验证,我们使用了 10X Genomics 网站上的一个公开 Xenium 数据集:Pancreatic Cancer with Xenium Human Multi-Tissue and Cancer Panel(https://www.10xgenomics.com/datasets/pancreatic-cancer-with-xenium-human-multi-tissue-and-cancer-panel-1-standard;数据集列表:https://www.10xgenomics.com/datasets?query=Xenium)。scRNA-seq 参考数据是通过从我们最初的全局细胞群中选取细胞群并结合我们的成纤维细胞亚型分型构建的。对于反卷积,按照推荐的方式实施了 NiCo 1.1.0 pipeline63,即对参考数据集和 Xenium ST 数据集进行过滤和归一化,寻找共同共享的基因,使用 Scanpy 执行 SCTransform,并以 0.7 的分辨率对 Xenium 数据进行 Leiden 聚类。随后,运行了 find_anchor_cells_between_ref_and_query 和 nico_based_annotation 函数,以空间离散度截止值 0.15 在参考数据集和 Xenium ST 数据集之间寻找锚点。随后利用基因(转录本)与细胞群(标记细胞)的共定位生成附图。
人原代 PDAC CAF 的刺激与 bulk RNA-seq
原代 CAF 使用 Miltenyi Biotec Tumor Dissociation Kit(130-095-929)从一份新鲜的胰腺 PDAC 手术标本中分离,该操作依照机构审查委员会(IRB)批准的方案进行,术前已在 Stanford 的 IRB-65893 下取得知情同意(参考文献 92)。供者为一名男性患者。本研究未使用已建立或永生化细胞系;成纤维细胞身份依据参考文献 92 的原代外植体分离方案确定,并未通过标志物分析单独确认。培养物未进行支原体污染检测。分离得到的 CAF 在 DMEM/F-12 with GlutaMAX(10565018,Gibco)、10% FBS(16000044,Gibco)、1% antibiotic–antimycotic(B22110,R&D)和 0.2% primocin(ant-pm-05,InvivoGen)中培养四个传代。第 4 代细胞(每个重复 105 个细胞;每种条件 n = 3 个重复)贴壁 12 h,随后用对照培养基、重组人 IFNγ(20 ng ml−1;285-IF,R&D)或 LPS(100 ng ml−1;tlrl-eblps,InvivoGen)处理 24 h。来自同一第 4 代细胞池的细胞被分到九个培养板中,未再进一步传代,每个培养板随后独立处理并测序(每种条件三个培养板)。随后使用 TRIzol(15596026,Invitrogen)提取 RNA。按照 NEBNext rRNA Depletion Kit v2(human/mouse/rat)(E7400L,NEB)的制造商方案,使用 NEBNext Ultra II Directional RNA Library Prep Kit for Illumina(E7760,NEB)制备了九个 RNA-seq 文库。
对于每个文库,每个重复取 50 ng 作为输入。在接头连接步骤中,使用 Singular Genomics Universal Library Prep Adapter(#700110)使文库适用于在 Singular Genomics G4 测序仪上测序。对接头连接后的 DNA 进行 12 个循环的 PCR 富集。未进行 index 读取(read 1,75 bp;read 2,75 bp;无 index 循环),因为每个文库都在专用泳道中测序。所有 RNA-seq 文库均在同一天进行的三次测序运行中,在 G4 测序仪上进行双端 2 × 75 bp 测序,每个泳道测序一个文库(共九个泳道)。
Bulk RNA-seq 数据从测序仪中以按 lane 的 fastq 文件形式提取,每个 lane 一个文库,并转移到 Stanford SCG 服务器。单个 fastq 文件使用 TopHat (v2.0.13) 比对到人类 GRCh37-hg19 参考基因组,得到九个计数矩阵(n = 3 个生物学重复,对应三个实验组中的每一组)。这些数据使用 base 的 read.delimn 函数读入 R,使用 cbind 合并为单个矩阵,然后根据样本名称、重复和条件进行注释。为了计算每对条件之间排名靠前的差异表达基因,首先使用 cpm 函数对计数矩阵进行每百万计数(CPM)归一化。采用至少 2 个样本中至少有 0.5 CPM 的基因阈值,最终保留了 26,363 个基因用于下游分析。使用 prcomp 进行 PCA,并使用 autoplot 绘制对数转换后的 PCA 数据。使用 DESeq2 (v1.38.4) 及其函数 calcNormFactors、esimateCommonDisp、estimageGLMTrededDisp、estimatedTagwiseDisp、DESeq 和 lfcShrink 确定组间差异表达基因。随后使用 EnhancedVolcano (v1.13.2) 生成所得 resLFC 对象的火山图。使用 plotBCV 计算生物学变异系数(补充图 16a)。对 IFNγ 或 LPS 处理后上调的前 200 个基因进行 EnrichR 分析(补充图 16b,c)。
为了生成 ISG15+ 和 CXCL8+ iCAF 的特征签名,首先使用 FindAllMarkers 函数鉴定定义 ISG15+ iCAF 和 CXCL8+ iCAF 亚群的前 50 个基因。为了计算每个 iCAF 亚群的特征评分,检查了每个样本中这 50 个标记基因的表达值。首先,为了对 50 个标记基因等权,对计数矩阵进行按行归一化(例如,Vi,j = Vi,j/Σ(Vi))。然后,为了计算每个 iCAF 亚群的特征评分,对每个样本中 50 个标记基因的归一化表达值求和。随后基于每种条件下生物学重复的簇特征评分的离散程度计算标准差和标准误。
我们的人类 TME 注释与其他大型图谱的比较
我们考察了 Nofech-Mozes 等27、Nieto 等28、Kang 等20 和 Han 等21 发表的四个近期大型 TME 图谱。对于每个图谱,我们从其各自的存储库下载相应的完整图谱对象,并转换为 SingleCellExperiment 对象。大型数据集被下采样至 50,000 个细胞。随后应用 scTME 工具包,根据我们 TME 图谱中的细胞群体,对查询数据集中的每个细胞分别进行盲注释。然后将所得的预测性 scTME 注释与该特定数据集提供的注释进行比较,并基于共现生成热图。
scTME
利用这个大型图谱,我们开发了一个新的 R 包 scTME,它利用群体水平的数据,为候选数据集中给定簇内细胞的注释提供概率估计。该包利用了 SingleR 工具包79 中的许多分类函数,而 SingleR
可选的参考数据集(ref)。省略时,使用随包提供的集成人类 TME 图谱。
- (3) 可选的聚类标签向量(clusters),维度为 (1 × c),或包含这些标签的元数据列名称,对应于将对该对象进行评估的细胞分组。提供时,在这些分组层面执行注释,并将分配的标签传播到每个组成细胞;省略时,每个细胞单独注释。
可选的聚类标签向量(clusters),维度为 (1 × c),或包含这些标签的元数据列名称,对应于将对该对象进行评估的细胞分组。提供时,在这些分组层面执行注释,并将分配的标签传播到每个组成细胞;省略时,每个细胞单独注释。
- (4) 可选因子(level),默认设置为 2,对应于图 2a,d–i 中定义的 45 个亚群。也可以将其切换为 1,此时输出将对应于图 2a 中定义的七个主要细胞类型。
可选因子(level),默认设置为 2,对应于图 2a,d–i 中定义的 45 个亚群。也可以将其切换为 1,此时输出将对应于图 2a 中定义的七个主要细胞类型。
- (5) 可选参数 label.col,用于指定从中提取标签的参考元数据列,供提供自定义参考时使用。
可选参数 label.col,用于指定从中提取标签的参考元数据列,供提供自定义参考时使用。
- (6) 可选阈值 max.cells(默认 50,000),高于该阈值时,数据将被随机子采样为细胞数等于 max.cells 的最终对象
可选阈值 max.cells(默认 50,000),高于该阈值时,数据将被随机子采样为细胞数等于 max.cells 的最终对象
- (7) 可选参数 return.details(默认 = FALSE),除最终细胞注释外,还将输出评分矩阵。
可选参数 return.details(默认 = FALSE),除最终细胞注释外,还将输出评分矩阵。
程序输出为:
- (1) 一个(1 × c 维)的标签向量,对应分配给每个细胞的注释;这些注释基于其原始输入分组以及每个分组被注释后的输出。
一个(1 × c 维)的标签向量,对应分配给每个细胞的注释;这些注释基于其原始输入分组以及每个分组被注释后的输出。
- (2) 一个评分矩阵,对应于对每个分组级分配所评估的概率。仅当 return.details = TRUE 时才会返回。若是,则这两个输出以列表形式返回。
一个评分矩阵,对应于对每个分组级分配所评估的概率。仅当 return.details = TRUE 时才会返回。若是,则这两个输出以列表形式返回。
代码本身的详细信息可在 GitHub 文档(https://github.com/michaeljanuszyk/scTME)中找到,并且可以使用 R 中的 devtools 库通过以下命令安装:install_github(‘michaeljanuszyk/scTME’)。
插图
原始插图使用 Apple iPad Pro 和 Apple Pencil 2.0 在 Procreate(v5.2.7)软件中绘制。亮度、对比度和饱和度等参数的后期编辑调整在 Adobe Photoshop(v23.4.2)中完成。最后,使用 Biorender(https://biorender.com;许可证见相关图注)向图中添加文本和对象叠加层。
统计与可重复性
未使用统计方法预先确定样本量。对于荟萃分析,样本量由符合图1a所定义纳入标准的已发表 scRNA-seq 数据集数量决定。除上述预先指定的数据集层面和细胞层面质量控制标准外,分析中未排除任何数据。未使用随机化。对于荟萃分析,所有符合纳入标准的已发表数据集均被纳入,因此不存在分配步骤。对于体外实验,重复培养物被分配到对照、IFNγ 和 LPS 条件时未采用随机化,并平行处理。除非相应图注中另有说明,所有统计检验均为双侧,所有 P 值均使用 Benjamini–Hochberg 程序进行多重比较校正。精确校正 P 值报告于补充表 8–10 和 13。
细胞亚群富集分析(图3a–c和补充图21)使用双侧加权 Welch t 检验进行,用于两个独立样本,其中重复单位是个体 scRNA-seq 样本,样本权重等于每个样本细胞数的平方根,采用 Welch–Satterthwaite 自由度。在每个亲本谱系内,这些分析仅限于向该谱系贡献超过30个细胞的样本。因此样本数因谱系而异,并在图3图注中按谱系说明,在补充表8中针对每个单独比较说明。
在所有谱系中,贡献样本数为每个亲本细胞谱系 859–1,777(图3a)、311–658(图3b)和 48–108(图3c)个样本。每个谱系的精确值见补充表8。本研究中报告的统计量均不来源于每组少于三个生物学独立样本。在给定谱系内,同一组样本贡献于每个组成亚群。Benjamini–Hochberg 校正在每个亲本谱系内分别应用。任何比较均未在每组少于三个生物学独立样本的情况下得出统计量。TCGA 反卷积分析(补充图6)使用了31种实体瘤类型的 n = 9,880 个原发肿瘤样本和740个正常样本,风险比通过 Cox 回归估计,并通过逆方差加权跨癌种合并。
PDGFRα 和 HLA-DR 的免疫荧光共染色(图3d)在来自患者的 n = 7 个生物学独立 PDAC、n = 3 个生物学独立 CRC 和 n = 3 个生物学独立 PTC 标本以及匹配的癌旁组织上进行。每个标本染色和成像一次,并且在给定肿瘤类型的所有标本中观察到可比染色模式;所示图像具有代表性。CODEX 分析(图3f–h)在 n = 3 个生物学独立 PDAC 标本上进行,每个标本在单次多重成像运行中分析一次,每例结果可比;所示图像具有代表性。通过目视检查鉴定出肿瘤及其他免疫细胞标志物阴性、呈纺锤样 HLA-DR+αSMA+COL1+ 细胞。研究者对基质伪时间区域分配未设盲,该分配在检查前由纤维量化算法以程序方式确定。
体外 CAF 刺激实验(Fig. 4d–h 和 Supplementary Fig. 16)每种条件进行 n = 3 个重复培养,这些培养由单个原代 PDAC CAF 分离物分拆而来,并独立处理与测序。条件间的差异表达使用 DESeq2(v1.38.4)评估,采用双侧 Wald 检验,并在通过表达阈值的 26,363 个基因范围内进行 Benjamini–Hochberg 校正。iCAF 特征评分(Fig. 4g,h)以三个重复培养的均值 ± 标准差表示,并叠加单个重复值,使用双侧非配对 Student’s t 检验进行比较(假定方差相等)。在体外实验中,研究人员未设盲,因为所有读出指标均为定量指标,且由测序数据经计算得出。
伦理声明
FFPE 肿瘤及肿瘤邻近组织标本取自 Stanford University Department of Pathology 的病理样本库。本研究未招募人类参与者,所有样本采集均在 Stanford University School of Medicine 的 IRB 批准下进行。所有组织标本在进一步处理前均按照患者隐私法规进行编码和去标识化。本研究未进行动物实验;此处分析的所有小鼠单细胞 RNA-seq 数据均为已发表数据,并在其原始发表文献所报告的批准下生成。用于原代 CAF 分离的新鲜 PDAC 手术标本根据 Stanford IRB 方案 IRB-65893 采集,术前已获得知情同意。本研究中分析的所有已发表单细胞 RNA-seq 数据集均来自公共数据库,并在其原始发表文献所报告的批准下生成。
报告摘要
有关研究设计的更多信息见与本文链接的 Nature Portfolio Reporting Summary。