Newshot
Translation(model translation, not the source's own text)
看,无需向量数据库:在开放表格式上进行湖规模向量搜索
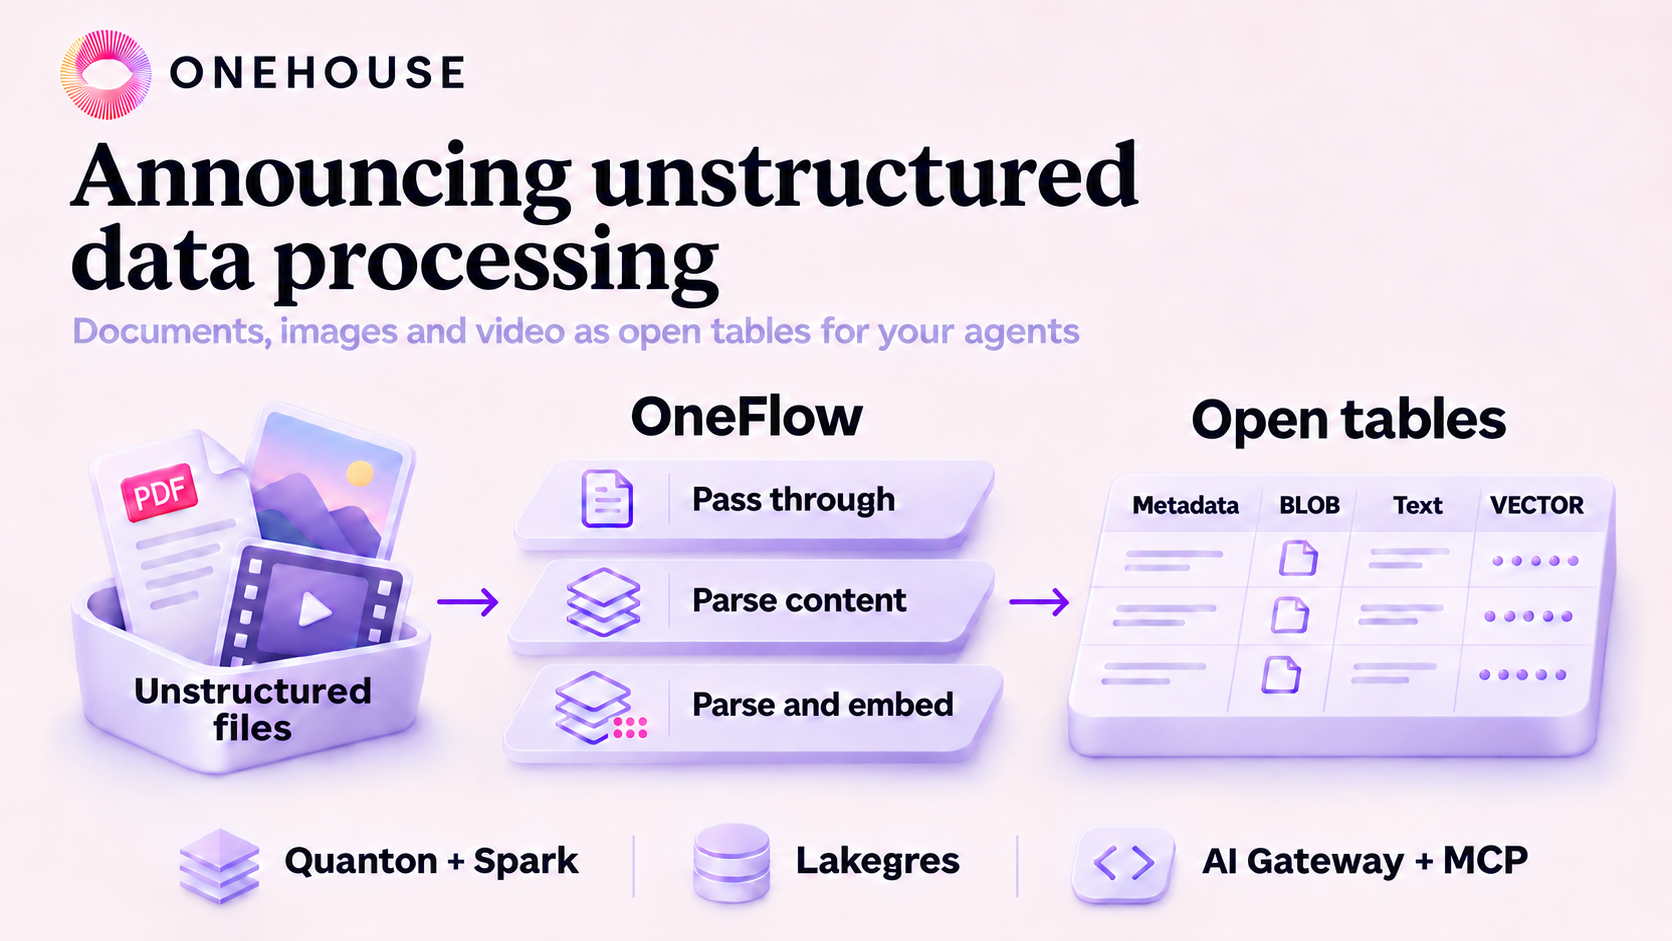
宣布非结构化数据处理:将文档、图像和视频作为开放表供你的智能体使用
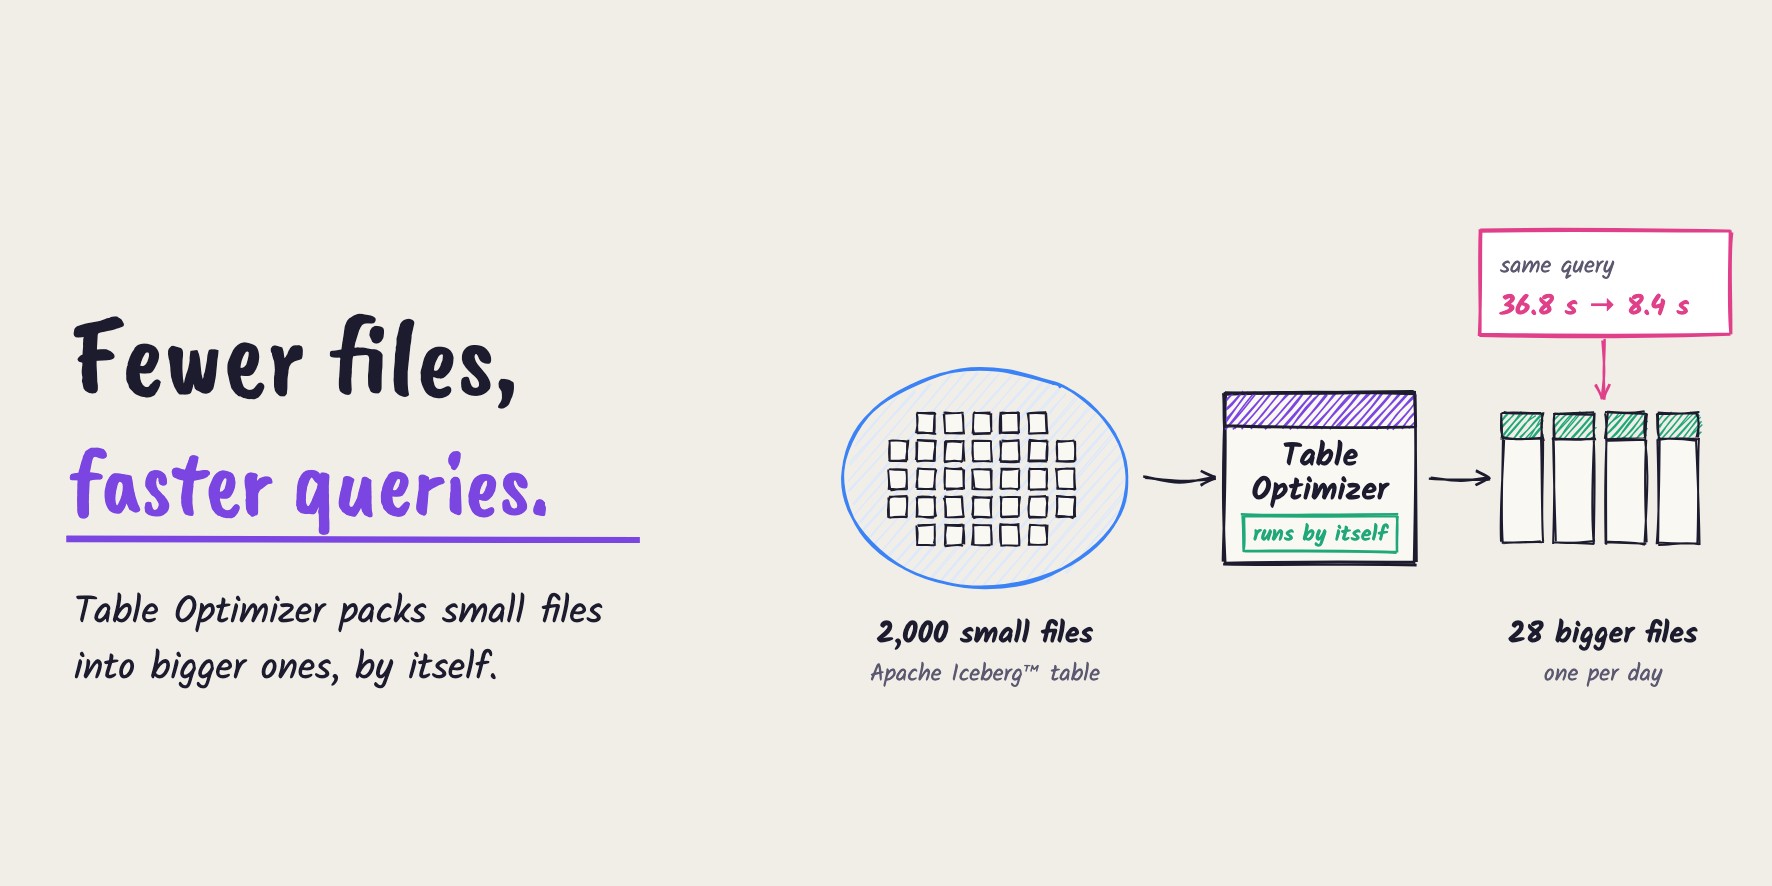
使用 Table Optimizer 修复由小文件导致的 Apache Iceberg™ 查询变慢
了解你的 Spark 计算有多少处于闲置状态
Onehouse vs Starburst Enterprise vs Cloudera:本地数据湖仓功能对比
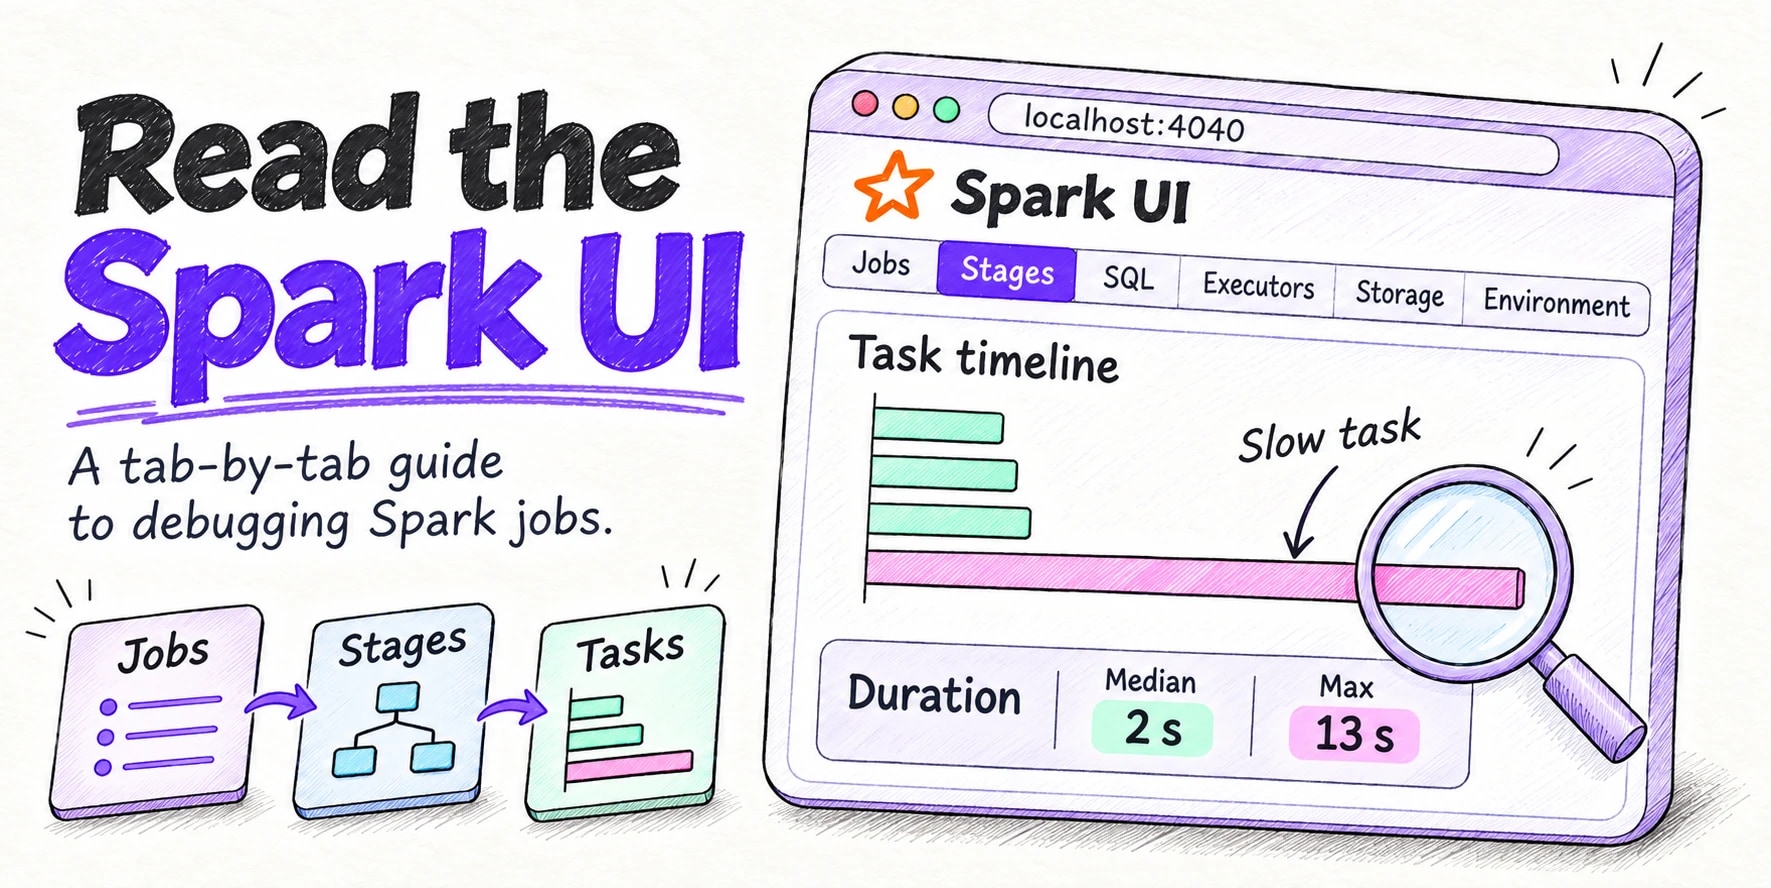
如何阅读 Spark UI:逐标签页调试 Spark 作业指南
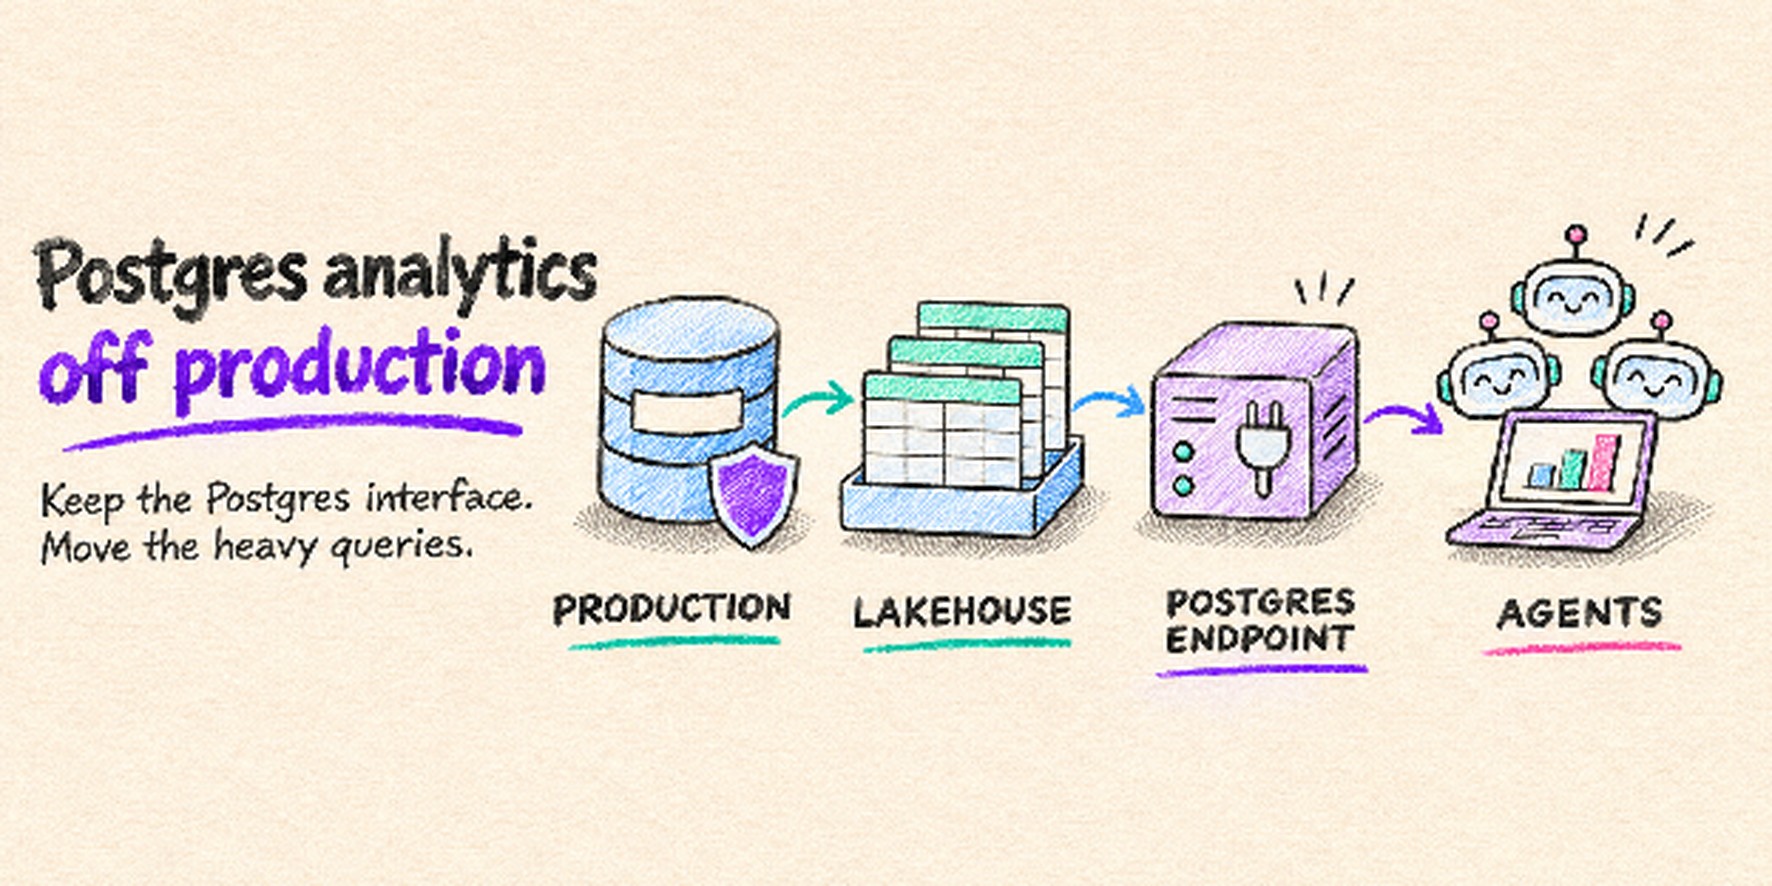
Postgres 分析:Postgres 能扩展到什么程度,以及如何让 AI 智能体远离你的生产数据库
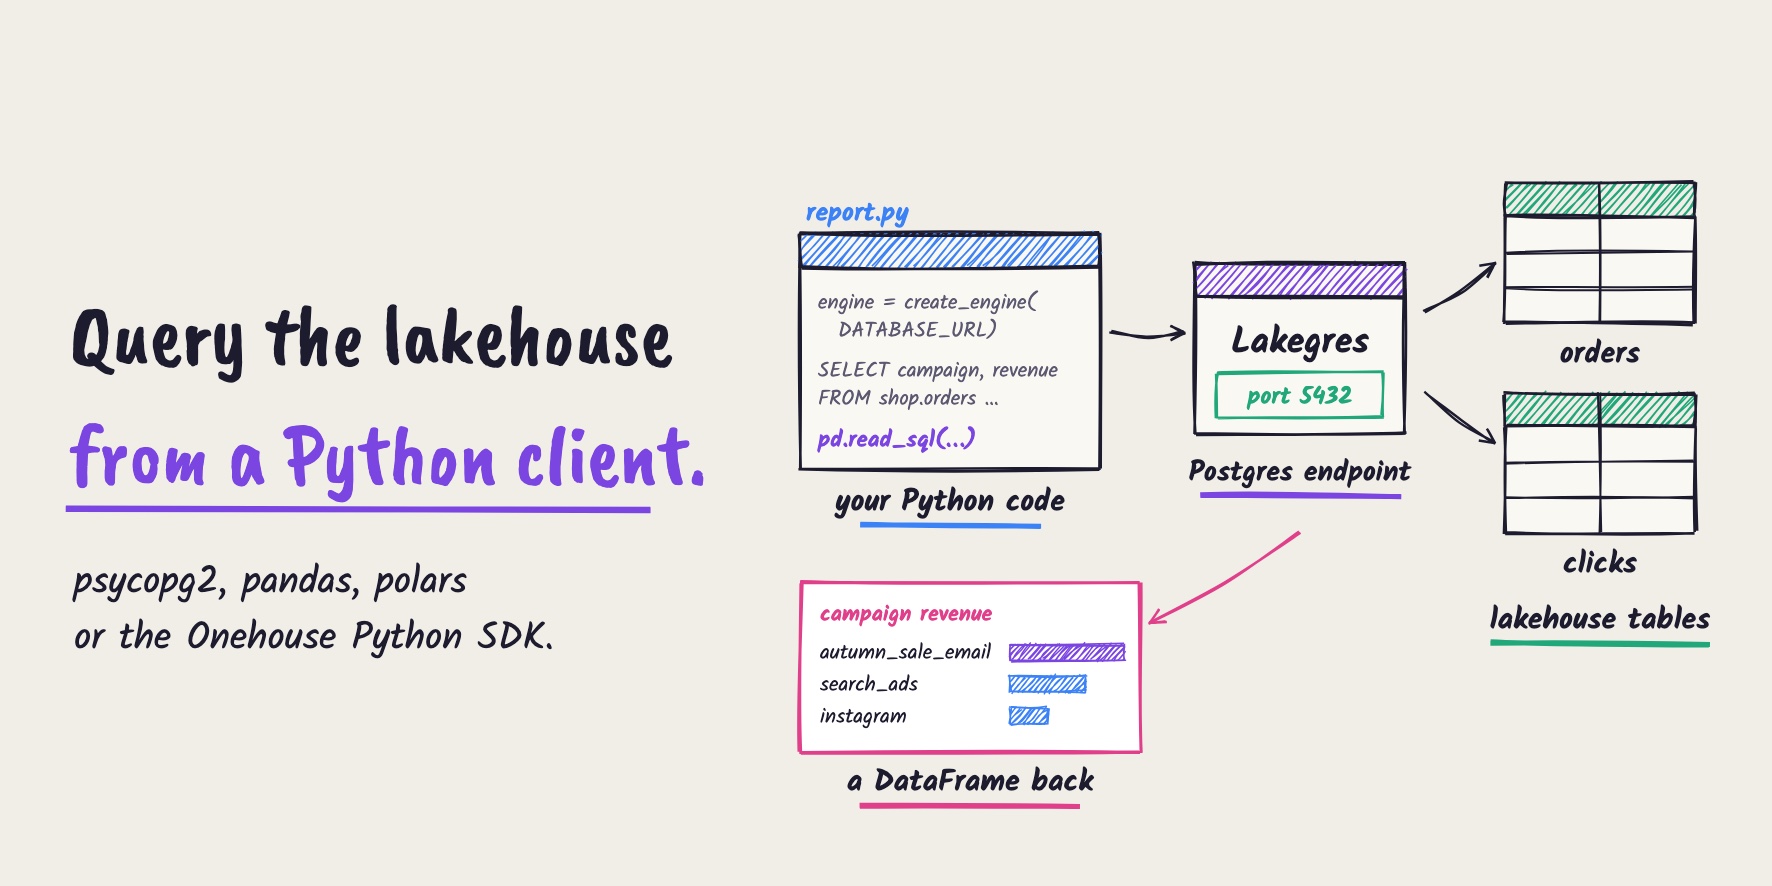
使用 Lakegres 从 Python 客户端查询湖仓表
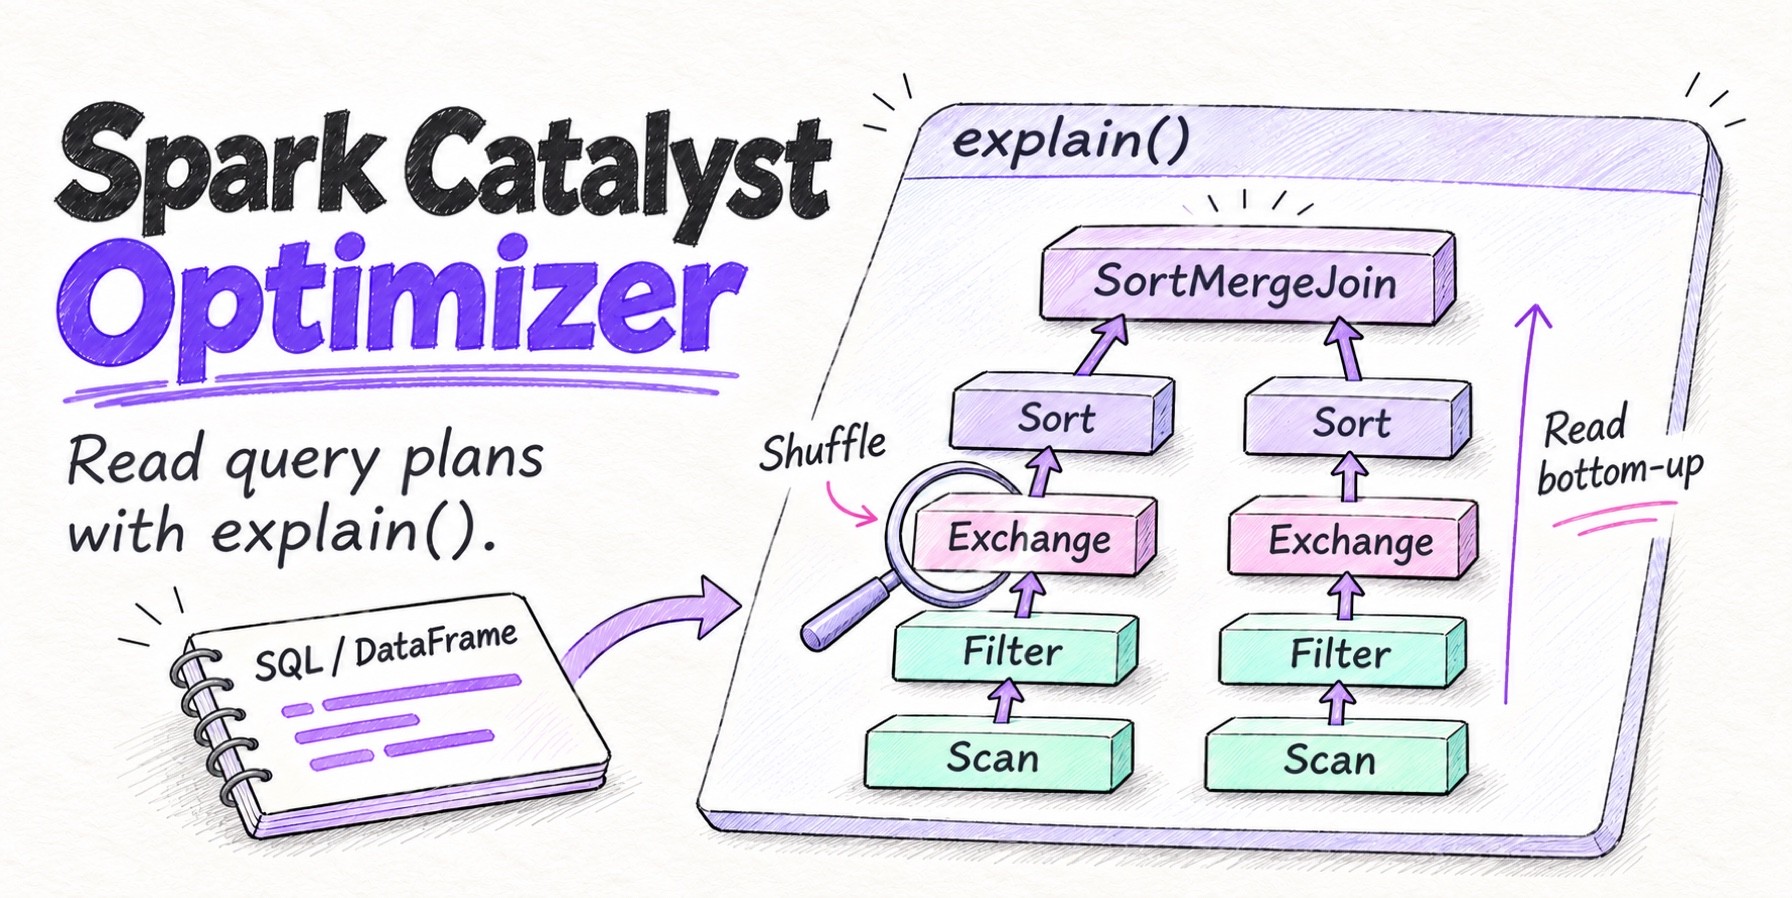
Spark Catalyst 优化器:如何使用 explain() 阅读查询计划
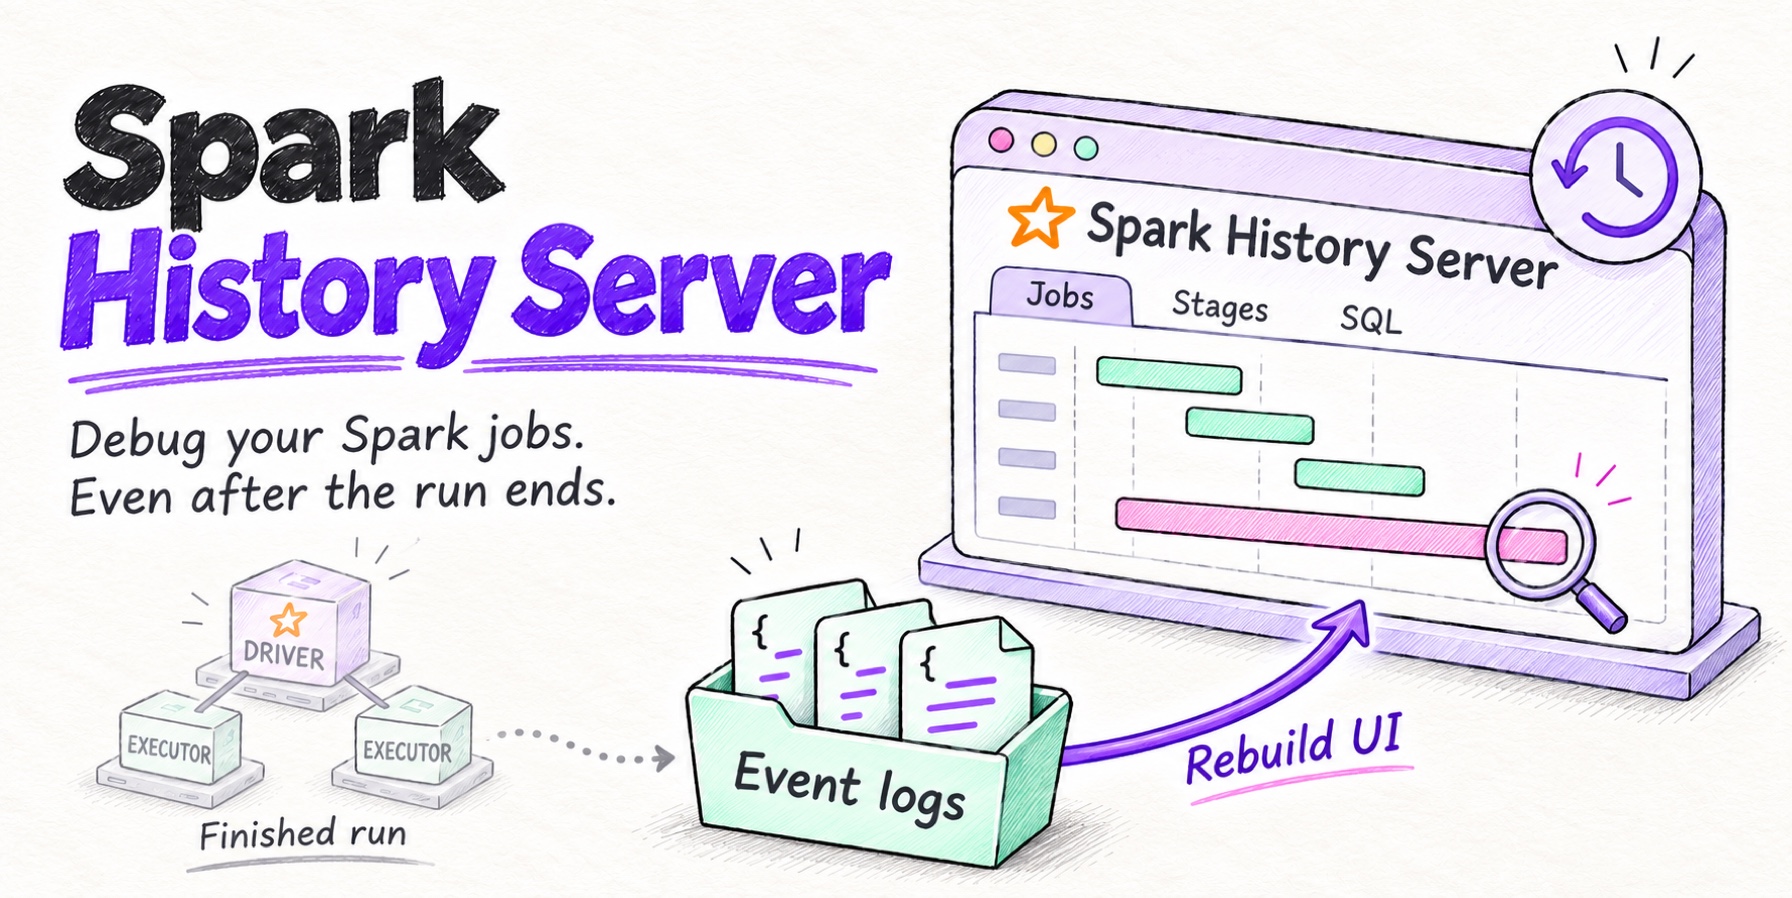
Spark History Server:如何在 Spark 作业结束后调试它
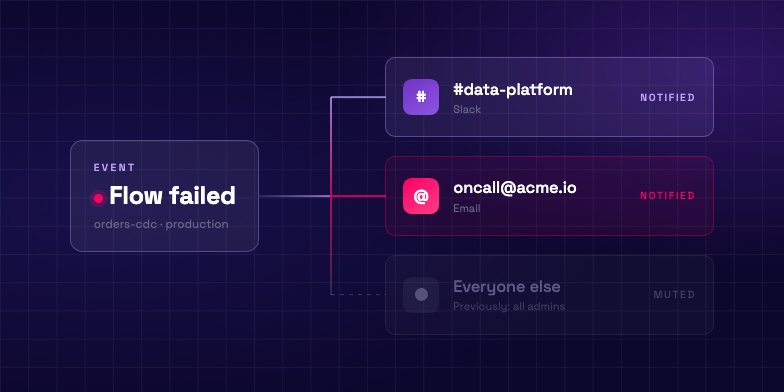
宣布 Notification Rules:按资源、事件和所有者路由湖仓告警
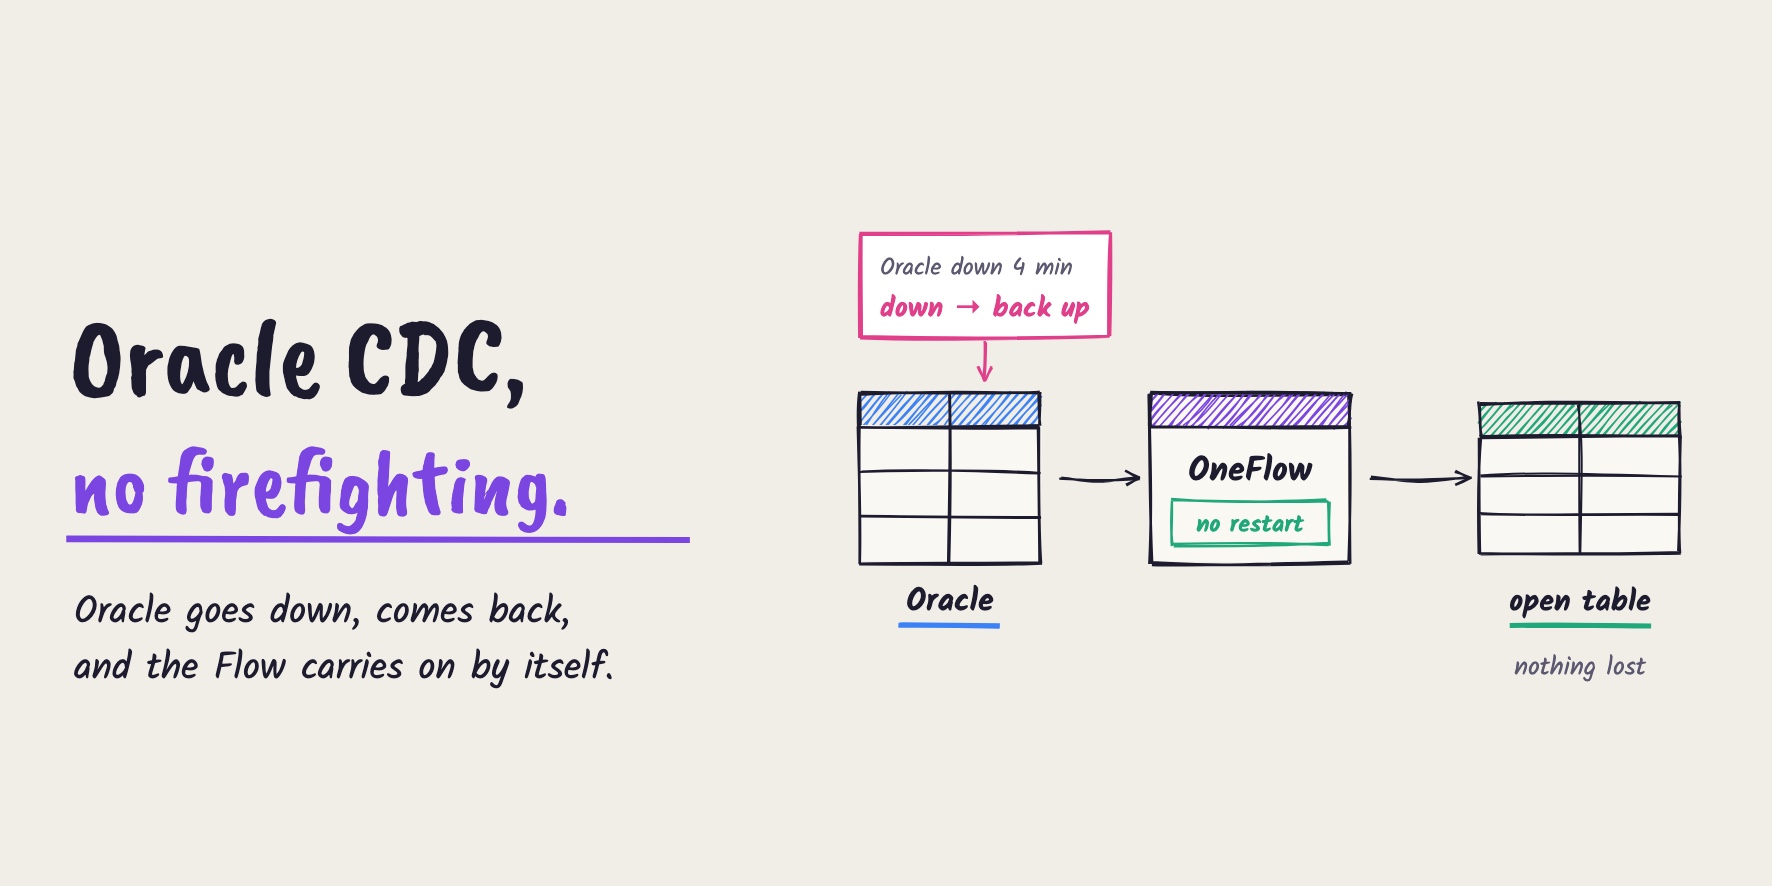
近实时 Oracle CDC,无需为管道救火
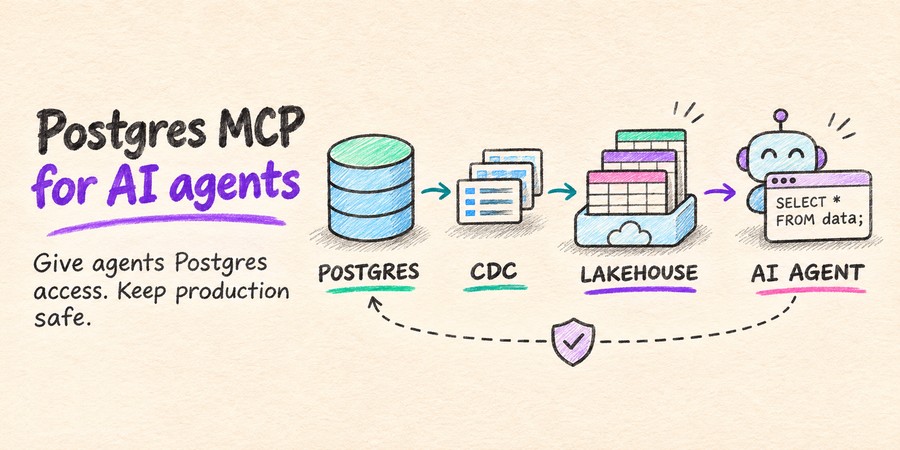
面向 AI 智能体的 Postgres MCP 服务器:如何让智能体在不危及生产环境的情况下访问 Postgres
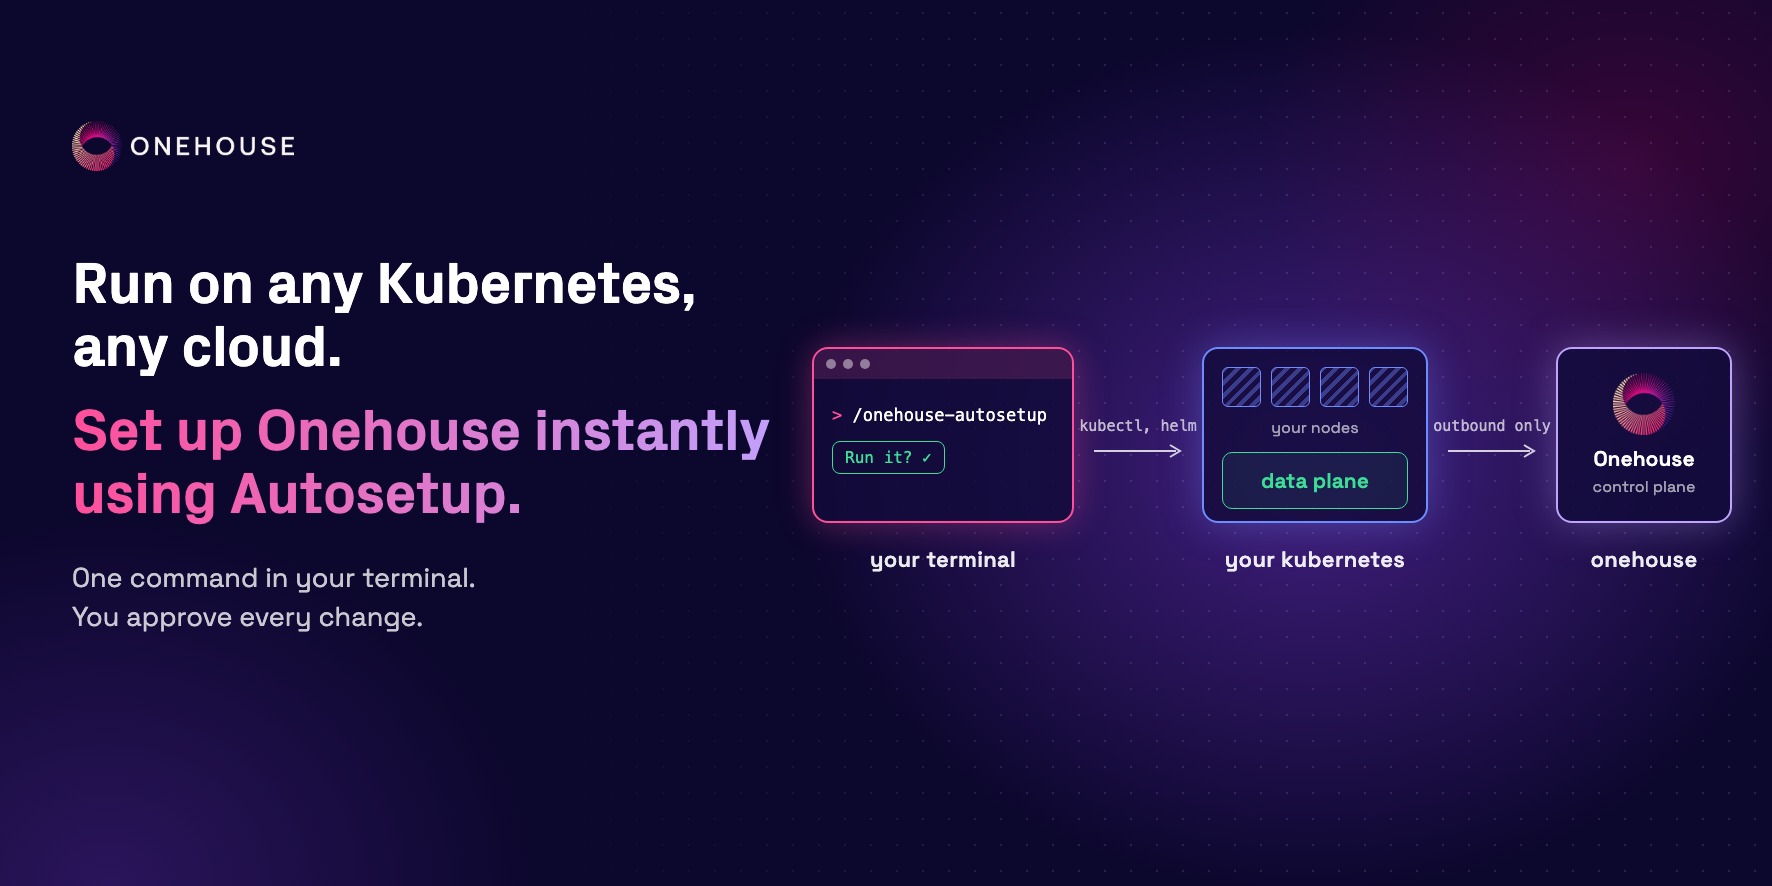
使用 Autosetup 在任意 Kubernetes 上设置 Onehouse
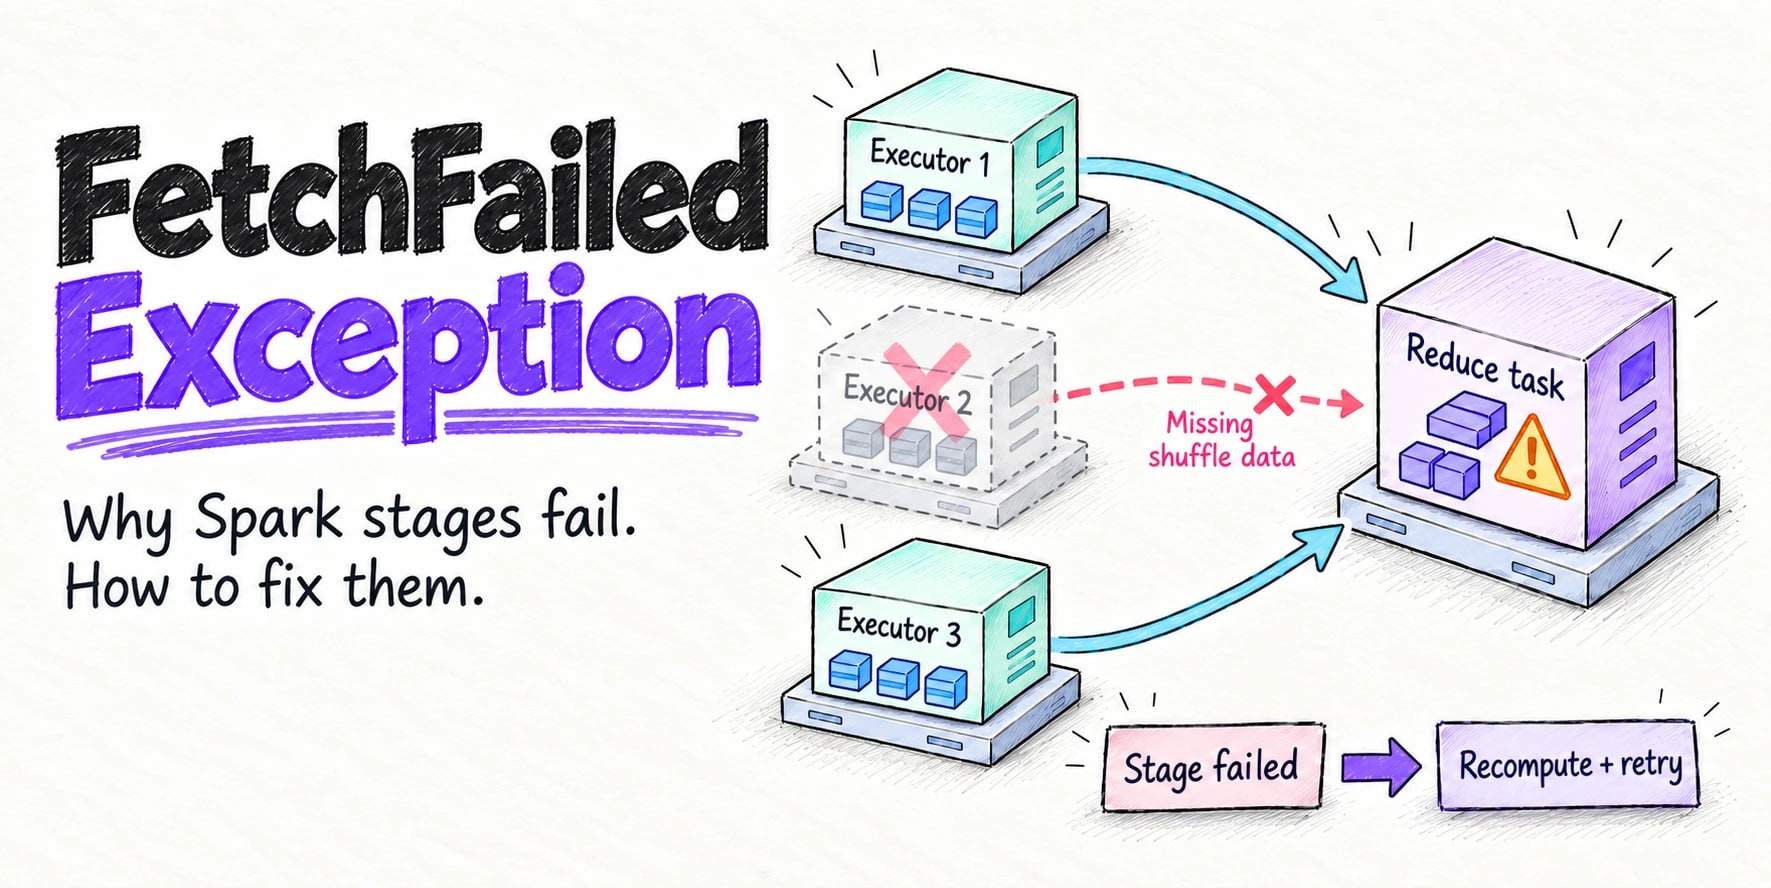
FetchFailedException:Spark 阶段为何失败以及如何修复它们
Databricks TCO:如何衡量总成本并降低它
Spark 工作负载的 EMR vs Databricks:成本、性能和锁定情况对比
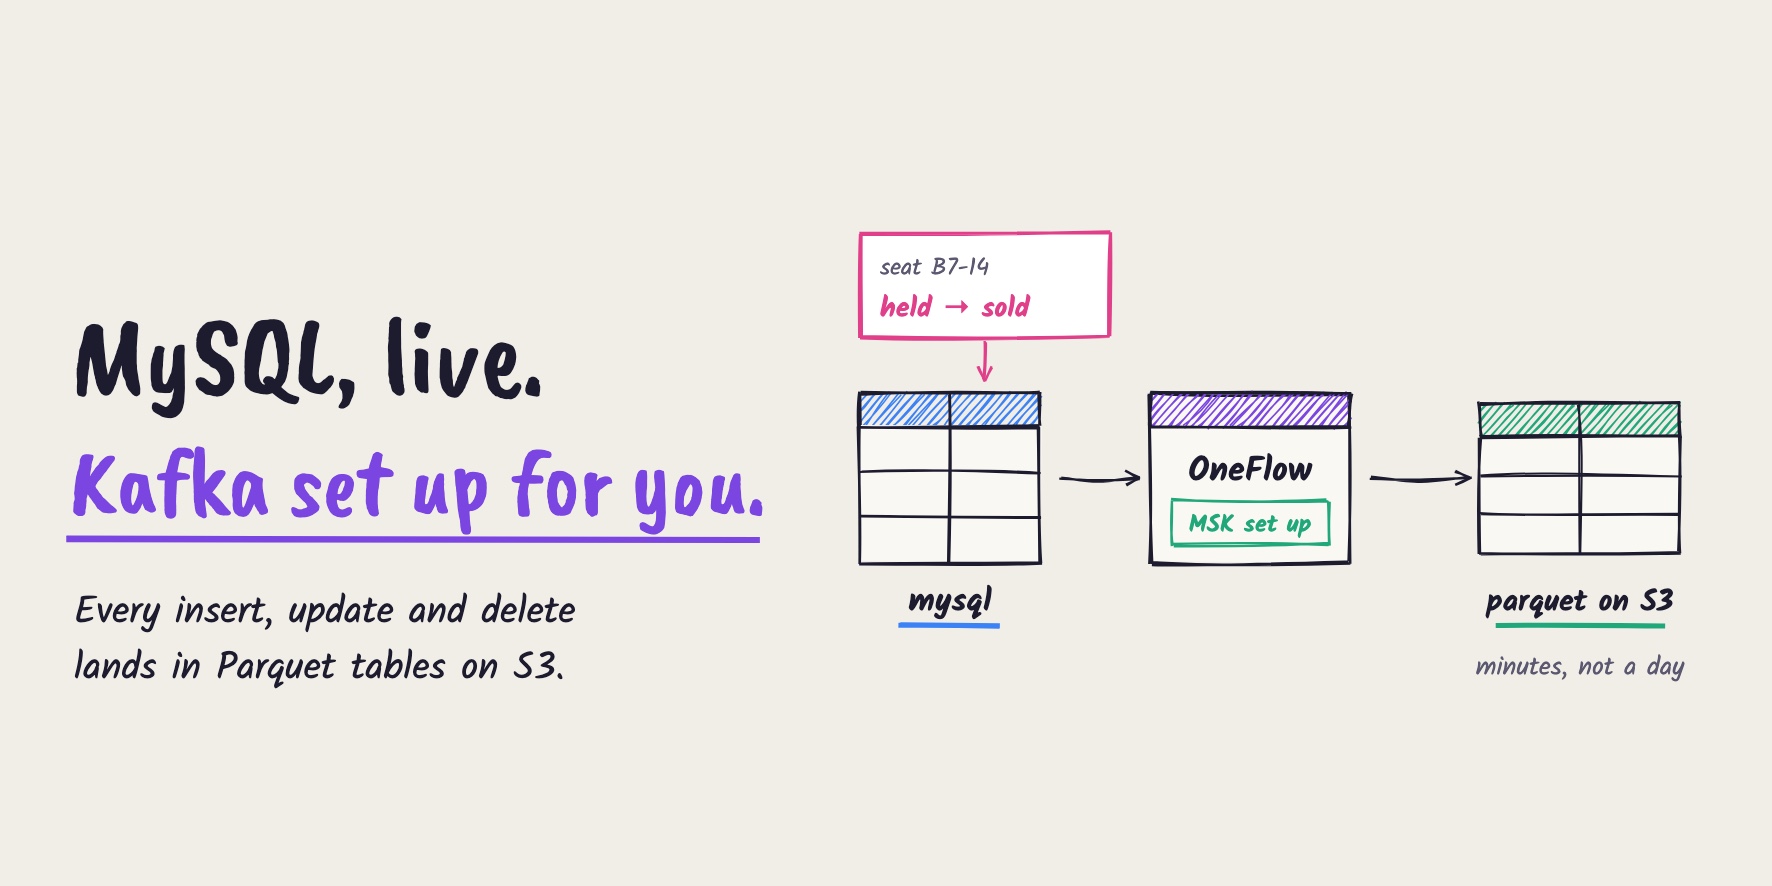
将 MySQL CDC 写入 S3 上的 Parquet 表,并为你设置好 Kafka
AWS EMR 成本优化:如何在 EC2、EKS 和 Serverless 上削减 EMR 账单
Databricks 性能调优:你能修复什么,以及不能修复什么
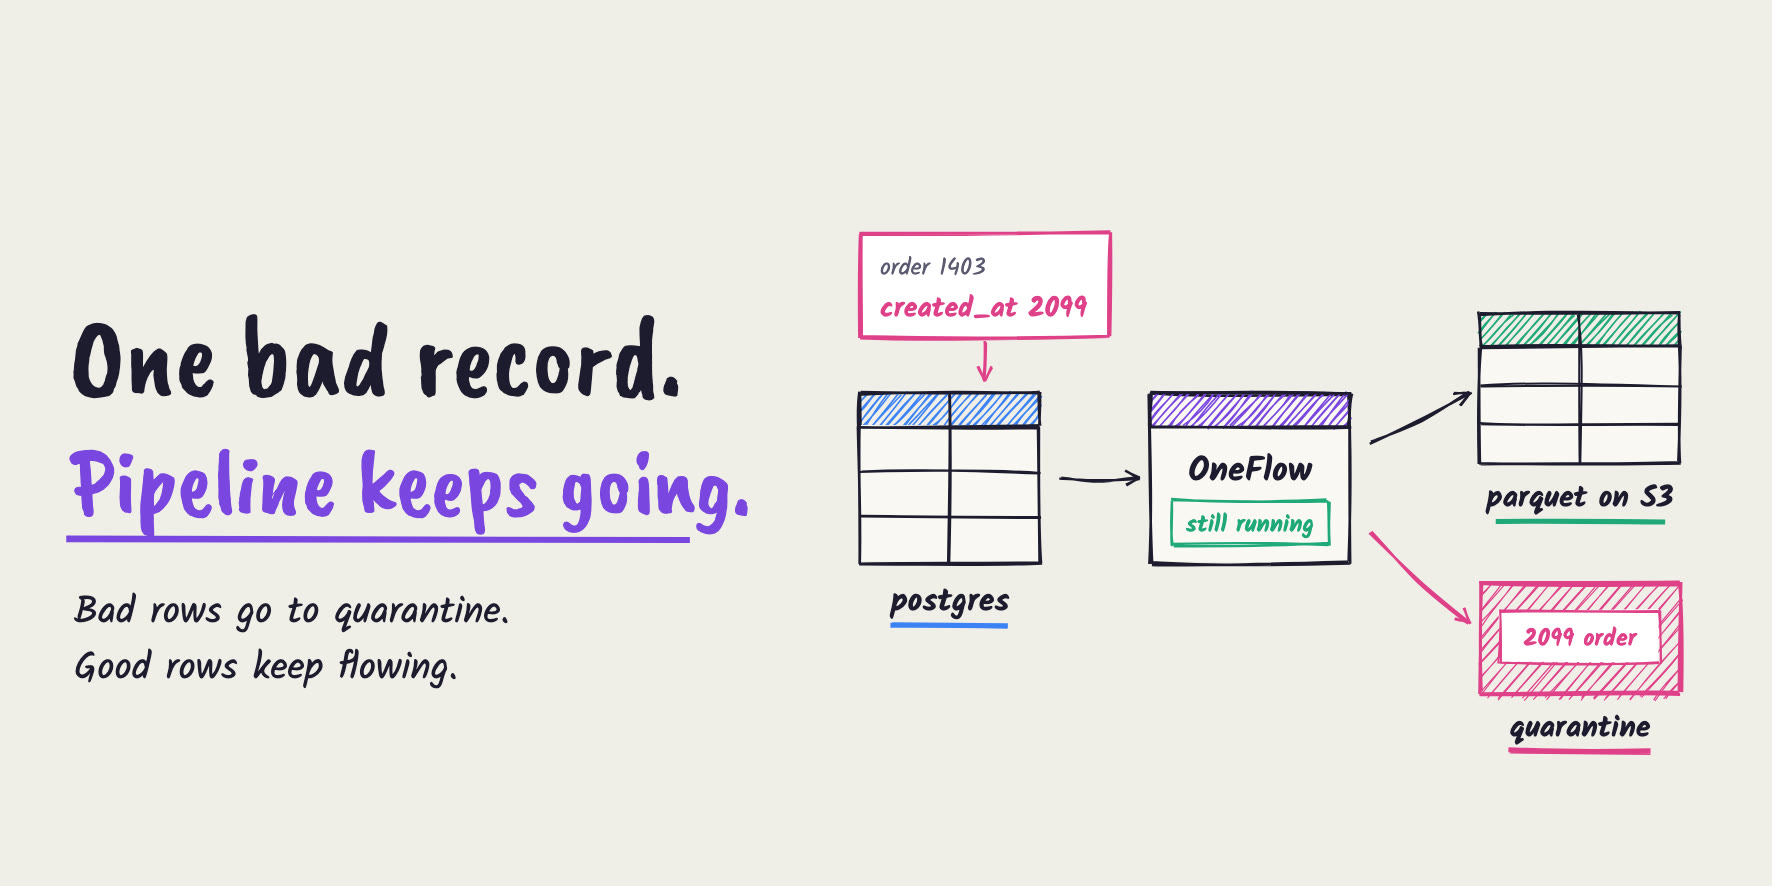
在不停止 Postgres CDC 管道的情况下隔离坏记录
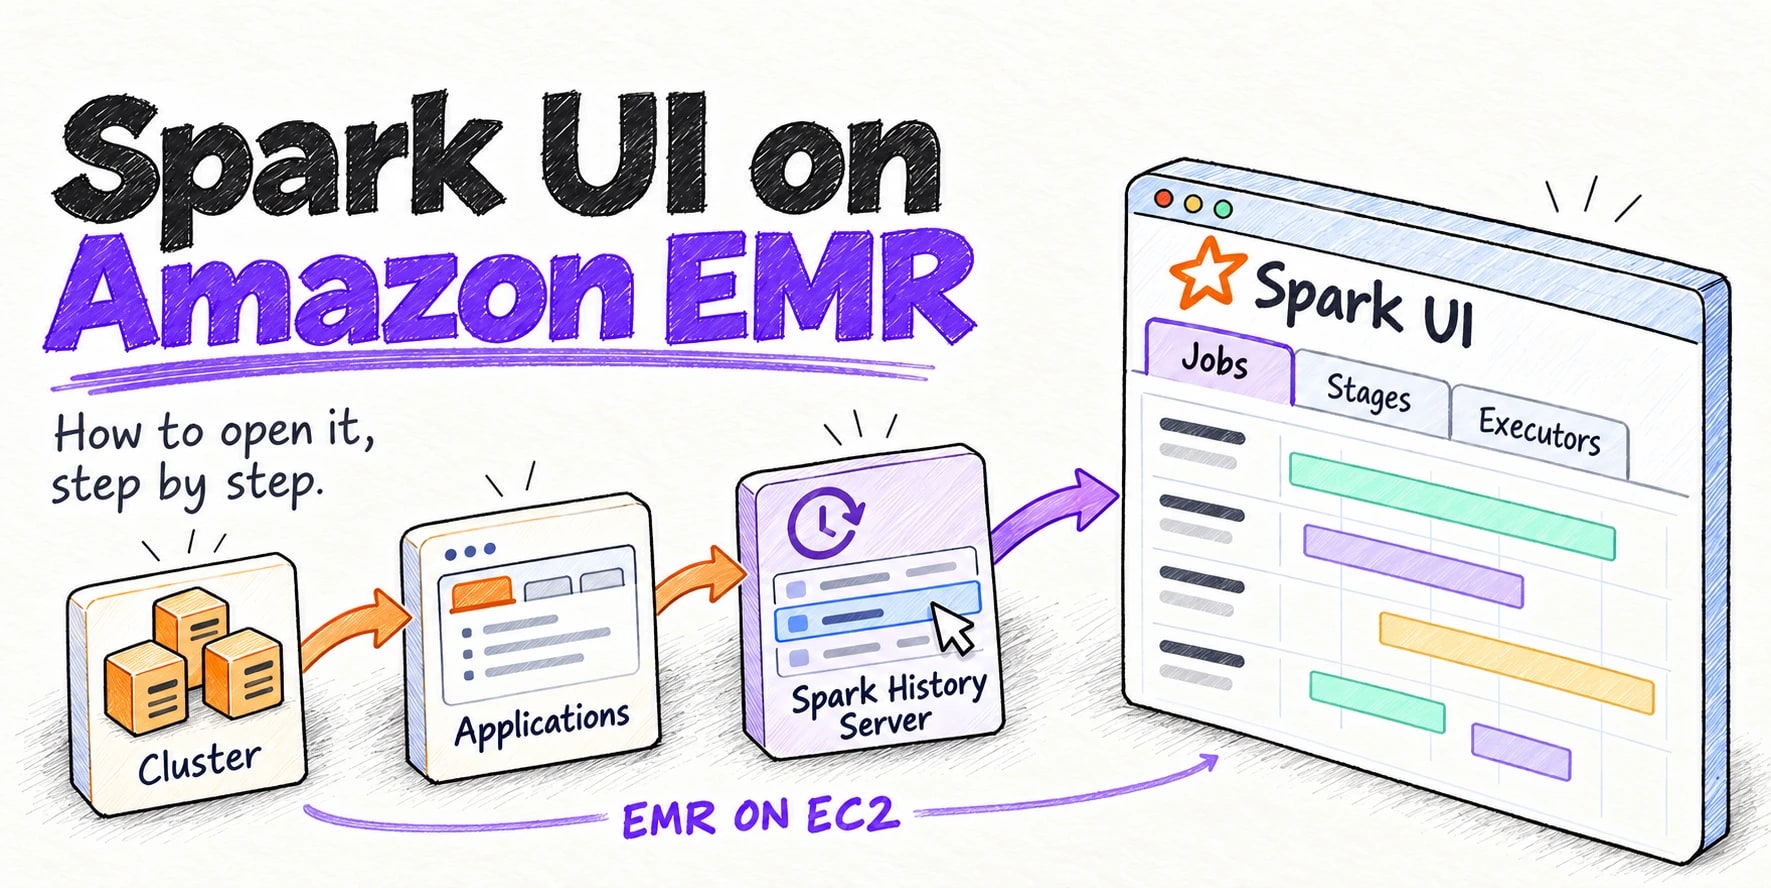
如何在 Amazon EMR 上访问 Spark UI
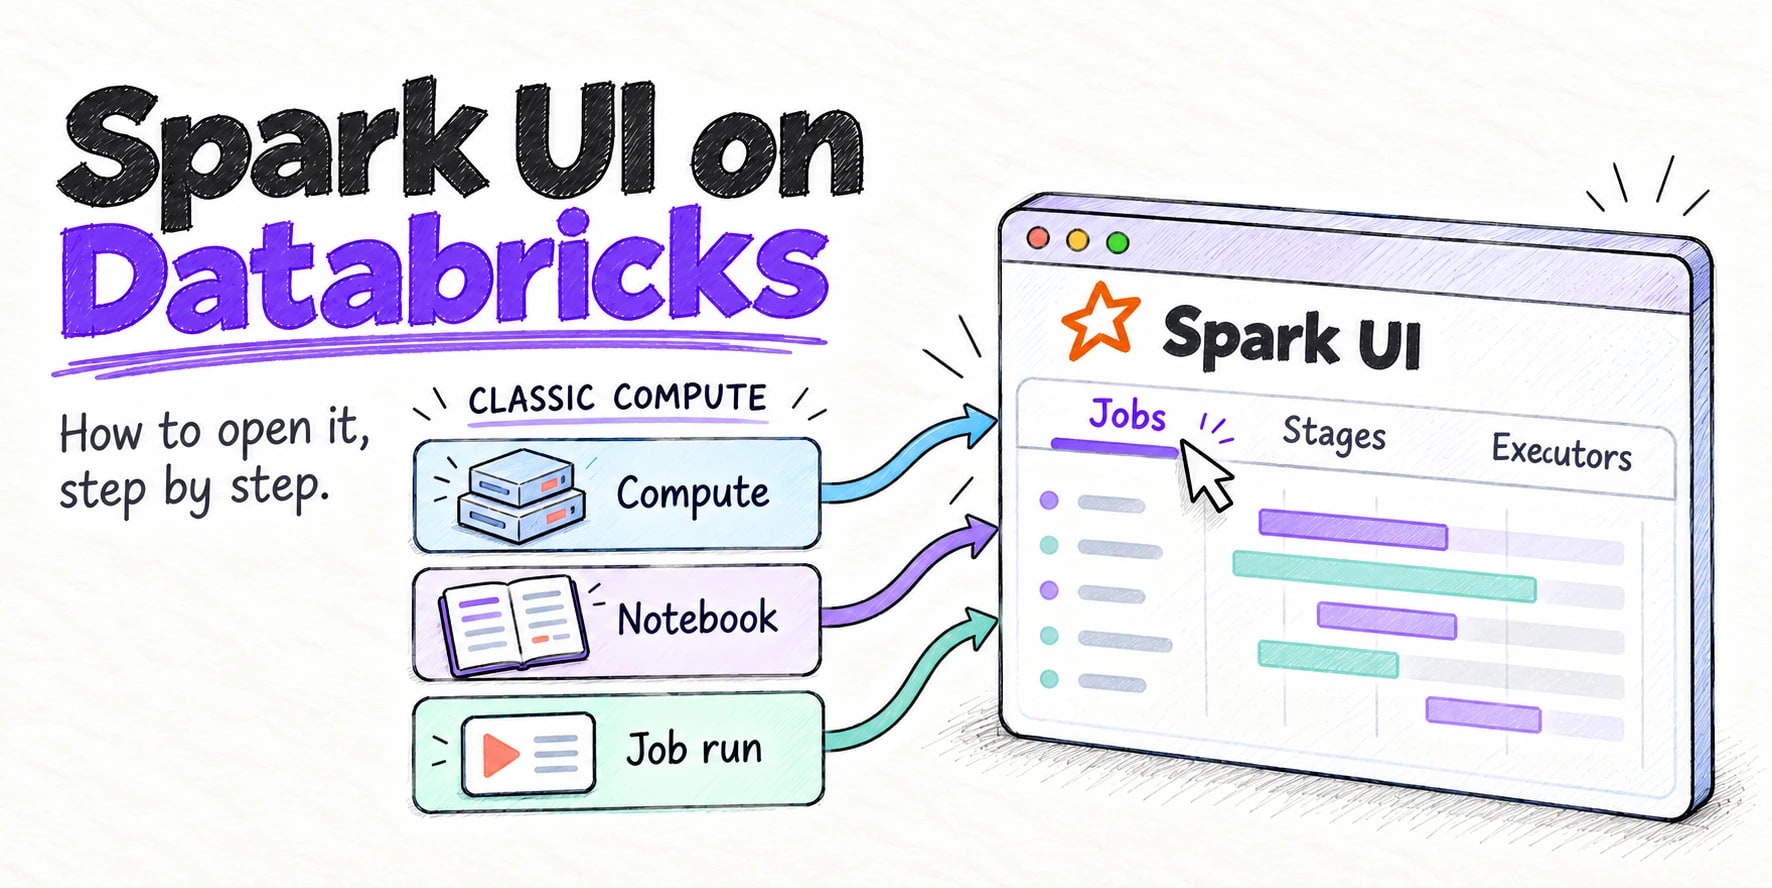
如何在 Databricks 上访问 Spark UI
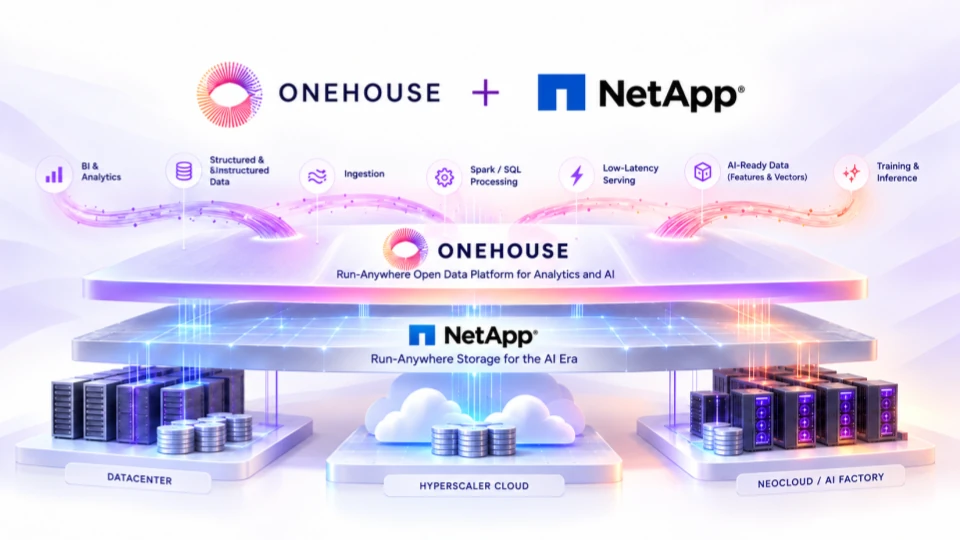
NetApp + Onehouse:跨数据中心、超大规模云和 Neoclouds,统一从 BI 到 AI 的数据
Lakegres:在现有 Open/Hudi/Iceberg 表上进行向量搜索
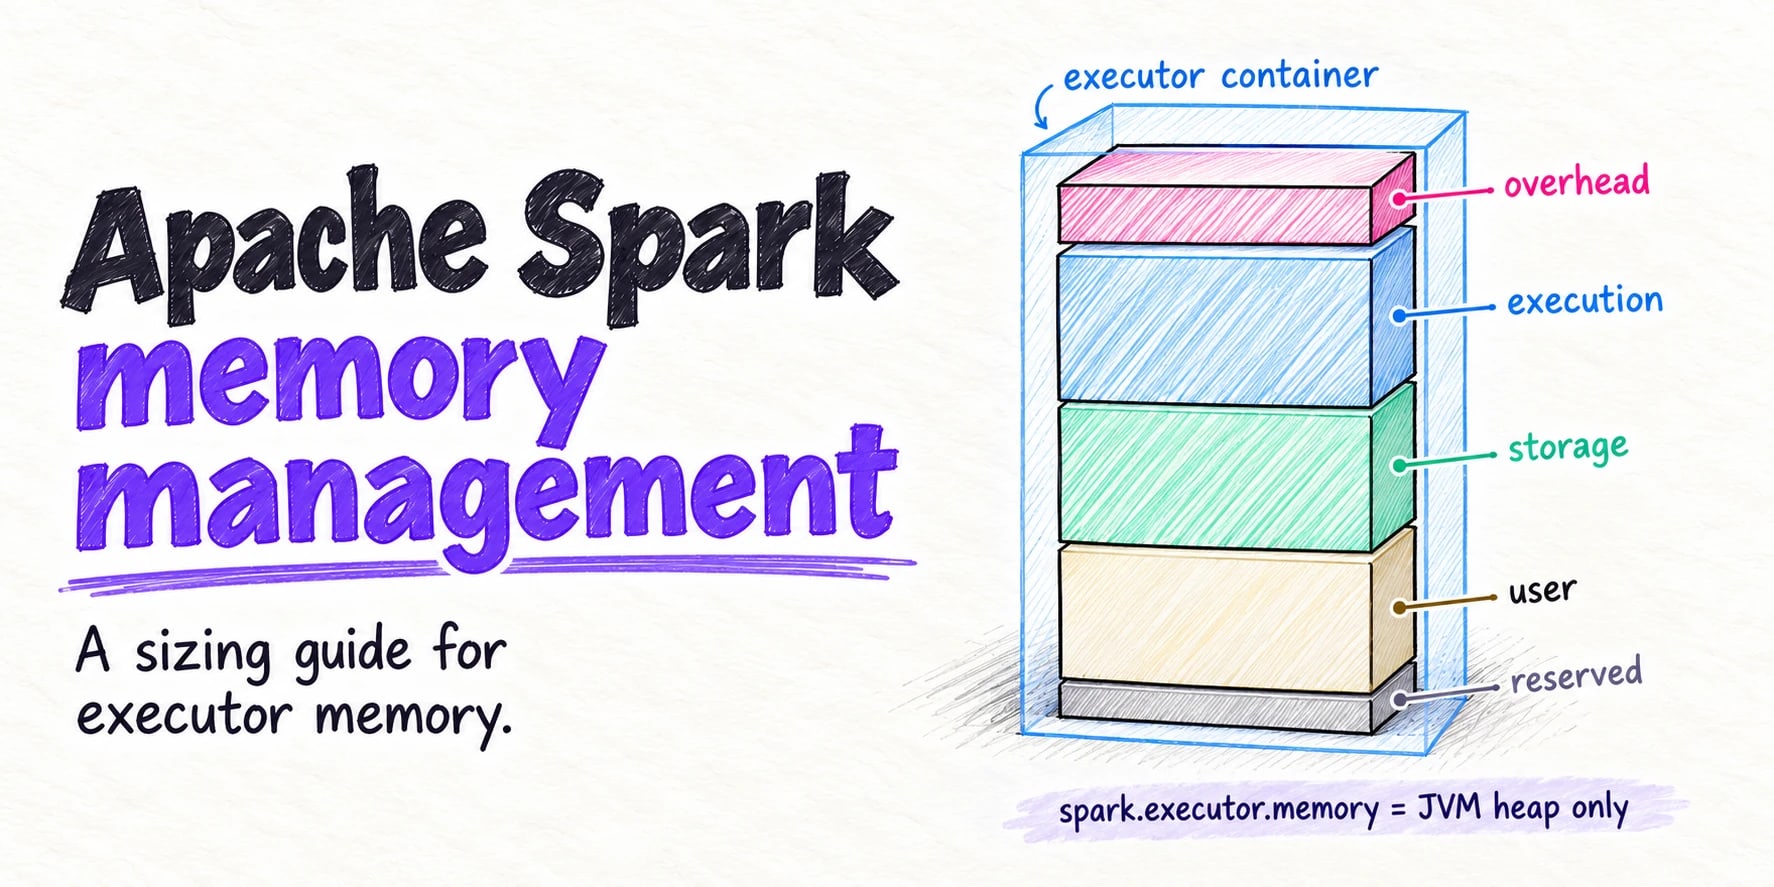
Spark 内存管理:executor 内存容量规划指南
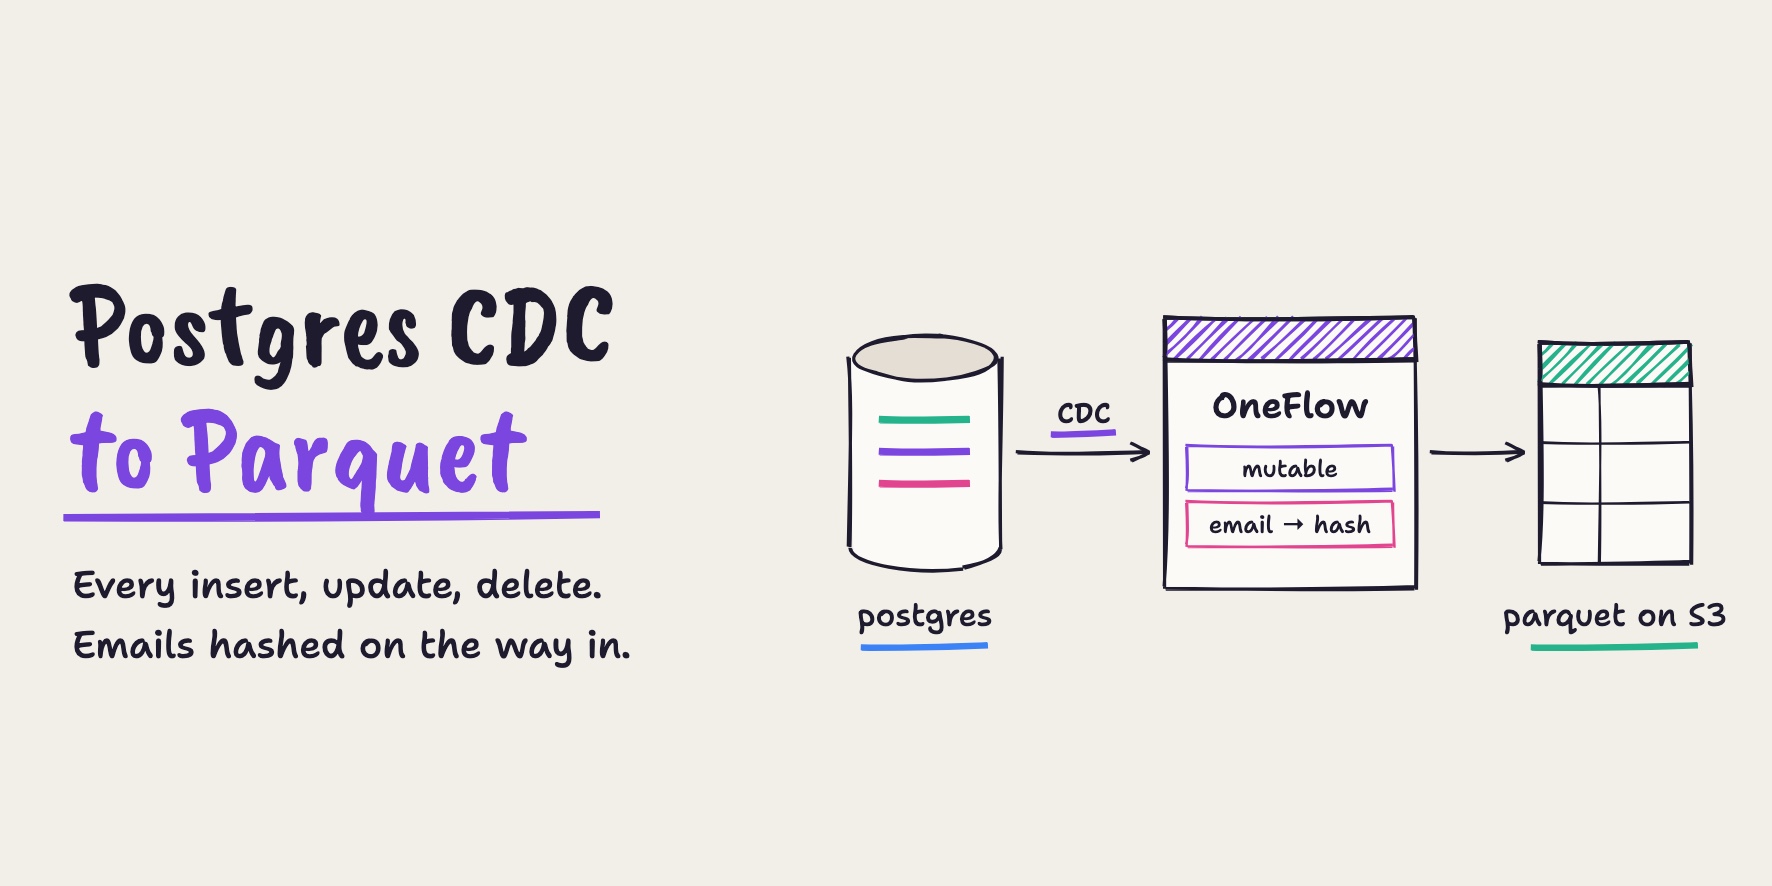
只需几次点击,即可将 Postgres CDC 数据写入 S3 上的 Parquet 表,并完成 PII 脱敏
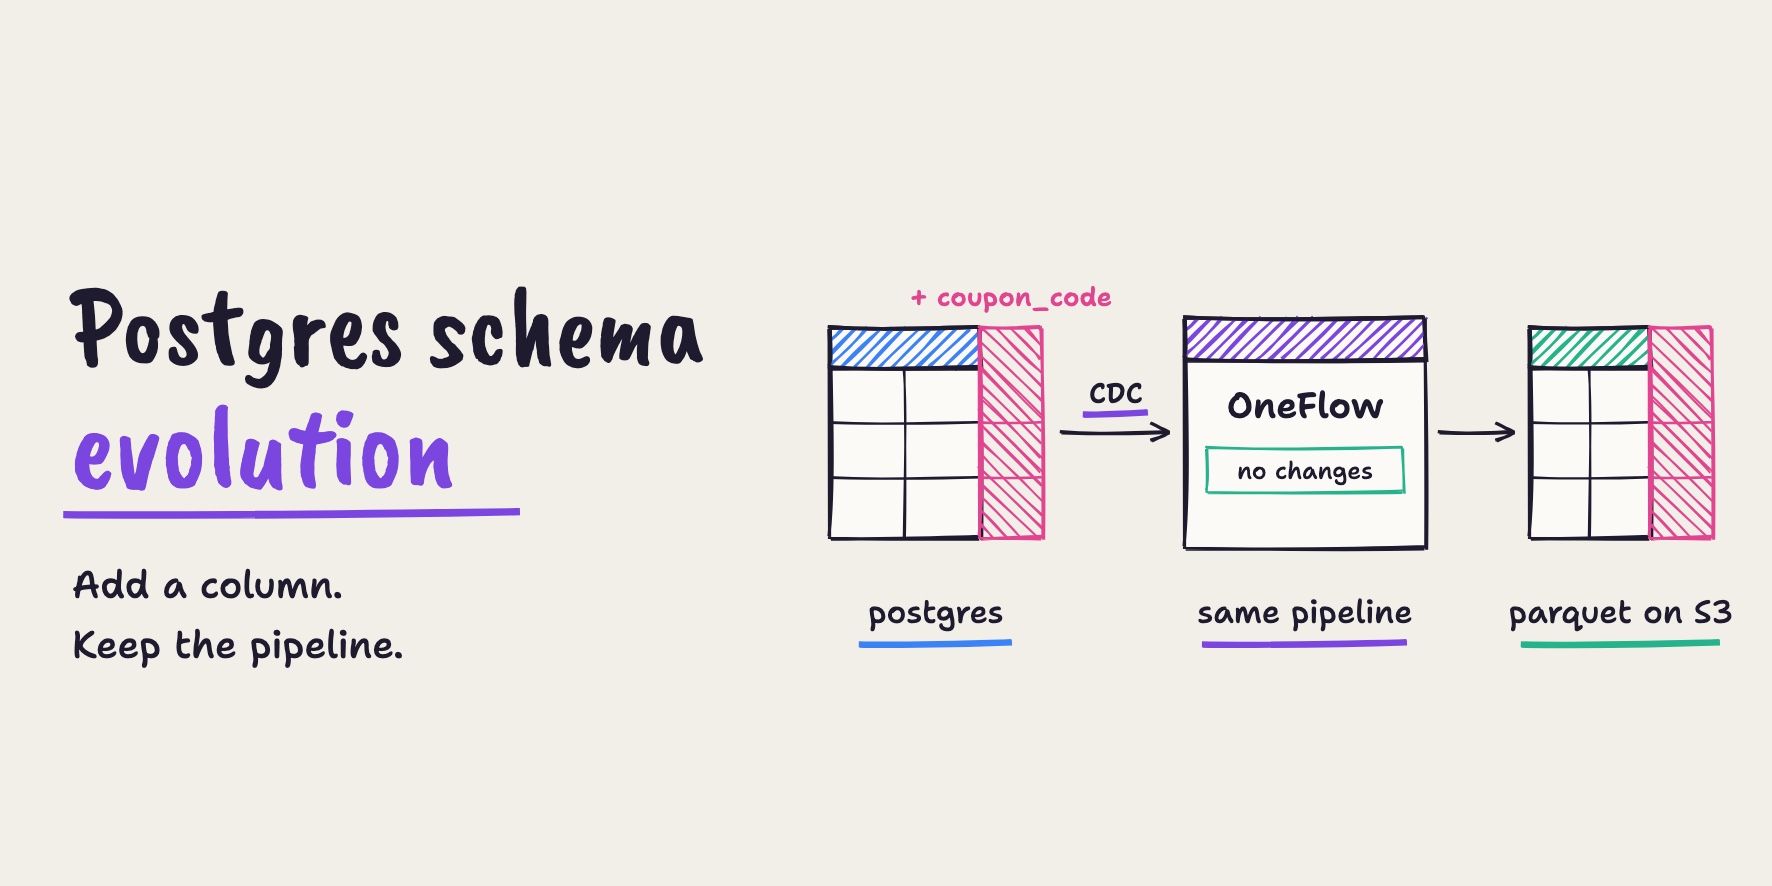
无需改动管道即可完成 Postgres schema 演进
2026 年最佳 Spark 加速器对比
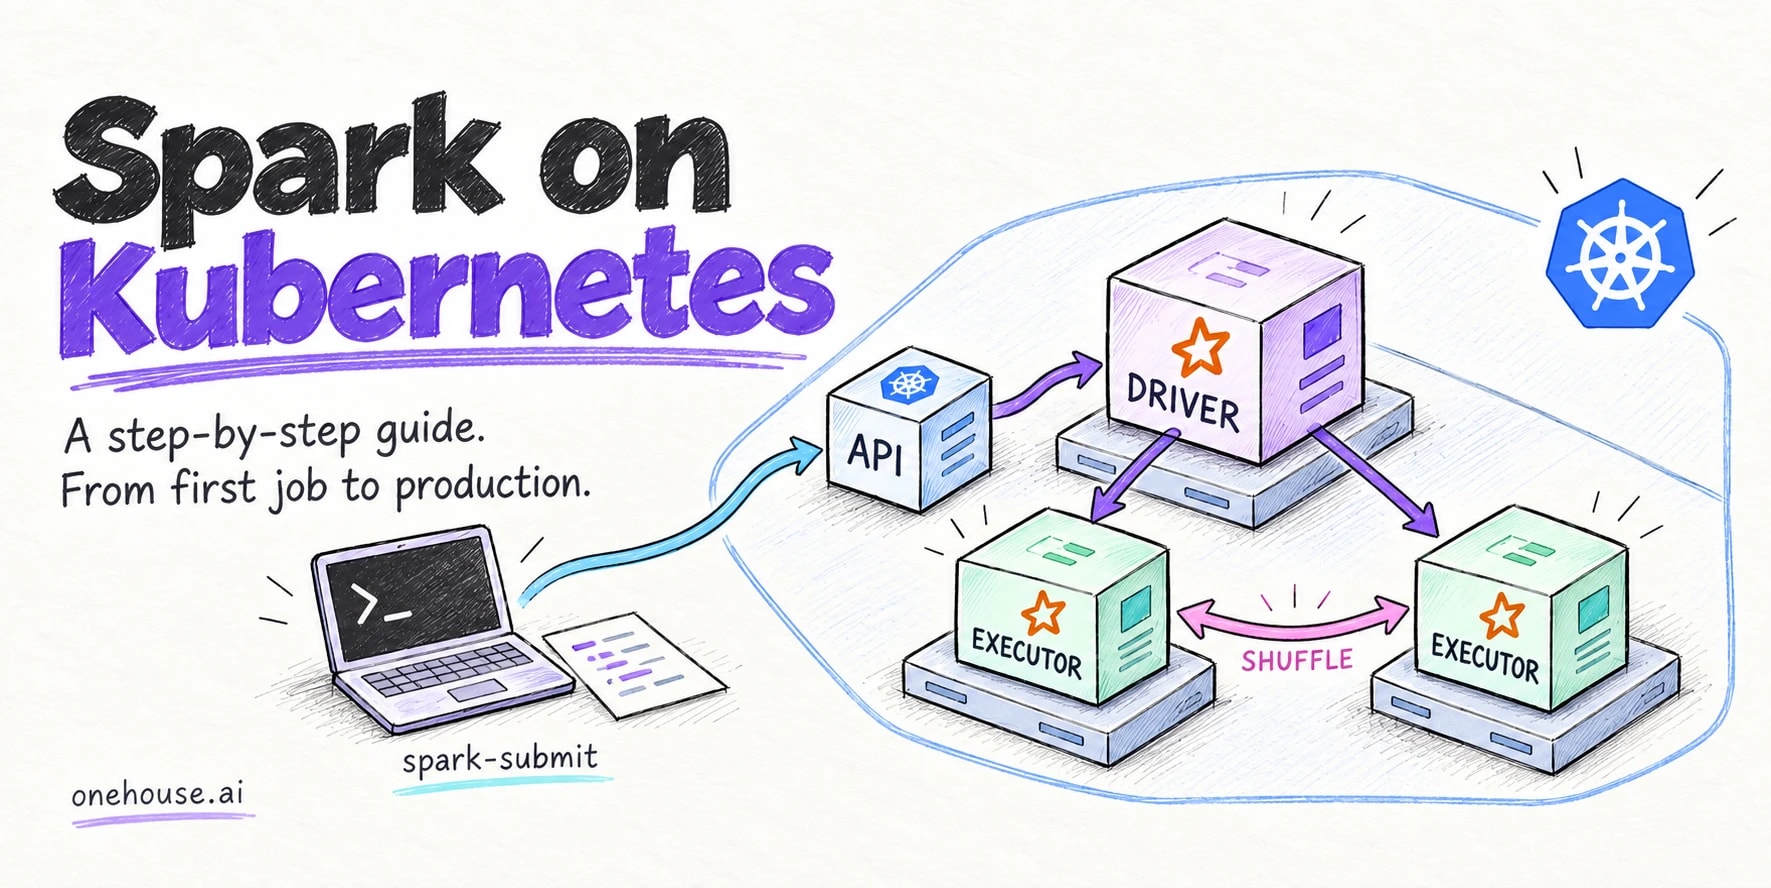
如何在 Kubernetes 上运行 Apache Spark:分步指南