 Newshot
GPT-6.2 Astra 刚发布即遭大量差评,实测后我觉得它有点冤
2026-11-18 10:39
OpenAI 可能没想到,自己精心准备的新模型,刚刚发布就迎来了一场颇为热闹的舆论风波。
今天凌晨,OpenAI 正式发布 GPT-6.2 Astra 和 GPT-6.2 Sol,主打更强的专业工作能力、更高的 Token 效率,以及进一步降低的使用成本。
按照官方公布的成绩,新模型在编程、科研、专业办公、3D 设计等领域表现出色,部分任务的完成成本甚至降至上一代的三分之一以下。
而在首批开发者实测中,GPT-6.2 的评价却出现了明显分化。有人惊叹于它的 3D 生成能力和成本优势,也有人认为模型在复杂任务中表现糟糕,甚至专门写了一封长信向 OpenAI 投诉。
我们也那么 GPT-6.2 究竟表现如何?
GPT-6.2 登场,跑分更聪明、更便宜
此次发布的两款模型有着不同定位,其中 GPT-6.2 Astra 面向复杂专业任务,GPT-6.2 Sol 则更加注重效率与成本,覆盖日常办公、编程及多步骤 Agent 工作。
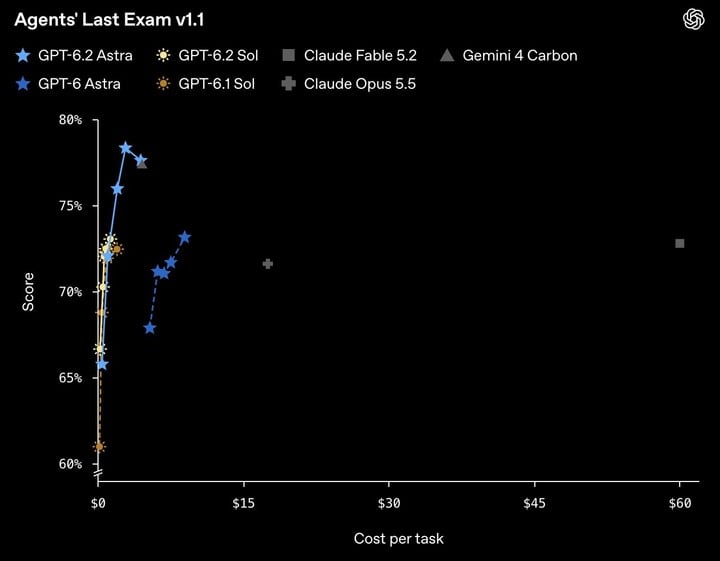
在衡量长周期、多步骤专业任务的 Agents’ Last Exam 测试中,GPT-6.2 Astra 比上一代高出 5.2 分,完成任务的成本却不到后者的三分之一;与 Claude Fable 5.2 相比,它领先 5.5 分,任务成本仅为对方的 5%。
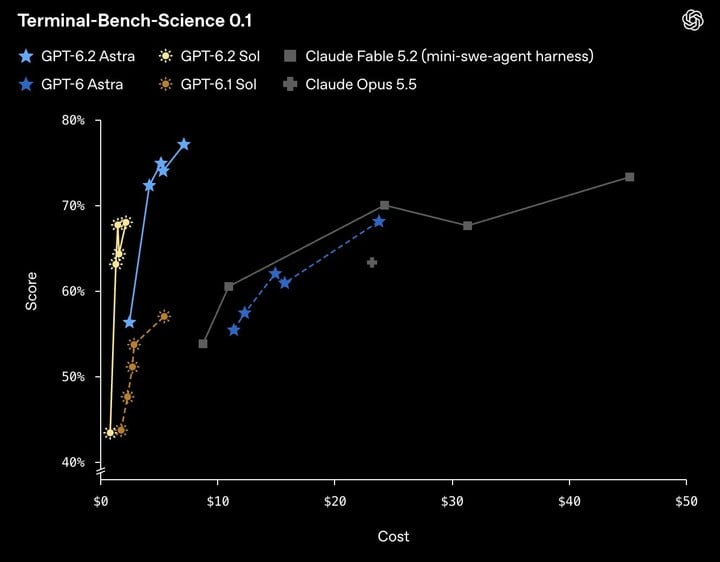
科研能力同样获得提升。在 Terminal-Bench-Science 0.1 测试中,Astra 的成绩比上一代提高 9 个百分点,OpenAI 甚至宣称,这是目前最适合科学家的模型。
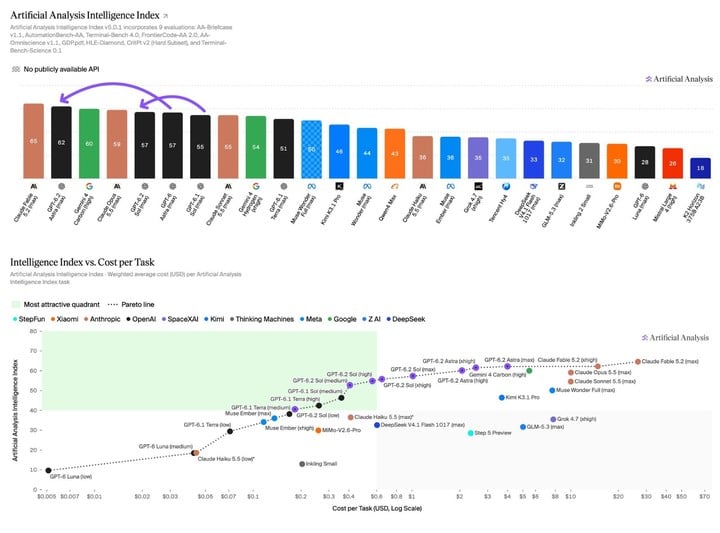
第三方评测机构 Artificial Analysis 的结果也提供了一个参照,GPT-6.2 Astra 在综合智能指数中排名第二,仅次于 Claude Fable 5.2,但在 Coding Agent 指数中与上一代持平,GPT-6.2 Sol 反而下降了 3 分。
相比单纯刷新 Benchmark,此次发布更值得关注的变化,是 OpenAI 开始重点展示模型如何完成真实工作。
比如给 Astra 一张 PPT 截图,它就能模仿原有的布局、字体和配色制作新页面;交给它财务报表,它还能生成包含收入预测、估值分析的 Excel 工作簿。
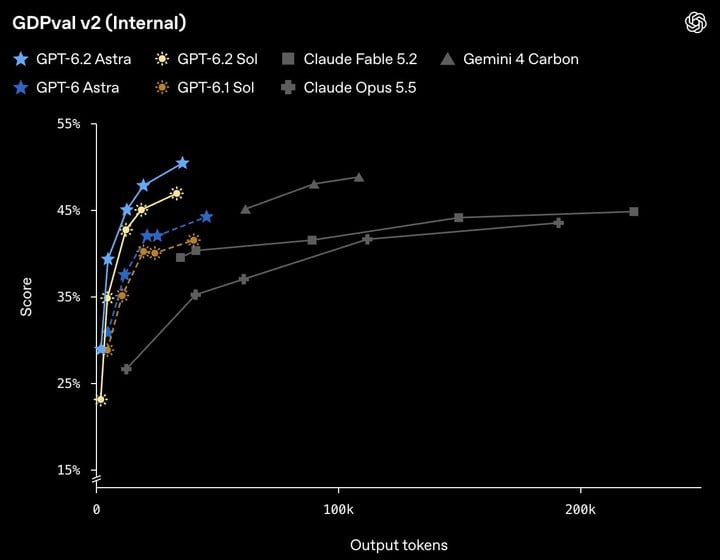
在 OpenAI 内部 GDPval v2 评测中,Astra 比上一代提高了 6.2 个百分点,输出 Token 减少 22%;在 Harvey LAB-AA 法律工作评测中,其任务通过率超过 Claude Fable 5.2 的两倍,成本约为后者的六分之一。
更令人意外的,是 GPT-6.2 在 3D 设计和机械工程领域的进步。
OpenAI 展示了 Astra 在 Blender 中模拟汽车悬架运动、制作遥控赛车装配动画,以及根据芝加哥 Marina City 大楼的阳台设计实体纸灯等案例。
在 Artificial Analysis 的 AA-3D 评测中,Astra 以 1318 Elo 排名第一,较上一代提高了 150 Elo 分,领先 Claude Fable 5.2 的 1271 Elo。
社交平台上的首批实测,也让这种进步变得更加直观。
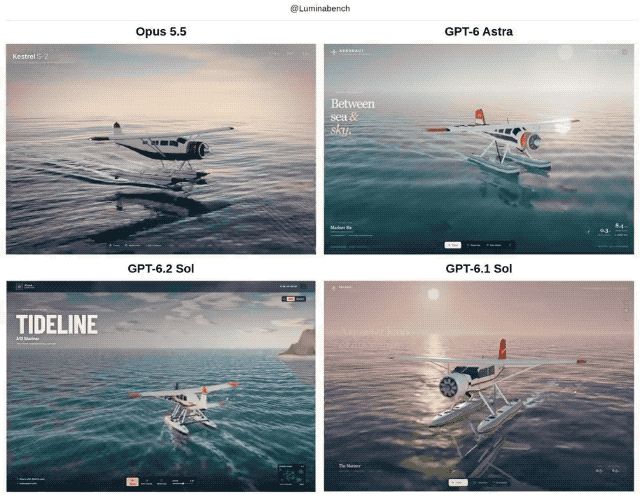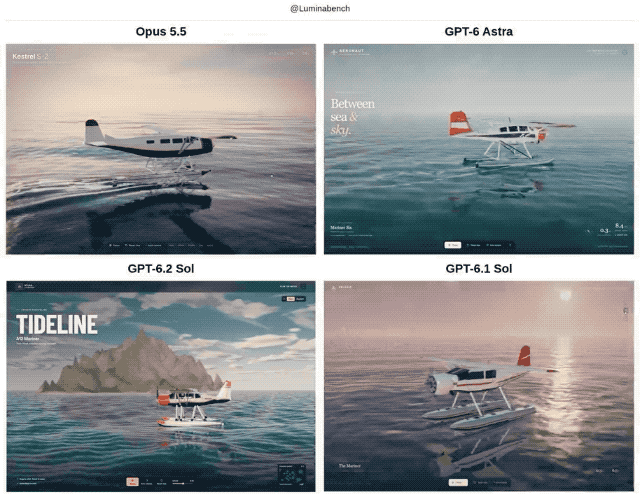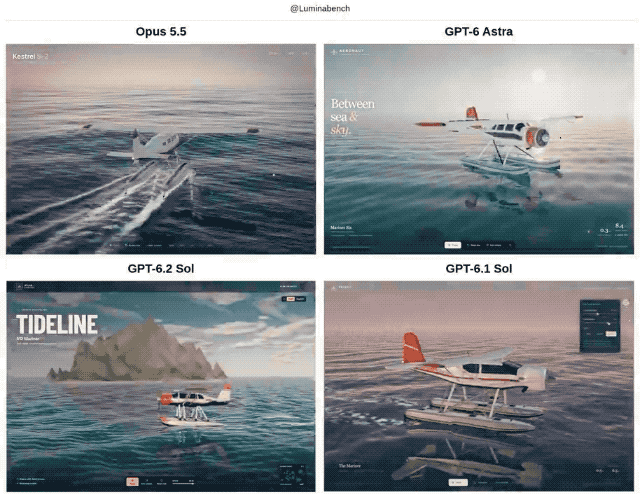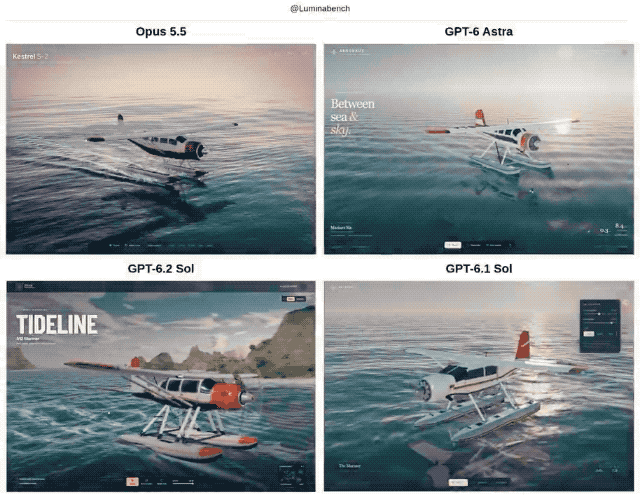
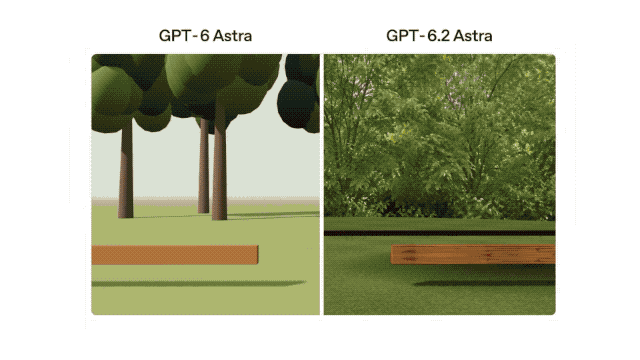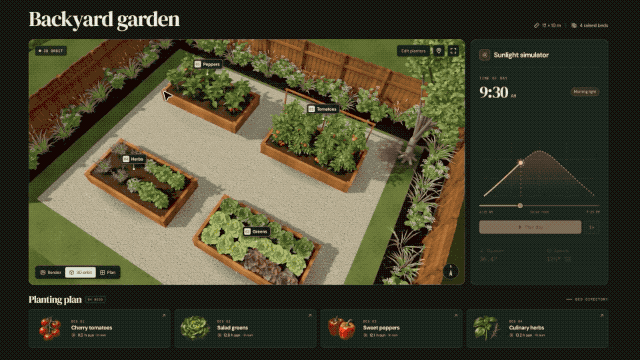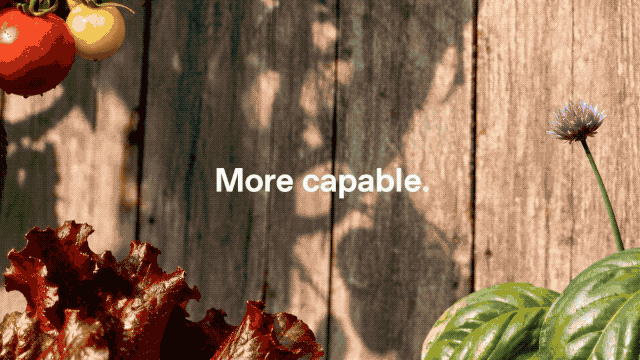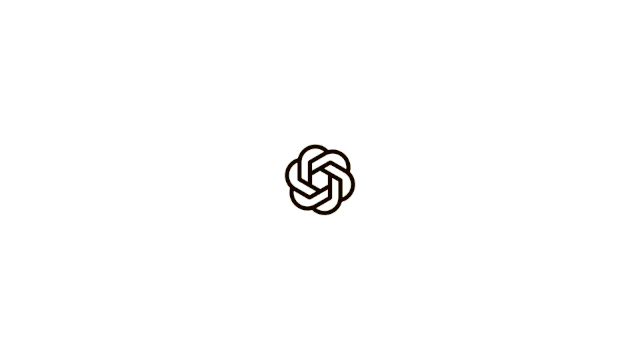
LuminaBench 在相同提示词测试中发现,GPT-6.2 Sol 生成的 3D 水上飞机场景相比 6.1 Sol 明显进步。
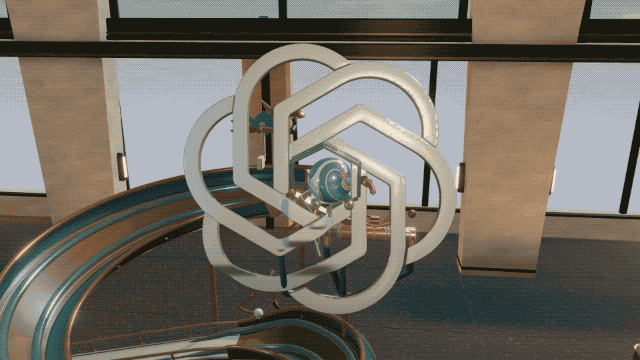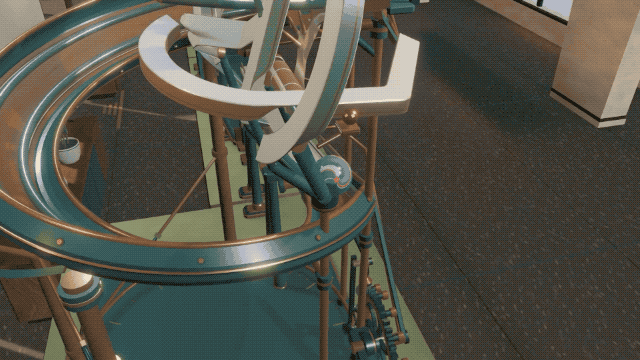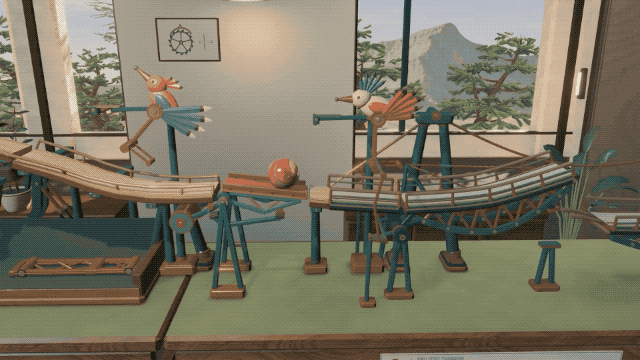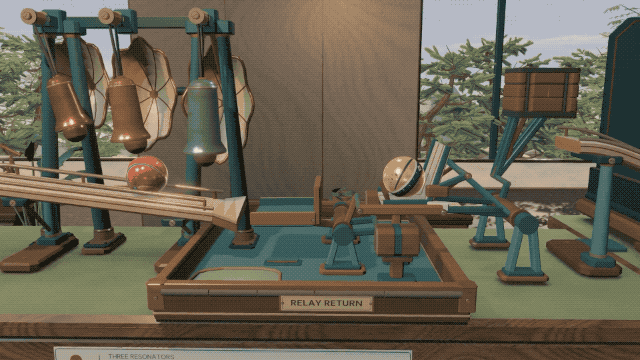
开发者 eric provencher 展示了 Astra 根据参考图制作的精细 3D 演示程序,还能直接通过 WebGPU 在浏览器中运行;
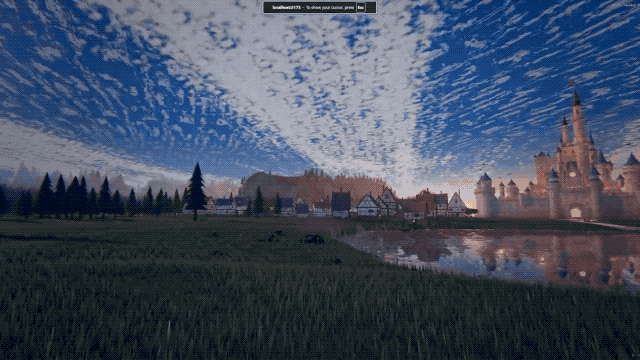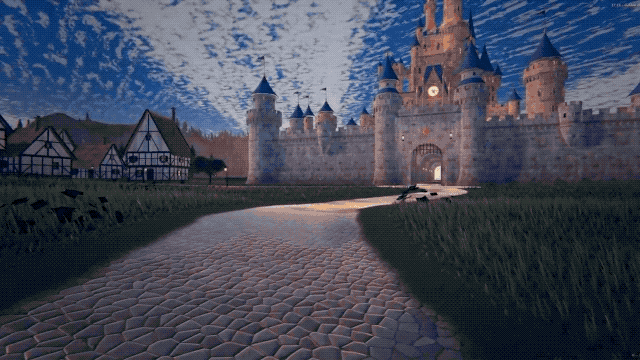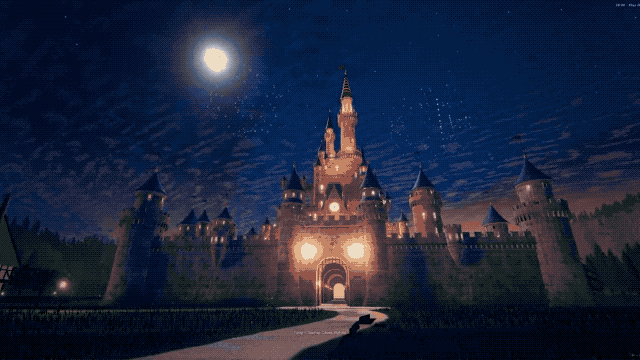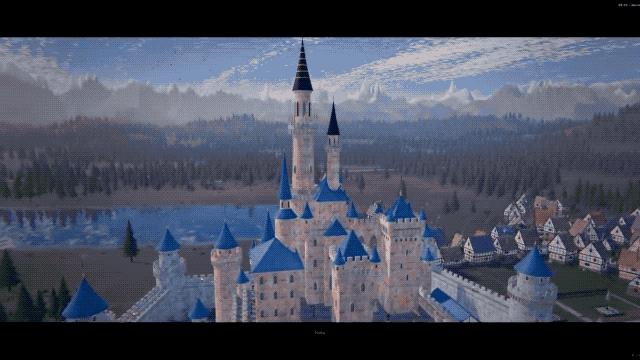
Synopsis 则用它搭建了接近真实、可步行的迪士尼灰姑娘城堡,连烟花、水面纹理和船只场景都颇为逼真。
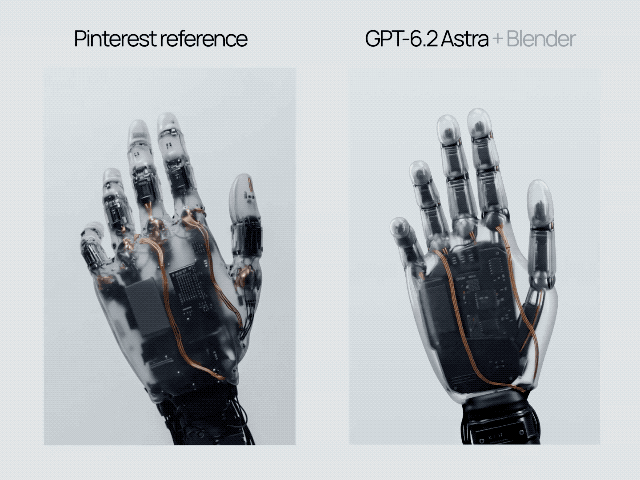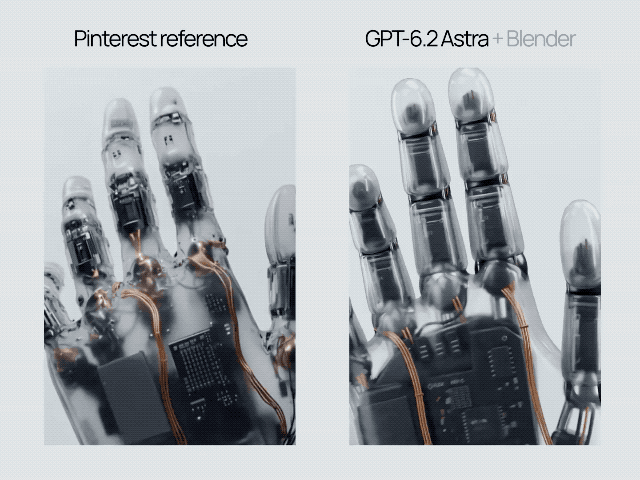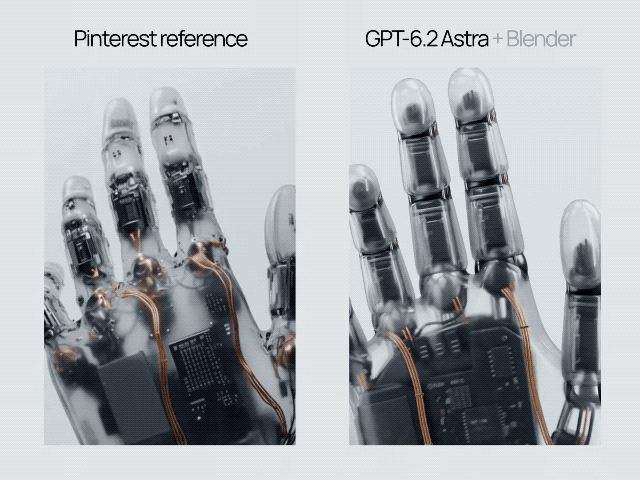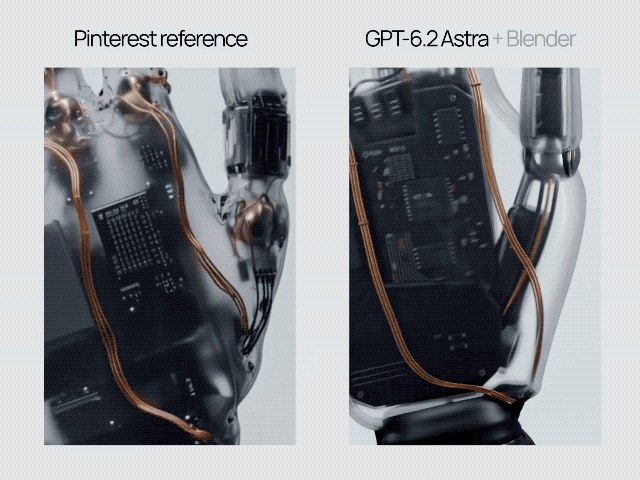
不过,AmirMušić 在测试 Astra 配合 Blender 制作机械手模型和动画后认为,实际效果尚可,但距离惊艳还有不小差距。
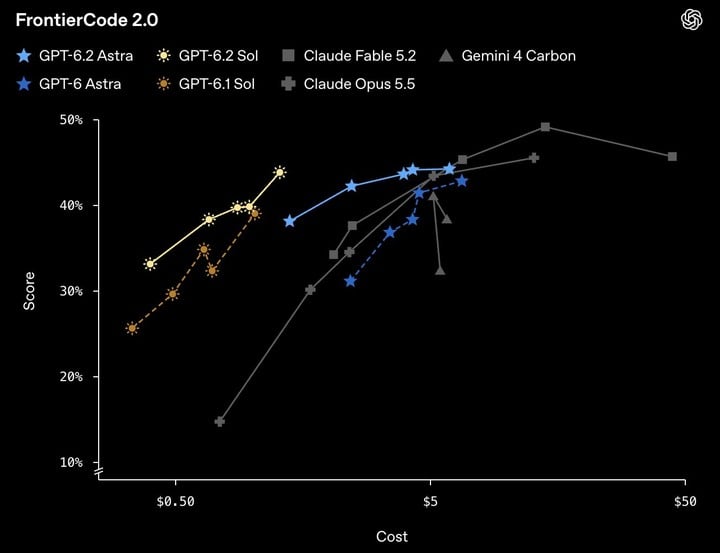
至于主打效率的 GPT-6.2 Sol,在 FrontierCode 2.0 编程测试中,与 Astra 的成绩仅相差 0.5 分,成本却只有约五分之一。
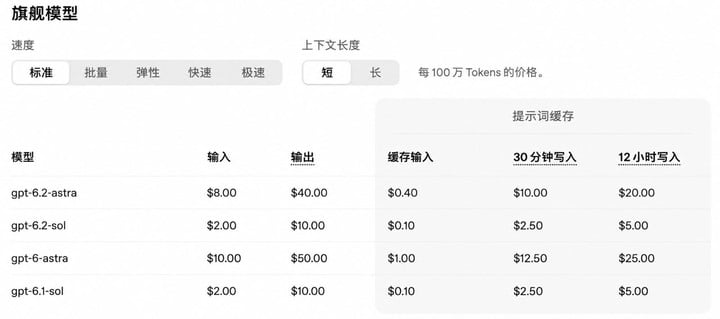
价格方面,GPT-6.2 Astra 的 API 输入和输出价格比上一代下降 20%,缓存输入下降 60%,每百万 Token 的输入、缓存输入及输出价格分别为 8 美元、0.4 美元和 40 美元。
GPT-6.2 Sol 则保持上一代价格,每百万 Token 输入 2 美元、缓存输入 0.1 美元、输出 10 美元。
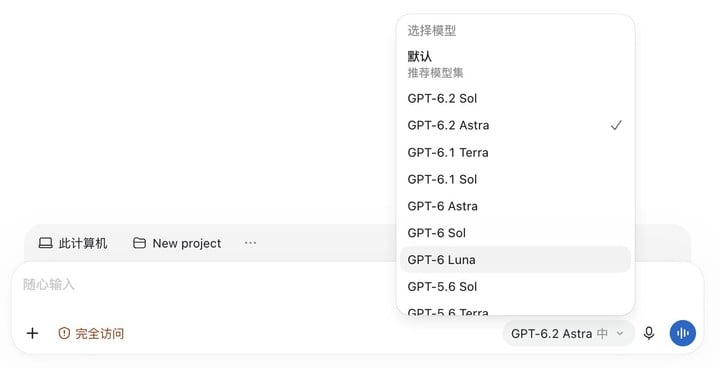
目前,两款模型已向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,同时上线 API,Ultrafast 模式也首次向 Pro 200 用户开放。
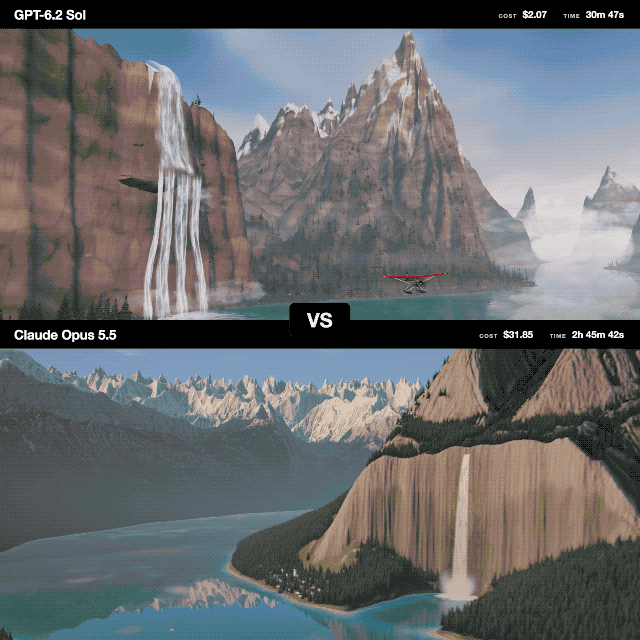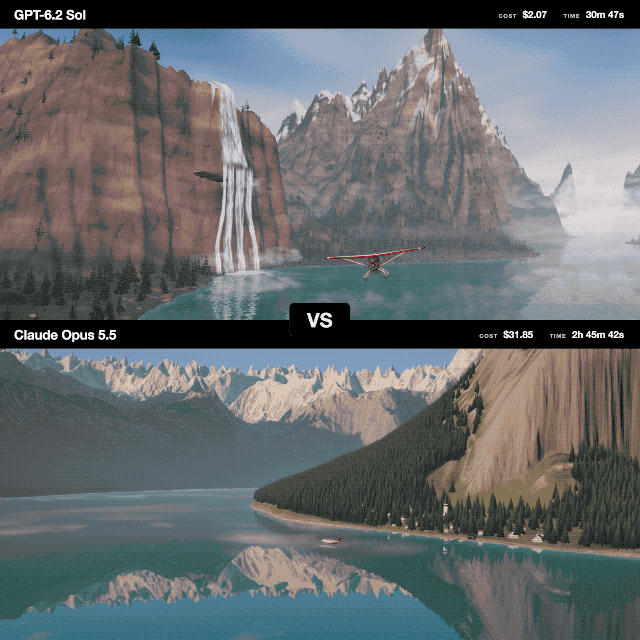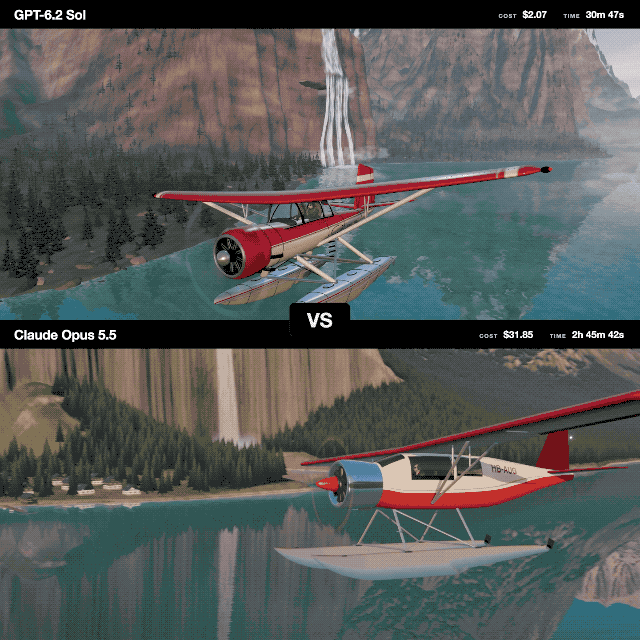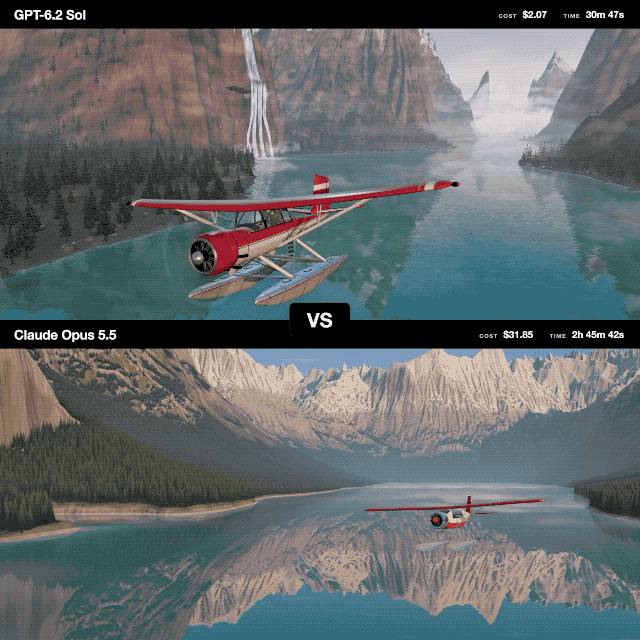
实际测试中的成本差异同样明显。
开发者 Tony 在相同高山水上飞机提示词下,使用 GPT-6.2 Sol 耗时约 31 分钟、花费 2.07 美元,而 Claude Opus 5.5 耗时约 2 小时 46 分钟、花费 31.85 美元。
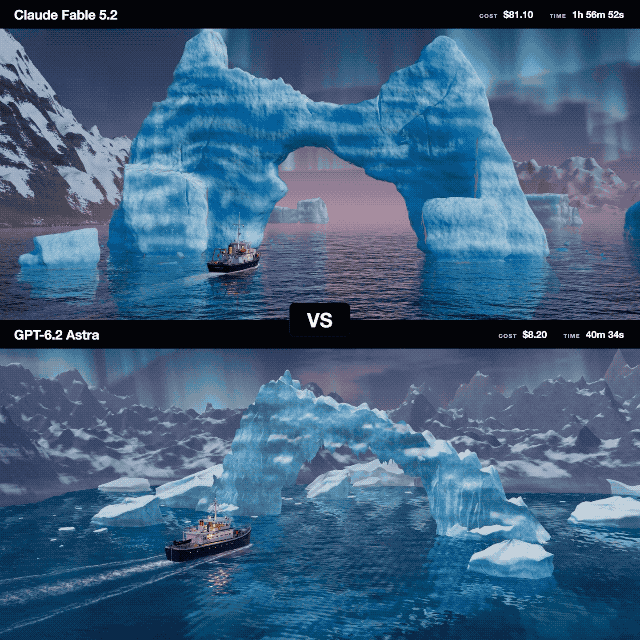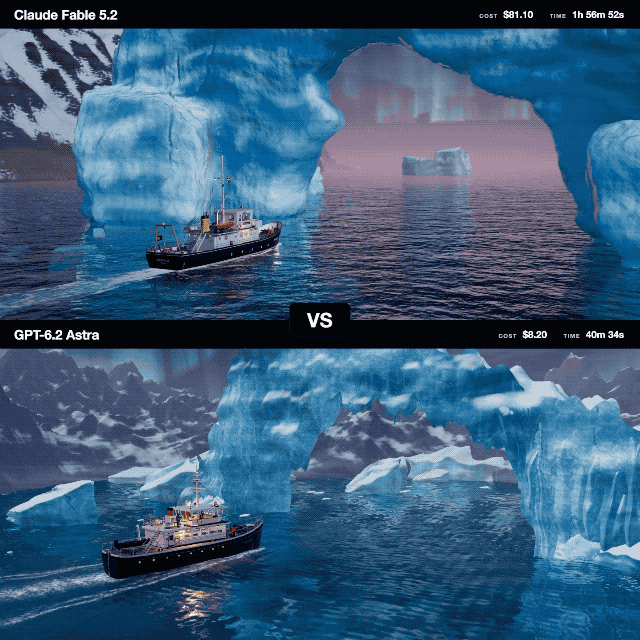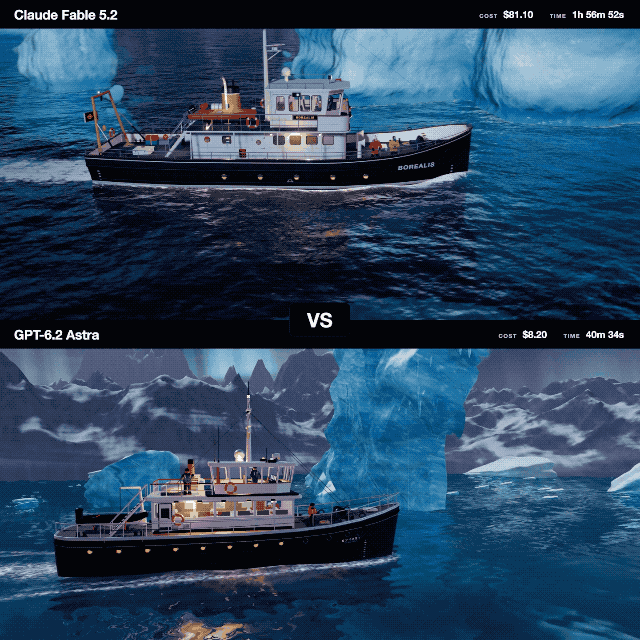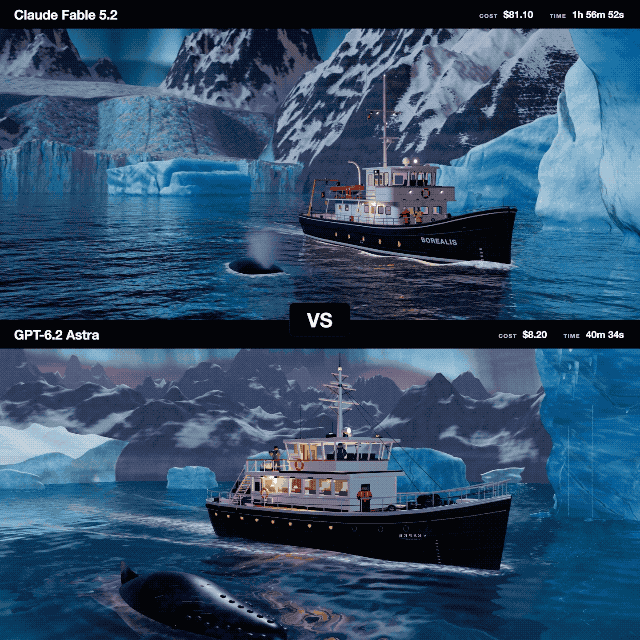
在另一组冰川渔船场景中,Astra 以 8.20 美元、约 41 分钟完成任务,Claude Fable 5.2 则花费 81.10 美元和近两小时。
从专业工作到 3D 设计,再到价格,OpenAI 交出了一份相当漂亮的成绩单,但开发者的实际使用体验,却远比跑分呈现得复杂。
最聪明的 AI,未必是你最想用的 AI
GPT-6.2 上线后,几位提前获得体验资格的知名开发者,接连表达了失望。
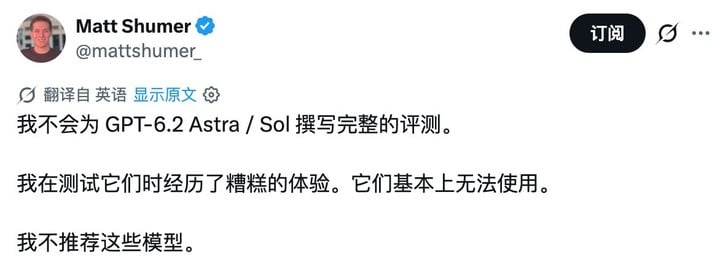
AI 开发者 Matt Shumer 在 X 平台直言,自己不会对 GPT-6.2 Astra 和 Sol 进行完整评测,因为此前的测试体验实在太糟糕,两款模型基本无法使用。
Every 联合创始人 Dan Shipper 的团队也提前测试了数周,认为 GPT-6.2 的整体表现令人失望。
按照他的观察,Astra 在写作方面甚至不如上一代,过分追求简洁,导致需要详细解释的问题经常得到过短的回答;编程表现与上一代接近,却经常在真实项目中提前停止工作;设计方面虽然有不错的审美,却容易生成高度相似的作品。
批评最激烈的,还得是知名开发者 Theo。
他透露,自己因为 GPT-6.2 Astra 的表现过于糟糕,专门花了一整天给 OpenAI 写投诉信。模型经常在长期任务中突然暂停,询问用户内部文件该如何命名等无关紧要的问题,还曾在一个 TypeScript 转 Rust 项目中连续运行 11 天,没有取得有效改进,反而一度让编译器运行速度下降了 56%。
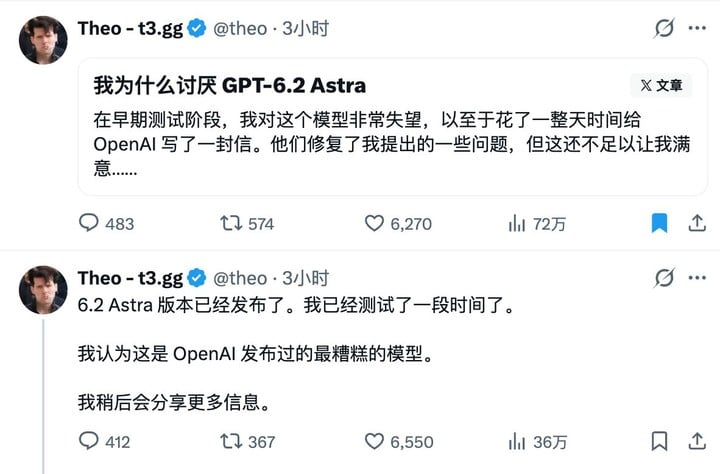
更让 Theo 头疼的是,Astra 经常能写出不错的代码,却无法清楚解释自己做了什么。
有一次,他询问某台电脑为什么运行缓慢,Astra 给出四段复杂的技术分析,而 Claude Opus 5.5 直接指出原因是 SSD 太慢,如今他甚至习惯让 Claude 帮忙解释 Astra 的工作结果。
颇具讽刺意味的是,Theo 也承认 Astra 在代码审查、3D、游戏开发和计算机操作方面表现出色,甚至曾帮他设计出一套预计每月节省 2.5 万美元的反向代理方案,但这些优势依然不足以让他将其作为日常开发工具。
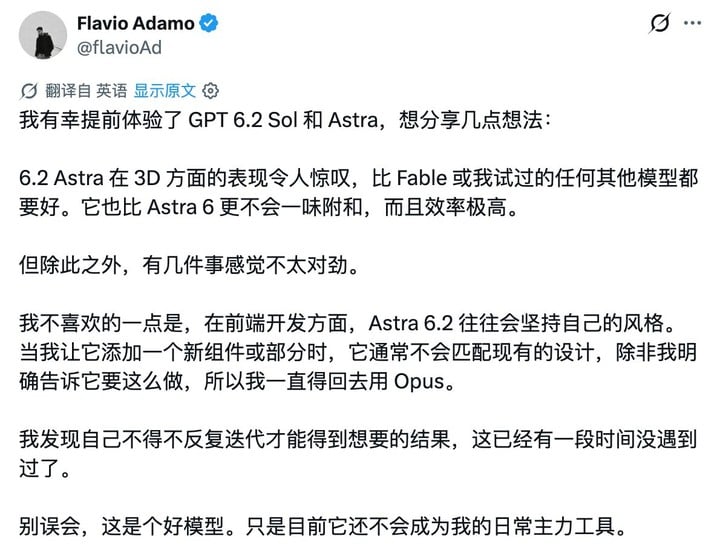
开发者 Flavio Adamo 也认为,Astra 的 3D 能力非常优秀,但在前端开发中经常擅自采用自己的设计风格,无法自然延续现有项目的视觉规范。
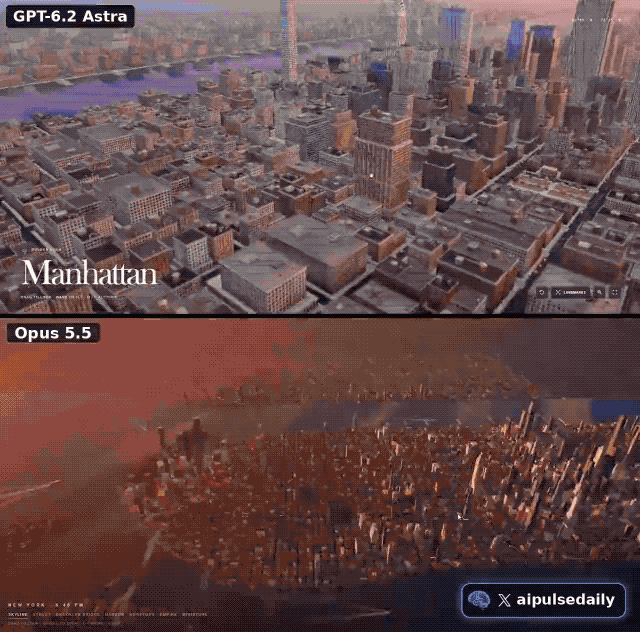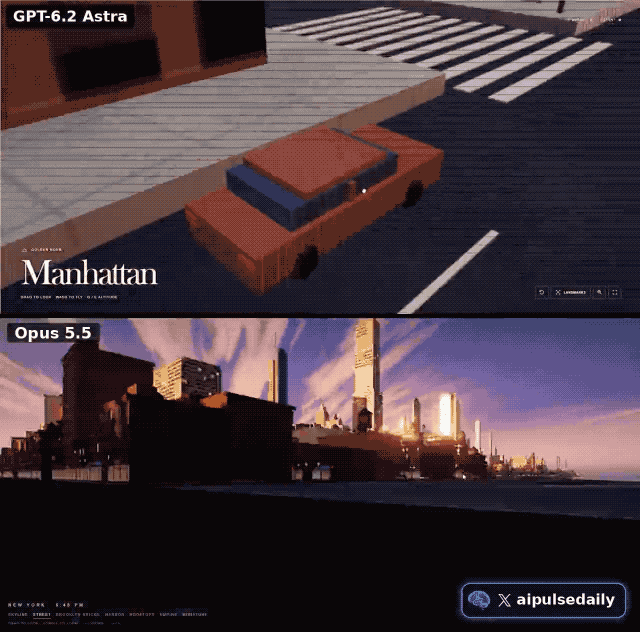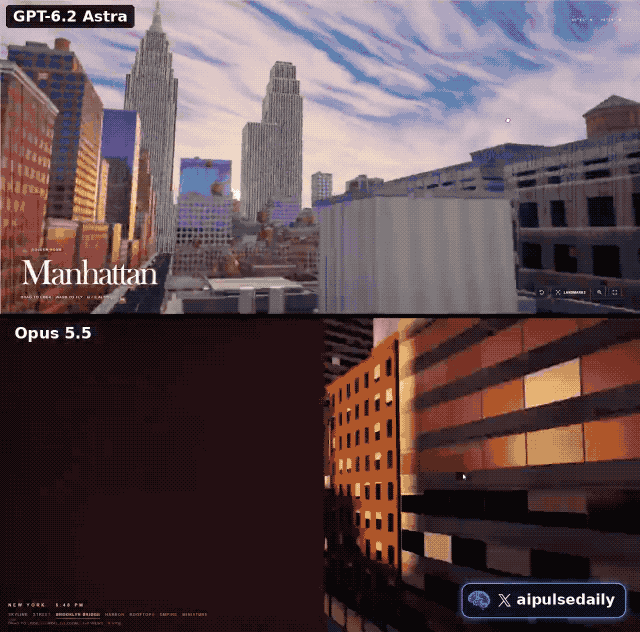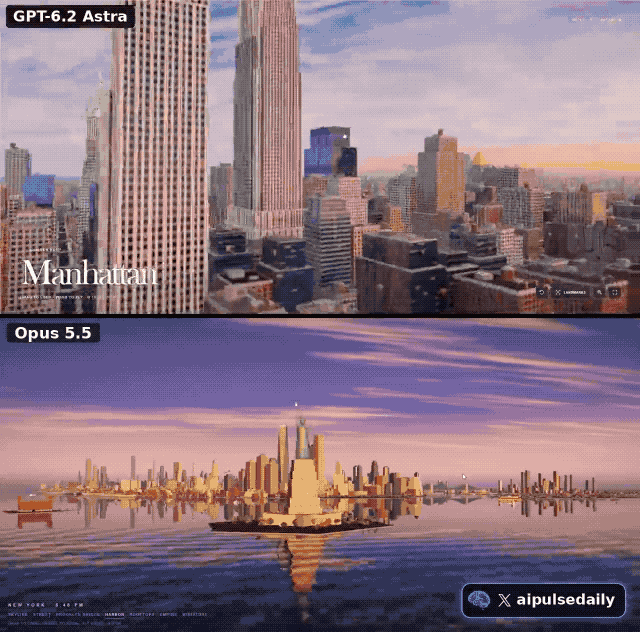
类似问题也出现在更多实测中。aipulsedaily 在曼哈顿 3D 场景测试后表示,Astra 虽然能够完成场景,但速度极慢,镜头移动迟缓,其他任务中也经常不够配合,因此正式工作仍会优先使用 Opus 和 Fable。
几位开发者的批评集中在相似的问题上,包括长期任务异常中断、执行偏离目标、沟通解释困难,以及对用户要求的遵循不足。
不过,提前体验者 Pietro Schirano 提出了不同看法,认为不少问题来自外围 Agent 执行框架 Harness,移除相关框架后,Astra 的表现明显改善。
OpenAI 自己也在官方博客中承认,在两项对齐测试中,新模型更容易遗漏妨碍任务完成的重要信息,例如文件缺失、搜索工具无法使用等,目前已通过调整 Codex 指令改善相关行为。
看完这些褒贬不一的评价,我也拿 GPT-6.2 做了三组测试,依旧分别是第三人称水下探索游戏、动画风乡村骑行体验,以及基础 WebGL 交互场景,重点考察模型对复杂需求、3D 场景搭建和交互逻辑的处理能力。
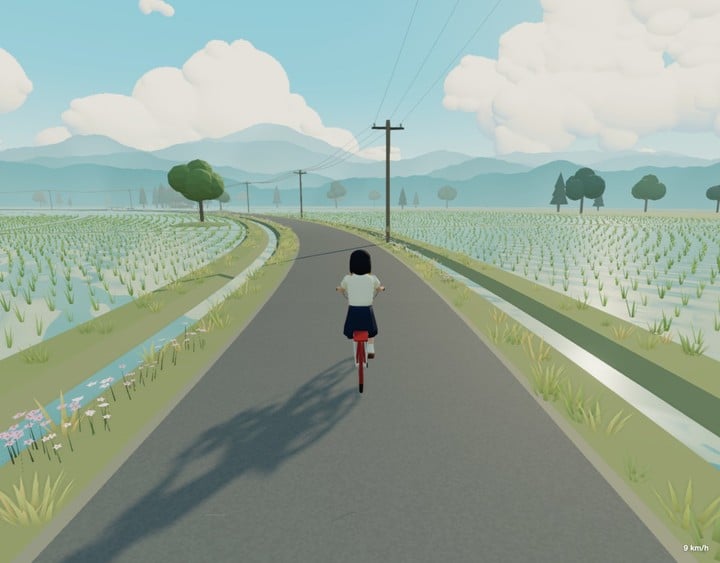
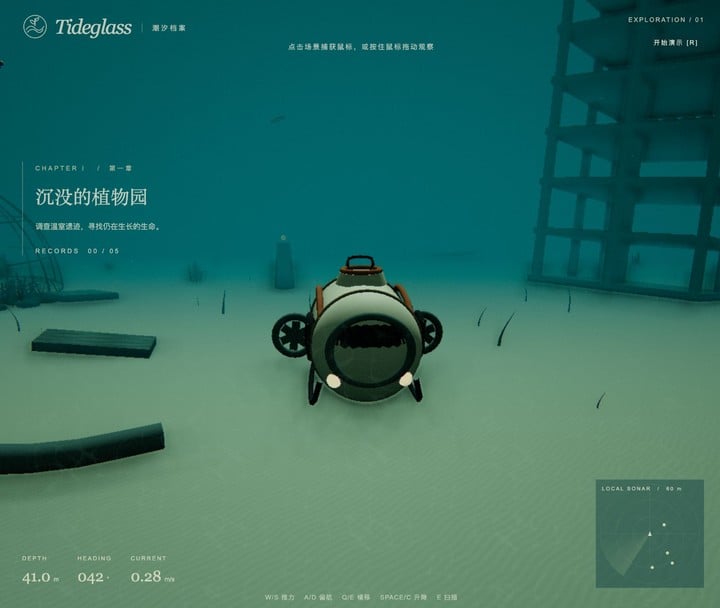
三个项目覆盖了从基础图形开发到复杂交互场景的不同需求,但从我的体验来看,GPT-6.2 的表现远没有网上所说的那么糟糕,首发后的舆论更像是差评的声音被集中放大了。
究其原因,随着 Agent 开始参与软件开发、专业设计和科研工作,一次任务可能持续数小时甚至数天,模型需要自行规划、调用工具并处理障碍,任何一次错误判断,都可能让用户付出额外时间和 Token 成本。
Theo 遇到的文件命名问题,对于普通聊天来说只是无关紧要的提问,但对于已经运行两个小时的 Agent,却意味着任务被迫中断。
同样,模型持续消耗 Token 改善程序体积,却忽略用户希望提升的性能,也说明自主执行能力越强,错误决策的代价可能越高。
尤其值得注意的是,OpenAI 此次反复强调 GPT-6.2 的成本优势,但真实项目的花费,还取决于模型能否准确理解目标、减少重复操作,并交付符合要求的结果。
单次推理价格降低,整个项目却可能因为反复试错变得更加昂贵。
另一方面,随着模型能力逐渐多元化,单一场景的表现也越来越难以代表一个模型的整体水平。
同样是 GPT-6.2 Astra,它可以在 3D 生成中取得令人惊艳的成绩,也可能在长期编程任务中反复兜圈子;有人觉得它的交互体验令人抓狂,也有人认为它的成本效率足以改变自己的工作流程。
不同任务对模型能力的要求本就不同,用户对模型好坏的判断,自然也会出现分歧。
GPT-6.2 的争议,恰好反映出大模型竞争正在发生的变化。
过去几年,模型厂商不断尝试证明自己的 AI 比竞争对手更聪明,如今随着 Agent 进入真实工作流程,用户开始更加关注它能以怎样的效率、成本和可靠性完成任务。
对于普通用户而言,与其被社交平台上最激烈的评价左右,不如把模型放进自己的工作场景中,看看它究竟能完成多少事情。最聪明的模型,未必是最好用的模型;最好用的模型,也未必需要证明自己最聪明。