 Newshot
主要
Pokkesviricetes 是 Nucleocytoviricota 门中一类真核病毒,具有大型、线性双链 DNA 基因组。该纲分为两个目:Chitovirales(痘病毒)和 Asfuvirales10。痘病毒可感染包括人类在内的广泛动物11。它们包括已被消灭的天花病毒、仍会零星感染人类的猴痘病毒,以及在免疫功能低下个体中引起良性肿瘤的传染性软疣病毒,还包括分子病毒学的经典模型痘苗病毒12,13,14。Asfuviruses 感染从单细胞真核生物到动物的宿主15,包括在猪和野猪中引起致命且具有重要经济意义的暴发的非洲猪瘟病毒16,以及更广泛的一类病毒,这些病毒大多是在与自由生活变形虫共培养时15,17,或利用基因组解析宏基因组学直接从环境(例如浮游生物)中6,18,19得到表征。除了世界卫生组织宣布的少数全球关注病毒外,Pokkesviricetes 纲对于我们理解真核 DNA 病毒、尤其是动物 DNA 病毒的多样性、生态和演化具有重要意义20,21。
导致感染动物的痘病毒出现的核质病毒演化轨迹仍不清楚。动物大约在 7 亿年前出现22,并携带多种共生单细胞真核生物,这些生物大多居住在其消化系统中23,24,25,是痘病毒祖先宿主的首要候选者。实际上,从单细胞真核生物到动物的宿主转换,会因一段持久的密切相互作用时期而大大促进,这种相互作用使单细胞真核生物得以适应动物的内部环境。然而,数十年来利用培养、PCR 调查、血清学和宏基因组学进行的研究表明,核质病毒主要是短暂的,因此在人类和其他动物的消化系统中很少大量存在5,6,26。直到现在,尚未发现 Nucleocytoviricota 的任何一个类群普遍与消化系统相关或在其中流行,这与这些病毒在环境中的广泛分布和显著多样性形成对比4,6,27。由于没有证据表明核质病毒会系统地感染动物体内的单细胞真核生物,围绕痘病毒出现的早期步骤无法得到解释。
在这里,我们通过调查来自广泛环境样本和动物相关微生物组的数万个宏基因组组装,探索了 Pokkesviricetes 的全球多样性和分布。我们发现了一个第三个 Pokkesviricetes 目,并提议将其命名为 Egovirales。Egoviruses 具有大型基因组,并预测会形成多层二十面体衣壳。它们是痘病毒最近的亲属,并且几乎只出现在全球人类、家畜和野生动物的消化系统中。估计有一个 egovirus 种群存在于各大洲超过 1% 的人群中。在 Trichostomatia(纤毛虫)、Parabasalia(Metamonada,包括病原体 Trichomonas vaginalis)以及 Parabasalia 相关的 polintons(另一类整合到宿主基因组中的 DNA 病毒)的基因组中,鉴定出了 egovirus 核心基因的高度保守同源物28,这暗示 egoviruses 与
DNA依赖性RNA聚合酶是进化信息丰富的基因标记,存在于Nucleocytoviricota门的大多数病毒中,包括所有Pokkesviricetes10,29。我们使用针对最大RNA聚合酶亚基A(RNApolA)的综合隐马尔可夫模型29,30,搜索了85,123个宏基因组组装序列,涵盖广泛的环境样本以及来自人类、家畜和野生动物消化系统的数千个样本(补充表1)。该搜索鉴定出1,969,342个RNApolA基因,我们使用自定义参考数据库将其与主要细胞和病毒类群进行关联(方法)。在Pokkesviricetes中,我们鉴定出单个与Eptesipox关系最密切的痘病毒,存在于来自澳大利亚的一种有袋类食肉动物的肠道微生物组中31,以及240个仅存在于环境中的asfuviruses,主要存在于水生生态系统中(补充表1)。这些结果与目前对Pokkesviricetes全球生态位分化的认识一致,并与先前的宏基因组调查6,19一起,促进了环境中asfuviruses已知多样性的大幅扩展。
除痘病毒和asfuviruses外,我们还鉴定出一个先前未被描述的DNA病毒分支,与这两个病毒目相关,在消化系统中普遍存在,我们暂将其命名为egoviruses。我们从人类、水牛、山羊、鸡、鹿和猪的消化系统中表征了12个完整、非冗余的egovirus基因组(平均核苷酸一致性低于98%)。这些线性基因组长度为160–360千碱基(kb),含有55碱基对(bp)的反向末端重复序列,这是Pokkesviricetes32,33的特征。egovirus基因组包含全部八个Nucleocytoviricota标志基因10,29(补充表2),其中family B DNA聚合酶(DNApolB)编码区经常分裂为两个独立的开放阅读框,这与最近在mirusviruses34中发现的另一个关键基因(terminase)的反式剪接相呼应。我们为egovirus双jelly-roll主要衣壳蛋白(DJR-MCP)构建了隐马尔可夫模型,以补充RNApolA调查,并进一步扩大了对宏基因组中egoviruses的搜索。总体而言,我们在864个宏基因组组装序列中鉴定出egovirus RNApolA和/或DJR-MCP(在286个样本中检测到两种标记),主要来自广泛动物的消化系统(补充表2)。在这864个egovirus阳性宏基因组中,egovirus RNApolA的平均覆盖度约为10×,egovirus主要衣壳蛋白(MCP)约为15×(R2 = 0.89),在部分人类、水牛、猪和鸡样本中达到100×以上(补充表2)。使用这2个标记基因,我们除了12个完整基因组外,还回收了200多个宏基因组组装基因组(补充表2和补充信息)。Egovirus基因组平均完整度为81%(最低质量分数为50%;方法),大小最大为467 kb(平均229 kb)。对人工整理标志蛋白的系统发育分析确信地将egoviruses鉴定为Pokkesviricetes纲内一个独特的主要分支,与痘病毒关系最密切(图1和扩展数据图1)。基于这些发现,egoviruses应代表Pokkesviricetes内的第三个目,我们建议将其命名为Egovirales。Egovirales是Nucleocytoviricota门中唯一被发现普遍存在于消化系统中的分支。
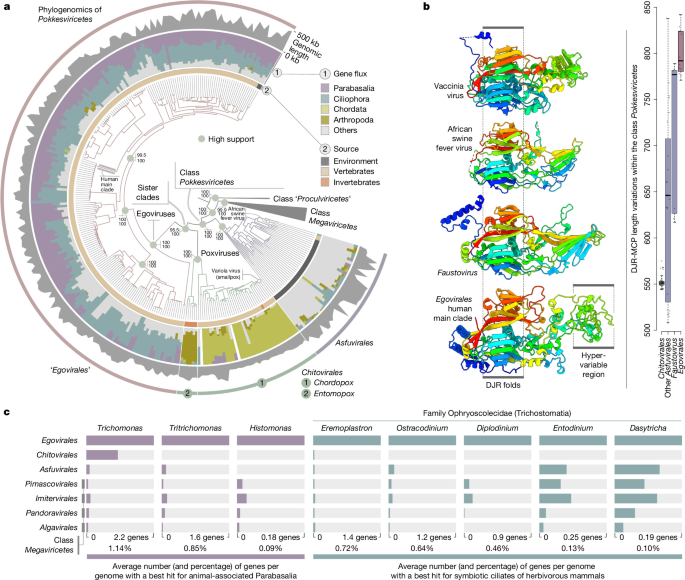
痘病毒最亲近的亲属在全球人类和动物肠道中占优势
a,对 Nucleocytoviricota 成员的最大似然系统发育基因组学分析,以及 202 个质量分数高于 50% 的 Egovirales 基因组。该树覆盖 1,807 个基因组,并使用 Nucleocytovoricota 的四个标志蛋白(DNApolB、RNApolA、RNApolB 和转录因子 IIS;4,110 个位点)的串联多序列比对,通过 IQ-TREE 和 LG+F+R10 模型构建。该树以推定的 Proculviricetes 纲为根,并使用 anvi’o v.9.1 可视化。树中的绿点突出显示关键节点的高支持率(近似似然比 ≥ 80 且超快自举近似 ≥ 95;方法)。b,对一个 Egovirales DJR-MCP(人类主要分支)的结构建模(下图),并与来自三个参考 Pokkesviricetes DJR-MCP 的 DJR-MCP 结构进行比较(Protein Data Bank 编号从顶部到倒数第二:3SAM、6KU9 和 5J7O)。该面板还显示了箱线图,总结了 egoviruses(完整基因组)、faustoviruses、asfuviruses 的其他分支和 Chitovirales 的 DJR-MCP 蛋白质长度变异。箱线图中的中心线显示中位数;箱限表示第 25 和第 75 百分位数;须从第 25 和第 75 百分位数延伸 1.5 倍四分位距;所有数据点均以单个点显示。c,核质病毒各目与八个真核属之间的基因流信号(仅考虑最佳命中)。
我们鉴定出 57 个核心基因,它们在 12 个完整 Egovirales 基因组中至少有 10 个基因组中存在,并通过
我们利用宏基因组组装中发现的 Egovirales 的 RNApolA 和/或 DJR-MCP 基因,对 egovirus 的发生和多样性进行了全球调查(补充表 2)。两个系统发育树都包含相同的六个 人特异性 egovirus 分支(图 2 和扩展数据图 2)。其中五个分支仅见于人类肠道样本,而最后一个分支(分支 03)仅出现在人类唾液样本中。仅从环境样本中回收到九个 egovirus 样 RNApolA 基因,这些样本包括一个含水层、一个冷泉和海洋沉积物(图 2 和补充表 1)。在系统发育树中,这些序列形成了四个小分支,其中两个(来自海洋沉积物)是 Egovirales 最基部的分支。所有其余 RNApolA 序列(超过 97% 的数据)均来自消化系统,代表了已知 Egovirales 多样性的大部分。DJR-MCP 系统发育树重现了这些趋势,在这种情况下,超过 99% 的序列来自消化系统(扩展数据图 3)。
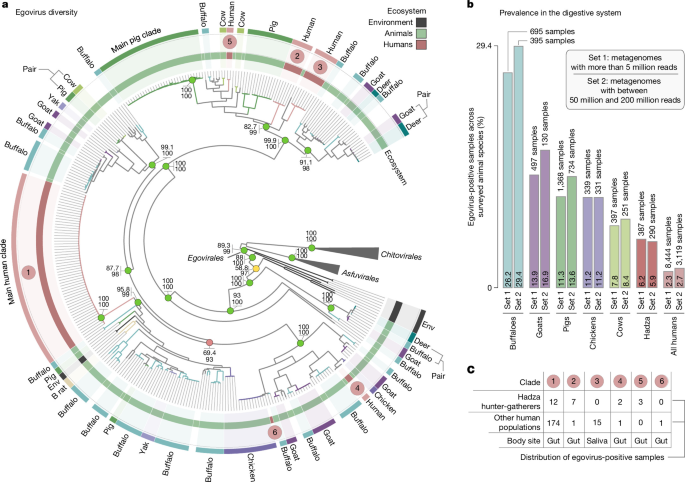
a,egovirus 的 RNApolA 最大似然系统发育树(n = 324),使用 Chitovirales 和 Asfuvirales 的代表序列生根(1,357 个位点),并采用 LG+F+R7 模型。信息层总结了生态系统类型(环境(Env)与人类与其他动物)以及对应同一动物物种中出现的 egovirus 分支的选择项。六个 人特异性分支也被突出显示。聚焦于 egovirus 的 MCP 的类似分析见扩展数据图 3。B rat、竹鼠。b,在不同动物物种对应的宏基因组组装队列中,Egovirales 的流行率(使用 RNApolA 和 MCP 两项调查的信号)。c,对应于六个 人特异性分支之一的 864 个 egovirus 阳性样本。
我们调查了来自 26 个肠道相关生物项目的 11,788 个宏基因组,每个至少含 500 万条 reads(其中 17 个项目涵盖人类),以估算 egoviruses 在动物物种中的流行率(补充表 4 和补充信息)。在年龄和地理位置各异的人体消化系统中检测到了 Egovirus 标志基因(n = 193;占 egovirus 阳性样本的 2.3%),来自 Tanzania43 的狩猎采集者(Hadza;占 egovirus 阳性样本的 6.2%)中信号显著增加(图 2)。这种增强的信号源于 egovirus 多样性更高,而不是最流行的人类分支(clade 01;仅占 egovirus 阳性样本的 3.1%)流行率更高。值得注意的是,三个人类特异性 egovirus 分支(clade 02、04 和 05)(几乎)仅在 Hadza 狩猎采集者中检测到,提示生活方式可能影响与人类相关的 egoviruses 多样性。Egoviruses 在猪(n = 155;占 egovirus 阳性样本的 11%)、水牛(n = 182;26%)、山羊(n = 69;14%)、牛(n = 31;7.8%)和鸡(n = 38;11%)的消化系统中也有充分体现。在可获得样本较少的其他家畜(鹿、牦牛、绵羊、瘤牛和驯鹿)中,也检测到了 egoviruses,但程度较低(补充表 1 和 2)。当仅考虑 reads 数在 5000 万至 2 亿之间的宏基因组(n = 4,909)以尽量减少测序深度差异时,观察到相似的 egovirus 阳性样本百分比(例如,人类为 2.7%,水牛为 29%)(图 2 和补充信息)。在所调查的动物物种中,水牛的 Egovirales 流行率迄今为止最高,其病毒涵盖广泛且亲缘关系较远的分支(图 2),并在反刍动物胃室中占主导(补充表 4 和补充信息)。野生动物消化系统可用的宏基因组更少,但尽管如此,仍发现竹鼠、一只金竹狐猴、一只橄榄狒狒和一头白犀牛是 egoviruses 的额外携带者,表明灵长类动物和其他野生哺乳动物也构成了 egovirus 多样性的重要储库。
痘病毒最近的近亲在全球人类和动物肠道中普遍存在
对 Egovirales 在所有宏基因组组装中的扩散情况进行的检查表明,密切相关的 egovirus 分支往往出现在同一动物物种中。这在与人 and 猪相关的两个主要分支中最为明显(图2和扩展数据图3)。我们在来自19项研究的186个宏基因组组装中表征了主要的人类分支(clade 01),这些研究覆盖许多大洲的多个国家,包括坦桑尼亚(Hadza)、尼泊尔、斐济岛民、美国、英格兰、瑞典、丹麦、德国、意大利和西班牙(补充表2)。RNApolA 基因之间的平均氨基酸一致性为99.4%,MCP 基因之间为99.9%,表明该分支代表一个在全球范围内存在于人类中的内聚病毒群体。一项针对 Sequence Read Archive (SRA) 组装的补充 k-mer 调查,使用来自 clade 01 基因组代表的3个标志基因,在超过500个宏基因组中检测到了这一病毒群体,拓宽了其信号在人类群体中的地理范围(补充表4和方法)。总体宏基因组信号表明,这一病毒群体(占 egovirus 阳性人类肠道样本的92%)存在于超过1%的人类群体中(包括偏远的农村村庄和人口稠密地区44,45),涵盖人类生命周期的多个阶段(例如,一名3岁儿童和一名孕妇),并在对同一个体的纵向研究中随时间持续存在46(采样时间长达近1年)。主要的猪分支表现出相似趋势,在来自4项研究的109个宏基因组组装中被发现,这些研究覆盖许多大洲的国家。最后,以人类唾液为特征的 egovirus 分支在美国和斐济被发现47,48。这些结果表明,内聚的 egovirus 群体可以覆盖广阔的地理区域,同时严格与单一动物物种的特定身体部位(肠道或唾液)相关联。此外,我们发现了密切相关的 egovirus 出现在多个动物物种中的实例。例子包括山羊–鹿、猪–牛和鹿–水牛配对(图2和扩展数据图3)。总体而言,我们的结果证明了 egovirus 群体与一种或多种动物物种的全球传播和强烈共现。
Egoviruses 与单细胞真核生物相关
痘病毒最近的亲属在全球人类和动物肠道中普遍存在
长期反复感染通常会导致病毒与其主要真核宿主之间发生横向基因转移,这种信号可通过比较基因组学检测到6,49。为预测 egoviruses 的宿主范围,我们在核质病毒与广泛的真核谱系之间进行了以蛋白质为中心的全局基因组比较(方法
Polintons 对应于具有 DJR-MCP 的 DNA 病毒的一个主要谱系,可感染广泛的真核生物28。Parabasalia 基因组,尤其是 T. vaginalis 的基因组,包含大量内源性 polintons,涵盖约 20 个基因9。其中一个基因编码 KilA,这是一种功能未知的 DNA 结合蛋白,似乎仅限于整合在 Parabasalia 基因组中的 polintons58。KilA 也是痘病毒和 egoviruses 的核心基因,在其他 nucleocytoviruses(包括 Megaviricetes 纲内)中呈更零星分布。我们对 KilA 的系统发育分析表明,该基因在 nucleocytoviruses 中具有古老的演化历史(图 3)。该分析进一步显示,polinton 的 KilA 基因由两个不同的分支(I 型和 II 型)组成,其树拓扑结构表明,它们各自的共同祖先是在 Trichomonas、Tritrichomonas 及其他相关 parabasalids 从其共同祖先辐射之前,从不同的 egoviruses 获得的。在 T. vaginalis 菌株 G3(176 Mb)的基因组中,两个 KilA 分支以高拷贝数存在(I 型 1,116 个拷贝,II 型 718 个拷贝),并分布到所有染色体上(图 3 和补充表 9)。两个分支拷贝数最高的第二个 Parabasalia 物种是 Trichomonas tenax。egovirus 核心基因向 polintons——Parabasalia 的内源性病毒——的表观转移,加强了 egoviruses 与这一肠道相关厌氧单细胞真核生物分支之间的联系。
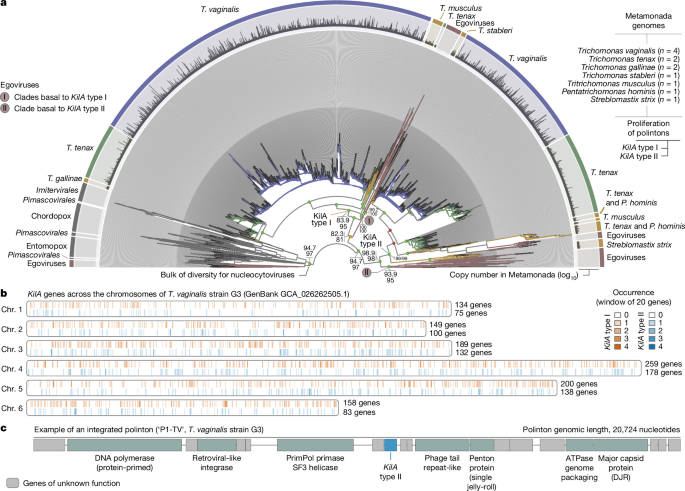
a,对来自 nucleocytoviruses 和内源性 polintons 的 KilA 预测蛋白进行的系统发育分析(2,207 条序列,313 个位点;模型 VT+F+R9),该分析在 polintons 中划分出两个系统发育分支(KilA I 型和 II 型)。仅选取了高度冗余 Metamonada 蛋白序列(95% 序列同一性)的代表序列(方法);所代表的序列数量显示为“拷贝数”。b,KilA 基因在 T. vaginalis 菌株 G3 基因组中的分布。c,整合到 T. vaginalis 菌株 G3 基因组中的 polinton P1-TV(参考文献 58)的基因组结构。Chr.,染色体。
讨论
我们对 Pokkesviricetes 纲 DNA 病毒的全球宏基因组调查发现了该纲中第三个推测的目,我们暂时将其命名为 Egovirales。Egoviruses 具有线性基因组,长度可达 467 kb,主要存在于人类(已表征六个分支)、家畜(已表征的 Egovirales 多样性的大部分)和野生动物的消化系统中,并在全球范围内普遍存在。Egoviruses 具有高度分化的 MCP(DJR-MCP)。我们提出,egoviruses 编码 asfuviruses 所独有的主要病毒粒子蛋白的同源物,其产生的病毒粒子具有类似非洲猪瘟病毒粒子的二十面体多层结构。Egoviruses 不仅填补了我们对 Pokkesviricetes 生态学和演化认识中的主要空白,而且代表了迄今发现的唯一一类具有大 DNA 基因组、常见且几乎仅在人类和动物肠道微生物组中检测到的病毒群。鉴于其演化轨迹和分布模式,这一此前被忽视的具有复杂基因组的主要病毒类群,对人类和兽医病毒学以及病毒演化具有重要研究价值。
迄今为止,消化系统被认为包含有限多样性和丰度的真核 DNA 病毒5,6,26,其中最普遍的类型,如 anelloviruses59,仅具有几千碱基的小型单链 DNA 基因组。对于具有大 DNA 基因组的真核生物病毒,尚无令人信服的证据表明其能在肠道中繁殖。但是,与其他 Nucleocytoviricota 谱系形成对比,许多数据挑战了以下假设:摄入的水或食物是人类和动物消化系统中 egoviruses 的主要来源。首先,egoviruses 几乎从未在环境样本中被检测到,但仅根据宏基因组组装信号(结合联合国可获得的动物种群统计数据)推测,它们存在于约 1.8 亿人的消化系统、数十亿家畜和鸡以及众多野生动物中。这些病毒是通过宏基因组分析发现的,该方法只针对最丰富的病毒基因组,并且仅通过这种方法就在超过 2% 的受分析人类肠道微生物组中被检测到,在许多动物微生物组中比例甚至更高。在 Egovirales 流行率最高的动物中,推测约 2 亿头水牛中有相当大比例(可能大多数)的胃室中携带着 1 种或多种繁盛的 egovirus 物种。其次,仅最普遍的人类特异性 egovirus 分支——已在覆盖多个大陆的广泛宏基因组调查中发现——就被推测存在于超过 1% 的人的肠道中。此外,纵向研究表明,该分支可在同一个人的肠道中长时间持续存在。因此,egoviruses 是多样、广泛分布且具有韧性的病毒,在消化系统中普遍存在。最后,一个以口腔为特征的人类特异性 egovirus 分支的出现,首次表明不同的 egoviruses 广泛存在于更多动物身体部位,进一步表明 egoviruses 很可能不是短暂的,而是人类肠道和口腔微生物组的长期成员。
综合来看,比较基因组学和靶向系统发育分析(例如对 DNApolB 的分析)强烈预测了 egoviruses 与两个亲缘关系较远的单细胞真核生物类群(Trichostomatia 目和 Parabasalia 门)之间的病毒–宿主相互作用,这两个类群均为厌氧、进行吞噬作用,并在动物的消化系统和口腔中普遍存在24,25,54,55,60,61,62。Egovirales–Parabasalia 的关联主要局限于 Trichomonas 和 Tritrichomonas,这两个属包含感染广泛动物和人类的重要病原体,并可显著影响动物免疫8。例如,Tritrichomonas foetus 是牛(生殖道)和猫(大肠)的寄生虫,也是猪胃和肠道中的共生体61。此外,T. vaginalis 是人类中最常见的非病毒性性传播感染病原体,估计每年约有 1.5 亿例病例63。明显的 egovirus 向 polinton 的 KilA 基因转移,随后 polintons 扩散到 T. vaginalis 和 T. tenax(栖息于人类口腔的寄生虫62)的基因组中,这一显著案例进一步支持了 egoviruses 与 Parabasalia 之间的长期关联。Egovirales–Trichostomatia 的关联几乎完全局限于 Ophryoscolecidae 科的属,已知这些属在反刍动物消化过程中发挥核心作用7,64。这些 Trichostomatia 和 Parabasalia 属在动物中的高流行率,以及它们以吞噬作用为中心的摄食方式,解释了 egoviruses 在动物物种间的广泛传播,并表明 egovirus 在消化系统中具有悠久的复制历史。
痘病毒最近亲属在全球人类和动物肠道中普遍存在
动物(涵盖昆虫和脊椎动物)中痘病毒的演化,包括据估计在一个世纪内造成五亿人死亡的天花,已被广泛研究11,65,66。然而,痘病毒作为一个类群的起源仍然成谜,原因是它们与其他核质大DNA病毒关系遥远(尽管明确无误)且缺乏中间形态。卵病毒(egoviruses)提供了这一缺失环节,因为它们在系统发育上处于痘病毒的姐妹支系位置,并在消化系统中普遍存在。尽管迄今为止卵病毒仅在哺乳动物和鸡中被检测到,但这一信号受动物物种间宏基因组测序数据可得性的影响,而目前这些数据严重偏向人类和牲畜。卵病毒的多样性很可能被大幅低估,尤其是在野生动物中。这项工作的结果表明,痘病毒和卵病毒的共同祖先感染了厌氧单细胞真核生物,这些真核生物能够在约7亿年前昆虫和脊椎动物(原口动物和后口动物)从其共同祖先分化之前,于祖先动物的肠道中进行吞噬作用22。鉴于著名的后滴虫类病原体,如毛滴虫(Trichomonas)和 Tritrichomonas,在感染过程中直接结合上皮67,68,且致病性纤毛虫也能穿透动物组织69,可以设想痘病毒是从一种类似卵病毒的祖先演化而来,该祖先获得了在动物肠道上皮细胞中繁殖的能力。我们对卵病毒基因组的分析表明,Pokkesviricetes 的最后共同祖先以及卵病毒和痘病毒的共同祖先具有类似 asfuviruses 的多层二十面体衣壳。在痘病毒的祖先从卵病毒分化之后,该衣壳被砖形颗粒所取代,或许与入侵动物肠道上皮细胞同时发生。
痘病毒的“出肠道”演化场景似乎与痘病毒和真核生物的生物学都高度吻合。在病毒方面,昆虫痘病毒可以通过首先感染上皮细胞70在昆虫中肠进行早期复制阶段。没有证据表明痘病毒在脊椎动物肠道中复制。在细胞方面,吞噬作用是动物免疫系统的重要组成部分71,是多种DNA病毒的进入点56,57,也是后滴虫类72和纤毛虫73的主要摄食机制。因此,上皮细胞执行吞噬作用的能力74,75为一种感染消化系统中厌氧单细胞真核生物的DNA病毒如何能够成功启动对相邻动物细胞的感染提供了一种可能的机制解释。总之,这项工作表明,与先前的认识相反,一个独特的核质大DNA病毒类群在人类和动物肠道中普遍存在,并揭示了痘病毒的起源。
方法
宏基因组数据库
宏基因组(列于补充表1)作为 mOTUs 数据库76,77,78的一部分进行组装和处理。此处我们提供宏基因组组装的细节以供参考。简言之,使用 BBMap79(v.38.71)对所有样本的测序读段进行质量控制,从读段中移除接头,移除比对到质量控制序列(PhiX 基因组)的读段,并丢弃低质量读段(trimq = 14,maq = 20,maxns = 1 和 minlength = 45)。质控后的读段使用 bbmerge.sh 以最小重叠16个碱基进行合并,产生合并的、未合并的双端和单端读段。来自宏基因组样本的读段使用 SPAdes 组装器80(v.3.15.2)在宏基因组模式下组装成 scaffolds。Scaffolds 经过长度过滤(500 bp 或以上),基因序列使用 Prodigal81(v.2.6.3)以参数 -c -q -m -p meta 进行预测。
使用 RNApolA 的首次宏基因组调查
文章标题:痘病毒最近亲缘病毒在全球人类和动物肠道中普遍存在
正文: 使用 hmmsearch(HMMER82 v.3.1b2)以 1 × 10−50 的 E-value 阈值,将针对 RNApolA 标志基因29 的广谱隐马尔可夫模型(HMM)图谱与宏基因组数据库中的预测基因序列进行比对搜索。该搜索共鉴定出近 200 万个 RNApolA 基因。随后,将阳性命中结果回溯关联至其来源 scaffold。
RNApolA 序列的分类归属
我们收集了对应于广泛参考 RNApolA 基因的氨基酸序列,涵盖通过培养和环境基因组学30,83,84 表征的细菌、古菌、真核生物和巨型病毒谱系。我们基于该资源构建了自定义 diamond(v.2.1.8)数据库85,并在配套的元数据文件中汇总了每条序列的分类归属。随后,我们使用该自定义数据库对宏基因组调查中鉴定出的 RNApolA 基因进行 diamond blast 搜索(v.2.1.8),并利用相关元数据文件评估其分类归属和新颖性评分(基于百分比一致性)。
指向 egoviruses 的系统发育信号
我们使用 CD-HIT86(v.4.8.1)并以蛋白质水平 70% 的一致性阈值去除宏基因组调查所鉴定近 200 万个 RNApolA 基因之间的冗余。该步骤得到一个包含 17,293 个长度超过 250 个氨基酸的独特 RNApolA 蛋白的数据库,涵盖了从宏基因组调查中回收的广泛细胞与病毒多样性。随后,我们使用 anvi’o87,88(v.8.1)的系统发育工作流程与可视化功能,结合 muscle89(v.3.8.1551)和 FastTree90(v.2.1.11),鉴定并去除对应于细菌和质体的 RNApolA 蛋白。聚焦于剩余的 10,853 个独特 RNApolA 蛋白,我们迭代使用相同的 anvi’o(v.8.1)工作流程进行从头比对和树重建,但此次旨在鉴定并去除离群序列(在树拓扑中孤立或具有长分支),以提高树的整体质量,这与系统发育工作流程中的常见做法一致(例如参考文献 30,91,92)。共进行了 13 次迭代,之后剩余 8,672 个独特 RNApolA 蛋白。利用这一精选数据库,我们借助分类注释和新颖性评分作为指导,探索了 RNApolA 蛋白的系统发育信号。由此鉴定出一个对应于 egoviruses 的单系进化支,其与 asfuviruses 和痘病毒亲缘关系最近。我们将这些序列纳入自定义 diamond(v.2.1.8)数据库,并对近 200 万个 RNApolA 蛋白进行第二次 diamond blast,以鉴定 Egovirales RNApolA 蛋白(百分比一致性大于 50%)并研究其来源 scaffold。数据可用性 Item 01 提供了本节及上一节所述的全部 RNApolA 蛋白序列、diamond blast 数据库、参考分类信息和 fast-tree 系统发育树。该方法共回收了 12 个完整的 Egovirales 基因组。
Egovirales 核心基因的功能注释
我们从 Giant Virus Database(GVDB)collection10 中收集了对应于 Asfuvirales 和 Chitovirales 的参考培养基因组和宏基因组组装基因组(MAGs),以及少量 Megaviricetes 代表基因组。我们将 12 个完整的 Egovirales 基因组加入到这个‘Nucleocytoviricota genomic resource’(Data availability Item 02)中,并使用 Orthofinder93(v.2.5.5,diamond_ultra_sens 模式)来表征基因簇。在 12 个 Egovirales 完整基因组中,至少 10 个基因组中出现的基因簇被标记为‘Egovirales core genes’(n = 57)。最后,使用来自 HH-suite v3 包的 HHpred94 profile–profile 比较,针对 MPI Bioinformatics Toolkit95 中可用的 Pfam、Protein Data Bank、Conserved Domain Database 和病毒蛋白序列(uniprot_sprot_vir70)数据库进行功能注释。通过本地安装的 ColabFold97(v.1.5.5),使用 AlphaFold2(ref. 96)对蛋白质结构进行建模。对于 Egovirales 的 DJR-MCP,ColabFold97(v.1.5.5)成功预测了其三维结构,并确认了 Nucleocytoviricota 门特有的 DJR 蛋白组分的存在(Data availability Item 03)。
使用单拷贝核心基因进行基因组完成度评估
在 Egovirales core genes(上一节)中,那些在 12 个完整基因组中至少 10 个中以单拷贝形式出现的基因被标记为‘Egovirales single copy core genes’(n = 51)。值得注意的是,单拷贝核心基因可为 egovirus 基因组提供完成度和冗余度的相关估计。简言之,我们使用 HMMER82(v.3.1b2)为每个 Egovirales single copy core gene 构建了 HMM,并创建了相应的 HMM 集合,可直接在 anvi’o(v.8.1)中使用(Data availability Item 04)。在后续章节中,egovirus 基因组的完成度和冗余度通过统计该 HMM 集合的命中数来预测,正如环境基因组学领域的常见做法,并且此前已应用于其他病毒谱系(例如,refs. 30,34)。
八个 Nucleocytoviricota 标志基因的回收
大多数核质巨DNA病毒含有少数对其功能最为核心的核心基因,这些基因与病毒粒子形态发生模块(包括 MCP)和信息模块(包括 DNA 和 RNA 聚合酶)相关。这些基因被称为标志基因(例如,参考文献 10、30)。我们使用 HMMER82 v.3.3.1 中的 hmmsearch(默认设置)搜索先前为这八个
我们从 Egovirales 来源的 scaffold 中收集了 20 条 DJR-MCP 序列(见“指向 egoviruses 的系统发育信号”一节),这些 scaffold 包含完整基因组。我们使用 MAFFT v.7.464(L-INS-I 算法;默认设置)对它们进行比对,并使用 hmmbuild(HMMER82 v.3.3.2)生成了专门针对 Egovirales DJR-MCP 的 HMM profile(Data availability Item 04)。随后,使用 hmmsearch(HMMER82 v.3.3.1)和 1 × 10⁻¹⁰ 的 E-value 阈值,将该 HMM profile 搜索宏基因组数据库中的所有预测基因序列。阳性命中(基于 RNApolA 和 DJR-MCP 两者)随后被回溯链接到其来源 scaffold,从而扩展了 Egovirales 阳性宏基因组样本的范围(Data availability Item 07)。
224 个 egovirus 环境基因组的数据库
mOTUs 数据库包含使用 Metabat2(ref. 104)(v.2.15)并结合差异覆盖度信息生成的宏基因组 bins,如 refs. 76,77 所述。在此,我们分析了 mOTUs 中所有含有 Egovirales
为了超越环境基因组的范围(上一节),我们构建了全局系统发育树,包含从宏基因组调查中提取的 egoviruses 的全部 RNApolA(序列长度超过600个氨基酸)和 DJR-MCP 蛋白序列(序列长度超过600个氨基酸),并以 GVDB 中 asfuviruses 和 chitoviruses 的基因组作为外群。系统发育树使用与单蛋白系统发育树相同的方法推断:使用 MAFFT v.7.464 的 L-INS-i 算法(默认设置)比对序列,使用 goalign v.0.3.5 修剪间隙达到或超过70%的位点,并使用 IQ-TREE v.1.6.2 和 ModelFinder 选项重建树。支持值由 1,000 次重复计算得出,用于 Shimodaira–Hasegawa-like aLRT102 和 UFBoot103。系统发育树(数据可用性第06项)使用 anvi’o (v.9.1) 进行可视化和定根。
egoviruses 与共现真核生物的宏基因组信号
我们使用 CD-HIT86 (v.4.8.1) 生成了一个非冗余数据库(平均核苷酸一致性低于95%),包含从 Egovirales 阳性样本中鉴定出的 egovirus MCP 基因、egovirus RNApolA 基因和真核生物 RNApolA 基因(数据可用性第09项)。我们针对该数据库对所有 Egovirales 阳性宏基因组样本进行了 reads 招募。为此,将质控后的宏基因组 reads 比对(Bowtie2,参考文献106,v.2.4.116)到该数据库,并使用 ‘anvi-profile-blitz’87,88(anvi’o v.8.1)例程利用比对结果生成平均覆盖度值。分类信息通过以下方式纳入:对 RNApolA 基因使用 diamond blast (v.2.1.8)(章节‘RNApolA 序列的分类归属’),对 MCP 基因使用系统发育树。
最流行的人类相关 egovirus 的 k-mer 调查
使用在线工具 Logan-Search107 对 SRA 数据(在组装水平)进行了全球 k-mer 调查(k = 31),调查对象为主要人类分支的一个基因组代表(MAG: ZEEV15_1_SAMEA3664761_BIN_00000011)的 MCP、DNApolB 和 RNApolA 单拷贝核心基因,最小 k-mer 覆盖度为50%(Logan-Search 默认截断值,以尽量减少假阳性)。该搜索提供了524个候选阳性样本,其中270个具有3个标记,95个具有2个,159个具有1个。由于该工具仅允许筛选小于1 kb的核苷酸序列,我们仅分析了这三个基因的前1 kb。
病毒与细胞之间的蛋白序列比较
来自 224 个环境基因组的 Egovirales 蛋白,连同来自 GVDB 集合的 Pokkesviricetes(Asfuvirales 和 Chitovirales)以及来自 GOEV 集合的 Megaviricetes,被用作查询序列,使用 MMseqs2(参考文献 108)(v.17-b804f)以默认设置对 UniProt-TrEMBL 进行相似性搜索。根据分类注释,剔除了未明确归属于细胞生物的命中(补充表5)。对于每个查询,仅保留序列一致性为 30% 及以上且 bit score 不低于 100 的最佳命中。鉴于 Egovirales 蛋白的命中中富集 Metamonada 和 Trichostomatia(Ciliophora),使用相同参数,将相同的查询序列对从 NCBI Genome 和 Genome Warehouse 检索到的更多 metamonad 和 ciliophoran 基因组进行搜索(列表见补充表8;数据可用性第10项提供了相应的蛋白质组)。使用 bit score 值比较各独立运行中的命中,并且每个查询仅保留得分最高的命中。为了概览功能,将 Egovirales 蛋白及其在 metamonads 和 Ciliophora 中对应的最佳命中用于对 Pfam-A.full(38.0 版)进行搜索,使用 MMseqs2(v.17-b804f;默认设置),每个查询仅保留最佳命中。为了进一步评估所检测到的相似性的特异性,我们以所有与 Egovirales 蛋白匹配(序列一致性为 30% 及以上且 bit score 为 100 及以上)的 metamonad 和 ciliophoran 蛋白作为查询序列,进行相互相似性搜索,无论它们是否为原始病毒查询的最佳命中。使用 MMseqs2(v.17-b804f)以默认设置,将这些蛋白对 Egovirales、Pokkesviricetes(Asfuvirales 和 Chitovirales)和 Megaviricetes 蛋白数据集进行搜索(补充表8)。还将它们对 UniProt-TrEMBL 进行搜索,以识别与 Nucleocytoviricota 之外的同源物显示出更强相似性的蛋白。当使用 metamonad 蛋白作为查询序列时,排除分配给 Metamonada 的 UniProt-TrEMBL 命中,以避免与该资源中代表的密切相关菌株发生自身匹配。对于每个查询,仅保留每个目标数据集内的最佳命中。
在 Parabasalia 和 Trichostomatia 中发现的 Egovirus 核心基因
我们的蛋白质序列比较识别出一个连接 egoviruses 与两个真核生物分支——Parabasalia 和 Trichostomatia——的基因流信号。该信号大部分源于出现在真核生物基因组中的 egovirus 核心基因。为厘清这一基因流的方向性,我们对四个功能已知的 egovirus 核心基因(DNA 依赖性 RNA 聚合酶最大亚基(RNApolA)、DNApolB、mRNA 加帽酶和 Holliday 连接解离酶)以及两个功能未知的 egovirus 核心基因(OG0000040 和 OG0000089)进行了系统发育分析。mRNA 加帽酶(PF03919.22)和 Holliday 连接解离酶(PF04848)的 HMM 谱从 InterPro 数据库(https://ebi.ac.uk/interpro/)获取,而 OG0000040 和 OG0000089(这两个是缺乏任何注释的 Egovirales 核心基因)的新 HMM 谱则使用 hmmbuild(HMMER82 v.3.3.1)从经 MAFFT v.7.464(FFT-NS-2 算法,默认设置)比对的 Egovirales 序列构建(Data availability Item 04)。同源序列使用 hmmsearch(HMMER82 v.3.3.1)鉴定,InterPro HMM 谱采用其 gathering threshold 分数截断值(Holliday Junction 默认最低 bit score 为 22,mRNA capping 为 26.5),另外两个则采用默认 E-value 纳入阈值(E-value 低于 0.01),并从 Pokkesviricetes、Megaviricetes 以及额外的 Metamonada 和 Ciliophora 集合(前一节),还有 TCS 数据库(源自 EukProt v.3,代表真核生物多样性109)中收集。为减少 mRNA 加帽酶和 Holliday 连接解离酶的冗余,序列用 CD-HIT(v.4.8.1)以数据集特异性阈值进行聚类(mRNA 加帽酶和 Holliday 连接解离酶数据集中 TCS 序列分别采用 80% 或以上和 95% 同一性;两个基因家族中 GOEV 序列均采用 90% 或以上同一性)。对于 DNApolB 和 RNAPa,HMM 谱及细胞和/或病毒同源物取自参考文献 30,而使用 hmmsearch(HMMER v.3.1)鉴定的来自 metamonads、Ciliophora 和 egoviruses 的同源物则直接并入这些数据集。对于 DNApolB、RNApolA 和 mRNA capping,分别移除短于 100、200 和 100 个氨基酸的序列。对于 DNApolB,我们还移除了长于 2,000 个氨基酸的序列。序列使用 MAFFT v.7.464(FFT-NS-2 算法,默认设置)比对,含 70% 或以上 gaps 的位点使用 goalign v.0.3.5 修剪,系统发育树(Data availability Item 06)使用 IQ-TREE v1.6.2 配合 ModelFinder 选项重建。对部分树而言,比对、修剪和树推断过程经过迭代,以在最终推断前识别并移除离群序列(树拓扑中孤立或长枝),从而改善分辨率和稳定性(Supplementary Information and Data availability Item 06)。
KilA linking egoviruses to metamonad polintons
痘病毒最近的亲属在全球人类和动物肠道中广泛存在
KilA 基因与 metamonads(尤其是 parabasalids)中的 polinton 样元件相关,由于其独特的进化背景,被单独分析。从 InterPro(https://ebi.ac.uk/interpro/)检索到一个 HMM 配置文件(PF04383.19),并使用 hmmsearch(HMMER v.3.3.1,配置文件的 gathering threshold 分数截止值)来识别 Pokkesviricetes(包括 egoviruses)、Megaviricetes 和 Metamonada 中的同源序列。考虑到 Metamonada 中 polinton 样元件的特异性富集,纳入了额外的基因组:T. vaginalis 菌株 ATCC 30188 (GCA_002891335.1) 和 ATCC 50138 (GCA_052324655.1),T. tenax 分离株 Hs4:NIH (GCA_047301845.1) 和菌株 NIH4 ATCC 30207 (GCA_900231805.1),Trichomonas gallinae 分离株 XT1081-07 (GCA_008369845.1),Trichomonas sp. 基因型 1c (GCA_047372395.1) 和 2a (GCA_047372375.1),以及 Pentatrichomonas hominis 分离株 Hs-3:NIH (GCA_047301545.1)。为限制冗余,使用 CD-HIT(v.4.8.1;95% 或更高一致性阈值)对来自 GOEV、GVDB 和 Metamonada 基因组的序列分别进行聚类,仅保留每个聚类的代表性序列(Data availability Item 11)。为减少真核序列的数量,将所有序列作为查询序列,使用 MMseqs2(v.17-b804f;默认设置)对 Pfam-A.full(release 38.0)进行相似性搜索;去除未最佳命中 KilA-N 的真核序列。使用 MAFFT v.7.464(FFT-NS-2 算法;默认设置)对剩余序列进行比对,使用 goalign v.0.3.5 修剪空位为 70% 或更高的位点,并使用 IQ-TREE v.1.6.2 的 ModelFinder 选项推断系统发育树。在序列数据集中去除异常序列(在树拓扑中孤立或长分支),然后进行新一轮的 de novo 比对、修剪和树重建。共完成八次迭代(除初始树之外)(Supplementary Information 和 Data availability Item 06)。
基因组共线性
检索了 T. vaginalis 菌株 G3(GenBank 参考 GCA-026262505.1)基因组的推定基因,包括其功能注释和 polinton 样区域的预测位置110。将 Egovirales 样命中以及 I 型和 II 型 KilA 基因的基因组位置映射到其上。最后,使用 MMSeqs2(v.17-b804f)和默认设置,鉴定了与 Polinton-1_TV 的 MCP 基因匹配的基因,Polinton-1_TV 是来自同一 T. vaginalis 菌株 G3 的注释良好的 polintovirus(参考文献 28),收集自 REPBASE 数据库(https://girinst.org/repbase/)。
报告摘要
有关研究设计的更多信息可在与本文链接的 Nature Portfolio Reporting Summary 中获取。