 Newshot
文章标题:大麦属的结构与调控演化
正文:
主要
大麦属(Hordeum)包含约33个物种,广泛分布于欧亚大陆和美洲的温带地区1,2,3。根据细胞遗传学证据,大麦属被划分为两个亚属:一个包含H和Xu基因组,另一个包含I和Xa基因组4。基本染色体数目为七条,尽管大多数物种为二倍体,但也已有四倍体和六倍体分类群的描述。栽培大麦(Hordeum vulgare)是最知名且研究最深入的物种,因为它是最早被驯化的谷类作物之一。如今,大麦是世界上第四重要的谷物,因其在食品、动物饲料和酿造中的用途而受到重视5。栽培大麦及其野生祖先(H. vulgare subsp. spontaneum)构成一个单一的互交可育基因库,允许野生型和栽培型之间频繁的基因流6。这一初级基因库长期以来一直被育种者利用以引入所需性状6。Hordeum bulbosum因其能够直接与栽培大麦杂交,通过渗入贡献了有价值的抗病基因7,8,9,10。其他大麦属物种未被驯化,但在生态系统稳定性、环境适应和饲用方面具有重要的生态和农业作用11,12,13,14,15。总体而言,大麦属既是一个农艺上重要的属,也是研究作物演化、环境适应以及生物和非生物胁迫抗性的有力模型。不完全谱系分选、反复杂交和基因流等因素部分模糊了物种边界,留下了重大演化问题未解决1,2,4,16,17。近期的大麦泛基因组已大幅推进了我们对栽培大麦及其近缘种内基因组变异的理解10,18,19。然而,这些研究在很大程度上局限于两个物种(H. vulgare和H. bulbosum),因此无法解析在整个属内运作的全基因组演化过程,包括大规模结构变异的起源、古老杂交、多倍体基因组演化以及调控位点的多样化。因此,将比较基因组分析扩展至涵盖整个属对于捕捉大麦属基因库内多样性的全貌以及促进演化研究和有效利用野生种质进行大麦改良至关重要。泛基因组学如今为应对这种复杂性提供了全面的资源。在番茄、马铃薯、玉米、葡萄、柑橘和棉花等作物中,属级泛基因组已揭示了广泛的结构变异、基因存在-缺失和演化动态20,21,22,23,24。研究结构变异有助于解释演化过程,并可为作物育种策略提供信息25。然而,大麦属内结构变异的全貌仍很大程度上未被探索。为填补这一空白,我们生成了代表所有已识别的二倍体大麦属物种以及代表性多倍体谱系的染色体级基因组组装。这一比较基因组框架提供了横跨整个属的结构和调控基因组演化的视图,为基因组演化产生了新的见解,并为利用野生多样性进行大麦改良奠定了基础。
大麦属物种组装与泛基因组
为最大限度覆盖该属的系统发育代表性,我们选取了27份材料,代表24个Hordeum物种,涵盖所有已确认的二倍体基因组群1以及代表性的四倍体和六倍体谱系(Extended Data Fig. 1a、Supplementary Table 1和Supplementary Figs. 1–25)。该数据集包括22份二倍体材料、4份四倍体材料和1份六倍体材料。利用PacBio HiFi高精度长读长和Hi-C数据,采用TRITEX流程26,27组装了24个基因组序列(Supplementary Tables 2和3以及Supplementary Figs. 26–28)。H. vulgare和H. bulbosum的序列组装来自我们此前的工作10,28。此前发表的Hordeum marinum H559染色体水平组装(ref. 29)使用TRITEX流程进行了更新,并使用了此前发表的Hordeum erectifolium NGB6816的转录组数据、Bionano光学图谱和Hi-C数据30。组装的contig N50平均为39.24 Mb。二倍体物种的组装大小为2.90 Gb至4.48 Gb(平均3.92 Gb),四倍体物种为7.49 Gb至8.56 Gb(平均8.16 Gb),而唯一的六倍体基因组组装大小为10.90 Gb。叶绿体基因组组装为136,335 bp至137,079 bp(平均136,840 bp)(Supplementary Table 1)。高组装质量得到平均长末端重复序列(LTR)组装指数(LAI)14.79、共识质量值(QV)67.30和k-mer完整度97.22%的支持(Supplementary Table 4)。对于杂合二倍体物种H. bulbosum,两个分型单倍型分别命名为Hap1和Hap2。对于多倍体物种,源自不同祖先基因组的独立组装染色体组被定义为亚基因组,并依据其与二倍体祖先谱系的系统发育关系命名为Sub1、Sub2和Sub3(Fig. 1a)。为评估Hordeum泛基因组的基因含量,我们使用转录组数据对所有基因组进行了注释(Methods和Supplementary Tables 5和6)。采用基因整合方法以确保基因预测的高度可比性,包括对Hordeum parodii(6x)和Hordeum gussoneanum(4x)的预测。鉴定出的高置信基因模型数量从二倍体Hordeum murinum的35,573个到六倍体H. parodii的94,943个不等(Supplementary Table 7)。我们使用BUSCO(v5.8.0)和poales_odb12数据集评估了Hordeum基因注释的质量,该数据集包含来自Poales的6,282个近乎通用的单拷贝直系同源基因。平均而言,97.35%的BUSCO基因被鉴定为完整,0.69%为片段化,1.84%为缺失(Supplementary Table 7)。使用OMArk和PSAURON进行的独立基准测试进一步证实了基因注释的高完整性和整体质量(Supplementary Table 7)。使用panEDTA流程31进行的转座元件(TE)注释显示,转座子平均占基因组的86.12%,范围为83.27%至90.35%(Supplementary Table 8)。
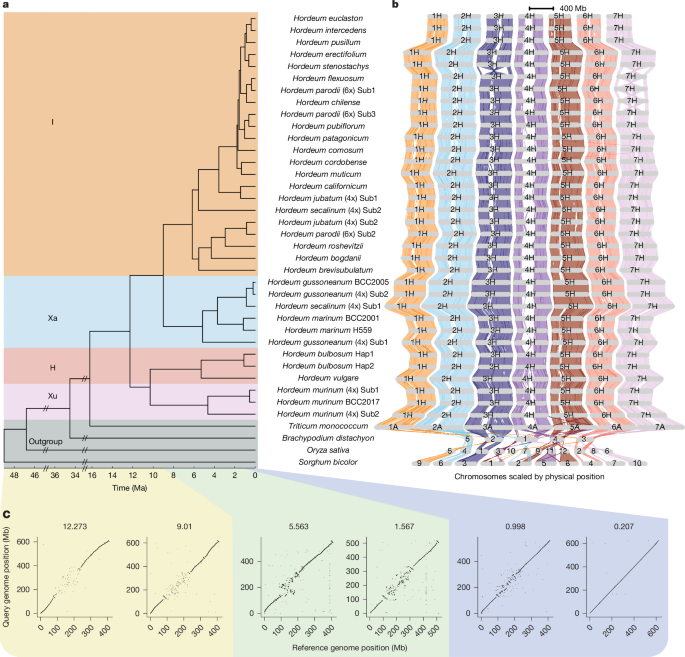
a,Hordeum 属物种的系统发育树。以 Sorghum bicolor、Oryza sativa、Brachypodium distachyon 和 Triticum monococcum 作为外类群。分歧时间利用全基因组单拷贝基因中的 4DTV 位点推断,此前已排除在 Extended Data Fig. 6c 中识别出的具有强系统发育不一致性(nRF > 0.21)的基因组区域。彩色矩形代表不同的基因组组。Hap1 和 Hap2 代表杂合二倍体 H. bulbosum 的定相单倍型,Sub1、Sub2 和 Sub3 表示多倍体物种中不同的祖先亚基因组。背景颜色代表物种的基因组组,从上到下顺序为:I、Xa、H、Xu 和外类群物种。b,34 个 Hordeum haplomes 和四个外类群基因组之间的 GENESPACE 共线性图。灰色条代表按基因组位置排列的染色体。为便于可视化,较小外类群基因组(S. bicolor、O. sativa 和 B. distachyon)的染色体按比例放大了五倍。c,不同时间分化的基因组间 4H 染色体的点图比较。从每个系统发育节点随机选择两个物种进行序列比对(Supplementary Table 11)。展示了六个代表性比较,其余比较见 Extended Data Fig. 3a。每个比对顶部显示的数字表示 x 轴所示物种与 y 轴所示物种之间的估计分化时间。
Hordeum 属的结构与调控演化
基于所有物种的注释基因集,我们构建了一个基于基因的 Hordeum 泛基因组。总体而言,42.4% 的基因被归类为核心基因,56.5% 为壳基因,1.1% 为云基因(扩展数据图 1b,c)。基因本体富集分析显示,磷酸化和激酶相关功能在核心基因中富集,ATP 和 RNA 结合在壳基因中富集,防御反应和氧化应激反应在云基因中富集(补充图 29)。核苷酸结合富含亮氨酸重复(NLR)基因是植物免疫系统的关键组成部分,在抗真菌和其他病原体32,33中具有重要作用。绘制其多样性图谱对于推进我们对作物抗病机制的理解至关重要。对 NLR 基因的分析显示,I 基因组物种所含 NLR 基因显著多于其他 Hordeum 基因组类群(Welch’s t 检验,P = 1.8 × 10⁻⁶)(扩展数据图 2a,b)。为进一步刻画这一多样性,我们构建了跨 Hordeum 单倍体基因组当量(haplomes)的 NLR 泛基因组,包含 800 个直系同源组,其中 13.75% 被归类为核心基因家族,27.75% 为壳基因家族,58.50% 为云基因家族(扩展数据图 2c)。此外,NLR 基因簇在 4H 和 5H 染色体上的丰度显著低于其余染色体(Wilcoxon 检验,P < 2.2 × 10⁻¹⁶)(扩展数据图 2d)。同样,对五肽重复(PPR)蛋白和线粒体转录终止因子(mTERFs)的全基因组分析显示,相较于 H 和 Xu 基因组类群,I 和 Xa 基因组类群中育性恢复样(RFL)亚组显著扩张。由于 RFL 蛋白参与携带细胞质雄性不育(CMS)34 的植株中的育性恢复
Hordeum 属的结构与调控演化
先前的研究基于质体和部分基因序列1,17推断了 Hordeum 物种间的演化关系。然而,部分物种间的关系仍支持较弱。在本研究中,我们利用全基因组单拷贝基因集重建了一棵最大似然树。与先前的系统发育树1,17不同,我们的物种树以最大自举支持率解析了所有主要演化关系,尤其是在近期分化的 I 基因组物种之间(Supplementary Fig. 35)。为进一步评估这些关系的稳健性,我们使用 ASTRAL-Pro3(Supplementary Fig. 36)重建了一棵独立的基于溯祖的物种树,该方法整合了各个最大似然基因树;并利用 CASTER 从全基因组多序列比对(MSAs)推断出全基因组系统发育(Supplementary Figs. 37 和 38)。我们还利用四倍简并第三密码子颠换(4DTV)位点估计了这些物种的分化时间,并排除了被鉴定为可能源自古老杂交的基因组区域(Supplementary Table 13)。我们估计 H 与 Xu 的分化时间为 10.3 百万年前(Ma),而 I 与 Xa 约在 9 Ma 分化。Hordeum 的冠群年龄可追溯至约 12.27 Ma(Fig. 1a 和 Supplementary Table 10)。小麦族(Triticeae)物种的染色体在其远端区域表现出高度共线性36,Hordeum 中也同样如此(Fig. 1b)。然而,比对时近端区域表现出显著的共线性丢失和高度碎片化的比对。跨 Hordeum 物种的全基因组比较显示,染色体重排随着演化分化逐步累积,导致染色体近端区域的共线性丢失和比对日益碎片化(Fig.1c,Extended Data Fig. 3a,Supplementary Figs. 39–44 和 Supplementary Table 11)。对所有 Hordeum 单倍体组的反向取向比对的定量分析进一步表明,在 Hordeum 演化过程中,推定倒位在染色体近端区域积累的速度显著快于远端区域(Supplementary Fig. 45)。在七条染色体中,4H 染色体表现出最广泛的近端共线性丢失(Supplementary Table 12)。近期分化的物种尽管存在大量结构变异,仍保留了强烈的染色体尺度共线性;而深度分化的 H–Xu 与 Xa–I 基因组组(超过 9 Ma)之间的比较则显示近端共线性几乎完全碎片化(Fig. 1c,Extended Data Fig. 3a 和 Supplementary Figs. 39–44)。为估计非共线性区域的大小,我们应用归一化覆盖度来鉴定分化超过 9 Ma 的物种中的这些区域(Extended Data Fig. 3c,d,Supplementary Figs. 46–50 和 Methods)。总之,我们确定了 Hordeum 中非共线性区域在染色体上的全基因组分布,在 H. vulgare 基因组中鉴定出的累计大小为
大结构变异揭示杂交
与近端区域中发现的动态结构变异不同,远端区域表现出更为保守、共享的结构变异。这表明,近端区域广泛的共线性丢失,阻碍了在亲缘关系更远的 Hordeum 物种之间可靠地鉴定结构变异。值得注意的是,远端区域的大结构变异主要是倒位。在 3H 和 7H 染色体上,我们鉴定出两个几乎跨越整条染色体、并在多个物种中存在的大倒位(扩展数据图 4d)。在 Hordeum 物种中共鉴定出 1,407 个大于 2 Mb 的倒位(扩展数据图 4d)。通过构建全面的倒位图谱,我们发现在 1H 染色体上有六个倒位出乎意料地在不同系统发育谱系之间共享(图 2a 和扩展数据图 5)。我们假设这些大规模结构变异可能源于涉及大段染色体片段的渗入事件。我们利用这些区域的单拷贝基因集构建系统发育树来检验这一假设。所得的树以最大 bootstrap 支持率得到解析,确认这些结构变异在 I 基因组组的一个分支与 H–Xu 基因组组之间共享(图 2b)。此外,在推断的杂交事件之后的 1.68 百万年内,10 个现存二倍体 Hordeum 物种发生了多样化,而同一时期其他系统发育谱系中没有发生可比的辐射(图 1a 和 2b 以及扩展数据图 5)。值得注意的是,这一替代的系统发育拓扑结构跨越约 200 Mb 的连续染色体区域,而非孤立位点,表明染色体尺度单倍型的遗传,这更符合古代渗入,而不是随机的基因树不一致或不完全谱系分选。
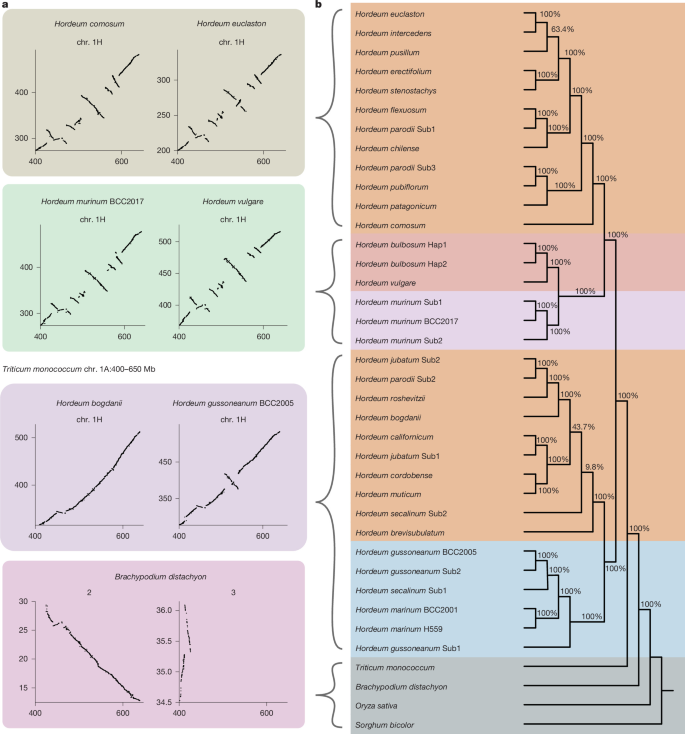
a,T. monococcum 与为清晰起见选出的七个代表性基因组之间 chr. 1A:400–650 Mb 区域的点阵图比较。其余基因组比较见扩展数据图 5。颜色表示不同的聚类,并且在该面板与扩展数据图 5 之间保持一致。b,基于 T. monococcum chr. 1A:400–650 Mb 区域内单拷贝基因的系统发育树。彩色矩形代表不同的基因组组。bootstrap 值显示在每个节点下方。基于拼接的局部单拷贝基因的近似无偏(AU)检验支持局部树(p-AU = 1.0),并拒绝参考树(p-AU = 1.4 × 10−42)。
文章标题:大麦属的结构与调控演化
正文: 为鉴定该属中更多古代杂交的印记,我们开发了一种基于单拷贝基因间局部系统发育不一致性的全基因组扫描方法。将单拷贝基因集划分为滑动窗口,并计算局部系统发育树与全基因组物种树之间的归一化Robinson–Foulds(nRF)距离(Extended Data Fig. 6a)。nRF值的峰值表示其系统发育历史偏离物种树的基因组区域,因此代表候选的渐渗事件。在此,我们将杂交足迹定义为在多个后代物种间共享、且持续表现出相对于全基因组物种树的替代系统发育关系的大染色体片段。使用源自全基因组nRF分布的经验阈值0.21来区分不一致性峰值与背景变异(Extended Data Fig. 6b and Supplementary Fig. 52),我们恢复了染色体1H的杂交信号,验证了该全基因组扫描方法。此外,我们在多个区域检测到超过十个具有强烈系统发育不一致信号的连续窗口(Extended Data Fig. 6c and Supplementary Fig. 52)。为进一步探究这些不一致性的潜在原因,我们利用这些区域的单拷贝基因集重建了局部系统发育树(Extended Data Fig. 6e,f, Supplementary Figs. 53–58 and Supplementary Table 13)。局部系统发育在较大染色体片段上持续支持某一特定替代关系的区域,被解释为古代杂交的证据。通过比较表现出系统发育不一致的区域与全基因组树,我们在Hordeum jubatum中鉴定出两次大规模片段交换,具有最高的bootstrap支持度(Extended Data Fig. 6e,f and Supplementary Table 13)。令人惊讶的是,这一大规模片段交换解释了此前相对于H. vulgare参考基因组在染色体5H上鉴定出的主要重复与缺失模式(Supplementary Figs. 12, 56, 59 and 60)。两个H. jubatum亚基因组中被交换的区域各自与不同的祖先基因组关系更近,表明表观的重复与缺失源于祖先片段交换,而非独立的拷贝数变化。(Extended Data Fig. 6d)。在异源四倍体H. gussoneanum中,在染色体2、5和7上检测到两个亚基因组之间广泛的片段交换(Extended Data Fig. 6e, Supplementary Figs. 53, 55 and 57 and Supplementary Table 13)。在异源六倍体H. parodii中,亚基因组1在染色体7上携带一段源自Hordeum stenostachys的大染色体片段,而亚基因组2和3在染色体4上表现出额外的片段交换(Extended Data Fig. 6f, Supplementary Figs. 54, 55 and 58 and Supplementary Table 13)。总之,这些兆碱基规模的结构变异保留了古代种间杂交和大规模染色体交换的印记,而这些印记仅凭全基因组系统发育无法显现,为Hordeum复杂的演化历史提供了新的见解。
Horizontal gene transfer
Hordeum 属的结构与调控演化
遗传变异对物种演化至关重要。除有性生殖外,水平基因转移(HGT)可作为获取新基因的演化捷径。传统上认为 HGT 在维管植物中罕见,但基因组学的进展已揭示 HGT 广泛发生,挑战了此前的假设37,38。我们先前的研究表明 Hordeum 中存在广泛的 HGT。值得注意的是,stenostachys 组(I 基因组;22 个二倍体物种中的 16 个)内的物种拥有从 Panicoideae 亚科禾草(例如 Panicum、Paspalum 和 Setaria)获得的核糖体 DNA(rDNA)39,40。最古老的转移(来自 Panicum)估计发生在 5 至 1.7 Ma 之间,导致 5H 染色体上出现大的基因组插入,其中一些跨度超过 400 kb,并包含 TEs 和蛋白编码基因41。在此,我们在 20 个二倍体 Hordeum 物种中鉴定了源自 Panicoideae 的核基因,并以 H. vulgare 作为阴性对照39,41。我们的分析揭示了 611 个外源基因,对应 126 个直系同源组,主要匹配 Paspalum(63%)和 Panicum(22%)(扩展数据图 7a 和补充表 14 和 15)。HGT 的程度各不相同,Hordeum flexuosum 携带的外源基因数量最多(68 个基因对应 43 个直系同源组)(扩展数据图 7a)。这些发现与表明禾草频繁交换遗传物质的研究一致42,43。HGT 频率与 Hordeum 系统发育相关,地中海和西亚物种表现出的转移基因少于其南美对应物种。这支持 HGT 对真核生物演化具有累积影响的假说44。H. bulbosum 和 H. murinum 中存在单个 panicoid 基因,可通过来自 I 基因组物种的 1H 染色体片段渐渗来解释,而不是通过早于 Hordeum 多样化的早期 HGT 事件来解释(图 2b 和扩展数据图 6c)。染色体定位表明,水平转移基因分布在 Hordeum 全部七条染色体上,其中 5H 染色体携带的数量最多(扩展数据图 7b)。这些基因在染色体臂的远端区域显著富集。尽管远端区域通常具有更高的局部基因密度,但负二项回归分析显示,基因密度只能解释观察到的 HGT 丰度变异的一小部分(pseudo-R2 = 0.034;补充图 61),表明仅凭更高的基因密度不能解释 HGT 基因的远端富集。尽管基因的共转移仍不确定,但先前的研究提示,大片段外源 DNA 可能一起转移41,43。相当一部分(126 个中的 82 个)源自 Panicoideae 的直系同源组缺乏天然的 Hordeum 同源基因,表明获得了新基因。功能注释提示,这些基因可能在生长素运输、光响应和转录调控等关键生理过程中发挥作用。RNA 测序(RNA-seq)分析在 126 个直系同源组中的 73 个中检测到至少一个表达的 HGT 基因(扩展数据图 7c 和补充表 16)。这些基因的潜在适应性意义值得进一步研究。我们的全属分析确立了 Hordeum 作为研究 HGT 演化影响的模式系统。
Hordeum 中的 TE 演化
Hordeum 属的结构与调控演化
Hordeum 物种的基因组组装大小范围为 2.90 Gb 至 10.9 Gb,并与先前的流式细胞术估计值45高度相关(图 3a)。在考虑多倍化的直接影响后,单倍体基因组表现出 2.85 Gb 至 4.68 Gb 的假分子大小。除在 H. jubatum 的一个亚基因组中检测到 19 Mb 重复外,未鉴定到大的重复事件(补充图 59–60)。总 TE 含量与单倍体基因组大小之间观察到强相关(图 3b),证实 TE 积累显著促进了 Hordeum 中的基因组大小变异。LTR 逆转录转座子被确定为这些变化的主要驱动因素,尽管 DNA 转座子也发挥作用(图 3c)。对各个转座子超家族的相关分析显示,多个 TE 家族促成了基因组大小变异,但总体 TE 丰度仍是单倍体基因组大小的最强预测因子(补充图 62a)。我们选取了 TREP 数据库中注释的平均含量高于 20 Mb 的转座子,并检查了它们在不同 Hordeum 单倍体基因组中的变异。这些 TE 家族清楚区分了 Hordeum 的主要演化谱系(补充图 62b)。为更详细地研究谱系特异性 TE 动态,我们聚焦于三个 LTR 逆转录转座子家族(BARE1、Sabrina 和 BAGY2),并使用 TEpop46 重建其多样化历史。TE 亚家族与主要 Hordeum 支系密切对应(图 3d 和扩展数据图 8a,b),表明谱系特异性扩增历史促成了基因组大小演化。
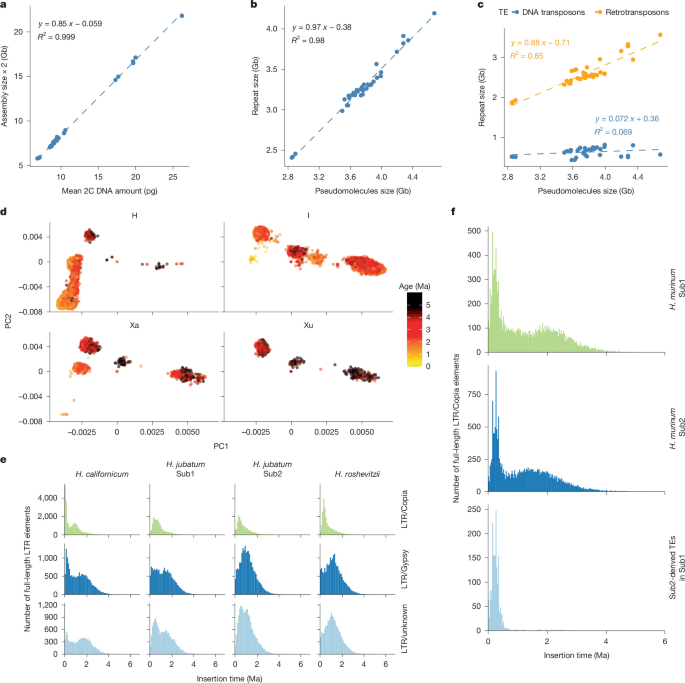
a,组装大小与 DNA 含量之间的共线性(n = 25,双侧线性回归,P < 2.2 × 10⁻¹⁶)。b,假分子大小与 TE 含量之间的共线性(n = 34,双侧线性回归,P < 2.2 × 10⁻¹⁶)。c,假分子大小与逆转录转座子(n = 34,双侧线性回归,P = 1.24 × 10⁻¹⁴)和 DNA 转座子含量(n = 34,双侧线性回归,P = 0.134)之间的相关性。d,对 Hordeum 物种中 68,707 条全长 RLG_BAGY2 逆转录转座子序列进行主成分分析(PCA)。每个点代表一个逆转录转座子;颜色表示估计插入时间(Ma)。e,H. jubatum、H. californicum 和 Hordeum roshevitzii 中全长 LTR 元件的插入时间分布。H. californicum 和 H. roshevitzii 分别是 H. jubatum1 中亚基因组1和2的二倍体祖先。f,基于亚基因组间共享的全长 LTR/Copia 元件,推断四倍体 H. murinum subsp. murinum(BCC 2009)在异源多倍化后的 TE 插入动态。亚基因组来源的 TE 表示在一个亚基因组中检测到的 TE 插入,这些插入与另一个亚基因组共享,但在相应二倍体祖先中缺失,反映了亚基因组融合后的 TE 积累。插入峰的开始指示异源多倍体形成的估计时间。H. murinum subsp. glaucum(BCC 2017)是 BCC 2009 中亚基因组1的二倍体祖先(ref. 1)。
为研究多倍体化后的 TE 进化,我们比较了三个独立形成的四倍体基因组的 TE 景观与其二倍体祖先的 TE 景观。这三个多倍体物种表现出不同的演化轨迹。在 H. murinum 中,TE 扩张很小(Extended Data Fig. 8c 和 Supplementary Table 17)。在 H. jubatum 中,两个亚基因组都小于其各自的二倍体祖先(Fig. 3e 和 Supplementary Table 17)。相比之下,Hordeum secalinum 经历了广泛的 TE 增殖,导致基因组显著扩张(Extended Data Fig. 8d 和 Supplementary Table 17)。值得注意的是,相对于二倍体祖先,LTR/Gypsy 元件扩张最大,因此对 H. secalinum 的基因组扩张贡献最大(Supplementary Table 17)。此外,Vagabond TE 家族在四倍体化后表现出重新活跃,其在四倍体基因组中的活性显著高于其任一相关二倍体祖先或另一个亚基因组中的活性(Extended Data Fig. 8e 和 Supplementary Figs. 63 和 64)。为避免亚基因组之间大规模片段交换引入的偏倚,我们在估计 TE 插入年龄之前排除了推测源自古老杂交的基因组区域(Supplementary Table 13 和 Supplementary Fig. 65)。尽管仅凭亚基因组分化无法精确确定四倍体形成的时间,但多倍体化后的 TE 动态可以从 TE 插入中重建。具体而言,我们根据仅在各亚基因组之间共享、而在其各自二倍体祖先中缺失的全长 TE 的插入年龄,推断了亚基因组融合的时间(Fig. 3f、Extended Data Fig. 8f,g 和 Supplementary Figs. 65 和 66)。这些共享插入必定发生在多倍体形成之后,从而为多倍体基因组的起源及随后的 TE 活性提供了时间信息。我们的发现强调,TE 含量是 Hordeum 中基因组大小变异的主要决定因素。相对于二倍体祖先,四倍体化并不总是导致基因组扩张;我们还观察到基因组收缩。尽管如此,多倍体化后的 LTR 插入为多倍体形成时间提供了独立估计,并为四倍体和六倍体 Hordeum 基因组的演化历史提供了新见解。
物种间的序列保守性
全基因组 MSAs 为研究跨物种的序列保守性与分化提供了框架。因此,我们使用 Progressive Cactus47 生成了 Hordeum 单倍型基因组的全基因组 MSA。总共,我们在 Hordeum 基因组中鉴定了 170.4 Mb 的共享比对序列(Extended Data Fig. 9a)。正如预期,快速进化的着丝粒周边区域显示出较少的比对,而染色体远端表现出更高的比对密度(Extended Data Fig. 9b)。这些比对的快速缩减可能归因于过去 1200 万年中 TE 活动对 Hordeum 基因组的显著重塑。为进一步研究不同功能基因组区域中的序列保守性,我们分析了通过转座酶可及染色质测序(ATAC–seq)鉴定的开放染色质区域,以及八个 Hordeum 单倍型基因组中注释的基因组特征(Supplementary Table 18)。非翻译区序列是保守性最高的非编码区域,并且在大麦与小麦分化之前以较慢的速度丢失。相比之下,开放染色质区域表现出与内含子相似的丢失模式,而启动子区域经历了更快速的更替(Extended Data Fig. 10a)。此外,我们使用 phastCons 在 Hordeum 基因组中鉴定了 74.7 Mb 的保守元件(Extended Data Fig. 10b,c)。在所有保守碱基中,69.0% 与注释基因重叠,6.0% 与开放染色质区域重叠。相反,44.7% 的注释基因碱基和 31.9% 的开放染色质碱基与保守元件重叠。保守元件在注释基因(优势比 = 138.0)和开放染色质区域(优势比 = 27.4)中均显著富集,且在基因中的富集明显更强,表明编码序列受到的进化约束强于调控区域(Extended Data Fig. 10c)。
总体而言,我们的研究结果表明,调控元件经历的进化更替显著快于编码序列,产生广泛的调控变异,这可能为大麦改良提供有价值的等位基因来源。相比之下,编码基因的高度保守性为比较功能分析和生物学知识的跨物种转移提供了机会。
春化作用的自然变异
在栽培大麦中,春性和冬性生长习性在很大程度上由春化基因 VERNALIZATION 1(VRN1)和 VERNALIZATION 2(VRN2)决定;VRN1 是 MADS-box 转录因子,VRN2
对 Hordeum 基因组中 VRN1 的检查揭示了由 TEs 引起的启动子和调控性第一内含子(5.7 kb 至 19.5 kb)的广泛变异(补充表 19)。为评估这一变异的功能效应,我们在非春化条件下、以 14 h 光照:10 h 黑暗的光周期,记录了 14 个野生 Hordeum 物种和 4 个栽培大麦对照的开花时间(图 4a 和扩展数据图 11a)。值得注意的是,Hordeum cordobense 和 Hordeum muticum 开花迅速(约 61 天),超过春性大麦品种(图 4a)。这两个物种在 VRN1 第一内含子关键区域51 共享一个独特的 79-bp 缺失,提示其在降低春化需求中起作用(扩展数据图 11b)。所有物种均含有 VRN2 位点,携带 1 至 7 个 ZCCT 拷贝(补充表 19)。一个关键发现是,在 H. cordobense、Hordeum californicum、H. muticum 和 H. jubatum 中存在两个 ZCCT 基因的反向重复(补充图 67)。由于反向重复可能触发 RNA 干扰(RNAi)53,我们预期 VRN2 被沉默并出现春性表型。令人惊讶的是,只有 H. cordobense 和 H. muticum 开花较早(图 4a,c 和扩展数据图 11a)。对 H. cordobense 的详细分析显示,ZCCT-1 因提前终止密码子而无功能,并且 ZCCT-2/ZCCT-3 反向重复连接区缺少多腺苷酸化信号,从而导致通读转录(检测为异常 mRNA 转录本)、发夹 RNA 形成和小 RNA 产生(图 4b,d、扩展数据图 11c 和补充图 68)。冬性 H. californicum 携带额外的功能性 ZCCT 拷贝,并在反向重复连接区具有多腺苷酸化信号,这可能阻止了 RNAi,从而维持 VRN2 的抑制功能(图 4b,e)。这与所分析物种中 VRN1、VRN2 及其靶标 FLOWERING LOCUS T1(FT1)的表达一致(图 4f)。这些发现突显遗传多样性塑造了 Hordeum 的春化作用。所研究的类春性材料携带 79-bp 的 VRN1 缺失以及被破坏或沉默的 VRN2,而类冬性基因型保留功能性 ZCCT 拷贝。综合来看,我们的结果表明,野生 Hordeum 物种对春季生长习性的适应靶向了与栽培大麦相同的基因和变异类型,指向保守的开花时间适应机制。
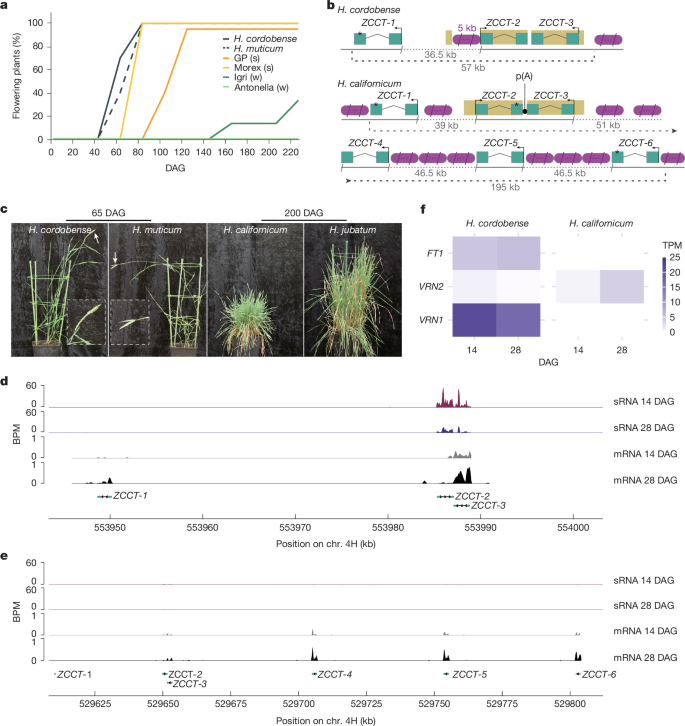
a,在非春化条件下开花的 H. cordobense 和 H. muticum 植株百分比(每个物种 n = 10)。品种 Golden Promise(GP)和 Morex 作为春性(s)对照,
文章标题:Hordeum 属的结构与调控演化
颖片是禾本科中一种独特的花器官,在双子叶植物中缺乏直接对应物54。它表现为一对或多对类似苞片的结构,承托单个或多个可育小花。颖片的大小和形状差异很大,从 Triticum 物种中类似外稃的大型结构到 Oryza 中退化的腋芽。在野生禾草中,颖片形态影响种子传播、繁殖成功以及对生物胁迫的防御55。在栽培谷类作物中,驯化倾向于减小颖片大小和粗糙度,便于脱粒。在 Hordeum 中,每朵小花具有一对位于 periaxial side 的颖片,不同物种间在长度、宽度和芒的延伸方面存在相当大的变异(图 5a)。对五个携带 I 基因组的二倍体物种(H. erectifolium、Hordeum pusillum、Hordeum intercedens H. stenostachys 和 Hordeum euclaston)进行转录组分析,鉴定出在早期(Waddington 阶段 3–6(W3–6))和晚期(W9–10)发育阶段的幼穗中表达的穗特异性基因56(Supplementary Table 21)。如果基因在分析的 13 个组织中的其余 11 个组织中的转录本丰度低于其在 2 个穗样本中合计表达的 5%,则被归类为穗特异性
Hordeum 属的结构与调控演化
本文提供的染色体级别基因组组装为研究 Hordeum 属的演化历史提供了基础。染色体级别分辨率使我们能够研究结构变异如何塑造基因组演化,尤其是在破坏染色体共线性方面。传统上,禾本科基因组被认为具有相对稳定的染色体结构58;然而,我们的发现挑战了这一假设。广泛的结构变异和染色体重排对基因组分化产生了实质性贡献,最终导致近端区域共线性近乎完全丧失。这些重排不仅标志着演化分化,也为理解 Hordeum 内物种形成所依赖的过程提供了见解。结构变异在染色体不同区域以显著不同的速率积累。近端区域表现出高变异性,而远端区域演化得更慢。这种不均衡的演化速率保留了该属内古老杂交事件的足迹,提供了种间基因流动的历史记录。这些发现为 Hordeum 演化过程中的古老杂交和基因组融合提供了经验证据,并为未来种间育种工作中识别相容基因组片段建立了框架。
然而,本研究中鉴定出的大片段倒位是否有助于适应性演化、生殖隔离或其他表型后果仍属未知,值得未来进行功能研究。全基因组 MSA 使我们能够比较 Hordeum 物种间的全基因组保守性。与通常表现出较强种间保守性的动物基因组相比,植物基因组——尤其是在 Hordeum 这类快速演化的属内——会经历由短世代时间和快速转座子扩张驱动的动态变化。这些过程推动了植物基因组持续重塑,导致即使在近缘分类群之间也存在高变异性。尽管演化如此迅速,许多基因仍然保持保守,而调控元件则表现出相当大的更替。这种对比提供了独特的机会:谱系特异性调控创新可用于作物改良,同时核心基因功能得以保留。例如,与春化响应相关的调控元件被发现因 Hordeum 物种而异,提示可以将新的调控变异引入栽培大麦,以精细调控开花行为。除了扩展 Hordeum 的基因组资源外,这项工作还为研究结构基因组演化、重建复杂演化历史以及利用遗传和调控多样性改良大麦提供了框架。
方法
植物材料
植物材料获自 Institut für Pflanzgenetik und Kulturpflanzenforschung (IPK) Gatersleben、美国农业部和 Nordic Genetic Resource Center 的种质库。登录号列于补充表 1。
HMW DNA 提取与 HiFi 测序
植物在温室条件下生长,并按照已发表方案10,60从幼嫩叶片组织分离高分子量(HMW)DNA。HiFi 文库构建和使用 PacBio Sequel IIe 仪器(Pacific Biosciences)进行的环形一致性测序基本如先前所述19。HiFi 测序在 IPK Gatersleben、Heinrich Heine University 的 Genomics and Transcriptomics Laboratory、Berry Genomics Co.、Novogene 以及 University of Wisconsin Biotechnology Center DNA Sequencing Facility 完成。
Hi-C 测序
Hordeum 属的结构与调控演化
原位 Hi-C 文库按先前发表的方案从幼苗制备,使用 DpnII 消化交联染色质。文库按文献 61 所述制备。样品按文献 62 定量,并使用 Illumina 标准方案在 IPK Gatersleben 和 Novogene 的 Illumina NovaSeq 6000 设备(Illumina)上测序。
光学基因组作图与混合支架构建
使用 PacBio HiFi 测序的同一株 H. erectifolium 个体的一个克隆用于构建光学基因组图谱(OGM)。通过流式细胞术从幼叶中纯化的总共 250 万个细胞核被包埋于琼脂糖微型胶块中,并按照 Šimková 等 63 的方案用蛋白酶 K 处理。总共 525 ng 的 HMW DNA 使用标准 Bionano Prep Direct Label and Stain 方案(Bionano)在 DLE-1 识别位点直接标记,并在 Bionano Saphyr 平台上分析。所得数据集包含 1.5 Tb 单分子数据,N50 为 247 kb,为 H. erectifolium 基因组提供了约 341× 覆盖度。该数据集用于使用 Bionano Solve 软件(v3.6.1_11162020)和标准配置文件 optArguments_nonhaplotype_noES_noCut_DLE1_saphyr.xml 生成从头 OGM 组装。
为提高 PacBio HiFi 组装的连续性,使用 OGM 组装运行了 Bionano Solve 中集成的自动混合支架流程。应用默认 DLE-1 Hybrid Scaffold 配置文件,并使用 ‘resolve conflict’ 选项进行冲突解决。序列组装与 OGM 之间的冲突经人工整理,随后使用修改后的 conflict_cut_status.txt 文件重新运行该流程。
转录组测序
植物在温室条件下生长,使用 RNAeasy Plant Mini Kit(Qiagen,Hilden,Germany)或 Trizol 试剂(Invitrogen)按照制造商方案从不同组织和发育阶段(补充表 5)分离总 RNA。RNA-seq 在代表特定发育阶段或组织类型的重复混合样本上进行。单样本 RNA-seq 和 RNA 混合物的 PacBio IsoSeq 按先前所述 10 进行。文库构建和测序在 Illumina NovaSeq 6000 设备(Illumina RNA-seq)和 PacBio Sequel IIe(仪器)上完成,地点为 IPK Gatersleben、Biomarker Technologies(BMK)、Heinrich Heine University Düsseldorf 的 Genomics and Transcriptomics Laboratory、Kazusa DNA Research Institute 或 Berry Genomics。PacBio IsoSeq 测序数据使用 isoseq3(v3.8.2)流程处理(PacBio - IsoSeq3, 2018/2024)。使用 refine -require-polya-min-polya-length 12 teloprime.fasta 修剪 ploy-A 尾并去除串联转录本。为生成非冗余转录本,我们使用 pbmm2(v1.10.0)align -preset ISOSEQ -sort -bam-index CSI 将全长非串联读段比对到基因组,并使用 isoseq3 collapse -do-not-collapse-extra-5exons 折叠冗余转录本。
基因组组装
文章标题:大麦属的结构与调控演化
正文: 使用 hifiasm(v0.13-r308 或 v0.15.5-r350 或 v0.16.1-r375)64 组装 PacBio HiFi reads。使用 TRITEX 流程26,27 构建假分子,并基于对 Hi-C 接触矩阵的人工检查纠正嵌合 contig 或方向错误。对于异源四倍体物种,使用先前开发的单倍型解析基因组组装策略10 对亚基因组进行分型。亚基因组的起源及其潜在祖先贡献者此前已由 Brassac 等人1 详细研究。为对多倍体基因组中的亚基因组进行分类,使用 Mash(v2.3)65 计算多倍体染色体与候选祖先基因组之间的成对染色体相似性。所得距离矩阵用于推断亚基因组起源和关系。在高杂合度或异交物种(H. brevisubulatum 和 H. murinum BBC2017)中,在 hifiasm(v0.15.5-r350)64 组装过程中纳入 Hi-C 数据,以合并单倍型并组装代表性单倍体基因组。H. erectifolium 除外,其初级 contig 首先使用 Bionano 光学图谱进行混合支架化,随后使用 Hi-C 数据和 TRITEX 流程30 构建假分子。叶绿体基因组按照先前发表的方案10 组装。使用 minimap2(v2.24-r1122)66 以参数 -ax map-hifi–secondary=no–sam-hit-only 将 HiFi reads 比对到大麦 cv. Morex 叶绿体基因组(GenBank 登录号 EF115541)。比对质量 <30 的比对被丢弃。比对上的 reads 使用 SAMtools(v1.16.1)67 转换为 FASTQ 格式,并使用 Canu(v2.1.1)68 在 PacBio HiFi 模式下组装,基因组大小从 120 到 400 kb,以 10-kb 递增。使用 BEDTools(v2.30.0)69 识别并修剪环状序列,并使用 GeSeq70 注释。完全注释的组装使用 MUMmer4(v4.0.0beta2)71 比对到 Morex 叶绿体基因组,并使用 seqkit(v0.9.1)72 调整 SSC 区域的起始位置和方向以匹配参考。使用 Jellyfish(v2.2.6)73 计算 k-mer 频率,并使用 findGSE(v1.94)74 分析以估计基因组特征。使用 Merqury(v1.3)75 评估组装质量,包括 QV 和 k-mer 完整性。
Hordeum 泛基因组的从头基因注释
我们按照 Mascher 等人28 描述的方案进行了从头结构基因预测、置信度分类和功能注释。作为证据,我们使用了上文所述的 RNA-seq 和 IsoSeq 数据,以及从 UniProt76 下载的经 Poales 过滤的蛋白质序列(2023 年 7 月)。使用 liftoff77 工具进行了额外的整合步骤。简言之,将一个物种的所有预测基因模型迁移到所有其他基因组上。使用 Mikado78,我们选择了最佳映射的基因模型,并相应地统一了所有基因预测。我们将预测的蛋白质分为高置信度和低置信度类别。高置信度蛋白质覆盖度超过 80% 且完整,要么在 UniMag 或 UniPoa 中有显著命中但不在 PTREP(https://trep-db.uzh.ch)中。低置信度蛋白质不完整,在 UniMag 或 UniPoa 中有命中但不在 PTREP 中,或者完整但在任何数据库中都没有命中。
我们使用 BUSCO(v5.8.0)79(数据集:poales_odb12)、OMARK(omamer verision 2.1.0/omark v0.3.1)80 和 psauron(v1.0.6)81 对注释进行了基准测试。
基于基因的 Hordeum 泛基因组构建
文章标题:大麦属(Hordeum)的结构与调控演化
基于27个已注释的Hordeum种质资源的初级蛋白质序列,使用Orthofinder(v2.5.5)82计算了直系同源组。用于计算核心、壳层和云基因的脚本已存放在 https://github.com/PGSB-HMGU/BPGv2 仓库中。核心基因包含来自所有27个比较种质资源的至少1个基因模型。壳层基因包含来自至少2个且至多26个Hordeum种质资源的基因模型。仅与来自同一基因型的基因聚类的基因被定义为云基因。在整合步骤中未纳入H. vulgare Morex和H. bulbosum的注释。因此,为抵消这两个物种在核心、壳层或云类别中任何潜在的过度或不足呈现,我们将H. vulgare cv. Morex和H. bulbosum的所有云基因回比对到所有其他基因组,并对任何缺失基因进行了校正。基因本体论术语富集分析使用goatools(v1.4.4)83进行。基于基因的共线性图使用GENESPACE84绘制。
核苷酸结合抗性基因的泛基因组分析
使用RGAugury(v2.2)85流程从我们的注释中鉴定核苷酸结合位点(NB-ARC)结构域编码基因,并根据结构域和基序结构将其分类为不同亚组:TNL包含TIR、NBS和LRR结构域;CNL包含CC、NBS和LRR结构域;RNL包含RPW8、NBS和LRR结构域;RN仅包含RPW8和NBS结构域;NL包含NBS和LRR结构域但缺乏TIR、CC和RPW8;TN仅包含TIR和NBS结构域;CN仅包含CC和NBS结构域;仅含NBS的基因仅包含NBS结构域。TIR、NBS、LRR、CC和RPW8分别指Toll/白细胞介素-1受体样、核苷酸结合位点、富含亮氨酸重复、卷曲螺旋和白粉病抗性8样结构域。NLR基因簇基于NLR基因的基因组邻近性定义。具体而言,使用bedtools(v2.30.0)69将彼此位于500 kb以内的任意两个NLR基因归入同一簇。随后使用bedtools(v2.30.0)69 merge以最大基因间距离250 kb将NLR基因分组为簇。仅保留包含不少于三个NLR基因的簇。泛NLR分析基于使用OrthoFinder(v2.5.5)82在所有NLR基因中鉴定的直系同源组进行。核心直系同源组定义为包含来自每个比较Hordeum种质资源的至少一个基因模型的直系同源组。壳层直系同源组包含来自至少两个且至多26个Hordeum种质资源的基因模型。未分配到任何直系同源组的基因模型(单例)或仅与来自同一基因型的基因分组的基因模型被归类为云基因。
PPR和mTERF基因的泛基因组分析
使用HMMER套件(http://hmmer.org)中的hmmsearch,以Cheng等人86定义的PPR家族的隐马尔可夫模型和Pfam 32.0数据库(http://pfam.xfam.org)87中用于mTERF基序的PF02536,在长于100个密码子的开放阅读框中搜索PPR和mTERF基序的存在。PPR蛋白的hmmsearch结果下游处理遵循Gutmann等人88描述的流程。最近被鉴定为RFL-PPRs89独特特征的RfCTD结构域被纳入基因注释。得分分别低于100和240的P-class和PLS-class基因被排除在注释之外,因为如先前定义(IWGSC 2018)90,它们不太可能代表功能性PPR基因。
基于图的泛基因组构建与分析
文章标题:大麦属的结构与调控演化
正文: 本文所述分析使用了以下工具包中的若干工具:vg(v1.61.0)91、odgi(v0.8.3-26-gbc7742ed)92、bcftools(v1.21)67 和 seqkit(v2.9.0)72。用于图构建和分析的所有脚本均可在 https://github.com/cropgeeks/panHordeum 获取。由于计算资源限制,我们使用 Cactus47 构建了大麦属全基因组的比对。我们选择 H. marinum BCC 2001 而非 H. marinum H559,是因其组装质量更高。基因组单倍型用 bedtools69 结合各自的重复序列注释进行了软屏蔽。Cactus 比对所需的引导树取自本研究生成的 Orthofinder93 输出。除设置适当的资源参数(即线程、内存和磁盘)外,我们以默认参数运行 Cactus。我们使用 hal2vg(https://github.com/ComparativeGenomicsToolkit/hal2vg)并加上 –noAncestors 标志,将所得全基因组比对转换为超级泛基因组图,随后用 vg convert 进一步处理,得到 GFA 格式的最终泛基因组图(https://github.com/GFA-spec/GFA-spec)。我们使用 odgi stats 并加上 –summarize 选项计算基本图统计量,包括图大小、节点数、边数、路径数和步数。为刻画图中不同片段的保守性,我们将节点分类为 core、shell 或 cloud。若某节点被所有样本的路径遍历,则视为“core”;若仅被单个样本的路径遍历,则视为“cloud”;其余情况视为“shell”。同样的分类也在碱基水平上进行。两项计算均使用 odgi 工具包完成(实现细节见 class_stats.sh)。为评估单倍型序列与其在图中的表示之间的一致性,我们首先使用 odgi paths 并加上 –fasta 选项,提取图中编码的所有单倍型的线性序列。随后使用 seqkit grep 按来源基因组对这些序列进行划分,从而在输入基因组与其图编码对应物之间建立直接的成对比较。对每个基因组对,我们进行精确序列匹配,确认每个输入序列(或其反向互补序列)是否在图编码版本中被精确保留(实现细节见脚本 fidelity.py)。我们基于完整图,使用 odgi heaps 并通过对输入基因组进行 100 次排列,计算泛基因组图的增长曲线。结果使用随 odgi 工具包92 分发的脚本 heaps_fit.R 绘制。鉴于图的规模和复杂度,对于 vg 和 odgi 工具包中若干所需工具而言,全图分析在计算上不可行(作业运行时间限制和/或内存需求)。因此,我们提取了等同于 H. vulgare cv. Morex 各染色体路径的子图,并将其作为所有变异分析的基础。我们使用 vg chunk 进行子图提取。变异直接从染色体级子图调用,使用 vg deconstruct。这生成了包含全范围变异大小的 VCF 输出。为从图中制备结构变异以供进一步分析,我们大致遵循了 Human Pangenome Consortium94 所使用的变异分解方法。这包括使用 vcfbub(https://github.com/pangenome/vcfbub)移除长度 >100,000 bp 的顶层变异,使用 vcfwave(vcflib v1.0.2)95 将每个变异的替代等位基因与参考序列重新比对,最后使用 bcftools norm67 对所得变异进行标准化。随后,我们使用自定义脚本向 VCF 文件添加变异长度信息(SVLEN),以便基于参考等位基因与替代等位基因之间的长度差异(>50 bp)提取结构变异,并根据差异的方向性将结构变异分类为缺失或插入(插入:字符串长度 REF <字符串长度 ALT;缺失:字符串长度 REF >字符串长度 ALT)。所得的 VCF 文件被
e 通过 bcftools query 转换为 BED 格式。变异密度图使用自定义 R 脚本和 ggplot2(v3.5.1)96 计算。为探索将该图用于读段比对和基因分型的可能性,我们尝试使用 vg gbwt/vg index/vg minimizer 为该图建立索引。就所使用的两个独立计算设施上的作业运行时间限制而言,这在计算上不可行,因此我们无法使用该图来评估读段比对。我们使用 Pansel97 进行了基于图的保守性分析,该工具用于直接从 pan-genome 图中计算多样性/保守性指标。使用了 1kbp 的默认 bin 大小,其他所有参数均采用默认设置。结果使用 ggplot2(v3.5.1)96 绘制。
全基因组 MSA
使用 BUSCO (v5.4.6)79 在 B. distachyon (v3.0)98、O. sativa (IRGSP-1.0)99、S. bicolor (NCBIv3)99、T. monococcum100、H. vulgare FT11(参考文献 19)以及本研究中收集的 29 个 Hordeum 单倍型基因组中鉴定单拷贝基因。存在于全部 34 个单倍型基因组中的 BUSCO 单拷贝基因的蛋白序列被串联并使用 MAFFT (v7.490)101 比对。使用 Gblocks (v0.91b)102 以参数 -t=extractedp -b4 = 5 -b5=h 过滤比对良好的区域。随后使用 RAxML (v8.2.12)103,采用 PROTGAMMAWAG 替换模型和 100 次重复的快速自举算法构建最大似然系统发育树。为便于全基因组比对,使用 RepeatMasker (v4.1.1; http://www.repeatmasker.org) 和由 panEDTA 生成的泛基因组 TE 文库对全部 34 个单倍型基因组进行屏蔽。随后将屏蔽后的基因组和推断的物种树作为 Cactus (v2.6.5)47 的输入,以生成全基因组 MSA。基因组元件的丢失率定义为多基因组比对中相应基因组位置上重建的祖先序列的大小。
系统发育与分化时间估计
为精确构建系统发育树并估计 Hordeum 属内的分化时间,我们纳入了四个额外外类群基因组:B. distachyon (v3.0)98、O. sativa (IRGSP-1.0)99、S. bicolor (NCBIv3)104(均下载自 Ensembl Plants;https://plants.ensembl.org/index.html)和 T. monococcum100 (https://wheat.pw.usda.gov/GG3/pangenome)。我们使用四种方法构建系统发育树。前两种方法基于全基因组单拷贝基因。使用 OrthoFinder (v2.5.5)82 从我们的 34 个 Hordeum 单倍型基因组和四个外类群基因组中鉴定直系同源基因,得到 2,198 个单拷贝基因。对于基于串联的方法,将这些基因的 CDS 序列串联并使用 MAFFT (v7.490)101 比对,然后使用 Gblocks (v0.91b)102 以参数 -t=extractedp, -b4 = 5, -b5=h 保留比对良好的区域;随后在 IQ-TREE (v2.2.2.6)105 中进行系统发育推断。对于基于溯祖的方法,使用 MAFFT (v7.490)101 分别比对每个单拷贝基因的 CDS 序列,使用相同参数通过 Gblocks (v0.91b)102 选择高质量区域,使用 IQ-TREE (v2.2.2.6)105 重建各个基因树,并使用 ASTRAL-Pro3 (CASTLES-Pro, v1.23.3.6)106 从这些基因树推断物种树。其余两种方法基于由 Cactus 生成的全基因组 MSA。在 CASTER-pair (CASTLES-Pro, v1.23.3.6)107 方法中,使用全基因组 MSA 推断以 S. bicolor 为根的系统发育树;而在 CASTER-site (CASTLES-Pro, v1.23.3.6)107 方法中,对全基因组 MSA 进行类似分析,但使用基于位点的推断,同样以 S. bicolor 为根。
为估计分化时间,首先基于全基因组不一致性分析排除表现出强系统发育不一致性(nRF > 0.21)的基因组区域。从单拷贝基因的 MSA 中提取 4DTV 位点。大麦与外类群物种之间的分化时间取自 TimeTree 数据库 (https://timetree.org/)108。最后,使用 PAML (v4.4)109 中的 MCMCtree 程序估计 Hordeum 属内的物种分化时间。
鉴定近端区域的边界
我们排除了同一物种中的多个单倍型组,最终保留了 32 个 Hordeum 单倍型组用于比较分析。所有单倍型组对均使用 minimap2(v2.24-r1122)66 进行相互比对,参数为 -2 -K 5 G -f 0.005 -x asm10,所得比对结果以 PAF 格式保存,用于通过点图进行可视化。对于每个参考单倍型组,我们在不重叠的 5 Mb 窗口中计算比对覆盖度,仅考虑比对质量大于 20 的比对。覆盖度值按各单倍型组的平均覆盖度进行归一化,从而生成归一化覆盖度曲线。在分化时间超过 9 Ma 的物种中,观察到归一化覆盖度呈双峰分布,因此可采用 0.5 的阈值区分远端区域和近端区域(Extended Data Fig. 3b,c)。最后,利用全基因组比对和归一化覆盖度曲线,人工界定所有物种中近端区域和远端区域的大小与边界。反向取向的比对被提取出来,作为推测倒位事件的指标。对每个两两比较计算了两项指标:(1) 每 Mb 反向取向比对的数量;(2) 反向取向比对所覆盖碱基的比例。这些指标分别针对近端和远端染色体区域计算,以比较物种分化过程中倒位的累积速率。采用包含分化时间、染色体区域类型(近端或远端)及其交互项的线性回归模型,评估不同区域之间反向取向比对累积速率的差异。
大片段倒位的鉴定
所有其他 Hordeum 基因组均使用 wfmash(v0.9.1-3;https://github.com/waveygang/wfmash)比对到 MorexV3(ref. 28)参考基因组,参数为 -p 90 -l 0。随后使用 SyRI(v1.5.5)110 以参数 -F P -f–nosnp 鉴定倒位。仅保留大于 2 Mb 且位于近端区域之外的倒位用于进一步分析。
利用基因树不一致性检测渗入区域
基于在‘系统发育与分歧时间估计’部分鉴定出的2,198个单拷贝直系同源基因,并以全基因组串联单拷贝基因树为参考,我们进行了滑动窗口基因树分析(扩展数据图6a)。所有单拷贝基因被划分为不重叠的窗口,每个窗口包含25个基因,步长为2个基因。在每个窗口内,使用MAFFT(v7.490)101比对蛋白质序列,并使用Gblocks(v0.91b)102保留比对良好的区域,参数为-t=extractedp -b4 = 5 -b5=h。使用FastTree(v2.1.11)111(默认GTR + CAT,20个速率类别)构建局部窗口树,从邻接树开始,并通过最小进化与最近邻互换移动进行优化;分支支持率使用Shimodaira–Hasegawa-like值计算。使用ETE3(v3.1.2)112以S. bicolor为外群对每个所得树进行生根,并使用参数–min_support_src 90计算相对于参考树的nRF距离。nRF指标量化树之间的拓扑差异,值范围从0(拓扑相同)到1(拓扑完全不同)。基于nRF分布,我们确定0.21作为区分背景与不一致信号峰的阈值(扩展数据图6b)。为评估不一致区域检测的稳健性,我们使用替代参数设置(30个基因,步长为1和5个基因)重复了滑动窗口分析。在不同窗口大小和步长下,主要的不一致峰均被一致地恢复,表明峰检测对参数选择不敏感(补充图52)。包含至少10个nRF ≥ 0.21的重叠窗口的基因组区域被定义为候选渐渗区域。对于每个候选区域,我们使用与全基因组树相同的流程重建了局部系统发育树。将这些局部树与参考树进行拓扑比较,从而推断渐渗起源。使用IQ-TREE(v2.2.2.6)105中实现的AU检验113比较局部参考树和局部系统发育树。P值(p-AU)低于0.05表明该树被显著拒绝。
HGT候选基因的鉴定
在20个二倍体Hordeum物种的基因组中搜索来自Panicoideae亚科禾草的潜在HGT基因。使用BLAST(v2.12.0+)114针对四个潜在供体物种在基因组中鉴定感兴趣区域:Panicum hallii(v3.2)、Setaria italica(v2.2)、Paspalum vaginatum(v3.1)和Paspalum notatum(GCA_036689595.1)(补充表10)。过滤BLAST结果,保留序列一致性≥95%且比对长度≥150 bp的命中。相同流程应用于H. vulgare cv. Morex(v3),作为阴性对照。H. vulgare被广泛认为是一个缺乏来自Panicoideae亚科HGT基因的物种39,41,42。在Hordeum受体基因组和H. vulgare中均发现的来自潜在供体的命中被排除在进一步分析之外。该过滤使用BEDTools(v2.26.0)69中的intersect工具进行,重叠阈值为20%。最后,将鉴定出的区域与新获得的注释进行比较,并提取相应的候选基因。在这一步中,我们鉴定了5,169个候选基因。
HGT候选基因的系统发育验证
为了验证如上所述鉴定出的候选 HGT 基因的外来(即 Panicoideae)起源,我们为每个候选基因构建了系统发育树。使用 BLASTn(e 值截止值为 10−10)从一组代表性 Poaceae 物种和两个外群(An
本研究使用了先前为19个Hordeum物种生成的花序、叶片和根组织RNA-seq数据(H. bulbosum的RNA-seq数据不可用)。使用Trimmomatic(v0.32)126按质量(Q30)进行读段修剪并去除测序接头。随后使用STAR比对器(v2.7.7a)127将每个文库中清理后的读段比对到相应的参考基因组。使用subread包v1.5.2中的featureCounts(v2.0.1)128对比对上的读段进行定量,随后使用edgeR包(v4.2.1)129中实现的M值截尾均值(TMM)方法进行标准化。若基因在至少一个组织中的TMM ≥ 1,则认为该基因表达。
TEs的注释与分析
使用panEDTA(v0.1)流程31对每个基因组中结构完整和片段化的TEs进行注释。除经人工整理的TREP数据库(https://trep-db.uzh.ch/)130外,TE分类遵循EDTA本体(https://github.com/oushujun/EDTA/blob/master/bin/TE_Sequence_Ontology.txt),并对TE类别进行人工整理。通过-cds参数提供来自H. vulgare cv. MorexV3的高置信度基因模型,以从TE注释中排除基因序列。对于每个基因组,从intact.gff3和pass.list输出文件中提取完整LTR反转录转座子的长度、分类、插入时间和分化指标。为研究TE家族扩张和基因组间关系,我们使用TEpop框架(https://github.com/wicker314/TEpop)将每个TE视为独立样本进行群体结构分析46。随后使用FlashPCA2(参考文献131)进行PCA,以探索Hordeum物种间TE变异的主要模式。为从TE爆发推断四倍体基因组的形成时间,从四倍体组装中提取全长LTR/Copia元件,并基于序列相似性使用CD-HIT(v4.8.1)132以参数-n 5 -c 0.9 -d 0 -aL 0.9 -aS 0.9 -g 1进行聚类。为避免亚基因组之间大规模片段交换造成的潜在偏差,被鉴定为交换片段的基因组区域已从该分析中排除(补充表13)。在多倍体亚基因组之间共享但在其相应二倍体祖先中缺失的TEs被定义为异源多倍化后插入。这些元件的插入时间分布用于重建亚基因组融合后的TE动态,插入峰的开始时间用于估计多倍体基因组形成的时间。
Hordeum保守元件的鉴定
为鉴定Hordeum基因组间的保守元件,使用Cactus(v2.6.5)中的halRemoveGenome从HAL比对文件中移除外类群物种。随后使用cactus-hal2maf以MAF格式提取全基因组MSAs,参数为“–chunkSize 1000000–noAncestors–onlyOrthologs–noDupes”,并以MorexV3作为参考基因组。在MSAs中过滤掉包含少于10条序列的比对块。使用PHAST包(v1.4)133中的phyloFit,利用大麦3H染色体的四重简并位点,将中性进化模型拟合到Hordeum系统发育中。基于全基因组多重比对和训练好的中性模型,使用PhastCons并带有“–most-conserved”标志鉴定保守元件。保守和非保守模型以0.45的目标基因组覆盖度进行训练,保守元件的预期长度设为8 bp。
ATAC–seq与数据分析
ATAC–seq 文库由 3–5 叶期的新鲜叶片组织制备。通过在分离缓冲液(0.25 M 蔗糖,10 mM Tris-HCl pH 8.0,10 mM MgCl2,1% Trion X-100,5 mM β-巯基乙醇)中精细切碎组织来分离细胞核,缓冲液中补充了 1× Halt Protease Inhibitor Cocktail(Thermo Fisher Scientific)。分离后,通过流式细胞术对细胞核进行定量,取 75,000 个细胞核在 37 °C 下使用 Tagment DNA Enzyme(TDE1,Illumina)进行 tagmentation 30 分钟。转座后的 DNA 使用 MinElute PCR Purification Kit(Qiagen)纯化,文库使用 NEBNext High-Fidelity 2x PCR Master Mix(New England Biolabs)扩增,最终文库纯化使用 VAHTSTM DNA Clean Beads(Vazyme)按照制造商的标准方案进行。文库按先前所述方法定量62,并按照制造商(Illumina)提供的方案进行测序(双端,2× 151 循环,Illumina NovaSeq 6000,IPK Gatersleben)。
使用 Trim Galore(v0.6.4_dev;https://github.com/FelixKrueger/TrimGalore.git)进行接头修剪和质量过滤,参数如下:-q 25–phred33–stringency 3–length 60–paired -j 10。仅保留两端均保留的读对用于后续分析。修剪后的读段使用 BWA(v0.7.17)134 比对到参考基因组。得到的 SAM 文件转换为 BAM 格式并使用 SAMtools(v1.10)67 排序。仅保留映射质量 ≥ 30 的正确配对读段(-f 2 -F 1804 -q 30),并进一步按读段名称排序,以便使用 samtools fixmate 进行配对信息校正。使用 Picard MarkDuplicates(v2.21.9,https://broadinstitute.github.io/picard/)标记重复读段,参数为 VALIDATION_STRINGENCY=LENIENT 和 REMOVE_DUPLICATES=false。标记后,仅保留正确配对、非重复的读段,并按坐标重新排序,生成最终清理后的 BAM 文件用于下游分析。BAM 索引使用 samtools index 生成。使用 MACS2(v2.2.9.1)135 进行 peak calling。有效基因组大小(-g)设置为 4.2 Gb,近似大麦基因组的大小。使用自动阈值评估(–cutoff-analysis)进行 peak calling,分析过程中保留所有重复读段以保留生物学信号。
VRN1 和 ZCCT 基因的鉴定
使用 blastn 搜索(blast-plus/2.12.0)114 在所有组装野生大麦基因组中鉴定 VRN1 和 ZCCT 基因,查询序列为 VRN1 MorexV3(NC_058522.1:c528157887–528147799)和 NCBI GenBank ZCCTa/b/c(AY485977、AY485978 和 AY687931)。相应区域通过 bedtools(v2.26.0)69 从基因组组装中提取,并使用 Geneious Prime 软件(v2024.0.5;https://www.geneious.com)手动注释和分析。VRN1 基因转录起始位点上游 2 kb 区域和第一内含子的序列相似性可视化通过 flexidot(v1.06)136 完成。H. cordobense 和 H. muticum VRN1 基因中的 79-bp 缺失通过 MSA 检测,使用从野生 Hordeum 物种和冬性栽培品种 Igri 中提取的 VRN1 序列,在 Geneious Prime 软件(v2023.0.4;https://www.geneious.com)中用 MAFFT101 进行。栽培品种 Igri 的关键区域在先前的一项研究中已鉴定51。
小 RNA 和 mRNA 的分离与测序
对在受控非春化条件(21 °C 日:18 °C 夜,14 h 光照:10 h 黑暗光周期)下生长的 H. cordobense 和 H. californicum 的每个阶段(14 DAG、28 DAG)分析了三个生物学重复。使用 Quick-RNA Miniprep Kit(Zymo Research)从冷冻叶片组织中提取总 RNA。使用 Bioanalyzer 2100(Agilent Technologies)在 RNA 6000 Nano chips(Agilent Technologies)上评估 RNA 质量和浓度。H. cordobense 28 DAG 的 RNA-seq 文库和小 RNA-seq 文库按照 Illumina 说明构建,并在 Novogene 的 NovaSeq 6000 平台上测序。其他测序文库(H. cordobense 14 DAG 和 H. californicum 14 和 28 DAG;小 RNA 和 RNA-seq)在 Institute of Experimental Botany(Olomouc)使用 NEBNext Multiplex Small RNA Library Prep Set for Illumina 和带 poly-A 选择的 NEBNext Ultra RNA Library Prep Kit for Illumina 构建,并在 Illumina NovaSeq 6000 平台上以 150 PE 模式测序。
Small RNA-seq 数据分析
小 RNA-seq 读段修剪和测序接头去除使用 cutadapt (v3.4)137 完成。仅使用长度为 21–24 nt 的读段进行后续分析。使用 ShortStack (v4)138 以默认参数将小 RNA 读段比对到相应基因组。使用 samtools (v1.11)67 和 deepTools (v3.5.6)139 组合从 bam 文件生成 bigwig 文件,参数为 bigwigAverage、bamCoverage–binSize 10、–normalizeUsing BPM。小 RNA 和 mRNA bigwig 文件的可视化使用 pyGenomeTracks (v3.9)140 完成。
RNA-seq 数据分析
RNA-seq 读段的质量修剪(Q30)和测序接头去除使用 Trimmomatic (v0.32)126 完成。每个文库产生的高质量读段使用 STAR (v2.7.7a)127 以默认参数比对到相应参考基因组。比对读段的定量使用 rsem (v1.3.3)141 完成。
开花时间分析
使用 14 个所选 Hordeum 物种种质的每个 10 粒种子(BCC 2067 H. cordobense、BCC 2058 H. californicum、BCC 2014 H. muticum、BCC 2055 H. jubatum、BCC 2001 H. marinum、BCC 2009 H. murinum subsp. murinum、BCC 2017 H. murinum subsp. glaucum、BCC 2023 H. flexuosum、BCC 2026 H. erectifolium、BCC 2028 H. pubiflorum、BCC 2043 H. pusillum、BCC 2059 H. intercedens、BCC 2065 H. patagonicum 和 BCC 2069 H. roshevitzii)。春性栽培大麦基因型 Morex 和 Golden Promise 以及冬性基因型 Igri 和 Antonella 作为对照纳入,并与野生种处理相同。种子在 4 °C 下层积 4 天,在培养皿中于湿润滤纸上萌发,然后移栽至土壤。植株在生长室的受控非春化条件(21 °C 日:18 °C 夜,14 h 光照:10 h 黑暗光周期)下生长并栽培至衰老。开花天数以三天为间隔记录,植株以芒尖首次伸出作为开花判定。使用 Nikon D5600 数码相机对植株拍照。
栽培大麦中 eog1 的鉴定及等位性测试
栽培大麦的细长外稃1(eog1)突变体59,包括eog1.a(GSHO 1891)、eog1.c(GSHO 1892)、eog1.e(GSHO 285)和大鳞片突变体(macrolepis,lep-e.1;GSHO 960),均取自大麦遗传资源库(Barley Genetic Stock Collection)。其中若干突变体,即M2342、M9630、M9815和M11405,是从先前建立的大麦HTX诱变群体的独立M2株系中鉴定得到的142。SEM观察按照标准方案143,使用Hitachi SEM SU8081进行。取幼嫩花序进行采样和检查。等位性测验通过将M9630分别与GSHO 1891和GSHO 1892杂交进行。所有F1后代在中央可育小穗上均表现出细长外稃(Extended Data Fig. 12d)。C2H2型锌指转录因子基因的序列特异性扩增使用引物T-70820-F(5′-TAGGACCGCATATTTCCAGG-3′)和T-70820-R(5′-GAACAGTTCCAAGGCGAAAG-3′)进行。所得扩增产物采用Sanger测序进行测序。
穗特异性基因的鉴定
使用fastp(v0.20.1)以默认参数144去除接头、含N碱基的reads和低质量reads后,获得clean reads(Supplementary Table 20)。Clean reads通过Hisat2 v2.1.0以默认参数145比对到各自对应的参考基因组。通过featureCounts(v2.0.1)使用标准参数128从比对文件中确定reads计数,并计算每个基因的TPM值。穗特异性表达基因定义为在其他组织中TPM低于5%的基因146。热图基于标准化TPM值,使用pheatmap R包(https://CRAN.R-project.org/package=pheatmap)生成。Venn图使用eulerr包(v6.1.0;https://CRAN.R-project.org/package=eulerr)绘制。以HORVU.MOREX.r3.2HG0170820.1(EOG1)推导的氨基酸序列为查询序列,对24个Hordeum基因组序列进行本地BLAST搜索,以鉴定同源蛋白。氨基酸序列比对使用MUSCLE(v3.8)115进行,所得MSA使用TBtools II147的Simple MSA Viewer功能进行可视化。
报告摘要
有关研究设计的更多信息,请参见与本文关联的Nature Portfolio Reporting Summary。