 Newshot
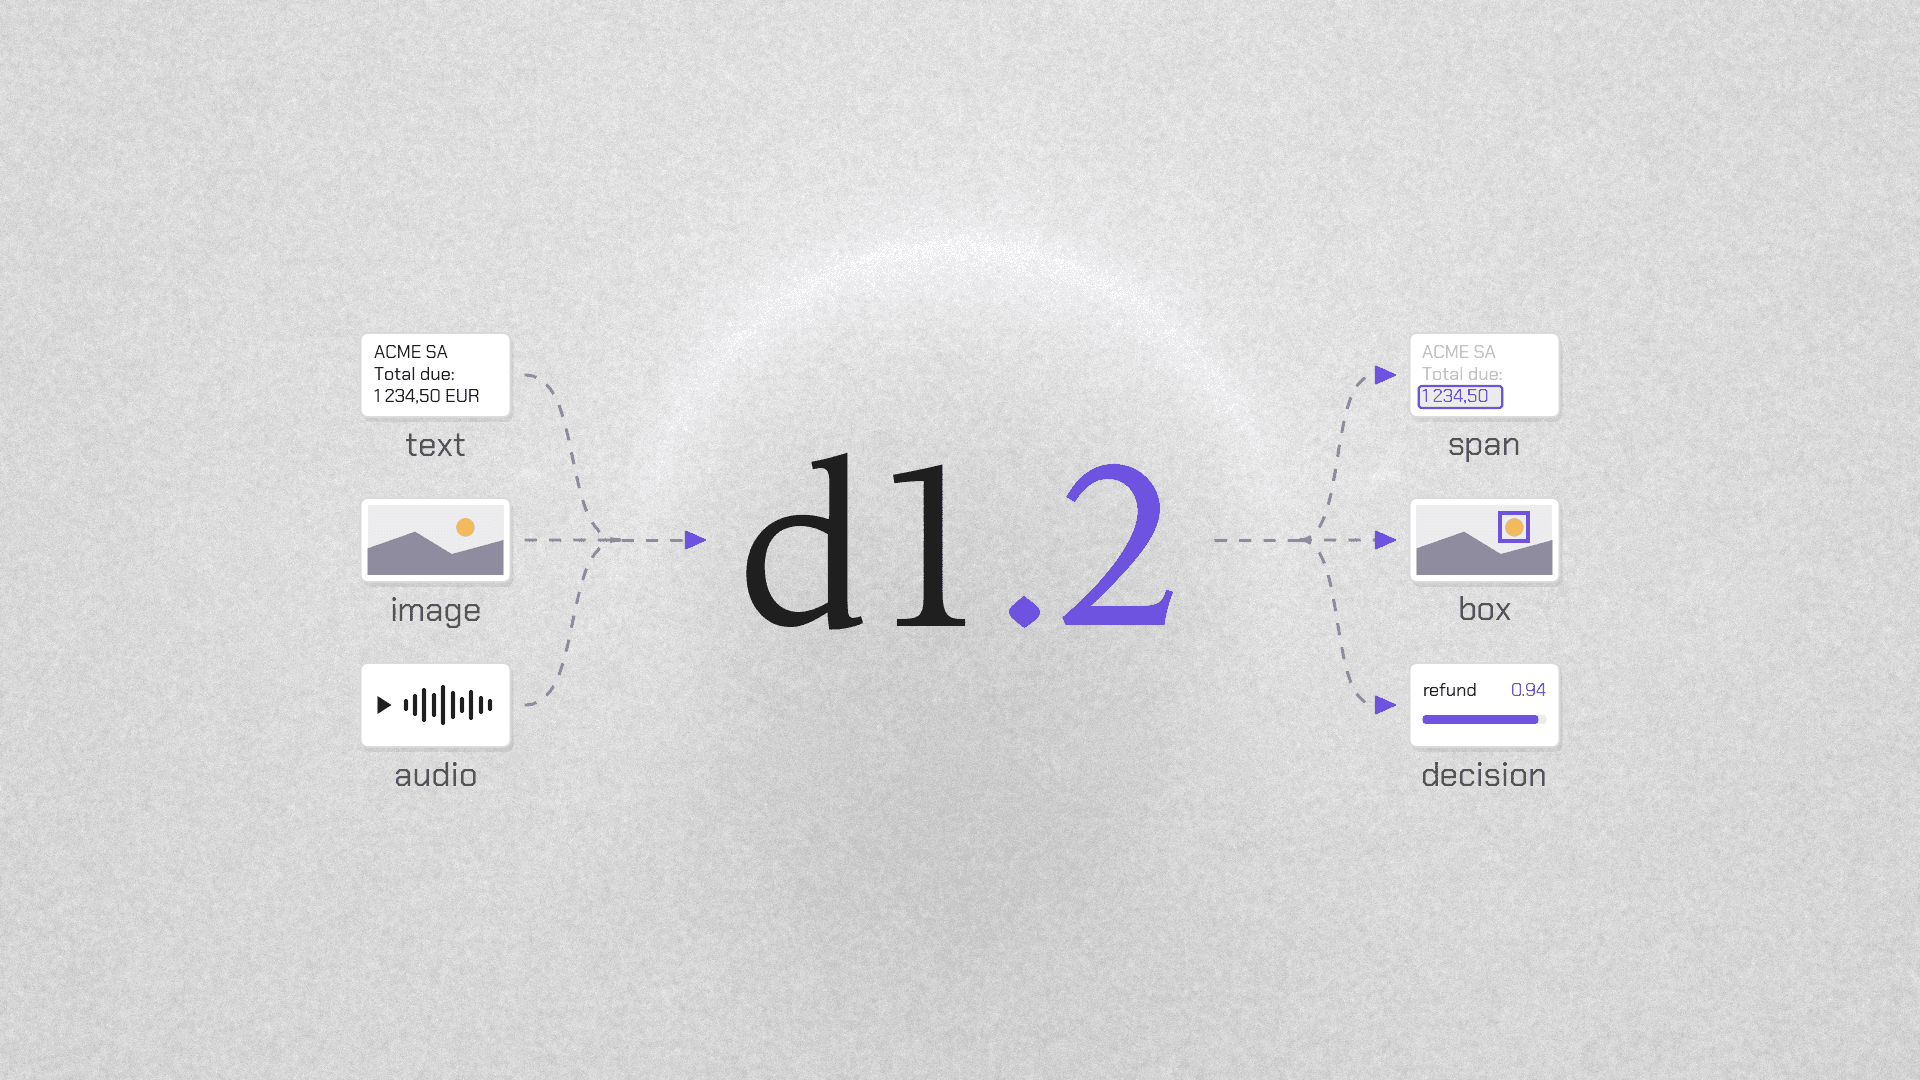
今天,我们发布 d1.2 和 d1.2-ultra,这是我们决策模型的新版本,现已支持音频输入和五项新任务。此外,d1.2-ultra 在 Artificial Analysis Decision Index v2.1 的决策模型中排名第一。
两款模型即日起在 Liquid API 上提供,d1.2 的价格为每百万输入 token 0.02 美元,d1.2-ultra 为 0.042 美元。
d1.2 和 d1.2-ultra 为 API 新增了五项任务:
- 从输入中读取一个值(文本、数字或日期)。针对一张发票问“应付金额是多少?”,模型会返回正确的值以及读取该值所依据的字符。如果发票上没有显示该值,它会回答“not found”,而不是猜测。
- 找出文本中某一类的所有片段(spans)。例如,要求找出便条中所有个人数据,模型会返回每个片段,如姓名、电话号码和电子邮件地址,以及它们在文本中的位置。
- 在图片中定位事物(单个目标返回一个框,每个实例返回各自的框)。例如,询问扫描表格上的签名在哪里,模型会返回围绕它的矩形(或“not found”)。要求找出一张照片中的每一棵树,它会返回每棵树周围的矩形以及数量。
- 估算一个数字(带范围的数字)。问一张照片中有多少人,模型会返回其最佳猜测(例如 12)和一个范围(例如 10 到 14)。
- 选出所有适用的选项(choice 且 multiple 设为 true)。询问一条支持消息涉及哪些主题,模型会返回每个适用的主题,例如账单和配送,每个主题都带有各自的概率。
d1.2 和 d1.2-ultra 也接受音频作为输入。音频输入可以是你所询问的内容,例如某人说哪种语言,或背景中是否有警笛声。问题本身也可以是一段录音,用说的而不是打字输入。
Artificial Analysis Decision Index
Artificial Analysis Decision Index v2.1 在六项基准上评估决策模型,涵盖从简历、收据和研究论文上的决策与提取,到工具调用和困难知识问题。它还会对模型为每个答案分配的概率打分,因此一个自信的错误答案比一个犹豫的答案代价更高。
d1.2-ultra 得分为 75,是该指数上的最高分,比此前最佳的决策模型领先两分。
两款模型在其成本上也取得了最佳得分。在 Decision Index v2.1 上,没有模型以更低的费用获得高于 d1.2 的得分,也没有模型在任何价格下获得高于 d1.2-ultra 的得分。
校准
决策模型提供的概率只有在正确时才有用。当它说 80% 时,它就应当在大约 80% 的情况下是对的,这样你才能设置阈值。例如,你可以自动将模型置信度低的任务转交人工审核。
校准误差衡量的是模型预测概率与其实际正确频率之间的差距。在全部五个模型回答的 13 项基准、22,505 个问题中,d1.2-ultra 的校准误差为 0.8 分,相比之下 d1.2 为 1.2,Jev 1.14 为 2.7,Perplexity 的 Decider v1.3 为 3.7,GPT-6 Luna 在其 Decisions API 上为 7.2。
新任务的准确率
目前尚无公开基准衡量这五项新任务,因此我们在由公开数据集留出划分构建的内部测试集上对它们进行了评估。在这些内部基准中,一次读取或一个框在找到目标时算作正确,或者在目标不存在时回答“not found”算作正确。
| 任务 | d1.2-ultra | d1.2 |
|---|---|---|
| 从收据中读取一个值( CORD , SROIE ) | 98% | 96% |
| 找出文档中的每一处个人数据,精确率 / 召回率( Nemotron PII ) | 94% / 93% | 92% / 88% |
| 定位照片中描述的物体( RefCOCO 、 RefCOCO+ 、 RefCOCOg ) | 94% | 94% |
| 估计照片中物体的数量,误差不超过一个( COCO ) | 93% | 92% |
| 选出照片中出现的每个物体( COCO ) | 87% | 90% |
从收据中读取一个值(CORD, SROIE)
找出文档中的每一处个人数据,精确率 / 召回率(Nemotron PII)
定位照片中描述的物体(RefCOCO, RefCOCO+, RefCOCOg)
估计照片中物体的数量,误差不超过一个(COCO)
选出照片中出现的每个物体(COCO)
在留出的录音上,两个模型对它们听到哪种声音(ESC-50)或说的是哪种语言(FLEURS,43 种语言)的问题,回答正确率为 95% 到 97%。每个问题提供三到六个选项,其中包含西班牙语和葡萄牙语这类容易混淆的选项,或者是一个是或否的问题。
可用性与定价
在 Liquid API 上以 d1.2-ultra 和 d1.2 调用这些模型,密钥来自 console.liquid.ai(Dashboard > API Keys)。
新的答案类型使用相同的端点和请求格式。本示例从一张发票中读取三个值,并询问第四个发票上未注明的值。
        import os, requests

invoice = "ACME SA\nInvoice 2026-117\nTotal due: 1 234,50 EUR\nPay before 03/04/2026 (day/month/year)"

response = requests.post(
    "https://api.liquid.ai/decisions/v1/systemone",
    headers={"Authorization": f"Bearer {os.environ['LIQUID_API_KEY']}"},
    json={
        "model": "d1.2-ultra",
        "state": invoice,
        "questions": {
            "payee": {"type": "text", "instructions": "Who issued the invoice?"},
            "total": {"type": "number", "instructions": "How much is due?"},
            "due": {"type": "date", "instructions": "By when must it be paid?"},
            "vat": {"type": "number", "instructions": "How much VAT is charged?"},
        },
    },
)

a = response.json()["answers"]
print(a["payee"]["text"], a["total"]["number"], a["due"]["date"], a["vat"]["number"])
# ACME SA 1234.5 2026-04-03 None
完整的 API 参考见决策模型文档。
两个模型仅对输入 token 计费。图像按每 32x32 像素块 1.5 个 token 的文本费率计算,因此一张 1024x1024 的图像计费 1,536 个 token。一次请求的文本和图片只计费一次,每个额外问题只增加其自身的文本。即将登陆 OpenRouter 和 Vercel。
引用
如需引用,请使用以下参考文献或 BibTeX:
Liquid AI, "d1.2: State-of-the-Art Omnimodal Decision Models", Liquid AI Blog, Nov 2026.
        @article{liquidAI2026d1.2,
  author = {Liquid AI},
  title = {d1.2: State-of-the-Art Omnimodal Decision Models},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/d1-2},
}