 Newshot
人人拥有的 AI。
CrowdGPT 致力于打造全球首个 0 美元、无数据中心、100% 开放的 AI。在你的电脑上运行这个应用,AI 就会变得更好。
训练 AI 的新范式。
一家公司训练前沿模型,要在数据中心里用上几千块 A100。大多数人并没有那样的硬件。但数百万人的游戏 PC 里,RTX 显卡正闲置着。CrowdGPT 利用这些算力,训练出来的模型属于每一位参与构建它的人。
隐私优先。
你的 GPU 训练所用的数据,是从 HuggingFace 上公开的 CrowdGPT 数据集流式传输而来的 10MB 数据块;任何人都可以查看或为该数据集做贡献。它绝不会访问或传输你的个人文件、浏览器历史记录或本地数据。
更环保。
在已经开机的消费级 GPU 上训练。CrowdGPT 不需要新建数据中心,也不需要额外制造硬件,这正是传统 AI 的一大取舍。
透明。
客户端只有一个可读的 Python 文件,任何人都可以审计和修改。模型权重可在 HuggingFace 上免费、100% 开放地下载。
客户端是一个单一的开源 Python 文件,人类可读。它从网上下载公开的训练数据,在本地训练,只上传模型更新。它无法访问你的文件,也无法危害你的机器。
服务端同样受到保护。每一次更新都会在由同伴交叉验证之前,先校验其大小、NaN 值和范数边界,屡次违规者会被禁止参与该项目。
运行之前,请先阅读源码。
帮助项目成长。
每一份贡献,哪怕再微小,都会让模型变得更好。运行一个客户端、给仓库点星,或者提交一个 issue。
安装客户端
用一条命令完成全部安装。即使你没有安装 python/git 也没关系。
- 约 6 GB 可用磁盘空间。仅 PyTorch 就约占 2.5 GB。
- 强烈建议使用独立显卡。NVIDIA(CUDA)、AMD(ROCm / DirectML)、Apple Silicon(MPS)和 Intel Arc(XPU)均受支持。
- 稳定的网络连接,用于流式获取模型权重和数据集分块。
- 仅用 CPU 的模式也能运行,但极其缓慢。
其余的一切都由安装器处理:GPU 检测、正确的 PyTorch wheel、缺失时的 Python 与 Git,以及一个隔离的虚拟环境。
一行命令安装(推荐)
把这条命令复制到你的终端。它会下载安装器、自动检测你的硬件,并启动客户端。
安装器的工作原理
- 检测硬件。为你的显卡安装正确的依赖。
- 安装依赖。若缺少 Python 和 Git 则先安装,然后从正确的索引安装 PyTorch 以及项目的依赖;一切都在隔离的虚拟环境中进行,因此不会触碰你系统里的 Python。
- 启动。从 HuggingFace 下载模型权重,流式获取一个数据集分块,然后开始训练。你随时可以停止。
关于——工作原理
CrowdGPT 如何协调一群相互独立的 GPU,在没有庞大基础设施的情况下训练出一个单一、连贯的语言模型。
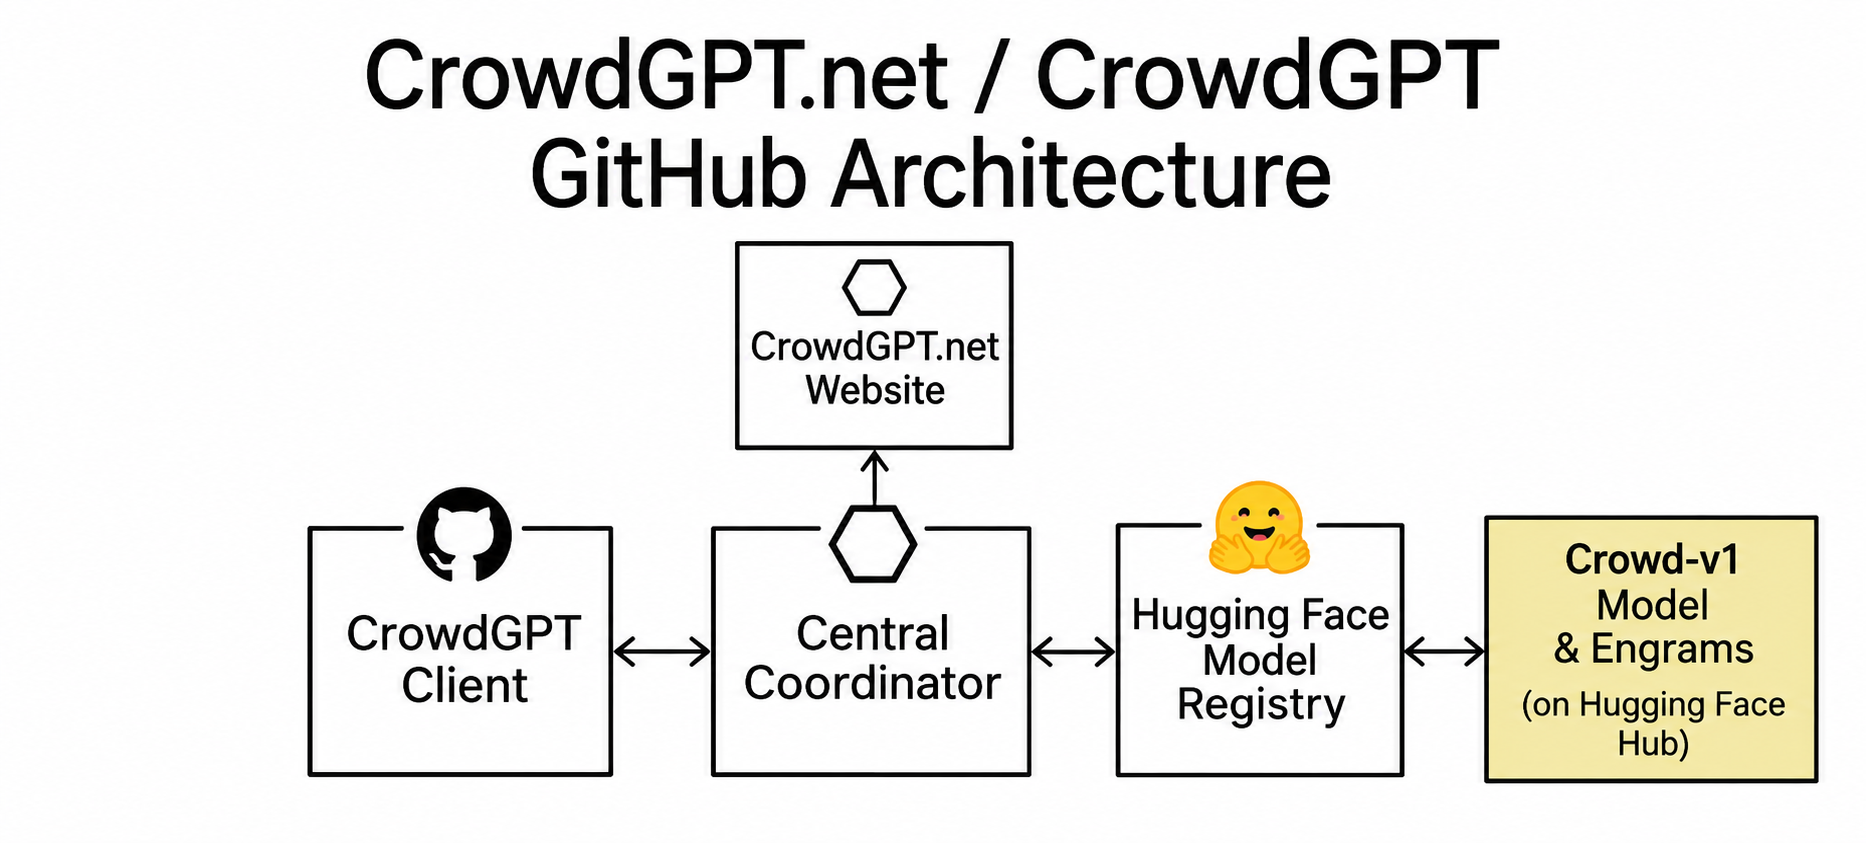
1. 任务分配
当设备连接时,服务器会为它分配一个特定的数据分片(来自公开 CrowdGPT 数据集的 10MB 分词文本块)以及当前的全局模型权重。客户端从 HuggingFace 下载权重,并通过 HTTP Range 请求在本地流式获取该数据块。数据集完全开放,任何人都可以为其做贡献。
2. 本地训练
应用在本地设备上进行 AI 训练。它计算出基础模型与新训练模型之间的路径(即“delta”)。你电脑上的任何内容都不会被访问。
3. 安全提交
随后应用会压缩更新,并将其发回服务器进行验证:
4. 聚合
有效的更新会被平均,并定期应用到全局 AI 模型上。模型权重会自动推送到 HuggingFace,以便公众审计、使用和测试。
网络状态
CrowdGPT 联邦训练网络的实时指标。
按硬件划分的训练池
查看哪些设备类型正在训练,哪些正在等待更多池成员加入。
这些数字的含义
- 贡献量:所有贡献者提交的模型更新总数。
- 已处理 Token 数:群体中每块 GPU 累计用于训练的 Token 数。
- 活跃客户端:过去 10 分钟内已向协调器发送过 ping 的 GPU。
- 模型损失:最近一次聚合更新的交叉熵损失。
统计数据每 15 秒从 HuggingFace CDN 自动刷新。全局模型权重在聚合更新完成后每 4 小时推送到 HuggingFace。
贡献者排行榜
为 CrowdGPT 训练运行提供支持的顶级贡献者。排名基于已处理 Token 总数。
| 排名 | 用户名 | Token 数 | 步数 | 信任分数 | 提交数 |
|---|---|---|---|---|---|
| 正在加载排行榜... |
提交训练数据
帮助扩充 CrowdGPT 数据集。将文本或文件提交到训练队列。所有提交在加入公开数据集之前都会由维护者审核。
- 纯文本、文档或任何文本语料库(.txt、.md、.json、.jsonl、.csv)。
- 公有领域、宽松许可或你自己的原创作品。
- 不包含个人信息、不包含你不拥有版权的材料、不包含恶意内容。
该数据集完全开放,并在 HuggingFace 上提供镜像。你在此提交的任何内容,在经维护者审核之前都不会用于训练。
联系我们
有问题、缺陷报告,或有兴趣运行自己的协调器?请联系我们。
GitHub Issues
报告缺陷、请求功能或讨论联邦逻辑技术细节的最佳场所。
电子邮件
用于商务咨询、合作机会或敏感安全披露。
托管
主协调器 API 由 Xevex 托管和维护。
模型权重
所有训练后的模型检查点和配置文件均可在 HuggingFace 上公开获取。