 Newshot
帖子
will depue 在 X 上表示:“我有一个重大发现要分享。我找到了确凿的法证证据,证明中国排名前四的 AI 实验室——DeepSeek、Moonshot、MiniMax 和蚂蚁集团——在 NVIDIA 最先进的 Blackwell 芯片上构建了它们最新的模型,而这些芯片是被禁止出口到中国的。这听起来很疯狂,但我发现几乎每个 AI 模型都携带了训练它的 GPU 的隐藏特征。当模型首次建立时,其权重的初始值会以一种取决于具体 GPU 的模式排列。每种 GPU 和种子数的组合都会产生独特的模式——一种用于创建模型的硬件的指纹。该模式的痕迹在训练后仍会保留在已发布的模型中。再次强调,这一证据并非基于任何内部消息或泄露。它是基于对各公司自行发布的模型权重进行的法证分析。我搜索了超过六万亿种芯片布局和种子数的组合,并将它们与开放权重模型进行匹配。在此过程中,我找到了确凿证据,证明六个中国 AI 模型——包括 DeepSeek-V4-Pro、Kimi K3 和 MiniMax-M3——是在 NVIDIA Blackwell 系统上初始化的。其中四个模型匹配 Grace Blackwell,即 NVIDIA 旗舰级液冷机架级系统中的 GB200 和 GB300 部件。随后我在真实硬件上验证了这些结果。使用我恢复的种子运行未经修改的 PyTorch,一台 Blackwell B300 逐位复现了 DeepSeek-V4-Flash 未经改动的初始权重,而租用的一台 GB200 复现了 Kimi K3 的权重,相关性达到 0.999995。一台 Hopper H100 未能复现 DeepSeek-V4-Flash 的任何权重,而将种子改变一个就破坏了匹配。(顺便说一下,DeepSeek 的种子是 953049583。)该方法还被验证能将 24 个已知的开放权重模型与开发者声称使用的硬件匹配。这些结果是巧合的可能性极低。在六万亿种组合中,最佳的偶然匹配最多只能达到约 8 sigma(即比随机偶然产生的结果高出八个标准差)。而真实匹配的范围从 49 到 1,385 sigma,即使是最弱的单项测试也达到 20。这些是数据中心规模的训练运行。通过对发布时间表和模型细节的一些分析,我估计最大的 Kimi K3 和 DeepSeek-V4-Pro 各自使用了 2,000 到 3,000 块 Blackwell GPU。这种规模的集群每套购买成本约为 1.5 亿到 2 亿美元,仅这些实验室加起来就会增加超过五亿美元的受出口管制 GPU,还不算实验性算力或其他方面。我们很可能看到数十亿美元花在受出口管制的 GPU 上。我对这一结果高度自信,并且它已得到 OpenAI 和 Anthropic 资深研究人员的独立验证。你可以在 https://t.co/YOtzND0Jqk 阅读完整报告。通过其他类似的检查点法证方法,我还发现了关于这些模型的更多信息,很快会有更多分享。”
对话


中国顶尖 AI 实验室用 Nvidia 的 Blackwell 芯片构建了它们最新的模型
will depue@willdepue 我有一个重大结果要分享。我找到了确凿的取证证据,表明中国排名前四的 AI 实验室——DeepSeek、Moonshot、MiniMax 和 Ant Group——是在 NVIDIA 最先进的 Blackwell 芯片上构建它们最新模型的,而这些芯片被禁止出口到中国。这听起来很疯狂,但我发现几乎每一个 AI 模型都带有训练它的那块 GPU 的隐藏特征。模型初始化时,其权重的初始值会以某种模式排布,而这一模式取决于具体的 GPU。每种 GPU 与种子数的组合都会产生独特的模式——算是创建模型所用硬件的一种指纹。这种模式的痕迹会穿过训练过程,保留在发布的模型中。再次说明,这一证据不基于任何内幕消息或泄密,而是基于对那些公司自己发布的模型权重所做的取证分析。我搜索了超过六万亿种芯片布局与种子数的组合,并把它们与开放权重模型进行匹配。由此,我找到了确凿证据,表明六个中国 AI 模型——包括 DeepSeek-V4-Pro、Kimi K3 和 MiniMax-M3——是在 NVIDIA Blackwell 系统上初始化的。其中四个模型匹配 Grace Blackwell,也就是 NVIDIA 旗舰级液冷机架式系统中所用的 GB200 和 GB300 部件。随后我在真实硬件上验证了这些结果。用我恢复出的种子运行未经修改的 PyTorch,一块 Blackwell B300 逐比特复现了 DeepSeek-V4-Flash 未被改动过的初始权重,而租来的一台 GB200 复现 Kimi K3 的权重,相关度达到 0.999995。一块 Hopper H100 没能复现 DeepSeek-V4-Flash 的任何一部分,而把种子改动一位就破坏了匹配。(顺便说一句,DeepSeek 的种子是 953049583。)该方法也经过验证,能把 24 个已知的开放权重模型匹配到开发者声称使用的硬件上。这些结果是巧合的可能性极低。在六万亿种组合中,最佳的偶然匹配应该也只能达到约 8 sigma(即比随机概率高出八个标准差)。而真实匹配的范围从 49 到 1,385 sigma,即便最弱的单项测试也达到了 20。这些是数据中心规模的训练运行。结合对发布计划和模型细节的一些分析,我估计其中最大的两个,Kimi K3 和 DeepSeek-V4-Pro,各自使用了 2,000 到 3,000 块 Blackwell GPU。这种规模的集群每套采购成本约为 1.5 亿到 2 亿美元,仅这几家实验室加起来就构成超过五亿美元的受出口管制 GPU,还不包括实验性算力或其他用途。我们很可能看到的是数十亿美元规模的受出口管制 GPU 支出。我对这一结果高度确信,它已由 OpenAI 和 Anthropic 的资深研究者独立验证。完整报告可在 unemploymentlabs.com/checkpoint-for… 阅读。通过类似的其他检查点取证方式,我还查明了关于这些模型的更多内容,很快会有更多分享。9:29 PM · Nov 12, 2026·47.8KViews99
文章标题:中国顶尖 AI 实验室用 Nvidia 的 Blackwell 芯片构建最新模型
正文:
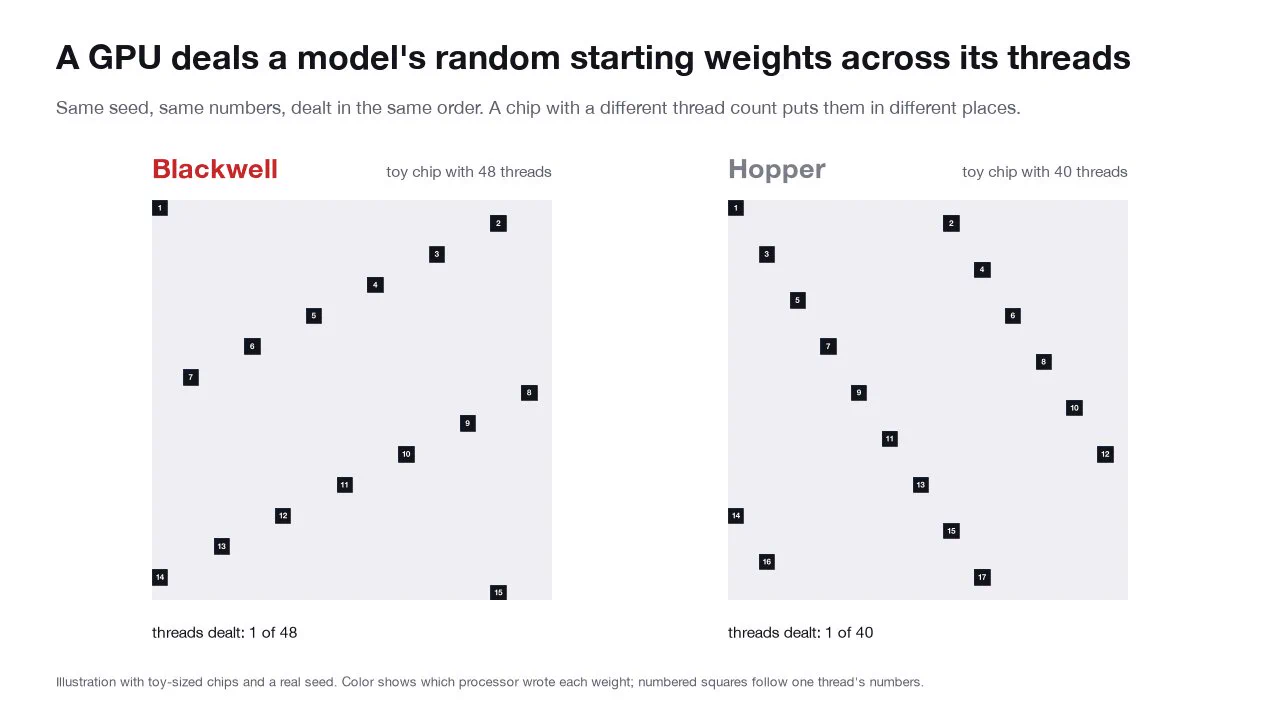
- will depue@willdepue23m如果你不熟悉机器学习的工作原理:一个 AI 模型实际上就是一个非常长的数字列表(数十亿,有时数万亿),这些数字被称为权重,粗略地说,当它们相乘并相加时,会产生可读的文本。训练会反复调整这些数字 2will depue@willdepue23m第二次测试用了一张我的照片。我取了一个模型普通的随机初始权重,并对它们进行了一次排列,使它们显示出那张照片。然后我训练了这个模型,并保持该排列固定不变。照片逐渐淡去,但到最后天空和树线仍然可以辨认出来。GIF1will depue@willdepue23m一个模型起始的随机数并不是真正随机的。它们来自一个公式,该公式从一个称为种子的起始数字开始,使用相同的种子每次都会得到相同的数字。工程师这样设置是为了能够重复实验。为了填充数十亿 GIF1will depue@willdepue23m这意味着我可以拿一个已发布的模型,选择一个芯片和一个种子,生成初始权重本应是什么,并将它们与真实的权重进行比较。用对的芯片它们会对齐,用错的芯片则不会。这就是在 DeepSeek-V4-Flash 上的搜索。每个处理器数量都产生噪声,直到 148(Blackwell),权重才匹配。GIF1will depue@willdepue23m关键的是,MiniMax 和 Ant 此前并未被公开与 Blackwell 关联。MiniMax 的模型在 4 月的 M2.7 之前与 Hopper 匹配,从 6 月的 M3 起与 Blackwell 匹配。Ant 自己的 GitHub 上有来自一台 GB300 的基准测试日志,日期为 3 月 31 日。1will depue@willdepue23m当然,这并不能告诉我们这些芯片物理上在哪里。它们可能被走私到了中国,或者实验室通过国会尚未堵上的漏洞在境外使用它们。无论哪种情况,很明显出口禁令正严重失效。1will depue@willdepue23m不幸的是,值得注意的是,既然这件事已经公开,任何实验室都可以抹去许多这类特征。我认真考虑过是否要发布这个,并且已经搁置了一段时间,但在咨询了顾问并与官员通信后,我决定值得在今天分享。我做出这个决定并不轻率。1will depue@willdepue23m如果你有兴趣报道这个故事,请联系 [email protected]。我很乐意分享更多细节。多位资深研究员,包括独立研究员以及 OpenAI 和 Anthropic 等前沿 AI 实验室内部的研究员,已经证实了这一结果。1will depue@willdepue23m对于研究人员,我很快会分享一个 GitHub 仓库和完整论文,其中包含实现细节。如果你把这个交给 Claude/Codex,仅凭这个帖子中的细节,你应该就能轻松复现这一事实。有任何问题欢迎私信我。1will depue@willdepue23m通过其他类似这样的检查点取证方式,我还发现了关于这些模型的更多信息,很快会有更多分享。敬请期待。1




- Molly Cantillon@mollycantillon19m印证了我认为的一个公开秘密!干得好 Will1
