 Newshot
急性髓系白血病发生前数年的演化动力学
主要
癌症是在组织内通过达尔文演化过程发展而来的1,4,5,6。构成我们组织的庞大细胞群体中的突变、漂变和选择,可能导致一个克隆出现,该克隆已获得多个遗传和表观遗传“驱动”改变,这些改变破坏组织稳态并促进不受控增殖7,8,9,10。尽管过去20年的大规模测序工作已提供导致癌症发生的驱动基因的综合目录11,12,13,但仍缺乏对这些驱动因素如何产生、扩增和竞争的演化动力学完整定量理解。为什么癌症驱动突变广泛存在于许多健康人体组织中2,14,15,16,17,而其中许多组织的癌症却相对罕见?为什么在一些人中,初始克隆扩增会进展为致死性癌症,而在另一些人中则保持良性?偶然性与决定性在癌症演化中的相对作用是什么?这些问题的答案可指导更合理的早期癌症检测18、风险预测19,20,21,22,23和个性化干预24,25方法。
基于体细胞演化的肿瘤发生理论自20世纪50年代起就已存在,并被用来解释癌症发病率随年龄非线性增加的现象26。这些多阶段模型强调了突变26,27、选择28,29和干细胞群体规模30的重要作用。然而,事实证明仅凭年龄-发病率数据难以证伪这些模型。分子演化动力学通过系列样本的深度测序读取,提供了对演化动力学更直接的测量,并改变了我们对微生物演化的理解31,32,33,34,35。然而,将类似方法应用于癌症发展已被证明具有挑战性,因为从无症状个体获取癌前组织的系列样本很困难。即使这些组织可获得,它们通常也只提供现有体细胞多样性的静态快照。要更好地理解癌前演化的动力学,需要以高时间分辨率收集的系列样本。
造血系统提供了一个独特机会来理解和量化癌前演化,因为可以在癌症发生前采集无症状个体的系列血液样本。健康血液表现出普遍且明显的年龄相关变化,这些变化由对在急性髓系白血病(AML)中反复突变的遗传改变的正选择驱动(例如,DNMT3A、TET2 和 ASXL1)19,20,21,22,23,36,37。这种现象被称为克隆性造血,会增加未来血液恶性肿瘤(如 AML)的风险19,20,21,22,23。尽管克隆性造血演化的某些方面已开始被定量理解38,39,40,41,42,43,但我们对这些年龄相关变化如何演化为 AML 的理解仍不完整。我们推断,在随后发生 AML 的人群中,于长达数十年的时间尺度上定期采集的系列血液样本,可用于更好地理解 AML 的演化起源。通过利用可纠错测序44,45的发展以及演化理论32,46,47的见解,我们试图刻画 AML 的关键驱动事件在生命中的何时发生,并深入了解支配其建立、生长和竞争的规则。
pre-AML 血液的纵向测序
文章标题:急性髓系白血病发病前数年的演化动态
正文: 英国卵巢癌筛查协作试验(UKCTOCS)研究在2001年至2005年间招募了202,638名50–74岁、无癌症的绝经后女性,其中50,640人被随机分配至“多模式组”,该组在长达11年间每年采集血清样本(参考文献3,48)。我们识别出在超过12年的随访期间随后发生AML的所有女性,其中47人在AML诊断前至少两个时间点有足够的血液样本可用。这47名女性被诊断为AML的中位年龄为72岁(范围53–83岁),在诊断前有多达10份连续血液样本(中位5份)可用(图1a、扩展数据图1和补充说明1)。我们从这47名女性中获得了249份AML前血清样本,并从47名年龄匹配、保持无癌症的对照者中获得了249份时间点匹配的样本。一名对照者随后因发生骨髓增生异常综合征(MDS)而被排除。为了精确追踪这些纵向样本中的演化动态,我们设计了一种名为TETRIS-seq的高灵敏度测序策略。该方法将针对一个面板的双链纠错测序44相结合,该面板全面覆盖克隆性造血和AML相关的基因组改变,包括基因突变、染色体重排和嵌合染色体改变(mCAs),并结合定制的计算机去噪算法(图1b、方法和补充说明2)。使用TETRIS-seq,我们可靠地实现了大于1,500×的双链一致性深度,能够稳健检测变异等位基因频率(VAFs)≥0.1%的单核苷酸变异(SNVs)和插入缺失(补充说明2f)。利用我们样本的纵向性质,我们对受mCAs影响的染色体区段上的单核苷酸多态性(SNPs)进行定相,从而能够检测≥5 Mb的染色体获得、缺失和拷贝中性杂合性丢失(CN-LOH)事件,低至约1%的细胞比例(补充说明2k,l)。
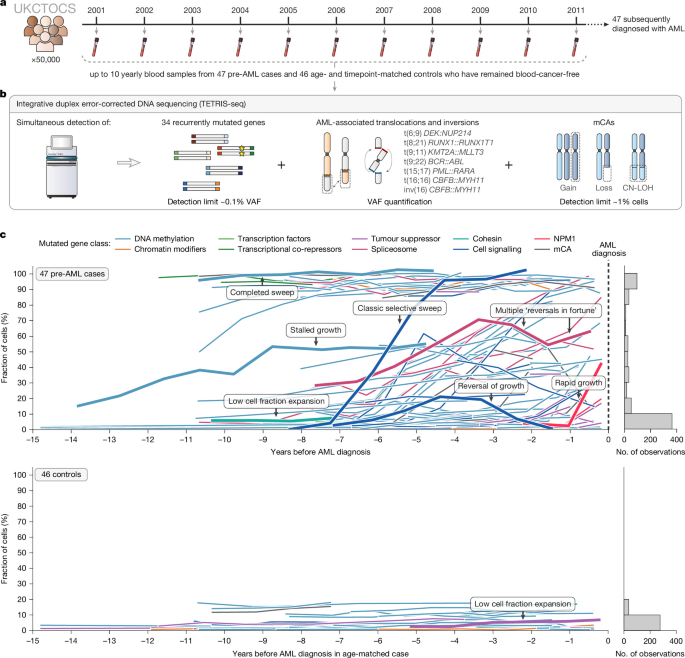
a,从UKCTOCS队列中47例未来AML病例和46名年龄匹配对照者每年采集的纵向血液样本,每人最多十份样本(每个时间点一份)。未进行技术重复。b,TETRIS-seq工作流程,用于对AML相关遗传改变进行深度双链靶向测序,并结合计算机去噪算法。c,在AML前病例(上;n = 132个变异)和对照者(下;n = 59个变异)中,在多于一个时间点检测到的所有变异的细胞比例轨迹,按突变基因类别着色(见键)。特征性动态行为被标记并突出显示。直方图(右)显示所有采样时间点上细胞比例测量值的分布(即每个变异每个时间点一个计数)。
AML前十年中的突变动态
应用 TETRIS-seq 揭示了 AML前病例与对照之间显著不同的体细胞演化动力学(Fig. 1c)。在对照中,我们在 72%(46 人中的 33 人)的人中检测到克隆性造血,这与先前研究一致37,39。在对照中观察到的变异通常细胞比例低于 20%,并且轨迹随时间似乎相对稳定(Fig. 1c)。这些变异大多位于已知的克隆性造血驱动基因中,包括 DNMT3A 和 TET2(Extended Data Fig. 2)。在 AML前病例中,我们在 89%(47 人中的 42 人)的人中检测到克隆性造血。与对照相比,在 AML前病例中观察到的变异丰度显著更高,并在采样期间表现出大的细胞比例变化(Fig. 1c)。这些变异发生在更广泛的 AML 相关基因中,包括剪接体、细胞信号传导和抑癌基因(Extended Data Fig. 2)。
在 AML前样本中观察到的细胞比例轨迹表现出广泛的定性行为,这些行为与对照不同(突出显示的轨迹,Fig. 1c)。我们观察到许多经典选择性清除的例子,即单个变异扩展并主导血液。大多数这些体细胞清除在采样期之前已经达到固定(“完成的选择性清除”)。我们在对照中未检测到任何选择性清除或完成的选择性清除。我们还观察到克隆扩增的例子,其生长停滞、逆转或经历了多次命运逆转(Fig. 1c),提示同一个体内平行谱系之间频繁且强烈的克隆干扰。这些行为几乎只在 AML前病例中
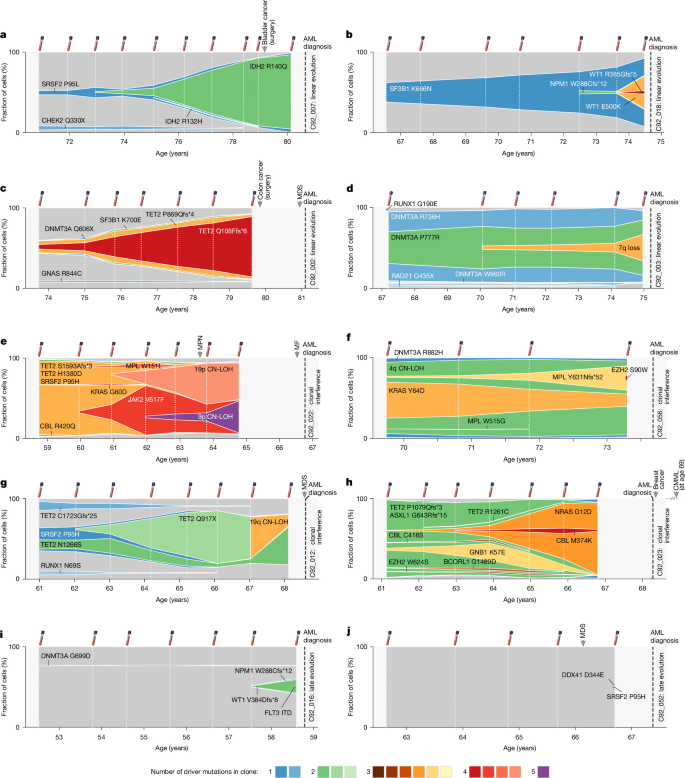
Muller 图展示了十例 AML 前病例中推断的克隆动态,展示了“线性演化”“克隆干扰”或“晚期演化”。每个面板对应一例 AML 前病例。每张图中,条带的垂直范围是归属于该克隆的细胞比例,嵌套条带显示子代克隆在其亲本内产生,横轴为年龄。颜色表示每个克隆中观察到的驱动突变数量(见色例);深灰色表示野生型(非驱动)细胞比例。白色竖向虚线表示 UKCTOCS 血液样本的时间。粗灰色竖向虚线表示 AML 诊断时间。任何 MDS、慢性粒单核细胞白血病(CMML)或骨髓增殖性肿瘤(MPN)诊断,或 AML 前化疗暴露的时间,由带标签的灰色箭头表示(更多细节见补充表 10)。a,线性演化:一个双突变克隆在诊断前约 5 年内席卷血液。b,线性演化:一个大型单突变克隆在诊断前最后几年获得更多驱动突变。c,线性演化:一个四突变克隆扩增并主导血液。d,线性演化:创始克隆在采样开始前已席卷血液,一个三突变亚克隆在诊断前扩增。e,四突变克隆之间的克隆干扰。f,三突变克隆之间的克隆干扰。g,双突变克隆之间的克隆干扰。h,三突变克隆之间的克隆干扰。i,晚期演化:一个推测的白血病前克隆在诊断前最后一年首次被检测到。j,晚期演化:一名胚系 DDX41 携带者,仅在最终样本中检测到一个小型体细胞 DDX41/SRSF2 突变克隆。MF,骨髓纤维化。
驱动突变的定量动态
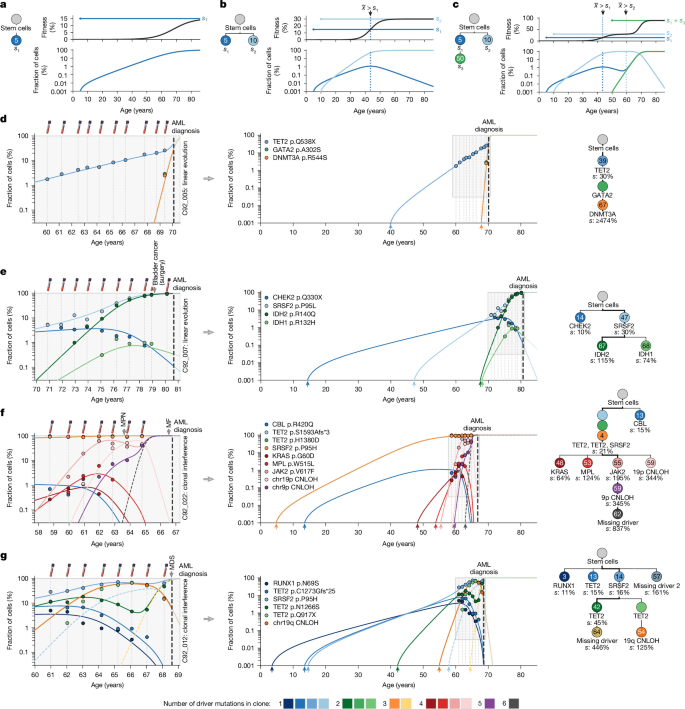
我们推断,我们数据的高灵敏度和时间分辨率可用于定量理解驱动突变在 AML 诊断前数十年中如何扩增和竞争(Fig. 3)。受微生物演化模型32,46 启发,我们开发了一个数学框架,用于预测克隆如何随时间扩增和竞争。在该框架中,给定克隆的动态由其出现时间、适应度效应以及最简单的相互作用项决定:群体中所有其他克隆的“平均适应度”不断增加,从而确保所有克隆的群体频率总和为 1。特定变异的动态通过将原始亲本克隆(即第一个获得该变异的克隆)的频率与所有继承该变异的子代克隆的频率相加来确定(Fig. 3a–c)。
急性髓系白血病发生前数年的演化动力学
a–c,示意图展示克隆组成(左,系统发育树)与每个克隆的适合度和出现时间(上图)如何通过群体平均适合度(黑线,上图)相互作用,从而产生不同的变异频率轨迹(下图)。注释(例如 \(\bar{x}\) > s1)标记群体平均适合度超过某一克隆适合度的位置,驱动轨迹中可见的逆转。a,单个克隆呈指数扩增,随着平均适合度上升而减慢,并扫荡至固定。b,两个独立克隆之间的竞争:当适合度较低的克隆的适合度被平均适合度超过后,该克隆下降。c,分支内和分支间的竞争产生多次优势逆转。d–g,在 UKCTOCS 血液采样期间(左图)以及自出生以来(右图),测得的细胞比例(数据点)与根据每个克隆适合度和出现时间的最大似然估计预测的变异频率轨迹(彩色线)进行比较。不确定性(95%优化器范围和标准差)见补充表9。灰色阴影表示 UKCTOCS 采样窗口。灰色和粗黑色竖直虚线分别表示血液样本和 AML 诊断。带标签的灰色箭头表示任何其他血液系统恶性肿瘤、AML前癌症诊断或 AML前化疗暴露(补充表10)。系统发育树(右)显示每个克隆推断的出现时间(圆圈中的数字,年)、适合度效应(每年百分比)和驱动突变数量(颜色;见图例)。d,线性演化:一个在约39岁时获得的 TET2 突变克隆缓慢扩增,直到诊断前3年获得另外两个驱动突变。e,线性演化:一个 SRSF2/IDH2 双突变克隆扫荡血液,而低频 CHEK2 和 IDH1 变异下降。f,在一个已经扫荡血液的三突变克隆背景上的克隆干扰,通过一个推断出的缺失驱动突变(虚线)得以解析。g,具有两个推断出的缺失驱动突变(虚线)的克隆干扰。
在度过最初的随机漂变阶段后,携带驱动突变的单个克隆以其适合度决定的速率呈指数扩增(其中“适合度”是相对于野生型造血干细胞(HSCs)的增长率,假设有效群体大小恒定)。这种克隆扩增导致群体平均适合度(\(\bar{x}\))升高,最终使克隆扩增在扫荡至固定过程中减慢(图3a)。两个适合度不同的独立克隆之间的竞争可导致适合度较低克隆的变异频率轨迹在其适合度被群体平均适合度超过后下降(图3b)。分支内克隆之间以及分支之间的竞争,可因克隆超过或落后于群体平均适合度而驱动更复杂的变异频率动态,涉及多次命运逆转(图3c)。利用这一框架,我们开发了一种最大似然方法(方法),以推断每个克隆的适合度和出现时间估计,并将预测的变异频率轨迹(线)与 AML 前病例(图3d–g、扩展数据图3–9和补充图47)和对照(补充图48–55)中测得的轨迹(数据点)进行比较。
我们观察到,这一简单框架预测的变异频率轨迹与观察数据之间高度一致。我们首先考虑一个线性演化的病例,没有克隆竞争的证据(C92_005,图3d)。在这里,我们推断一个 TET2 变异在约39岁时获得,并以约2.4年的倍增时间指数扩增(每年30%的适应度)。约30年后(约67岁时),该谱系又获得两个驱动突变,导致快速克隆扩增,倍增时间约8周(每年≥474%的适应度)。3年后在70岁时确诊。病例 C92_007 也表现出以线性为主的演化模式(图3e)。在这里,我们推断第一个前白血病克隆(SRSF2 p.P95L)在约47岁时获得,并以约2.5年的倍增时间扩增(每年30%的适应度)。约20年后(约67岁时),该谱系获得一个 IDH2 p.R140Q 突变,形成双突变克隆并快速扩增,倍增时间约7个月(每年115%的适应度效应)。这一双突变克隆在患者70多岁后期横扫血液,患者在80岁时被诊断为 AML,此时距获得 IDH2 突变已13年。携带 SRSF2 和 IDH2 变异的双突变克隆的扫荡,使两个低频变异(位于 CHEK2 和 IDH1)在竞争中被淘汰,突出表明高频克隆为低频克隆的行为提供重要信息,反之亦然。
我们接下来考虑有明确克隆干扰证据的病例(图3f、g)。在 C92_022 中,到第一个样本采集时(诊断前8年),一个携带三个驱动突变(SRSF2 p.P95H 和 TET2 双等位基因缺失)的克隆已经完成了对血液的全面扫荡(图3f)。在这一三突变克隆的背景下,发生了快速演化,涉及获得多个进一步的驱动事件。首先,由获得 JAK2 V617F 和 MPL W515L 引起的两个独立克隆在约55岁时出现,并分别以4.3个月和6.7个月的倍增时间扩增(每年约195%和约124%的适应度效应)。这些克隆很快被一个适应度显著更高的克隆在竞争中淘汰,该克隆携带 19p CN-LOH,在约59岁时获得,并以仅2.4个月的倍增时间扩增(每年约345%的适应度效应)。然而值得注意的是,该谱系并未发生扫荡。相反,JAK2 V617F 谱系获得两个进一步事件:一个 9p CN-LOH,以及随后一个来源未知的事件(“缺失驱动”),后者以约1个月的倍增时间增长,并在不到2年内扫荡整个血液。如果不引入一个适应度很高的缺失驱动事件(虚线轨迹,图3f),在65岁时测得的变异频率将与观察到的克隆行为不一致。因此,变异频率轨迹之间的内部一致性可用于检测我们的测序 panel 遗漏的事件(方法)。C92_012(图3g)突出了另一个克隆干扰的例子,其中观察到的 VAF 轨迹提示存在两个缺失的驱动事件。尽管这些驱动事件被遗漏,其他观察到的驱动事件的动态仍使我们能够估计它们的发生时间和适应度效应。
总体而言,这些发现表明,一旦在 HSC 池中建立,前白血病克隆的动态出人意料地可预测。尽管我们不能排除外在效应改变某些克隆,但解释这些数据并不需要引入更复杂的场景:通过假设克隆具有内在适应度,并在空间结构极小的条件下全局竞争一种资源,就可以实现对变异轨迹的极其接近的拟合。
突变的获得年龄与适应度
急性髓系白血病发生前数年的演化动力学
将我们的框架应用于所有pre-AML病例,使我们能够估计这些47例病例(图4)和46例对照(补充图48–56)中许多驱动AML发生的关键事件的适应度和发生时间。在约80%的pre-AML病例中,我们的数据提示,关键驱动事件的获得历时数十年。在发生AML的个体中,三分之二的人在20岁时已经获得了首个驱动突变(图4b)。平均而言,这些首个驱动事件发生在AML诊断前50多年,但以每年约10%至30%的相对温和的适应度优势扩增(倍增时间约为2–7年,图4c)。三分之一的人在50岁时已获得第二个驱动突变(图4b)。平均而言,这些第二次‘打击’发生在AML诊断前约30年,并赋予细胞大得多的适应度优势,使其以每年约20%至100%的速率扩增(倍增时间约为1–3年,图4c)。值得注意的是,随着pre-AML
我们的数据所提供的进化动力学定量图景突出了几个重要特征。首先,转化通常涉及同一克隆中获得多个驱动突变(范围为2–6个),而这些驱动事件获得的时间在患者间存在相当大的差异。其次,白血病前克隆受到强烈的正选择,其适应度优势跨越两个数量级:从适应度最低的单突变克隆每年10%到适应度最高的四突变克隆每年1,000%。第三,变异频率轨迹表现出多样的定性行为,提示在某些情况下存在强烈的克隆竞争(例如C92_012和C92_022),而在其他情况下则完全没有竞争(例如C92_005和C92_007)。
我们假设,这些特征中的许多可能是一个由简单规则集支配的随机进化模型的新现属性。为检验这一点,我们受先前微生物进化模型32,46,47的启发,开发了一个克隆动力学模型,并对其进行了修改以纳入关键实验观察(Methods)。在该模型中,血液由N个循环HSC组成的群体维持,这些HSC每\(\tau \)年对称分裂(图5a)。HSC以每年U的速率获得驱动突变。驱动突变赋予HSC的适应度效应各不相同。在野生型HSC中出现的驱动突变会创建一个单突变克隆,其赋予的适应度优势来自一个分布,该分布的中位数和范围由单一参数s ≈ 16%/年控制(Methods)。在单突变克隆中出现的驱动突变赋予的中位适应度效应大r = 2.5倍(s ≈ 40%/年),从而创建一个双突变克隆。三突变克隆和四突变克隆遵循相同的几何模式(中位适应度效应分别为s ≈ 100%/年和s ≈ 250%/年)。在此框架中,向显性AML的转化定义为同一克隆内获得四个驱动突变,且该克隆在85岁之前达到细胞比例的50%以上。使用既有估计值\(N\tau \) = 105(参考文献38,39,41)、U ≈ 10−5/年(参考文献40)以及单突变适应度效应的s ≈ 16%/年39,42,43,我们在200,200次模拟中模拟了克隆动力学,并考察了在约900例虚拟偶发AML之前数十年中观察到的进化动力学(图5b–d)。
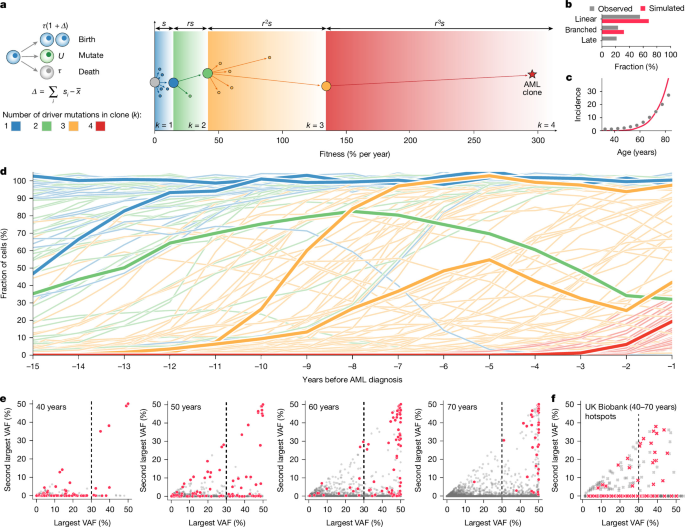
a,随机分支模型(右)和示意图(左),展示克隆(圆圈)如何获得驱动突变以产生子代克隆。驱动突变使适应度产生越来越大的“跳跃”(x 轴),从野生型 HSC(灰色)到单突变(蓝色)、双突变(绿色)、三突变(橙色)和四突变克隆(红色)。模拟 AML 定义为获得四个驱动突变的克隆(红色星号)。克隆生长速率由克隆与群体中所有其他克隆的平均适应度(\(\bar{x}\))之间的相对适应度(Δ)决定。b,观察到的 pre-AML 病例(灰色,n = 47)和模拟 AML(红色,n = 943;来自 200,200 次模拟)被归为线性、分支或晚期演化模式的比例(按 Methods 中的分类)。观察组:47 例中 26 例线性、11 例分支、10 例晚期。模拟组:943 例中 642 例线性、301 例分支、0 例晚期。c,模拟 AML(红色,200,200 次模拟;至 85 岁累积风险 0.47%)和临床检测到的 AML(灰色,数据来自 Cancer Research UK50;0.48%)的年龄发病率(每 10 万人每年)。d,943 例偶然模拟 AML 中前 50 例的变异等位基因轨迹,按克隆中驱动突变的数量着色。e,模拟个体在 40、50、60 和 70 岁时最大和第二大变异的 VAF 联合频率图。为便于阅读,每个面板绘制了 943 例未来 AML 病例中的 100 例样本(红色),以及 199,257 例对照中最多 4,000 例(灰色)。垂直线标记最大 VAF = 30%;其右侧的点至少经历了一次体细胞清除(VAF > 30%)。f,同 e,针对 UK Biobank 中检测到的 27 个克隆性造血热点位置之一(Methods)的变异(年龄约 40–70 岁)。未来髓系白血病病例(红色;n = 114)和对照(灰色,n = 4,920)。发生体细胞清除的个体未来患髓系白血病的风险增加(比值比 = 107,95% 置信区间 75–150;P = 2.7 × 10–67,双侧 Fisher 精确检验)。垂直线同 e。
尽管该模型很简单,但它再现了我们数据中观察到的许多定性和定量特征。在该模型下,线性和分支演化模式都会出现,其中线性模式预计更常见(Fig. 5b)。该模型预测 AML 发病率随年龄强烈增加,与观察到的真实世界 AML 发病率在定量上高度一致(Fig. 5c)。该模型中虚拟 AML 出现前数十年的变异频率轨迹也表现出与观察到的 pre-AML 病例相似的定性行为谱,包括选择性清除、生长逆转、多次命运逆转和晚期快速扩增的例子(Fig. 5d)。尽管模拟对照受相同的演化过程支配,这些行为在对照中几乎完全不存在(Extended Data Fig. 10a–d),表明以罕见结局为条件会对观察到的动态产生深远影响。
我们接下来探讨了该模型能否为识别未来 AML 病例的演化动力学特征提供见解。在 50 年期间绘制的模拟变异频率轨迹显示,该模型中大多数未来 AML 源于以下情况:在虚拟 AML 发生十多年前,单突变或双突变变异已完全横扫血液(扩展数据图 10e)。为了检验这些体细胞变异横扫对未来 AML 的预测能力,我们考虑了所有模拟个体,这些个体至少获得了一个在低深度测序数据中可能被过滤为“胚系”的驱动变异(VAF > 30%),并按年龄细分(图 5e)。在我们的演化模型中,约 99% 的虚拟 AML 病例在诊断前 5 年以上至少发生过一次完全的体细胞变异横扫,约 98% 在诊断前 10 年以上至少发生过一次横扫。在第一次横扫之外,还存在第二个体细胞驱动变异(VAF > 10%)可识别出未来 AML 高风险群体,其阳性预测值在 40 岁时约为 88%(44/50),50 岁时约为 75%(214/292),60 岁时约为 50%(564/1,152),70 岁时约为 22%(719/3,313)。
体细胞变异横扫的存在可用于识别先前因无法区分体细胞变异横扫与胚系变异而被遗漏的未来 AML 高风险群体21,22。为了证明这一点,我们考虑了 UK Biobank 中的个体,其基线血液样本包含的体细胞变异 VAF 高到在低深度全外显子组测序或全基因组测序数据中难以与胚系变异区分(VAF > 30%,图 5f)。考虑已知体细胞热点位置的变异(方法),其中胚系变异的可能性大大降低,我们发现至少有一次体细胞变异横扫的个体相对于没有的个体,未来发生髓系白血病的风险显著增加(比值比 107,95% 置信区间 75–150,P = 2.7 × 10–67,Fisher 精确检验)。这一发现表明,为从体细胞变异检出中去除胚系变异而施加的过滤器可能会去除与未来 AML 风险强烈相关的完全体细胞变异横扫。
讨论
这些数据提供了 AML 在诊断前几十年如何从前体克隆演化的定量图景。对关键驱动事件的获得年龄和适应度效应的估计强调,在大多数情况下,通往 AML 的多步路径的第一步发生在生命早期。在这些早期阶段,血液通常是多克隆的,多个单突变克隆从低细胞比例平行扩增,如克隆性造血中所观察到的41。这些早期白血病前克隆的适应度与在克隆性造血39,42,43 以及年龄匹配的健康对照中观察到的相似。早期驱动变异的动力学仍由正选择而非漂变主导,但它们扩增缓慢:需要数年时间大小翻倍,数十年才能被检测到。
文章标题:急性髓系白血病发生前数年的演化动态
正文: 在这些初始生长缓慢的克隆背景下获得进一步驱动突变,似乎是对照组与未来AML病例之间的决定性差异。在大多数pre-AML病例中,初始生长缓慢的克隆会产生携带两个、之后三个或四个驱动突变的子克隆,其生长速度远快于单突变克隆。在对照组中,这种多突变克隆很罕见:一个双突变克隆扩增至高VAF的情况预计在3,000名60岁人群中发生不到1例(Fig. 5e)。在这些后期阶段,血液通常呈寡克隆性:多个双突变和三突变克隆在独立的谱系上产生,并且由于其更大的适应度效应而扩增并相互竞争,产生经典的克隆干扰模式31,46,49。当种群规模足够大、使得增加适应度的突变并不罕见,但又没有大到使其非常常见(\(\theta =N\tau \mu \,\approx 1\))时,这些模式就会出现。鉴于现有对人类中\(N\tau \) ≈ 105年的估计38,39,41,我们的数据表明,在通往AML的多阶段路径的每一个节点上,驱动突变的获得速率约为每个细胞每年10−5,这与基因组中有数千个位点提供通往适应度增加的突变路径相一致。尽管增加适应度的突变在每个阶段都很常见,但在特定个体中获得转化所需的全部驱动突变的概率是年龄的一个很小、 albeit 强烈增加的函数。因此,这一概念框架可能部分调和了以下事实:癌症驱动突变在健康组织中很常见2,14,15,16,17,同时仍然预测癌症本身会相对罕见50。这一演化框架也可能提供一种自然的方式来纳入关于环境风险因素的最新发现51。增加突变克隆适应度的暴露可能会促进肿瘤发生,而抑制其适应度的暴露则具有保护作用。
随机性在这些动态中起着关键作用。生命早期获得高适应度的双突变和三突变克隆似乎是未来AML风险的关键决定因素。早期血液的完全选择性清除即为例证,其中所有血细胞均源自单个HSC祖先。我们在47例pre-AML病例中至少三分之一观察到这一点——这是一个保守估计,因为我们的panel遗漏了一些驱动事件。在大规模队列(如UK Biobank)中识别早期体细胞选择性清除具有挑战性,原因是对高VAF的种系变异进行了过滤。我们推测,通过识别体细胞选择性清除,例如使用第二份组织样本(如口腔拭子)去除种系污染,未来AML的风险预测可能会大幅改善。
第二个和第三个“打击”通常发生在诊断前十多年,这提供了很长的干预机会窗口。C92_007中的IDH2 R140Q双突变就是一个典型例子。它在诊断前以约115%的适应度效应呈指数扩增14年(Fig. 3e)。如果该克隆的生长被减缓(例如,使用IDH抑制剂24或新抗原疫苗25),不禁让人推测AML是否本可以被预防。由于克隆生长的指数性质,即使生长速率的适度降低,经过数十年的累积,也可能对前白血病克隆的大小产生深远影响,从而影响其获得进一步转化突变的概率。因此,我们推测,产生此类高风险克隆减少的低毒性干预措施可能会大幅降低转化风险。
文章标题:急性髓系白血病发病前数年的演化动力学
正文: 我们研究的一个局限在于,我们无法直接获取诊断材料,这意味着我们无法确定在 pre-AML 样本中可检测到的克隆是否真正导致了 AML。此外,在某些病例中,最终的转化事件很可能发生在我们最后一次血液样本之后。事实上,我们在 pre-AML 中发现的突变谱与 AML 诊断时通常见到的突变谱之间存在有趣的差异,例如,在 60 岁或以上的患者中,NPM1 和 FLT3 突变见于 25–35% 的病例52,而我们研究中靶向的染色体重排见于约 10%(参考文献 53),但这两者在我们队列中均罕见。它们在我们样本中的缺失强烈提示它们是晚期发生的事件。我们队列中约 20% 的 pre-AML 病例要么未显示克隆扩增,要么仅显示限于诊断前 1–2 年的快速扩增。来自深度靶向甲基化测序54 的证据强烈提示,这些病例中有 50%(10 例中的 5 例)确实存在预先存在的克隆扩增(例如 C92_048、C92_052、C92_072),而其他病例则不存在(例如 C92_055、C92_063)。这些扩增阳性病例中有两例(C92_048 和 C92_052)携带胚系 DDX41 变异。本研究的一个临床局限在于,关于既往髓系疾病和既往化疗的信息来自登记 linkage 而非直接临床记录审查。基于登记的 ascertainment 可能无法捕获所有诊断或治疗。这些因素限制了 ontogeny 分类(例如 de novo 与 secondary AML)的完整性和确定性,尽管一部分病例有明确记录的既往髓系疾病或既往细胞毒治疗,从而能够进行有把握的分类(补充说明 5)。重要的是,ontogeny 分类不完整不仅反映了临床数据捕获的局限,也反映了早期髓系疾病可能在临床上保持沉默这一事实,尤其是在年龄相关克隆性造血常见的老年人中。因此,我们的队列反映了老年人中发生的 AML 所典型的生物学和临床背景谱,而所识别的演化动力学代表了在这一真实世界人群中运作的过程,而非单一 ontogeny 定义亚组中的过程。
我们的模型假设有效 HSC 群体大小恒定,而诸如白血病前干细胞扩增或分化阻滞等生物学因素可能影响 VAF 与真实克隆负荷之间的关系。因此,我们的适应度估计应被解释为相对于背景群体的有效竞争优势。
我们数据中一个令人惊讶的发现是,已建立克隆的动力学具有多么可预测和确定性的特征。变异轨迹与最简单的克隆竞争模型高度一致:即克隆仅通过一个要求其频率之和为 1 的全局相互作用项进行竞争。这表明,当克隆在血液中增长至细胞分数大于 0.2% 时,由于多个微环境的混合和再播种55,56,骨髓中空间结构的影响已被平均化。
文章标题:急性髓系白血病发生前数年的演化动力学
与观察数据不一致的简单演化模型的一个方面,是20%表现为晚期演化的病例。我们的多阶段模型通常预测此类病例非常罕见。我们认为有两种可能的解释。第一,该模型未考虑由单一超罕见事件驱动的 AML,例如定义 AML 的易位,如 t(15;17); PML::RARA。第二,可能发生在我们测序 panel 之外的白血病前克隆性扩增。尽管我们确实覆盖了绝大多数已知 AML 驱动因素,但很可能仍有罕见的 AML 驱动因素有待发现,正如在克隆性造血41中见到的遗传起源未知的克隆性扩增所提示的那样。这或许能解释部分病例,例如 C92_052,我们对其甲基化54的分析强烈提示存在一个完全取代的克隆。
我们测量体细胞演化如何塑造疾病风险、又如何被疾病风险塑造的能力,是人类遗传学的一个新前沿57。造血系统是发展体细胞演化定量理解的理想模型,因为其易于采样、相对缺乏空间结构以及已有大量大型数据集。我们的工作是迈向对 AML 发生完整定量理解的一步。需要进一步工作来理解这些原则是否以及能在多大程度上推广到其他癌症。
方法
纵向外周血 DNA 样本
纵向外周血 DNA 样本取自作为 UKCTOCS 一部分生物样本库保存的血清样本(ISRCTN22488978;ClinicalTrials.gov 标识符:NCT00058032)。UKCTOCS 是一项多中心随机对照试验,于2001年至2005年间从英格兰、威尔士和北爱尔兰招募了202,638名50–74岁的绝经后女性,以评估筛查对卵巢癌死亡率的影响3。UKCTOCS 的入组标准和试验细节此前已有描述58。UKCTOCS 经 North West Multi-centre Research Ethics Committee 审查和批准(REC reference 00/8/34),参与者提供了书面知情同意,同意将其样本和数据用于经伦理批准的二次研究。我们使用 UKCTOCS 样本和数据的研究经 South Central Berkshire B Research Ethics Committee 审查和批准(REC reference 18/SC/0481)。本研究按照所有相关指南和法规进行。
在 UKCTOCS 入组时,50,640 名参与者被随机分配至“多模式筛查组”,该组涉及每年采集血清样本,最长持续 11 年,直至 2011 年 12 月 31 日。所有样本均按标准化方案采集。血液在试验中心采集于凝胶管(8 ml 凝胶分离血清管;Greiner Bio-One 455071)中,并每日在室温下运送至中心实验室;在那里样本经离心(1,500g,10 分钟),分离出的血清使用半自动 MAPI 平台(IMV)分装到 10 × 500 µl 细管中。这些细管储存在中心实验室的液氮罐中;液氮罐装满后,被运送至 HTA 许可的商业冷冻设施(Fisher Bioservices, UK,直至 2018 年 3 月;NIHR Biocentre,2018 年 4 月至 2023 年 7 月;此后为 BioDock)。从样本采集到离心的中位时间(约 22.1 h)导致白细胞 DNA 泄漏到血清59中。通过链接至国家癌症、死亡和行政登记系统,对 UKCTOCS 参与者的健康结局进行随访。到 2017 年,“多模式筛查组”中有 47 名女性偶然罹患 AML(ICD-10 C92.0),并且在 AML 诊断前至少两个时间点有足够的可用血清样本。这 47 名女性被诊断为 AML 的中位年龄为 72 岁(范围 53–83 岁,四分位距 8 岁),且在 AML 诊断前有来自中位 5 个时间点(范围 2–10,四分位距 3.5)的血清样本完成生物样本库储存(Extended Data Fig. 1a,b)。我们从这 47 名女性(“pre-AML 病例”)可获得的每个年度时间点各获取 1 ml 血清(249 份样本),并从 47 名年龄匹配、保持无血癌的 UKCTOCS 参与者(“对照”)中获取时间点匹配的连续样本。随后一名对照因发生 MDS 被排除。未使用统计方法预先确定样本量;所有符合条件的 pre-AML 病例均被纳入。由于这是观察性研究,随机化不适用;在测序和分析期间,研究者对病例–对照状态未设盲。DNA 由 LGC Genomics 提取,使用在 KingFisher 96 上基于磁珠的改良 Kleargene 方法,并洗脱于 10 mM Tris-Cl,pH 8.0。DNA 使用 PicoGreen 定量,在 pre-AML 样本中平均为 279 ng ml−1 DNA(范围 11–814 ng ml−1 血清),在对照样本中为 270 ng ml−1 DNA(范围 11–1,313 ng ml−1 血清)(Extended Data Fig. 1c)。
文章标题:急性髓系白血病发生前数年的演化动力学
正文: 通过与国家癌症登记处(英格兰/威尔士)、医院病例统计(HES)数据库或威尔士患者病例数据库(PEDW)、国家统计局死亡记录进行记录链接,以及针对北爱尔兰参与者与中央服务机构和北爱尔兰癌症登记处进行记录链接,获取了所有 pre-AML 病例和对照中任何 MDS(ICD-10 编码 D46 或 C94.6)、CMML(ICD-10 编码 C93.1)或 MPN(ICD-10 编码 D45、D47.1、D47.3、D47.4、C92.1、C92.2、C94.4)或其他血液系统恶性肿瘤(例如淋巴瘤或骨髓瘤)诊断的信息。非血液系统恶性肿瘤的诊断信息也通过链接国家癌症登记处和 HES/PEDW 数据库以及国家统计局死亡记录获得。提取这些临床诊断用于描述既往髓系疾病、既往恶性肿瘤和治疗暴露,以提供与继发性和治疗相关 AML 框架相关的临床背景(详细病例注释见补充说明 5)。当某一诊断出现在多个数据源中时,以最早记录的条目作为诊断日期。因此,记录的诊断日期反映的是诊断在国家记录中首次出现的时间,可能并不对应于疾病的生物学发病时间。通过交叉核对可用来源评估了可能的编码错误:仅在 HES/PEDW 中出现一次且与其他 HES/PEDW 事件、癌症登记数据或死亡证明信息不一致的诊断条目,被视为可能编码错误并予以排除。AML 诊断前(对于对照,则为匹配病例 AML 诊断年龄之前)接受化疗(ICD-10 编码 Z51.1、Z51.2、Z92.6)或放疗(ICD-10 编码 Z51.0、Z92.3)的信息从 HES 数据库和 PEDW 获得。对于有化疗记录的参与者,通过交叉核对 HES/PEDW 和/或癌症登记数据中的诊断编码来确定适应证。与 AML 诊断在时间上相关且缺乏既往恶性肿瘤证据的化疗编码被认为是指向 AML 的化疗,未归类为 pre-AML 暴露。没有 pre-AML 病例或对照被记录为曾接受过放疗。吸烟信息(如有)从 UKCTOCS 参与者问卷和 HES 数据库(ICD-10 编码 Z72.0)获得。所有链接来源的最后更新于 2020 年收到。由于 HES 和 PEDW 仅覆盖英格兰和威尔士由 NHS 资助的医疗,在私立机构、国外或英国其他地方进行的诊断或治疗可能未被捕获。补充表 10 汇总了所有 pre-AML 病例和对照中任何记录的 MDS、CMML、MPN 或其他血液系统或非血液系统恶性肿瘤诊断的时间,以及既往化疗暴露和吸烟史,并仅对 pre-AML 病例汇总了死亡结局(死因和生存间隔)。
细胞类型解卷积
为估计样本中不同血细胞类型(B 细胞、自然杀伤细胞、CD4+ T 细胞、CD8+ T 细胞、单核细胞、中性粒细胞和嗜酸性粒细胞)的比例,我们使用了 R 包 EpiDISH 及参考数据集‘centDHSbloodDMC.m’60。为来自 23 例 pre-AML 病例和 23 例对照的 94 份 UKCTOCS 样本制备了全基因组亚硫酸氢盐文库,其中部分样本贡献了不止一个纵向时间点。在这 94 份样本中,88 份符合最低覆盖标准(333 个 CpG 中至少覆盖 286 个)并纳入解卷积分析(平均深度 7×)。每份样本单独进行解卷积,使用该样本中覆盖的参考 CpG(补充说明 1 和补充图 1)。
TETRIS-seq 定制 panel 设计
文章标题:急性髓系白血病发生前数年的演化动态
正文: 为确保我们能够在纵向 pre-AML 样本和对照样本中追踪一系列全面的克隆性造血和 AML 相关基因组变化的演化,我们开发了两个独立的靶向 panel,在同一份输入 DNA 样本上以整合文库制备的方式使用:一个小 panel(约 58 千碱基(kb)),专门用于 SNV 和 indel;一个大 panel(约 1.6 兆碱基(Mb)),用于 mCA、染色体重排和 KMT2A 部分串联重复(KMT2A-PTD)检测(补充说明 2)。
对于 SNV 和 indel panel,我们设计了一套定制的 120 核苷酸(nt)寡核苷酸探针(TWIST Biosciences),靶向克隆性造血和 AML 中常见突变的 34 个基因内常见突变的 exons(补充图 2–5 和补充表 1):ASXL1、BCOR、BCORL1、CBL、CEBPA、CHEK2、CSF3R、DDX41、DNMT3A、EZH2、FLT3、GATA2、GNAS、GNB1、IDH1、IDH2、JAK2、KIT、KRAS、MPL、NPM1、NRAS、PPM1D、PTPN11、RAD21、RUNX1、SF3B1、SRSF2、STAG2、TET2、TP53、U2AF1、WT1 和 ZRSR2。
对于 mCA、染色体重排和 KMT2A-PTD panel,我们设计了一套定制的 120-nt 寡核苷酸探针(TWIST Biosciences),靶向全基因组范围内每隔约 280 kb 分布的共 10,326 个常见 SNP(次要等位基因频率 > 0.01),以支持 mCA 的检测(补充表 2)。使用该方法,可以检测杂合 SNP B 等位基因频率(BAF)的偏离,结合 read depth 信息,即可检测 gain、loss 或 CN-LOH 事件。对于染色体重排的检测,设计了一套定制的 120-nt 寡核苷酸 baits(TWIST Biosciences),靶向七种染色体重排各自重排伴侣染色体的已知 breakpoint 区域61,62,63,64,这七种重排在世界卫生组织 AML 分类65 中定义了 AML 的特定亚类:t(6;9) DEK::NUP214、t(8;21) RUNX1::RUNX1T1、t(9;11) KMT2A::MLLT3、t(9;22) BCR::ABL、t(15;17) PML::RARA、t(16;16) CBFB::MYH11 和 inv(16) CBFB::MYH11(补充图 6 和补充表 3)。KMT2A 以拥有众多可能的 breakpoint 伴侣而著称,因此还靶向了 KMT2A 中更多常见的 breakpoint 区域66。KMT2A-PTD 最常涉及 exon 2 或 3,并跨越 exon 9 至 11(参考文献 67)。可以通过观察从 exon 2 或 3 开始、相对于从不参与 KMT3A-PTD 的 exon(例如 exon 27)的 read depth 相对增加来检测它们68。因此设计了一套定制的 120-nt 寡核苷酸 baits(TWIST Biosciences),靶向 KMT2A exon 2–27(补充表 3)。
TETRIS-seq 错误校正文库制备与测序
TETRIS-seq 文库制备按照“TWIST custom panel enrichment workflow”(TWIST Biosciences)进行,但经过调整以允许引入 duplex unique molecular identifiers(UMIs)用于错误校正测序,并允许在同一份输入 DNA 上使用两个靶向 panel。DNA 产量在 UKCTOCS 样本之间有所差异(扩展数据图 1),但对于每个时间点,pre-AML 样本和匹配对照均使用相同量的输入 DNA(平均 43 ng,中位数 50 ng,范围 4.5–80 ng)。
文章标题:急性髓系白血病发生前数年的演化动态
正文: 简言之,DNA 在 32 °C 下经酶促片段化(使用 Twist Biosciences 专有酶混合物)、末端修复并加 dA 尾 21–24 分钟(补充表 4)。随后将含有 3-bp 双链 UMI 序列的 IDT xGen CS 接头(5.5 µl,10 µM)在 20 °C 下连接至 DNA 片段两端 15 分钟,随后使用 0.8× DNA 纯化磁珠(Twist Biosciences)进行磁珠纯化。双链 UMI 标记的片段在 50 µl 反应体系中进行 PCR 扩增(25 µl KAPA HiFi HotStart ReadyMix(Roche Diagnostics)、10 µl IDT xGen 独特双索引引物(10 µM)、15 µl 双链 UMI 标记片段)。PCR 扩增条件如下:98 °C 45 秒;98 °C 15 秒(补充表 5)、60 °C 30 秒、72 °C 30 秒,共 11–12 个循环;72 °C 1 分钟。使用 1× DNA 纯化磁珠(Twist Biosciences)进行磁珠纯化后,将扩增的 UMI 标记双索引片段洗脱至 22 µl ddH2O 中,然后使用 Agilent 2200 TapeStation 进行可视化和定量。
定量后,每个样本分为两份:一半用于 SNV/indel panel,另一半用于 mCA/染色体结构重排 panel。样本按每组八个合并(每个带索引样本 187.5 ng),两个 panel 分别合并。合并后的样本使用 1.5× Agencourt AMPure XP 磁珠(Beckman Coulter)浓缩,然后在热循环仪中于 95 °C 杂交 5 分钟,随后 70 °C 杂交 16 小时,与定制 panel 探针(SNV/indel panel 探针或 mCA/染色体结构重排 panel 探针)杂交。链霉亲和素磁珠捕获(室温 30 分钟)后,捕获的 DNA 在 50 µl 反应体系中进行 PCR 扩增(25 µl KAPA HiFi HotStart ReadyMix(Roche Diagnostics)、2.5 µl TWIST 扩增引物、22.5 µl 捕获 DNA),条件如下:98 °C 45 秒;98 °C 15 秒、60 °C 30 秒、72 °C 30 秒,共 12 个循环(mCA/染色体结构重排 panel)或 17 个循环(SNV/indel panel);72 °C 1 分钟。使用 1× DNA 纯化磁珠(Twist Biosciences)进行磁珠纯化后,样本洗脱至 32 µl ddH2O 中,然后使用 Agilent 2200 TapeStation 进行可视化和定量。随后将样本稀释至 10 nM 并送测序。文库在 Illumina NovaSeq 6000 S4(Cancer Research UK Cambridge Institute Genomics Core Facility)上使用 XP 工作流程进行测序,采用 150-bp 双端读长,index 1 为 8-bp 读长,index 2 为 8-bp 读长。每个泳道测序四十个样本,每个泳道掺入 10% PhiX 对照 DNA。SNV/indel 和 mCA/染色体结构重排 panel 在不同泳道中测序,且除少数例外外,同一个体的不同时间点在不同泳道中测序。每次测序运行每个泳道约产生 30 亿条读长(每个样本约 6800 万条读长)。对于 SNV/indel panel(约 58 kb,589 个探针),这相当于约 50,000× 的原始深度(一致性序列调用前)。对于 mCA/染色体结构重排 panel(约 1.6 Mb,13,114 个探针),这相当于约 1,000× 的原始深度。
编写了定制计算工作流程用于处理测序数据。该工作流程使用了多个软件包,包括 Picard69、Fulcrum Genomics fgio package70、Burrows–Wheeler Aligner(BWA)71、Genome Analysis Toolkit(GATK)72、SAMtools73、VarDictJava74、Pindel75 和 ANNOVAR76,以及若干定制 Python 脚本。该工作流程包括四个主要步骤(补充说明 2c):(1)UMI 提取和初步比对;(2)单链一致性序列(SSCS)调用;(3)双链一致性序列(DCS)调用;(4)推定变异检测。对于 SNV/indel panel,变异从 DCS 文件中调用。mCA、KMT2A-PTD 和染色体结构重排 panel 不需要相同的深度准确性,因此仅使用 SSCS。
用于 SNV 检出的 TETRIS-seq 计算机模拟噪声校正模型
双链测序的理论错误率低于每 bp 10−9 个错误,这实际上就是两条 DNA 链上同一核苷酸位置同时发生两个互补错误的概率,无论是自发发生还是在第一个 PCR 循环中发生44。然而在现实中,文库制备伪影,例如由超声处理、末端修复和比对错误45引起的伪影,均已被证明会逃过双链错误校正。因此,为了能够在超低频率下可靠地检出变异,我们开发了一种用于 SNV 检出的计算机模拟噪声校正方法(Supplementary Note 2)。我们的噪声校正模型基于以下零假设:panel 中某个位置上的每种碱基改变都有特定的错误率(\(\varepsilon \)),并且在该位置某个样本中观察到的变异读段数(k)应符合该特定错误率下的 beta-二项采样。我们编写了一个自定义 Python 脚本,用于推断 panel 中每个位置(以下简称为“位置”)上每种可能的单核苷酸碱基改变的错误
使用 VarDictJava74 从 DCS 文件中检出 Indels,并按补充说明2中的详细描述应用后处理过滤。使用 Pindel75 识别 FLT3 内部串联重复(FLT3-ITDs),若在 SSCS 和 DCS 文件中均检测到,则判定为真实。用 Python 编写了一个定制的染色体重排检出程序,并使用具有已知染色体重排的样本的系列稀释液进行了验证(补充说明2i)。该检出程序采用逐步算法识别四类染色体重排。检出仅限于我们测序 panel 特异性靶向的 AML 相关重排的常见断点区域(补充图6)。首先从这些靶向区域中提取不一致读对及其补充比对,以识别候选断点。根据读段配置,可推断一个或两个断点配对端。对于仅识别出一个配对端的不一致读段,将 ≥10 bp 的软剪切区域通过与其与至少三个读对中已识别出的断点配对端序列进行比较来进行“重新比对”;若序列匹配度超过 95%,则判定为匹配。没有不一致比对的一致软剪切读段也以类似方式“重新比对”,即与至少五个读对已识别出的断点配对端序列进行比较。每个断点的 VAF 按支持读段数与局部读段深度的比值计算,并报告两个断点 VAF 中较高者。使用 ANNOVAR76 注释断点坐标,随后对所有检出结果进行后处理,以细化断点坐标、去除伪影,并合并对应于同一潜在重排的多个基于读段的事件(补充说明2i)。染色体重排检出最初在 pre-consensus BAM 文件上进行,但后处理后仍保留的任何重排均在 SSCS BAM 文件上重新检出,以便更准确地定量 VAF。
TETRIS-seq mCA 与 KMT2A-PTD 检出
为检测 KMT2A-PTD 事件,编写了一个定制的 Python 脚本(使用 pysam77 pileup),用于计算每个靶向 KMT2A 外显子的平均读段深度。随后将这些平均深度相对于 KMT2A 外显子27的平均读段深度进行标准化,并计算外显子3:27比值(R)。携带 KMT2A-PTD 的细胞比例按以下公式计算:cell fraction = 2(R − 1)(补充说明2j)。
使用基于 Python 的自定义调用程序从 SSCS reads 中检测 mCA,该程序旨在利用 mCA/染色体重排 panel 中杂合 SNP BAF 和测序深度(log2R 比值;LRR)的偏差,以及从同一 mCA 以较高细胞比例存在的时间点获得的纵向单倍型定相信息(Supplementary Note 2k)。缺失和获得事件会导致 LRR 和 BAF 均出现偏差,而 CN-LOH 事件会导致 BAF 偏差但 LRR 不变(因为遗传物质数量没有变化)(Supplementary Fig. 25)。LRR 值根据测序深度计算,并归一化到由 36 个对照样本构建的正常样本 panel,对正常样本 panel 内的样本采用留一法策略。每条染色体独立运行五个互补检测器,针对等位基因失衡和拷贝数变化的不同特征:一个 BAF 滑动窗口检测器(在三种窗口大小下运行,以捕获不同大小范围的事件)、一个 LRR 优先检测器、一个用于高细胞比例 CN-LOH 和缺失事件的纯合区域检测器、一个针对三体模式 BAF 分裂的小片段获得检测器,以及一个用于细微全臂事件的臂水平检测器。候选事件被分类为获得、缺失或 CN-LOH,方法是根据 BAF 衍生的细胞比例估计,选择预期 LRR 与观察到的 LRR 最匹配的事件类型。细胞比例根据杂合 BAF 峰分离度使用 Supplementary Table 16 中的公式估计。来自所有五个检测器的调用结果被合并并去重,在最早和最晚可用时间点均以 100% 细胞比例检测到的 CN-LOH 事件被归类为可能为生殖细胞来源并排除。基于对独立模拟测试集的评估(该评估显示对小于 5 Mb 的事件的灵敏度显著降低),所有下游分析仅保留大于或等于 5 Mb 的事件(Supplementary Figs. 26–29)。
对于检测到体细胞 mCA 的个体,对所有可用的纵向样本进行了测序,并应用了自定义的定相纵向调用程序。单倍型定相来源于“索引样本”,定义为病例中距离 AML 诊断最近的时间点(或对照中的匹配时间点),但有一个例外(C92_012),其 mCA 在该时间点低于未定相调用程序的检测限,因此改用其之前的时间点作为“索引样本”。在“索引样本”中,通过比较每个杂合 SNP 的 BAF 相对于 0.5 的位置来指定定相。然后,这些定相分配被应用于同一受试者的所有其他可用时间点,并使用单侧单样本 t 检验评估定相 BAF 平均偏差是否显著大于零(P < 0.05)。细胞比例根据平均定相偏差使用事件类型特异性公式估计(Supplementary Table 16)。在模拟测试数据上,定相调用程序达到 50% 灵敏度检测阈值时约为 1% 细胞比例,而未定相调用程序为 20–25% 细胞比例(Supplementary Figs. 26–29)。在 UKCTOCS pre-AML 病例和对照中检测到的体细胞 mCA 调用结果见 Supplementary Table 7。
推断克隆架构
采用分层逐步过程来推断某个变异是否可能是克隆中唯一的驱动突变(即“单突变克隆”),还是更可能与该个体中检测到的其他一个或多个变异处于同一克隆(补充表8)。首先,我们查看个体中检测到的每个变异的最大细胞比例:使用鸽巢原理,如果任一时点两个变异的细胞比例之和超过100%,则推断这两个变异处于同一克隆。其次,我们查看变异轨迹的细胞比例动态:如果细胞比例轨迹在任一时点发生交叉(即一个变异的细胞比例上升到高于另一个变异的细胞比例),则推断这两个变异处于不同克隆。第三,我们查看变异之间细胞比例动态的相关性:如果两个变异的轨迹表现出相似的增长动态(例如在相同时点细胞比例升高或降低),则推断这些变异处于同一克隆。接下来,如果新变异获得时已存在一个较大的克隆,那么当新变异获得时该较大克隆的细胞比例超过50%,我们推断这个新变异更可能出现在已有的较大克隆内。最后,特别是在考虑仅在最接近 AML 诊断时点的样本中检测到、但仍以低细胞比例存在的变异时,我们查看变异的增长率及其相对于 AML 诊断的时间:增长率越高,且变异首次检测到的时间越接近 AML 诊断,我们就越可能推断该变异与多突变克隆相关。
演化模式分类
每个 AML 前病例和对照的演化模式被分类为“克隆干扰”、“晚期演化”或“线性演化”。“克隆干扰”定义为并行演化分支上存在多个驱动克隆,其中至少一个克隆扩展到造血细胞池的相当比例(操作上定义为细胞比例超过10%),从而影响其他共存克隆的轨迹。“晚期演化”定义为推测的白血病前克隆仅在 AML 诊断前1–2年内可检测到(或者,对于对照,在匹配病例 AML 诊断年龄之前可检测到),或者完全未检测到致病驱动突变(由我们的 panel 覆盖)的病例。“线性演化”涵盖不符合上述两类的病例,通常表现为驱动突变沿单一优势主干依次获得并扩展,几乎没有证据表明存在高频侧支分支或来自并行高频谱系的竞争。
推断突变获得年龄与适合度效应
我们开发了一个数学框架,用于推断克隆的获得年龄和适合度效应。在该框架中,每个克隆(由其最近获得的突变定义)具有一个“建立时间”(\({t}_{0}\))和适合度效应(s),它们决定克隆随时间的大小,使得在特定时间(\({t}_{1}\)),克隆大小由方程给出
群体中所有克隆的频率(包括未突变的 HSC)总和为1,使得在特定时间(\({t}_{1}\)),克隆频率由方程给出
急性髓系白血病发生前数年的演化动力学
特定变异的动力学通过该变异的 VAF 直接测量,其由原始亲本克隆(即第一个获得该变异的克隆)的频率与所有继承该变异的子代克隆的频率求和决定。利用这一框架,并结合对每个样本克隆结构的推断(如上所述),我们开发了一种最大似然方法,通过比较所有 pre-AML 病例和对照中预测的 VAF 轨迹与观察到的 VAF 轨迹,来推断群体中每个克隆的适应度和建立时间估计。为了在给定预测轨迹的情况下为观察数据分配似然,我们开发了如下似然函数:对于每个时间点的每个变异,我们使用二项概率为观察到的变异读段数分配似然,其均值由预测频率给出,样本量由样本中该位置的总深度给出。将所有轨迹的所有变异时间点上的 log(likelihoods) 求和,我们的最大似然方法最小化所有总 log(likelihoods) 之和。
我们的最大似然优化方法从每个克隆的建立时间和适应度的“初始估计”开始。根据 VAF 时间点的数量,这通常估计自穿过 log(VAF) 轨迹所画直线的梯度(对不可检测的 VAF 时间点使用或不使用 ‘bounded VAFs’),或者基于克隆中突变的数量(Supplementary Note 4)。一旦每个克隆的建立时间和适应度的“初始估计”设定,就应用三阶段最大似然过程。在每个阶段内,执行大约 1,000–5,000 次优化,每次优化都调整建立时间和适应度,以找到该样本中所有轨迹的最低总 log(likelihood)。三个阶段中的每个阶段都涉及随着每次优化对克隆的预测建立时间和适应度进行逐渐更精细的调整(类似于模拟退火)。在某些情况下对 log(likelihoods) 施加惩罚,例如,用于处理变异不可检测的时间点(Supplementary Note 4)。对于每个样本,三阶段最大似然过程对 25 个“种子”重复进行,并将产生最低总 log(likelihood) 的种子的结果作为该样本中变异的最可能建立时间和适应度。
为了量化我们的适应度和建立时间估计周围的不确定性,我们考虑了所有似然分数处于最佳(最低)log(likelihood) ±20% 以内的“种子”。由此,我们计算了两个不确定性度量:(1) 这些种子间参数估计的 95% 范围(“95% 优化器范围”),定义为包含 95% 数值的中心区间;(2) 这些参数值的标准差(Supplementary Note 4、Supplementary Fig. 46 和 Supplementary Table 9)。
血液中演化动力学的模拟模型
在该模型中,血液由 N 个循环 HSCs 组成的群体维持,这些 HSCs 每 \(\tau \) 年对称分裂,并被建模为连续时间生灭过程39。在该框架中可发生不对称分裂,但它们不影响克隆大小,因此未被显式建模。HSCs 以每年速率 U 获得驱动突变。驱动突变赋予 HSCs 的适应度效应各不相同。适应度效应抽取自一个概率密度分布,该分布使用如先前所述40的拉伸指数建模:
其中 \({\mathscr{N}}\) 是归一化常数,k 是克隆中驱动突变的数目,并且我们设 p = 3、r = 2.5。在野生型 HSC 中产生的驱动突变会形成单突变克隆,其带来的适应度优势取自一个分布,该分布的中位数和范围由单一参数 \({s}_{0}\) = 每年 16% 控制。在单突变克隆中产生的驱动突变会带来中位适应度效应,其幅度增大 r = 2.5 倍(典型适应度效应 s = 每年 40%),从而形成双突变克隆。三突变和四突变克隆遵循相同的几何模式(中位适应度效应分别约为 s ≈ 每年 100% 和 s ≈ 每年 250%)。在该模型中,驱动突变的适应度优势以加性方式合并,因此携带 k 个驱动突变的克隆的生长速率由下式给出
其中 \(\bar{x}\) 是群体中所有克隆按其克隆大小加权后的平均适应度,\({s}_{i}\) 表示该克隆中每个驱动突变的适应度优势。向显性 AML 的转化定义为:同一克隆内获得四个驱动突变,并且在 85 岁之前达到超过 50% 的细胞比例。使用既有估计值 \(N\tau \) = 105、U ≈ 每年 10−5 以及单突变适应度效应的 s ≈ 每年 16%,我们在 200,200 次模拟中模拟了克隆动力学,并考察了在 943 例虚拟偶发 AML 之前数十年中所观察到的演化动力学。
UK Biobank 中的高 VAF 变异
在具有外显子组测序数据的 UK Biobank 参与者中判定克隆性造血变异。既往有癌症史的个体(包括自报癌症,但不包括基底细胞癌、宫颈癌前病变和腐蚀性溃疡)被排除,剩余 424,089 名个体。基线之后发生其他血液系统恶性肿瘤的个体也被排除(n = 4,035),剩余 420,054 名个体用于分析。North West Multi-centre Research Ethics Committee 审查并批准了 UK Biobank 的科学方案和操作程序(REC 21/NW/0157),所有参与者在入组时均提供了签署的知情同意书。使用 DNANexus Research Analysis Platform(UK Biobank Application Number 58387)上的 samtools mpileup,从 UK Biobank 外显子组 CRAM 文件中,在先前被鉴定为克隆性造血驱动变异位置的 27 个基因组位点上判定变异39:DNMT3A R320、R326C/G/S、R598、R729G/W、Y735C/F、R736C/G/H/L/S、R771*、R882H/C/S/L/P、W860R、P904L/Q/R;GNB1 K57E;IDH1 R132H;IDH2 R140Q、R172K;JAK2 V617F;KIT D816F/H/V/Y;KRAS G12C/D/V;MPL W515L;NRAS G12C/D/V;SF3B1 K666N、K700E;SRSF2 P95H/L/R。支持 reads 少于三个的变异被丢弃。共鉴定出 516 名在 UK Biobank 基线评估之后被诊断为髓系白血病(ICD-10 C92)的个体(“前瞻性病例”)。总共有 5,034 名个体携带所分析的至少一种克隆性造血变异,其中 114 名为前瞻性病例。总共有 106 名个体携带两种克隆性造血驱动变异,其中 23 名为前瞻性病例。体细胞 sweep 定义为至少一种变异 VAF > 30%;388 名个体存在体细胞 sweep,其中 42 名为前瞻性病例。与前瞻性髓系白血病的关联使用双侧 Fisher 精确检验相对于所有其他参与者进行评估。
统计与可重复性
未使用统计方法预先确定样本量:UKCTOCS “多模式组”中截至 2017 年已被诊断为 AML、并且在 AML 诊断前至少两个时间点有足够血清样本可用的所有个体均被纳入。
报告摘要
有关研究设计的更多信息见与本文关联的 Nature Portfolio Reporting Summary。