 Newshot
文章标题:A Better Vocabulary for Testing
正文: 当代用于讨论软件测试的词汇体系困扰我很久了。单元测试中的“单元”这一概念并没有真正被定义,集成测试集成的是范围任意的模块,E2E 测试的概念说得通,但它对实际被测行为以及测试方法的描述都极为不充分,你是使用自动化代理、人工监督、预定义的动作集合、随机探索……这些全都被一笔带过、含糊掩盖了。另一边你有压力测试、负载测试、渗透测试等等,但业界并没有恰当的归类,一切似乎都基于“感觉”。简单上网一搜就能看到如下这种基于“层级”的分类,以及 Atlassian 的一则“广告”,它给你列出软件测试的 7 种“类型”。
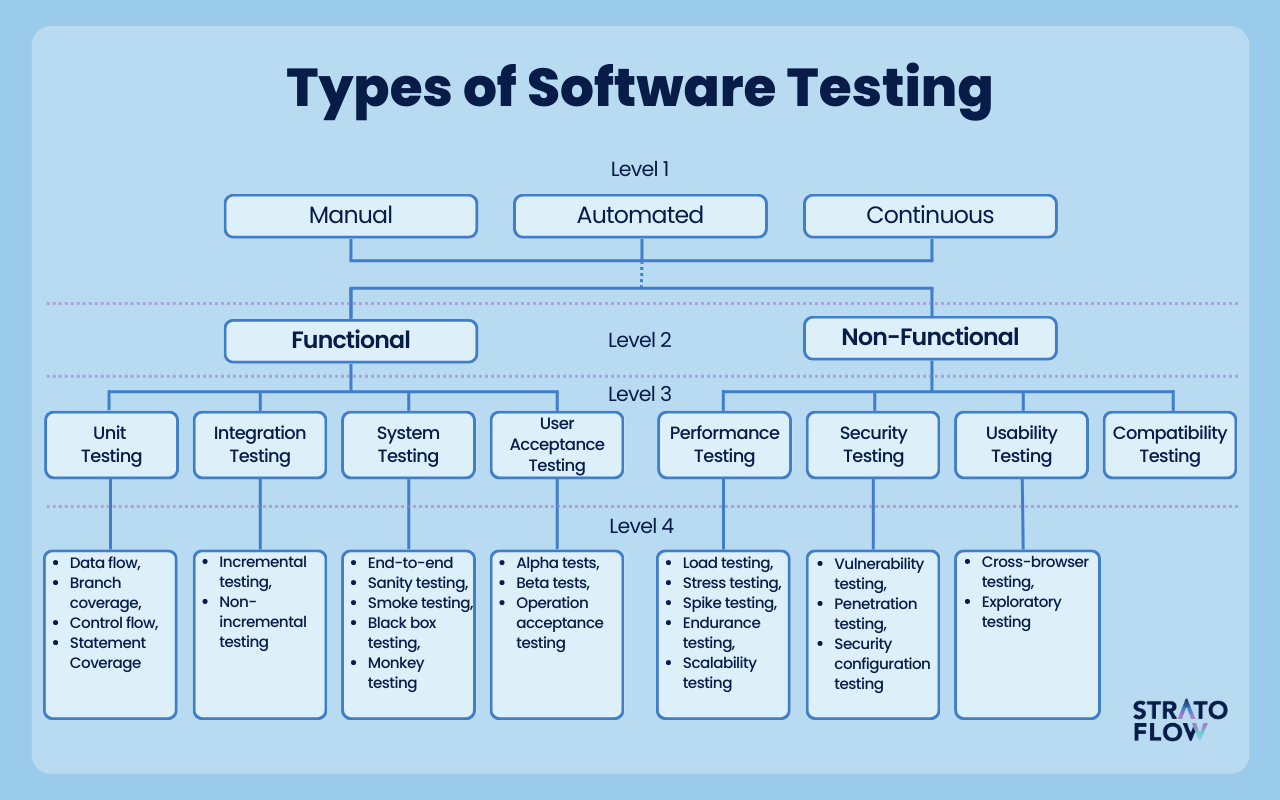
我们能超越这些吗?当然能。我们应该超越吗?我认为应该。我们应当拥有一套可操作的词汇体系,你应当能够根据资源的可用情况来升级或降级你的测试,针对你所处的情形,应当有一份关于可用选项集合的“配方”。当然,这篇文章会非常偏向某一类别,即随机测试,我恰好已经在这个方向上工作了一段时间。
我的观点如下:我们大致可以划分出 5 个不同的类别,其中一些彼此正交,一些则在内部再“分支”。
测试的范围
第一个类别是测试单元的范围,这类似于经典的单元/集成/e2e 测试分类试图含糊定义的东西,但我认为它在这件事上失败了。范围有两个轴,其中一个基于我们所用编程语言的构造,我们可能测试一个函数、一个类/结构体/类型、一个模块,或一个系统。第二个轴是范围是有状态的还是无状态的。你可能有有状态的函数,也可能有无状态的系统,尽管我们预期大多数函数是无状态的、大多数系统是有状态的。应当指出,这些范围之间也差别很大,有人可能会说大型系统的入口函数与系统本身是同一回事,但范围之所以有用,原因如下:
当我们谈论测试任何东西时,我们通常谈论的是输入和输出,但输入空间实际上非常不同。函数,尤其是无状态的函数,消费的是你编程语言中的任意结构。系统接收的是交互或指令,通常是某种被解析和校验的序列化数据。这实际上使得系统测试在输入列表上可以严格得多,因为它包含了一个天然的判别器,能够收缩输入空间,而编程中的函数签名往往过于宽松,函数的输入类型包含了许多该函数永远不会消费的潜在输入。
当状态参与进来时,你的测试可以通过如下方式与前述测试同构化:把对带有状态 s 的函数 f、消费输入 x 并产生输出 y 且将状态变换为 s' 的测试,转换为另一个无状态函数 g,它要么产生初始状态 s,要么让状态对 (s, s') 成为输入输出的一部分。
测试词汇的改进
这种有状态/无状态转换取决于系统的复杂度,因为测试一个输入需要你先把它构造出来。简单的状态可以转化为可构造的输入,但构造一个代表系统真实工作负载的复杂状态并不简单,对许多系统来说甚至完全不可能。在这种情况下,与其把测试改造成无状态的,不如把系统当作一个模拟来对待。你传入基于系统公共 API 的消息,其中包含指令或交互,并在多消息场景中获得回答或确认,你可以检查系统的中间状态以及初始和最终状态,确保你的不变式、前置条件和后置条件成立。
同样,为了让函数测试更易处理,你可以采用契约式设计(Design by Contract,DbC),它在 C++26、D、Kotlin 和 Racket 中有原生支持,在 Python 和 Rust 中有库支持,还有许多我大概没听说过的语言。在 DbC 中,我们可以把对函数输入所做的假设写成函数的注解——这些假设原本可能表现为未检查的指针解引用,或承诺此类输入不可能出现的代码注释——这些注解可以在运行时检查,有时甚至可以通过静态分析在编译期检查。DbC 允许我们约束函数的输入空间,而正如我所说,这个空间在许多时候远大于现实。想象一下为你系统中读取的条目创建一个字典,以及一个与初始 hashmap 一起创建的键列表。在编程语言看来,你对 hashmap 的每次查找都可能失败,而现实中我们知道它们全都应该成功。这在你和编程语言之间制造了紧张关系,让你感觉自己像是在和它搏斗。使用 DbC、更具表现力的类型系统以及更好的领域建模,可以解决其中大部分问题。
测试的目的与假设
测试在某种程度上评估或测量“某物”。它创建一个可以通过运行测试被证伪的假设,而目的就是证伪这个假设。我们可以在不同的领域表达一些假设;最简单的是功能正确性,它评估函数在给定某组输入时是否产生正确的输出。还有其他领域,比如执行时间,我们可以借此测试被测系统的性能;或者安全性,我们可以借此检查系统是否能够抵御潜在的攻击向量。大多数大规模系统是分布式系统,受物理定律约束,可能产生网络延迟、丢包、故障,甚至单机系统也会经历文件系统故障、磁盘损坏等,我们可以测试系统针对这些情况的韧性。混沌测试的概念主要指在出现意外故障的情况下测试系统的健壮性。
根据所关注的领域,这类目的或假设差异很大。在测试潜在时序侧信道的安全场景中,假设是测试将构造一个环境,攻击者能够从中通过执行两个不同输入所需的时间提取信息。在测试系统或网页的可访问性时,假设是存在某种残疾、无法利用全部系统交互的用户将无法执行其需要或想要执行的操作。当然,每个测试都需要一个基于场景的领域特定 oracle。
测试的 Oracle
测试词汇的更好表达
一旦手头有了假设,我们就需要一个 oracle 来验证它。最自然的 oracle 是人。虽然说这是软件公司中 QA 的职责有些轻描淡写(他们也通过创建自动化场景来编写 oracle),但这确实是他们擅长的领域。他们手工编写场景来对系统进行测试,希望发现"不寻常"或"不期望"的场景。其中一些场景可能更为正式,例如,你的软件在任何时刻都不应该卡死或无响应,这是很常见的要求;但另一些场景则基于直觉,比如"这个页面的变换与其他页面相比很奇怪"。我喜欢把这种以人类用户判断作为 oracle 的测试称为"tinker testing"(捣鼓式测试)。
虽然 tinker testing 通常不包含在测试的讨论中,但它是编程的重要组成部分,因为传统的软件测试归根结底是 tinker 测试的编码化。如果你不做测试驱动开发(我大多不做),你很可能先实现一个功能,然后创建一个小测试,在其中可以非常容易地更改参数——如果编译很快,也许手动改就行,或者使用某种从命令行或 Web 用户界面读取输入的功能。我们摆弄软件产生的产物以更好地理解它,因为软件中并非每个功能都是有意的或显式的。许多代码会产生意想不到的后果,这也是我们测试它的部分原因。捣鼓允许我们:(1) 检查产物是否符合预期的后果;(2) 发现我们最终偷偷引入了什么样的非预期后果。代码越"密集",引入非预期后果的可能性就越高,这也增加了对 tinker testing 以及一般测试(包括应用 TDD)的需求,但那是另一个话题了。
第二类 oracle 是示例。当你用一组具体的值来编写单元测试,例如 add(3, 5) == 8,你做的就是基于示例的测试,就像你在计算器上输入 10 + 32 来检查它确实告诉你结果是 42 时所做的 tinker 测试一样。你可以为各种假设编写基于示例的 oracle,尽管我们通常认为它们主要用于功能正确性。你可以测量函数的执行时间来指定上界,例如 time(f(1337) < 0.5),或者 time(sort([])) < time(sort[10, 9, 8, 7, 6, 5, 4, 3, 2 1])。你可以检查你的 SQL 清洗器是否确实能捕获你能想到的特定 SQL 注入。无论场景多么复杂,通常都有办法为其创建一个示例。一些方法将这一想法推得很远,这就是为什么今天的测试文献中有了 expect testing、golden testing 或 snapshot testing——在这些方法中,测试工作流通过验证输出是否符合测试者对给定用户的期望来演进,测试框架将快照保存到文件中,把程序的当前状态编码为正确行为。虽然 expect testing 的主要用例似乎是捕获回归,但它也为我们提供了一种非常容易地创建更多示例的方式,这些示例实际上蕴含了我们程序中许多隐藏的或未表达的语义,因此它们构成了有趣的 oracle。关于 expect testing 的更多内容,Jane Street 的这篇博客文章值得一读。
第三种类型的 oracle 是内联断言,它实际上又回到了我在作用域末尾谈到的 DbC。前置条件是代码块开头的断言,后置条件是代码块末尾的断言,不变式是应当在代码块开头和末尾都成立的断言,尽管在中间可能被打破。内联断言是可以放在程序中任何位置的断言,业内高保障领域有一些公司倡导激进地使用内联断言,甚至在生产环境中也是如此,我建议大家阅读 Tiger Style 文档,他们在编写健壮且安全的软件方面有非常好的原则。内联断言本身并不真正与某种测试方法耦合,这与到目前为止我提到的其他 oracle 不同,那些既是 oracle 又是测试方法。Tinker Testing 将人类直觉和摆弄作为测试方法,将人类判断作为 oracle,而 Example-Based Testing 将输入-输出示例同时作为 oracle 和测试方法,因为用户在产出输入(测试方法)的同时也产出了预期输出(oracle)。Expect testing 在某种程度上耦合了这些方法,用户仍然提供输入,但 oracle 首先是他们的判断,之后是快照时程序的状态。内联断言可以与其他测试方法一起使用,因为它们是规格说明的方法,而不是为被测系统产生输入的方法。
第四类 oracle 是性质,这就引出了基于性质的测试。性质是关于被测代码的抽象陈述,而非基于示例的测试中那种具体输入。有些性质可能是全局不变量,意味着它们像内联断言一样,你在每个执行单元结束时进行检查。这类例子包括许多语言中的“程序永不崩溃”(也许 Erlang 除外?),或者“永不解引用空指针”,或者如果你在运行物理模拟,可能是你希望在每个时间步保持动量守恒,或者根据你的领域可能有任何其他类型的全局一致性指标。其他性质则更为局部,它们是蜕变性质,将两个程序/函数的输出相互关联起来。例如,加法的结合律告诉我们 a + (b + c) = (a + b) + c(这对 IEEE-754 浮点数不成立,所以要小心),或者两个 SQL 查询的 UNION 应该是它们 UNION ALL 的子集。我们还有其他经典性质,比如往返性质,它告诉我们两个互为逆函数的函数会得到原始输入,例如无损压缩算法应该始终具有 decompress(compress(bytes)) = bytes 的性质,或者加上再减去同一个量应该得到原始量 a + x - x = a - x + x = a,这也就相当于某种抵消效果。兼容性是另一种经典性质,功能等价的不同过程在给定相同输入时应该始终返回相同的结果,所以所有排序算法在同一列表上应该始终返回相同的结果 quicksort(l) = bubblesort(l),或者将某些功能并行化不应改变其可观察行为 par(f, x) = f(x),或者你非常复杂的分布式系统应该提供与其更简单的单节点版本相同的可观察行为。这种类型的兼容性,有时称为差分测试,有时称为基于模型的测试,极其强大。它发现了浏览器中的渲染 bug、GCC 中的编译器 bug、SQLite 中的优化 bug,它已被用于测试大规模系统,如 S3 对象存储或 AWS 最近发布的可验证权限引擎 Cedar。我要提到的最后一种经典性质是幂等性,它出现在列表排序中,sort(sort(l)) = sort(l),但由于它能够在物理世界之上创建一个逻辑上的“始终一次投递”层,通常被认为是许多分布式系统的核心性质。与内联断言类似,性质也不指定具体的测试方法。所以给定某个性质 p,你实际上可以在 Tinker Testing 中使用它,这就是为什么 React 会运行你的 effects 两次,以便你能意识到你正在违反 React 的性质,即 effects 不应改变状态,而应创建一个新的状态。你可以在基于示例的测试中使用它,只需提供输入并让 oracle 成为该性质。性质 oracle 还为你提供了更自动化、更强大的系统测试方法。到目前为止我只谈到了第一阶 oracle,即关于我们代码的第一阶逻辑命题的体现。事实上,你可以在更强大的逻辑系统中编写性质,例如模态逻辑,它可以表达关于你程序的时间规格,其中一些等价于我们已经提到的性质,全局不变量等同于线性时序逻辑中的 ALWAYS([]) 模态,LTL 人士称之为“安全性质”,但它们也可以表达“活性性质”,可以谈论应该每隔一段时间或在未来某个不确定时间点发生的事件。我在这方面没有太多背景,我建议你查看 Hillel Wayne 关于 TLA+ 的著作,以了解更多关于这些规格的内容,这些规格同样非常常用
用于测试的更好的词汇
在分布式系统规范中。
测试方法
在上一节中,我区分了测试方法(向测试提供输入)与测试判定器(如何判断测试是否失败),并且已经揭示了 Tinker Testing 和 Example-Based Testing 作为两种测试方法。还有哪些其他方法,可以用于测试属性或内联断言?
我将从另一种我们通常不视为软件测试的测试类型开始,即静态分析。静态分析工具分析一段代码,并判定它是否通过某个“测试”。类型系统实际上就是一个“测试”,它测试你的程序是否类型良好,即没有任何执行会导致类型层面的失败。有两种方式将类型系统视为测试:其一,你可以在“大部分为静态类型”的语言中使用动态类型,例如 Rust 中的 std::any、Haskell 中的 Dynamic、C 中的 void*。这些机制允许你绕过类型系统,这意味着如果你的程序没有正确维护它们并强制转换为不兼容的类型,现在实际上可能在运行时出现类型错误。另一方面,你可以在静态类型语言之上插入静态分析工具,例如 C++ 上的 Infer,或者在动态类型语言之上添加静态类型检查器,例如 Python 上的 mypy/ty,然后观察它们会拒绝你的更宽松系统本会接受的程序。那么这些类型系统持有哪些属性呢?我想把它们纳入讨论的原因是,借此引入对使用 refinement types(请阅读更多相关资料)的新一代类型系统的讨论,这些类型系统可以静态地证明你的属性、不变式或契约。所以你仍然编写与判定器相同的属性或契约,但检查方法现在是静态的,Liquid Haskell、Rust 中的 Flux、Dafny 编程语言是我能想到的,我强烈建议你去了解它们。还有像 CBMC 和 Kani 这样的模型检查器,当你的某些不变式和属性以它们能处理的方式表达时,它们可以静态地检查这些不变式和属性。
你也可以使用枚举,它在理论上是完备的(如果你有无限的时间和算力),因为它枚举你的类型。所以枚举整数看起来像 0, 1, -1, 2, -2……为我们程序中的几乎所有类型编写枚举都是可能的,尽管像图这样的循环类型可能使其非常困难,我相信应该有可能为一个类型建立完备的排序,从而给出枚举(某个非常聪明的 PL 研究者会举出一个让我在此处出错的例子,请这样做,以便我可以添加一个小注记,或者更好的是替我写好注记,我直接插入到这里)。
或者,这本身就是一个相当大的类别,你可以使用随机性。不必按照 0、1、-1……这样的顺序,你可以疯狂一点,用 42、-1337、22222222……。随机性让测试性质变得非常可扩展,因为你可以非常快速地生成许多小结构,也可以以较慢的方式生成能够揭示与你的系统许多交互的大结构。你也不需要完全随机,因为除了生成之外,你还可以变异已有的结构。所以你可以先生成少量输入,一旦有了足够多的输入,就可以不再从头生成,而是开始对已经生成的旧输入进行调整。想象你有一个大列表,你可以直接删掉其中一些、往里面添加更多元素,或者替换中间的一部分。在选择要变异哪些输入时,如果你能有一种衡量它们有多“好”的度量,从而可以优先处理那些输入,那将非常非常好。人们思考这个问题已经很久了,而我们目前拥有的最好的度量之一叫做分支覆盖,现有的随机测试系统会观察你的程序命中了多少分支或基本块,并优先处理那些通向新的、未探索路径的输入。恭喜你,你现在已经了解了 Coverage Guided Fuzzing。一群优秀的模糊测试研究者创建了互联网上最好的模糊测试资源之一——Fuzzing Book,如果你觉得这个概念有意思,请去看看。我之前提到过,差分测试此前在生产系统(如 GCC)中发现了许多正确性 bug,同样地,研究者和安全工程师使用 coverage guided fuzzing 在尤其是 C/C++ 程序中、但也跨越广泛范围发现了数千个 bug,如果你查看任何 fuzzer(AFL、AFL++、OSS-Fuzz)的 trophies 部分,你会看到大量你熟悉的名字。即使没有聪明的随机性,一个写得好的数据生成器配合强性质也能带来许多 bug,CSmith 测试 GCC 和 Clang 就是一个例子,SQLancer 在生产 DBMS 中发现数百个 bug 是另一个例子。并非所有测试都必须像我开头提到的那样处于系统的规模,你可以用不同方式测试函数、模块、系统。
在测试一个函数时,你为输入类型编写随机数据生成器,在循环中随机生成输入,试图证伪你的性质。在大多数语言中,已经有“派生”随机生成器的方法,所以编写性质就是你大部分的工作。你可以尝试对我在上一节提到的经典性质进行模式匹配,或者尝试把你已经写好的基于示例的测试抽象为可以用随机数据测试的通用模式。几乎任何语言都有流行的 Property-Based Testing 库,Python 中的 Hypothesis、Typescript 中的 fast-check、Java 中的 jqwik、Rust 中的 proptest,当然还有万源之本 Haskell 中的 QuickCheck。如果你好奇,这个页面有一份非常全面的列表。这些库替你省去了大量工作,让你主要专注于表达你的性质。
文章标题:A Better Vocabulary for Testing
正文: 在测试一个系统或一个模块时,你需要构建一个“模拟环境”。一个模块会有一组 API,而一个系统会有一组可能的交互,并且它们很可能是带状态的。针对这些带状态的产物测试你的性质,有两种方法:(1) 维护一个系统内部的、更简单的模型——我们实际上正是用它来测试 Turso(一个从零重写 SQLite 的项目)——并利用该模型来决定生成什么、期望系统给出什么结果等等。(2) 通过查询系统,利用系统自身的内部模型来做这些决定,这正是 SQLancer 测试各种 DBMS 时所做的,但如果你所测试的问题与被测系统所维护的内部模型相关,这种方法就容易被系统中的“暗点”所蒙蔽。在测试 DBMS 时,我们维护一份期望该 DBMS 具备的性质列表,并生成随机的 SQL 语句来检查这些性质。以一个更简单的模块为例,比如我们要测试一个栈,我们只需维护一小组交互(pop、push x、empty?),并不断从中挑选,以发现我们此前未曾遇到过的交互。
我已经提到过,在真实的物理系统中,你的输入不只是用户发给系统的消息,整个物理环境都是输入,因此仅测试用户发送的输入是不够的,你还需要测试当你的某台机器关机时、当出现某种文件系统故障时、或当遭遇网络降级时会发生什么。浏览器中的限流选项、关掉你部分机器的混沌测试、从外部杀掉一个进程,都是你如何提供这些物理输入的示例。高保障系统需要这些测试,因为用户在为功能之外的那份保障付费。这一领域一个突出的方法叫做确定性模拟测试(Deterministic Simulation Testing,DST),它人为地向你的系统中注入故障,以测试那些我们通常不会测试的输入。据我所知,这一方法由 FoundationDB 推广开来,但目前 TigerBeetle 和 Antithesis 是你可以进一步了解这些的两个地方,所以我就说到这里。
至此,我结束这份新词汇提案,其中还混入了一些随机测试的广告。我相信软件测试还有很长的路要走,我们所测试的行为集合不过是冰山一角,而随机测试将成为这个未来的关键部分。希望你喜欢阅读本文,如果你有任何评论或建议,请发邮件给我([email protected])。
注:如果你喜欢这篇文章,我强烈推荐 Matklad 这篇关于单元测试与集成测试的文章。