 Newshot
有一个很酷的想法:增量计算。概念很简单:如果你计算了某些东西,然后输入发生变化,这并不一定意味着你需要重新计算所有内容。你的大部分计算可能仍然有效,而且很多时候你只需要重做一小部分变更。
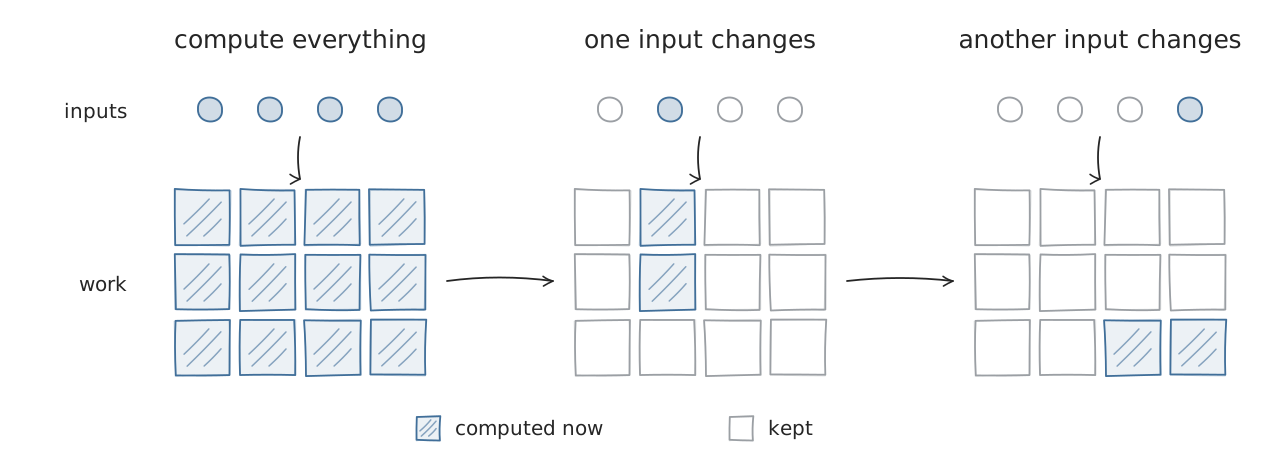
当你需要计算大量内容、存在大量输入,并且这些输入以不同的可能性独立变化时,这个概念通常效果最好。最常见的例子大概是增量编译,它让编译过程尽可能复用已有工作,从而使开发期间的迭代快得多。有趣的部分是“迭代”:注意,增量编译并不一定能让冷构建更快。无论有没有增量性,编译器性能可能大致相同,只是重复复用编译器产物变得更高效。你很可能听说过它。如果你听说过,你大概知道增量编译并不容易(1、2、3)。但它很酷!
如果增量计算概念很好地适用于编译器,那么它甚至更适合 LSP 服务器,因为用户在编辑器中进行编辑的频率远高于重新编译代码,而且每次按键都必须在毫秒级改变编辑器状态(除非你彻底凭感觉,不再需要 IDE 了)。
这可能在某种程度上与 rust-analyzer 使用 salsa 作为其架构核心部分有关。Salsa 是一个让增量计算非常方便和高效的库。不过有一个缺点。它主要被设计为在内存中工作。我们稍后会谈谈它如何工作。
对于像 Rust Glancer 这样试图尽可能降低内存占用的项目,这行不通。因此,很长一段时间里,Rust Glancer 没有使用增量计算,而是拥有一套复杂的持久化缓存网络,带有分片和针对性优化,以使计算高效。而且它确实有效,持续了一段时间。但这种方法扩展性不太好:如果你需要维护手动实现的自定义缓存格式、优化它,并把计算与它绑定,那么你追求的效率越高,得到的复杂度就越高。基本上,复杂度是“二次方”的:它按 O(computations_complexity * cache_implementation_complexity) 增长,因为两者相互关联(计算机科学纯粹主义者们,抱歉犯下这种罪过)。
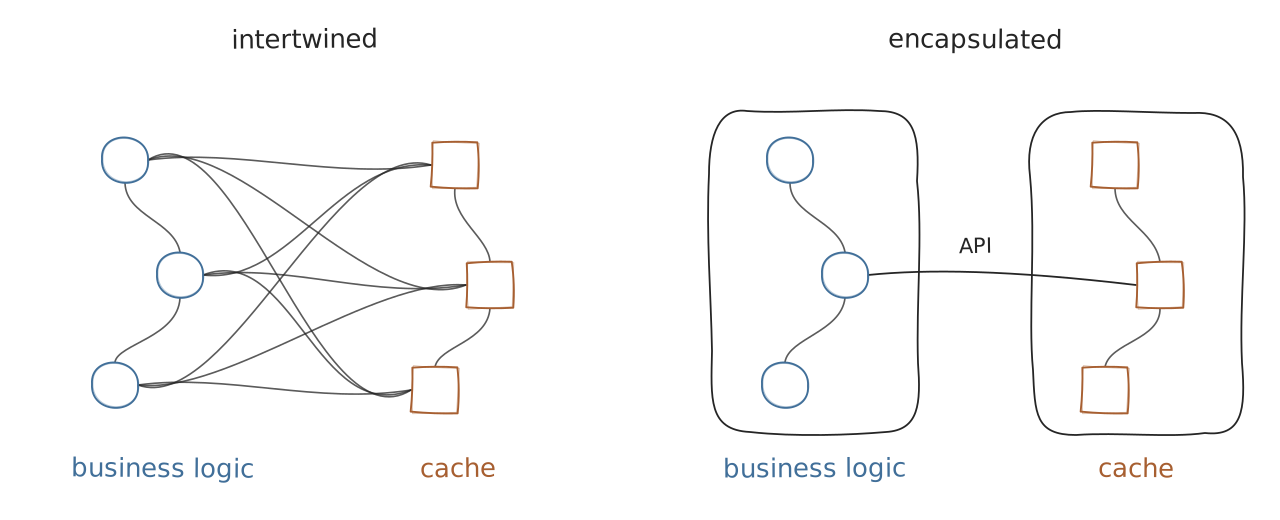
所以……Rust Glancer 到了这样一个阶段:它确实会从持久化增量计算中受益匪浅。而对它的探索结果非常有趣,所以在这篇博客文章中,我们将讨论增量计算如何在内存中工作,以及如何让这种方法与持久化配合工作。
Salsa
在我们开始讨论增量计算底层如何工作之前,先看看它是什么样子。
如果你知道如何使用 Salsa,请随意跳到下一节。如果你熟悉红绿算法以及 Salsa 使用的内存内方法,可以跳到持久化开始的地方。
现在,增量计算在博客文章中有点难以解释,因为它的价值要求应用程序有一定规模。所以我们需要一个例子,大到足以展示增量性的价值,又小到可以在这里讨论。这有点荒唐,但我希望你能关注这个想法,而不是眼前这段代码的价值。
让我们想象一下,我们正在做一个奇怪的文本处理器,它会统计目录中所有文件里的单词数,并判断这个计数是否好笑。为了让事情更有趣,文件可以包含其他文件。
如果朴素地实现,会是什么样?很可能像这样(好吧,我们忽略 IO):
        type FileId = usize;

struct File {
    name: &'static str,
    text: String,
    includes: Vec<FileId>,
}

struct Db {
    files: Vec<File>,
}

fn word_count(db: &Db, id: FileId) -> usize {
    let file = &db.files[id];
    println!("word_count({})", file.name);

let own = file.text.split_whitespace().count();
    let included: usize = file.includes.iter()
        .map(|&child| word_count(db, child))
        .sum();

own + included
}

fn is_haha_number(db: &Db, id: FileId) -> bool {
    println!("is_haha_number({})", db.files[id].name);
    matches!(word_count(db, id), 67 | 69 | 420)
}
        fn main() {
    let mut db = Db {
        files: vec![
            File {
                name: "a",
                text: "hello world".into(),
                includes: vec![1],
            },
            File {
                name: "b",
                text: "one two three".into(),
                includes: vec![],
            },
            File {
                name: "c",
                text: "not connected".into(),
                includes: vec![],
            },
        ],
    };

let (a, b, c) = (0, 1, 2);

println!("Result: {}\n", is_haha_number(&db, a));

// Change b's text, but preserve its word count.
    db.files[b].text = "red blue green".into();
    println!("Result: {}\n", is_haha_number(&db, a));

// Change b's word count: a now has 67 words.
    db.files[b].text = "word ".repeat(65);
    println!("Result: {}\n", is_haha_number(&db, a));

// a now has 69 words, but is_haha_number is still true.
    db.files[b].text = "word ".repeat(67);
    println!("Result: {}\n", is_haha_number(&db, a));

// Replace a's dependency on b with a dependency on c.
    db.files[a].includes = vec![c];
    println!("Result: {}\n", is_haha_number(&db, a));
}
        type FileId = usize;

struct File {
    name: &'static str,
    text: String,
    includes: Vec<FileId>,
}

struct Db {
    files: Vec<File>,
}

fn word_count(db: &Db, id: FileId) -> usize {
    let file = &db.files[id];
    println!("word_count({})", file.name);

let own = file.text.split_whitespace().count();
    let included: usize = file.includes.iter()
        .map(|&child| word_count(db, child))
        .sum();

own + included
}

fn is_haha_number(db: &Db, id: FileId) -> bool {
    println!("is_haha_number({})", db.files[id].name);
    matches!(word_count(db, id), 67 | 69 | 420)
}

fn main() {
    let mut db = Db {
        files: vec![
            File {
                name: "a",
                text: "hello world".into(),
                includes: vec![1],
            },
            File {
                name: "b",
                text: "one two three".into(),
                includes: vec![],
            },
            File {
                name: "c",
                text: "not connected".into(),
                includes: vec![],
            },
        ],
    };

let (a, b, c) = (0, 1, 2);

println!("Result: {}\n", is_haha_number(&db, a));

// Change b's text, but preserve its word count.
    db.files[b].text = "red blue green".into();
    println!("Result: {}\n", is_haha_number(&db, a));

// Change b's word count: a now has 67 words.
    db.files[b].text = "word ".repeat(65);
    println!("Result: {}\n", is_haha_number(&db, a));

// a now has 69 words, but is_haha_number is still true.
    db.files[b].text = "word ".repeat(67);
    println!("Result: {}\n", is_haha_number(&db, a));

// Replace a's dependency on b with a dependency on c.
    db.files[a].includes = vec![c];
    println!("Result: {}\n", is_haha_number(&db, a));
}
输出也不会有任何意外:
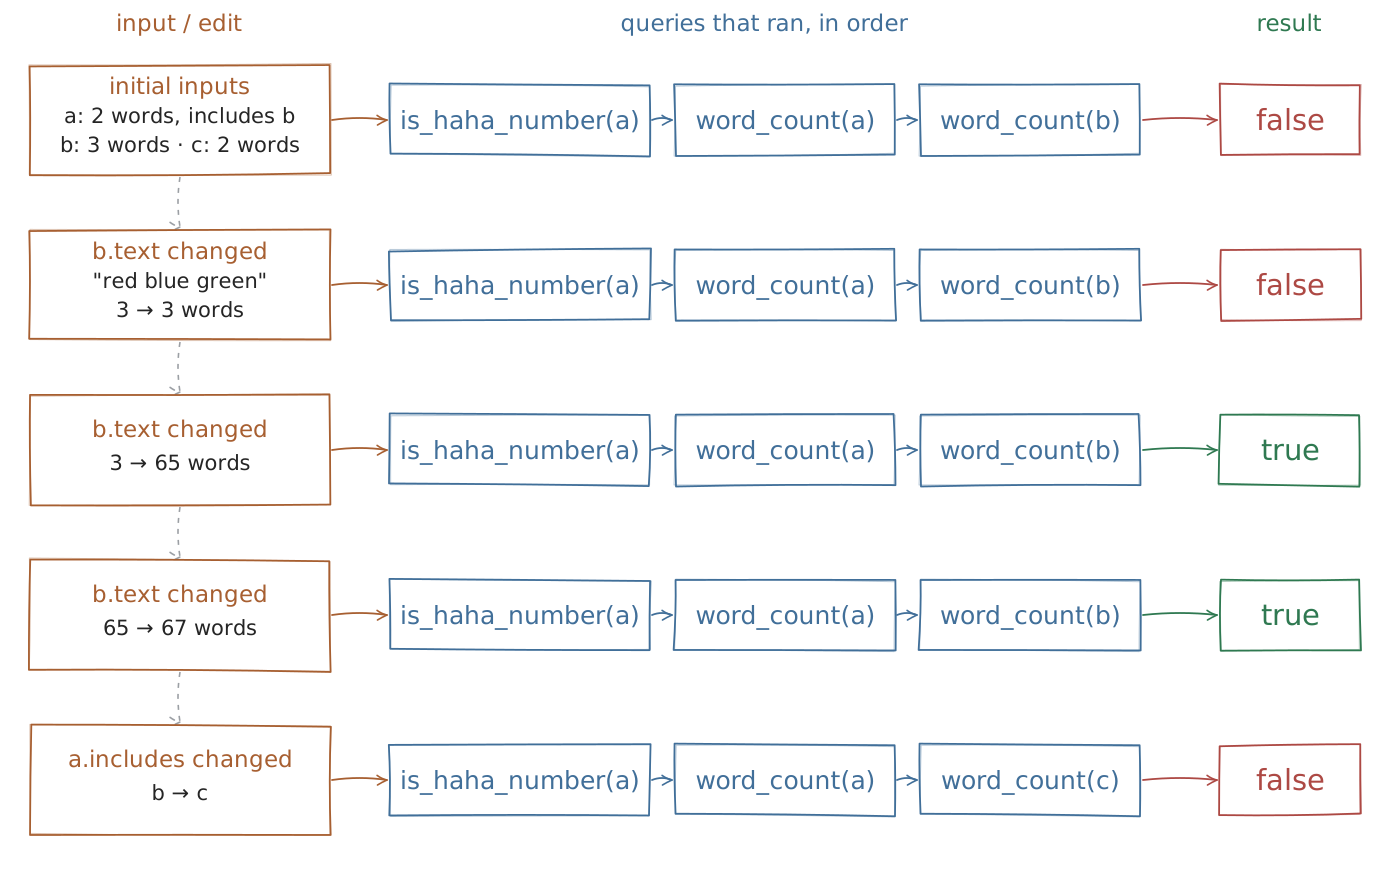
现在,我们试试 Salsa。它应该能让我们把一些计算变得可复用。它看起来会是这样:
        use salsa::Setter as _;

#[salsa::input]
struct File {
    name: &'static str,
    #[returns(deref)]
    text: String,
    #[returns(deref)]
    includes: Vec<File>,
}

#[salsa::tracked(returns(copy))]
fn word_count(db: &dyn salsa::Database, file: File) -> usize {
    println!("word_count({})", file.name(db));

let own = file.text(db).split_whitespace().count();
    let included: usize = file.includes(db).iter()
        .map(|&child| word_count(db, child))
        .sum();

own + included
}

#[salsa::tracked(returns(copy))]
fn is_haha_number(db: &dyn salsa::Database, file: File) -> bool {
    println!("is_haha_number({})", file.name(db));
    matches!(word_count(db, file), 67 | 69 | 420)
}
        fn main() {
    let mut db = salsa::DatabaseImpl::default();

let b = File::new(&db, "b", "one two three".into(), vec![]);
    let c = File::new(&db, "c", "not connected".into(), vec![]);
    let a = File::new(&db, "a", "hello world".into(), vec![b]);

println!("Result: {}\n", is_haha_number(&db, a));

// Change b's text, but preserve its word count.
    b.set_text(&mut db).to("red blue green".into());
    println!("Result: {}\n", is_haha_number(&db, a));

// Change b's word count: a now has 67 words.
    b.set_text(&mut db).to("word ".repeat(65));
    println!("Result: {}\n", is_haha_number(&db, a));

// a now has 69 words, but is_haha_number is still true.
    b.set_text(&mut db).to("word ".repeat(67));
    println!("Result: {}\n", is_haha_number(&db, a));

// Replace a's dependency on b with a dependency on c.
    a.set_includes(&mut db).to(vec![c]);
    println!("Result: {}\n", is_haha_number(&db, a));
}
        use salsa::Setter as _;

#[salsa::input]
struct File {
    name: &'static str,
    #[returns(deref)]
    text: String,
    #[returns(deref)]
    includes: Vec<File>,
}

#[salsa::tracked(returns(copy))]
fn word_count(db: &dyn salsa::Database, file: File) -> usize {
    println!("word_count({})", file.name(db));

let own = file.text(db).split_whitespace().count();
    let included: usize = file.includes(db).iter()
        .map(|&child| word_count(db, child))
        .sum();

own + included
}

#[salsa::tracked(returns(copy))]
fn is_haha_number(db: &dyn salsa::Database, file: File) -> bool {
    println!("is_haha_number({})", file.name(db));
    matches!(word_count(db, file), 67 | 69 | 420)
}

fn main() {
    let mut db = salsa::DatabaseImpl::default();

let b = File::new(&db, "b", "one two three".into(), vec![]);
    let c = File::new(&db, "c", "not connected".into(), vec![]);
    let a = File::new(&db, "a", "hello world".into(), vec![b]);

println!("Result: {}\n", is_haha_number(&db, a));

// Change b's text, but preserve its word count.
    b.set_text(&mut db).to("red blue green".into());
    println!("Result: {}\n", is_haha_number(&db, a));

// Change b's word count: a now has 67 words.
    b.set_text(&mut db).to("word ".repeat(65));
    println!("Result: {}\n", is_haha_number(&db, a));

// a now has 69 words, but is_haha_number is still true.
    b.set_text(&mut db).to("word ".repeat(67));
    println!("Result: {}\n", is_haha_number(&db, a));

// Replace a's dependency on b with a dependency on c.
    a.set_includes(&mut db).to(vec![c]);
    println!("Result: {}\n", is_haha_number(&db, a));
}
代码看起来非常相似!不过,让我们检查一下输出。
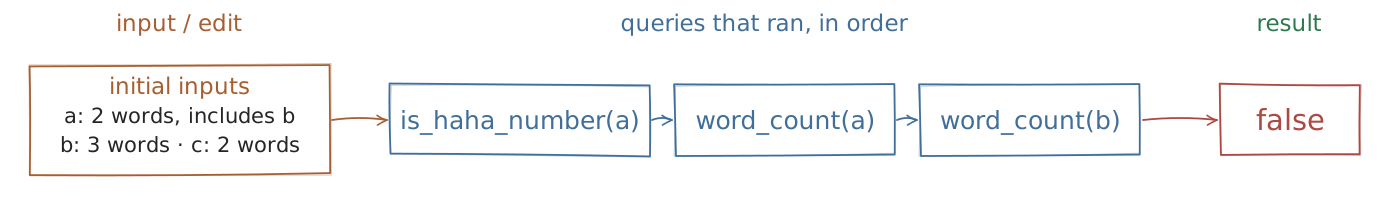
第一次调用与朴素示例一致:
但第二次调用就不一样了!
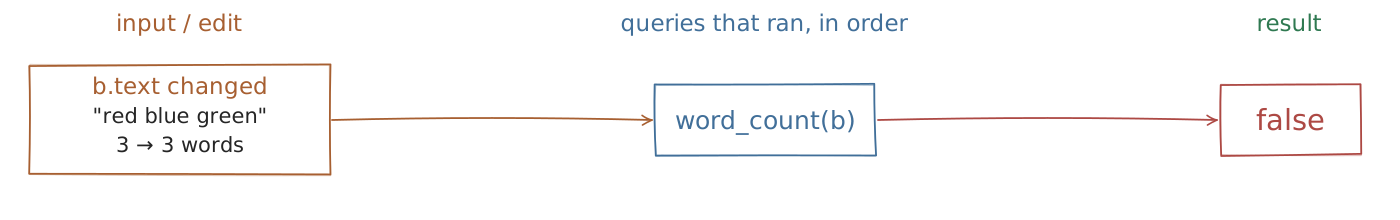
注意:我们不仅没有调用 word_count(a),也没有调用 is_haha_number!
Salsa 能看出文件 b 变了,于是为它重新运行了 word_count。但输出没有变化,所以之前所有的计算依然有效:没有需要重新运行的东西。
第三个输出也很有意思:
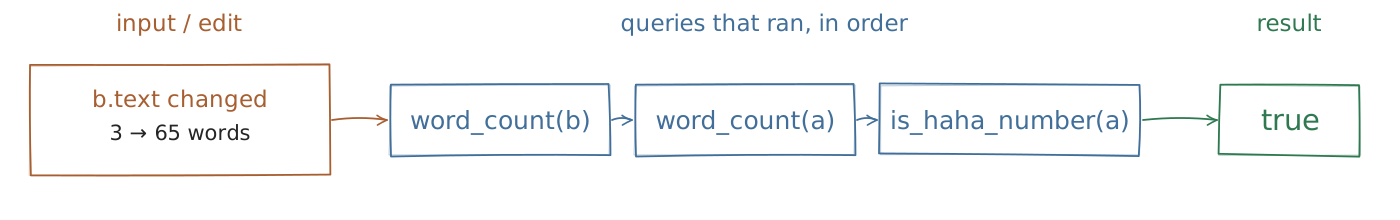
b 的词数变了,而 a 包含 b,所以我们需要重新运行全部三个查询。但顺序是反过来的!这是因为我们在内部有一张依赖图,会沿着依赖树,从“叶子”到“根”重新执行发生变化的查询。
第四个输出也是如此:
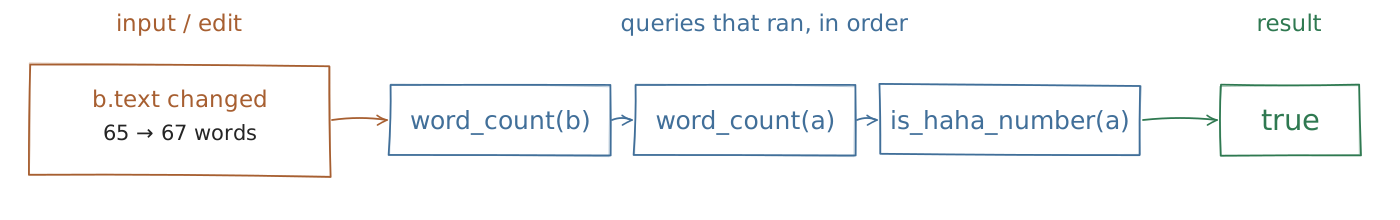
我们把 b 从 65 个词改成了 67 个词,所以 a 现在有 69 个词。结果仍然是 true,但我们确实得更新这些计算。如果我们还有另一个依赖 is_haha_number 的查询,验证就会在那里停下,它上面的所有查询都不必运行。
最后一个输出也很有意思:
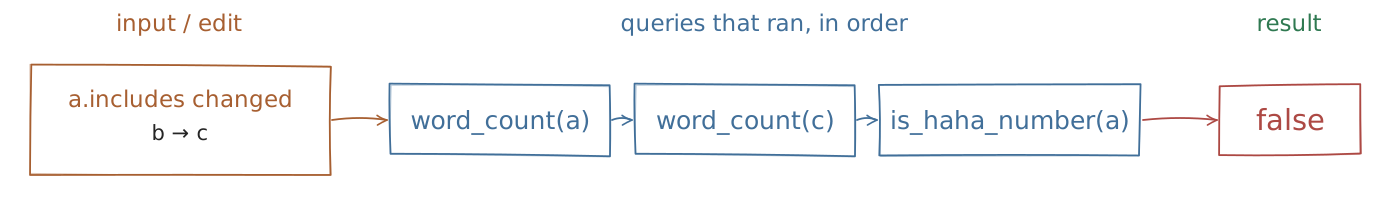
我们改变了 a 的依赖,所以 b 已经不在了。于是我们从已知的东西开始:a 的 word_count。它现在有一个尚未被追踪的、对 c 的依赖,因此我们在 a 之后转向 c。剩下的部分与之前相同。
所以希望你明白这个思路了:每个查询结果都会被记住,如果我们发现这个查询的输出没有变化,就不需要重新计算那些依赖此输入的查询。更准确地说,如果查询 X 所依赖的所有查询都没有变化,那么查询 X 就不需要重新计算。
现在想象一下,你的工作区里有 700 个依赖。最顶层的依赖中有一个文件变了。699 个依赖可以保留它们的结果!在单个 crate 内部,仍然只有一个文件变了,所以关于其他所有文件的信息至少部分保持不变。我们只需要重做真正重要的计算。
而最重要的是,我们不需要自己编写任何这类追踪代码,Salsa 免费提供给我们。
方便吗?方便!
Inside Salsa
但这是怎么做到的呢?
嗯,这确实不简单。如果你想更正式地深入了解,我推荐以下阅读材料:
- Rust Compiler Development Guide 中的 Queries overview(它不是 salsa,但思路相同)
我会给出一个简要概述。
想象每个查询与它的参数组合在一起,是一个对象。这个对象可以带有一堆元数据,说明它是否已被计算过、计算发生在什么时候、输出是什么,以及它依赖哪些对象。我们把这个元数据称为 “memo”。
Rust 中的持久化增量性
旁注:为什么“与其参数结合?”很重要?因为我们不能对 is_haha_number 做 memoize,但可以对 is_haha_number(420) 做 memoize,所以你可以把它看作 (function, arguments) -> output 的映射。
并且想象一下你有输入:某些由用户提供的东西,而这个东西可以被某个查询显式请求。
我们也可以说数据库有一个修订号,初始为 1。当你改变某个输入时,修订号会提升到 2,以此类推。这个修订号可以在 memo 中用作“它何时发生”(或者更确切地说,“它最后一次变化的时间”)。
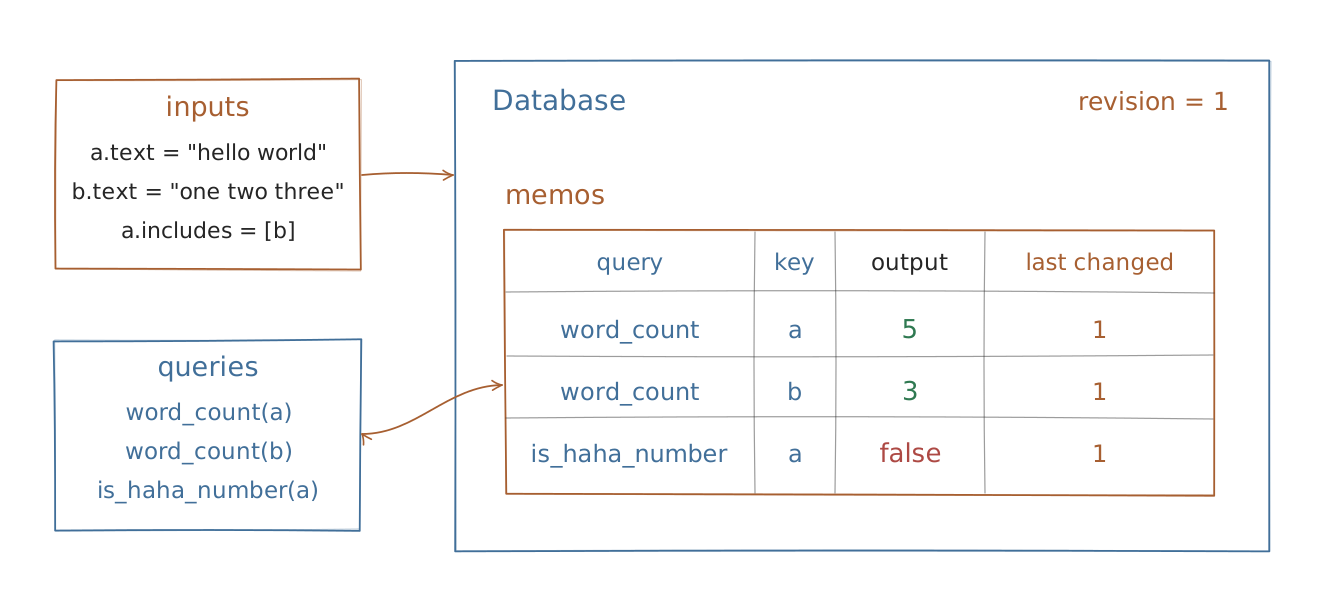
现在,我们已经提供了输入并调用了一个查询。它有一些关联代码,这些代码内部可以做两件事:
- 请求另一个查询结果
- 请求一个输入值。
如果查询请求一个输入,它应该记录自己依赖这个输入。因此,如果输入发生变化,它必须被重新计算。
如果查询请求另一个查询,我们可能会检查对应查询是否有一个带有已计算值的 memo。如果有,我们需要确保它对于我们当前所处的修订号是有效的。如果有效:太好了!它可以被复用,我们不需要重新计算它。否则,我们需要递归进入这个查询。显然,我们也会记录对这个查询的依赖。
在执行期间,我们会收集所有输入和所有依赖查询,并最终计算出我们查询的结果。当我们这样做时,我们可以填写 memo:记录修订号和输出。
然后……完成!下次你请求输出时,我们会查看这个查询对象的 memo。如果输入没有变化,我们可以直接交出结果。如果它们变了,我们沿着查询链向下走,做同样的事情。所以自然只有那些实际上可能发生变化的东西会被重新计算。
哦,但这里还有一个更重要的细节,它让一切变得更好。如果修订号改变了,这并不自动意味着我们需要重新计算这个查询。我们可以重新计算依赖项,并把它们与旧值比较。如果所有输出都等于旧输出(想象 word_count(a) 从 67 变成 69,但 is_haha_number 仍然返回 true true:依赖 is_haha_number 的查询可能不会失效),我们可以直接把当前版本标记为已验证并返回旧结果。当昂贵查询有很多廉价依赖时,这一点可能非常重要。
序列化相同。
- turbo-tasks(概览见此处)。这个非常有趣,因为它有文件系统缓存,引入它的原因基本相同:减少内存使用。然而,它仍然是以内存优先构建的,并且是为异步工作负载构建的。
// a now has 69 words, but is_haha_number is still true. db.update_inputs(|u| b.set_text(u, "word ".repeat(67)))?; print_result(&mut db)?;
// Replace a's dependency on b with a dependency on c. db.update_inputs(|u| a.set_includes(u, vec!["c".to_owned()]))?; print_result(&mut db)?;
Ok(()) }
use ajika::{Database, Db, Inputs, Result, Retention}; use std::time::Duration;
#[ajika::input(key = String)] struct File { #[input(arc)] text: String, #[input(arc)] includes: Vec<String>, }
#[ajika::query] fn word_count(db: &Db<'_>, path: String) -> Result<usize> { println!("word_count({path})");
let file = File::at(path); let own = file.text(db)?.split_whitespace().count();
let mut included = 0; for child in file.includes(db)?.iter() { included += *word_count(db, child.clone())?; }
Ok(own + included) }
#[ajika::query] fn is_haha_number(db: &Db<'_>, path: String) -> Result<bool> { println!("is_haha_number({path})"); Ok(matches!(*word_count(db, path)?, 67 | 69 | 420)) }
fn print_result(database: &mut Database) -> Result<()> { let result = database.run(|db| is_haha_number(db, "a".into()))?; println!("Result: {}\n", *result); Ok(()) }
fn main() -> Result<()> { let limits = Retention { max_entries: 10_000, max_bytes: 256 1024 1024, max_idle: Duration::from_secs(24 60 60), }; let mut db = Database::open("cache/", "sample-0", Inputs::default(), (), limits).unwrap();
let a = File::at("a".into()); let b = File::at("b".into()); let c = File::at("c".into());
db.update_inputs(|update| { a.set_text(update, "hello world".to_owned())?; a.set_includes(update, vec!["b".to_owned()])?;
b.set_text(update, "one two three".to_owned())?; b.set_includes(update, vec![])?;
c.set_text(update, "not connected".to_owned())?; c.set_includes(update, vec![])?; Ok(()) })?;
print_result(&mut db)?;
// Change b's text, but preserve its word count. db.update_inputs(|u| b.set_text(u, "red blue green".to_owned()))?; print_result(&mut db)?;
// Change b's word count: a now has 67 words. db.update_inputs(|u| b.set_text(u, "word ".repeat(65)))?; print_result(&mut db)?;
// a now has 69 words, but is_haha_number is still true. db.update_inputs(|u| b.set_text(u, "word ".repeat(67)))?; print_result(&mut db)?;
// Replace a's dependency on b with a dependency on c. db.update_inputs(|u| a.set_includes(u, vec!["c".to_owned()]))?; print_result(&mut db)?;
Ok(()) }
看起来非常相似,API 变化主要只是风格差异,首次运行时输出相同。

然而,这里的关键部分是,我们可以在末尾添加以下内容:
let inputs = db.inputs().clone(); // Copy the same inputs we had drop(db); // Close the database
// Reopen the same database let mut db = Database::open("cache/", "sample-0", inputs, (), limits).unwrap(); print_result(&mut db)?;
而 print_result 只会打印 False。重启后不会执行任何东西!持久化生效了!
魔——法——!(某种程度上)
说正经的,主要区别在于侧重点。当你开始做这样一个项目时,选择优先级会对设计产生很大影响。而这里做出的选择是持久化优先。虽然 Ajika 提供了内存后端,但它主要用于测试。预期的用例是使用你的磁盘。
它从一个内存数据库没有的非常基本的问题开始:如果我重启应用程序会发生什么?
如果你本地已经有缓存,很多情况都可能使这个缓存失效:
- 应用可能使用更新版本的 Ajika,而该版本有破坏性变更。
- 应用可能更改了一些查询,因此旧缓存现在不可用。
- 某些东西可能以某种方式损坏了缓存。
文章标题:Rust 中的持久化增量计算
同样地,考虑到我们对计算结果做了缓存,这基本上只是一种优化。如果应用运行期间缓存被损坏或被移除,用户多半会希望直接丢弃缓存、把计算再重做一次,而不是让应用崩溃并报出“缓存不可用,我该怎么办???”。
因此,缓存必须是可丢弃的。Ajika 和应用都会提供 schema 版本号来标识修订版本,如果已存储的缓存与之不匹配,我们就重置缓存。如果缓存被损坏,Ajika 会尝试恢复而不是直接失败,即使这意味着要从头重新计算数据。
下一个最明显的变化是,大多数操作都可能失败。由于 IO 是我们的基本属性,而 IO 可能失败,我们需要考虑这一点。操作失败并不意味着缓存被损坏,但确实意味着当前查询可能没有被计算出来。不过,通常可以重试。
最后,持久化不幸是个有泄漏的抽象。你无法真正回避数据位于内存之外这一事实,因为你持久化的所有东西都必须可序列化。而你的中间查询数据可能可复用但不可序列化(想象一个借用了源文本的 AST:让它拥有数据很可能会更糟),所以有些查询可能是瞬态的:我们只计算一次,并在当前操作运行期间保留,但操作结束后就丢弃而不持久化。
不过,这些性质结合起来效果相当不错:你的应用必须感知持久化,但不是以恼人的方式。如果某处失败,你会知道,但不必担心,因为 Ajika 会为你修复。如果某些东西不可序列化且无关紧要,它可以被转成瞬态查询。如果你不想让测试依赖持久化,只需插入一个内存后端即可。
那么,让我们看看它在底层是如何工作的。
Ajika 内部
LLM 使用免责声明:这里讨论的库是在使用 LLM 的情况下开发的,和 Rust Glancer 一样。希望从这篇文章中可以明显看出,我是把 LLM 当作工具使用并且拥有完全的控制权。它不是 vibe coded 的。
Ajika 有三个部分:ajika 本身、ajika_macros 和 ajika_storage。
我们会先看 ajika,再看 ajika_storage。宏留给读者作为练习,但它们总体来说相当直白。
Ajika 本身非常简单,看看这张图就知道了:
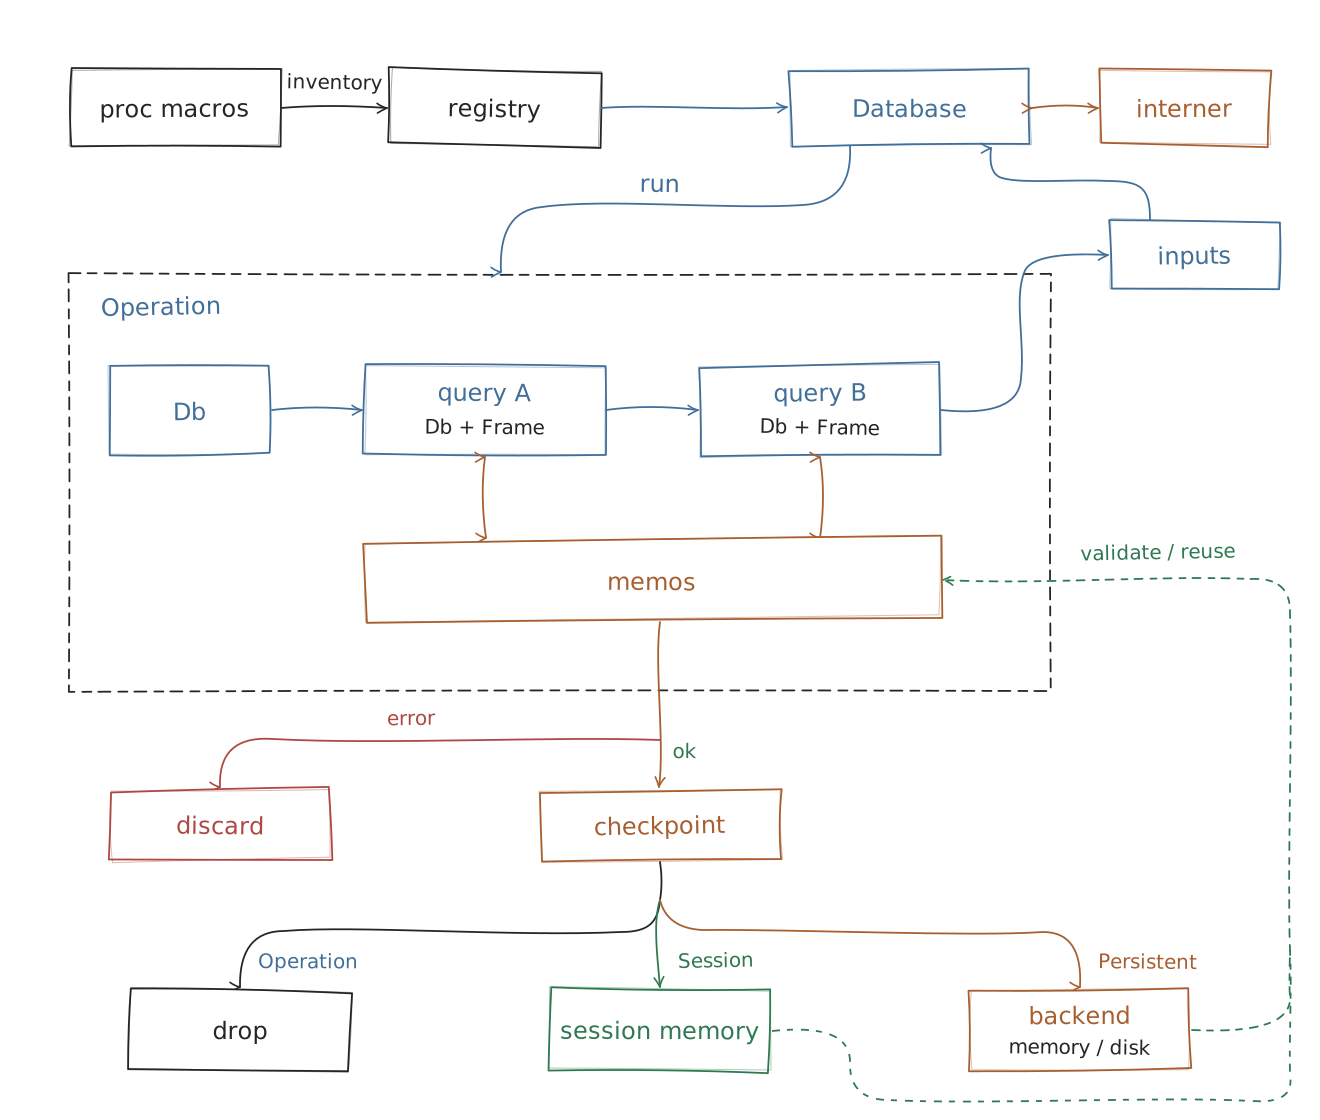
……开个玩笑。不过我们很快就会把它讲清楚。
核心思想与 Salsa 非常相似:
- 我们有一些执行计算的查询。
- 我们可以提供输入。
- 我们有一个数据库,为我们管理查询依赖并记住各种东西。
不过,我认为浏览一下高层细节可能还是有用的。
旁注:Ajika 有自己的书,对许多概念的深入程度远超这篇博文。我会在一些地方引用它。缺点是,与这篇手写的博文不同,那里的文本主要是 LLM 生成的,即使我做了大量润色,也看得出来。最终我会做一次完整的手动重写,但目前我认为人工筛选过的 LLM 指南总比没有指南好。
数据库与查询
数据库是入口点。你选择内存后端或持久化后端,提供 Inputs,然后运行你的操作。
查询是我们想要执行的实际逻辑。它们通过 ajika::query 宏定义,总体来说相当直白。关于查询本身的更多细节在书里,我们会在本文稍后看看查询是如何执行的,以及这个 Db 对象到底是什么。
输入
输入要有趣一些。你的输入类型通过 ajika::input 过程宏定义,它会为你做一些包装。你的输入结构基本上是一种映射:你指定一个键,例如 String,然后可以使用数据库为任何你拥有的键获取输入值(或缺失),无论是 "foo" 还是 "bar"。如果你有一个单例值,比如 config,可以用 () 作为键。同样,关于输入的更多内容可以在书中找到,也可以查看 lazy inputs。
输出
输出可能是系统中第一个因为持久化而变得有趣的部分。
输出需要存储在文件系统上,因此它们需要可序列化。对于你不想序列化的输出,可以使用瞬态查询,它只会在单次操作期间将值保留在内存中。但即便如此,仍有一个问题:你希望输出有多大?
如果你有 1000 个非常细粒度的查询,就意味着我们需要大量文件系统往返。如果你只有一组查询,而它们计算大量数据,你就需要反序列化一个大值,只是为了查看其中的一部分。
因此,输出提供了一种折中的解决方案:你可以选择直接返回值,或返回该值的句柄。如果返回句柄,查询可以使用该句柄按需从数据库取回值。直接返回的值会被完整
- 在 Operation 中为这个查询获取或创建一个 Memo。注意,memo 数据可以通过对应的 Record 从文件系统读取。
- 检查它是否有一个可以确定复用的输出。如果有,直接给出即可。
- 如果它不能确定被复用,执行所需的验证,例如检查所有依赖是否相同。如果验证通过,给出该值。
- 最后,查询值要么未计算,要么不可复用。创建一个新的 frame 并运行查询逻辑。如果此查询会调用任何其他查询,它们将具有相同的工作流。将结果值和依赖保存在 memo 中。
并且,如果在执行期间查询接收到另一个查询结果,它会将其记录在自己的 Frame 中以便复用。
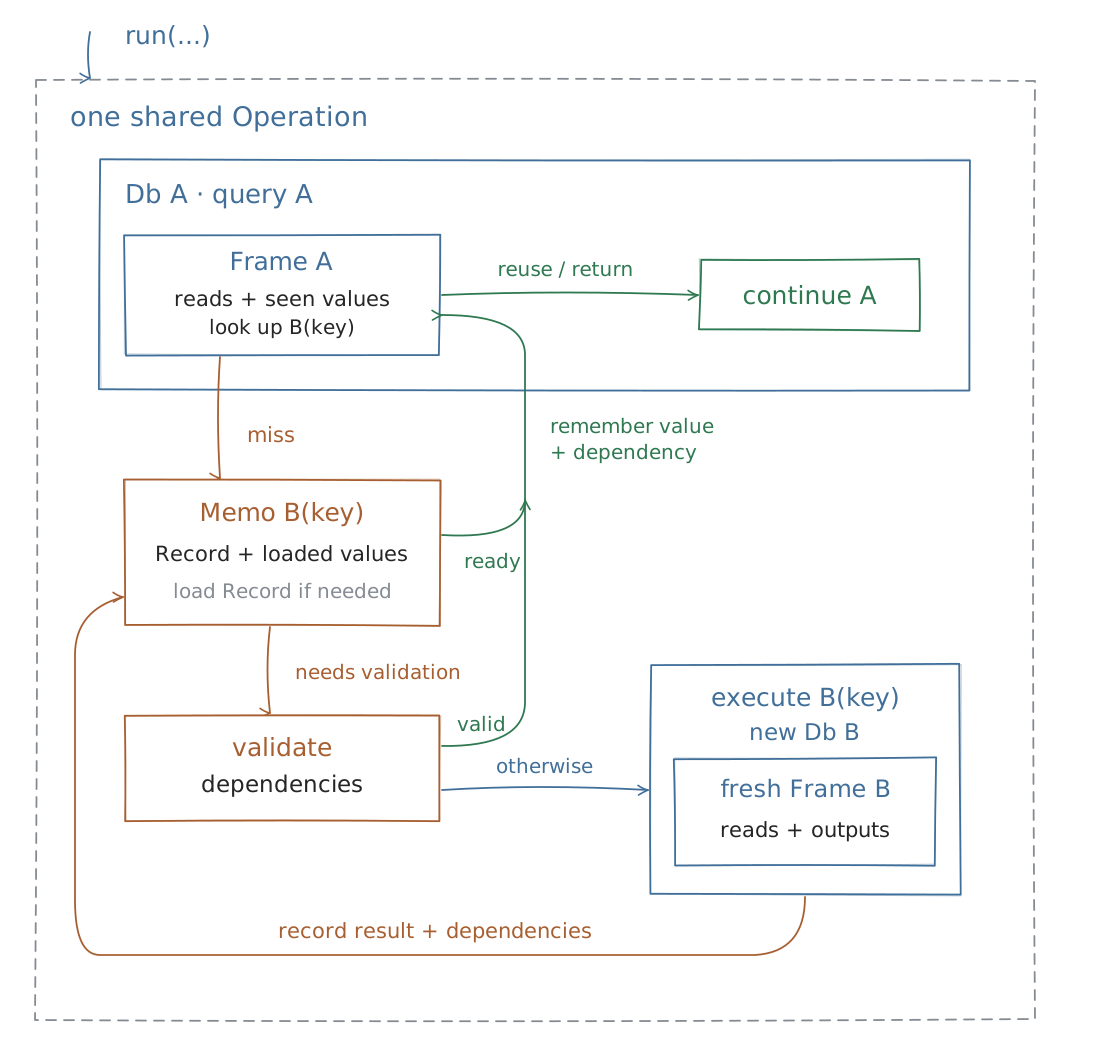
显然,有大量的簿记工作、对并行性的支持以及其他使其复杂化的东西,但总的来说算法相当直接。
完成操作
一旦 Operation 完成,我们需要实际应用这些更改。run 像事务一样工作,因此其中所做的所有事情都立即可见,但在 run 之后,取决于 run 是失败还是成功,结果要么被丢弃,要么被持久化。
检查点写入通常相当直接:
- 准备更新:遍历脏 memo,收集更改的值,标记不再由查询发出且可以移除的值,等等。
- 应用更新:实际执行更改,比如将新值写入磁盘或移除过时的值。
- 发布更改:在所有内容写入后,使更改对下一次 run 可见。
所以 Ajika 层面的检查点相当直接。更有趣的是 Ajika 存储总体上如何工作。
Ajika 存储
终于,我们来到了持久化!
这可能是 Ajika 最有趣的部分。我们如何以高效的方式存储数据?
Ajika 的第一个版本对所有内容都使用 redb。它奏效,但效果不是很好。由于我们实际上并没有一个“数据库”本身,而更像是一个用于许多 blob 的存储,redb 增加了太多开销。然而,它提供了非常需要的特性,比如事务。
所以,Ajika 使用 redb 作为元数据存储:它是一个索引,主要包含指向值的指针。
值被写入“pack 文件”:基本上就是二进制文件,我们可以向其追加新条目。而在 redb 内部,我们只需存储一个指针:(文件名, 偏移量)。每个存储的条目都有一个头部,包含长度和压缩算法等信息。为了提高效率,如果值非常小,我们可以将其内联保存在 redb 内部,而不是写入文件。
如果你想访问一个值,你会去 redb,检查对应的键,然后要么内联读取它,要么在指定的访问位置读取指定的 pack。相当简单。
显然,那里还存储了一些更多数据(我们很快就会简要讨论 identities),但总的来说,这是一种相当“愚蠢”(希望是好的方面)的数据存储格式。
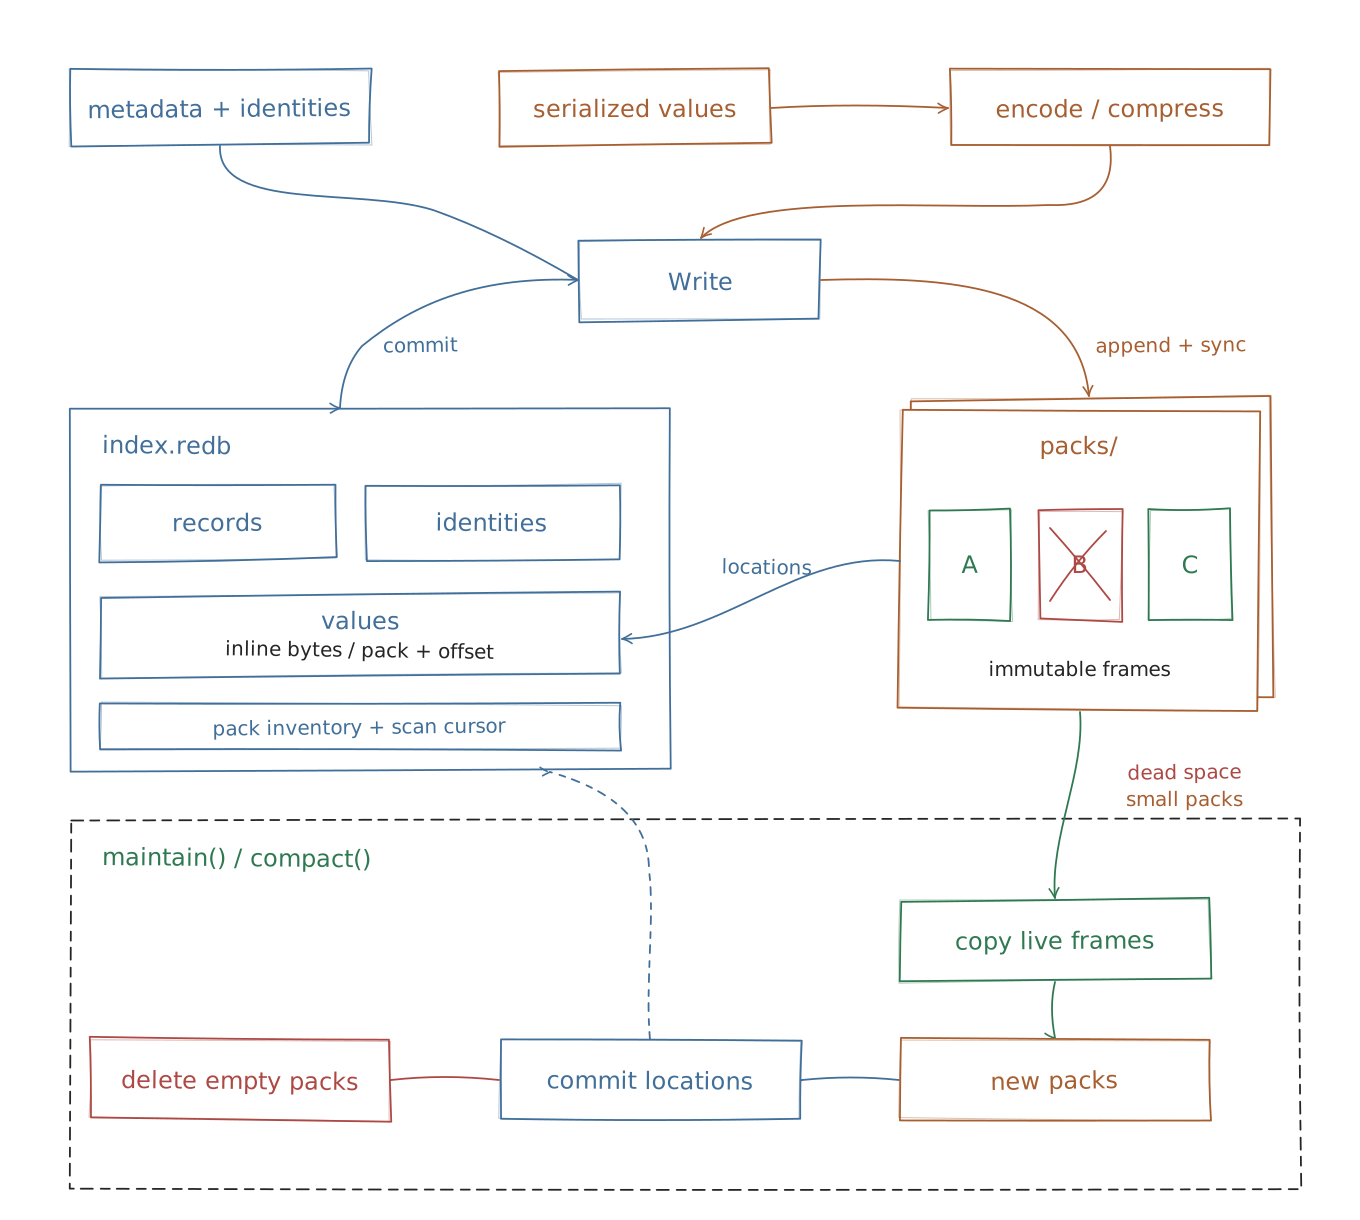
不过,有一个需要注意的地方:如果我们天真地这么做,存储可能会无限制增长。Pack 最终可能利用率非常低,主要由“死”值组成,而且其中一些可能根本不可观察。因此,存储支持维护:每当你执行一次操作时,Ajika 可能会执行一次清扫,重新打包值并更新指针,而在操作结束时,Ajika 会尝试向存储发出信号,告知哪些值现在可以删除。这里有几个可调参数:你可以指定保留时限(以便清理非常旧且未使用的查询),或者目标存储大小(它充当软限制,并会影响清理策略)。
但最终,这种设计让值的存储和检索相当高效,并且与 Ajika 的整体设计集成得非常好。
驻留器
好了,我们快完成了,我保证!最后一个小部分:驻留。
驻留值是一种优化,它为你