 Newshot
用 vibe coding 造一颗推理芯片
最近编程比较有意思的一点是,coding agent 让我能进入全新的领域,因为它们给了我接触新的编程语言和范式的机会。最近,这就意味着折腾硬件,因为现在写底层软件容易多了。所以,在这篇博客里,我想试着回顾一下 vibe coding 一块 FPGA 的经历,期间我经历了一连串“我靠”时刻,反复好几次,也让我对“只要有足够大的 token 预算(感谢 YC)以及有趣的问题可以喂给模型,一切皆有可能”有了新的认识。
最近我无意中听到一些创始人聊 FPGA 是怎么工作的。我承认自己对 FPGA 相对比较无知。我在创业公司或大学里从没真正做过相关实验,所以之前对它们了解甚少。我熟悉的基本概念是:你可以把电路编程进一块可重编程的芯片。于是你不用依赖通用计算架构(比如 CPU),而是可以用一块可重编程的架构,也就是说,加载到芯片上的配置决定了它的逻辑和布线如何连接,而这(理论上)能带来性能优势。我也知道写它需要堆积如山的 C++,并且涉及手动分析波形来做仿真和验证。不过我以前从没做过这些,而且它看起来相当繁琐。
这大概就是我入手前的全部认知。
很自然地,我那颗 ML 脑袋就想:“能不能用这些来做 AI 推理?”我不是第一个这么想的人——GitHub 上有几个仓库在尝试把 ML 模型移植到 FPGA 上。但我还没真正看到过一篇 writeup 讲 coding agent 是否擅长编写底层的 C++ 和 Verilog 代码来对它们编程,并验证输出,让它们真正准确地跑起来。(剧透警告:它们在这方面强得离谱。)
所以我决定得弄一块来试试。AWS 有带 FPGA 硬件的 F2 实例,这似乎比直接去买物理硬件更方便,于是我让 Codex 起了一个预留实例,就开始干活了。它的内存相对有限,只有 16 GB 的 FPGA HBM。差不多同一时间,我在和 DeepGrove 的创始人合作,他们在讨论他们新的三值权重架构,这种架构非常适合内存受限的场景。它在 Mac 硬件上是 SOTA,并且能真正做 agentic tool calling,所以我想,何不试试看能不能让它在 FPGA 上跑起来,而且快到有实用价值。
接下来发生的事,是一个跑在 Conductor 里的云端 agent 连续工作了好几天,我大多时候只是偶尔给它打打气,而它同时(1)让一个模型完整跑了起来,(2)把速度从第一个完整模型的 bit-exact 基线提升了 33×,达到了实时可用的水平。这是我跑过的最令人震撼的 autoresearch 循环之一,整个实验历史里它最终写了大约 3M 行代码,解析了 30M 行输出文件,运行了数百次实验,只烧掉了 $10,000 的 Claude 和 OpenAI token。大部分代码是 C++,还有一些 Verilog。我大概有十年没写过任何像样数量的 C++ 了,而且我从没写过 Verilog。老实说,我对 Verilog 一窍不通。我的大多数 prompt 都不怎么高明:基本上就是我说些“你是个超级智能的模型,该更有创造力了”和“咱们冲 2 倍速度,你可以的”之类的话。有时我会拿出一点 ML 常识,比如说“嘿,是时候考虑投机解码了”或者“为什么那个跑在 CPU 上,你应该把它移植过去”。但绝大多数时候,纯粹是凭感觉,而且我很确定只要时间足够,模型自己也能想明白那些事。另外,看起来 Astra 和 Opus(新版 Fable 还没发布)在这方面都相当能干,我可以互换着用。我确信有人有不错的 benchmark 能说明哪个更聪明,但两者都达到了我心中“足够聪明”的门槛。
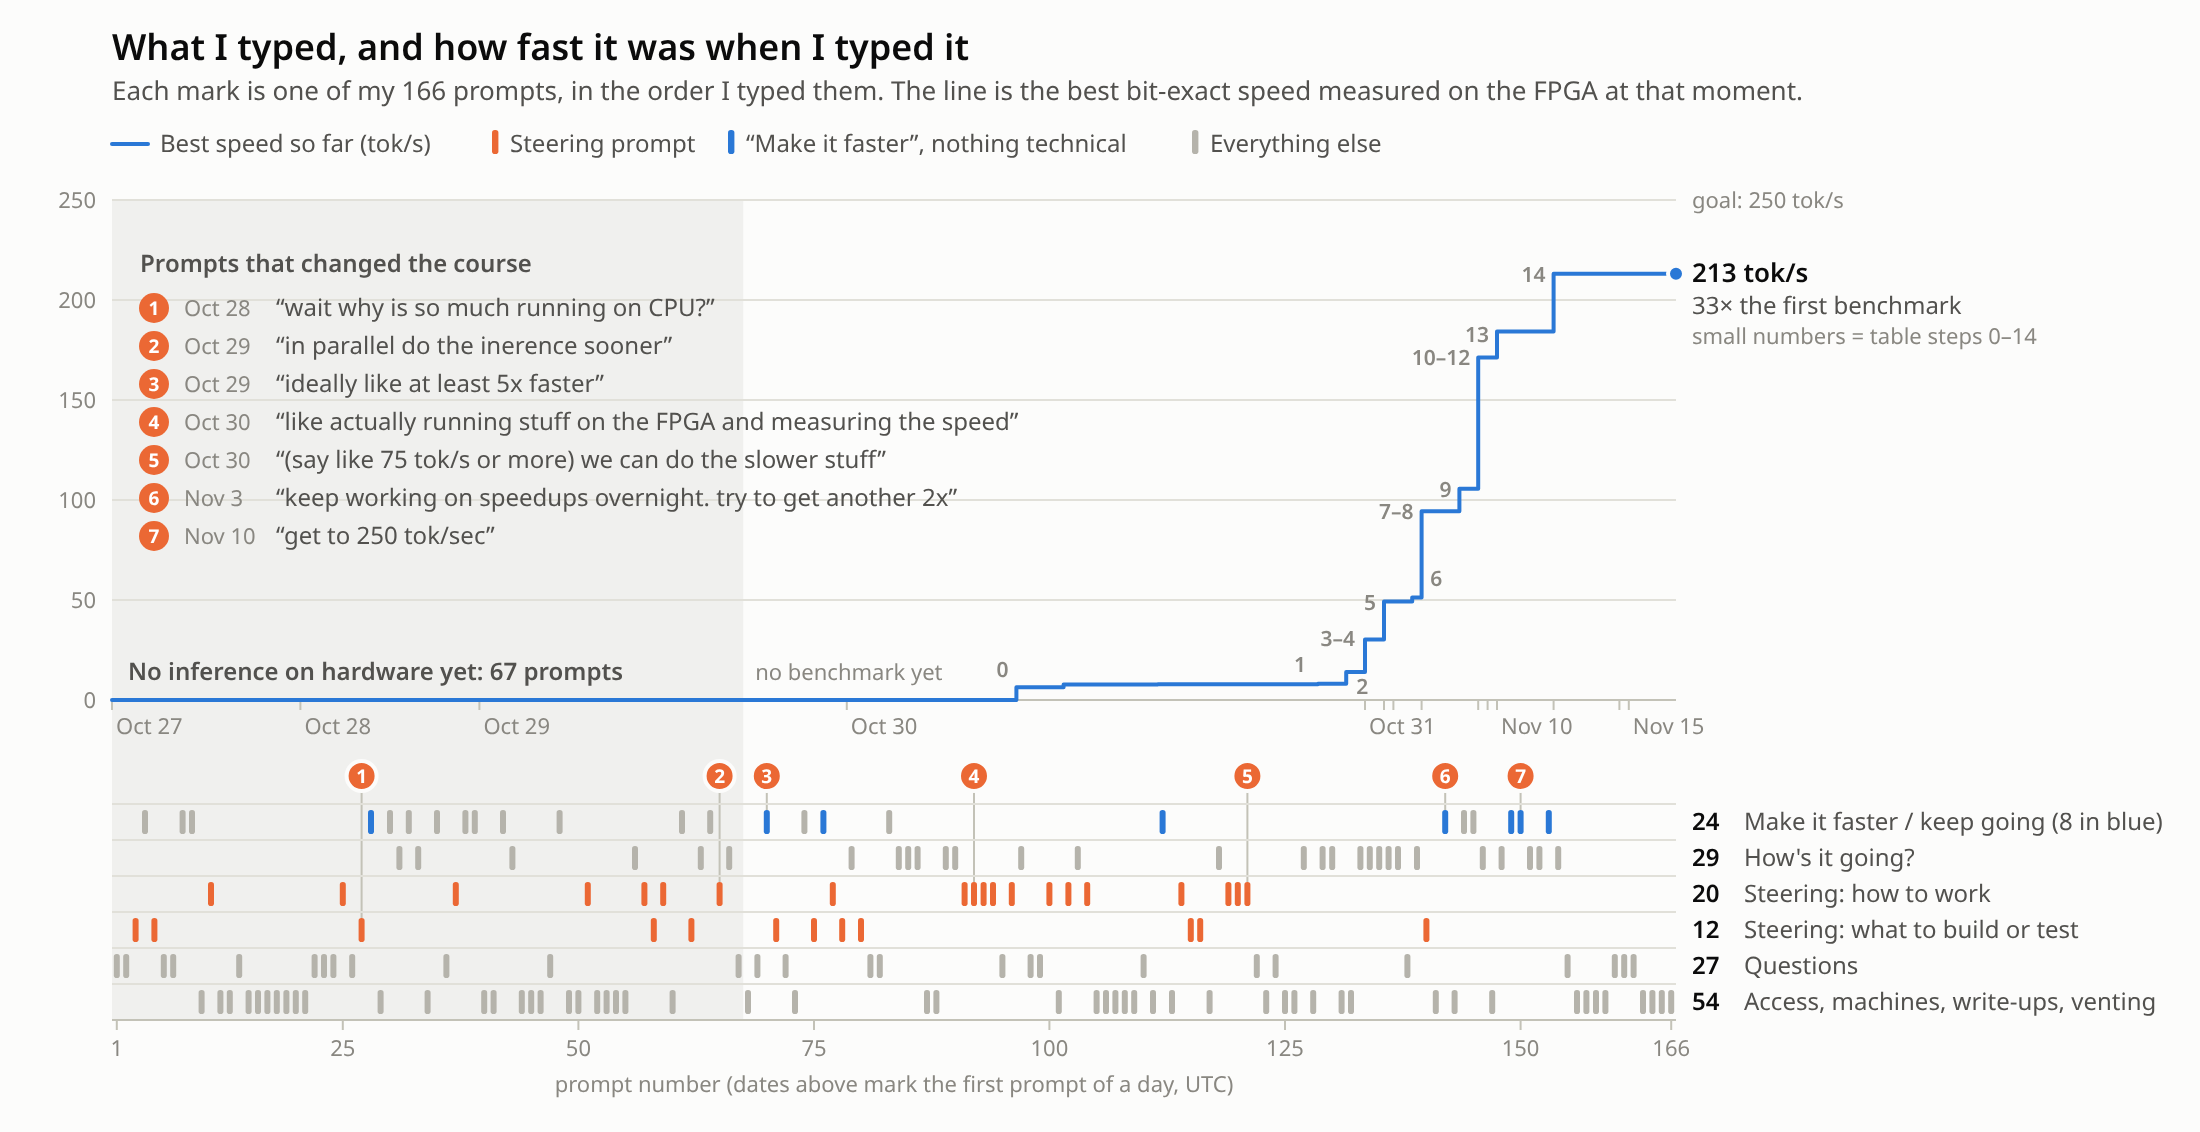
从“跑通了”到每秒 213 个 token
图表:一次一个实验,越跑越快
实测 benchmark tokens/s · 选择一个步骤,看看改变了什么
一个同时读取两个内存 bank 的 head loader(+17.3%,在单张图片上开启/关闭实测)、一个运行时 expert 预取策略,以及 router-job 的计时修复;在一次浸泡测试在 231.25 发现随机故障后,将时钟降低一档运行(225/425 MHz)。
图表记录的是实测的优化顺序:6 → 213 tokens/s,即基线的 33 倍。
人类的建议帮了多大忙?
在某个时间点,大约达到 10 TPS 时,我把这件事发消息告诉了 DeepGrove 的创始人,他们回复说很惊讶它竟然这么容易就跑起来了,还说他们几个月前试过这个,当时的模型还不够好,效果不太明显。他们发给我一段提示词,总结了他们的一些经验教训,我把它复制粘贴到我的会话里,看看有没有影响。这基本上是我在这次会话里加入的最重要的一条真正的指导。该提示词转载如下。
这里是一个人为 dense bs=1 decode 优化的 fpga 实现所做的工作,针对带 ternary 权重的 dense qwen 风格模型。你应该对此持保留态度,挑选你认为实际有用的内容加入你的计划。另外,如果你觉得没用,就不要做那些耗时的东西,比如跑非常长的 cycle accurate 仿真测试之类,或者像物理设计,因为这些可能要花好几个小时。这里有一些想法,请挑选使用,把这当作背景参考,而不是你必须严格遵循的东西,以下是一些可能有帮助的点。不过要优先考虑让它尽快跑起来的速度..
MATMUL(TERNARY 引擎)
- 不用乘法器。2 位权重驱动一个 3:1 mux,选出 x、~x 或 0。未使用的第 4 个编码会触发错误标志,这样损坏的权重能被捕获。
- 取负是 ~x + 1。lane 标记负数,row reducer 每行加一次 +1,而不是每个 lane 加一次。
- 激活是分组整数:INT12,或者在需要更大范围的地方(MLP down projection)用 INT16。以整数方式归约,应用 FP32 组 scale,在 FP32 中累加。
- 投影前的 RMSNorm 被延后:先量化激活,累加后再应用归一化 scale。这样更便宜,且数值上等价。
- 8 个 core 分在两个 cluster 中。相互独立的投影(gate/up)在各自的 core 组上同时运行。
- 结果:在相同速率下,DSP 用量约为 INT8/INT16 设计的一半,代价是更多 LUT。
内存
- 权重以 2 位打包,每次传输的数据量是 16 位的 8 倍。在 batch 1 下,权重读取耗费的能量和时间远超数学运算。
- 权重从 HBM 直接流入计算 lane,跳过片上 buffer(每个 token 只用一次)。激活缓存在每个 core 旁边,并在行之间复用。
- HBM 路由是每个内存通道一条链,而不是一个大 crossbar。布局数据时让全部 32 个通道保持忙碌。
- 片上 buffer 是带显式生命周期的类型化 slot(open -> write -> commit -> read -> release)。每个 slot 有一个用于 scale/exponent 的 side memory。buffer 会检查格式、范围和生产者,从而在硬件中捕获调度 bug。
- KV cache 是 MXINT8:8 位值,每 32 通道块共享一个 exponent。小到足以流式处理,且精度保持。
- 对于 MoE:将每个 expert 条带化到每个通道上,并在运行时将 expert ID 映射到地址,而不是使用固定程序。
ATTENTION
- Attention 以 64-token 的 tile 在 cache 上流式处理,使用 online softmax(FP32 运行 max/sum)。完整的 score 矩阵从不存储。
- 概率是 UINT16,context 在 FP32 中累加。
用 Vibecoding 打造一颗推理芯片
- 每个 attention 单元在一条数据通路上交错执行两个独立任务(C-slow),从而在不复制硬件的情况下隐藏流水线延迟。
- Q/K head norm 和 RoPE 有了各自的小型向量单元,因此不会阻塞通用向量路径。V projection 与这项工作重叠进行。
- 新的 K/V 一产生就追加到 HBM。我们用滑动窗口来限制缓存读取。
调度
- 一个控制器按程序顺序发出工作,带有标签和屏障。引擎只有在缓冲区依赖明确时才重叠,因此我们获得了重叠而没有竞态。
- 对于 MoE:router 成为新的关键路径,因为在其完成之前无法取数。将其保持在 FP32(更低的精度会改变被选中的专家),并在其周围尽可能重叠其他工作。
正确性(也许不必严格遵循)
- 我们先确定数值契约(格式、舍入点、运算顺序),然后构建硬件以匹配它。向量运算必须匹配参考模型的顺序和精度,而不仅仅是“接近”。
- 验证阶梯:逐块 cocotb 单元测试。一个完整层针对真实 checkpoint 进行协同仿真。多 token、完整 24 层解码与参考 oracle 逐 token 比较。KV cache 写入的字节级核算。
- 逐块 cocotb 单元测试。
- 一个完整层针对真实 checkpoint 进行协同仿真。
- 多 token、完整 24 层解码与参考 oracle 逐 token 比较。
- KV cache 写入的字节级核算。
- 我们将仿真结果、时序签核和板级结果分开保存,从不从一方推断另一方。
- 每个发布的数字都链接到其来源报告。
物理设计(也许对你来说不必要)
- 芯片有 3 个区域(SLR)。将宽数据通路保持在一个区域内,并对每个跨区信号做寄存。长链路使用 credit,而不是组合 ready。
- 我们将引擎放在其数据旁边:内存逻辑靠近 HBM,attention 放在 DSP 密集的区域。
- 综合后立即筛查逻辑深度(250 MHz 下最多 10 级),并通过流水线、分片或 C-slow 来修复。完整的布局布线留到集成阶段。
- 开发循环:小改动 -> lint -> 单元测试 -> 快速综合 -> 深度/时序检查 -> 重构。
编码 agent 认真地考虑了这些要求,但似乎在质量上没有产生多大差别。事实上,当我后来让它阅读所有日志并确定它实际使用了哪些指令时,它说:
它最大的设计想法在你粘贴之前就已经在我的计划中了。你在 Oct 29 21:50 UTC 粘贴了它:4,741 个字符,描述了别人为密集、batch-1、三值 FPGA 解码器所做的工作。在 70 秒内,我将其整理为十个要采纳的想法和五个要拒绝的想法,并写入了每个设计 agent 的简报。你朋友 Edward 更简短的评论,关于使用查找表作为逻辑门,早了 24 分钟,在速度线上没有留下任何东西。
我采纳的设计想法:主要是确认。
- 已计划:将权重直接流式传入计算通道、并行运行行、以及以突发方式读取 attention cache,这些都在我 35–40 分钟前启动的设计简报中。
- 与后来构建的匹配:router 中的交错通道(步骤 3);用于 head norm 和 RoPE 的独立单元(步骤 4);程序顺序 sequencer(步骤 5);每个 die 间交叉处的寄存边界(步骤 8 和 12)。
- router 中的交错通道(步骤 3);
- 用于 head norm 和 RoPE 的独立单元(步骤 4);
- 程序顺序 sequencer(步骤 5);
- 每个 die 间交叉处的寄存边界(步骤 8 和 12)。
- 我无法证明没有这些笔记就不会发生这些。
我拒绝的想法:所有五个数值捷径。更低精度的激活、延迟的 norm、8 位 KV cache、online softmax 和 16 位概率,每一个都会改变输出位。这正是他们的设计获得效率的地方,而你的位精确规则排除了它。
标题:Vibecoding 一颗推理芯片
流程建议:这一条立刻带来了改变。
- 你提出的要求:不要做那些要花上几个小时的事情。
- 我停掉的事:一个已经跑了大约 24 小时的仿真,以及两个 250 MHz 的构建。
- 我改用的方案:一个短循环,包含 C 测试、综合和逻辑深度检查,每次集成分做一次布局布线。
- 可能的收益:它能更快拿到硬件结果。
- 可能的代价(我无法证明):两个只有 RTL 仿真才能暴露的挂死,第二天就在板子上出现了,那次大集成因此损失了 38 个小时。
它触发的一个真实发现。在检查他们的内存方案时,我发现了 AWS 自己的参考内存设计,它在全部 32 个内存通道上达到 426 GB/s。内存子系统就是基于它构建的。
换句话说,对于大多数实际的设计想法,情况并不明确,但有充分理由相信模型自己也能想出来,尤其是因为它在经过好几轮压缩之后、过了很多个周期才把它们提出来。但这条流程建议立刻就有用,它能更快拿到硬件结果并提高迭代速度。换句话说,人类在定义“如何快速迭代”和“正确性长什么样”上仍然有用,而 agent 非常擅长管理探索过程。
优化日志
以下是自动研究循环找到的改动。有意思的是,它主要是一系列幅度不大的改进,每次复合出约 1.5 倍的提升,而不是一两个巨大的改进。
基线:第一个全模型位精确的 FPGA 镜像(R8),配合主机侧前缀缓存对外提供服务。
从基线起 1.0×
仅主机软件:单命令开销从约 10 ms 降到 0.9 ms(持久化寄存器映射、流式读取,不做逐命令的 SDK 调用或 fsync)。
本步 1.25× · 从基线起 1.25×
一个 128 通道的注意力引擎,它以突发方式读取 KV 缓存,而不是一次读一个字,同时保持参考实现中精确的求和顺序。
本步 1.74× · 从基线起 2.18×
一个并行 MoE 路由器,带有精确的 GCC 排序决胜规则,外加一个内置 argmax 的流式输出头;中等强度的路由让它能跑到 250 MHz。
本步 1.46× · 从基线起 3.19×
一个胶水引擎,它以经过验证的精确顺序并行执行归一化、RoPE、量化以及各引擎之间的拷贝。
本步 1.47× · 从基线起 4.70×
全新的完整流水线(流式三值投影通道 + 一个取代 R8 控制路径的新定序器),前提是先修掉两个只在硬件上出现的挂死。
本步 1.63× · 从基线起 7.65×
精确的推测解码:主机通过提示查找来草拟 token,FPGA 在一次流程中验证多个。
本步 1.04× · 从基线起 7.97×
修复了一个以 1/6 速度在芯片间搬运路由权重的中继:每层的路由停顿从 43,862 周期降到 12,292 周期。
本步 1.14× · 从基线起 9.08×
头部影子 v2(用临时猜测启动下一个 token,尽早发现失误)加上跨芯片时序修复,使内核达到 237.5 MHz、内存达到 450 MHz。
本步 1.62× · 从基线起 14.68×
带真实草拟模型的精确推测解码:一个精简版 Maple 在 F2 的主机 CPU 上提前草拟,FPGA 验证每一个 token。
本步 1.12× · 从基线起 16.42×
把内存端口从 4 个翻倍到 8 个(两个投影通道,输出头跨 bank 条带化):每时钟 1.39×,但拥塞把时钟压到 181/375 MHz。
本步 1.03× · 从基线起 16.91×
把注意力引擎的 KV 读取藏在它的计算之后,并把路由器的 2,048 步串行求和换成精确的、与顺序无关的求和(每层 12,292 → 2,338 周期)。
本步 1.24× · 从基线起 20.98×
无损的 5 三值权重打包(权重字节减少 20%)、更短的串行步骤,以及把输出头移到远端芯片,这缓解了拥塞并允许 225/400 MHz。
本步 1.27× · 从基线起 26.63×
头部影子失误后重新推测、在路由器期间对 MoE 专家进行推测性预填充,以及一次芯片间再平衡(去掉未使用的 DDR 控制器),使两次启动都跑在 231.25/450 MHz。
Vibecoding 一颗推理芯片
这一步 1.08× · 相对基线 28.63×
一个头加载器,可同时读取两个存储体(+17.3%,在单张图片上开与关的测量结果),一个运行时专家预取策略,以及路由任务时序修复;把时钟降低一档运行(225/425 MHz),因为在 231.25 下进行长时间浸泡测试时发现了随机故障。
这一步 1.16× · 相对基线 33.13×
对比情况
要在这些配置之间做 1:1 对比是很困难的。我并没有在每种替代方案上运行相同的自动研究循环,而且我假设如果那样做,还能榨出更多性能。重点是展示 FPGA 在最初实现时有多慢,以及优化循环把它带到了多远。
下面的测量来自 11 月 15 日在 AWS 上重放同一组 8 轮对话 × 3 回合基准测试。价格是那次实验记录下来的按需费率。“精确回合”统计的是与固定 CPU 参考结果匹配的输出。包含 GPU 实现仅供参照,它们不满足同样的位精确标准,但实际已经相当接近。
| 项目 | 实例 | 每小时价格 | 基准 tok/s | 精确回合 | FPGA 快多少倍 |
|---|---|---|---|---|---|
| F2 FPGA, r9(最终镜像) | f2.6xlarge | $1.98 | 213.13 | 24/24 | — |
| 精确 CPU 对照, 32 线程 | m8a.8xlarge (32 Zen 5 核心) | $1.95 | 129.5 | 24/24 | 1.65× |
| 精确 CPU 对照, 24 线程 | c7i.12xlarge (24 Sapphire Rapids 核心) | $2.14 | 99.6 | 24/24 | 2.14× |
| 固定标量参考, 全部 32 核心 | m8a.8xlarge | $1.95 | 40.6 | 24/24 | 5.25× |
| 固定标量参考按固定设置, 1 线程 | r7i.2xlarge | $0.53 | 1.1 | 24/24 | 195× |
| 精确 CPU 对照, 4 线程(小实例) | m8a.xlarge (4 Zen 5 核心) | $0.24 | 67.6 | 24/24 | 3.16× |
| DeepGrove 自己的分支带 GPU 卸载(非位精确,仅供参考) | g4dn.xlarge (T4 GPU) | $0.53 | 35.7 | 1/24 | 5.97× |
| 社区 CUDA 移植(非位精确,仅供参考) | g4dn.xlarge (T4 GPU) | $0.53 | 166.3 | 0/24 | 1.28× |
随着上下文增长会发生什么?
这是从 16 个 token 的提示开始、一直持续到 8,192 个 token 的上下文填满的一次生成:共生成 8,176 个 token。中间五列显示的是不同迭代代数在指定上下文长度下的解码速度(token/s)。最后一列是整次运行的挂钟时间。
| 镜像 | 16–64 | 1–2k | 2–4k | 4–6k | 6–8k | 整次运行 (s) |
|---|---|---|---|---|---|---|
| r5 | 108 | 70 | 57 | 45 | 37 | 162.3 s |
| r6b | 142 | 111 | 90 | 72 | 60 | 102.3 s |
| r7 | 181 | 140 | 111 | 88 | 72 | 83.6 s |
| r8 | 186* | 155* | 121 | 94 | 77 | 77.6 s |
| r9 | 233* | 151* | 120 | 93 | 76 | 77.8 s |
- 对于 r8 和 r9,前两列来自单独的、更短的、生成 2,032 个 token 的运行。其他列来自完整上下文运行。
r9 提升了短上下文下的速度,而完整的长上下文运行大约与 r8 持平。
模型实际说了什么
这些示例来自最终的 r9 镜像。
算术,附带步骤
246 个 token · 229.7 token/s · 端到端 1.16 s
        USER: What is 37 × 48? Explain the steps briefly.

MODEL: <think>
We need to compute 37 × 48. The user asks to explain steps briefly. So I'll do multiplication: 37 × 48 = 37 × (50 - 2) = 37×50 - 37×2 = 1850 - 74 = 1776. Or directly: 37×40=1480, 37×8=296, sum=1776. I'll present a brief explanation.
</think>

To multiply 37 by 48, you can break it down:

- 37 × 48 = 37 × (50 – 2) = (37 × 50) – (37 × 2) = 1850 – 74 = 1776.

Alternatively, 37 × 40 = 1480 and 37 × 8 = 296, so 1480 + 296 = 1776.

The final answer is **1776**.
一点 Python
140 个 token · 220.0 token/s · 端到端 0.76 s
系统提示:“你是一个有用的助手。回答前先简要思考,然后清晰简洁地回复。”
        USER: Write a Python function is_palindrome(s) that ignores case, spaces and punctuation.

标题:Vibecoding 一颗推理芯片

正文:
MODEL: <think>
我们需要写一个 Python 函数 is_palindrome(s),它忽略大小写、空格和标点符号。因此我们需要过滤掉非字母数字字符,转换为小写,然后检查结果字符串是否等于其反转。提供代码。
</think>
def is_palindrome(s: str) -> bool: """ 如果字符串 s 是回文,忽略大小写、空格和标点符号,则返回 True。 """
过滤只保留字母数字字符并转换为小写
filtered = ''.join(ch.lower() for ch in s if ch.isalnum())
与其反转进行比较
return filtered == filtered[::-1]
这把我们带到了哪里
这是一个有趣的项目。我不确定我是否还会以这种特定方式使用这种特定的芯片架构,我也当然不是在声称,一个在 FPGA 上运行的 8,192 token 上下文模型是我会推荐任何人在生产环境中使用这类东西的方式。但这件事就这样跑通了,这相当了不起。这样的能力彻底改变了有决心的工程师团队可以从事什么工作的 overton 窗口。它应该意味着,如果你能把模型指向正确的方向,全新类型的想法(科学发现、产品、初创公司)都是可能的。我很期待看到大家构建出什么。