 Newshot
Steller
一个有趣的基准,已经打满
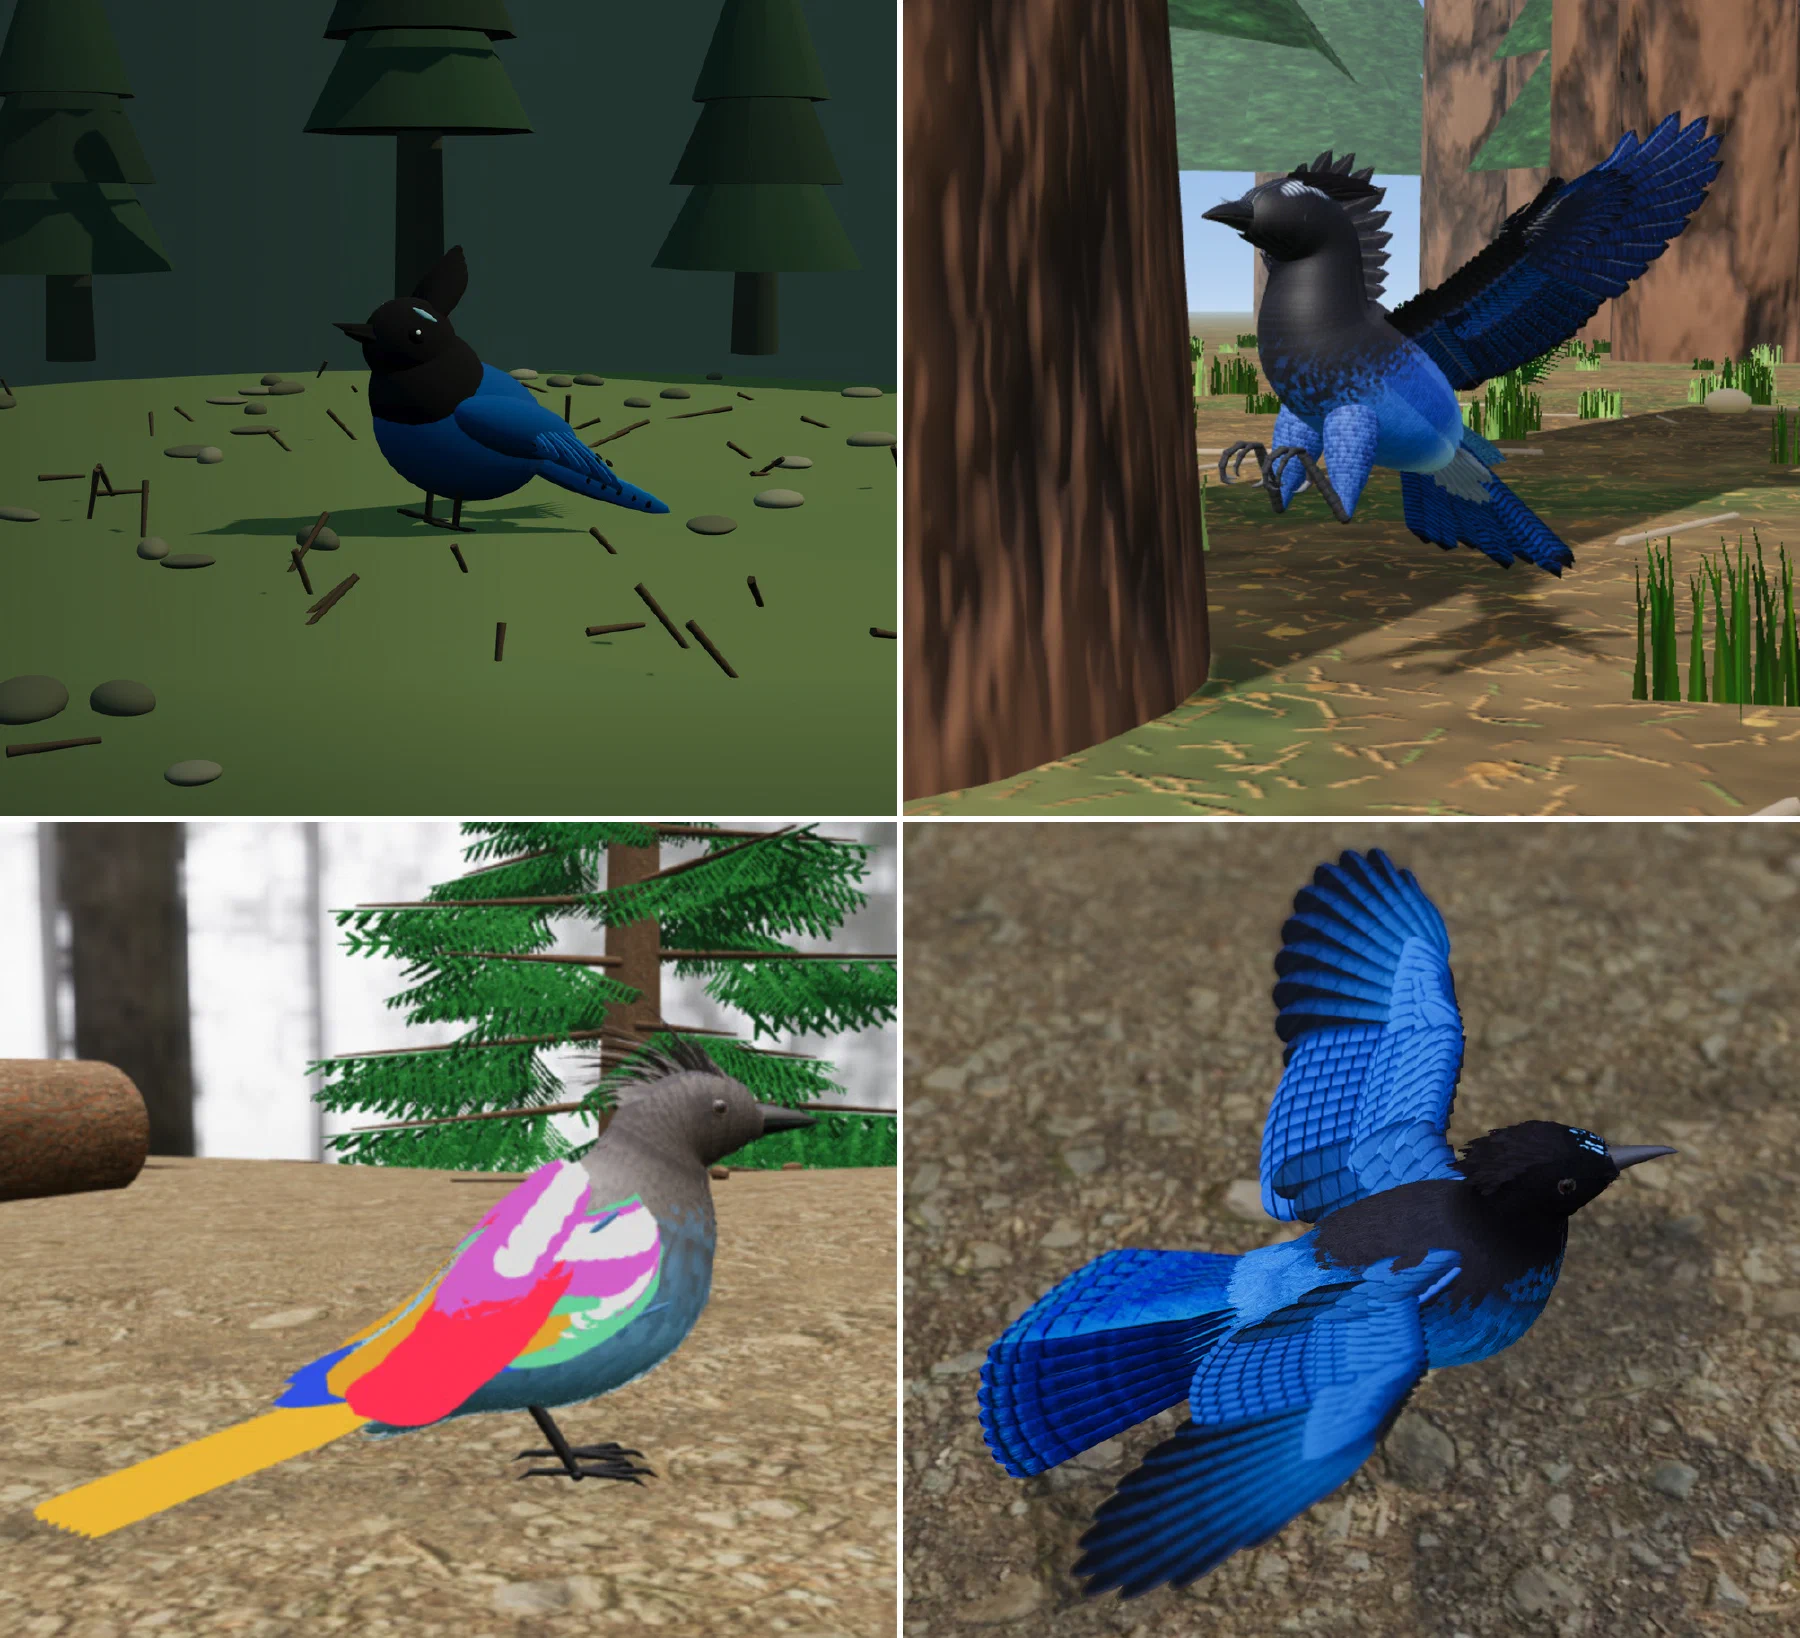
每个人都该构建自己的 AI 基准。为什么?
- 各实验室会针对公开基准优化他们的 agent,所以基准的变化往往夸大能力的实际变化。
- 你想用 AI 做的事往往是你个人特有的,带有一些无法干净利落地塞进通用基准的怪癖。
- 主观基准往往能让你感受到 agent 产出质量的“质感”,而必须被压缩成分数/通过-失败的基准做不到这一点。
- 如今的基准滑稽地过度偏重编程和逻辑推理,仅仅因为它们可验证。
- 构建自己的基准很好玩,还能为新模型发布添一份兴奋感。
因此,每当我遇到 AI agent 解决不了、或者做得很糟的问题时,我就把 prompt 抄进电脑上 ~/benchmarks/[NAME].md 的一个小文件里,有时附上任务所需的文件等上下文。然后,等新模型出来时,我跑上几个,快速感受一下新模型能做什么。
Steller
其中一个(主观)基准,我对它的结果已经足够满意、可以称其“通过”了,就是 STELLAR.md。
请在 3JS 中创建一个详细的交互式环境,里面有一只 Steller's Jay,能够响应鼠标点击而移动(既会飞也会跳),并且能在无人干预的情况下被动移动,模拟这种动物的运动和被动活动。它应处于一个简化的 3D 场景中,以便展示 jay 的运动。你的目标是以极高的视觉保真度捕捉该动物的物理特征、运动方式和行为模式。力求写实,避免那些会产生分散注意力的视觉伪影的简化。它只能使用 Javascript 和 HTML,并且应能离线运行。你可以通过其他提供商的其他模型运行子 agent(经由 codex、claude 和 agy CLI)来检查你的工作并提供视觉点评。你有 6 小时,以及最多 100 美元的 API 额度可用(涵盖所有模型)。开始之前有什么问题吗?
然后我会回答模型提出的任何问题。
细心的读者会发现,在这个 prompt 里我把它打成了“StellAr”(带 A),而它实际上拼作“StellEr”(带 E)——这是我写这篇博客文章时才知道的。我猜我不是个好 SPELLAR(笑)。
Progression
我开始问这个问题是在 2026 年 6 月,当时人们刚开始谈论 3D 建模的巨大进步。
早期结果很糟,但解决了一组越来越复杂的问题,涉及交互性、运动、纹理/图案,最终是飞行物理。就像任何好项目一样,它们也带来了一些有趣的失败
Astra 6.2 and Fable 5.2
在 5 个月内,也就是 2026 年 11 月,我判定这个基准“已解决”。Astra 6.2 和 Fable 5.2 都能在成本阈值之内把它做得非常好。
文章标题:动画版暗冠蓝鸦,一个美丽的 AI 基准测试
正文: 下面嵌入的结果来自一个 Fable 5.2 agent,它与一个 Astra 6.2 agent 协作进行视觉审查。它们在形成这一结果的过程中来回沟通了许多次(比我通常在其他形式的跨模型协作中见到的都要多),其间两者都时不时对代码做出了修改。我把最终结果归功于 Fable 5.2,只是因为它负责协调并编写了几乎全部代码,而 Astra 6.2 单独运作时的表现则远没有那么亮眼。最终运行耗时 4.5 小时,相当于约 80 美元的 API 成本。我对这个结果做了一些视觉上的调整(比如提高了羽毛的饱和度,并让另一个 agent 对 CPU 性能做了一轮优化,好让它在移动端也能流畅运行以便用于本文),但视觉推理的核心质量来自那一次运行。
接下来是什么?
最终,在某个时候,我想玩一款电子游戏,它把我们所知的关于鸟类如何行为、沟通、成长以及与环境互动的几乎一切,编码进一个游戏里——在游戏中你是一只鸟,在 VR 中穿行于世界,与其他鸟类和栖息地互动,躲避捕食者,觅食,并最终努力把一只雏鸟(如果幸运的话,是多只)抚养到成年。
这个想法源于三处灵感:
- “American Truck Simulator”游戏(在其中,超写实让某种可能无聊的东西变得引人入胜)
- “Untitled Goose Game”(在其中,简单的点击指向机制、与一个丰富世界的互动,就是令人愉悦)
- 以及哲学家 Thomas Nagel 那篇著名的论文“What is it like to be a bat?”(它指出了想要真正理解身为另一种生物是什么感觉,存在根本性的局限)
想象一下,如果关于一个物种的所有世界信息(视频、行为分析、科学研究等)都能被 AI 解读,从而构建出一种体验,试图模拟作为那个物种生活可能是什么样子。
我的希望是最终能玩上一款暗冠蓝鸦模拟器,去尝试理解身为一只鸟可能是什么感觉——在雷雨中蜷缩在植物下,高高飞越森林,在灌木和栅栏的庇护掩映附近觅食,交流、跳舞、拥有小小的社交群体。我觉得这会很有趣、有教育意义,而且很难,我能想象玩它会真正拓宽我们的心智(不只是暗冠蓝鸦,还有米诺鱼、蟋蟀、老虎、虎鲸、瓢虫等等)。
这个基准测试并不是这样一款游戏的终点,只是那条路上的一块里程碑。
基准测试究竟是什么?
我通过 Pharos 让我所有的 agent 都能访问过去的对话历史,对基准测试也不例外。这对较早的运行本质上“不公平”,因为在最终运行中,agent 团队(未经我指示)利用这个 MCP 检查了先前的尝试并避开了一些陷阱,还从先前的运行中获得了一些想法。这无疑会偏向较晚的模型,并模糊了“模型变强了”与“模型从过去的错误中学到了东西”之间的界限。
现在,如果你觉得“这破坏了基准测试的意义”,我会在狭义上不同意。
大多数人和公司把基准测试当作评估“这个 agent 在没有任何帮助或支持的情况下能做什么”这一问题的途径。我更感兴趣的是问“在前沿上,什么是新近成为可能的”。关于过往努力的信息通常对我的 agent 是可得的(多亏了 Pharos),所以我希望在考虑这一优势的前提下评估和思考模型在前沿上的能力。我个人基准测试的目的是帮助我理解什么是新近成为可能的,而这种可能性是历史与工具的函数,而不仅仅是模型智能的函数。
所以,下一次 AI 在某个任务上让你失望时,不要为此哀叹,把它藏起来留给未来——这样你就能手舞足蹈,并更好地理解可能性的前沿。