 Newshot
在 SageMaker AI Serverless 模型定制上进行全量微调(FFT)
微调是指在公司自有数据上继续训练预训练大语言模型(LLM)的过程,使其适应特定领域、任务或风格,而非仅依赖通用知识。对企业而言,其价值是双重的。微调后的模型在特定领域工作上能带来可衡量的更高准确率,同时降低成本:一个更小的专用模型可以在你的任务上达到甚至超越前沿模型的表现,而每 token 推理价格仅为其一小部分。这些节省会在数百万次请求中不断累积。因此,微调已成为企业以更低成本从 LLM 中获取更多价值的关键流程。
参数高效微调(PEFT)方法,如低秩适配(LoRA),已成为将 LLM 微调到下游任务的实用解决方案,通过仅更新一小部分 LLM 参数来降低 GPU 容量需求。LoRA 旨在平衡效率与表达能力,然而,权重更新的低秩特性本质上限制了 LoRA 微调模型的表示能力,可能损害其在复杂任务上的性能。这种权衡阻碍了 LoRA 方法捕捉多样化任务所需的复杂模式的能力。为应对这些挑战,全量微调(FFT)同时更新模型参数,克服了低秩限制,使 LLM 能够充分吸收复杂的领域特定知识。
Amazon SageMaker AI Serverless 模型定制现已支持全量微调(FFT),因此你无需管理基础设施即可实现卓越的模型质量。无需 GPU 预置、集群设置或分布式训练配置。在本文中,我们探讨 FFT 在关键基准测试中何时何地持续优于 LoRA,考察解释这一质量差距的模型权重矩阵的谱特性,提供由使用 SageMaker AI Serverless 模型定制的受控实验支持的实用超参数调优指南,并向你展示如何在 SageMaker AI 上开始使用 FFT。
全量微调:为何重要
LoRA 等模型定制类型通过冻结预训练模型的权重,并向模型层中注入小的、独立的替换矩阵对(称为低秩矩阵)来减少可训练参数。这对于简单的适配很有效,但低秩结构本质上限制了微调模型的表示能力。随着任务变得更加复杂、数据集规模超过数万个样本,LoRA 会触及准确率平台期,此时增加秩(以及因此增加的可训练参数)无法弥合与标准微调之间的准确率差距。这一平台期表明,性能差距并非仅仅因为参数更少。它是由秩亏缺本身造成的。低秩更新无法捕捉深度任务适配所需的权重变化的全部复杂性。
然而,对于存在大规模优质数据集的复杂任务和领域,全秩微调通过同时更新模型参数而表现出色。FFT 均匀地修改模型的权重矩阵,利用模型权重矩阵的完整表示能力,而非将更新限制在小子空间内,并且不会引入低秩方法特有的突然的局部失真。其结果是更强的模型收敛性、跨模型层更好的激活对齐,以及一个忠实捕捉目标任务分布和其预训练知识丰富性的模型。FFT 的质量优势随数据集规模而增长:在 10 万+ 训练样本时,FFT 在代码生成任务的 LLM-as-Judge 语义正确性上达到了 90.0%,如下图所示。
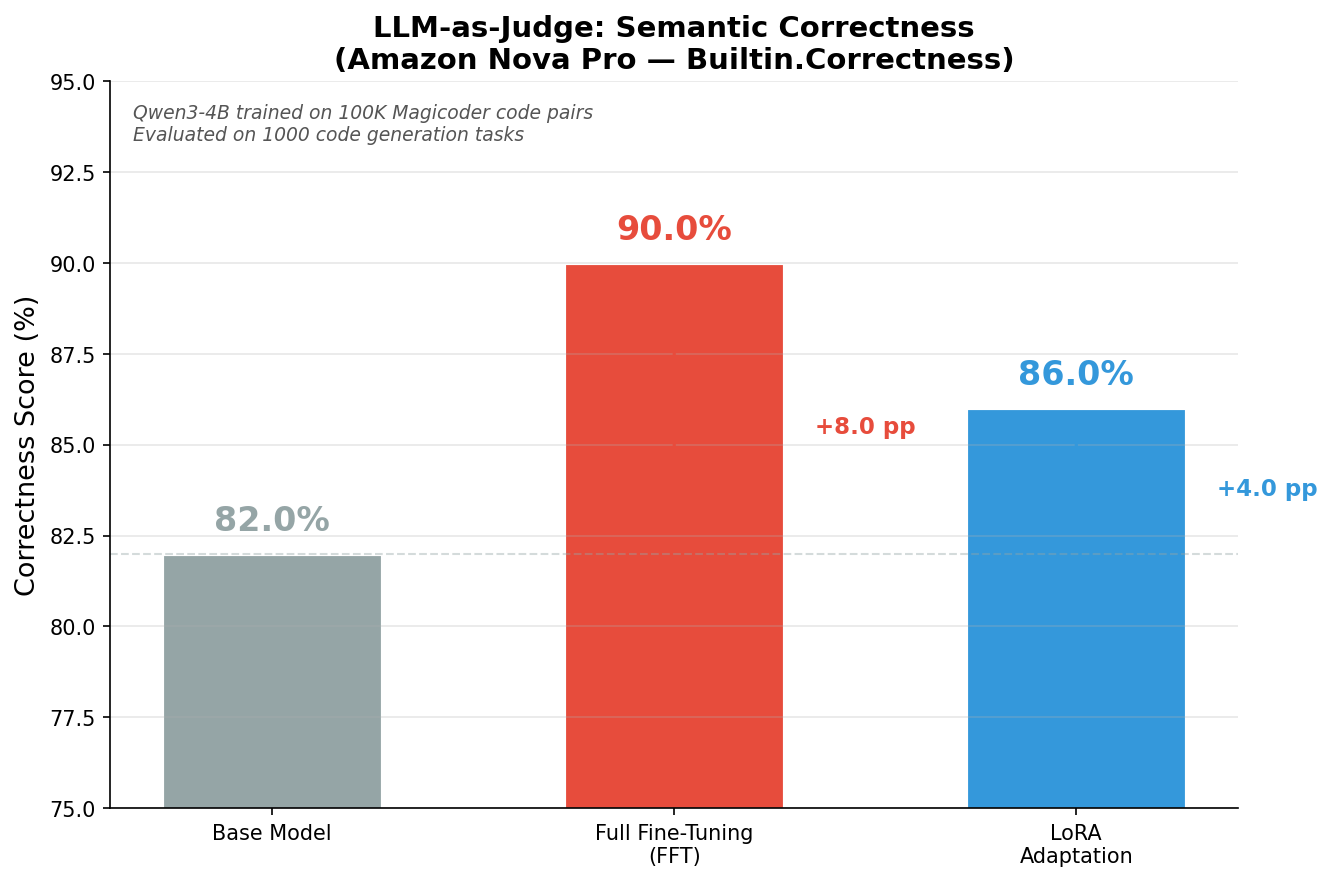
图 1:随着训练数据规模扩展到 100K+ 示例,按训练方法划分的 LLM-as-Judge 语义正确性
此外,以下雷达图提供了整体视图:基础模型(内层多边形)在所有轴上都显示出持续较低的分数。LoRA(中间多边形)表现出强劲且均衡的提升。FFT(外层多边形)在每个维度上延伸得更远,在 BLEU 和 ROUGE-2 分数上的领先尤为明显。这种多维度的质量领先证实,它不是某个指标特有的假象,而是全秩优化的根本优势。
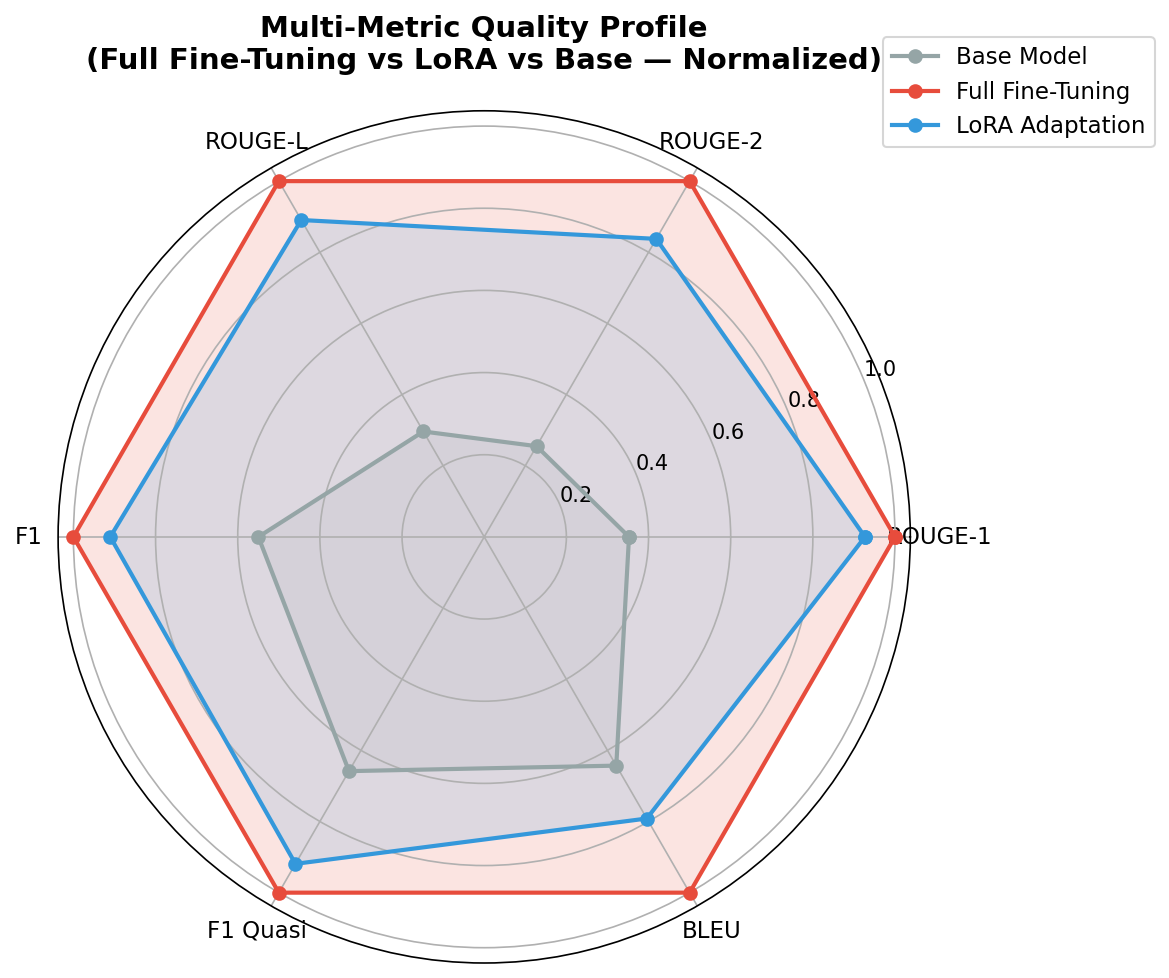
图 2:比较基础模型、LoRA 和 FFT 在质量维度上的雷达图
我们如何得到这些结果的细节、用于模型定制的编码数据集以及实验过程,将在以下各节中详细说明。
实验与基准测试结果
在本文中,我们对 Amazon SageMaker AI Studio 中提供的 Qwen3-4B 基础模型使用了监督微调(SFT)技术,并通过 SageMaker AI Serverless Model Customization 在 LoRA 和 FFT 训练方法上完成了所有微调实验。在每个实验中,两种方法都使用相同的提示、目标和评估代码。
数据集:代码生成 110K 指令对
在所有实验中,我们在 Magicoder-Evol-Instruct-110K 数据集上对 Qwen3-4B 基础模型进行微调;该数据集是一个经过整理的语料库,包含 110,000 个编码指令-响应对,涵盖算法设计、调试、数据结构和系统编程。我们对数据集采用 90/5/5 划分:99,000 条记录用于训练,5,500 条用于验证,以在定制作业期间监控收敛和训练损失,另有 5,500 条保留为留出测试集,用于对最终模型进行无偏评估;这些数据已注册到 SageMaker AI 数据集资产中,如下图所示。
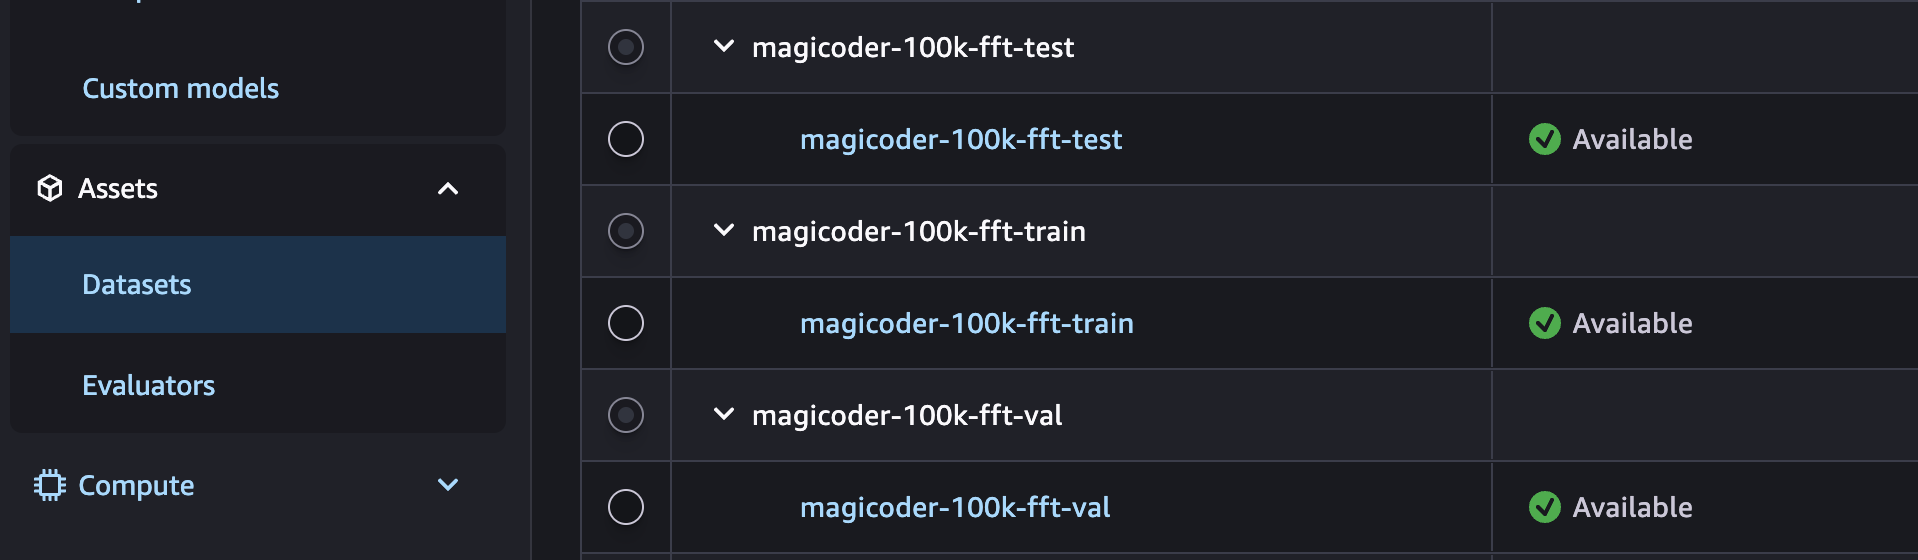
图 3:已在 SageMaker AI 数据集资产中注册的 110K 指令对数据集
Serverless Model Customization 作业
本文中的所有模型定制实验均在 Amazon SageMaker AI Serverless Model Customization 上完成。SageMaker AI 上的 Serverless Model Customization 使数据科学家和机器学习(ML)工程师无需管理基础设施或规划 GPU 容量,即可专注于模型微调。您指定基础模型、数据集和超参数,服务会以无服务器方式自动处理计算资源分配和检查点管理。以下代码片段展示了使用 SageMaker Python SDK 在 Serverless Model Customization 上启动全量微调(FFT)作业的一个此类实验。
        from sagemaker.train.sft_trainer import SFTTrainer
from sagemaker.train.common import TrainingType

trainer = SFTTrainer(
    model=base_model_id,
    training_type=TrainingType.FULL,
    model_package_group=model_package_group_name,
    training_dataset=training_dataset,
    validation_dataset=val_dataset,
    s3_output_path=output_path,
    sagemaker_session=sess,
    role=role,
)

# Configure hyperparameters as needed
trainer.hyperparameters.learning_rate = 2e-5
trainer.hyperparameters.global_batch_size = 8
trainer.hyperparameters.max_epochs = 2
trainer.hyperparameters.lr_warmup_steps_ratio = 0.1

trainer.train(wait=False)
这段代码会触发一个 Serverless Model Customization 作业,如下图所示;训练性能指标会在该作业中跟踪,并可在关联的 MLflow 应用中查看。
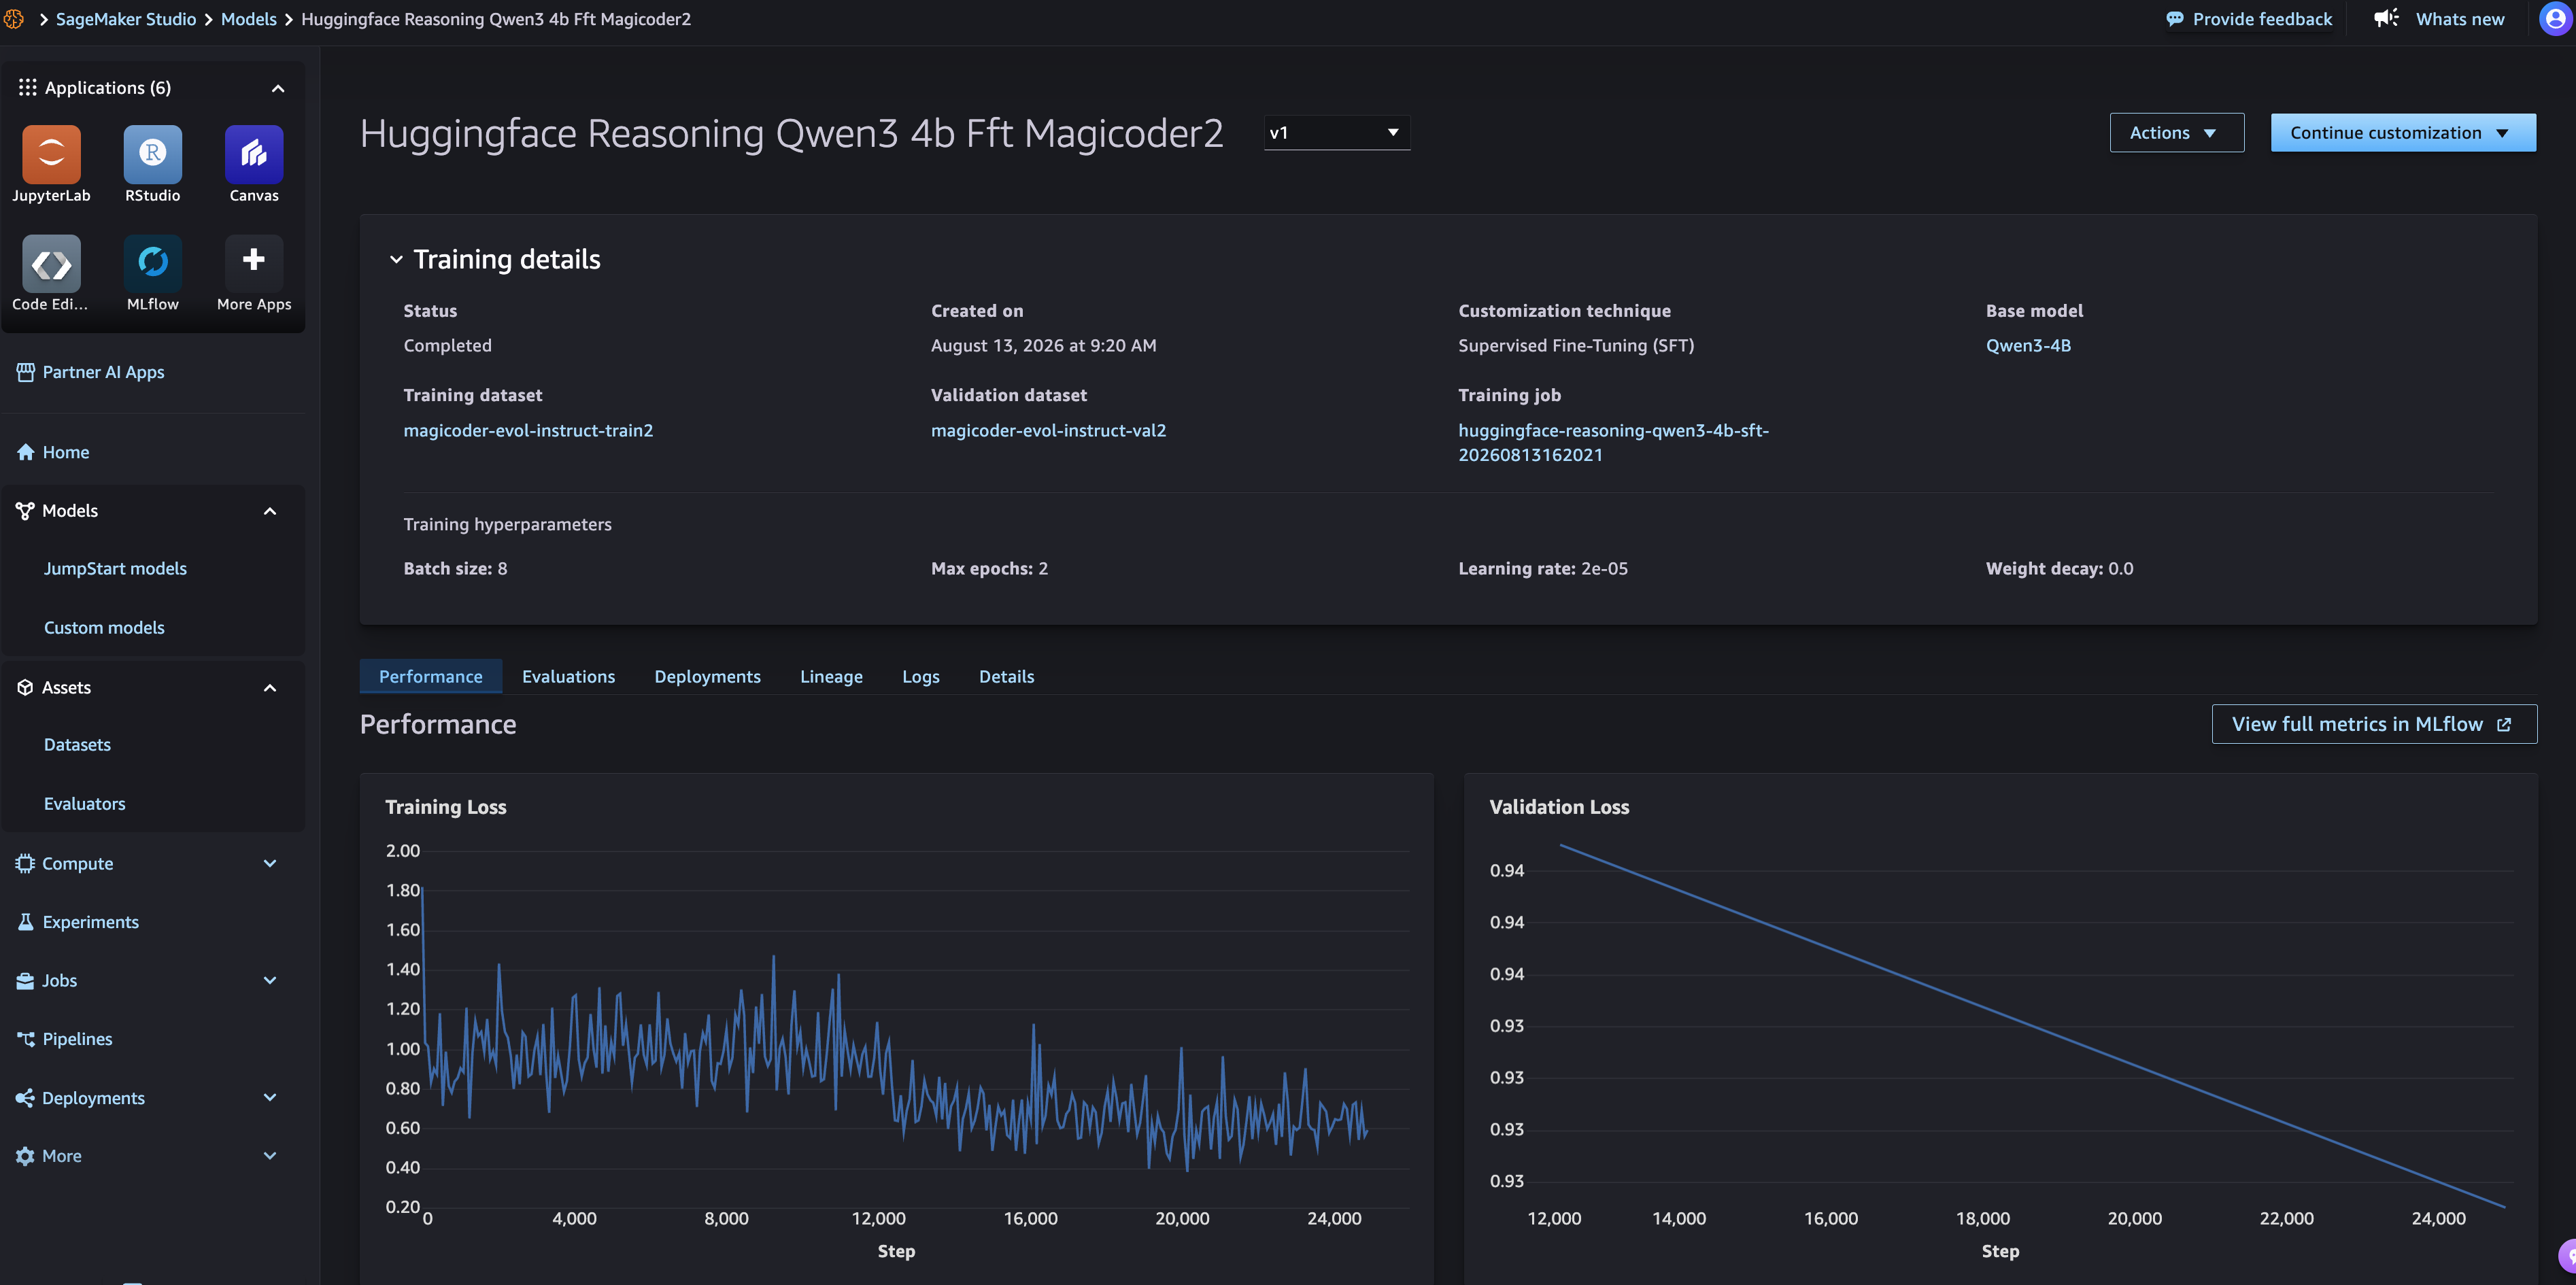
图 4:Serverless Model Customization 作业,训练指标在 MLflow 中跟踪
从 Full Fine-Tuning 切换到 LoRA 只需一处更改:将 TrainingType.FULL 设置为 TrainingType.LORA。其余代码保持不变:
        trainer = SFTTrainer(
    model=base_model_id,
    training_type=TrainingType.LORA,  # ← only change
    model_package_group=model_package_group_name,
    training_dataset=training_dataset,
    validation_dataset=val_dataset,
    ...
)
模型评估与基准测试
我们在 SageMaker AI Serverless Model Customization 内置的三种多样化评估方法上测试了生成的定制模型:LLM-as-Judge、PRIMECODE 和 MMLU,如下图所示。每种方法针对模型质量的不同维度:语义正确性、代码生成保真度和通用知识保留度。它们共同全面呈现模型定制质量。
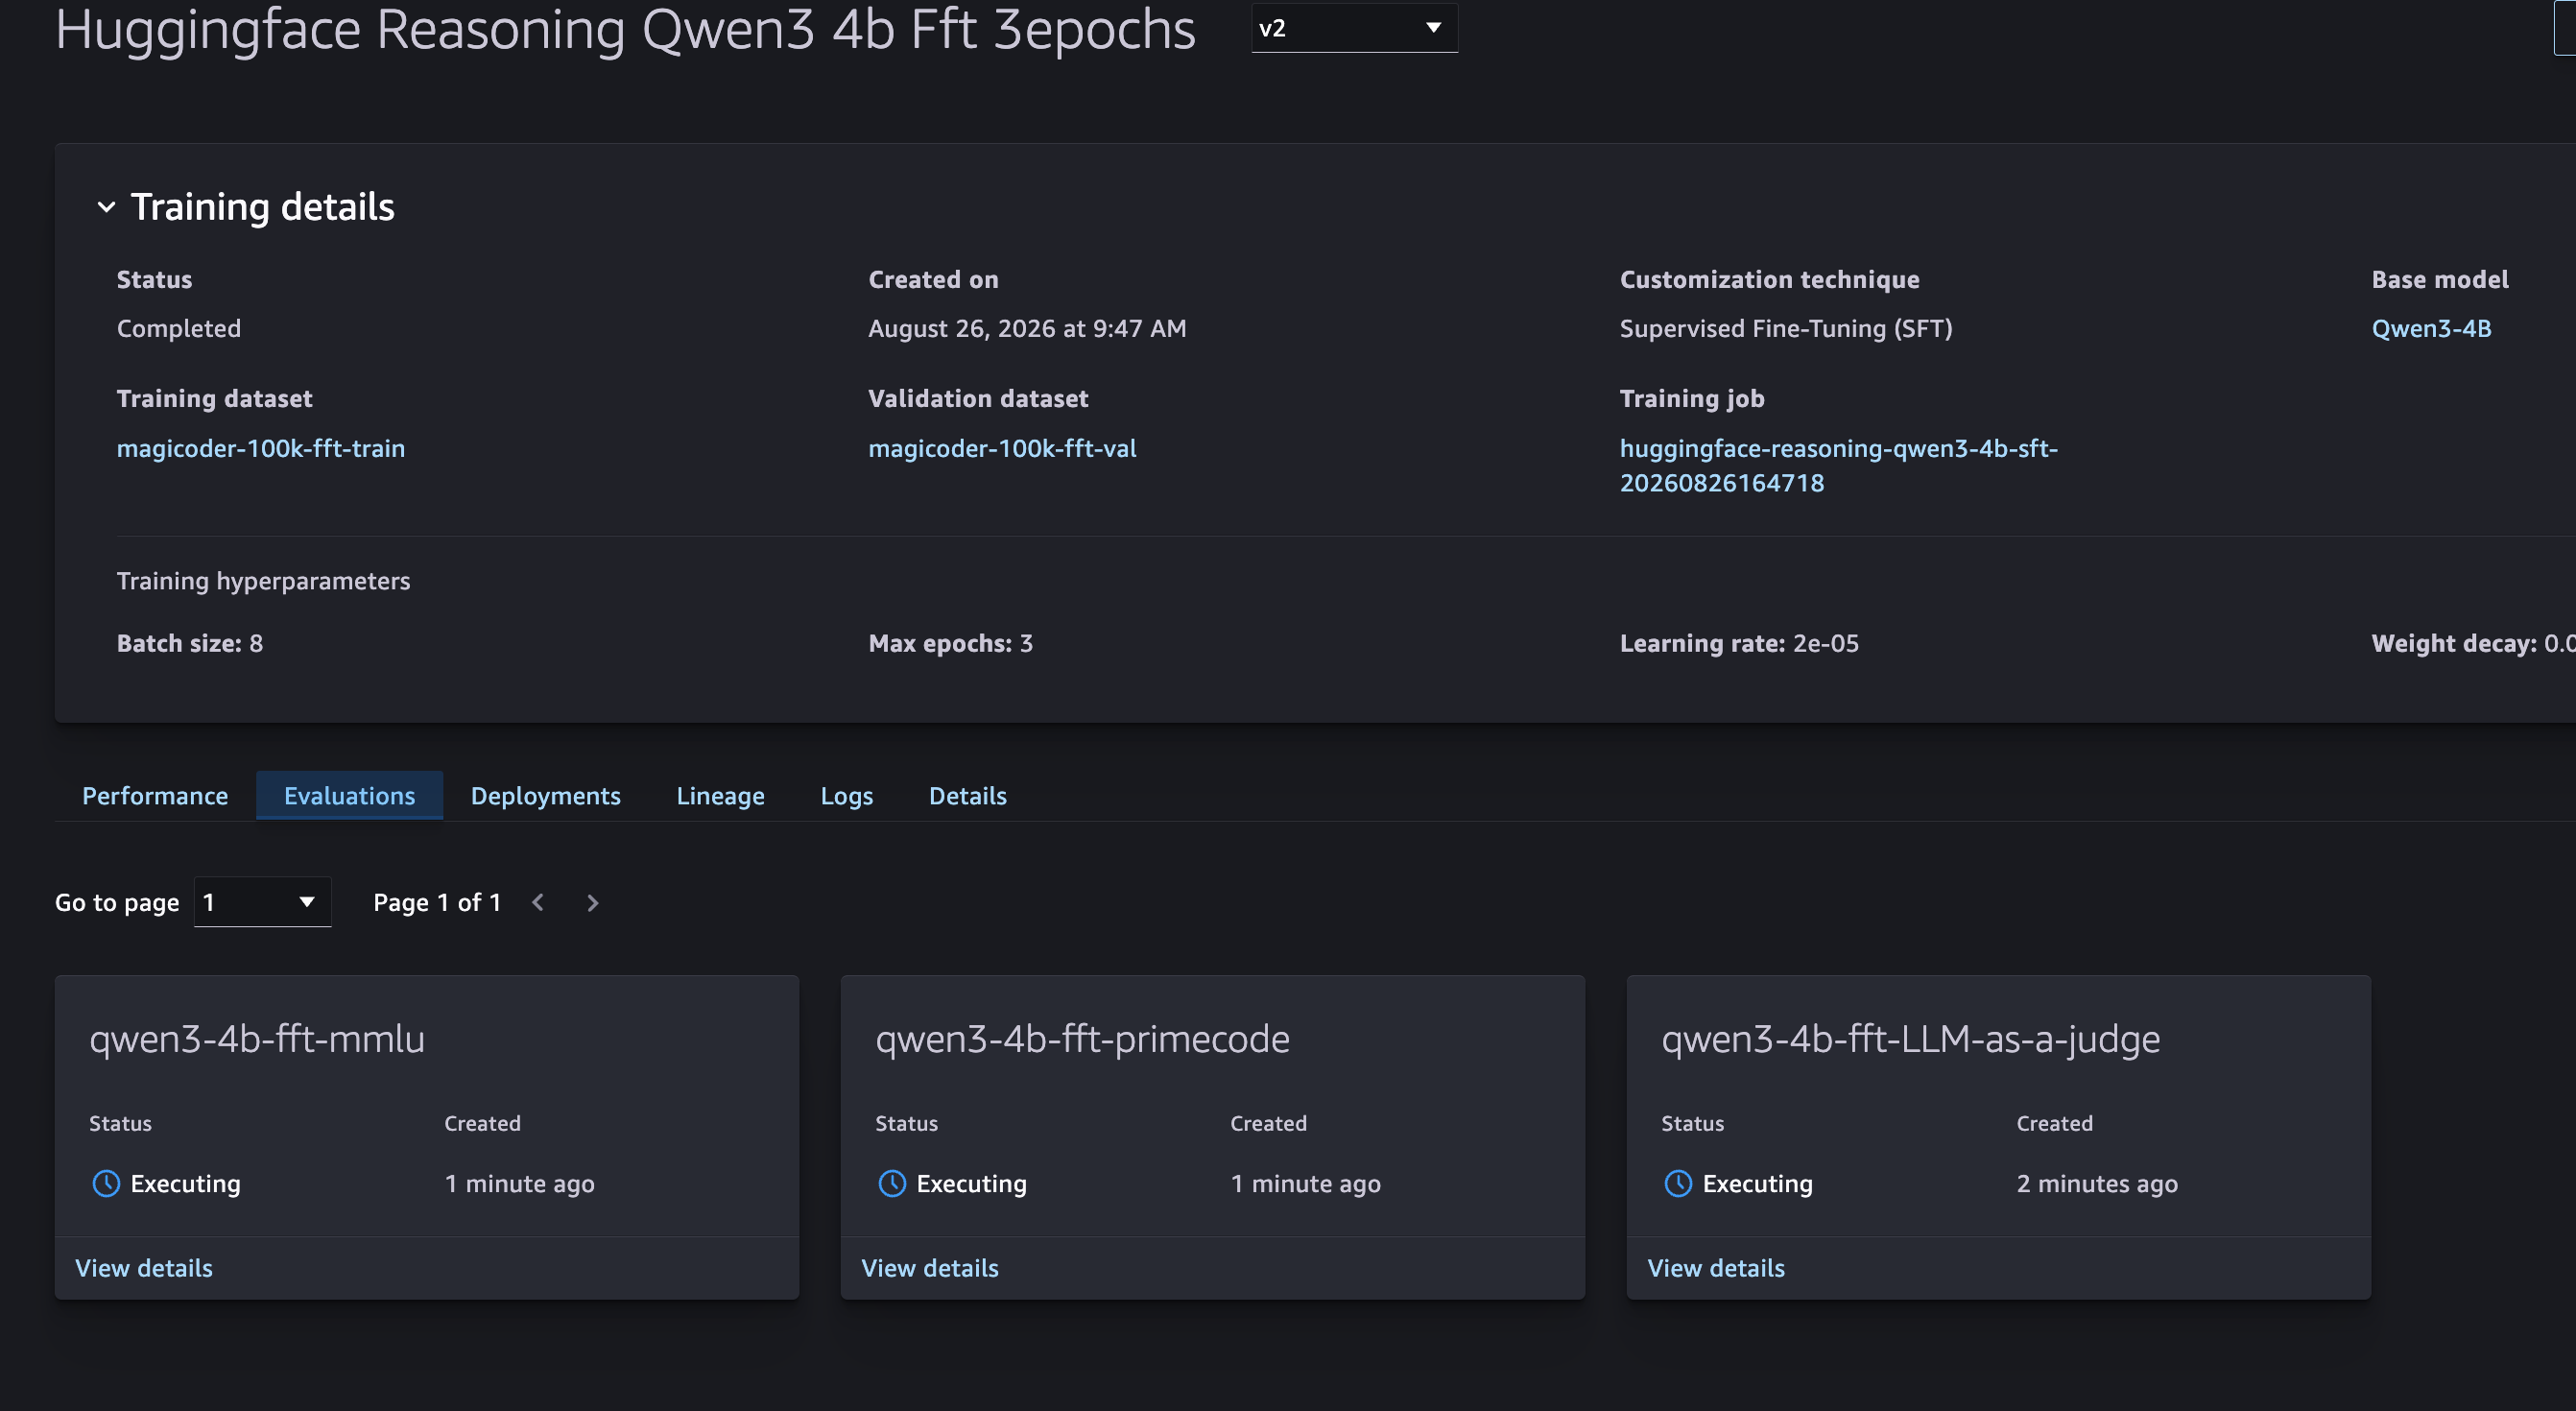
图 5:SageMaker AI Serverless Model Customization 中的三种内置评估方法
LLM-as-Judge 指标使用前沿模型(本文中为 Amazon Nova Pro)作为自动评估器,它会读取模型生成的代码及原始提示,并判断解决方案在逻辑上是否正确。在 Serverless Model Customization 上,你可以同时评估定制模型和基础模型,如下图所示。
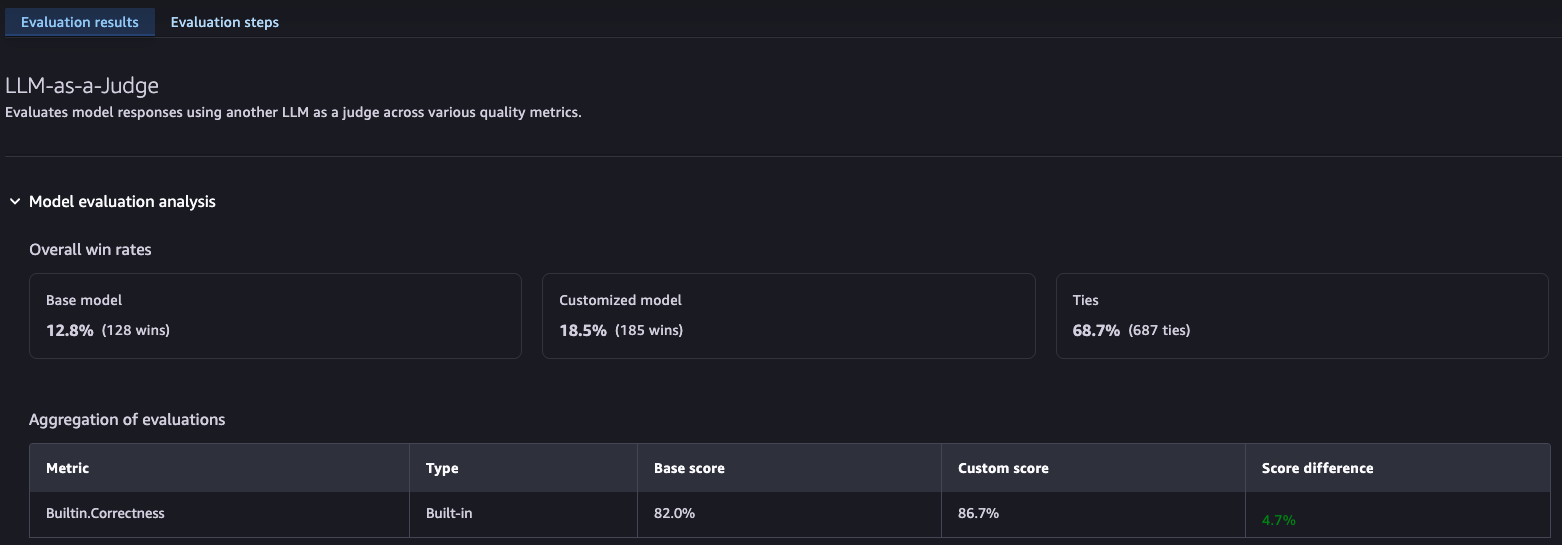
图 6:LLM-as-Judge 评估,比较定制模型和基础模型
PRIMECODE 是一种自定义评分器评估,使用确定性文本相似度指标衡量模型生成代码与参考解决方案的接近程度:BLEU(n-gram 精度)、ROUGE-1/2/L(面向召回的重叠度)和 F1(精确率-召回率平衡)。这些指标完全可复现,因此非常适合受控消融研究。我们将 PRIMECODE 作为表层代码质量的主要指标,因为它量化了模型对训练数据中编码模式、格式约定和实现风格的学习程度。BLEU 分数高意味着模型生成的代码在结构上看起来与专家编写的解决方案相似,如下面的结果所示。
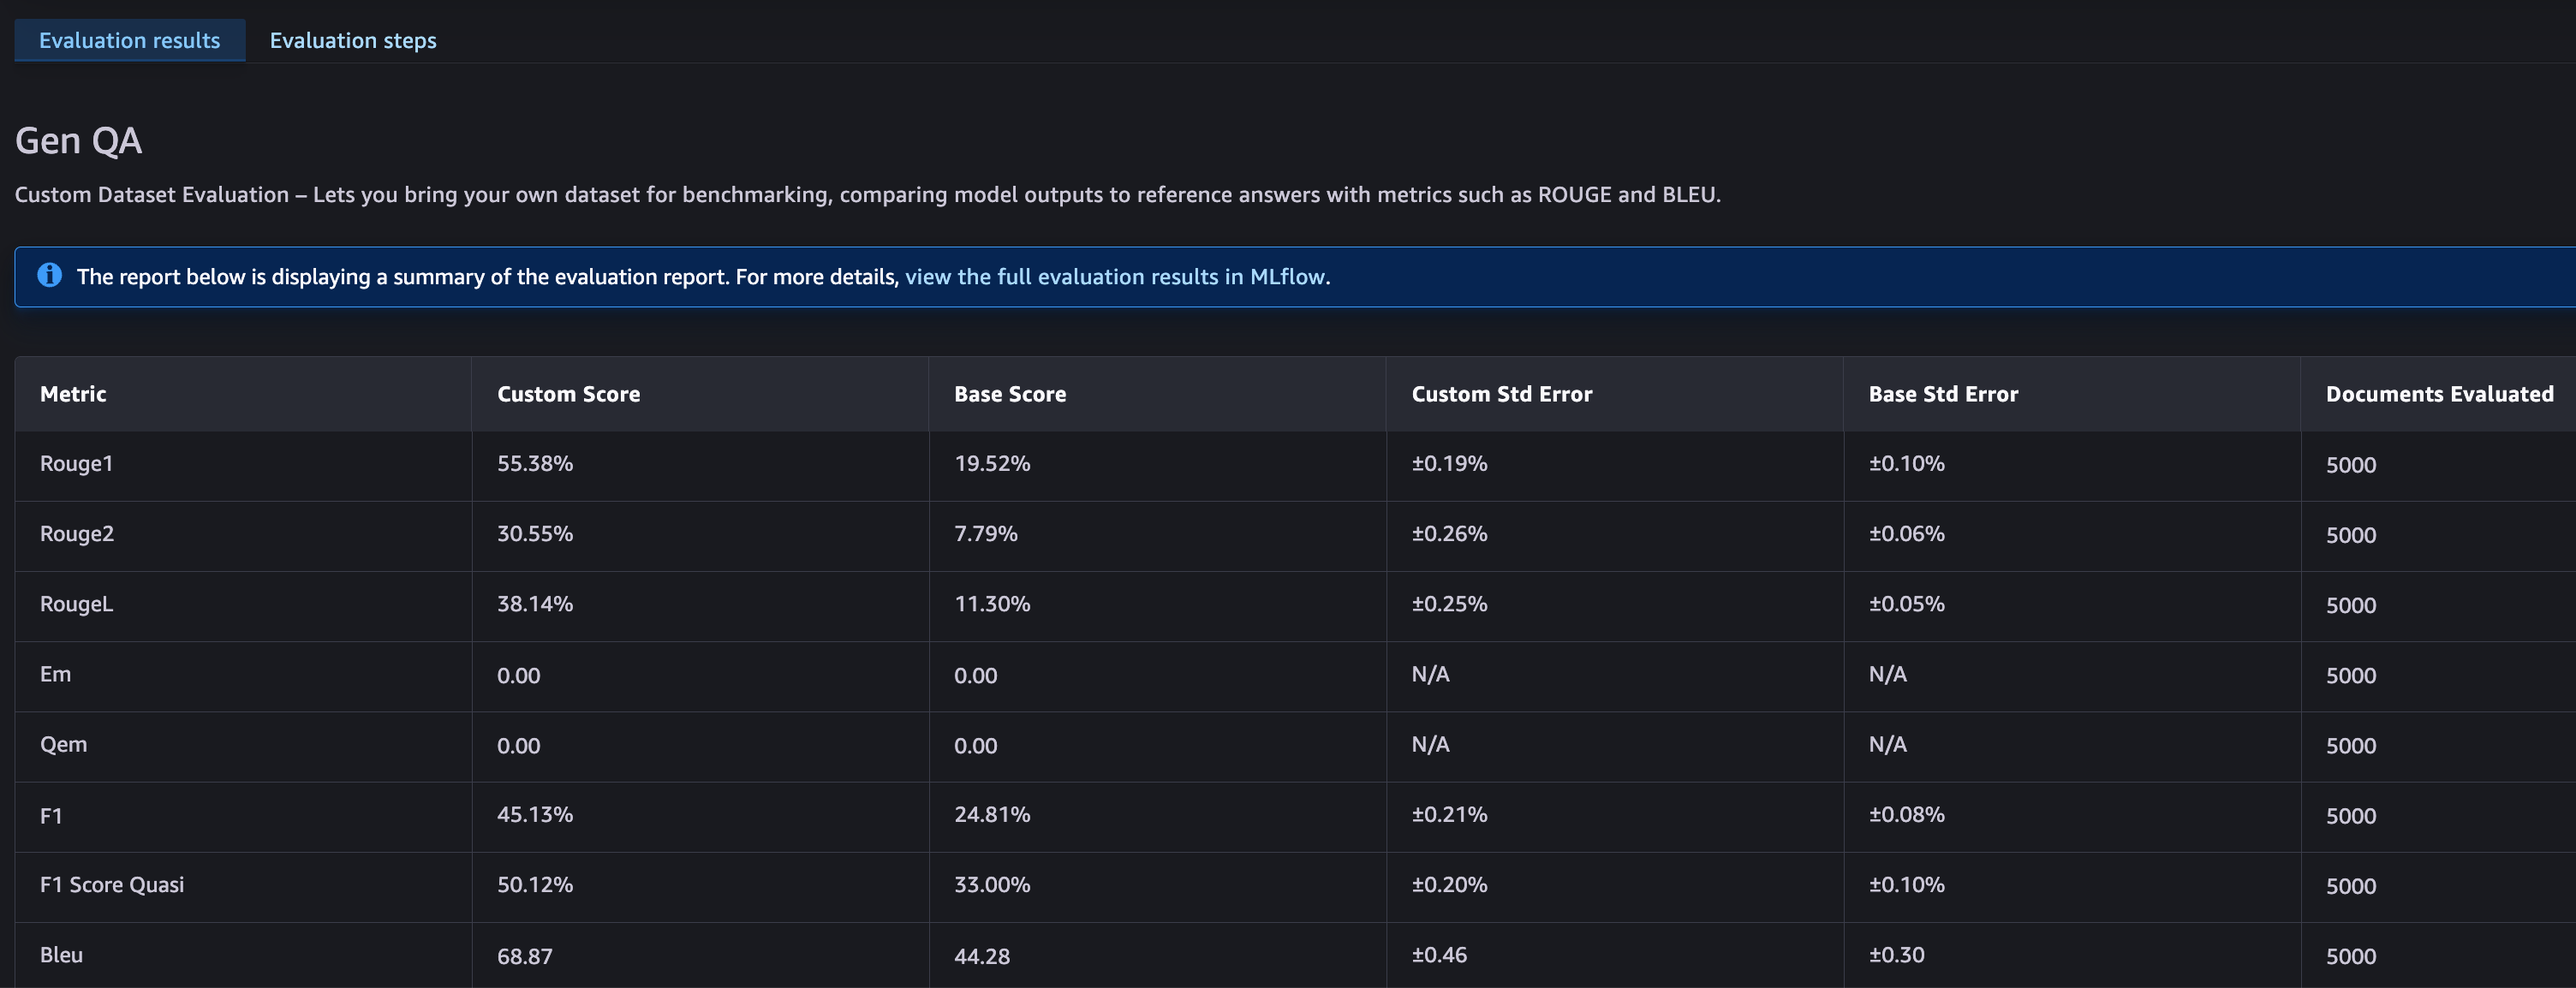
图 7:定制模型的 PRIMECODE 文本相似度分数
MMLU(Massive Multitask Language Understanding)是一个内置基准,测试模型在 57 个学科上的表现,从抽象代数和解剖学到营养学和哲学。它衡量模型在领域特定微调后是否保留广泛通用知识,如下图所示。我们将 MMLU 用作遗忘检测护栏。对代码进行微调可能会覆盖模型权重中存储的通用能力。通过跟踪微调前后的 MMLU 准确率,我们可以精确量化模型为提升代码生成能力而牺牲了多少通用知识,以及我们的超参数选择是加速还是缓解这一权衡。
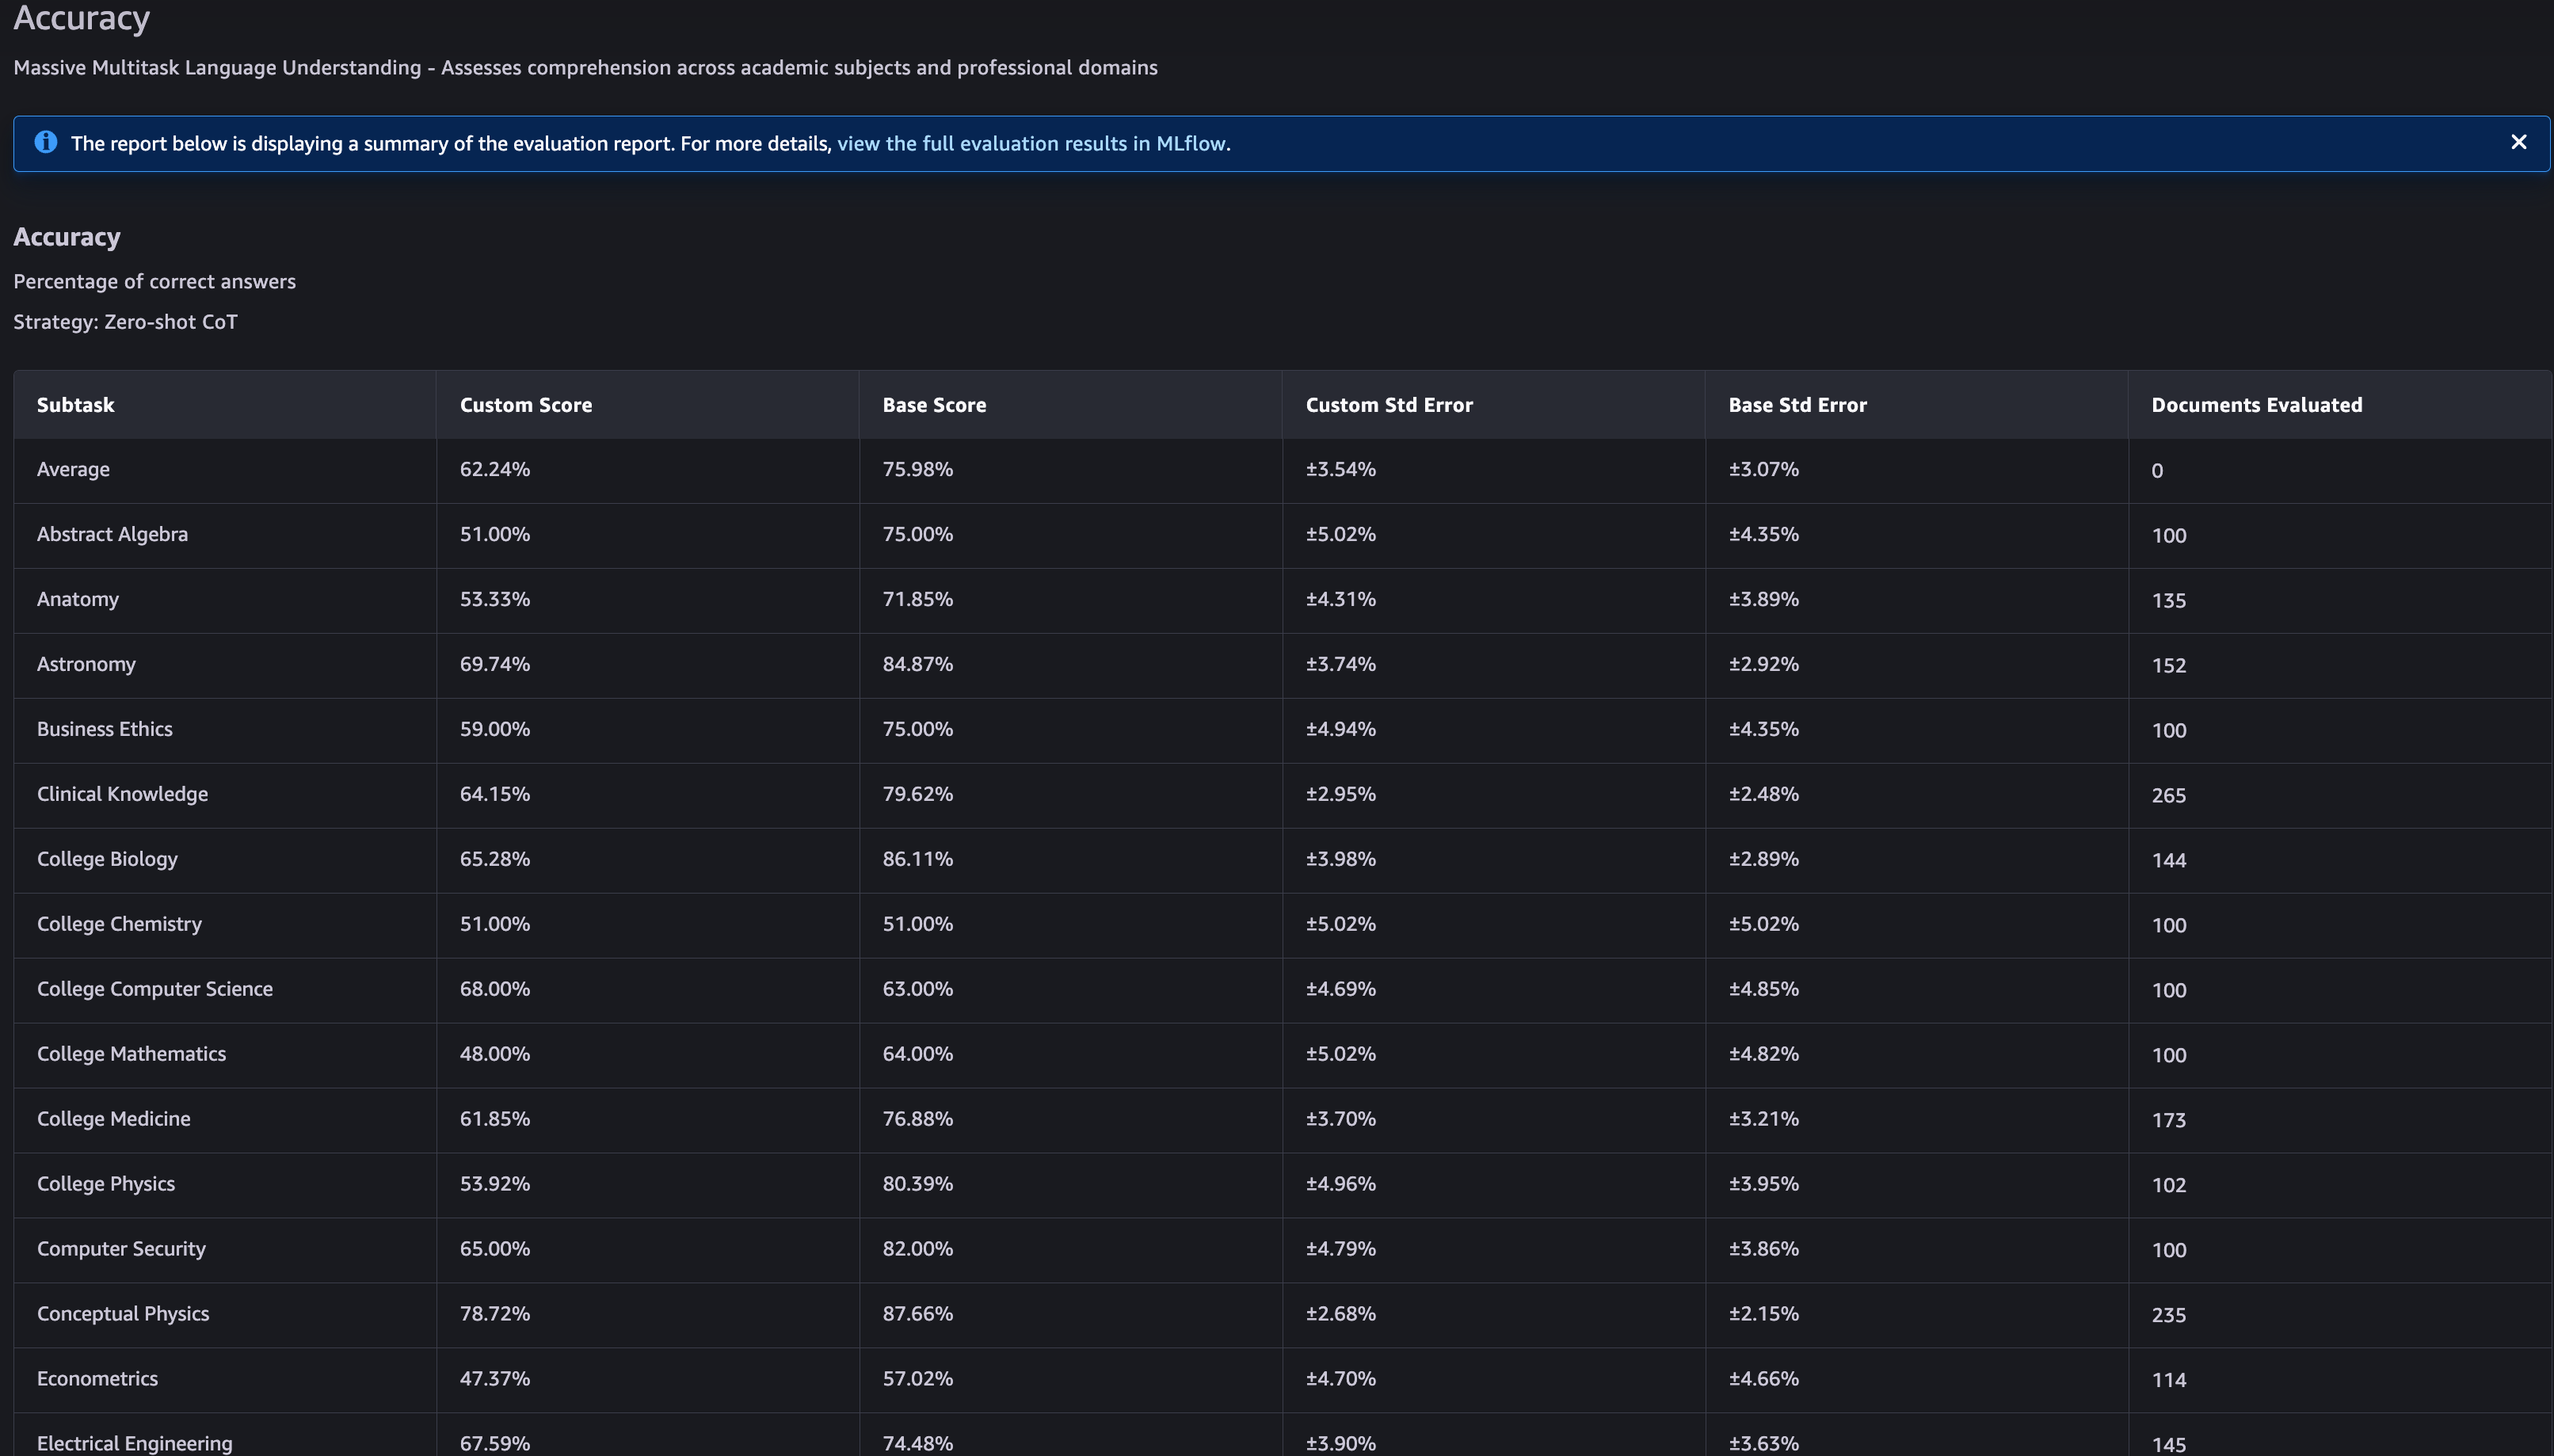
图 8:微调前后的 MMLU 准确率
大规模快速实验
SageMaker AI Serverless Model Customization 的设置和使用非常简便,使我们无需重新配置基础设施即可快速进行实验。我们在 LoRA 和 FFT 之间切换训练类型,扫描超参数,并在多个基础模型上测试。在很短的时间窗口内,我们在多个受支持的基础模型(Qwen3-4B、DeepSeek-R1-1.5B、Nemotron-30B、Gemma-4-26B)上运行了数十次模型定制实验,系统地消融了学习率、批大小、warmup 比例、epoch 数和数据集规模。每个实验从提交作业到获得评估结果都在几小时内完成,生成的微调模型会自动作为带版本的 Model Packages 注册到 SageMaker Model Registry 中,可供审核或部署。
超参数选项
SageMaker AI Serverless Model Customization 支持许多超参数。在本节中,我们结合此前代码生成任务中在多种超参数配置下运行的一系列实验,解释其中几个重要的超参数。虽然有效取值会因任务而异,但在这些实验中观察到的模式可为配置 FFT 模型定制作业提供有用的起点。有关在启动 FFT 模型定制作业之前可以配置的超参数的更多信息,请参阅超参数文档页面。
1. learning_rate
在全量微调中,学习率控制每个权重被更新的激进程度。与只改变小型适配器矩阵的 LoRA 不同,过高的 FFT 学习率会永久覆盖预训练知识。在我们的实验中,下面的 LR × 数据集规模风险图显示,在大型数据集(超过 100K)上使用 2e-5 的 LR 属于安全区。
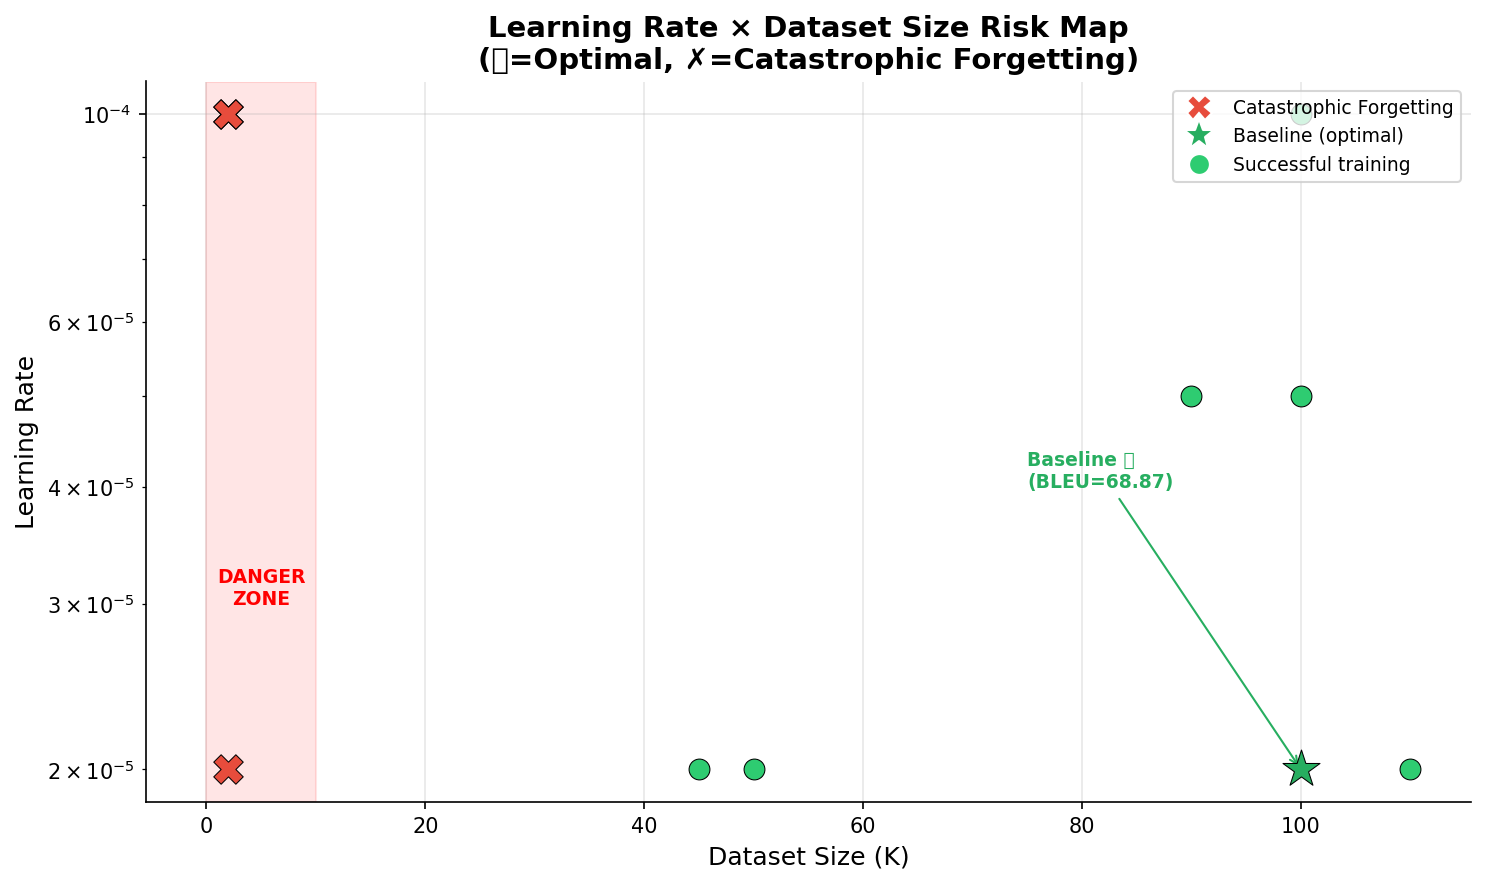
图 9:全量微调的学习率与数据集规模风险图
2. max_epochs
在 FFT 中,epoch 数本质上是一个遗忘问题,而不是损失曲线问题。训练损失会持续下降,留出验证集看起来也会很正常,因为它与训练数据共享同一分布,但模型在未训练过的所有内容上的能力会悄然退化。在 3 个 epoch 时,LLM-as-Judge 正确率升至 90.0%,而超过 3 个 epoch 后,我们实验过的每个变体都出现了退化。
3. global_batch_size
批大小决定每个梯度步有多少样本参与贡献。在固定学习率下,较小的批次会产生更多噪声更新,其表现很像更高的学习率,从而增加遗忘风险。较大的批次会降低噪声,但也会减少优化步数,可能导致欠拟合。
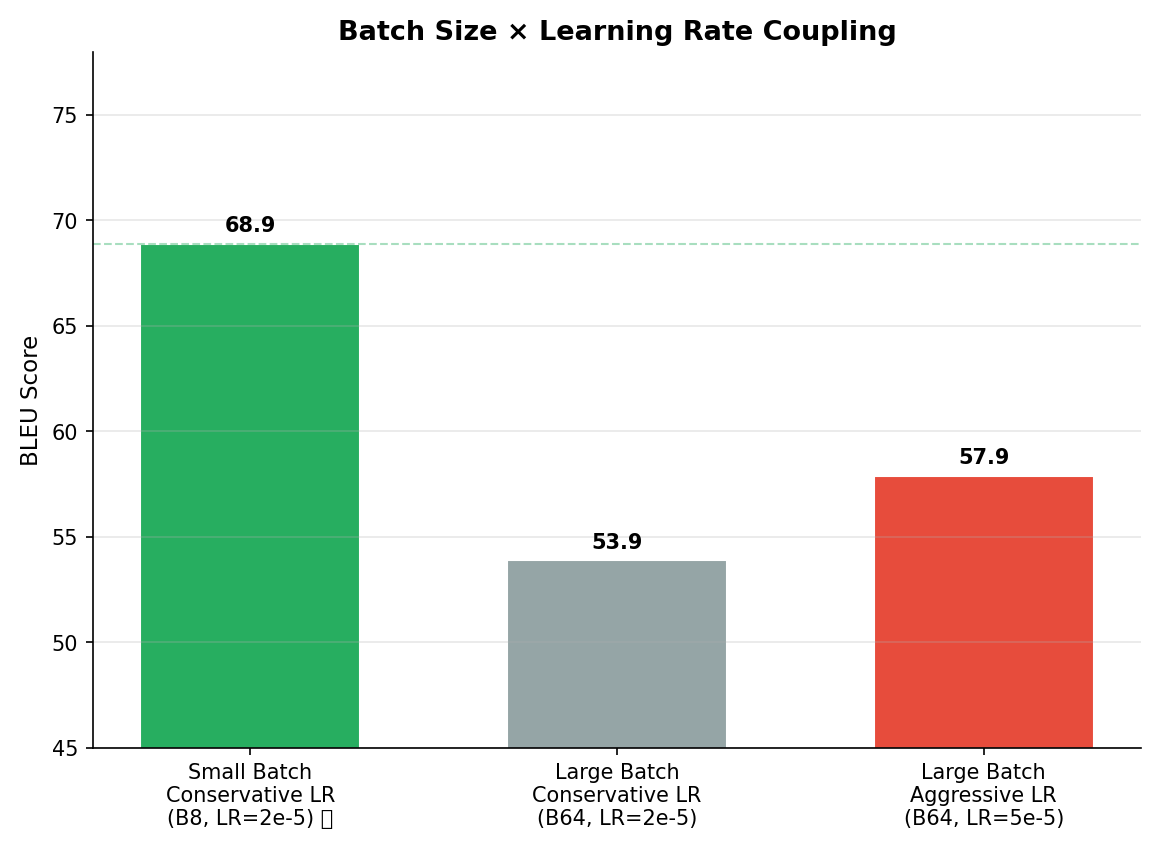
图 10:全局批大小对模型质量的影响
灾难性遗忘风险
FFT 会修改模型中的每个参数,包括编码预训练期间获得的通用知识的参数。当微调将这些参数过于激进地推向狭窄领域时,模型可能会“忘记”其更广泛的能力,这一现象称为灾难性遗忘。我们使用 MMLU 系统地测试了这一点,衡量了所有微调配置下的通用知识保留情况。如下图所示,warmup=5%、批大小为 8、LR=2e-5 的基线配置最好地保留了通用知识(MMLU)。
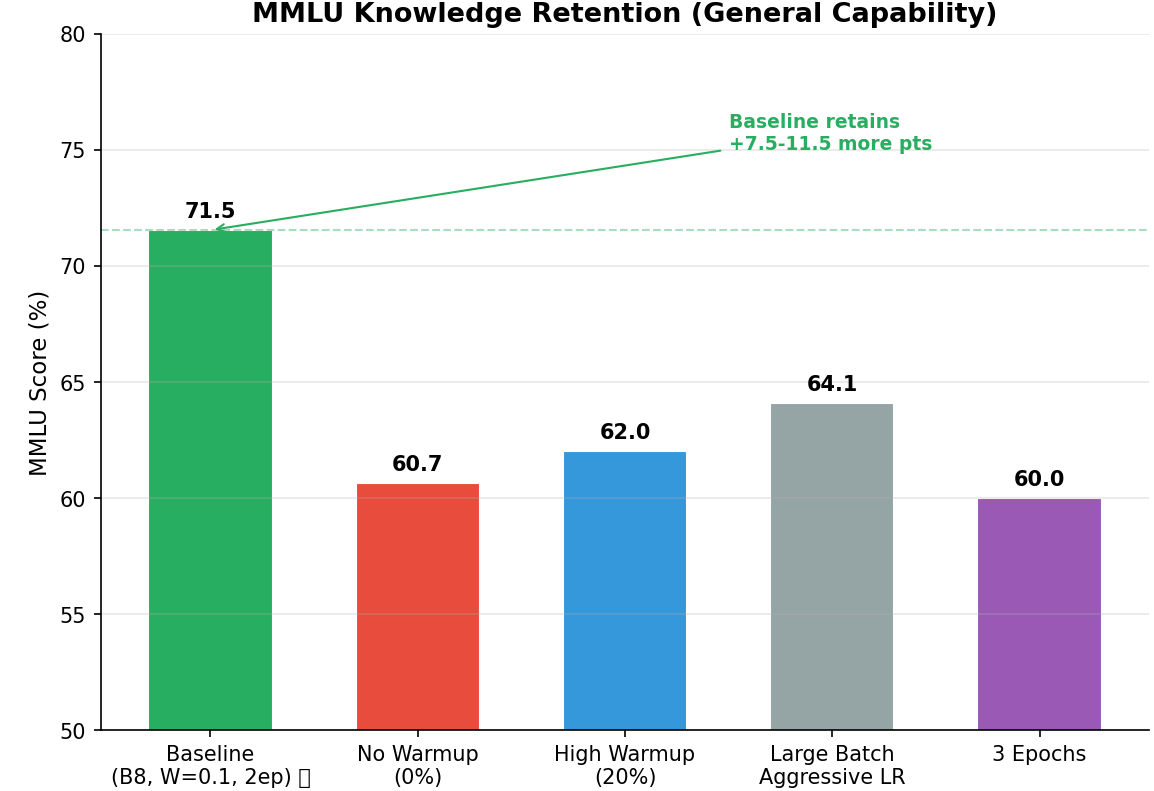
图 11:跨超参数配置的 MMLU 通用知识保留情况
因此,需要注意的是,FFT 并非普遍优于 LoRA,其有效性对超参数选择极其敏感。例如,在我们的实验中,FFT 和 LoRA 在 MATH 精确匹配上都逊于基座模型,凸显了在领域特定微调期间保持推理能力的挑战。FFT 中激进的学习率(LR ≥ 5e-5)被证明尤其具有破坏性,导致 MATH 分数骤降至 2–3%,MMLU 准确率降至 3.6%,这是灾难性遗忘的明确证据。此外,LoRA 在 LLM-as-Judge 指标上略优于 FFT(81.5% 对 79.5%),表明参数高效方法在主观质量评估上仍可占据优势。这些发现进一步表明,FFT 与 LoRA 之间的选择应以仔细实验、数据集特征以及对相关权衡的清晰理解为指导。
结论
借助 Amazon SageMaker AI Serverless Model Customization 上的 Full Fine-Tuning,当任务复杂度和数据规模有要求时,你的模型可以充分吸收领域特定知识。如果你的用例需要深度适配,例如专门化推理、代码生成或领域特定语言理解,并且你拥有足够的高质量训练数据,那么 FFT 能带来可衡量的更强结果。
你可以通过无服务器训练、内置评估,并且无需基础设施或计算容量规划,开始在 SageMaker AI Serverless Model Customization 上使用 FFT,从而专注于数据和超参数选择。你可以使用 SageMaker Python SDK 以编程方式配置并启动训练和评估作业。你可以查看文档,了解 Serverless Model Customization 上 Full Fine-Tuning 所支持的基础模型。