 Newshot
为 AI agent 提供业务上下文——有用吗?省钱吗?我们来验证一下
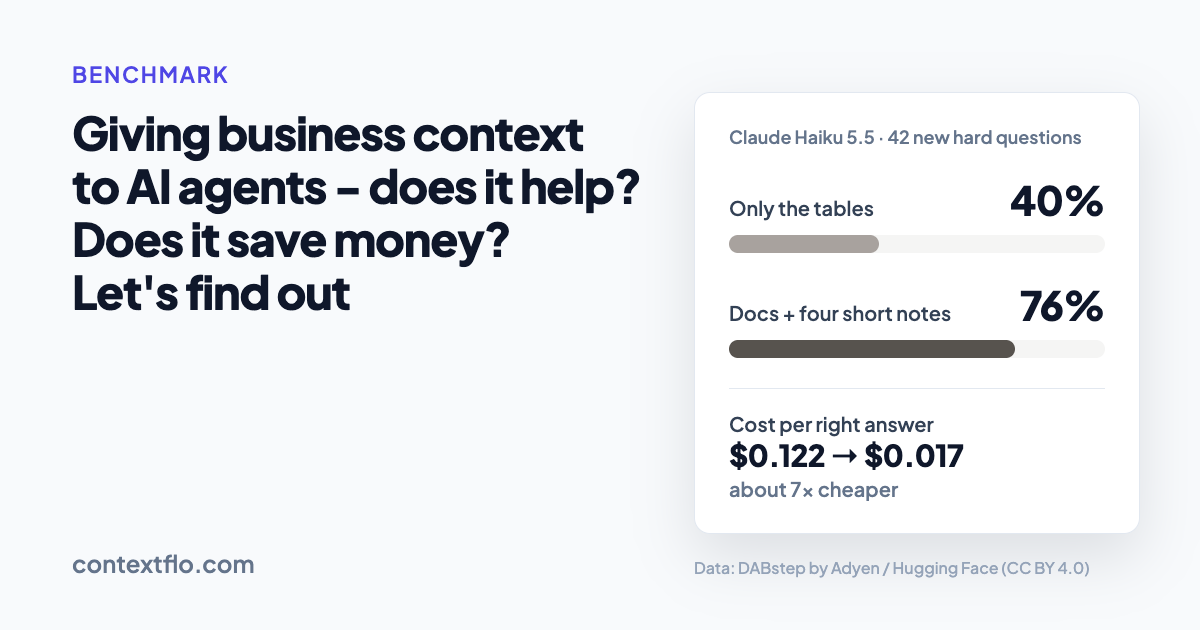
我们用 Adyen 和 Hugging Face 构建的一个贴近真实的支付数据集,让同一个 AI agent 分别在有无上下文的情况下运行。
更新于 2026 年 11 月 16 日
- 要点
- 基准设置
- 为什么选这个数据集
- 数据集包含什么
- 问题
- 我们如何运行
- 探索阶段的结果(25 个问题)
- 仅靠文档:准确率相同,成本更低
- 那四条笔记
- 上下文何时会让结果变差
- 我们的第一个数字是错的
- 在新问题上测试
- 仍然存在的问题
- 成本如何
- 如果你要在自己的公司做这件事
要点
给 AI agent 提供公司文档,并不比什么都不给更好:没有文档时正确率为 40%,有文档时为 36%。真正起作用的是四条简短笔记,就像老同事给新人的那种提醒。它们把正确率提升到了 76%,而每个答案的成本大约只有原来的四分之一。如果你的公司有文档,很可能也存在同样的缺口。真正能回答问题的规则,活在人们的脑子里。
基准设置
我们让一个 Claude Haiku 5.5 agent 在一个模拟支付公司的公开测试数据集上运行,数据真实而杂乱,并对比了有无上下文(公司文档,加上我们写的笔记)的情况。
| 模型 | Claude Haiku 5.5 |
|---|---|
| 数据集 | DABstep,由 Adyen 和 Hugging Face 构建 |
| 探索 | 25 个难题,由脚本按固定规则挑选 |
| 测试集 | 42 个新问题,混合了多种问题类型 |
| 对比的设置 | 仅数据表、+ 公司文档、+ 文档和探索中写出的四条笔记 |
| 尝试次数 | 每个问题 3 次,每种设置下都如此 |
我们先通过一小组难题来探索数据。不出所料,agent 仅凭数据表表现很差,而文档也没有让它变好。于是我们读了它的错误答案,写下了那四条笔记。
然后我们冻结了这些笔记,在一组全新的、笔记并非从中提炼的问题上测试,问题类型更广,其中有些比其他更容易。要点中的数字来自那次测试。
你不需要了解支付领域的知识也能看懂。支付只是任何公司数据的一个替身:数据表、一些文档,以及只有团队才知道的规则。
为什么选这个数据集
大多数 AI 测试用的是干净、虚构的谜题。真实的公司数据不是这样。它有一份没人完全理解的价格表,有大部分正确但并非全对的文档,还有那些“大家都知道”的事情。
DABstep 是由大型支付公司 Adyen 和 Hugging Face 构建的公开测试。它描述了一家虚构的公司,数据真实,混乱也真实。问题都是财务或运营负责人会问的那种。正确答案是保密的,所以没人能作弊。
我们把数据原封不动地加载进了一个数据库(BigQuery)。没有清洗,没有重命名。
数据集包含什么
想象一家为网店处理银行卡支付的公司。购物者用卡支付,公司对每笔支付向店铺收取一小笔费用。
| 表 | 通俗解释 | 行数 |
|---|---|---|
| payments | 2023 年的每一笔银行卡支付:哪家店、金额多少、哪张卡、购物者如何支付,以及最终是否被判定为欺诈 | 138,236 |
| fees | 价格表:每种支付方式对店铺的收费 | 1,000 |
| merchant_data | 30 家店铺:它们卖什么,账户如何设置 | 30 |
| 两张小型查找表 | 店铺类别和国家 | 小 |
店铺的名字是虚构的,比如 Rafa_AI、Crossfit_Hanna 和 Golfclub_Baron_Friso。卡品牌也是虚构的:GlobalCard、NexPay、TransactPlus、SwiftCharge。
这家公司还附带两份文档:一份关于费用和欺诈如何运作的手册,以及一份 payments 表指南。它们是不错的文档。在有文档的设置中,agent 会按原样获得全部内容:
- 表和列的含义:全部五张表及其大部分列。
- 手册中的七条业务规则:费用如何计算(固定金额加百分比)、价格行中的空白(null)表示“任意”、月度交易量和欺诈按自然月统计,以及本地支付、账户类型、支付方式和捕获延迟分别是什么意思。
这是真实的业务背景,不只是数据库结构。提供给 agent 的所有内容都在 GitHub 上。
价目表的挑战
价目表有 1,000 行。每一行描述一种支付方式及其费用,就像运费费率表里的一行(“2 公斤以下,寄往欧洲,快递:12 欧元”)。
下面是一行数据,与它在数据中的原始形态完全一致:
Loading code sample...
用大白话说:在 TransactPlus 上,在八类商户之一的一家店里,用两种支付方式之一(C 或 B)完成的借记卡支付,费用是 10 美分加上金额的 0.19%。
要给一笔支付定价,你需要找到描述它的那些行,并使用它们的价格。不过要注意那些空白([] 和 null)。它们是什么意思?数据没有说明,手册也只覆盖了两者中的一个。先记住这一点。
问题
测试有 450 道题。我们分两轮使用:一轮是 25 道难题的探索轮,我们阅读错误答案并据此撰写短记;另一轮是 42 道新的难题的留出测试,短记从未见过这些题(详见下文)。
两组题目都不是手工挑选的。一个脚本用固定规则挑选了两组题(不选答案为“不适用”的题,混合多种题型),因此任何人都可以重新运行它并得到相同的题目。每道题都有唯一正确答案:一个数字、一个字母或一个简短列表。举几个用大白话说的问题:
- “如果我们改变这一个价格,Rafa_AI 在七月份会多付还是少付多少?”
- “对于 GlobalCard 上的一笔 10 欧元信用卡支付,哪种支付方式最贵?”
- “如果 Rafa_AI 让它的欺诈购物者改用另一种支付方式,哪种方式的成本最低?”
每家企业都会就自己的数字问这类问题:这花了多少、如果我们改变那个会怎样、我们应该把客户引导到哪里。
我们如何运行
- 每次都是同一个 agent。相同的模型、指令和工具。agent 通过 Contextflo 连接数据库,这使它能够看到表、读取我们提供的任何短记,并运行查询。它不能更改任何内容。
- 在探索阶段,一次只加一条短记。六种设置:只有表,然后加文档,然后依次加入每条短记,这样你可以看到每一条的作用(每种设置 75 个答案)。
- 每次尝试都从头开始,不保留上一次的记忆。
- 每次运行都公开,包括错误的那些。
探索阶段的结果(25 道题)
| agent 拥有的内容 | 3 次尝试全部答对的题数 | 答对的尝试次数 | 每次尝试成本 |
|---|---|---|---|
| 只有表 | 25 道中 3 道 | 75 次中 14 次(19%) | 约 6 美分 |
| + 公司的文档 | 25 道中 3 道 | 75 次中 12 次(16%) | 约 2 美分 |
| + 短记 1:空白表示“任意” | 25 道中 7 道 | 75 次中 23 次(31%) | 约 3.5 美分 |
| + 短记 2:把所有适用的价格加起来 | 25 道中 14 道 | 75 次中 44 次(59%) | 约 1.5 美分 |
| + 短记 3:“月度”指自然月 | 25 道中 13 道 | 75 次中 45 次(60%) | 约 1.4 美分 |
| + 短记 4:如何回答“哪个最便宜” | 25 道中 14 道 | 75 次中 47 次(63%) | 约 1.2 美分 |
如何解读:共有 25 道题,每道尝试 3 次。百分比统计的是尝试次数,不是题目数。这 3 次尝试显示 agent 是否可重复,因此它们不算作 75 次独立测试。第一列是更严格的衡量标准。
如何评分:如果有人向官方记分板提交了完全相同的答案,我们采用记分板的判定。否则,我们对照一份从记分板重建的答案表进行严格检查(真实答案是保密的)。详见下文。
成本是 AI 模型每次尝试收取的费用。数据库账单在下面进一步说明。
仅加文档:准确率相同,成本更低
添加手册没有改变准确率。19% 对 16% 的差异太小,在这么多题目的情况下不算数。但它确实把每道题的成本削减了约三分之二。
文章标题:Show HN:公司文档没能帮到我们的 AI agent,四则短记让准确率翻倍
正文: 没有文档时,agent 把大部分精力花在琢磨各列到底是什么意思上,一遍遍跑查询去猜。有了文档,它不再猜数据是什么。但它仍然不知道业务是怎么使用这些数据的。知道一列是什么意思,并不等于知道该怎么回答那个问题。
四则短记
每一则都来自阅读 agent 的错误答案,并追问:队友会告诉它什么?其中两则补充了文档里没有的内容。另外两则澄清了文档已经写明的内容,因为 agent 拿到了规则却仍然答错了。
| 短记 | 新增还是澄清? |
|---|---|
| 1. 空白表示“任意” | 澄清。手册提到了 null,但没提到价目表同样使用的空列表 [] |
| 2. 把所有适用的价格都加起来 | 新增。文档从未说明一笔付款可以匹配多个价格 |
| 3. “月度”指日历月 | 澄清。手册里说了;这则短记给出了确切的步骤 |
| 4. 如何回答“哪个最便宜” | 新增。针对某一类问题的操作指南,而不是业务规则 |
空白表示“没有”还是“任意”?
价格行里的空白表示“任意”。卡类型为空白表示任意卡,而不是没有卡。
这一则澄清了手册。手册说了这一点,但只针对 null。卡类型、店铺类别和支付方式这几列从不为 null:它们用空列表 [] 表示“任意”。这则短记把两种情况都讲清楚了。
没有这则短记,agent 把空白读成“不适用”,于是忽略了价目表的大部分内容,算出的费用过低。有了它,准确率从 16% 提升到 31%。
在你们公司:一个结束日期为空的订阅。它是已取消,还是永不结束?团队里每个人都知道。但表里没写。
一个价格,还是全部?
一笔付款可以匹配价目表的多个行,并且它要为所有这些行付款。
这一则是新增的。手册解释了单行价格如何计算,但从未说明一笔付款可以匹配多个行。
没有这则短记,agent 找到一个匹配行就停下了。这就像餐厅向一桌客人收取了服务费,却忘了同样适用的大团体费。有了它,准确率从 31% 提升到 59%,是最大的一次跃升,而且运行速度快了约 40%,因为 agent 不再兜圈子了。
在你们公司:一个部分退款的订单还算收入吗?一个拥有两个折扣的客户能同时享受两个折扣吗?一句话,几乎每个数字都会变。
“月度”指哪个月?
有些价格取决于店铺那个月卖了多少,比如批量折扣。“月”指一月、二月等等,而不是最近 30 天,而且你算的是金额,不是付款笔数。
这一则澄清了手册,手册里本来就这么说。我们用确切的步骤重述了一遍,确保不会被误读。准确率几乎没变(59% 到 60%),但运行成本降低了。
在你们公司:月度收入是日历月还是最近 30 天?“活跃用户”是按天还是按周计算?
如何回答“哪个选项最便宜?”
对于“如果我们把购物者转到另一种支付方式,哪个最便宜”这类问题,要基于店铺的实际付款逐项计算。
这一则是新增的,它更像是“如何回答这类问题”,而不是关于业务的事实。这是我们最接近直接给出答案的一次,而它带来的提升(60% 到 63%)太小,不算数。我们保留了它,并在此标注出来。
当上下文反而帮倒忙
短记 2(“一笔付款支付所有适用的价格”)对几乎每个问题都正确,但有一个问题是例外。
加入这则短记之前,agent 在“一笔 10 欧元 GlobalCard 付款最贵的支付方式”这个问题上,3 次全部答对。加入之后,3 次全错。在工作日志里,agent 算出了正确答案,然后又改成遵循短记。
agent 相信你告诉它的内容,胜过相信自己的推理。一则过于宽泛的短记可能弄坏原本能正常工作的东西。把这些短记当作代码来对待:审查它们、测试它们,并观察发生了什么变化。
我们的第一个数字是错的
文章标题:Show HN: 公司文档没帮到我们的 AI agent,四条短注让准确率翻倍
正文: 我们最初的评分显示 77%。这太宽松了。
正确答案是保密的,所以我们根据公开排行榜自己造了一份答案表:如果有很多人提交了某个答案,并且它被标记为正确,我们就把它算作正确。这份答案表在“他们愿意多付多少”这类问题上太过宽容。它接受了 -9.4166,而真实答案是 -9.42,官方评分会把它判错。
于是,我们把全部 450 次尝试(6 种设置,每种 75 次)逐一对照官方排行榜对那个确切答案的标记——只要之前有人提交过。按这种检查:
- 每种设置的得分都下降了大体相同的幅度
- 短注带来的提升依然成立(从 16% 到 63%)
- 主要数字是 63%,不是 77%
那些“愿意多付多少”的问题中,有几个在每种设置下都以同样的方式出错。这说明存在一条我们还没写短注的规则。
在新问题上测试
这些短注来自对这同样 25 道题的错误答案的阅读。合理的问题是:我们是不是只是教会了它这 25 道题?
所以我们做了一次留出测试。在运行任何东西之前,我们冻结了短注、文档、指令和评分规则。一个脚本挑选了 42 道新的难题:从测试的 14 种题型中各取 3 道。其中十种题型在探索阶段出现过;四种从未出现。同一个 agent,每种设置 3 次尝试,共三种设置。
| agent 拥有的内容 | 3 次尝试全对的题数 | 答对的尝试次数 | 每次尝试成本 |
|---|---|---|---|
| 只有表格 | 42 道中 13 道 | 126 次中 50 次(40%) | 约 5 美分 |
| + 公司文档 | 42 道中 9 道 | 126 次中 45 次(36%) | 约 1.6 美分 |
| + 四条短注 | 42 道中 31 道 | 126 次中 96 次(76%) | 约 1.3 美分 |
评分方式与探索阶段相同。大多数答案之前已经有人提交到官方排行榜,所以我们采用它的标记。其余从未提交过,所以我们对照重建的答案表检查:只有表格时 126 次尝试中有 12 次,有文档时 19 次,有文档和短注时 2 次。即使我们把这些全部判错,结论依然成立:文档和短注仍然至少有 126 次中 94 次正确,而只有表格时最多 62 次,有文档时最多 64 次。
提升依然成立,而且比探索阶段更大。文档再次没有帮助提高准确率,但降低了成本。短注几乎让正确回答翻倍。
按题型拆分:
| agent 拥有的内容 | 探索阶段出现的题型(30 道题) | 从未见过的题型(12 道题) |
|---|---|---|
| 只有表格 | 26% | 75% |
| + 公司文档 | 26% | 61% |
| + 四条短注 | 70% | 92% |
这四种新题型反而更容易,因为 agent 只靠表格就答对了其中 75%。大部分提升来自熟悉的题型:同类问题,但店铺、月份和金额是短注从未见过的。一条短注就是一条规则,所以它对同类的下一道题也有效。
仍然出错的地方
在留出测试中,有文档和短注时,42 道题里有 11 道并非每次尝试都正确。它们分成几组:
- “如果这个价格变了,他们愿意多付多少”(2 道题):每种设置、每次尝试都错。我们在探索阶段也看到了同样的情况。这是四条短注都还没覆盖的东西。
- “把欺诈购物者转移到另一种支付方式”(3 道题):每种设置、每次尝试都错。短注 4 本是为这类问题准备的,但它不够。
- “一般来说,最贵的品类/支付方式是什么”(4 道题):短注让其中两道变得更糟。一道在有文档时从 3 次中 2 次正确变成 3 次中 0 次,另一道从 3 次中 2 次变成 3 次中 0 次。这和探索阶段出问题的是同一类问题(见上文):那条关于把每个价格加总的短注对大多数问题是对的,但对“一般来说”的问题不对。
- 另外两道在加入文档后略有下滑,短注也没能挽回:只有表格时 3 次中 3 次正确,之后 3 次中 2 次;以及 3 次中 1 次,然后 3 次中 0 次。
文章标题:Show HN: Company docs didn't help our AI agent. Four shortnotes doubled accuracy
正文: 我们有意停在四条笔记。要把最后三分之一做对,就意味着把答案写进笔记里,那是在作弊应付测试,而不是在帮助 agent。
成本是多少
每个问题都带来两张账单:AI 模型和数据库。
- AI 模型:没有任何资料时每题约 5 到 6 美分,有了文档和笔记后降到约 1 美分。按每个正确答案算,在留出测试集上:只有表时 12 美分,有文档和笔记时不到 2 美分。
- 数据库:我们测量了 BigQuery 对每次查询的计费。在留出测试集上,每次尝试平均约 43 MB(只有表)、51 MB(有文档)、33 MB(有文档和笔记)。在这个小数据集上只是不到一美分的零头。有了笔记,agent 跑的探索性查询更少,读取的数据最少。我们没有测试更大的数据库,所以不声称这在更大规模上如何变化。
如果你要在自己公司做这件事
你的文档说明数据是什么。回答问题的规则活在人们脑子里,所以要先把这些写下来。从 agent 的错误答案入手:每一个都指向某件没人写下来的东西。像审查代码一样审查笔记。好的笔记能让你得到更多正确答案和更小的账单。
凭据
每个留出问题和每次尝试都紧贴本文下方:agent 跑了什么、返回了什么、每个答案如何被标记。完整未删减的运行、代码、笔记以及如何重跑都在 GitHub 上。
- 数据:来自 Adyen 和 Hugging Face 的 DABstep,可自由复用(CC BY 4.0),按原样加载。
- 模型:Claude Haiku 5.5,每种设置下都相同。
- 问题:25 道用于探索的难题,由脚本按固定规则挑选:仅难题,没有“不适用”或空答案,只选许多排行榜提交对答案一致的问题,按题型分布。另有 42 道用于留出测试,同样方式挑选,14 种题型各 3 道,与探索题不重叠。
- 在留出测试前冻结:笔记、文档、指令、工具、模型、问题列表和评分规则,各由文件哈希固定。我们在每批开始和结束时对 agent 能看到的一切做了快照,结果一致。
- 评分:官方排行榜对每个存在确切答案的标记,否则对照我们的答案表做严格检查。