 Newshot
教会 PacketSnitch 使用自己的文档:构建一个小型 AI 工具路由器
2026 年 11 月 18 日 · Marshall Whittaker
问题
在开发 PacketSnitch 的过程中,我遇到的一个比较有意思的问题,是如何让用户用自然语言与应用程序交互,然后把该请求转化为应用程序知道如何执行的实际操作。
这乍听起来相当直接。给 AI 模型一组工具,描述这些工具做什么,让它决定调用哪一个。对吧?
嗯,并不完全是。
问题在于,随着应用程序增长,你能要求它做的事情也越来越多。你最终会得到一个越来越庞大的函数、参数、实参集合,以及对每个操作如何执行的非常具体的要求。你可以把这一切都塞进一个提示词里,但最终你会遇到上下文限制、工具选择不一致,以及模型能力根本不足以可靠地判断你让它做什么。
而且如果你在本地运行一切,你还必须考虑你期望用户拥有的硬件。
我并不特别想仅仅为了让人能就自己的抓包向 PacketSnitch 提问,就要求大量语言模型、专用 GPU 或云服务提供商。
所以我开始以稍微不同的方式看待这个问题。
搜索引擎已经在做类似的事情
有意思的是,我想出的解决方案基于我在 PacketSnitch 其他地方已经实现过的功能:网站上的搜索功能。
网站搜索的工作方式是,它接收用户的搜索词,识别相关关键词,并用这些关键词从索引集合中找到合适的文档和信息。
我意识到,我基本上可以把同样的概念应用到 AI 集成上。
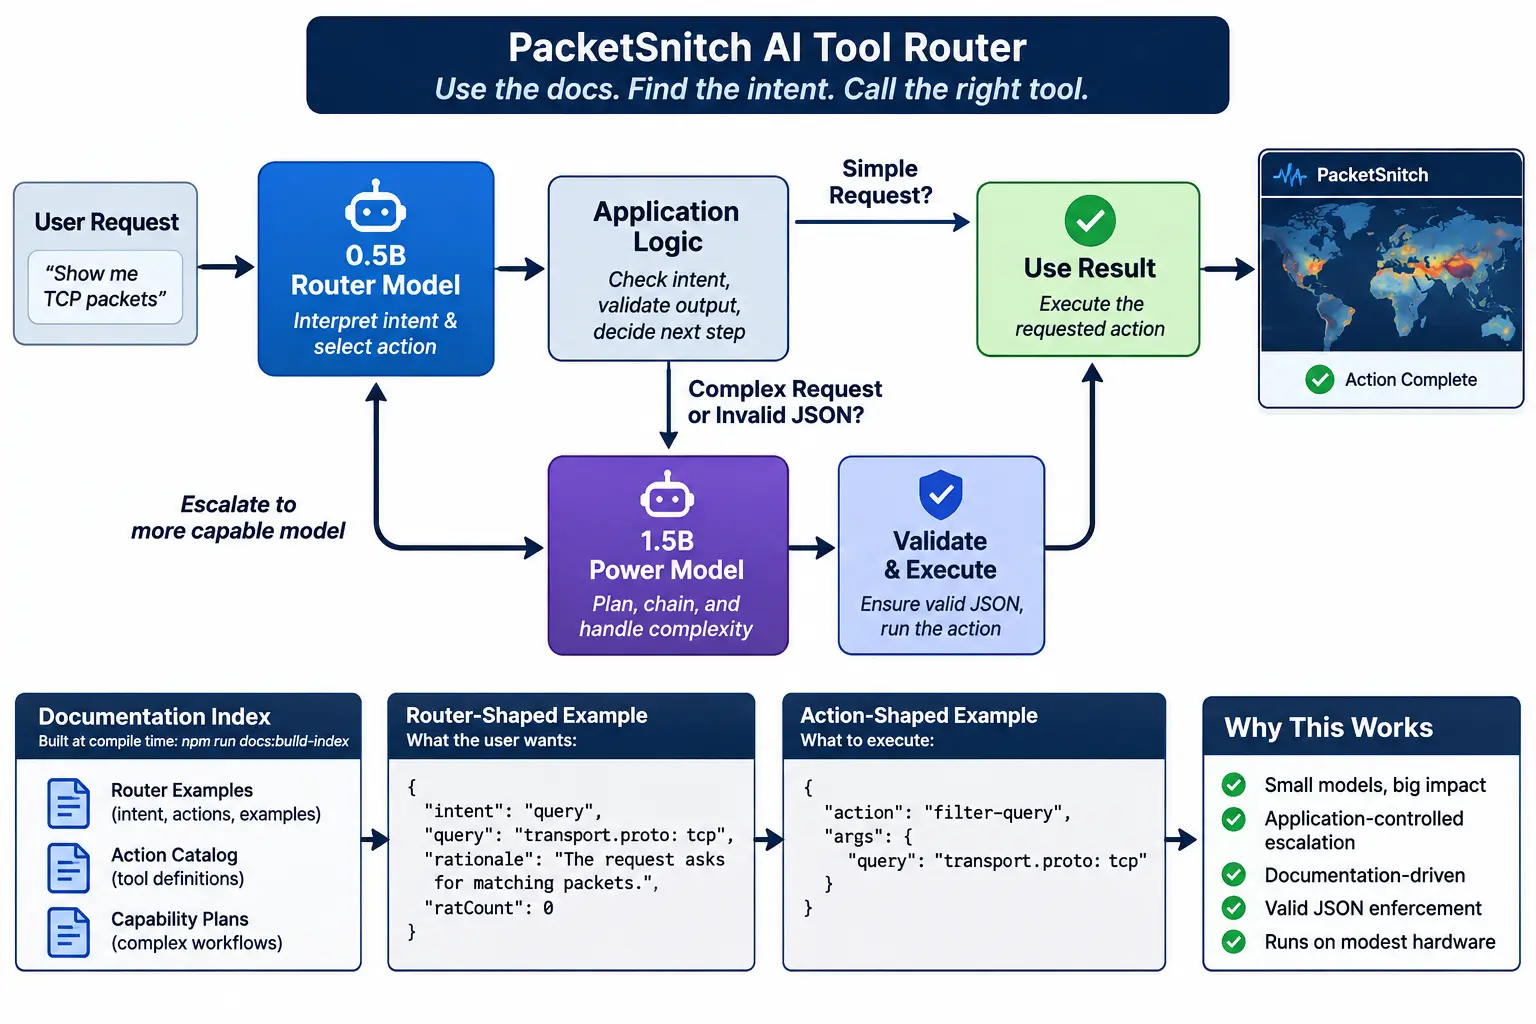
与其教 AI 模型如何使用 PacketSnitch 中的每一个单独函数,我可以教它识别用户想要完成什么、对意图进行分类,然后查找执行该任务的合适说明。
换句话说,AI 其实不需要知道如何做所有事情。
它需要知道去哪里找。
构建操作语料库
第一部分是创建一个结构化的操作集合,供 AI 参考。这些操作关联着文档和说明,准确解释它们应如何执行。
这些文档索引在构建时使用以下命令预生成:
npm run docs:build-index
这会生成结构化的文档和示例,AI 在确定如何满足请求时可以参考它们。
我没有把整个应用程序的文档全部塞进模型上下文,而是使用传入提示词的关键词,按需生成一组相关的操作类别。
然后模型解释用户请求,并确定哪一类操作最合适。
这里有一个重要的区别:路由器预期输出的内容,与实际应用程序需要执行的内容并不相同。
例如,路由器可能收到文档,说明查找匹配数据包的请求应使用 query intent,而应用过滤器需要 filter-query 操作,并带有一个名为 query 的实参。
一个路由器形态的示例如下:
        {
  "intent": "query",
  "query": "transport.proto: tcp",
  "rationale": "该请求要求查找匹配的数据包,因此这是一个过滤查询。",
  "ratCount": 0
}
对应的操作形态表示如下:
        {
  "action": "filter-query",
  "args": {
    "query": "transport.proto: tcp"
  }
}
这是两种不同的表示方式,服务于两种不同的目的。
第一种描述的是用户想要完成的事情。第二种描述的是应用需要执行的操作。
模型将文档作为参考,来理解两者之间的关系,但并不一定只是把一种 JSON 结构复制成另一种。
它需要处理用户提供的任意数据、应用上下文,有时还需要额外的规划,才能构造出最终的动作。
当处理更复杂的请求时,这一点尤其重要——用户可能希望把多个操作合并到一个任务中。
例如,一项能力可以表示为一个包含 capability 步骤的计划:
        {
  "intent": "plan",
  "steps": [
    {
      "action": "capability",
      "id": "stats.places.search",
      "args": {
        "query": "Hangzhou"
      }
    }
  ],
  "rationale": "The request asks for one registered capability.",
  "ratCount": 0
}
文档为模型提供了构造这些操作所需的信息,而模型本身负责解释请求并生成相应的 JSON。
这是一个重要的区别,因为模型并不需要记住应用的整个 API、理解代码库中的每一个函数,或者为所请求的操作发明自己的实现。
它实际上充当的是一个路由器和分类器,把用户的意图连接到一组有文档记录的能力上。
实际执行由应用负责。
一个小模型,配上由应用控制的升级路径
这个实现的另一个有趣之处在于,我实际上并不需要一个特别大的模型来完成这些事。
我使用一个 0.5B 参数的模型作为初始路由器。它处理那些意图相对明显、无需太多额外推理就能确定适当动作的简单请求。
对于更复杂的请求,则有一条升级路径,交给一个 1.5B 参数的模型。
这里有一个微妙但重要的区别:0.5B 模型并不判断自己是否足够聪明来处理某个请求。这个决定由外围的应用逻辑做出。
PacketSnitch 会评估较小模型识别出的意图,并判断该请求是否落在快速路由系统的能力范围内。
例如,让 PacketSnitch 显示 TCP 数据包是一个相对简单的操作。路由器可以识别意图、查找适当的动作,并生成必要的 JSON。
而让 PacketSnitch 调出热力图上的某个特定位置,并且只显示它与另一个已被过滤的主机之间的交互,那就是另一回事了。
这涉及多份应用上下文、可能需要多个操作,还需要一些超出我对 0.5B 模型合理预期的规划。
在这种情况下,应用会把请求升级给能力更强的模型。
此外还有一层额外的验证机制。这些模型经过训练,能够生成有效的 JSON;如果较小的模型产出的输出不符合预期要求,就会被拒绝并自动升级。
这意味着我并不依赖较小的模型去认识自身的局限,或者判断自己是否应该求助。
这个过程由应用控制。
随后,1.5B 模型能够处理更复杂的请求,包括规划操作、融入应用上下文,以及把多个意图串联起来,以完成那些难以表示为单一直观工具调用的事情。
这给我带来了两个优势。
首先,大多数请求都可以由一个极小的模型来处理,这种模型在本地运行要容易得多。其次,更复杂的请求仍然可以交给一个容量稍大的模型,由它来解读用户意图并查阅可用的文档。
我不需要因为一小部分请求可能需要更多推理,就对每一个请求都动用大模型。
训练路由器
让架构跑通是一回事。让这么小的模型真正识别出足够多不同的用户意图、从而可靠地选出正确的操作,则是另一回事。
为了把最初的 0.5B 路由器调到理想状态,我最终进行了五轮训练,随后又在完善配置和训练数据的过程中做了六次重新训练迭代。
我使用的基础模型是:
- Qwen/Qwen2.5-0.5B-Instruct
- unsloth/Qwen2.5-1.5B-Instruct
这个过程里比较令人沮丧的一点是,我发现先前试验过的一套训练配置从根本上就是有问题的。训练出来的模型效果很糟,而且当时并不能立刻看出问题出在训练栈本身,而不是数据或模型。
一旦确定了这一点,我就把当时使用的确切配置固定下来,不再做不必要的变量改动。
最终的训练环境是这样的:
        torch==2.11.0+cu128
unsloth==2026.11.4
unsloth_zoo==2026.11.4
transformers==4.57.6
trl==0.29.1
peft==0.21.3
bitsandbytes==0.50.2
datasets==4.8.5
accelerate==1.15.0
huggingface-hub==0.36.2
safetensors==0.8.0
fsspec==2026.2.0
sentencepiece==0.2.3
protobuf==4.25.9
gguf==0.19.0
pyyaml==6.0.3
xformers==0.0.36
在安装完依赖之后,我还针对 CUDA 12.8 的索引强制重新安装了对应版本的 PyTorch 构建,以确保环境使用的正是我想要的那个版本。
从那之后,大部分工作都在训练数据上。
对于这么小的模型,你真的没有太多留给模糊性的空间。它需要识别出那些在更大的模型看来可能相似的请求之间的差异,理解它们属于哪个类别,并可靠地生成正确的结构化响应。
我花了相当多时间修改和调整数据集,确保模型学到的是不同类型意图之间的区别,而不是简单地记住关键词。
这个区别相当重要。
用户可能会让 PacketSnitch 查找某些内容、分析某些内容、总结某些内容,或者检索某台特定主机的信息。根据措辞不同,这些请求可能重叠得相当多。路由器需要识别出用户实际想要完成什么,而不是只匹配几个词,然后盲目选择第一个恰好包含这些词的工具。
输出也必须是可预测的。我不是让模型写一篇文章或生成一段对话式回复,而是让它识别出一个操作,并构造出应用能够实际使用的一小段 JSON 表示。
最终,我把路由器调到了这样一个程度:它能够可靠地识别出合适的意图并选出正确的工具,而不需要大得多的模型。
结果是什么样的
开发过程中,我希望能够做到的一件事,是衡量路由器是否真的产生了预期的工具调用,而不是只看它的回复、然后判断它们看起来是否合理。
我构建了测试场景,将预期操作与模型的预测进行比较。
例如,下面是一个来自 mischief-500h 路由器的真实可用测试:
请求:Show TCP packets
预期输出:
        {
  "action": "filter-query",
  "args": {
    "query": "transport.proto: tcp"
  }
}
模型预测:
        {
  "action": "filter-query",
  "args": {
    "query": "transport.proto: tcp"
  }
}
测试输出:
        {
  "scenario": "fast-route:filter:transport.proto: tcp",
  "request": "Show TCP packets",
  "expected": "{\"action\":\"filter-query\",\"args\":{\"query\":\"transport.proto: tcp\"}}",
  "prediction": "{\"action\":\"filter-query\",\"args\":{\"query\":\"transport.proto: tcp\"}}",
  "ok": true,
  "latencyMs": 153
}
一个小模型识别用户意图并生成正确的结构化动作,响应时间为 153ms。
显然,这只是一个测试用例,并不代表每个请求都会有完全相同的表现。但它展示了当请求落在较小模型的职责范围内时,这种架构能够做到什么。
关键在于,模型并没有把时间花在弄清楚如何实现一个过滤器上。它已经有文档解释了如何做到这一点。它的工作是理解用户想要什么,并生成相应的动作。
这样做的成本
整个过程花了一个多星期。
在实际训练中,我使用了安装在数据中心的 L40S 显卡,运行在 90 核 Xeon 系统上。算力总成本仅约 40 美元。
这不是笔误。
大约四十美元的训练算力,就让我得到了一个经过训练和精炼的小语言模型,足以执行一项相当专门的路由任务——否则人们很容易想用一个更大的模型来做这件事。
而得到的模型足够小,可以在一台配备 32GB 内存、配置尚可的笔记本上运行,而且不会把它可用的资源全部占满。
我认为这是一个相当不错的权衡。
为什么这种方法有效
我认为围绕 AI 集成的一个较大误解是,你需要一个特别智能的模型才能完成有用的事情。
你并不一定需要。
很多应用层的 AI 问题,实际上并不是需要模型无所不知的问题。它们需要的是模型识别某个人想要什么,确定哪项能力与之相关,并遵循一个已知的流程。
通过分离这些职责,你可以大幅减少模型实际需要知道的内容。
在这种情况下,模型本质上是自然语言与应用现有功能之间的一个翻译层。
文档成为知识库,JSON 定义和示例成为指令,而模型则成为负责解释意图并导航这些信息的组件。
这也是一种更容易维护的安排。如果我给 PacketSnitch 增加另一项能力,我可以记录该动作并让它对路由器可用,而不必每次添加另一个工具时都重新训练模型。
文档索引是预生成的,相关信息在需要时被检索,模型使用这些信息来构造操作。
显然也有局限性。小模型仍可能误解模糊的请求、选择错误的类别,或生成错误的参数结构。这就是为什么应用仍然需要验证生成的调用并妥善处理失败。模型并不会仅仅因为能构造 JSON 响应就被赋予对应用的无限制权限。
但就我试图达成的目标而言,这种方法的效果出奇地好。
结论
对我来说有趣的是,我最终把已经在搜索上使用的同一套理念用在了 AI 上。
我没有试图让系统知道一切,而是让它擅长找到完成特定任务所需的信息。
AI 识别用户想要什么,找到合适的指令,并遵循它们。外围应用决定该请求是适合较小模型,还是需要升级到能力更强的模型。
它不需要庞大的参数数量、昂贵的 GPU 或基于云的推理服务,就能做真正有用的事情。
我觉得这种方法颇有潜力,尤其是对于那些拥有大量已文档化工具和功能的应用而言。与其试图训练一个模型去理解整个应用,不如训练一个相对较小的模型去导航应用自身的知识库。
这是一种巧妙的方式,让 AI 学会使用它可用的工具,而无需教会它如何自行构建每一个工具。
或许更重要的是,它让本地 AI 集成成为一个切实可行得多的方案。
Happy hacking!