 Newshot
文章标题:何时可以仅凭离线评估上线?
TL;DR 构建 AI 功能的团队希望跳过缓慢的 A/B 测试,仅凭离线评估做决定。本文探讨这在什么情况下可行,同时保持损害在线指标的风险较低。这可以奏效,但只在难以验证且可能随时间变化的强假设下成立。噪声也是个问题,因为它可能掩盖离线结果与在线结果之间的强关联。在我们的示例中,朴素估计表明评估解释了在线结果变异的 24%,而真实数字是 60%。
随着基于 agentic 和 LLM 的产品与功能越来越普遍,关于如何高效迭代它们的讨论也越来越多。为了评估产品质量和变更的影响,离线评估已成为工具包中的标准组成部分,与人工评估、在线 A/B 测试和问卷调查并列。
当我们更改 AI 功能时,比如使用新提示词或不同的底层 LLM,有两种主要方式检查它是否变好。离线评估是在任何真实用户看到变更之前,在一组固定的样本提示词上运行的快速测试,通常由其他 LLM-as-judges 对答案评分。A/B 测试将新版本提供给一组随机真实用户,并比较他们的行为与旧版本用户的行为。
经常出现的一个问题是,我们是否可以更依赖离线评估,而更少依赖那些更耗时、资源密集的替代方案。更具体地说,我们是否可以跳过 A/B 测试,仅依靠离线评估来做产品决策?如果可以,什么时候可以?
潜在收益很大。离线评估只需数小时;A/B 测试通常需要数天或数周。
如果我们能够自信地仅基于离线评估做出产品决策,我们就可以缩短反馈循环并更快迭代。但“我们能否仅凭评估做决策”到底是什么意思?
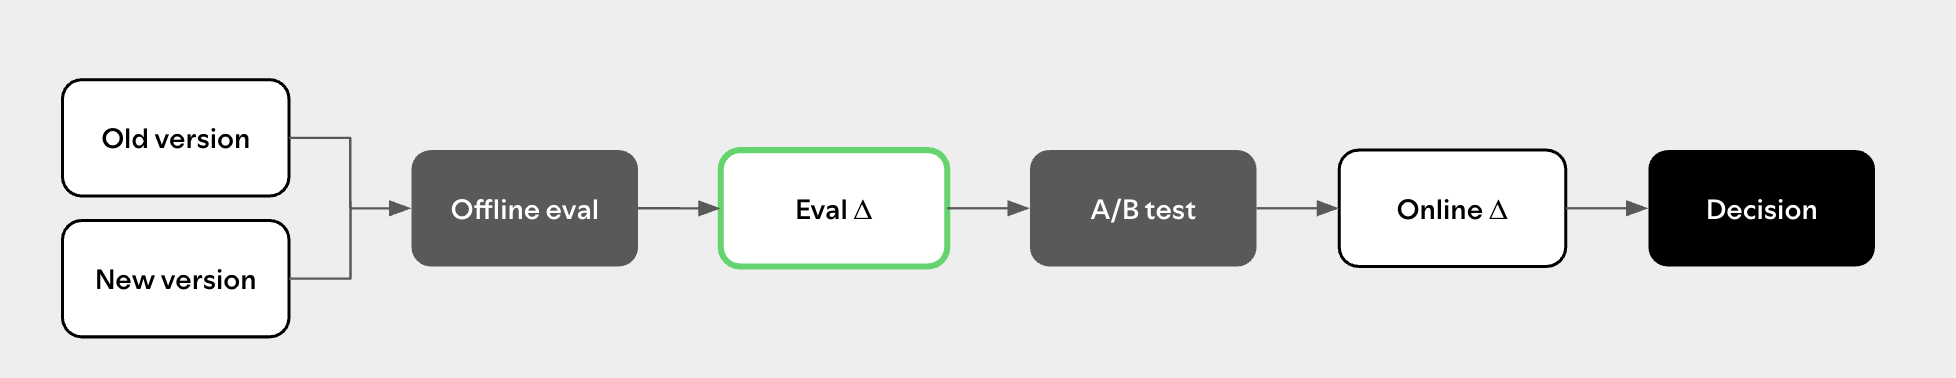
本文的目标有两方面。第一,形式化我们希望在基于离线评估、没有 A/B 测试的情况下决定上线变更时获得什么样的保证。
第二,理解实现这种保证需要知道、假设或估计什么,以及涉及的主要挑战和陷阱。
在我们的论文《When Can You Ship on Evals Alone?》中,我们详细探讨了这个问题。该方法具有通用性,旨在帮助任何构建基于 LLM 产品的团队建立直觉。
我们需要知道什么?
我们将“何时可以仅凭评估上线”形式化如下:我们希望基于离线评估做出上线决策,同时限制上线实际损害在线指标的风险。
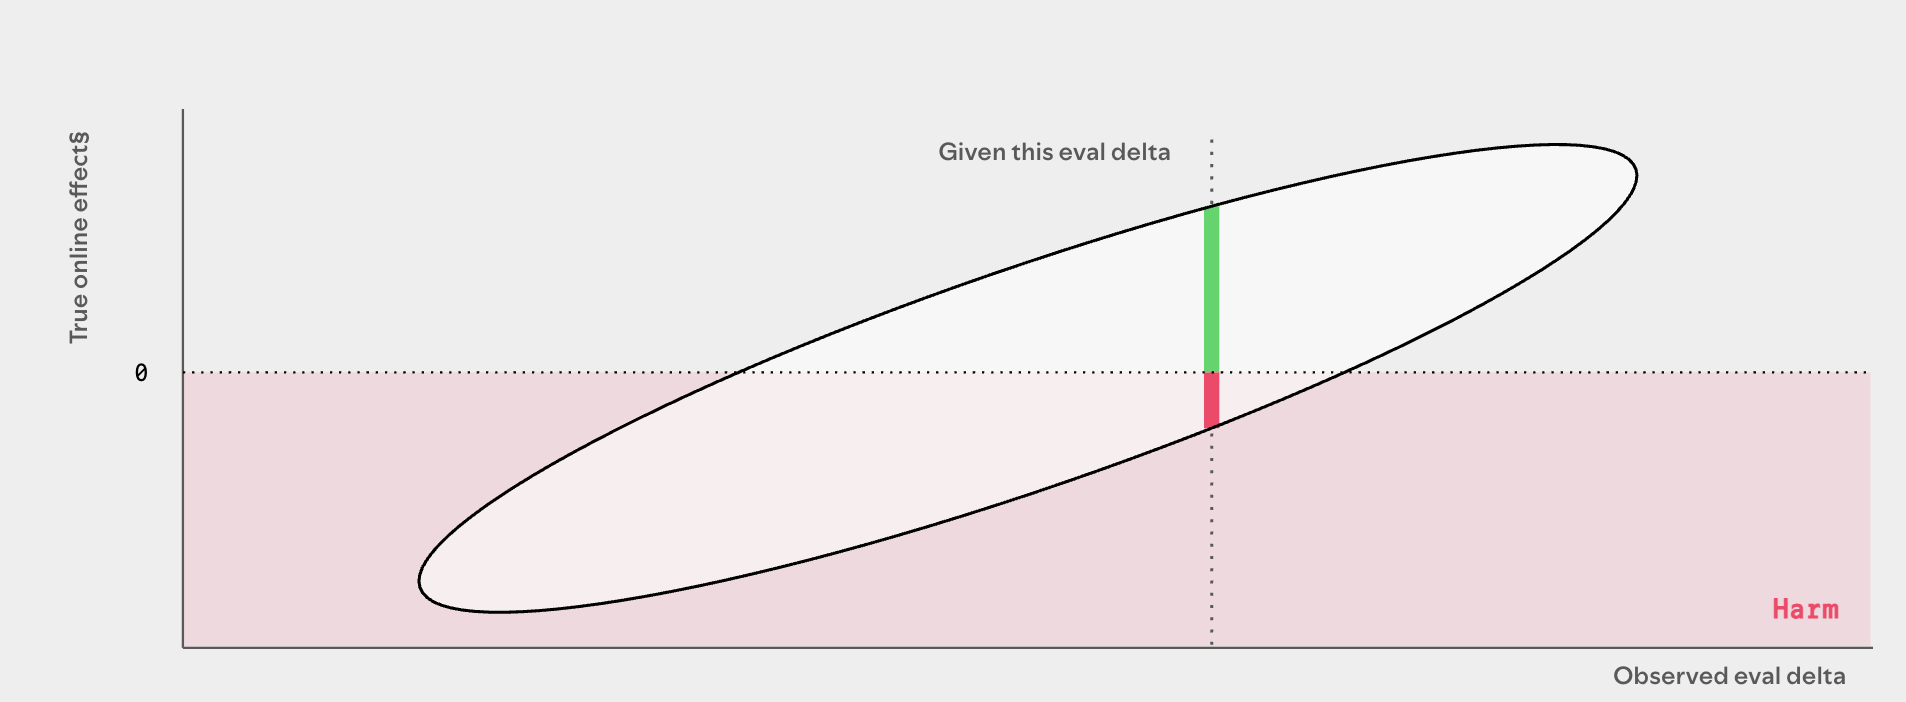
如果我们想限制上线某物损害在线指标的风险,理想情况下我们需要知道在给定观察到的离线评估处理效应时,真实在线处理效应的条件分布。如果我们知道这个分布,就可以直接评估并限制在给定任何观察到的评估效应时做出有害上线决策的风险。通俗地说:对于任何评估结果,我们想知道该变更实际上以某个特定在线指标衡量时,帮助还是伤害真实用户的可能性有多大。
那么我们如何学习这种关系?这正是事情变得微妙的地方。
第一个挑战是,我们需要离线评估效应和在线处理效应的成对观察,而且都来自同一个底层关系。我们不能有一组异质的实验:对某些类型的变更,评估的提升对应于在线结果的提升,而对另一些类型,这种关系不同甚至相反。
第二个挑战是测量误差。两个数字都是带噪声的估计值,而非精确值。离线评测分数存在来自多个来源的抽样误差,包括从更大的评测集中随机抽取样本,以及使用 LLM 对答案打分(LLM-as-a-judge)。线上处理效应同样以存在抽样误差的方式估计。在学习二者关系时,我们需要考虑这些误差。
为了对这些挑战建立直觉,也为了理解当我们的假设不成立时会发生什么,我们引入一个简化的工作模型。
一个简化的工作模型
该模型做出了若干较强的简化假设。希望跳过统计部分的读者可以直接跳到下一节。所有细节都在论文中。
- 第一,我们假设拥有一个足够大的、同质的配对池,其中包含离线评测效应与线上处理效应。并且,我们假设未来任何我们想基于评测做出决策的变更都来自同一类别,具有相同的离线效应与线上效应之间的底层关系(也称为可交换性)。
- 第二,我们假设真实的离线与线上处理效应服从二元正态分布。
- 第三,我们假设测量误差以零为中心、方差已知,且在不同干预之间相互独立。
- 最后,我们假设使用 LLM 作为评判者所引入的任何误差都与处理组无关。
这些是较强的假设,我们之后会回到当它们被违反或被放松时会发生什么。
正确处理测量误差的重要性
简短版:如果我们忽略噪声,一个很强的离线—线上关系可能看起来很弱。
要理解处理测量误差有多重要,一个很好的起点是考虑如何估计离线结果与线上结果之间关系的强度。
在这些假设下,给定评测效应时线上效应的条件分布是完全确定的。平方相关系数(R²,大致表示评测能解释多少线上结果,从 0 到 100%)决定了在观察到评测之后,线上效应中还剩多少不确定性。高 R² 意味着评测对线上结果具有高度信息量。低 R² 意味着无论我们测量评测的精度多高,仍会存在相当大的不确定性。
使用朴素估计量,我们发现在论文的工作示例中,平方相关系数仅为 24%,而真实值为 60%。更一般地,我们证明朴素的平方相关系数估计量会被测量误差衰减:两次测量中的噪声都会稀释我们观察到的相关性。
这甚至在初始阶段就很重要——当我们只是想评估离线评测是否可能足以作为 A/B 测试结果的代理时。如果不正确处理测量误差,我们就有可能大幅低估既有关系的强度。
在我们的工作模型下,我们可以使用经典的元分析方法来建模误差结构,并在估计底层关系时对测量误差进行调整。
构建决策门
假设我们相信工作模型的假设已得到满足。我们将如何基于离线评测构建决策规则?
在我们的假设下,我们可以估计给定观测到的离线评测效应时,真实线上处理效应的条件分布。
然后我们可以构建一个决策门,用以约束发布有害内容、或扼杀(决定不发布)实际会改善线上指标的内容的风险。
除非平方相关系数为一,否则总会存在这样的情况:正的离线评测效应并不对应正的线上效应,反之亦然。因此,基于微弱为正或为负的评测效应做决策,无法达到我们想要的保证。
相反,发布与扼杀的阈值需要取决于代理关系的强度。
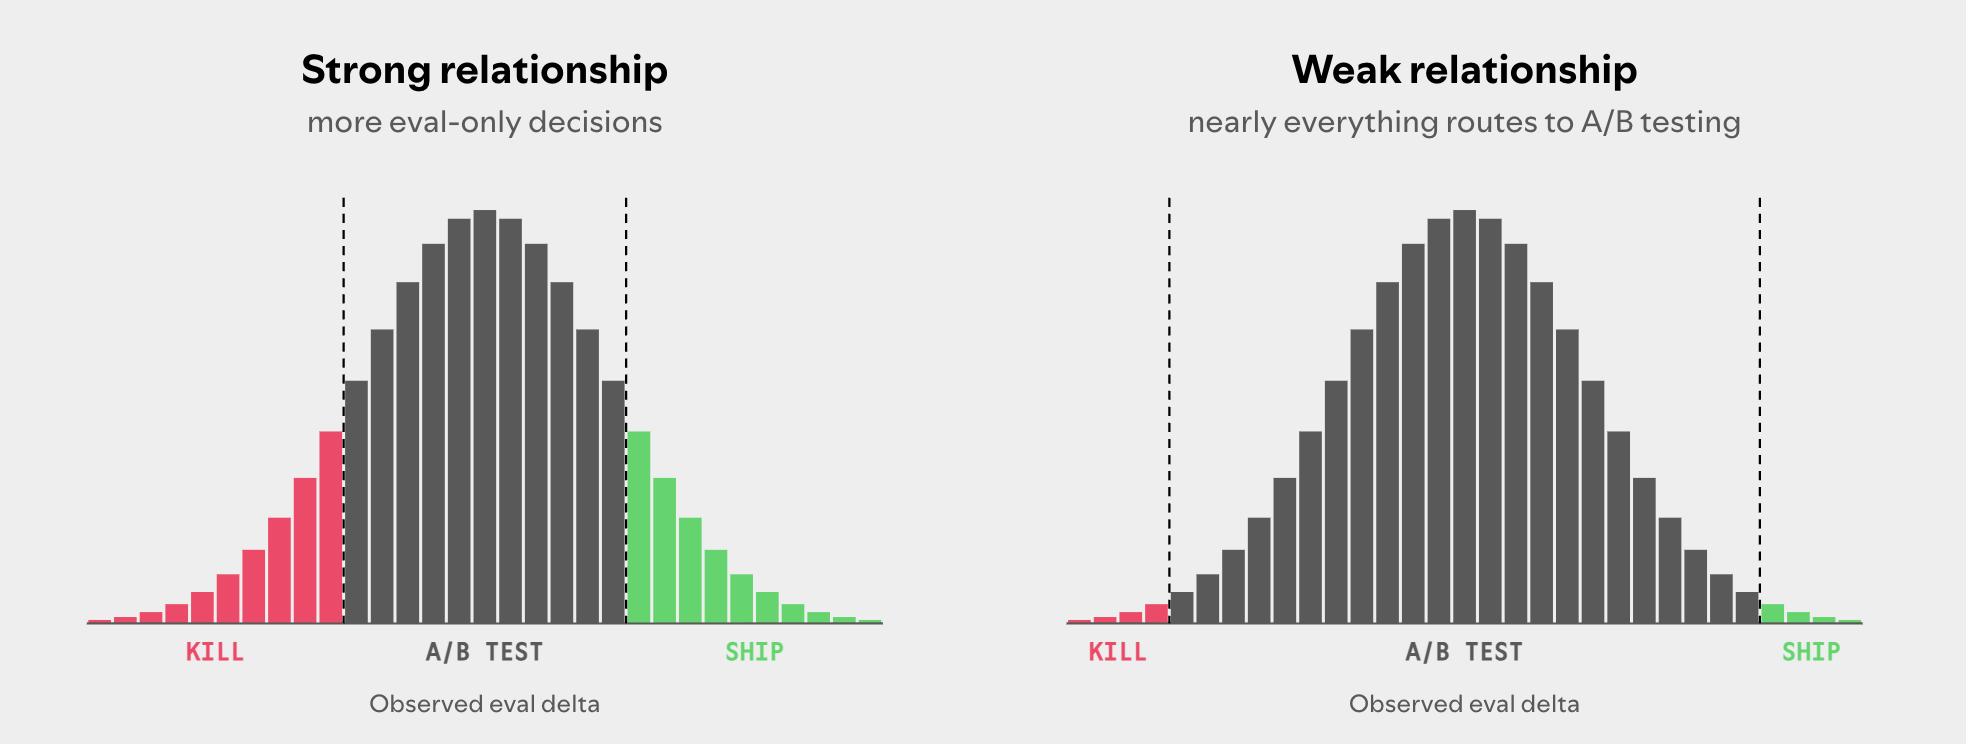
如果替代关系是完美的,我们可以直接使用常规显著性水平在离线评估上进行测试,并获得对线上效果的相应保证。但关系越弱,我们在做出决策之前需要从离线评估中获得的证据就越强。
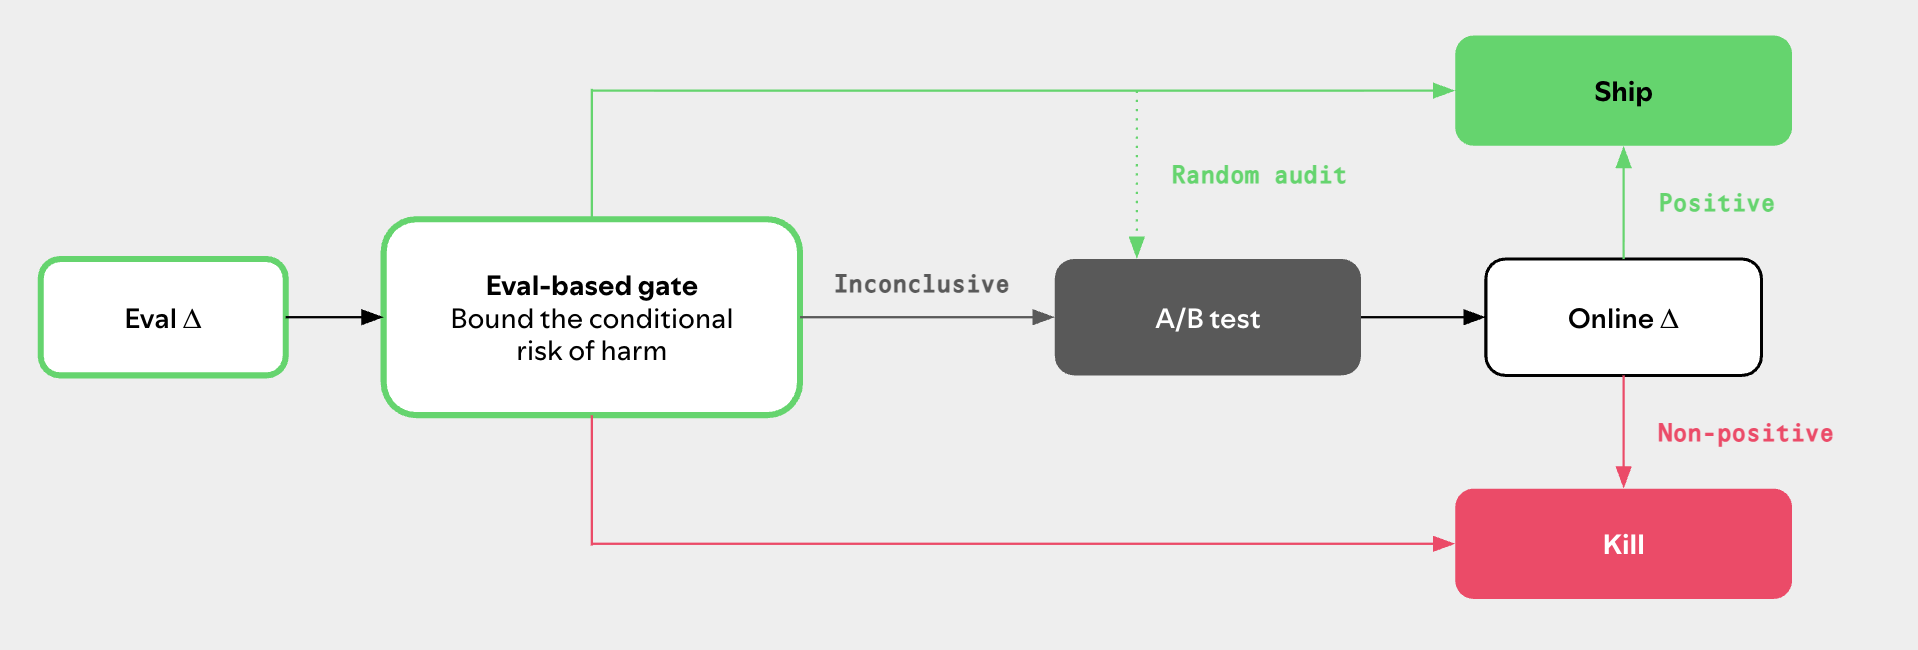
最终我们得到一个门控机制:足够正向的离线评估效果导致上线,足够负向的效果导致终止,而介于两者之间的情况则进入 A/B 测试。
质疑假设:同质数据集的重要性
回到第一个根本性挑战:如果我们没有干净、同质的数据集,会发生什么?
假设我们拥有来自几个不同变更类别的实验,而离线与线上处理效果之间的关系因类别而异。我们可能会得到辛普森悖论式的效应,即趋势出现在汇总数据中,但在任何单个组内都不出现。
在任何单个类别内,离线与线上效果之间可能没有关系,但当我们把它们汇总在一起时,我们观察到一个强关系。
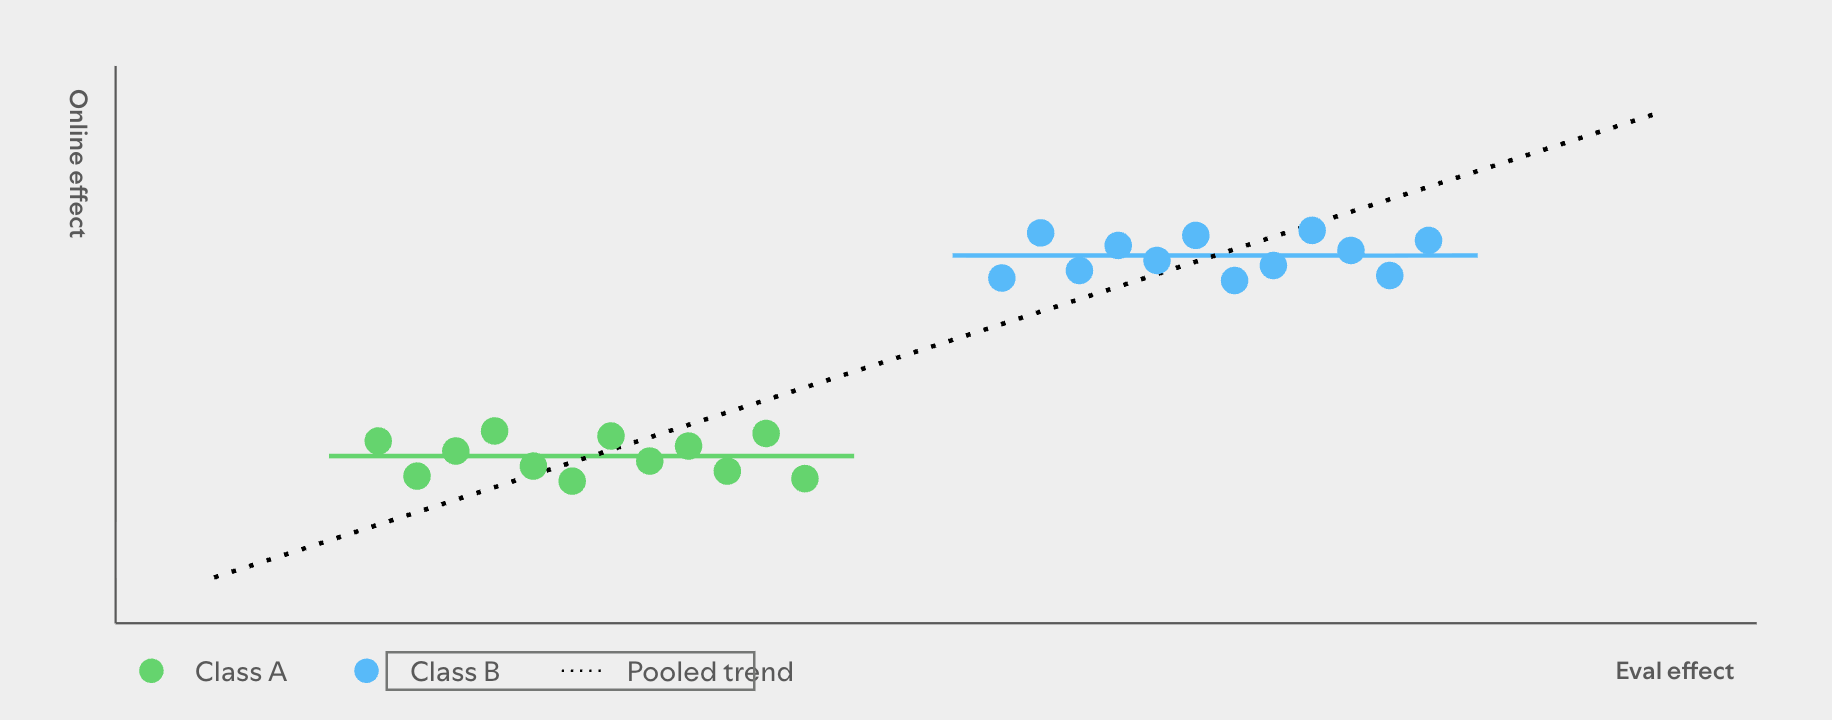
因此,汇总数据集可能表明存在非常强的替代关系,即使在任何单个类别内离线评估与线上结果之间没有预测性关系。
除非我们足够确定我们的实验是同质的,否则我们就有可能严重错误估计替代关系的强度。我们可以检查不同类别内的关系,但测量误差使这更加困难。
这里与维护历史贝叶斯先验有一个平行之处,正如我们在这篇关于贝叶斯 A/B 测试的博客文章中所讨论的。在这两种情况下,我们决策的性质取决于历史语料库的质量,而历史语料库的质量可能难以评估和维护。
质疑假设:LLM 作为评判者带来的偏差
LLM 作为评判者被广泛用于评估 LLM 的自由文本回答。关于验证评判者质量的研究越来越多。例如,Ye et al. (2025) 系统地研究了不同形式的评判者偏差。在我们的论文中,我们关注有偏的评判者如何影响决策。有两种重要情况。
第一种是 LLM 评判者有偏差,但偏差与处理组无关。在这种情况下,偏差对估计处理效果不是问题,因为当我们取处理组和对照组之间的差异时,偏差会抵消。
第二种是偏差取决于处理组。那么它可以极大地影响观察到的处理效果以及离线与线上效果之间关系的估计强度。它甚至可以翻转符号,使更差的版本看起来更好。
重要的区别不在于评判者是否有偏差,而在于偏差是否取决于处理组。
第二种形式的偏差可能比人们预期的更为常见。越来越多的证据表明 LLM 评判者可能偏爱自己生成的输出。然而,Chen et al. (2025) 表明,明显的自我偏好可以部分反映输出质量的真实差异,而不仅仅是偏差。这在评估智能体系统时会产生问题,特别是当比较不同的 LLM 作为驱动智能体的底层模型时。
由于比较和切换底层 LLM 是开发智能体系统的常见部分,这种类型的偏差在实践中可能很普遍。而依赖于处理组的偏差会影响离线评估决策门控的有效性。
质疑假设:一旦我们部署门控会发生什么?
像 {{NAME_ab12cd34}} 这样写的值是真实值的占位符。在回复和工具调用中完全按照所写使用它们:它们会在任何运行之前被填充为真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:何时可以仅凭离线评估就上线?
正文: 假设我们构建了这个门控机制,并将其用于产品决策。我们对同质数据集的假设还隐含了历史实验与未来实验之间的可交换性。我们假设新的变更会来自相同的底层关系。但这一假设只是某一时间点的快照。
除非我们盲目地假设它永远成立,否则就需要某种机制来检测漂移(即关系随时间发生的变化)。代理关系可能随时间变强或变弱,甚至完全消失。
但问题在于:一旦部署了这个门控,我们就停止对进入上线区和淘汰区的变更运行 A/B 测试。我们能观察到它们的离线评估效果,但不再观察它们的在线处理效应。我们恰恰在门控做出决策的这些区域失去了真实基准。
对于中间区域的实验,我们仍然可以观察到这种关系,因为它们会进入 A/B 测试。但这并不能告诉我们,上线区和淘汰区的关系是否已经发生漂移。
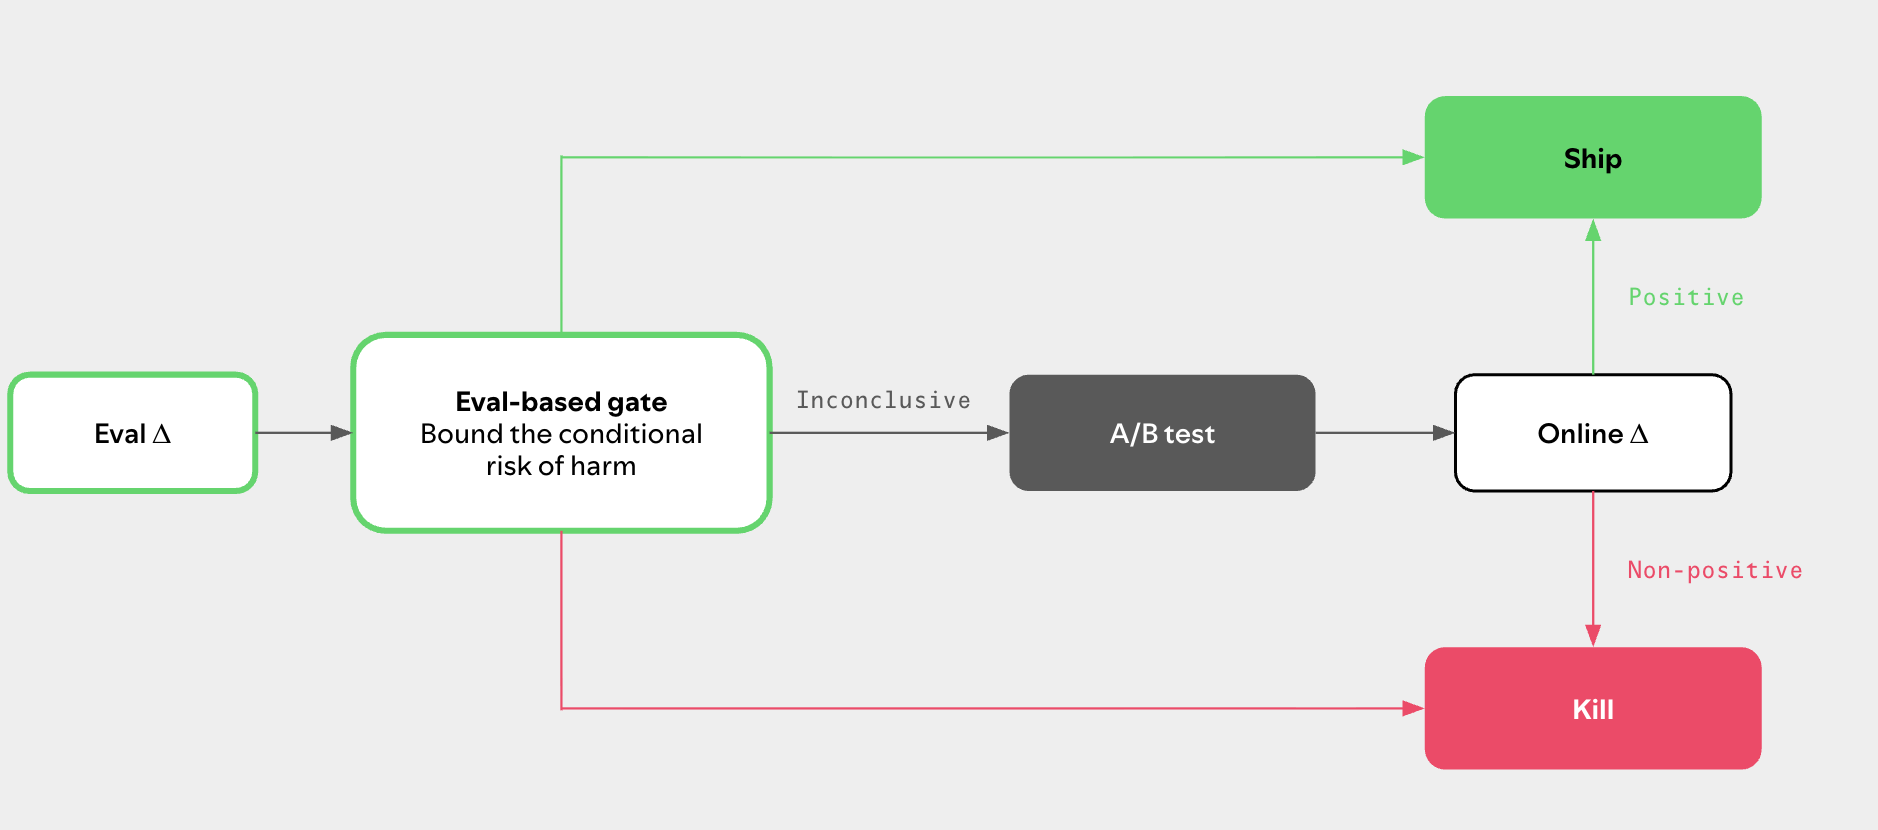
应对这一问题的一种方法是引入审计池。我们随机抽取一小部分原本会被直接上线或淘汰的实验,仍然对它们运行 A/B 测试。这样我们就能获得跨决策区域的配对观测,从而持续验证门控、检测漂移,并在必要时更新它。
其代价是,能够在没有 A/B 测试的情况下做出的决策变少了。
那么,何时可以仅凭离线评估就上线?
让我们回到最初的问题:能否仅凭离线评估就上线,同时对损害在线结果的风险加以约束?
原则上可以,前提是我们愿意做出足够强的假设,并相信这些假设在实践中是合理的。然而,仍有若干重要挑战存在。
在实践中,门槛很高。许多假设难以验证,而且即使你在某一时点验证了它们,随着离线/在线之间关系以及分布随时间漂移,这也是需要持续重新评估的事情。
首先,构建并维护一个干净的语料库很困难。我们需要足够相似的变更,使其离线效果和在线效果能够合理地遵循相同的联合分布。这一点很难确立,更难长期维持。在标准的产品开发过程中,我们应该预期会出现收益递减以及其他改变这种关系的转变。
其次,我们的工作模型依赖于很强的分布假设。这些假设可以放宽,但更稳健的决策规则很可能以效率为代价。在代理关系相对较弱、阈值又偏保守的情况下,可能只有极少数变更符合仅凭离线评估做决策的条件。到某个程度,效率收益可能小到不足以证明这种方法的合理性。
第三,可靠地刻画 LLM 评判者引入的测量误差和偏差仍然具有挑战性,尤其是在我们还需要监测漂移并确保假设持续成立的时候。
在 Spotify,我们广泛使用离线评估来迭代我们基于 LLM 和生成式 AI 的产品。它们在我们的开发流程中扮演着重要角色,但我们仍持续将它们与在线实验配合使用。这使我们不仅能管理我们所关心的风险,还能评估并优化离线评估可能无法充分捕捉的长期结果。
归根结底,一个重要区别依然存在:A/B 测试让我们在设计上就能约束风险,而离线评估只有通过对离线与在线结果之间关系做出额外假设,才能提供可比的保证——而这些假设在实践中往往难以验证和维持。
分享本文