 Newshot
TLDR;我们构建了 Blobasaur,一个基于 SQLite 的分片、分布式、轻量级 blob 存储服务器,以解决我们高吞吐量的 blob 读写用例。从几 KB 到几 MB 不等的 JSON blob 现在可以在商用硬件上每秒写入和读取数千次,同时保持个位数毫秒的延迟。
在 Kite 上——我们拥有约 2000 万客户的交易平台——用户可以深度定制他们的投资和交易界面。他们保存多图表布局、金融指标模板、矢量绘图以及各种任意 UI 偏好设置。此外,我们还提供 Terminal 模式,允许用户通过拖拽、放置和自定义小组件来设计自己的工作区。在底层,我们的后端服务将这些用户偏好和元数据存储为不透明的 blob(主要是 JSON),大小从几 KB 到几 MB 不等。
多年前,我们将此类 blob 存储在 CouchDB 中,但事实证明它不适合我们当时开始看到的吞吐量水平。随后我们迁移到了 SSDB(ssdb),一个使用 C++ 编写的、基于磁盘并支持 Redis 协议的存储。这也让集成变得非常容易。SSDB 解决了我们眼下的性能问题,并在生产环境中可靠运行了数年。
随着时间推移,两个问题迫使我们寻找替代方案:
- SSDB 不再维护,这显然是一个运维风险。它是用 C++ 编写的,而 C++ 不属于我们的技术栈或专长,因此分叉并维护也不可行。
- 扩展性和大小限制。SSDB 不是分布式系统,只能运行在单个节点上。这给未来的扩展带来了重大挑战,其中一度迫使我们将 blob 大小限制在 1 MB,因为较大负载下延迟会下降。随着我们添加 Terminal 模式等功能并接入更多内部服务,我们需要一个健壮的解决方案。我们的标准是:
- 具有简单 API 的键值 blob 存储。
- 为多兆字节 blob 读写操作和高吞吐量而设计。我们承受每秒数千到数万次读写任意 blob 的请求负载。由于股市的波动性,这些负载不可预测且呈突发性。
- 水平可扩展、分布式。
- 磁盘空间效率 / 压缩。
- 易于维护且高度经济。
因此我们调研了针对高吞吐量 blob 存储优化的 FOSS 数据库,并考察了以下选项:
- ScyllaDB:我们已经在使用 ScyllaDB 处理高吞吐量工作负载,但在我们的测试中,它对于大 blob 表现欠佳。吞吐量显著更低,资源使用更高。我们特别需要多兆字节的 blob。频繁覆盖和 TTL 过期产生的墓碑需要在 ScyllaDB 中仔细调优。
- PostgreSQL:我们在技术栈中已有相当丰富的 Postgres 经验,并尝试过将 blob 存储为 BYTEA 列,但事实证明,就性能和磁盘空间效率而言,它对于该用例再次严重欠佳。
- YugabyteDB:将 blob 存储作为选项之一,但并非主要为此设计或优化。此外,它是一个功能过多的大型系统。
- RocksDB:拥有正确的基础原语,但同样并非为高吞吐量多 MB blob 写入而架构设计。
- Ceph:运维复杂度和资源需求严重。我们甚至没有去尝试它。
- SeaweedFS:这是最接近的候选者。然而,存在几个阻碍。我们的用例是覆盖密集型的(用户更改其工作区)针对同一键,而 SeaweedFS 在压缩之前会持续追加,这可能导致磁盘使用量不可控地增长。blob 有自己的 ID,然后必须在单独的数据库中映射到用户键,又增加了一层。它不支持每个 blob 的 TTL。此外,设置相当复杂,涉及许多组件。
文章标题:基于 SQLite 的分布式高性能 blob 存储
正文:
- S3 和 MinIO:对象存储对小 blob 有较高的每请求延迟,在写密集负载下请求成本很高(写入占我们流量的 50%),并且只能提供粗粒度的生命周期 TTL,而不是精确的键过期。更不用说,考虑到每秒数千次操作、每天数千万次操作,S3 会产生可观的成本。
- 原始文件系统(每个 blob 一个文件):把 blob 直接放在磁盘上意味着要实现原子写入和写入批处理,管理大量文件和目录,面对经典的原子读写磁盘性能问题和 inode 带来的麻烦,还要为 TTL 维护单独的元数据索引。更不用说,还要在 AWS 存储卷上编排这一切。
大约在这个时候,我们在另一个项目中尝试使用 SQLite,并对其“比文件系统快 35%”的说法感到惊叹。我们恰好还有一个查询缓存系统,每天在一个 Postgres 实例中创建数百万张表,相当成功地把它推到了极限。把这两件事联系起来,我们想,为什么不在 SQLite 之上构建一个系统来存储数百万个 blob,看看会发生什么?
于是我们最终构建了 Blobasaur,一个用 Rust 编写的开源分片 blob 服务器,它使用 Redis 协议,并以 SQLite 作为存储引擎。它是一个单一二进制应用,性能高,部署和维护极其简单。它已在 Zerodha 投入生产,并成功取代了 SSDB。
我们需要什么
我们已有多个 Go 和 Python 服务通过 Redis 协议与 SSDB 通信,还有更多服务等待接入。我们希望新方案满足这些要求:
- 兼容 Redis 协议(如果可能的话):每个现有客户端都已经使用标准 Redis 库(GET、SET、HGET、HSET、DEL、EXPIRE)。如果我们能有一个可以无缝替换的系统,就能让现有服务保持不变,并显著降低风险。
- 在各种负载大小下都保持低延迟:它需要以个位数毫秒的延迟同时服务 2 KB 的设置 blob 和 5 MB 的图表布局。
- 内置压缩:我们几乎所有的负载都是重复性很高的 JSON,压缩效果很好。
- 带 TTL 的简单 CRUD:我们不需要复杂的数据结构、服务端脚本或二级查询。我们只需要带键过期的键值及哈希 CRUD。
- 多节点分区:我们需要把数据拆分到多台机器上,避免单个节点成为瓶颈。
- 可接受较低的持久性:这个存储保存的是非关键的 UI 和工作区偏好,而不是关键金融数据。如果突然断电导致最近的写入丢失,用户可能会丢失最近的图表布局调整,这很烦人,但永远不会影响交易。对我们的用例来说,这是一个很好的性能取舍。
为什么选 SQLite(以及 Rust)
在存储方面我们有几个选择。显而易见的是原始文件系统,每个 blob 一个文件。但那样的话,一切都要我们自己发明:
- 原子写入和批处理。
- TTL 清理,这需要二级索引或遍历目录。
- 处理 fd 限制。
- 将元数据与原始数据分开管理。
SQLite 几乎给了我们原始文件系统所缺乏的一切。对于小 blob,SQLite 比原始文件系统 I/O 最多快 35%。虽然原始文件在约 100 KiB 以上开始胜过 SQLite,但我们会在写入前压缩 blob。幸运的是,我们 99% 的压缩值都远低于 100 KiB。
使用 SQLite 也意味着继承一个经过实战检验的存储引擎,具备 ACID 事务、崩溃恢复和标准工具。磁盘上的任何分片都可以用标准的 sqlite3 CLI 检查,或用普通 SQL 查询进行分析等。
文章标题:基于 SQLite 的分布式高性能 blob 存储
正文: 虽然我们大部分后端技术栈用的是 Go,但 Blobasaur 是用 Rust 写的。Go 的标准 SQLite 驱动需要 CGo,这会让静态构建变复杂,在高并发下执行 C 调用时会固定 OS 线程,并且在分配和压缩数兆字节缓冲区时会增加垃圾回收压力。用 Rust(sqlx、rusqlite 和 tokio),我们直接调用 SQLite 的 C API,内存使用可预测,并且可以交付单个静态二进制文件。
架构
将数据拆分成分片
在 WAL(预写日志)模式下,单个 SQLite 数据库允许并发读取,但同一时间仍然只允许一个写入者。由于写入大约占我们生产流量的 50%,每节点一个 SQLite 文件很快就会成为瓶颈。
为了在单台机器上获得写入并发,Blobasaur 将数据拆分到磁盘上的多个 SQLite 数据库文件中,称为分片:
- 一致性哈希:每个 key 通过多探测一致性哈希映射到一个分片。
- 带组提交的每分片写入者:每个分片有一个专用写入任务,由一个有界队列供给。写入者不是一次提交一个 key,而是从队列中取出批量的待写入操作,并在单个 BEGIN IMMEDIATE ... COMMIT 事务中执行它们。这样就把事务和 WAL 开销分摊到并发客户端上。
- 并发读取者:读取直接走每个分片的只读 SQLite 连接池,并且可以与写入者并发运行。
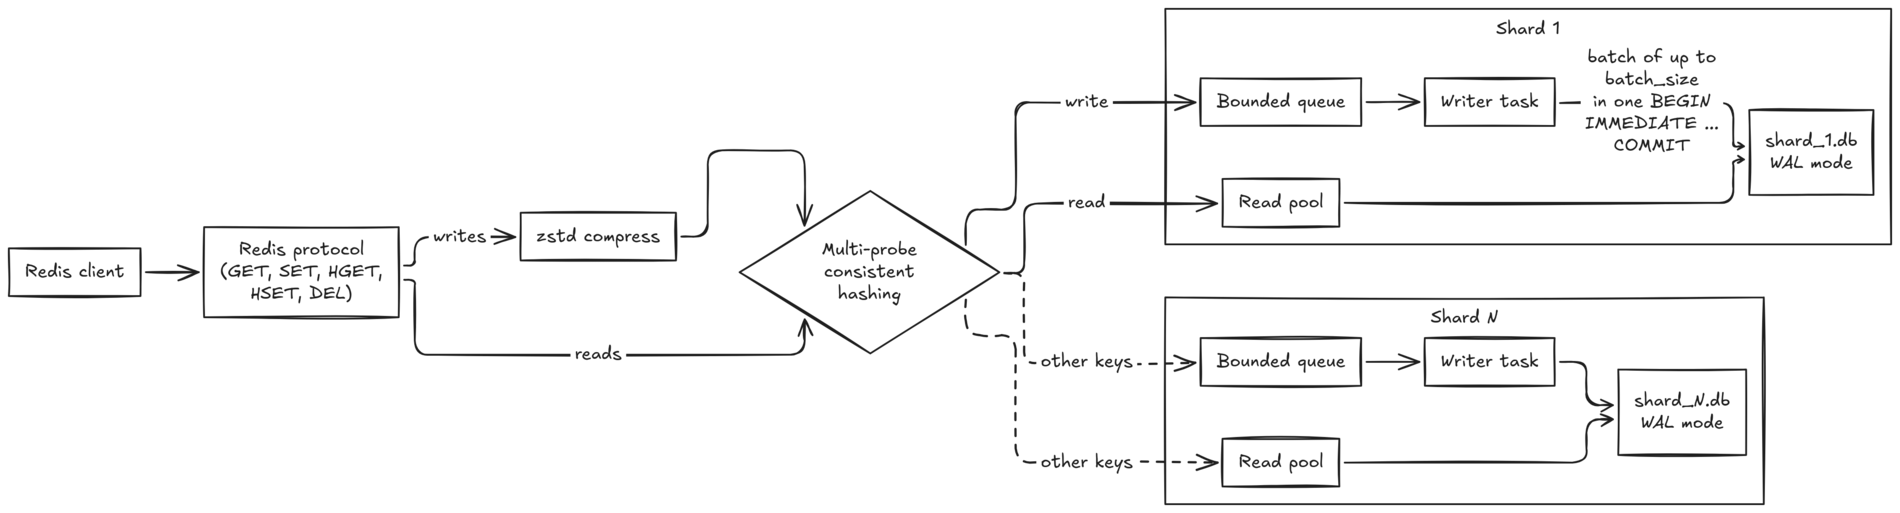
分片能带来多大帮助?
我们用负载生成器以 64 个并发连接,对 1 个分片和 16 个分片做了基准测试。每个请求使用 64 KiB 的 JSON blob 负载(接近我们的生产平均值),zstd 大约能压缩 9 倍。
所有运行都使用 100,000 个 key、同步写入和 batch_size = 50,数据目录位于 tmpfs 上,以将 SQLite 锁和 CPU 开销与磁盘差异隔离开。两种配置获得相同的总资源:1,600 MB 的 SQLite 页缓存和 64 个总读取连接。
| 工作负载 | 1 个分片 | 16 个分片 |
|---|---|---|
| 仅 HSET | 7,740 ops/s, p99 10.7 ms | 25,324 ops/s, p99 8.3 ms |
| 50% HSET,50% HGET | 14,227 ops/s, p99 10.5 ms | 29,538 ops/s, p99 8.5 ms |
| 仅 HGET | 67,128 ops/s, p99 2.1 ms | 70,884 ops/s, p99 2.3 ms |
使用 16 个分片时,写入吞吐量提高 3.3 倍,写入延迟中位数从 8.2 ms 降至 2.1 ms。读取吞吐量几乎保持不变,因为 SQLite WAL 模式本身就能为并发读取者提供服务且无争用。
在每秒 25,324 次 HSET 操作、每次携带 64 KiB 负载的情况下,Blobasaur 通过 zstd 处理大约 1.66 GB/s 的未压缩 JSON。服务器和负载生成器都运行在同一台 16 核笔记本电脑上,共享其 CPU 资源。
Schema
我们的服务同时使用普通 key(SET/GET)和 Redis 哈希(HSET/HGET)来按服务或功能对 blob 分组(例如 HSET prefs userID <json>)。
在每个分片内部,普通 key 存放在 blobs 表中:
        CREATE TABLE IF NOT EXISTS blobs (
    key TEXT PRIMARY KEY,
    data BLOB,
    created_at INTEGER NOT NULL,
    updated_at INTEGER NOT NULL,
    expires_at INTEGER,
    version INTEGER NOT NULL DEFAULT 0
);

CREATE INDEX IF NOT EXISTS idx_expires_at
    ON blobs(expires_at)
    WHERE expires_at IS NOT NULL;
SET 写入 blobs。HSET 写入其命名空间对应的表 blobs_<namespace>,列相同。例如,HSET prefs user42 ... 将 user42 存储在 blobs_prefs 中。
过期时间存储在同一行的 expires_at 中。读取查询在读取时过滤掉已过期的行(expires_at IS NULL OR expires_at > ?),同时后台 worker 异步清理过期行。由于 expires_at 上的索引是部分索引(WHERE expires_at IS NOT NULL),没有 TTL 的行不会在过期索引中占用空间。
压缩
Blobasaur 支持在写入 SQLite 之前使用 zstd、lz4、gzip 和 brotli 压缩。我们在生产环境中使用 zstd。
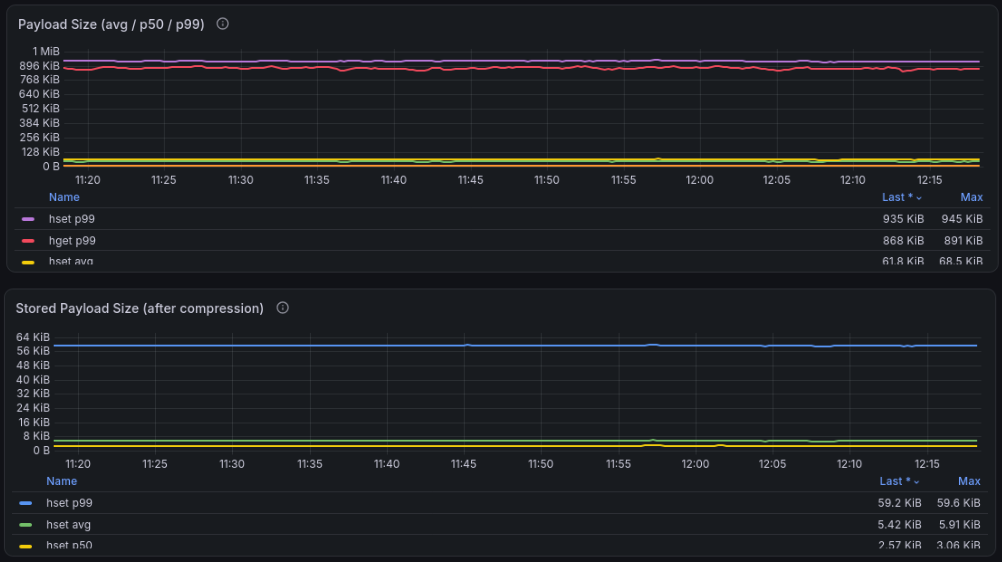
以下是压缩前后生产环境 HSET 流量一小时内的压缩比:
| HSET payload | 客户端发送 | 存储在 SQLite 中 | 缩减 |
|---|---|---|---|
| 平均 | 63.6 KiB | 5.5 KiB | 约 11 倍 |
| p99 | 935 KiB | 59.3 KiB | 约 16 倍 |
在 SQLite 默认 4 KiB 页大小下,将 63.6 KiB 的 payload 缩减到 5.5 KiB,可在不计行和索引开销的情况下,将其存储占用从大约 16 页降低到大约 2 页。存储 blob 数据的页数越少,对页缓存的压力就越小,通过 WAL 写入并进入数据库的数据也越少。
持久性
由于针对 UI 偏好这一具体用例,我们不需要严格持久性,因此分片以 WAL 模式运行,并设置 PRAGMA synchronous = NORMAL。SQLite 不会在每次事务提交时执行 fsync。操作系统崩溃或断电可能丢失尚未同步到持久存储的最近已提交事务,同时保持数据库一致性。
对于希望进一步降低写入延迟的工作负载,Blobasaur 还支持可选的 async_write 模式,该模式在写入进入分片内存队列后立即确认,早于 SQLite 批量提交。
跨机器扩展
为了扩展到单台服务器之外,Blobasaur 实现了 Redis Cluster 协议,使其兼容标准支持集群的 Redis 客户端。与 Redis Cluster 一样,键空间使用 CRC16 划分为 16384 个哈希槽。每个 Blobasaur 节点拥有配置的槽范围,节点之间通过 gossip 相互发现。如果客户端将键发送到错误的节点,该节点会返回 MOVED 重定向,指向拥有该键的节点。
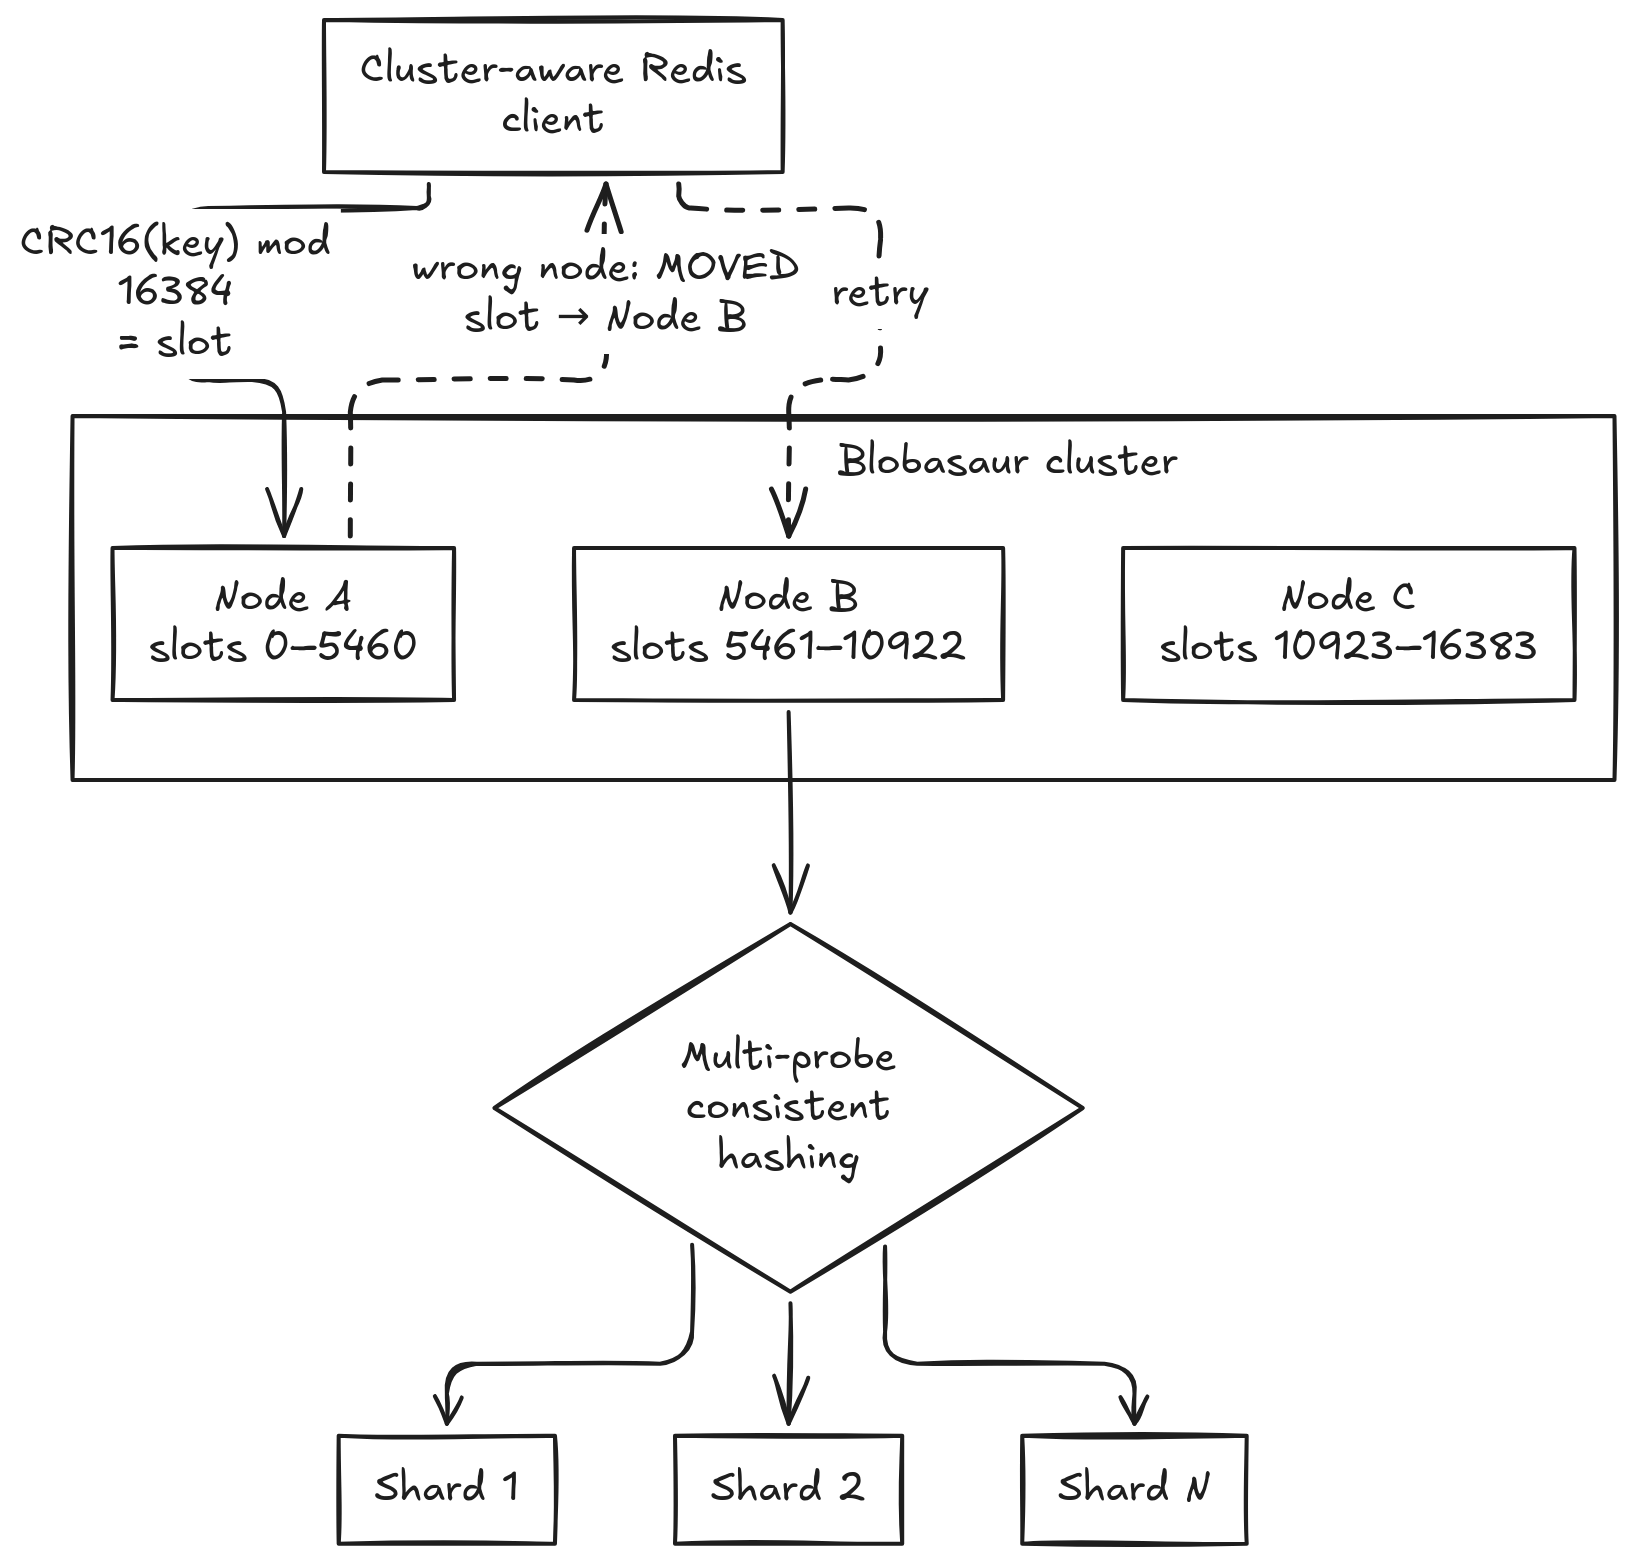
这为 Blobasaur 提供了两级路由:
- 集群层:CRC16(key) % 16384 选择机器。
- 节点层:多探测一致性哈希选择该机器上的 SQLite 分片。
目前存在一些限制。当前槽分配在配置中是静态的。运行中节点之间的实时槽重平衡和自动故障转移尚未实现。
更改分片数量
我们选择多探测一致性哈希,是为了让节点重分片只需移动最少数据,而无需虚拟节点。使用朴素的 hash % num_shards,从 4 个分片增加到 5 个分片会移动约 80% 的键。使用一致性哈希,只有约 20% 的键会移动(属于新分片的份额)。
目前重分片是通过内置 CLI 进行的离线操作:
- 停止服务器。
- 运行 blobasaur shard migrate 4 5 --verify。
- 更新 config.toml 中的 num_shards 并启动服务器。
迁移工具会移动目标分片发生变化的键。使用 --verify 时,它会检查键是否在预期的分片中,并报告迁移后的行数。
从 SSDB 迁移
我们以分阶段部署策略推出了 Blobasaur:
- 新工作负载优先:当我们推出 Kite Terminal 模式时,将其工作区存储直接指向 Blobasaur。
- 双写与回填:对于图表偏好等现有工作负载,我们更新服务以同时双写 SSDB 和 Blobasaur,同时运行历史键的后台迁移。读取优先到 Blobasaur,在缓存未命中或出错时回退到 SSDB。
- 切换:在客户端,唯一的代码更改是从单节点 Redis 客户端切换到使用三个 Blobasaur 节点 IP 的 Redis Cluster 客户端。
在双写运行一个月且零差异后,我们关闭了 SSDB。
一路上的经验教训
删除行不会缩小 SQLite 文件
早期我们注意到磁盘使用量只增不减,即使在数百万键过期或被删除之后也是如此。默认情况下,SQLite 将释放的页保留在内部 freelist 中供未来写入使用,而不是将空间返还给操作系统。
为解决这个问题,我们在每个分片上启用了 PRAGMA auto_vacuum = INCREMENTAL,并新增了 blobasaur shard vacuum 子命令,用于在设定的分配范围(默认 128 MB)内回收未使用的 freelist 页。由于在 WAL 模式下收缩实际数据库文件需要执行 checkpoint,Blobasaur 会在执行增量 vacuum 之后立即运行 PRAGMA wal_checkpoint(TRUNCATE)。
异步写入必须对每次读取可见
当启用 async_write 时,写入会返回 OK,但此时数据仍留在分片的内存队列中,等待下一批提交。为了保持读己之写(read-your-writes)一致性,排队的写入也会被放入一个内存中的 pending map,读取时会先检查该 map,再查询 SQLite。
在测试中,我们遇到了一些边缘情况:某些读取和存在性检查路径绕过了这个 pending map,或者没有考虑删除操作。例如,DEL 之后紧接着 GET,可能会从 SQLite 返回旧值,因为排队的 DEL 尚未提交。我们通过以下方式修复了这个问题:在 pending map 中存储显式的墓碑标记,并让所有读取(GET、HGET、EXISTS、TTL)都先经过它。
过期清理必须与写入方共享
在生产环境中,我们的 p99 写入延迟通常低于 5 ms,但偶尔会出现 30 到 50 ms 的尖峰。
我们将尖峰追踪到后台 TTL 清理任务。最初,清理 worker 打开自己的写入连接,并对所有过期行执行一条大型 DELETE 语句。这条大型 DELETE 与分片的主写入方争抢 SQLite 的单一写锁,导致正常的客户端批次 stalled。
我们通过两种方式修复了这个问题:将清理批次路由到分片现有的写入连接,使它们与客户端写入干净地轮流执行;并用 cleanup_chunk_size(默认 1,000 行)限制每一轮的处理量。由于过期行在读取时已经被过滤掉,将物理删除分散到更小的块中消除了延迟尖峰,且不影响正确性。
在生产环境中
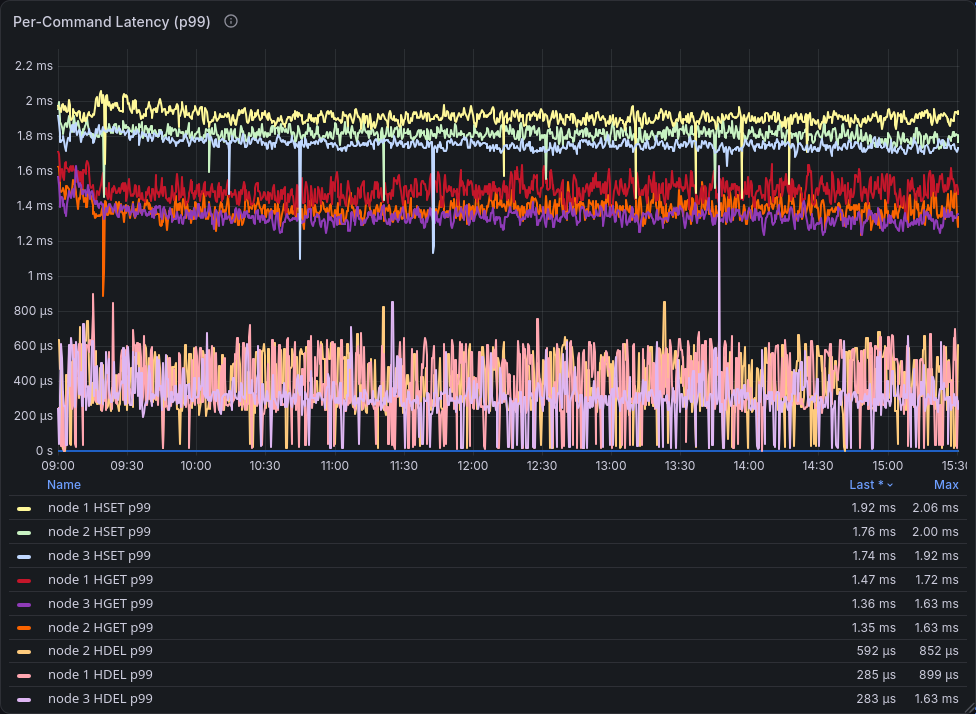
我们当前的 Blobasaur 部署以三节点运行(4 vCPU、8 GB RAM 集群)。在一个完整的交易时段内(09:00 到 15:30),所有命令的 p99 延迟在每个节点上保持在 2 ms 左右,p50 位于 250 到 550 µs 之间。
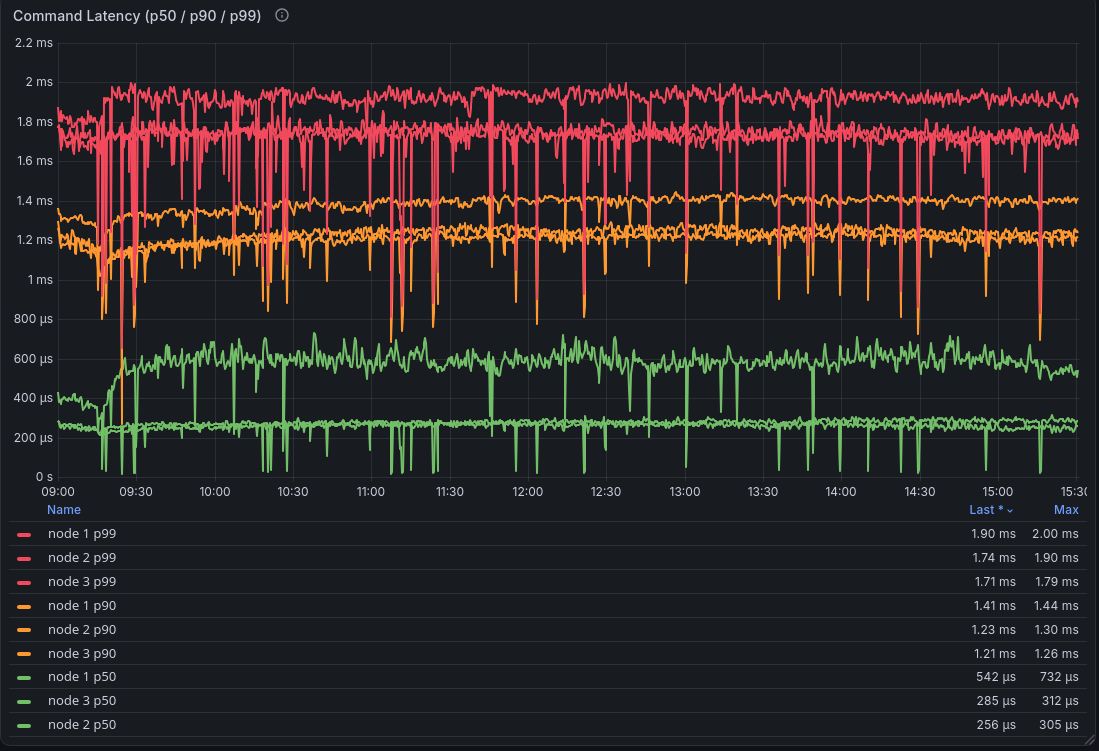
按命令细分,HSET 的 p99 约为 2 ms,HGET 的 p99 约为 1.4 ms,HDEL 的 p99 大多低于 1 ms。
Blobasaur 以 AGPLv3 许可证开源,可在 GitHub @iamd3vil/blobasaur 获取。在 4th Cross Labs 可以找到 Zerodha.tech 黑客集体的其他项目。