 Newshot
文章标题:规格驱动开发:AI 软件工厂背后的方法论(2026)
正文: TL;DR:规格驱动开发指的是在 AI agent 编写任何代码之前先就一份书面规格达成一致,然后依据这份文档进行构建和评审。它是“AI 软件工厂”中决定产出质量好坏的那一环。截至 2026 年 11 月,主要有五种方法:规格优先工具包(GitHub Spec Kit、Kiro、OpenSpec)、全新上下文评审(Elephant-Goldfish Model)、带角色的 agent 团队(BMAD Method)、带上下文工程的先规划后执行(Claude Code 的 plan mode 和 CLAUDE.md),以及测试优先——即用失败的测试作为规格。Vibe coding 用于原型没问题;生产工作需要经过评审的规格、agent 能运行的检查,以及人工签字确认。
规格驱动开发在短短一年多时间里就成了一个拥挤的工具品类。GitHub、AWS 和许多开源项目都推出了自己的版本,而“AI 软件工厂”也成了把这些步骤串联起来的说法。本指南按方法而非按工具组织,因为工具每隔几周就变,而方法不变。工具细节截至 2026 年 11 月 17 日准确。
Vibe coding 与规格驱动开发:vibe coding 在哪里失效
Andrej Karpathy 在 2025 年 2 月创造了“vibe coding”一词,指的是一种“忘记代码的存在”的风格,他称其“对于一次性的周末项目来说还不错”。这一点至今仍成立。对于原型、内部脚本或可点击的演示,跟 agent 聊到能跑通,是花一个下午的合理用法。
真实项目在四个方面有所不同:
- 需求存在于聊天记录里。下一次会话、下一位开发者和客户都看不到它们。
- agent 用看似合理的猜测填补空白。BMAD Method 的 README 说得很到位:编码助手“常常把未言明的假设变成代码”。
- 没人能评审意图。评审者看到的是 diff,而不是这个 diff 本该实现什么。
- agent 自己给自己打分。Anthropic 的 Claude Code 指南指出,agent“在工作看起来完成时就停下来”,而看起来完成并不等于完成。
这些都不是新问题。这就是我们需求 elicitation 大师课里讲过的期望差距。agent 只是让团队更快地掉进这个坑。
什么是规格驱动开发?
规格驱动开发(SDD)是一种与 AI 编码 agent 协作的工作方式,其中在实现开始前达成一致的书面规格是唯一事实来源。agent 依据它构建,评审者依据它检查工作,当代码和规格不一致时,由人来决定改哪一个。
Thoughtworks 的 Birgitta Böckeler 描述了三个层级:
- 规格优先(Spec-first):为当前任务编写规格,代码存在后通常就搁置了。
- 规格锚定(Spec-anchored):规格被保留下来,并随功能演进而更新。
- 规格即源(Spec-as-source):人类只编辑规格,代码由规格重新生成。
她 2025 年 10 月写作时,几乎所有工具都是规格优先。现在有几个工具瞄准规格锚定,配有活规格和漂移检查,而规格即源被证明最难实现。其基本理念很古老:测试驱动开发、行为驱动开发以及一份好的产品需求文档,都把“做什么”放在“怎么做”之前。变化的是读者。如今规格必须服务于一个从未参加过你任何会议的 agent。
AI 软件工厂的定位
“AI 软件工厂”被用得很随意,主要出现在厂商营销中。大多数定义都收敛到一种运营模式:agent 处理交付中离散的步骤(分诊、编码、评审、测试),而人来定义意图并验证结果。Unblocked 的一份买家指南称瓶颈“向上游转移到规格和验证”,BCG Platinion 则称这一变化是“人类工作的重新配置”而非消除。Böckeler 测试过的规格即源工具 Tessl,此后以“一次一个技能,构建你的软件工厂”这一口号重新定位。
像 {{NAME_ab12cd34}} 这样书写的值是真值的占位符。在回复和工具调用中都完全按原样使用它们:它们会在任何东西运行之前被填入真值。不要要求验证它们,也不要用示例替换它们。
无论你把这个流水线叫什么,规格说明都是它的入口。给工厂喂一个含糊的提示词,产出的软件也同样含糊,只是速度更快。
规格驱动开发的五种方法(截至 2026 年 11 月)
1. 规格先行:先写需求、设计和任务,再写代码
怎么运作。 你用自然语言描述功能。智能体把它转成需求,再转成技术方案,再转成任务列表,每一步生成之前都由你审核。只有到这时,智能体才开始实现任务。
- GitHub Spec Kit 是 GitHub 推出的 MIT 许可工具包(约 15 万星)。它的核心流程是先做一次性的项目「宪法」来确立原则,然后为每个功能依次执行 specify、plan、tasks、implement 和 converge,其中 converge 会拿代码对照规格检查,并把遗漏的工作加回任务列表。它集成了 40 多个编码智能体,包括 Claude Code、GitHub Copilot、Codex CLI、Gemini CLI 和 Cursor。
- Kiro 是一套智能体工程系统,包含 IDE、CLI 和 Web 应用,其网站称它「由 AWS 构建并运营」。它的规格依次经过需求(带验收标准的用户故事)、设计和任务,分别保存为 requirements.md、design.md 和 tasks.md。它还提供缺陷修复规格,以及一种「Quick Spec」,可以不经审批关卡直接生成这三个文件。
- OpenSpec 出自 Fission-AI(MIT 许可,约 7.5 万星,2.0 版于 2026 年 11 月 11 日发布),它把每次变更放在单独的文件夹里,包含提案、规格、设计和任务,构建完成后归档进长期维护的 specs。它把自己定位为比 Spec Kit 更轻量,并且同时面向已有代码库和新项目。
适用场景。 中型或大型功能,尤其是客户需要在花钱之前先确认范围的时候。
薄弱之处。 仪式感太重。在 Böckeler 的测试中,Kiro 把一个小缺陷变成了四个用户故事、16 条验收标准,她还觉得 Spec Kit 那一堆 Markdown 文件审起来很累。智能体也不总是遵循给它的规格,所以你仍然需要评审和测试。
2. 全新上下文评审:大象-金鱼模型
怎么运作。 大象-金鱼模型(EGM)把工作分给记忆差异极大的两类智能体。「大象」是一个长期会话,掌握项目上下文,和你一起起草规格。「金鱼」评审员是全新的智能体,它们只看文档和文档引用的代码,看不到任何对话。如果规格只有参与过聊天的人才看得懂,金鱼就会卡住,于是那些没说出口的假设就暴露出来了。你决定哪些发现值得处理,并在智能体动手实现之前批准设计。
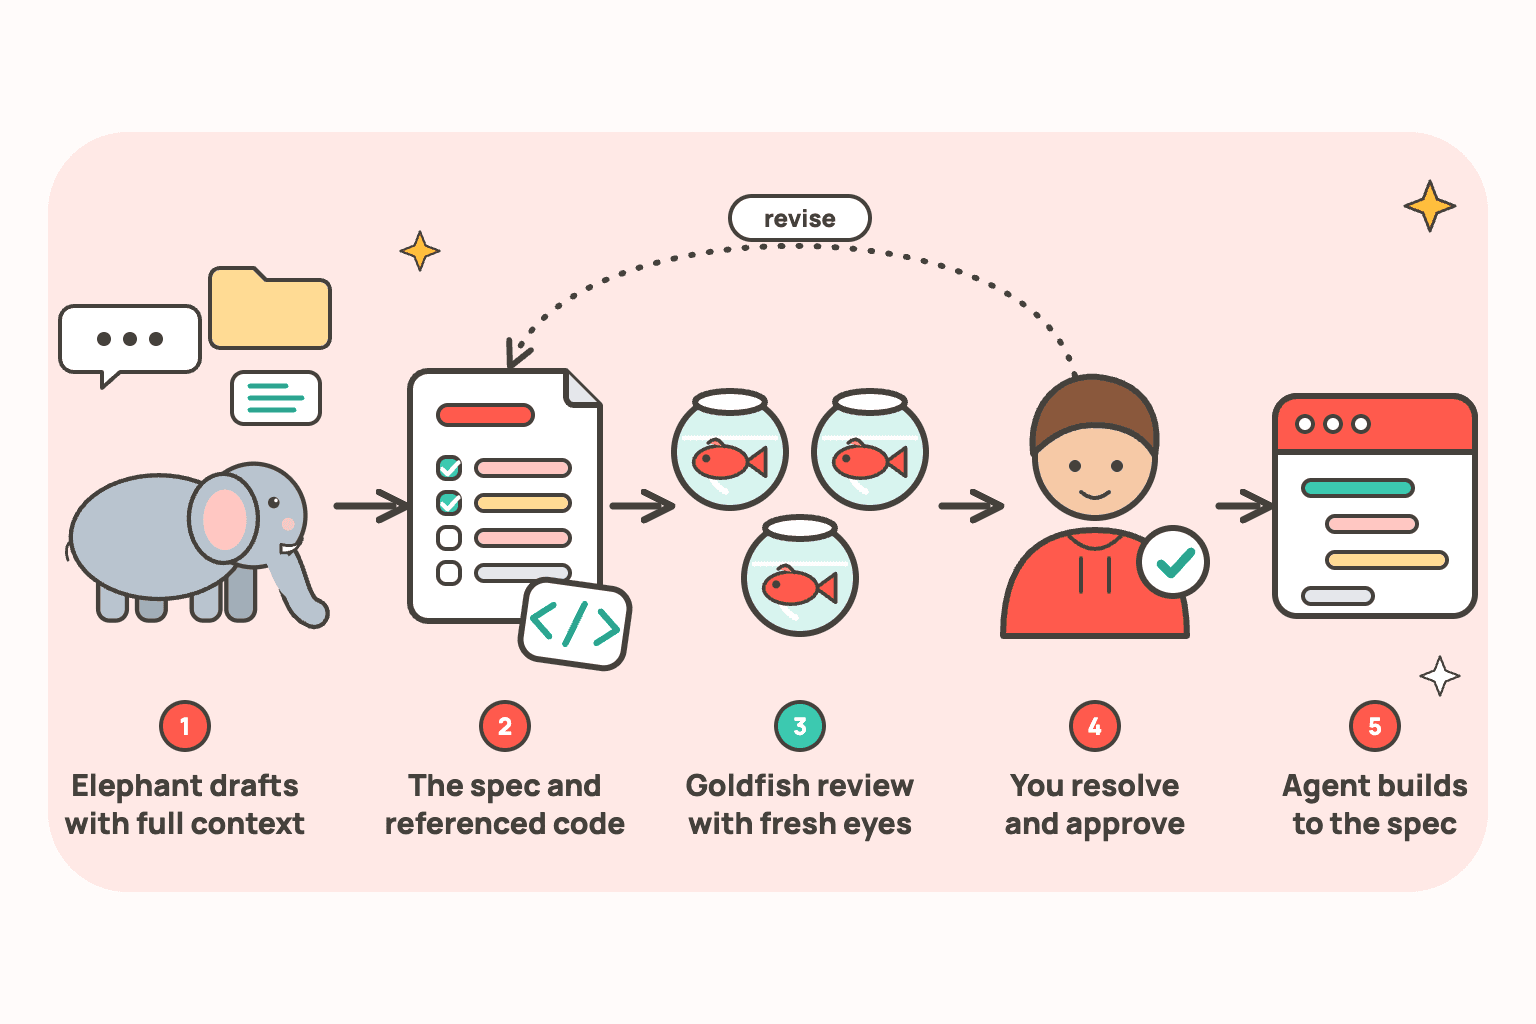
工具。 EGM 是一个 Apache 2.0 插件,于 2026 年 9 月在 Google 的 GitHub 上开源,约有 2 万星。其 README 声明它不是 Google 官方支持的产品。它源自 Dave Rensin 2026 年 4 月的文章,该文主张设计文档应当成为人类拥有的主要产物:「通过金鱼测试的文档,会成为抵御垃圾内容的重要防线。」该插件可运行在 Claude Code、Codex CLI、ChatGPT 和 Codex 桌面应用、Antigravity 和 Claude Cowork 中。它的技能涵盖头脑风暴、逐节起草、五阶段评审(简洁性、可理解性、设计批判、第二轮简洁性检查和实现就绪度)以及处理发现的问题。其中两个可以单独使用:bootstrap 为已有代码库自下而上地生成 README 文件,drift report 把设计文档与当前代码做对比,最好每周运行一次。
适用场景。代价高昂的设计决策、对话之外的人必须依赖的规格,以及文档已经腐烂的现有代码库。
薄弱之处。它需要一个能够生成新的子代理的代理,而审查会消耗 token 和时间,并且按设计会产生大量反馈,你必须对这些反馈进行分诊。它规定设计阶段不接触生产代码,正如架构说明所承认的,这是一条没有任何机制强制执行的约定。
3. 带角色的代理团队:BMAD Method
工作原理。你不是使用一个通用代理,而是与模仿交付团队的具名角色协作。在 BMAD Method 中,这些角色是分析师、产品经理、产品负责人、UX 设计师、架构师和开发者,每个角色都有自己的产物,从简报和 PRD 到 epic、story 和架构文档。一个“派对模式”允许多个角色讨论一份草稿。工作按变更规模来定,因此琐碎的编辑会跳过规划,而项目级的工作则会走完整流程。
工具。BMAD Method 免费且采用 MIT 许可证(约 55,000 颗星)。截至 2026 年 11 月,版本 6.12 是稳定线,版本 7 处于预览 alpha 阶段,因此预计会有变化。
适用场景。尚无简报或 PRD 的新产品,以及希望在写代码之前被推着回答产品问题的独立创始人。这与我们在自己的工作室中给 AI 代理分配角色的直觉相同。
薄弱之处。角色是提示词,而不是独立的专业知识。Anthropic 的 Claude Code 指南指出,子代理默认是在同一任务上使用同一模型,给你“一双新鲜的眼睛”,但“不是更聪明的答案”。这些文档仍然需要一个了解业务的人来批判性地阅读。
4. 先规划后执行与上下文工程
工作原理。这是最轻量的方法,许多开发者已经在使用它而没有命名。代理探索代码库并写出一份计划,你修正计划,然后它才编辑文件。围绕这个循环的是上下文工程,Anthropic 将其定义为精心策划模型看到的“最优 token 集合”:项目记忆文件、聚焦的会话以及代理之后可以重新加载的笔记。
工具。在 Claude Code 中,计划模式允许代理读取文件并运行命令,但在你批准计划之前阻止编辑。Anthropic 的最佳实践建议让代理采访你,直到它能写出规格,将其保存到文件,并在新会话中基于它进行构建。该指南还建议保持 CLAUDE.md 简短,只保留代理无法从代码中推断出的内容,并将零例外的规则移入 hooks 和权限规则。对于审查,其 /code-review 命令会在一个从未见过你对话的新子代理中检查 diff,这就是内置于工具中的金鱼理念。
适用场景。在熟悉的代码库上进行日常功能开发和修复,由审查结果的开发者使用。
薄弱之处。它依赖于纪律。计划通常存在于会话中,因此除非你保存它,否则它充其量只是规格优先,下周就消失了。
5. 测试优先:以失败的测试作为规格
工作原理。你编写,或让代理编写,描述你想要的行为的测试。你确认它们失败,然后代理只编写足够的代码使它们通过。测试套件是机器可以检查的规格,这弥补了“看起来完成了”的差距。
工具。无需特殊工具。Kent Beck 的文章 Augmented Coding: Beyond the Vibes 描述了用一个代理构建 B+ 树库,该代理遵循严格的红-绿-重构规则,一次一个测试,而他则留意循环、未请求的功能以及被禁用或删除的测试。Anthropic 的指南对无人值守运行提出了同样的观点:给代理“一个它必须变绿的失败测试”。
适用场景。业务规则、计算、库、数据转换和 bug 修复,这些场景中对与错很容易陈述。
薄弱之处。测试捕捉的是行为,而非意图或架构,而用户体验也很难用测试来表达。智能体还可能削弱或禁用测试,而不是修复代码——这正是 Beck 所警惕的,因此测试也需要人工审查。我们关于非功能性测试的文章涵盖了功能性测试所遗漏的内容。
哪种规格驱动开发方式适合你的项目?
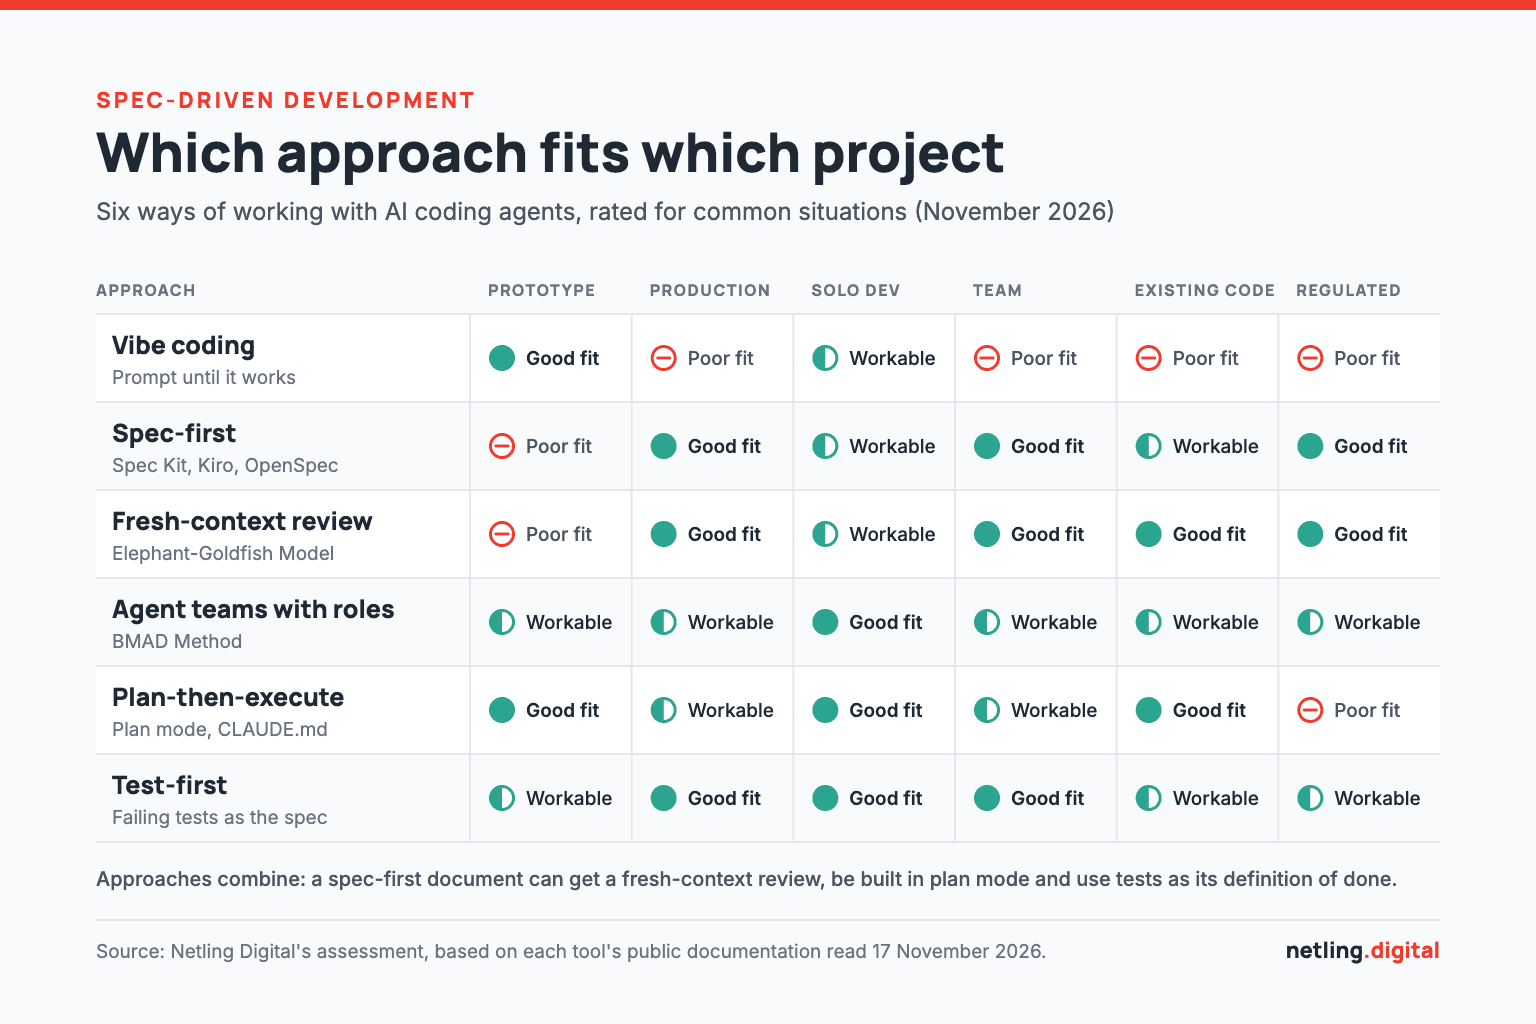
这些方式相互结合而非相互竞争。你可以先写一份规格先行文档,让它接受全新上下文审查,在计划模式下实施,并以测试作为完成标准。我们的粗略指南:
- 原型或演示:vibe coding 或普通的计划模式。如果想法经得起考验,在重建之前先写规格,正如我们的 MVP 指南所述。
- 即将投入生产的产品:每个功能一份规格先行文档,由人工审查,并以测试作为验收标准。
- 独立开发者:先计划后执行加测试。只有当功能跨越多个会话时,才加入规格先行工具。
- 团队:规格先行或全新上下文审查,将规格存放在仓库中,让人类和智能体阅读同一份文档。
- 现有代码库:先记录现有内容(EGM 的 bootstrap、BMAD 的现有代码库路径、OpenSpec 的变更文件夹),然后运行漂移检查。我们的遗留系统现代化文章解释了为什么这一发现步骤很重要。
- 受监管或高风险工作:规格先行加审批关卡、全新上下文审查,以及每个阶段指定的人工签核。例如,Spec Kit 预设可以要求在计划中体现监管可追溯性。
我们在 Netling 的工作方式
我们的团队使用 Claude Code。在客户项目中,在 AI 编写任何代码之前,书面规格由人工起草并批准。你可以在我们的开发流程和 Build 服务中看到这一步的位置。
有些工作绝不单独交给 AI:
- 安全敏感的代码,包括身份验证、支付和权限。
- 合并,始终等待人工代码审查。
- 数据库迁移以及任何涉及生产数据的工作。
- 架构决策:技术栈、数据模型以及服务边界的位置。
我们还提供加入你团队的专属开发者:React 和 Next.js 开发者、NestJS 开发者或 Nuxt 开发者。
常见问题
规格驱动开发是 vibe coding 的对立面吗?
不完全是。Vibe coding 跳过书面规格,以结果看起来是否可行来评判,而规格驱动开发先商定规格,再对照规格检查代码。你可以用 vibe coding 做原型,然后在想法值得正式构建时切换。
什么是 AI 软件工厂?
一个非正式术语,指一种交付流水线:AI 智能体处理编码、审查和测试等步骤,而人类定义要构建什么并验证结果。规格驱动开发是它的入口:没有清晰的规格,工厂只会更快地构建错误的东西。
我需要 Spec Kit 或 Kiro 这样的工具吗?
不需要。仓库中的 Markdown 规格、计划模式下的编码智能体以及一组失败的测试就涵盖了核心理念。专用工具增加了结构性和可重复性,这对团队和较大的功能最有帮助。
什么是 Elephant-Goldfish 模型?
一个开源插件,发布在 Google 的 GitHub 上,但并非 Google 官方支持的产品。在该模型中,一个上下文丰富的“大象”智能体起草规格,全新的“金鱼”智能体在看不到对话的情况下进行审查。在编写任何代码之前,由人工批准规格。
规格驱动开发只是瀑布模型的翻版吗?
如果一开始就把整个产品定义清楚,这确实可行。用得好时,它按功能逐个推进:一份简短规格、一次评审、一次实现和一次规格更新,在正常的敏捷交付中每隔几天重复一轮。
最后思考
规格驱动开发与其说取决于某个工具,不如说取决于思考发生在哪里。如今代理编写代码的速度已经超过人类阅读代码的速度,因此人的工作转向决定要构建什么、清楚地写下来并检查结果。选择最轻量的方法,确保有一份经过评审的规格、一个代理可以运行的检查,以及一个签字确认的人,并随着项目和团队成长逐步增加结构。
如果你正在规划一个产品,并且希望有一个在写代码之前先写规格的团队,请向我们发送项目简介或与我们联系。
分享这篇文章
觉得有用?帮助其他人发现它。