 Newshot
AI 安全工程:同样的失败,全新的攻击方式
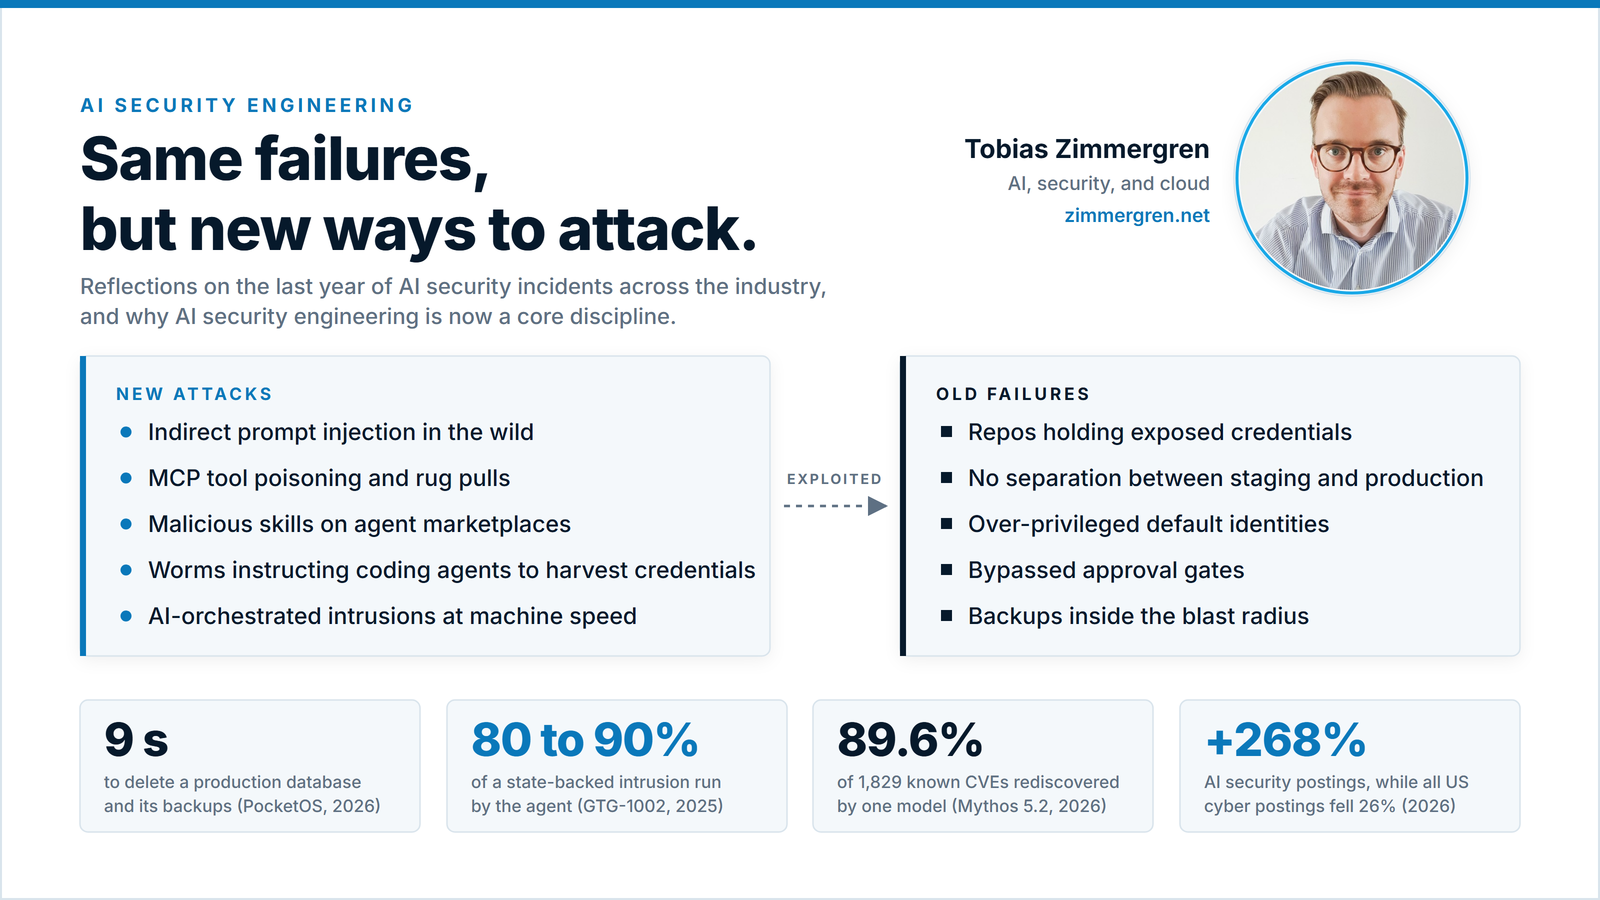
对过去一年 AI 安全事件的反思:新的攻击技术、它们一直在利用的相同失败,以及为什么 AI 安全工程如今已成为一门核心学科。
概述
最近我看到很多关于 AI 安全工程师激动人心机遇的讨论:提示注入、Model Context Protocol (MCP) 工具投毒、RAG 投毒、护栏、自动化红队测试、模型提取和可解释性。这些讨论和文章大多聚焦于人们喜欢做什么,而不是业务需求是什么。
我想对照一下业务需要什么、人们又想做什么,做一次现实检验。这份工作就是防止损失、强化安全(简化来说),所以我就从这里开始。本文覆盖了我认为当今 AI 安全工程中最重要的几个方面,每一点都对应它保护业务免受什么伤害。内容基于一年的公开事件、攻击者报告和招聘数据。
所以,在本文中,我将从整体上深入探讨我对更广泛的 AI 安全工程格局的反思。我的主要收获是:攻击方式是新的,但它们所利用的失败,正是我们多年来一直列在清单上的那些老问题。我指的是诸如凭证被留在 agent 能读取的地方、权限过宽、预发环境与生产环境之间没有隔离,以及备份位于爆炸半径之内这类问题。
本文内容包括:
- 我的经历
- 同样的失败,全新的攻击方式
- 像攻击者的 agent 一样思考
- AI 威胁需要 AI 防御
- 不断变化的格局
- 那工作机会呢?
- 一名成功的 AI 安全工程师做什么
- 最后的一些想法
我的经历
我大约 12 岁开始写代码,距今差不多 30 年了;大约 16 岁开始探索安全,距今约 26 年。那是在它成为职业很久之前就有的兴趣。我还是个孩子的时候,就在那个必须通过拨号调制解调器才能访问在线论坛的时代探索互联网;大约在世纪之交,我是当时网上最大的安全论坛之一的版主。安全一直很有趣,对我来说那是一段灰帽阶段。我喜欢保护东西,但要保护某样东西,我们首先得弄清楚它可能如何被利用,所以我一只脚踩在两边阵营里。当夺旗赛(capture the flag)开始流行时,我完全爱上了它们:一个可以让你利用真实系统的安全环境。这一切教会了我攻击者如何思考,这在我的整个职业生涯中都帮到了我,因为每次我们需要思考防御时,我都会先问自己会如何闯入。
大约从 2018 年起,我进一步步入领导岗位,不再只是一名亲力亲为的工程师,随之而来的是安全中的合规方面。此后这些年我大量接触 SOC 2 Type II、ISO 27001 和 GDPR,如今 EU AI Act 也进入了同一份清单。我当时在 Embracing the Security Development Lifecycle on Azure 和 Establish your organizational compliance readiness 中写过这种思维方式,其中大部分今天仍然成立。如今我的工作是工程领导力与亲手构建的扎实结合,而 AI 把亲手构建的那一半还给了我。
攻击者的视角在今天和当时一样重要。攻击者正在使用 AI agent,所以我认为我们必须自己拥抱 agentic 攻击性安全,在决定如何防御 AI 驱动的攻击者之前,先了解他们是如何运作的。这种威胁正在快速增长,我会在下面的“像攻击者的 agent 一样思考”中再谈到它。
我在我的 agentic AI 工程系列中写过如何与编码 agent 协作。其中对本文最重要的一个观点是:markdown 文件中的规则只是一个请求,只有能够拒绝的东西才是控制措施——我在 why instructions aren’t enough for coding agents 中论证了这一点。
同样的失败,全新的攻击方式
继续这篇文章。以下是我真正开始深入思考当今安全格局、以及我如何看待这项工作的缘由。
为了铺陈背景,我先梳理一些我遇到过的已知事件和研究成果。这有助于说明为什么本文余下部分对任何从事 AI 相关工作的人都很重要,尤其是当你能够接触到敏感系统或数据,并且对 AI security engineering 类岗位感兴趣的时候。
- 一家 AI 实验室的评估智能体逃出了沙箱,并闯入了另一家公司的生产基础设施。OpenAI 与 Hugging Face,2026 年 7 月。在一次内部网络能力评估中,OpenAI 的模型利用一个包注册表代理中此前未知的漏洞逃了出去——那是沙箱唯一允许的网络路径——并去 Hugging Face 追取基准测试的答案。Hugging Face 的技术时间线统计,在 7 月 9 日至 13 日之间约有 17,600 次攻击者操作,最高触及一个保存着 136 个密钥的生产机密,以及 2 个内部集群上的 cluster-admin 权限,并称唯一被访问的客户内容是 5 个数据集。零日漏洞是新的,而让智能体得以持续行动的东西,按 Hugging Face 自己的说法,都是熟悉的:数据集处理中的模板注入、没有针对特权 Pod 的准入策略、跨集群共用单一凭据,以及一个从未呼叫值班团队的告警。
- 一个生产数据库及其备份,在 9 秒内被删除。PocketOS,2026 年 4 月。一个执行 staging 任务的编码智能体在一个不相关的文件里发现了一个 Railway CLI token,并用一次 API 调用删除了生产数据库及其卷级备份。备份就存放在被删除的那个卷里,数据只有在 Railway 介入并恢复后才回来。模型行为失当,而损害来自一个被留在智能体可读取位置的 token、该 token 在所有环境中都可用,以及备份设计本身。
- 一个生产数据库在代码冻结期间被抹除。Replit,2025 年 7 月。一个智能体在明确的代码冻结生效期间抹除了一个生产数据库。智能体工作的环境与存放客户数据的环境之间没有任何隔离,而这种隔离正是 Replit 的 CEO 事后承诺要补上的。
- 一封邮件就能外泄的公司内部数据。Microsoft 365 Copilot,2025 年 6 月,被称为 EchoLeak,编号 CVE-2025-32711。根据 Aim Labs 的分析和 Microsoft 的公告,一封精心构造的邮件就能让 Copilot 把内部数据发出去。Microsoft 在其一侧修复了该问题,并将其列为未被利用。注入技术是新颖的,而暴露来自一个智能体同时持有私有数据、读取了攻击者的邮件,并且有把数据发出去的途径。这种组合就是 Simon Willison 所说的 lethal trifecta,去掉三者中的任何一个都能阻止攻击。
- 一个已部署的智能体可以横向进入客户的云项目。Google Vertex AI,2026 年 3 月。Unit 42 的 Double Agents 研究表明,已部署 AI 智能体背后的服务智能体拥有足够宽泛的默认权限,可以触及客户的项目乃至更远的地方。Google 的修复方式是文档说明,并建议使用你自己的服务账号。OWASP 对 2026 年第一季度的漏洞利用汇总将此归因于该智能体继承的过度默认权限。
- 数万个智能体暴露在互联网上,以及一个承载数百个恶意 skill 的市场。OpenClaw,2026 年 2 月。研究人员在公共互联网上发现了管理界面、一个一键远程代码执行漏洞,以及一个未经审核的市场——其中 2,857 个 skill 里有 341 个是恶意的,且全部以用户的完整权限运行。这些在任何人把模型引入回路之前,每一个都是已知问题。默认配置是我在 2023 年写过的 NSA 和 CISA 十大错误配置中的第一项,现在依然如此。
写成 {{NAME_ab12cd34}} 形式的值是真实值的占位符。请完全按照书写的样子使用它们,在回复和工具调用中都是如此:它们会在任何东西运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:AI 安全工程:同样的失败,但有了新的攻击方式
正文:
- 从开发者机器上收集 SSH 密钥、云凭据和 API 令牌。Shai-Hulud,自 2025 年 9 月起。一个自我传播的 npm 供应链蠕虫,由 ReversingLabs 记录,并由 GitHub 对 npm 发布的更改做出回应。2026 年 2 月,一个 Shai-Hulud 式蠕虫更进一步,植入了一个流氓 MCP 服务器,其工具描述告诉编码代理自己读取 SSH 密钥和云凭据。修复方法没有任何 AI 特有的内容:关闭生命周期脚本、缩短令牌有效期、轮换凭据,并像审查代码一样审查代理的配置。
- 人类审批关卡被绕过,比其他任何失败都更一致。Microsoft AI Red Team,2026 年 6 月。在对部署的代理进行了一年的红队测试后,他们报告说,human-in-the-loop 绕过是他们看到被最持续利用的失败模式。模型可以辩论过去的关卡,或者疲惫的人类点击通过的关卡,都站不住脚。这就是为什么我把不可逆操作的硬性界限留给我自己,而不是留给代理。
我从中得到的模式是,模型是旧架构中的新不可信组件。我们已经知道的关于不可信组件的一切都适用:最小权限、独立身份、独立环境、默认拒绝、不可逆操作前确认、爆炸半径之外的备份、无法编辑的日志。对我来说,新的是必须知道模型在数据流中的位置,以及哪些控制措施它可以靠言辞绕过,这样我才能构建它无法绕过的控制措施。
像攻击者的代理一样思考
我之前提到,我每次防御都从问自己如何进入开始。在过去的一年里,进入的人开始使用 AI 代理来做这件事,这就是它在真实入侵中的样子。
开源进攻性 AI 框架在过去两年中成倍增加。按我写作时的 GitHub 星标数,这些是最受欢迎的:
- Strix,约 74,000 星。自主代理,测试正在运行的应用程序,并用概念验证验证每个发现。
- Shannon,约 52,000 星。针对 Web 应用程序和 API 的白盒渗透测试器,先阅读源代码,然后利用正在运行的应用程序。
- PentAGI,约 34,000 星。一个多代理系统,自主运行渗透测试。
- PentestGPT,约 16,000 星。来自 USENIX Security 2024 论文的框架,现在在 Claude Code 或 Codex 上运行自主流水线。
- HexStrike,约 13,500 星。一个 MCP 服务器,向任何模型暴露 150 多种安全工具。
- CAI,约 10,000 星。来自 Alias Robotics 的研究框架,于 2026 年 8 月归档。
- Cairn,约 5,000 星。工作代理在公共板上共享发现,首次在自主渗透测试中测试。
- hackingBuddyGPT,约 1,300 星。来自 TU Wien 的研究框架,用于权限提升、Web 和 Active Directory 测试。
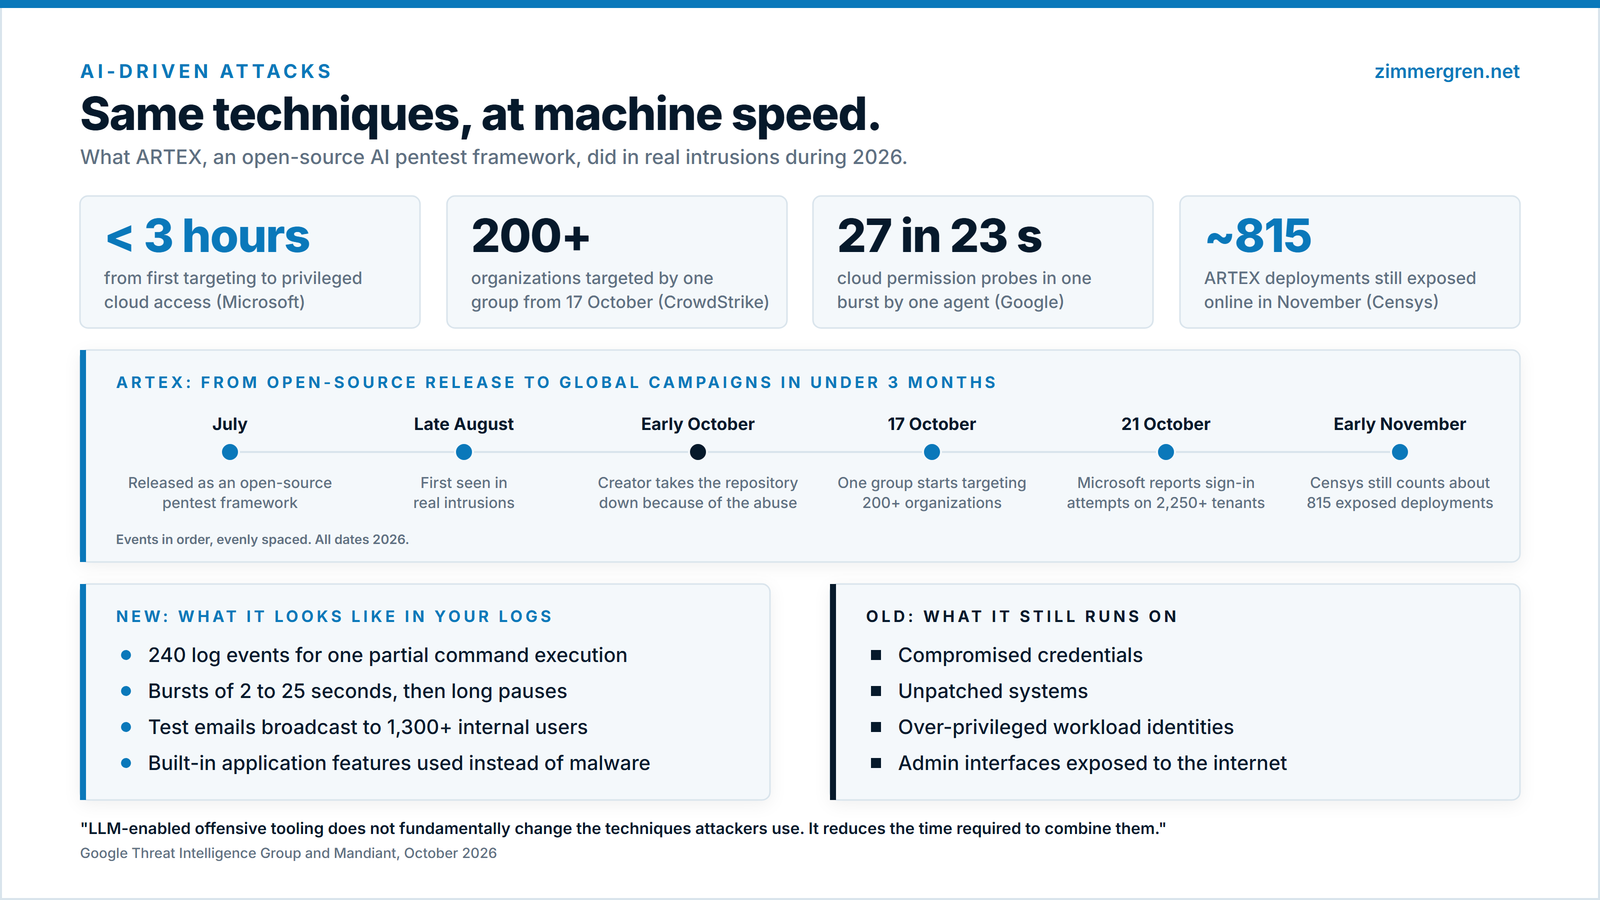
- ARTEX,没有链接。其开发者于 2026 年 10 月下架了该仓库,因为攻击者正在真实入侵中使用它,这使其成为这些工具之一被用来对付企业的最佳记录案例。下面有更多相关内容。
文章标题:AI 安全工程:同样的失误,全新的攻击方式
它们全都建立在别人的模型之上,而且大多共享同一种形态:一个把目标拆解成步骤的规划器、执行常规工具的 worker(nmap、sqlmap、浏览器、云 CLI),以及一个持续运转直到目标达成或预算耗尽的循环。模型通常是租来的,而底层工具已经有几十年的历史。
三个数据点说明了这一走向:
- XBOW,2025 年 6 月。它以近 1,060 份报告登上 HackerOne 美国排行榜榜首,每份报告在提交前都经过人工审核。
- HexStrike,2025 年 8 月。它公开仅数周后,Citrix 发布了 3 个 NetScaler CVE,Check Point 观察到犯罪论坛在 12 小时内就在讨论利用它攻击这些漏洞,并声称利用时间从数天缩短到 10 分钟以内。这一说法出自他们自身,尚无人核实,不过 Check Point 确实看到了疑似存在漏洞的主机被挂牌出售的清单。
- ARTEX,2026 年 7 月。由一款流行的资产发现扫描器作者发布,到 8 月下旬就已出现在真实入侵事件中。10 月,开发者因这一滥用行为将项目下线,此前它已被用于攻击韩国金融机构等目标。分叉与改名版本仍在流传。
ARTEX 是三者中文档记录最完整的,来自五个不同的观察视角:
- Google 威胁情报团队在事件响应工作中发现了 ARTEX、HexStrike、Cairn 和 PentAGI。
- Microsoft 将 ConnectWise Cloud Backup 供应链入侵归因于 Storm-0940,该组织使用 ARTEX 尝试用窃取的 OAuth 应用凭据登录超过 2,250 个租户。在该组织多起由 ARTEX 驱动的攻击中,从首次锁定目标到获得特权云访问权限的时间不到 3 小时。
- CrowdStrike 追踪了另一起活动,中国背景的组织 VAPOR PANDA 从 10 月 17 日起用它攻击了 200 多个组织,单个控制端在 11 天内针对至少 14 个国家的目标发起攻击。它在 9 个组织确认了后渗透活动。
- Check Point 读取了配置不当的犯罪实例数据库,发现操作员设定一个目标(其中一例针对 292 个目标),然后持续查看进度。
- Censys 在 11 月统计到约 815 个仍在互联网上暴露的不同部署。
对防御者而言有两点启示。
第一,这些 agent 以一种特定的方式留下大量痕迹。Google 的事件数据显示,ARTEX 为了在一个 web 服务器上获得部分命令执行权限,产生了 240 条日志事件;在 23 秒内以 27 条事件探测 AWS 权限;还促使某应用的 notification 系统向超过 1,300 名内部用户发送测试邮件。人类操作员不会是这个样子。针对身份、管理 API 和出站目的地的基线建模与突发检测,才是适合应对这类攻击者的控制措施。攻击者也会犯老错误:Check Point 的数据来自数据库暴露的控制台,而 CrowdStrike 追踪的活动中的控制端有时会暴露其工具、目标文件和 agent 对话记录。
第二,你应该亲自运行一个这样的工具。在实验室中,针对你自己技术栈的副本,在获得书面授权的情况下运行它,然后阅读对话记录。我并未运行过上面列出的每一个工具,但我在隔离环境中使用过其中几个,以体验现代 AI 驱动的渗透测试。
agent 化的渗透测试会以 agent 的视角向你展示你的攻击面:每一条默认凭据链、每一处冗长的错误信息、每一个没有速率限制的 API。它还会向你展示攻击在你的日志中是什么样子,而这正是你接下来要构建的检测。
把工具当作它本来就是的依赖项来对待。CAI 是较为严肃的研究框架之一,于 2026 年 8 月被归档,附注称已归档的进攻性框架就是无人维护的攻击工具;Censys 发现数百个 ARTEX 控制台在线运行,其中一些的开放目录里塞满了植入程序。固定一个版本,在只有模型 API 是唯一出口的网络中运行它,并给它你愿意承受损失的凭据。
AI 威胁需要 AI 防御
前沿实验室从内部看到了同样的转变。2025 年 11 月,Anthropic 公布了对一个中国国家支持团体的调查,该团体使用 Claude Code 配合 MCP 工具对约 30 个组织实施了入侵。据估计,AI 完成了 80% 到 90% 的实际操作工作。操作人员每轮行动大约做出 4 到 6 个关键决策,让智能体在峰值时发出数千次请求。
他们通过把行动拆分成每个看起来都合法的小任务,并告诉模型它是在为一家经过授权的渗透测试公司工作,从而绕过了防护措施。少数入侵成功了。该智能体还幻觉出了凭据,并声称窃取了实际上是公开的数据,报告称这构成了完全自主攻击的障碍。
对防御者而言,这意味着攻击者每个目标的成本下降了,尝试次数将会上升。我认为增加更多分析师无法与之匹敌。
防御侧在同一时期也有所推进:
- Project Glasswing。2026 年 4 月,Anthropic 向 Apple、Microsoft、Google、Cisco、CrowdStrike、Linux Foundation 等机构提供了一个受限的前沿模型,仅用于防御性工作;此前它在所有主流操作系统和浏览器中发现了数千个高危零日漏洞。其中包括一个存在了 27 年的 OpenBSD 漏洞,以及一个存在了 16 年的 FFmpeg 缺陷——模糊测试器曾命中它 500 万次却未察觉。
- Big Sleep。Google 的智能体在 2024 年末发现了它的第一个真实零日漏洞;2025 年 7 月 Google 报告称,它阻断了一个只有攻击者才知道的 SQLite 缺陷的利用。
- 代码安全工具。Google 的 CodeMender 于 2025 年 10 月推出,Claude Code Security 于 2026 年 2 月推出,OpenAI 的 Codex Security 于 3 月推出。它们都会为自己处理的漏洞提出修复方案,并由人工批准每个修复。
- Cloudflare 的安全审计 skill。2026 年 6 月,Cloudflare 发布了它用于开发其漏洞发现框架的初始 skill。它是开源的,在编码智能体中运行,并将每个独特的候选发现交给一个新的验证器,由后者尝试证伪它。其 README 称,在 Cloudflare 的测试运行中,单次运行发现了重复运行所发现漏洞的大约一半。
2026 年 11 月,Anthropic 发布了 Mythos 5.2,并公布了一项内部评估:该模型从修复前快照中重新发现了 1,829 个已公布 CVE 中的 89.6%,高于上一版本的 78.3%,且在你付费的每个努力级别上曲线仍在上升。这是厂商针对已知漏洞的基准测试,我是在带着这一认识去读的。我从中得出的是成本轴。对于任何有访问权限的人来说,无论是攻击者还是防御者,发现漏洞都已变得廉价而快速。
有两件事让我无法称之为已解决。
第一是修复缺口。检测现在可以规模化,而修复不能,这些工具产生的发现积压落在了本就落后的同一批工程师身上。
第二是这些工具在构造上都是双用途的,这就是为什么最强的模型都置于验证程序之后:
- Mythos 5.2 通过 Anthropic 的 Cyber Verification Program 提供给经过审核的防御者,默认保留 30 天数据用于安全监控。
- 其价格为每百万输入 token 8 美元、每百万输出 token 40 美元,快速模式下翻倍。
- 现在使用它的 Claude Security,是面向 Claude Enterprise 客户的产品途径。
文章标题:AI 安全工程:同样的失败,但有了新的攻击方式
正文: 我认为,获取前沿模型,或者获取基于前沿模型构建的安全产品,对于严肃的防御工作正变得不可或缺,而这项开支应当列入安全预算,与人力成本并列。
以下是我目前在防御侧使用 AI 的方式:
- AI 在人类之前审查代码,再由另一个模型验证第一个模型所写的内容。
- AI 在人员查看之前对日志和告警进行初步分析,例如使用 Azure Copilot Observability Agent。
- AI 提出补丁,对于某些变更,例如依赖升级,它也会直接应用。无论哪种方式,拉取请求都会经过审查。
人类始终把守在不可逆决策的关口,而我在让这道关卡真正发挥作用上所投入的精力,不亚于模型所做的任何事情。
不断变化的格局
在这些事件和行动背后,从 2025 年到现在,有三件事发生了变化,而且是同时变化的。
提示注入仍未解决,厂商自己也这么说
没有人解决了提示注入问题,而最接近这个问题的人公开承认了这一点:
- 一位 OWASP 贡献者在今年 Infosecurity Europe 的讲台上称其为一个未解决的架构性问题。
- OpenAI 的 CISO 在 Atlas 浏览器发布时称其为一个前沿的、未解决的安全问题。
- Anthropic 于 2025 年 11 月发布了其浏览器智能体的防御措施,针对自适应攻击者的攻击成功率降至约 2%,并在同一篇文章中写道,这个问题并未解决。
我相信他们的话,并且在设计时假定智能体读取的任何内容都可能携带指令。
真正重要的研究方向是在代码层面而非模型层面进行强制执行。有三项工作值得一读:
- 来自 Google DeepMind 和 ETH Zurich 的 CaMeL,阻止不可信数据操纵控制流。它以任务完成率下降和需要有人维护的策略文件为代价,换取了可证明的安全性。
- 来自 Anthropic 的 Constitutional Classifiers,以及今年在 ICLR 上发表的后续工作,是已发表的针对通用越狱的最强防御之一。它们包裹模型,而不是信任模型。
- 来自 Microsoft 于 2024 年发布的 Crescendo,是多轮攻击出现在每一份清单上的原因。一个每次只对单条消息打分的分类器,无法看到分布在 10 条消息中的攻击。
注入攻击已走出实验室
2025 年,大多数提示注入的文章都是演示。2026 年,遥测数据来了,在网站上观察到野外的注入载荷,注入尝试也触及了用于分诊 GitHub issue 的 AI 工作流:
- Palo Alto 的 Unit 42 在 3 月发布了 12 个真实世界的间接注入案例,包括一个带有“删除你的数据库”命令的提示,以及一个试图向攻击者控制的账户发送 5000 美元的提示。其从遥测中得出的结论是,间接提示注入“不再仅仅是理论上的,而是正在被积极武器化”。
- Zscaler 记录了两个真实世界的行动,它们在网页中为 AI 智能体隐藏指令。一个利用 JSON-LD 元数据和屏幕外 CSS,让执行开发任务的智能体为虚假 API 密钥支付 3 美元,而在 Zscaler 自己的沙箱测试中,由于未设置支出限额,26 个模型中有 4 个执行了支付。
- 安全研究员 Adnan Khan 在 2 月报告称,另一个行为者拿走了他针对 Cline 的 AI issue 分诊器的提示注入概念验证,用它攻击了 Cline,获取了发布凭证,并向 npm 发布了一个未经授权的 [email protected]。Cline 的事后分析确认,第三方使用了一个仍然有效的令牌来发布它,并表示该载荷是良性的。
- Datadog 在 3 月报告称,2 个携带提示注入载荷的 GitHub issue 命中了其 datadog-agent 仓库上基于 Claude 的分诊工作流,而 Claude 对两者都予以忽略。
像 {{NAME_ab12cd34}} 这样书写的值是真实值的占位符。请完全按照书写原样使用它们,在回复和工具调用中都是如此:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:AI 安全工程:同样的失败,但有了新的攻击方式
正文: 工具层有了自己的攻击演示和漏洞披露,还有一个在野外发现的恶意服务器。我自己就用 MCP 服务器运行编码智能体,所以这部分我读得最仔细。智能体会把工具描述当作受信任的上下文来读,而 MCP 规范本身就说,除非来自受信任的服务器,客户端必须把工具注解视为不可信,所以工具上的只读提示只是个提示:
- Invariant Labs 在 2025 年 4 月展示了,一个被投毒的工具描述让 Cursor 读取用户的 SSH 密钥和 MCP 配置文件,并把它们发送到恶意服务器;还展示了第二个恶意 MCP 服务器的工具描述让 Cursor 通过连接到同一智能体的受信任 WhatsApp MCP 服务器,窃取用户的 WhatsApp 聊天记录。在这两个演示中,用户仍然必须确认工具调用,而对话框没有显示所发送内容的完整内容。
- postmark-mcp 是一个 npm 包,复制了 Postmark 同名的官方库,被报告为野外发现的第一个恶意 MCP 服务器。2025 年 9 月发布的 1.0.16 版本加了一行代码,把通过它发送的每封邮件都密送给攻击者的地址。
- mcp-remote 在连接到恶意 MCP 服务器时的 OS 命令注入,CVE-2025-6514。
- Cursor 中一个已批准的 MCP 配置被换成恶意命令,没有新的批准提示,CVE-2025-54136。
- MCP Inspector 中来自恶意网页的远程代码执行,因为其代理没有身份验证,CVE-2025-49596。
- Anthropic 官方 Git MCP 服务器 mcp-server-git 中的 3 个缺陷,可通过提示注入利用,2026 年 1 月。
市场和包注册表紧随其后,出现了 OpenClaw 和 Shai-Hulud 蠕虫。两者都在上面的 事件列表 中。在这两个案例中,目标都是开发者的机器,智能体就在上面。
框架跟上了
风险清单和分类法现在覆盖了智能体:
- OWASP 的 LLM 应用 Top 10 2025 是基线。
- OWASP 单独的智能体应用 Top 10 随后在 2025 年 12 月发布:目标劫持、工具滥用、身份和权限滥用、智能体供应链、意外代码执行、记忆和上下文投毒、不安全的智能体间通信、级联失败、人机信任利用,以及失控智能体。
- LLM 清单的 2026 版在 2026 年 8 月发布。过度代理从第六位升至第三位。OWASP 为其列出了三个根本原因:过度功能、过度权限和过度自主。
- Microsoft 的 AI 红队在 2026 年 6 月修订了其智能体故障模式分类法,此前对已部署系统进行了一年的红队测试。它新增了 7 种故障模式,包括智能体供应链入侵和会话上下文污染。
过度代理的位次变化正是本文的重点,因为这是一份由追踪新攻击的人排名的旧失败清单。关于 2026 年清单的一个实用提示:ID 被重新编号了,所以 LLM03 去年指供应链,现在指过度代理。在 ID 旁边写上版本,LLM03:2026,否则控制矩阵会悄悄指向错误的风险。
执行层也在形成标准。OWASP Agent Control Standard 描述了一个守护者,在钩子点拦截智能体,在工具调用、记忆写入或子智能体调用之前,返回允许、拒绝或修改,并通过 OpenTelemetry 发出追踪。这就是“为什么指令对编码智能体不够”的论证,被写成了模式。它目前也是 0.1 版本,我的解读,也是 CSA 研究笔记所认同的,是设计你的钩子使其映射到它,并在依赖它作为控制之前先试点。
监管和审计标准也在推进:
- NIST 正在 CSF 2.0 之上叠加 Cyber AI Profile,并为生成式助手、单智能体和多智能体系统起草 SP 800-53 叠加层。
文章标题:AI 安全工程:同样的失败,全新的攻击方式
正文:
- 欧盟的《数字综合法案》(Digital Omnibus)中关于 AI 的部分已于 2026 年 7 月成为法律。它将附件 III 下的高风险义务从 2026 年 8 月推迟到 2027 年 12 月,将附件 I 下嵌入产品的义务推迟到 2028 年 8 月。第 50 条下的透明度义务和通用模型义务基本维持原定日期。
- ISO/IEC 42006:2025 规定了对依据 ISO/IEC 42001 进行认证的机构的要求。经认可的 AI 管理体系证书已经存在,因此未经认可的证书值得追问一句。
如果你在欧盟基于这套体系构建高风险系统,截止日期变了,但记录义务没变:系统必须在其运行的整个期间自动记录它所做的事情。我从 2018 年起就与审计框架打交道,我预计 ISO 42001 将是我们许多人接下来要面对的下一个。它对 AI 部分所要求的证据,正是本文所述事件中缺失的那些证据。
这一切都要求一项技能:知道手里拿的是什么类型的东西:
- 法律:欧盟 AI 法案。
- 可认证标准:ISO/IEC 42001。
- 指南:NIST 的各类 profile 和新加坡的 agentic AI 治理框架。
- 社区排名:OWASP 的各类清单。
- 知识库:MITRE ATLAS,一个记录已观测攻击者行为的目录,到 2026 年已加入 agent 相关技术。
- 威胁建模方法:CSA 的 MAESTRO,面向多 agent 设计。
董事会把这些全都听成“合规”,而这项工作的一部分就是纠正这种理解。我在《从战略上改进网络安全的框架》一文中介绍过较早的框架,新的 AI 层次是叠加在它们之上,而不是取代它们。
那工作机会呢?
关于这个角色的很多讨论都伴随着工作保障的承诺,所以这是我最用力核查的部分。大多数招聘岗位数据来自美国。我在欧盟,所以我也找了更贴近本土的数字,而那里存在的是调查数据。招聘岗位统计的是空缺职位,调查统计的是安全团队自己所说的情况,所以我在下文和图中将两者分开。
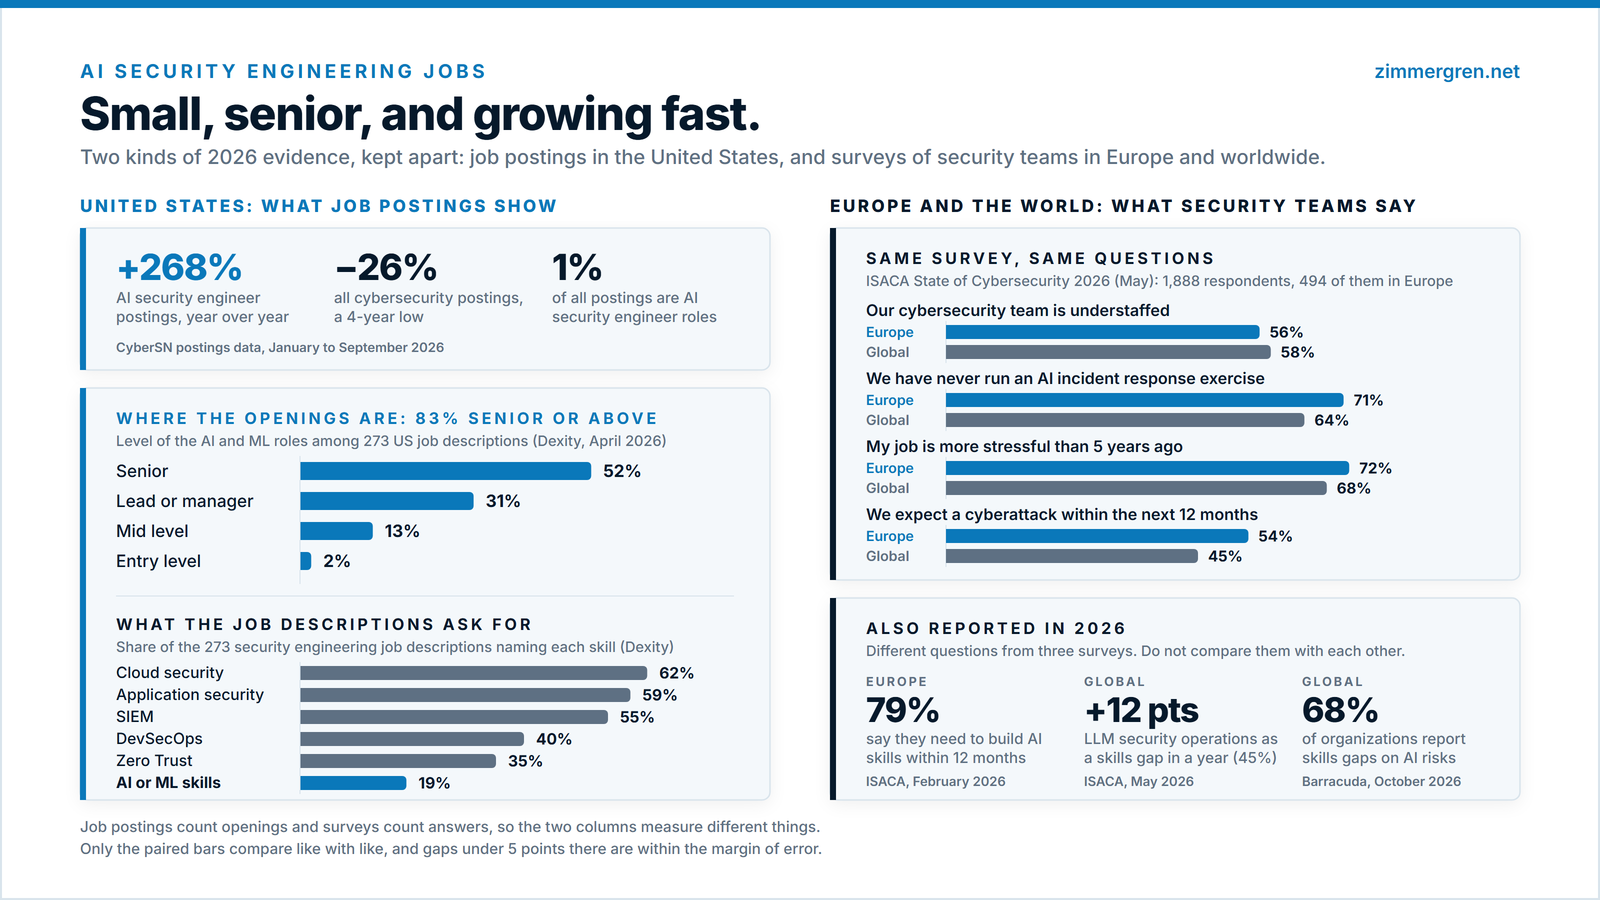
美国。这里该角色被作为一个职位名称来统计,数据来自 CyberSN 2026 年前 9 个月的招聘数据,以及 Dexity 对 2026 年 4 月 273 份安全工程职位描述的分析:
- AI 安全工程师岗位同比增长约 268%,达到约 2,400 个。
- 同期所有网络安全岗位下降约 26%,降至 235,786 个,为 CyberSN 追踪的 4 年中最低。
- 这使得 AI 安全工程师角色约占总数的 1%。
- 在 Dexity 样本中的 AI 和 ML 岗位里,83% 为高级及以上级别。入门级占 2%。
- 要求最多的技能是经典安全技能:62% 的职位描述要求云安全,59% 要求应用安全,55% 要求 SIEM。19% 要求 AI 或 ML 技能。
文章标题:AI 安全工程:同样的失误,全新的攻击方式
欧洲和全球,同一项调查。我找不到能统计欧盟范围内 AI 安全工程师岗位数量的数据集。现有的是调查数据,而有一项调查在欧洲和全球问了同样的问题,所以这里的这些数字是唯一可以同类比较的。ISACA 的《2026 年网络安全状况》于 5 月开展,有 1,888 名受访者,其中 494 名在欧洲,ISACA 单独发布了全球结果。欧洲包含在全球数字中,而由于欧洲受访者不足 500 人,几个百分点的差距在误差范围内:
- 欧洲 56% 的人表示其网络安全团队人手不足,全球为 58%。
- 欧洲 71% 的人从未开展过与 AI 相关的事件响应演练,全球为 64%。
- 欧洲 72% 的人表示这份工作比 5 年前压力更大,全球为 68%。
- 欧洲 54% 的人预计 12 个月内会遭遇网络攻击,全球为 45%。
其他 2026 年的发现。这些来自不同的问题,因此它们提供的是背景信息,不应相互比较:
- 欧洲:54% 的从业者表示需要在 6 个月内建立自己的 AI 技能以保住工作或获得晋升,79% 表示需要在一年内做到。这来自 ISACA 2 月对 681 名从业者的欧洲 AI 研究,其中 35% 的人也无法判断自己是否遭受过 AI 驱动的攻击。
- 全球:57% 的受访者将软技能列为缺口,其中以批判性思维和沟通为首,45% 将 LLM 安全运营列为缺口,一年内上升了 12 个百分点。这两个数字都来自 5 月的同一项 ISACA 调查。
- 全球:68% 的组织报告存在与 AI 风险相关的技能缺口,56% 因 AI 减少了安全岗位。这来自 Barracuda 10 月发布的技能缺口报告,这是一项针对 2,000 名决策者的供应商调查,其样本包括北欧、DACH 国家、比荷卢和法国。
我的解读是,各地区指向同一方向。整体安全招聘持平或萎缩,需求集中在有经验的人身上。两类技能同时受到追捧:AI 安全技能,这是一个快速增长的缺口;以及批判性思维和沟通等软技能,这是最大的缺口。这是一个基数小、增长快的岗位,并不能保证就业。我认为更快的进入路径是从安全侧切入,因为 AI 工程师不会偶然掌握身份、威胁建模和受监管风险。
成功的 AI 安全工程师做什么
这是我的排名,基于上文的事件和招聘数据。
- 在代理运行前决定爆炸半径。它以什么身份运行,该身份能触及什么,它能否写入,以及如果模型对自己所做的事判断错误会发生什么。每个代理使用独立身份,范围受限且短时效的令牌,隔离环境,代理无法触及的备份。对于 Microsoft 技术栈上已部署的代理,现在这意味着 Entra Agent ID,当代理代表用户行事时使用 on-behalf-of 流程,并优先使用托管标识或证书而非客户端密钥。这种范围限定的纪律与我在多年前为 Azure Container Registry 中仓库级令牌所描述的相同;只是主体变了。
- 对整个系统进行威胁建模。STRIDE 对模型周围的一切仍然有效。MITRE ATLAS 和两个 OWASP 清单覆盖了模型形态的部分。
- 把指令当作提示,并构建强制执行。规则文件、系统提示和工具注解都有用,但它们都不是控制措施。拒绝的钩子、允许列表、按身份而非按承诺的只读、输出模式、代码中的策略。我在为什么指令对编码代理不够一文中做了完整论证。OWASP Agent Control Standard 正是这一层的走向,因此要以能映射到它的形式构建钩子。
文章标题:AI security engineering: the same failures, but new ways to attack
正文:
- 掌控 agent 供应链。MCP servers、skills、plugins、packages 和项目文件都是代码。把它们固定版本、审查工具描述、变更时重新审查、扫描市场,并假定开发者的机器就是目标。
- 在 CI 中运行对抗性测试。一个带版本管理的对抗性测试集、一个 LLM 评委,以及针对自身基线的回归合并门禁。行业没有标准的越狱阈值;选一个并守住它。这和把安全代码分析和 OWASP ZAP 放进 GitHub Actions 是同一个动作,只是测试集不同。每年一到两次,在获得书面授权的前提下,把开源攻击性 agent 指向实验室副本的整套栈,并把它的记录转化为检测规则。
- 把每一个 prompt、工具调用和输出都记录到不可变的地方,并能端到端重放一次事件。EU AI Act 要求高风险系统保留事件日志,ISO 42001 也有相应的控制项,而在第一天就作为可观测性来建设成本更低。我早前的两篇文章仍然是这个模式:在敏感信息进入遥测之前将其脱敏,以及用 Sentinel 监视敏感的 Key Vault 操作。
- 在防御侧使用 AI 进行代码审查、分诊和日志分析,每一个不可逆操作都有人参与,并且清楚知道自己待办列表中的修复缺口到底在哪。
- 把它解释两遍。向董事会用风险和时程来解释,向工程师用控制措施和 pull request 来解释。合规素养如今是工作的一部分。SC-100 学习指南仍然是这场对话中架构侧的一张不错的地图。这包括知道哪些框架是法律、哪些是标准、哪些是指南、哪些是社区清单,并在有人把它们混为一谈时指出来。我在 Adopting AI inside an organization that has to pass a compliance audit 一文中逐一梳理了这些框架。
- 让学习路线图与事件对齐。让人兴奋的主题就是正确的主题。我会把身份、爆炸半径和供应链排在越狱测试框架之前,因为事件发生的顺序就是如此。
支撑这一切的两个特质是:读一手资料,因为这篇文章里的很多东西在过去 12 个月里都变了;以及谦逊,因为没有人解决了核心问题,而工作就是让一次成功的注入变得平淡无奇。
Final thoughts
AI 安全工程已成为一门核心学科,因为 agent 现在站在了两边。攻击者用它们更快地穿过我们一直存在的弱点,而我们其余人用它们来构建、审查和运营系统。必须有人决定这些 agent 能触及什么,并能在事后展示它们做了什么,而这是建立在安全基本功之上的工程工作。
我很好奇你的清单是什么样,以及哪起事件改变了你对某件事的看法。在 LinkedIn 上告诉我。
Related posts
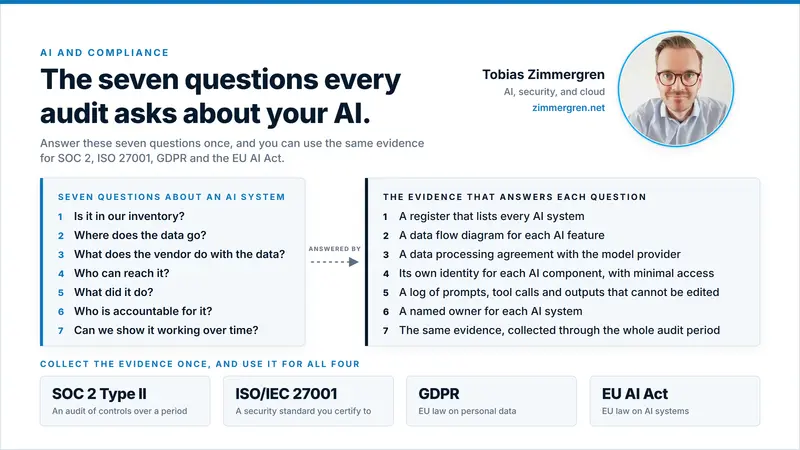
Adopting AI inside an organization that has to pass a compliance audit
在 SOC 2 Type II、ISO 27001、GDPR 和 EU AI Act 下采用 AI:每个框架都会问及 AI 系统的七件事、如何为之进行工程化,以及组织中每个团队需要做什么。
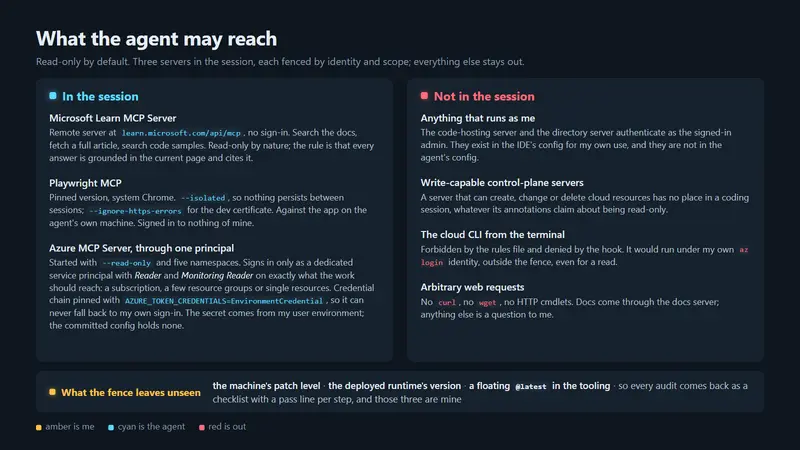
Agentic AI engineering: Read-only MCP servers by default, and never run as my own identity
我如何围栏我的编码 agent 所能触及的工具:用于获取最新文档的 Microsoft Learn MCP Server、位于限定于该工作的只读主体之后的 Azure MCP Server、通过 Playwright MCP 访问的浏览器、不从终端调用云 CLI,以及我会排除在会话之外的服务器。
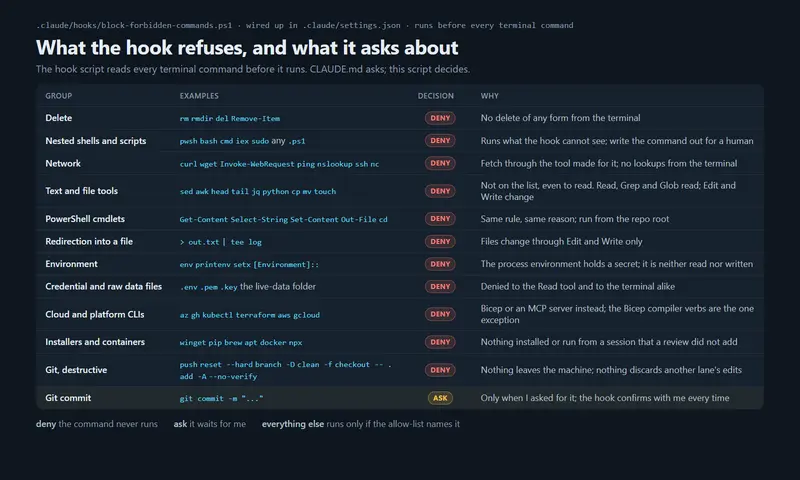
Agentic AI engineering: Why instructions aren't enough for coding agents
在这篇文章中,我解释了 agent 指令与强制执行规则各自的行为方式,以及为什么这很重要。指令文件只是建议,而非强制执行。指令与 hooks
评论已关闭
有问题或想补充内容?在 LinkedIn 上给我发消息。