 Newshot
推出 Amazon SageMaker JumpStart 模型排行榜
Amazon SageMaker JumpStart 提供数百个可快速部署的开放权重基础模型。这种丰富选择很强大,但也带来一个实际问题:应该从哪个模型开始?比较模型通常意味着逐个阅读模型卡片,并寻找不同来源在不同条件下发布的基准分数。然后,你仍然必须猜测每个模型在你的用例中会表现如何、成本是多少。
今天,我们推出 Amazon SageMaker JumpStart 模型排行榜,这是一种直接在 Amazon SageMaker Studio 中按质量、速度和成本并排比较 JumpStart 模型的新方式。在本文中,我们将说明排行榜展示的内容,用通俗语言定义关键术语,并逐步介绍如何从候选清单走到已部署的模型。
什么是 JumpStart 模型排行榜?
排行榜是 SageMaker Studio 中 JumpStart 基础模型页面的一个新视图,就位于 Categories 和 All models 视图旁边。它使用你熟悉的同一个搜索栏和筛选器,并打开一个大语言模型(LLM)排行榜。你无需先回答设置问题,就能立即看到排名。对于每个模型,它显示两类信息:
- 三个公开基准(BIG-Bench Hard、GPQA Diamond 和 MMLU-Pro)上的质量分数,由 AWS 自己运行,对每个模型使用相同的评估设置,因此数字具有可比性。
- 性能和成本指标,由 AWS 通过使用每个 JumpStart 部署配置向端点发送标准化测试工作负载来测量,因此你可以看到模型响应有多快,以及运行成本是多少。
因为两类数字都来自同一来源和同一方法,你可以进行同类比较,而不必拼凑不同网站的数据。发布时,排行榜涵盖来自 Meta、Google、Qwen、IBM 和 Arcee 等提供商的 70+ 个模型,并会随时间增加更多模型。
以下截图展示了 SageMaker Studio 中的排行榜,其中包含每个模型的基准分数、性能指标和预估成本。
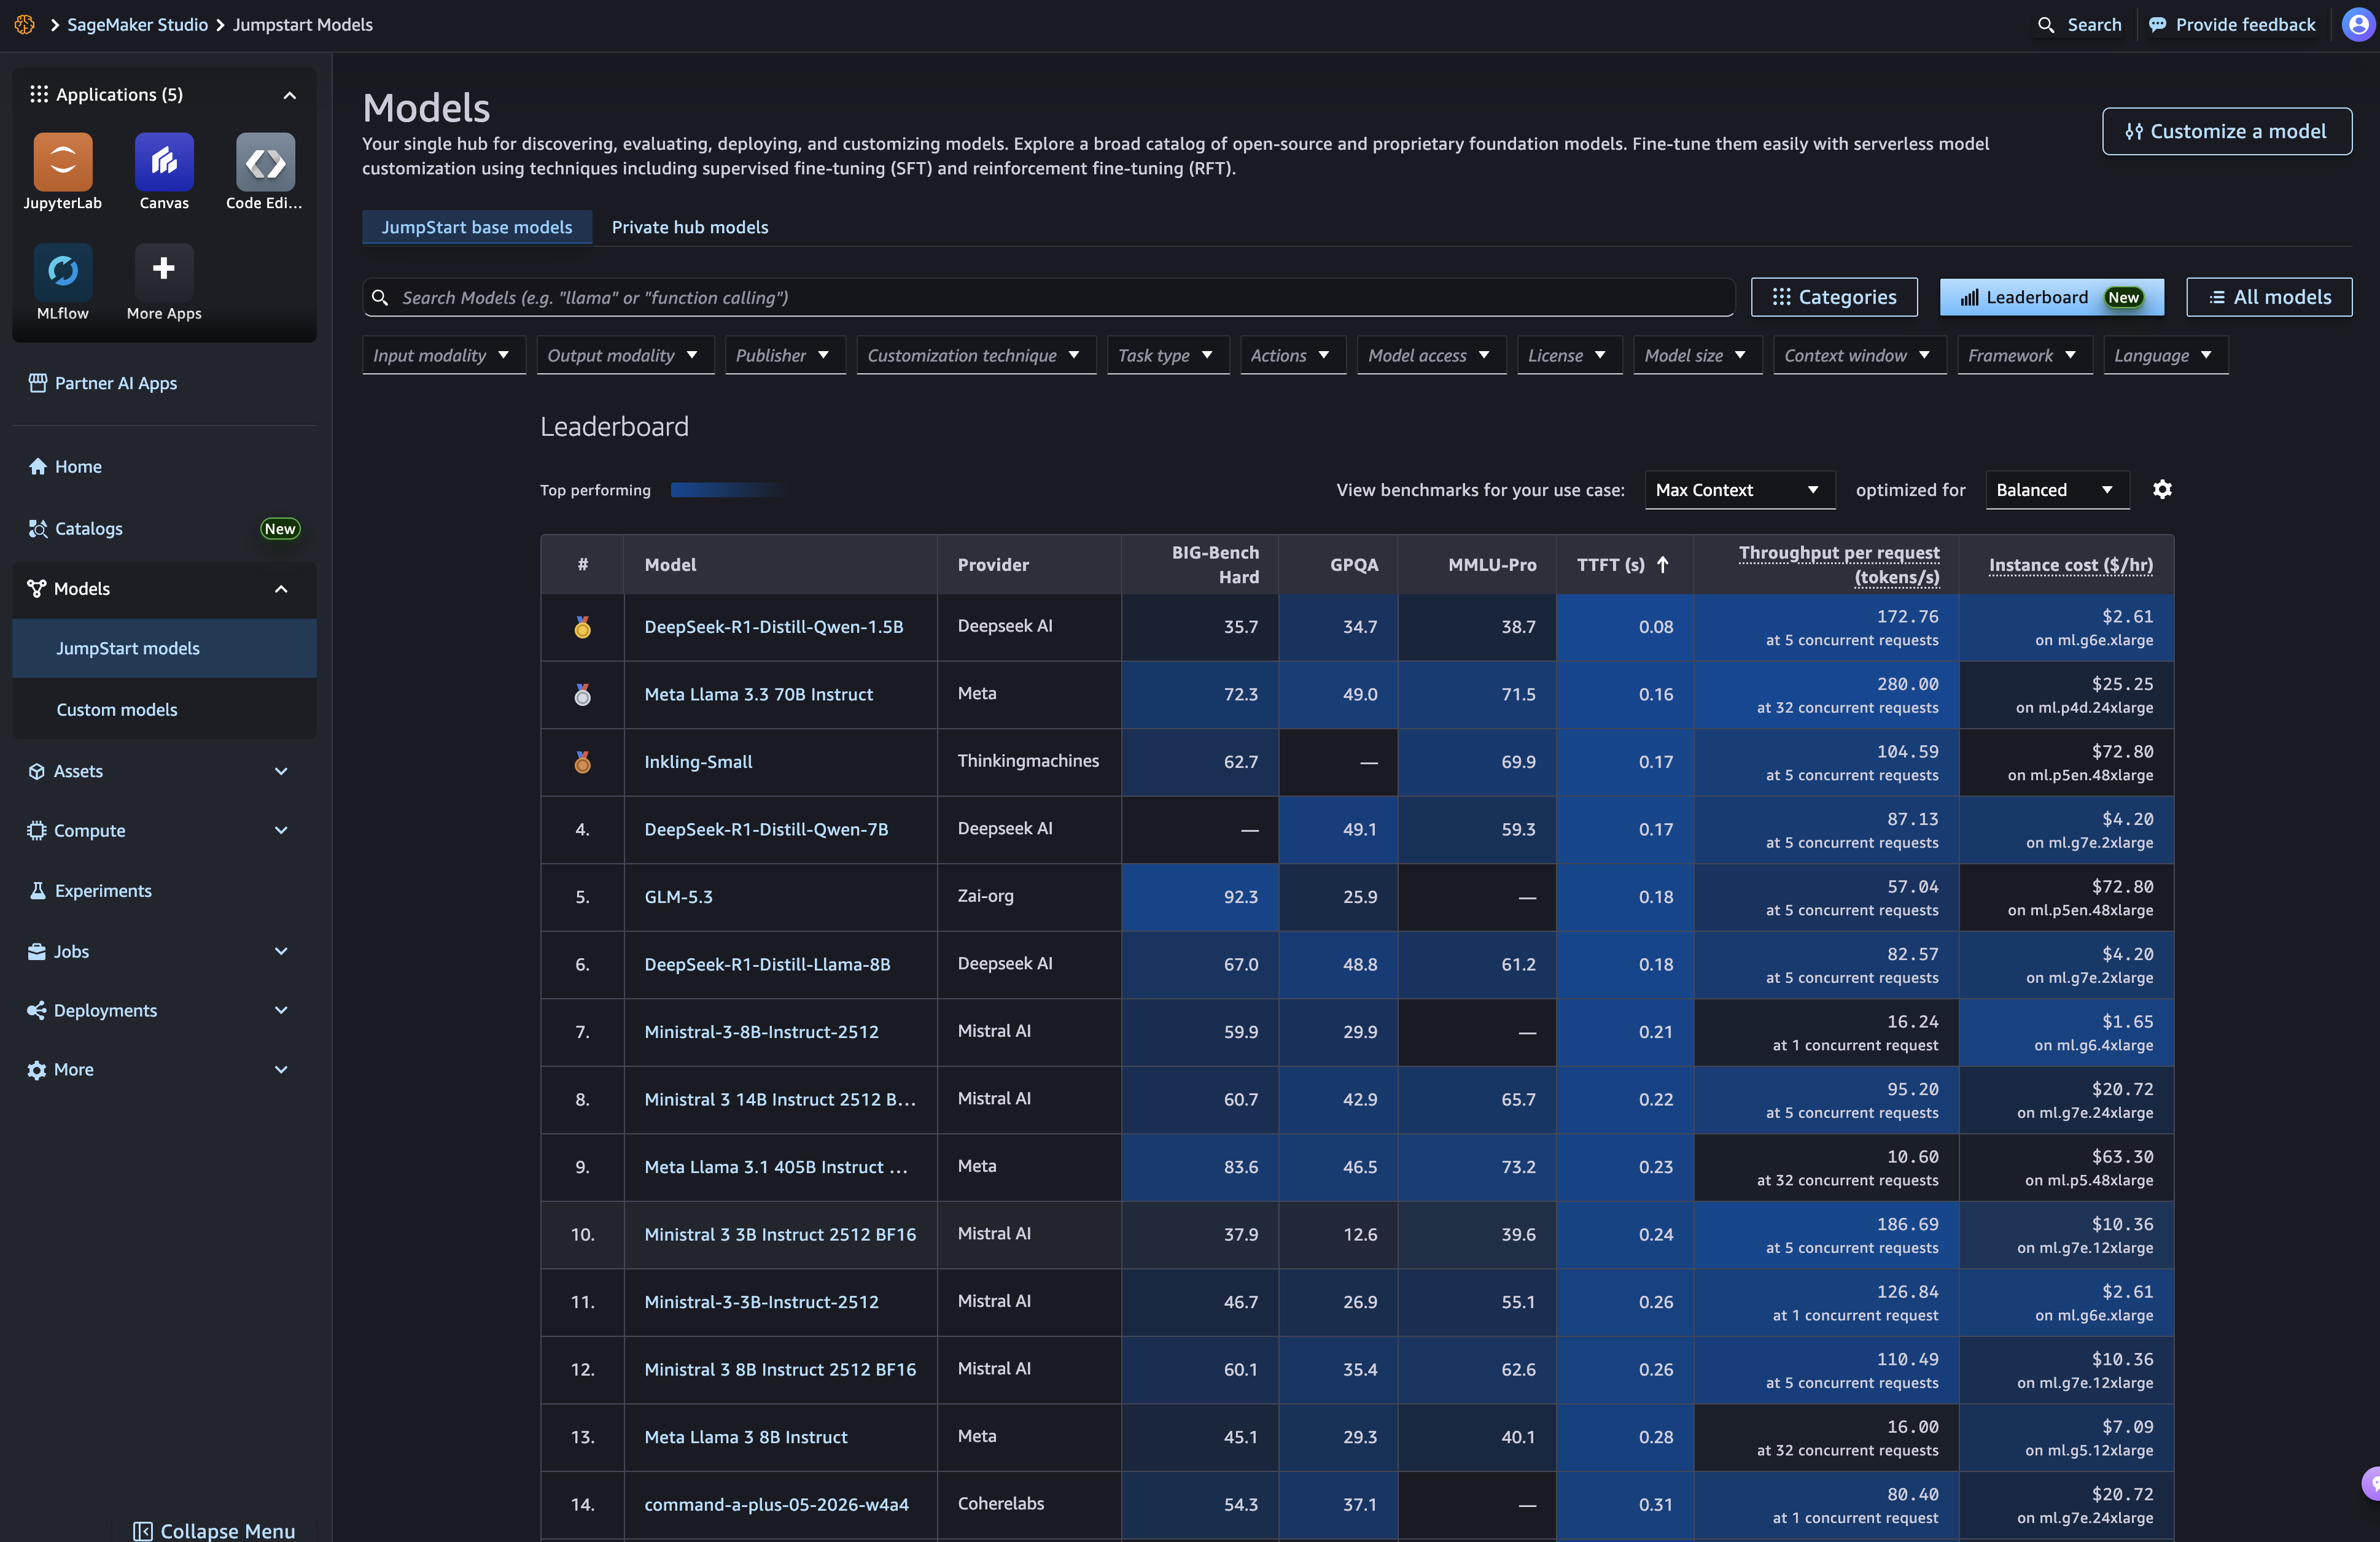
图 1:SageMaker Studio 中的排行榜概览
关键概念
本节定义排行榜使用的术语:质量基准、塑造性能数字的用例配置文件和优化目标,以及性能指标本身。
质量基准
基准是一种标准化测试:一组带有已知答案的固定问题。让每个模型都通过相同的测试,就能得到可比较的分数。发布时,排行榜报告 LLM 的三项推理基准:
| 基准 | 用通俗的话说,它衡量什么 |
|---|---|
| BIG-Bench Hard (BBH) | 一组需要多步推理的挑战性任务,例如逻辑演绎、跟踪对象和多步算术。 |
| GPQA Diamond | 研究生水平的科学问题,很难通过搜索网络来回答。是深度推理的良好信号。 |
| MMLU-Pro | 跨许多学科(如科学、法律和工程)的广泛知识和推理,使用更难的单项选择题。 |
这三项都是越高越好。排行榜分别展示每个基准,而不是将它们混合成一个数字。这保持了结果的透明度:你可以权衡对你的应用重要的基准,并根据基准的公开定义核对每个分数。
用例配置文件和优化目标
速度和成本取决于你的工作负载以及模型的部署方式。排行榜上方的两个菜单控制你看到的性能和成本数字:
文章标题:推出 Amazon SageMaker JumpStart 模型排行榜
正文:
- 用例配置。在 View benchmarks for your use case 菜单中,选择最接近你工作负载的配置。默认是 Max Context。配置只改变性能和成本指标。质量基准分数对每个配置都相同。
- 优化目标。对于每个配置,一个模型可以有多个部署配置,排行榜一次显示其中一个的指标。用 Optimized for 菜单选择显示哪一个。默认是 Balanced。
每个优化目标选择不同的配置:
| 优化目标 | 显示的配置 |
|---|---|
| Balanced | 每 token 估计成本最低的配置。因为每 token 成本取决于实例价格和吞吐量,这在每小时支付的费用与实例生成 token 的速度之间取得平衡。 |
| Cost optimized | 每小时实例价格最低的配置。与其他目标相比,延迟可能更高,吞吐量可能更低。 |
| Latency optimized | 首个 token 时间最低的配置。 |
| Throughput optimized | 吞吐量最高的配置。这些配置可以使用投机解码。 |
性能指标
| 指标 | 它告诉你的信息 |
|---|---|
| 首个 token 时间(TTFT) | 用户在模型开始响应前等待多长时间。越低越好,对聊天最重要。 |
| 每请求吞吐量(tokens/s) | 模型每秒生成多少 token。越高越好,对批处理和高容量工作负载很重要。 |
| 实例成本($/hr) | 给定指定实例类型的每小时估计成本。 |
关于成本的说明:估计成本仅反映 SageMaker 实例成本,基于配置默认实例类型的按需每小时费率。它不包括数据传输、存储、推理组件成本,也不包括 Reserved Instances 或 AWS Savings Plans 等折扣。你的实际账单会有所不同。使用 AWS Pricing Calculator 进行账单估算。
我们如何做基准测试
已发布的基准分数通常来自不同团队,使用不同的提示、设置和硬件,这使得它们难以比较。我们采取了不同的方法:
- 每个模型一种方法。AWS 对排行榜上的所有模型使用相同的评估工具和设置运行每个基准测试。
- 在 SageMaker 上测量。性能和成本来自向使用每个 JumpStart 部署配置部署的端点发送标准化测试工作负载,这些配置与你可以启动的配置相同。
有关完整细节,包括提示、生成设置以及配置如何测量,请参阅 JumpStart 排行榜方法论。
演练:查找模型
以下步骤展示如何从浏览到部署模型。你需要访问 SageMaker Studio 以及部署 JumpStart 模型的权限。
步骤 1:打开排行榜
在 SageMaker Studio 中,打开 Models 页面,然后选择 Leaderboard 视图。排行榜保持与其他视图相同的搜索栏和筛选器,并且有自己的 URL。你可以将其加入书签或与团队分享直接链接。
以下截图显示选择了 Leaderboard 视图的 Models 页面。
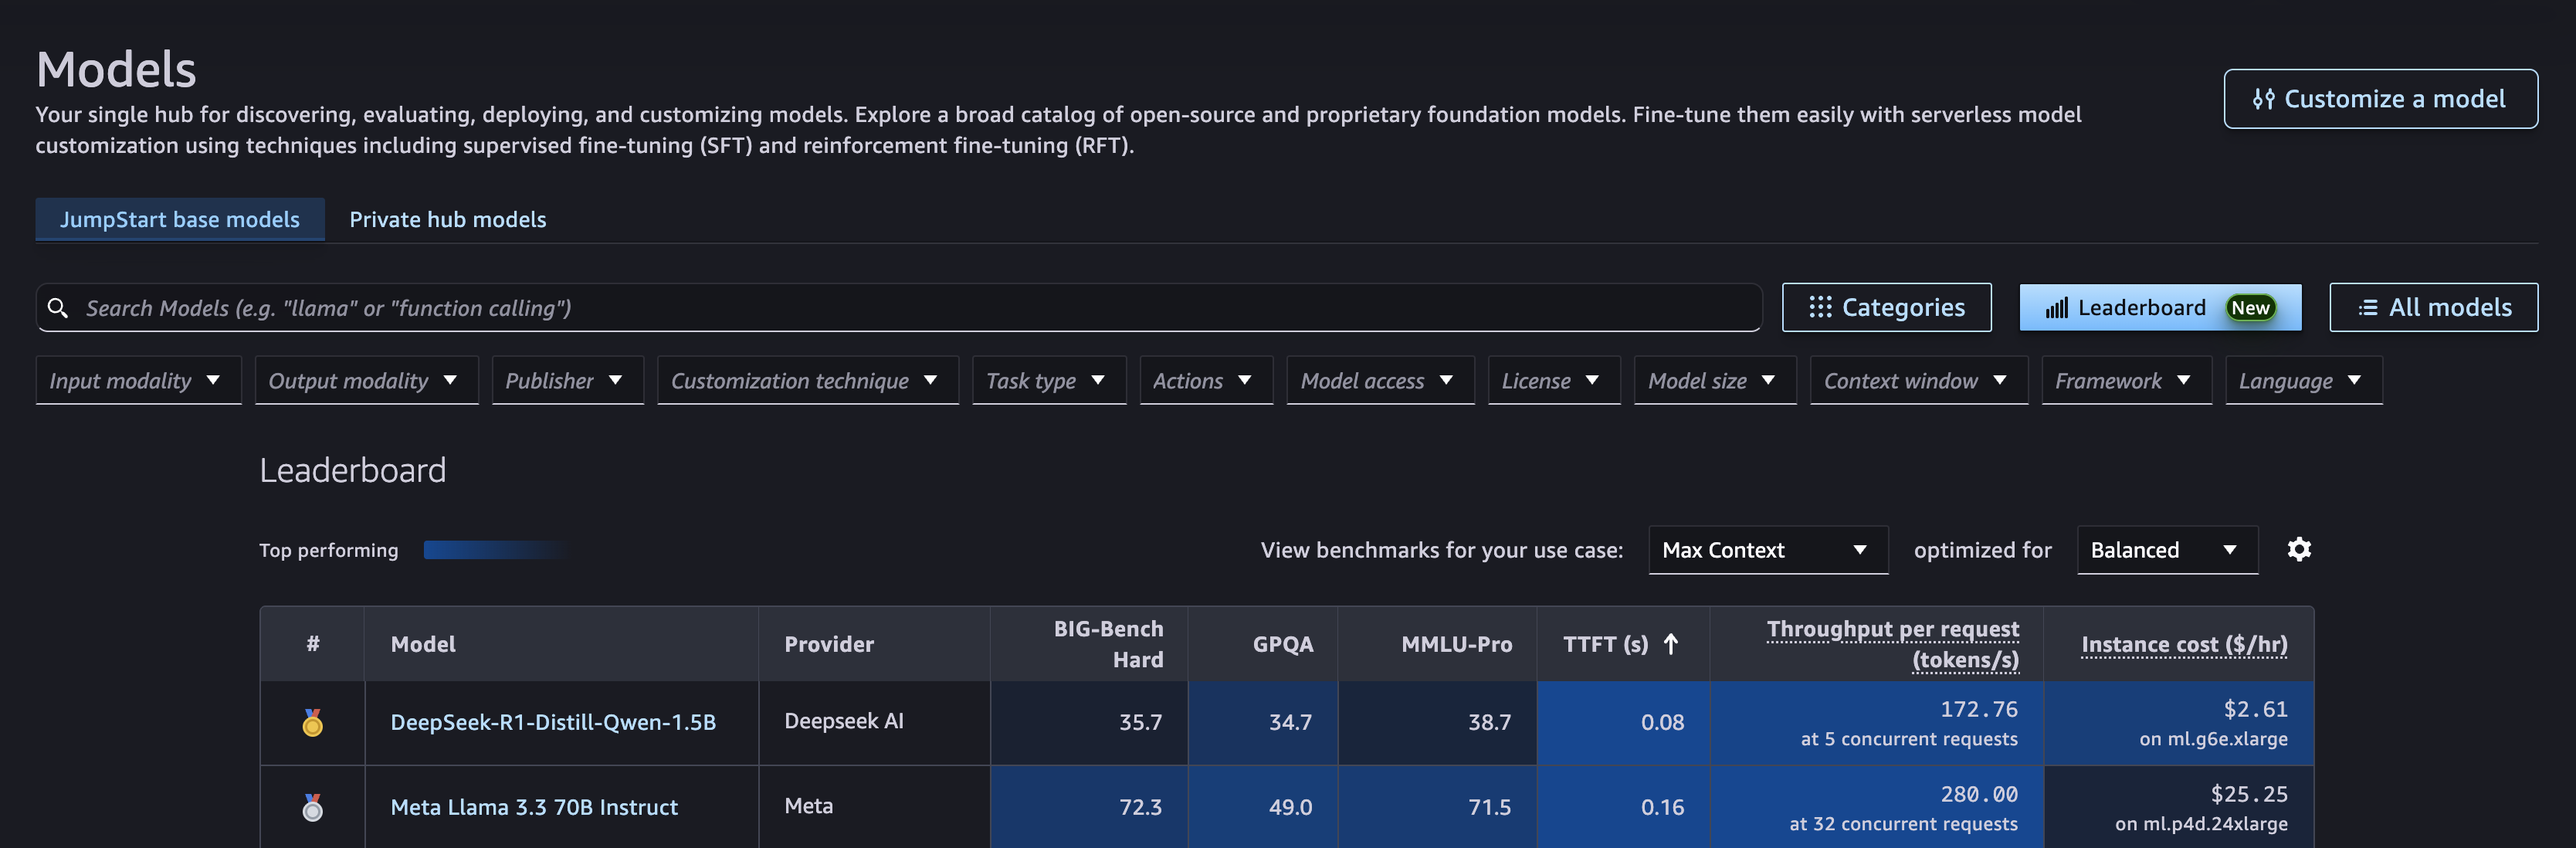
图 2:选择了 Leaderboard 视图的 JumpStart 基础模型页面
步骤 2:用筛选器缩小列表
使用你在 JumpStart 其他地方已经使用的相同搜索和筛选器,只保留符合你要求的模型。常见筛选器包括许可证、提供商以及输入和输出模态。先从硬性要求开始,例如允许商业使用的许可证,然后再看分数。
以下截图显示按输入模态、输出模态和许可证筛选的排行榜。
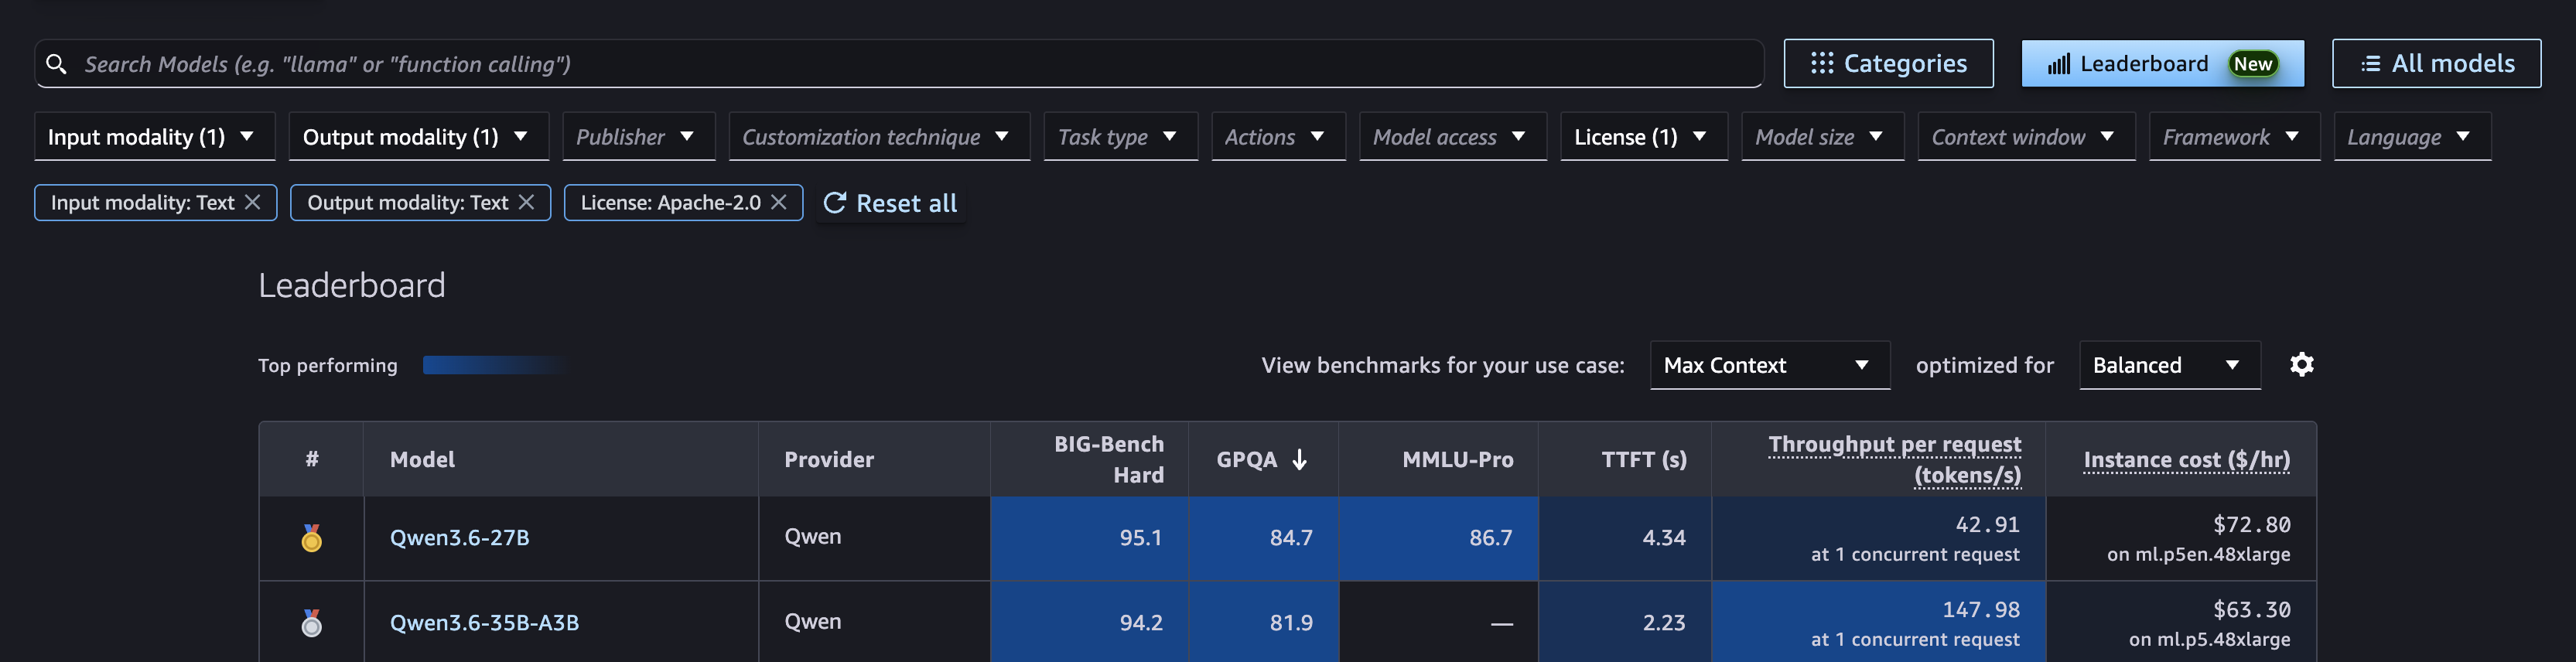
图 3:应用筛选条件后的排行榜
第 3 步:选择用例配置和优化目标
在排行榜上方,从 View benchmarks for your use case 菜单中选择最接近你工作负载的配置(默认:Max Context)。然后从 Optimized for 菜单中选择一个目标(默认:Balanced)。对于面向客户交互的聊天机器人,Latency optimized 是一个合理的起点。对于夜间文档处理,Throughput optimized 或 Cost optimized 可能更合适。性能和成本列会更新,质量分数保持不变。
下面的截图展示了排行榜上方的 View benchmarks for your use case 和 Optimized for 菜单。
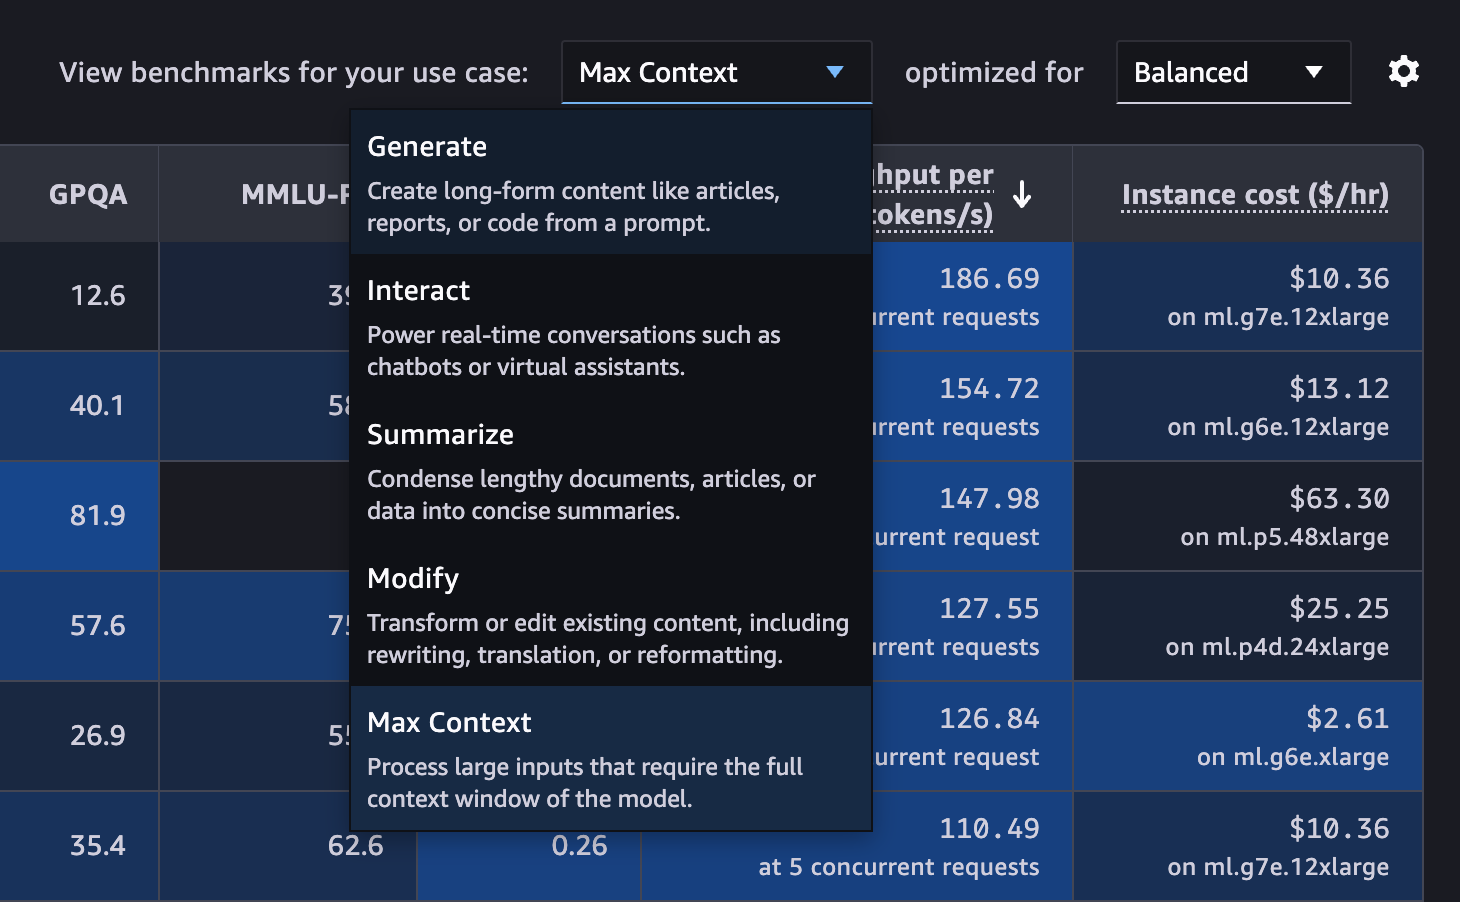
图 4:View benchmarks for your use case 菜单
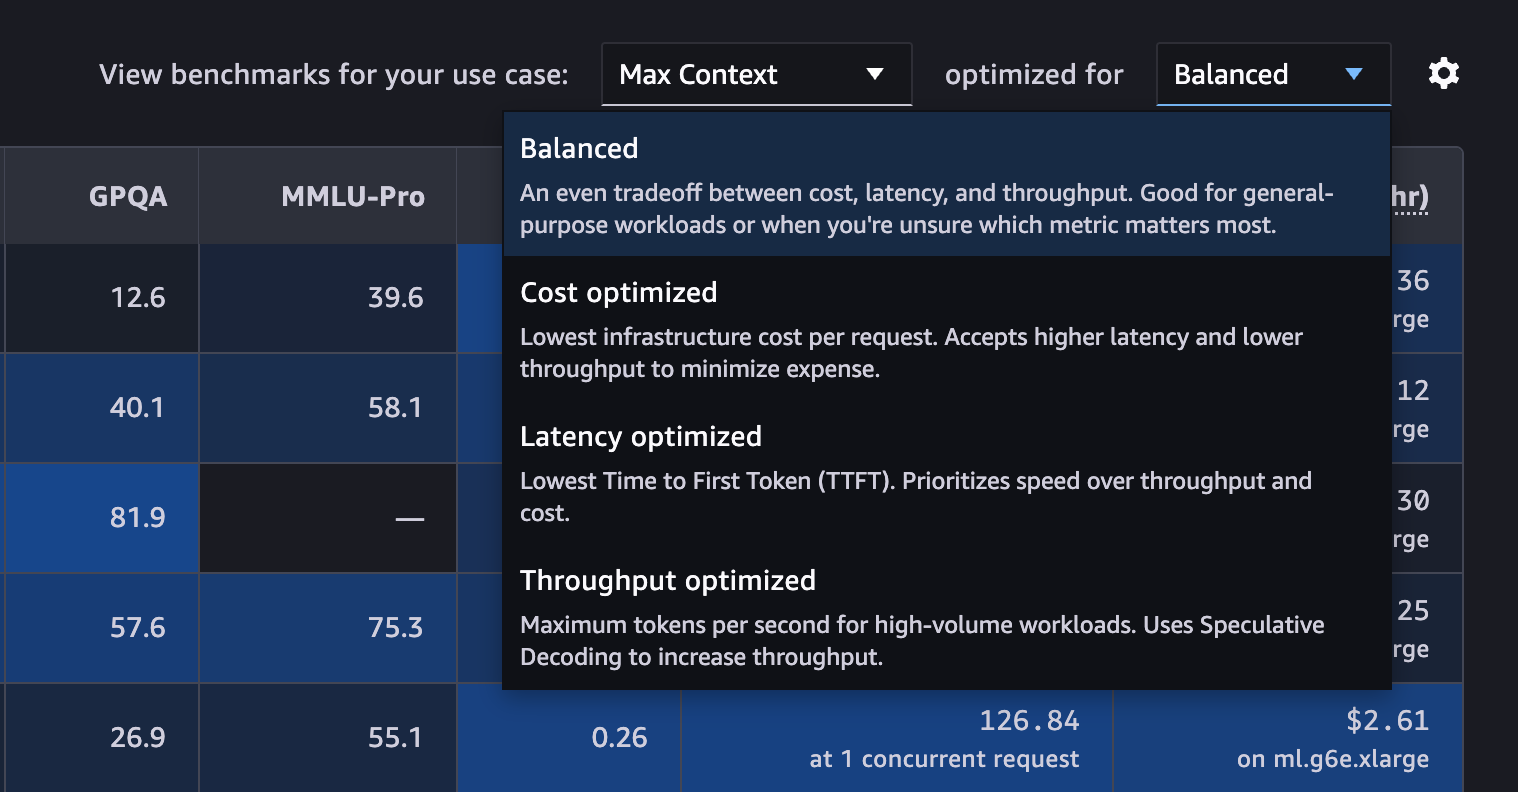
图 5:Optimized for 菜单
第 4 步:阅读热力图并自定义列
每一列都有一个蓝色热力图,因此表现最好的模型一眼就能看出来:蓝色越深,该列中的结果越强。对任意基准列排序,即可按你最关心的指标对模型排名。使用列设置(齿轮图标)隐藏不需要的指标,并水平滚动查看更多内容。滚动时模型名称列保持冻结,边缘的渐隐效果表示还有更多列可用。
下面的截图展示了热力图和列设置菜单。
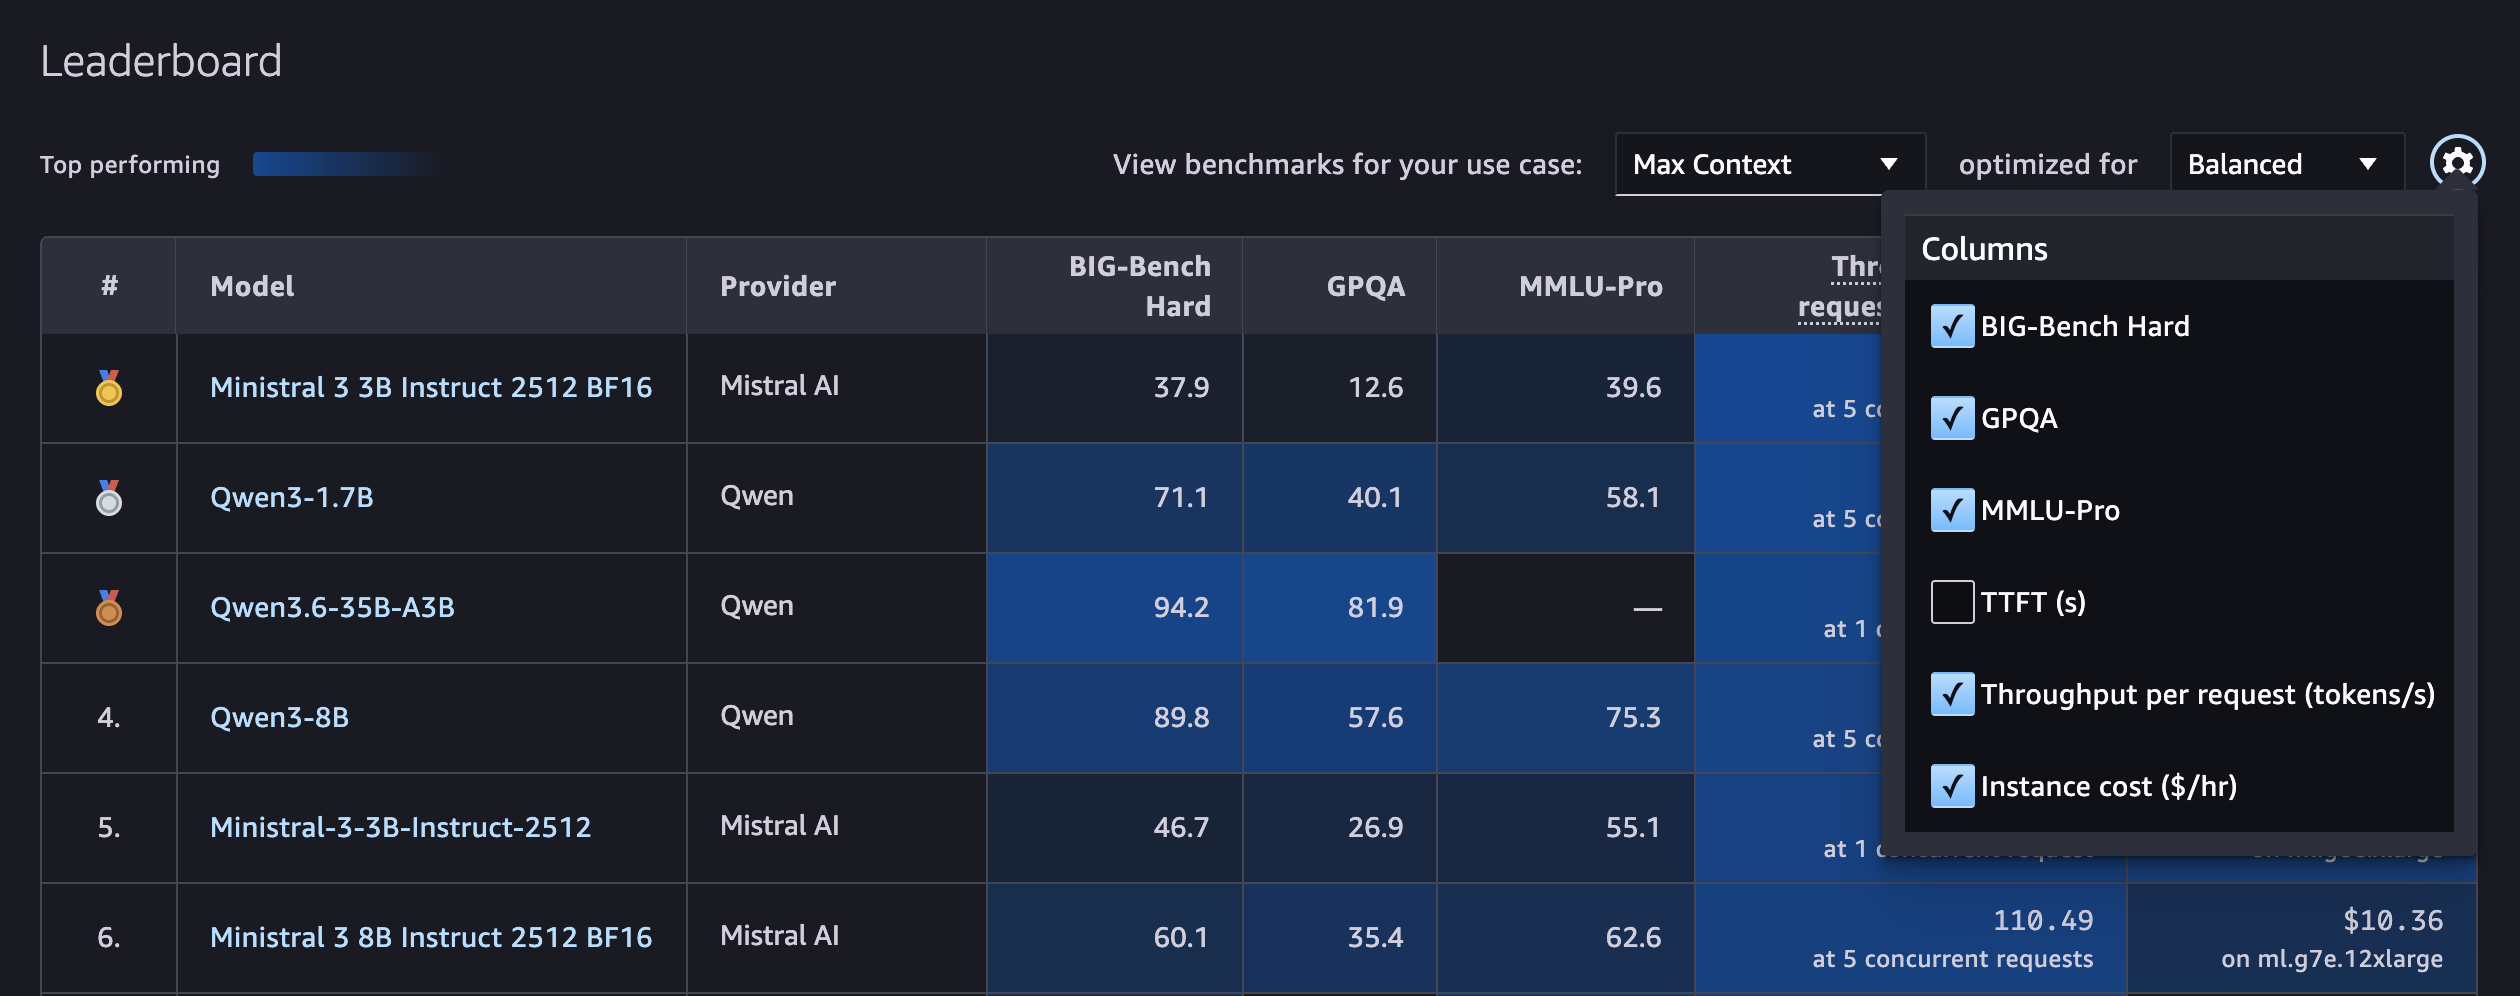
图 6:热力图和列设置
第 5 步:部署或自定义模型
选择一个模型以打开它。在这里,你可以选择部署该模型,或者对于支持无服务器自定义的模型,对其进行自定义。如果进行部署,请选择与你在排行榜上比较时相同的用例和优化目标。每个指标都对应其测量时的配置,不同的配置可能会改变质量、延迟、吞吐量和成本。
下面的截图展示了一个带有 Deploy 和 Customize 选项的模型页面。
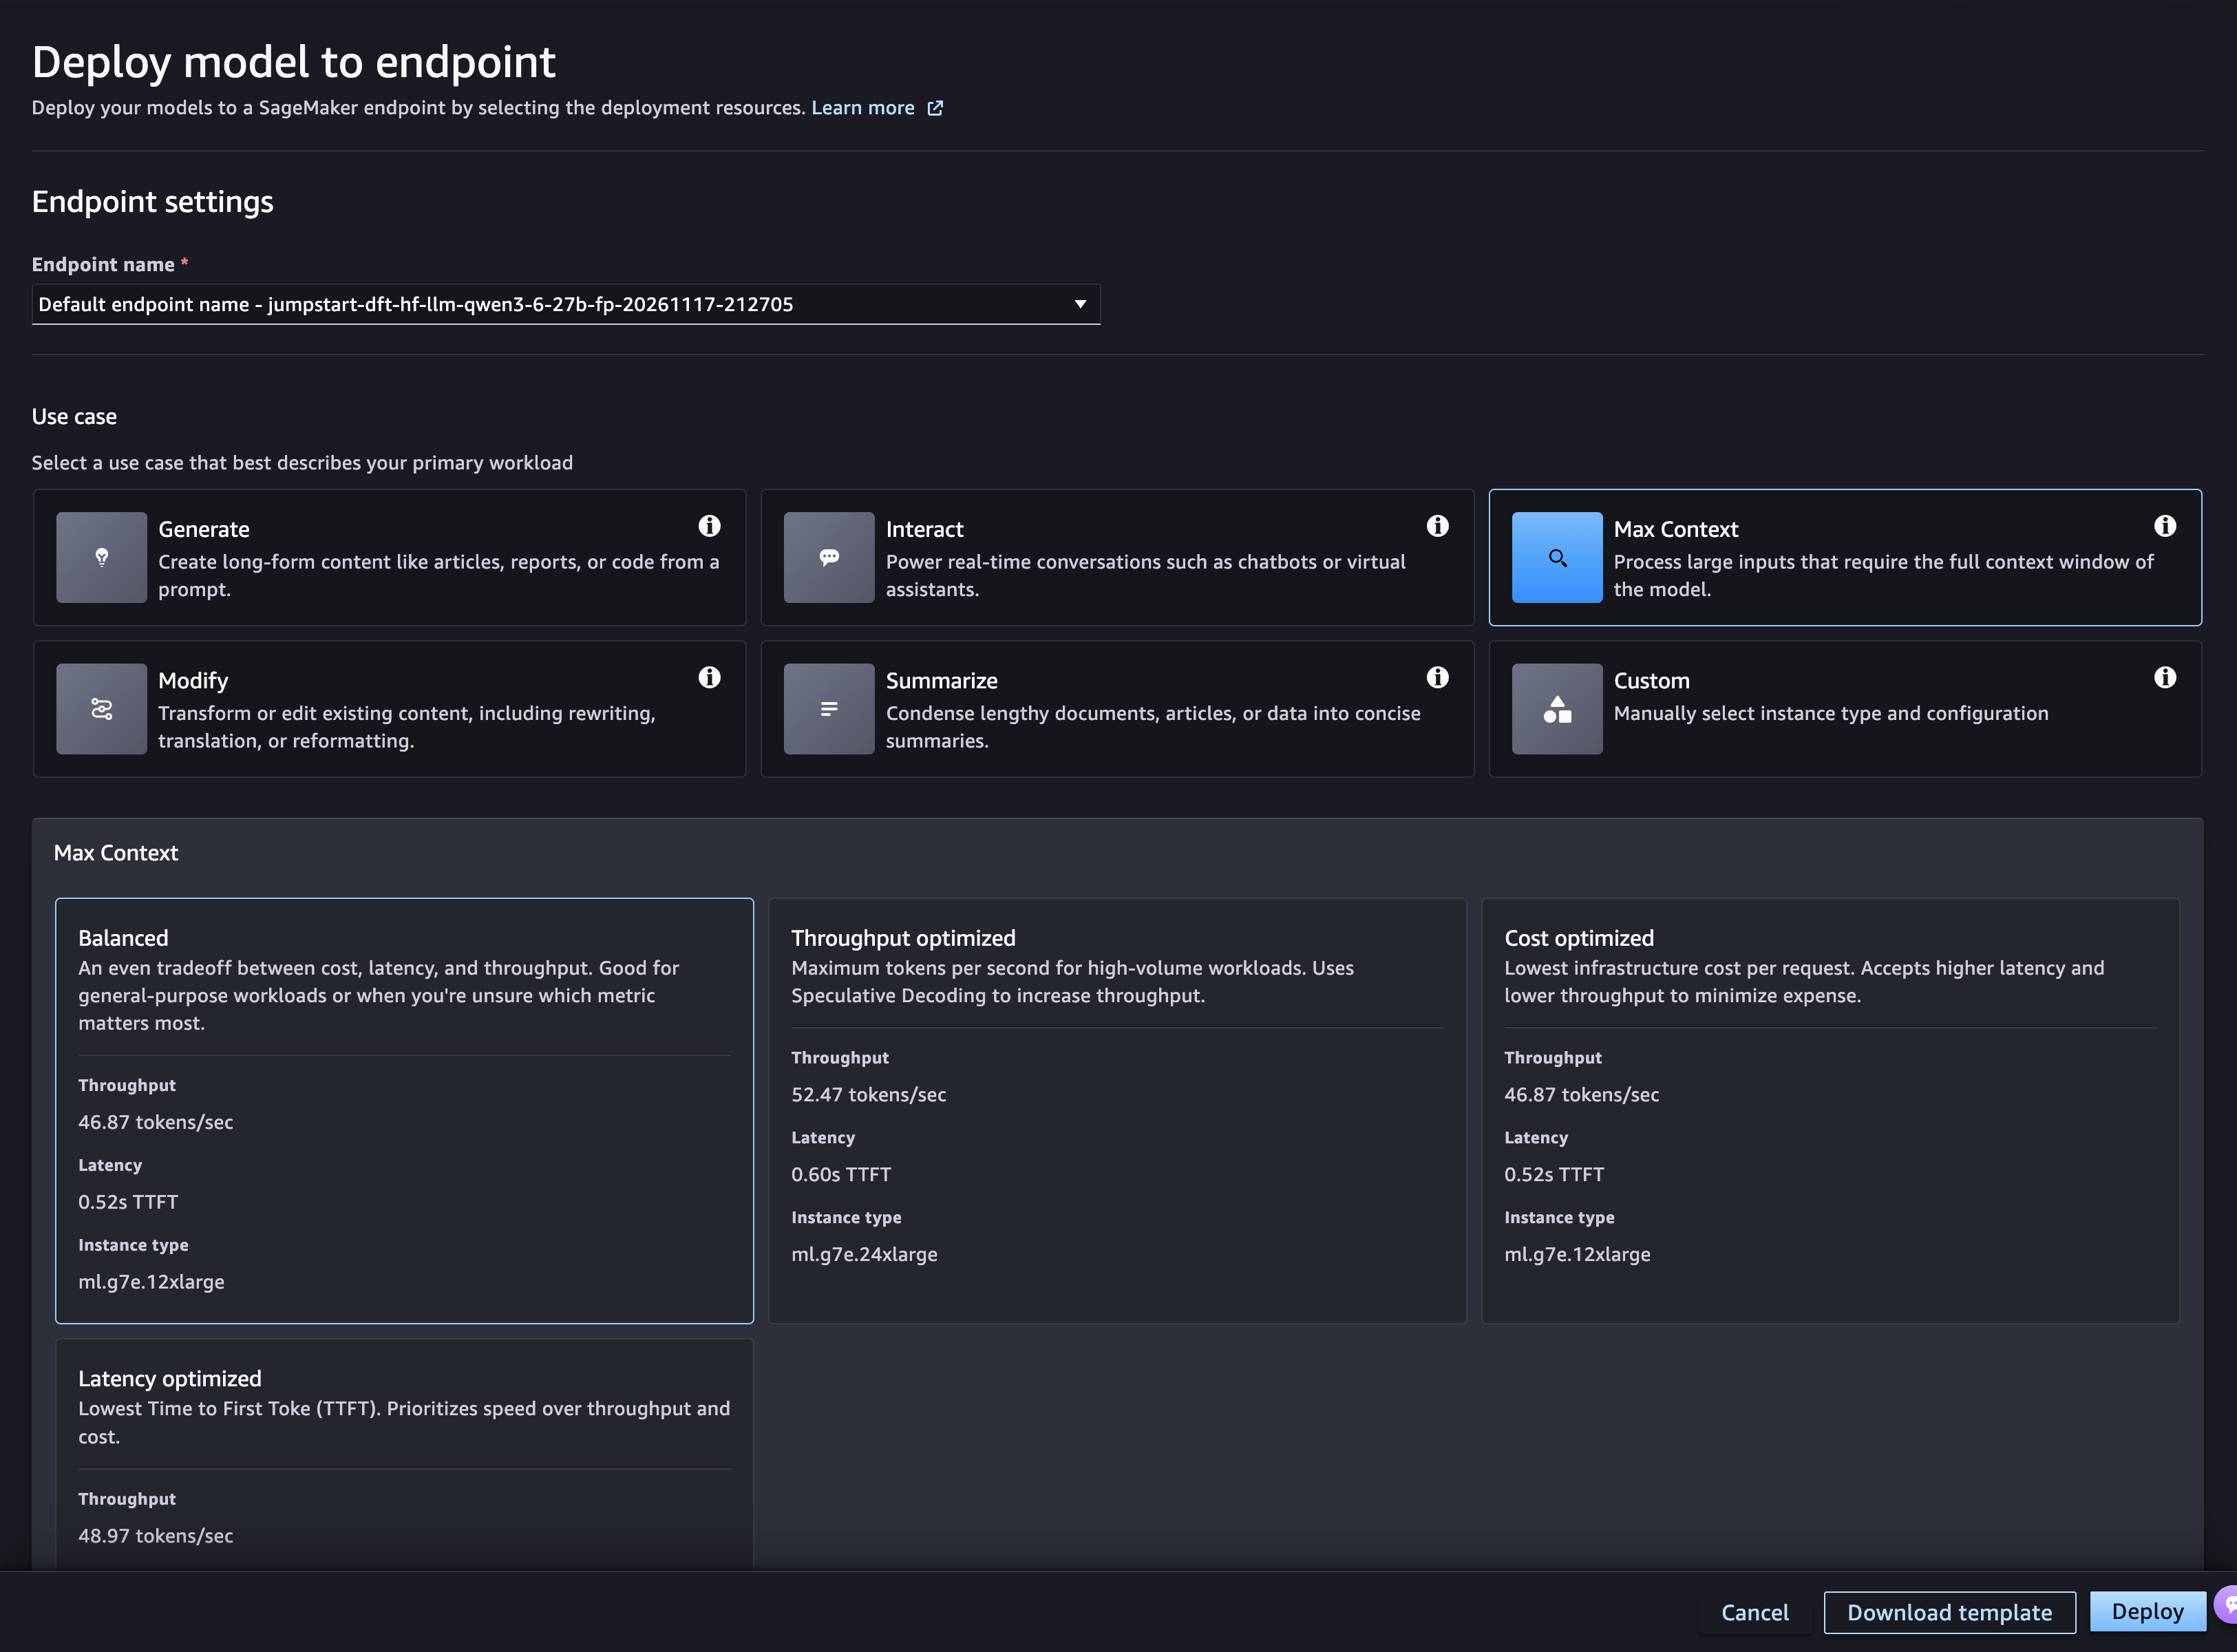
图 7:带有 Deploy 和 Customize 选项的模型页面
示例:为聊天助手挑选模型
假设你正在构建一个内部帮助台助手。员工提出问题,并期望得到快速、准确且遵循既定回复格式的答案。你需要一个具有商业许可证的模型,并希望成本可预测。
按许可证筛选并选择一个类似聊天的用例配置和 Latency optimized 后,你的候选清单可能如下所示:
| 模型 | BBH | MMLU-Pro | TTFT (s) | 吞吐量 (tokens/s) | 实例成本 ($/hr) |
|---|---|---|---|---|---|
| Model A(大型) | 95.9 | 87.2 | 2.33 | 37 | $37.66 |
| Model B(中型) | 94.2 | 84.9 | 0.98 | 44 | $5.75 |
| Model C(小型) | 77.4 | 66.1 | 0.27 | 61 | $2.61 |
从表中可以看出,Model A 的知识分数最高,但成本也最高,首次响应最慢。Model B 的分数几乎一样好,在多步推理上表现稳健,并且运行在更小、更便宜的实例上。对于帮助台而言,推理问题和快速响应比通用知识最后那几分更重要,因此 Model B 是更好的起点。更大的模型并不总是更好的选择,而排行榜让这种权衡在几秒内就变得清晰可见。
文章标题:推出 Amazon SageMaker JumpStart 模型排行榜
正文: 接下来,你会部署模型 B,用帮助台中的真实问题对它进行测试,并将模型 C 作为低成本备选记在心里——前提是它的质量经得起检验。
提示与须知
- 用排行榜来建立候选清单,而不是做最终决定。基准测试衡量的是通用能力。在投入生产之前,一定要用你自己的数据和提示词来评估排名前两三个的模型。
- 先筛选,再排序。许可证、输入或输出模态等要求会决定模型是入选还是被排除。分数只用来帮你对剩下的模型排序。
- 在同一个基准测试内比较模型。每个基准测试都有自己的难度,因此一个基准测试上的分数无法与另一个基准测试上的分数直接比较。
- 考虑模型类型。推理模型与非推理模型使用不同的生成参数进行评估,推理模型的 GPQA Diamond 分数是 10 次运行的平均值。两种类型之间的比较是近似的。
- 检查部署配置。每个指标都适用于其测量时所对应的配置。请在你计划部署的配置上比较模型。
- 把接近的分数视为平局。微小的差异可能落在正常的运行间波动范围内,并不意味着某个模型明显更好。要寻找明显的差距。
- 覆盖面在不断扩大。并非每个 JumpStart 模型都已经有基准测试分数,且上线时的基准测试聚焦于 LLM。没有分数的模型并不是弱模型,只是尚未被基准测试。
后续计划
我们正在持续扩展排行榜。我们正在探索的方向包括:
- 私有 hub 支持,让使用精选 JumpStart 私有 hub 的组织能够查看其已批准模型的排行榜。
- 超越 LLM 文本生成的更多任务排行榜,例如目标检测、文本嵌入和图像理解。
- 随着新模型加入 JumpStart,提供更多模型和基准测试。
结论
SageMaker JumpStart 模型排行榜将质量、速度和成本汇聚于一处,并在 SageMaker 上以一致的方式测量。你无需比较来自不同来源的数字,而是可以筛选出符合你要求的模型,在你计划运行的配置上进行比较,并通过几次点击完成部署。
要开始使用,请打开 SageMaker Studio 中的 Models 页面并选择 Leaderboard 视图。如需了解更多,请参阅以下资源:
- JumpStart 排行榜方法论。
- Amazon SageMaker JumpStart。
- SageMaker JumpStart 文档。
- 基于用例的 SageMaker JumpStart 部署。
- 使用 SageMaker 无服务器定制来定制模型。
打开排行榜,为你的工作负载挑选两三个候选模型,并在为生产环境选定其中一个之前,部署它们以用你自己的提示词进行测试。