 Newshot
TL;DR:我们将 SuperKMeans 与 e-means 融合,实现了高维向量聚类的 3 倍加速,且无质量损失。现已在 https://github.com/cwida/SuperKMeans 提供。
最近,向量嵌入的聚类领域热闹非凡:EVōC、SuperKMeans、QGKmeans,以及就在上周出现的 e-means、o-means 和 s-means。其中,e-means 是件大事:它承诺只需 2 个 epoch 就能达到与 Lloyd's 相同的质量。为什么这对向量搜索来说是件大事?
嗯,聚类是大规模向量索引(例如 IVF、ScANN)的关键构建模块,而这恰恰是用户在发起相似性搜索查询之前不得不等待的瓶颈。
一年前,我们发布了 SuperKMeans。SuperKMeans 通过在聚类时避免扫描向量维度,将 Lloyd's k-means 加速 2—10 倍,且不以聚类质量为代价。SuperKMeans 已被业界迅速采用(ParadeDB、Zilliz、FAISS),这表明改进高维向量聚类性能是多么及时。然而,e-means 同样令人兴奋,因为它通过运行更少的 epoch 来减少计算量。传统上,向量嵌入的聚类被标准化为 10 个 epoch。而 e-means 承诺仅用 2 个 epoch 就能达到相同(或更好)的聚类质量。我推荐大家去看看 e-means 作者制作的精彩网站:https://e-means.github.io/
有趣的是,在他们的论文中,作者提出 SuperKMeans 的维度剪枝思路与 e-means 是正交的。我们同意:这两个想法之间没有任何相互对立之处。自然而然,这让我们开始动手了!
实验设置
我们扩展了聚类库,实现了 e-means 和 SuperEMeans(已在 https://github.com/cwida/SuperKMeans 开源),并测量了它们的收益。
数据集:我们将使用两个数据集:i) 来自 VectorDBBench 基准的 500 万条 1536 维 OpenAI 嵌入:https://huggingface.co/datasets/makneeee/openai_large_5m。(27 GB)。ii) 用 Cohere Embed V3 模型嵌入的前 1000 万条 MS MARCO 段落(1024 维向量):https://huggingface.co/datasets/Cohere/msmarco-v2.1-embed-english-v3(40 GB)。
索引:我们将构建一个点与簇的比例为 1:256 的 IVF 索引,因此 OpenAI 数据集约有 20,000 个质心,Cohere 数据集约有 40,000 个质心。
配置:本次实验,我将使用单台 Zen 5 机器,16 核、128 GB 内存(r8a.4xlarge | $1.278/hr)。不过,我们的 SuperKMeans 库可在任何 CPU 上运行(例如 Intel、Graviton、Zen)。
结果
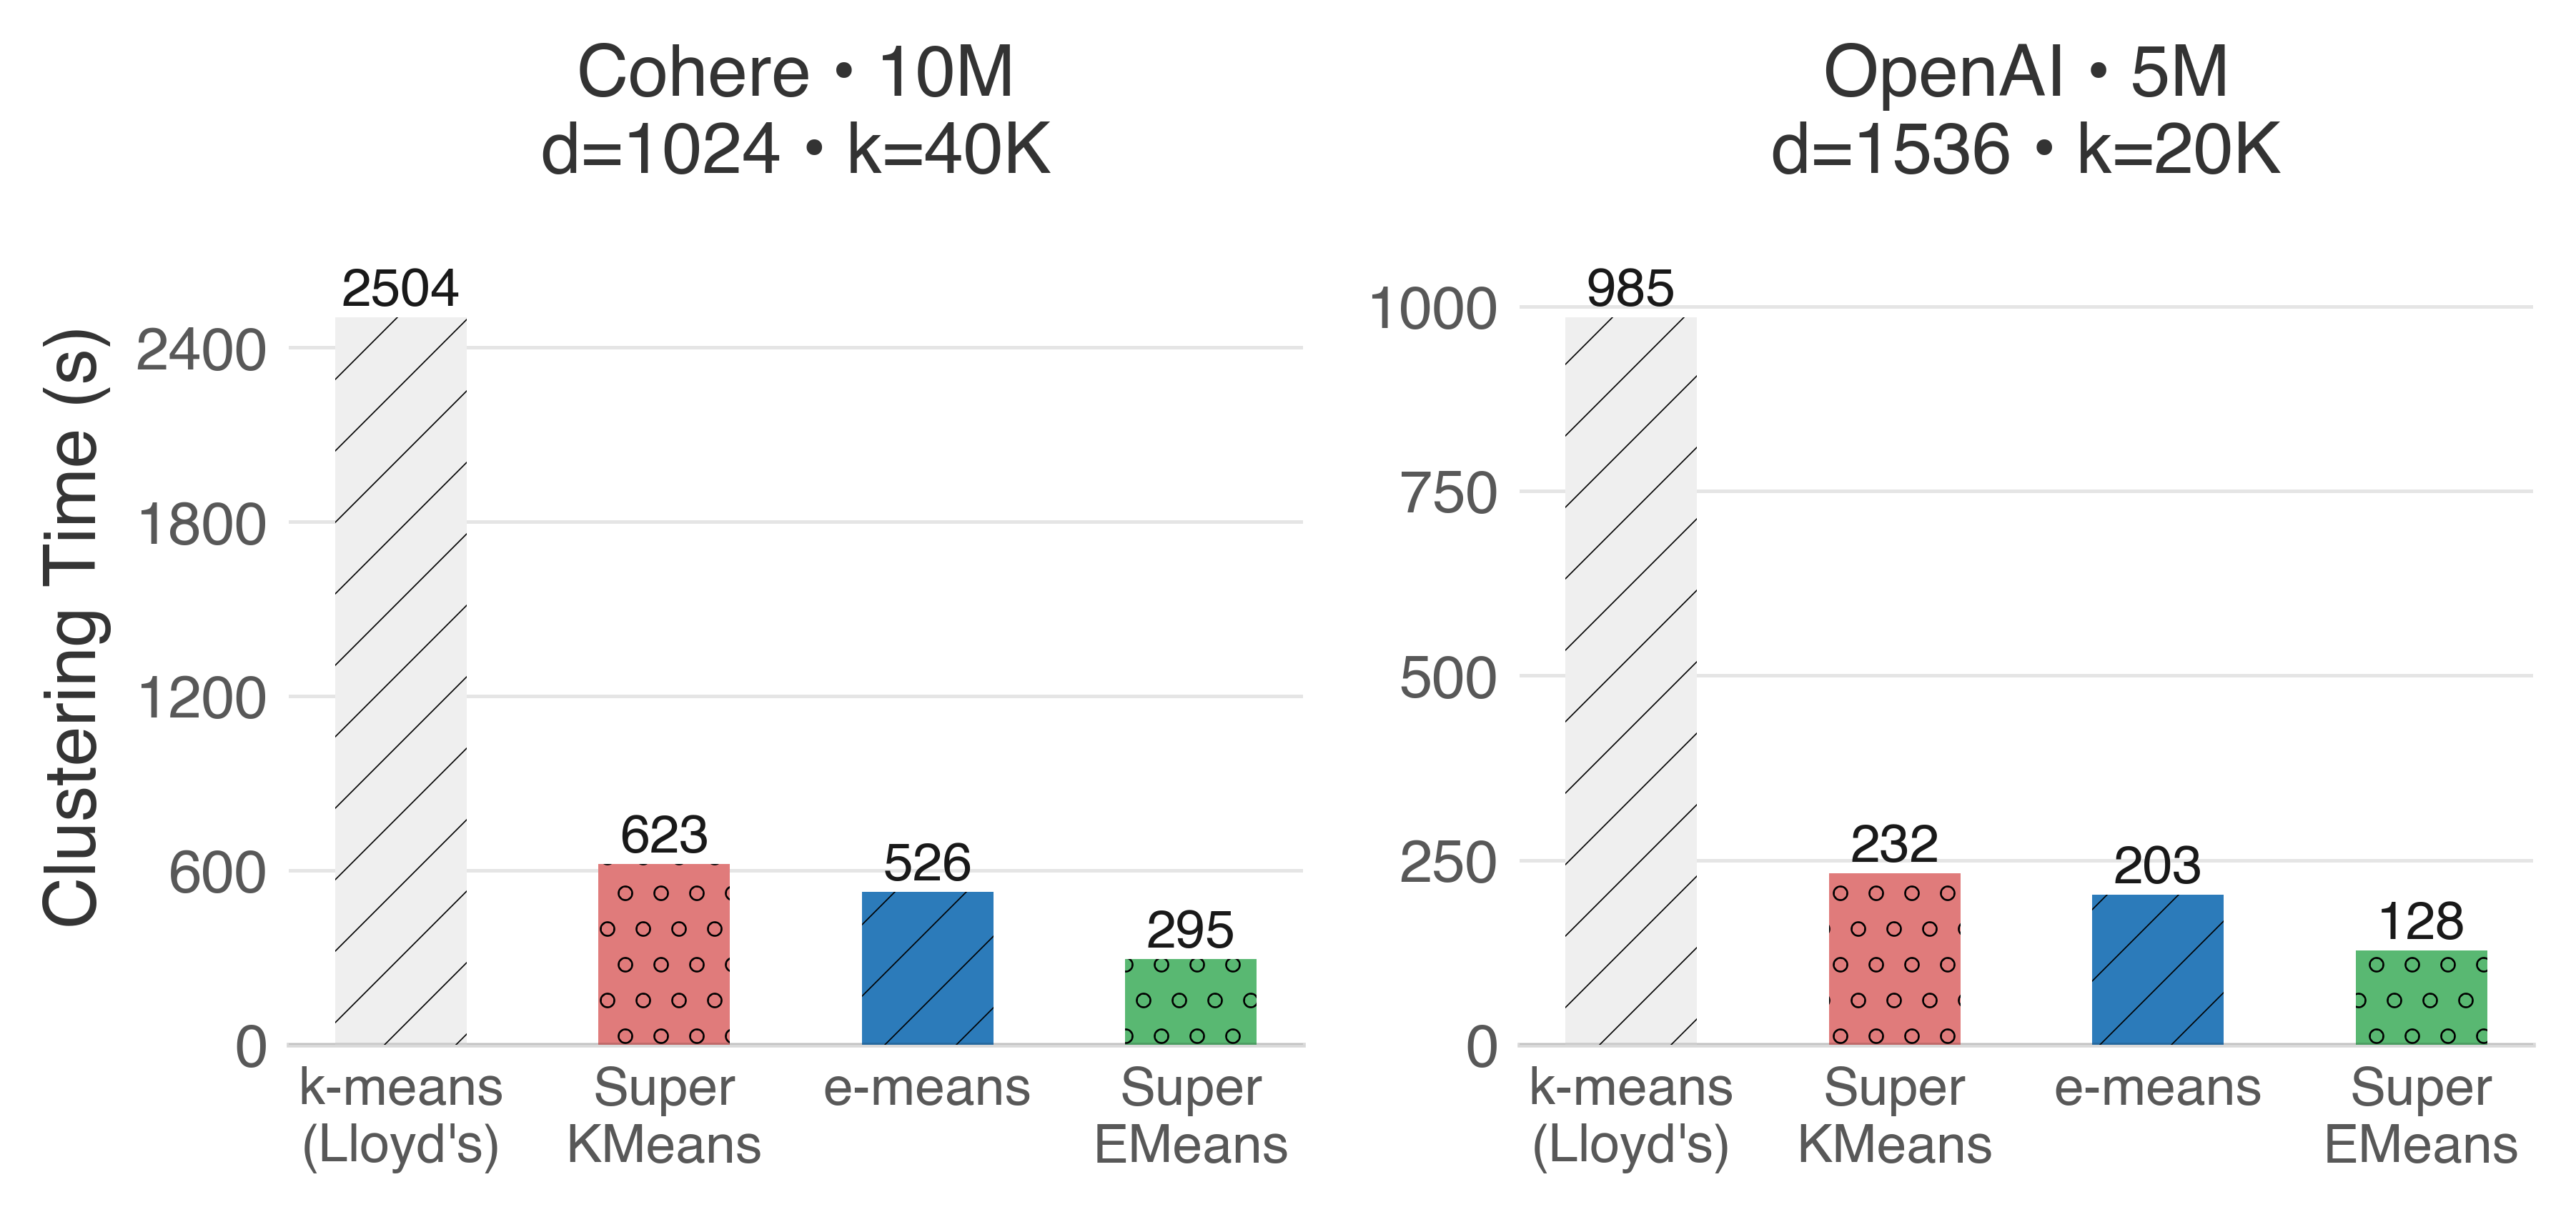
下图比较了 Lloyd's(10 次迭代)、SuperKMeans(10 次迭代)、e-means(2 个 epoch)和 SuperEMeans(2 个 epoch)的端到端聚类运行时间。SuperEMeans 大幅加速了 e-means,最高快 1.8 倍。
但是……这是高质量的索引吗?
让我们比较各方法得到的质心在向量搜索任务上的表现。在本分析中,我们向 IVF 索引发出 1000 条查询。然后,我们测量在扫描 1% 可用簇的情况下,检索到的前 100 条结果中落在真实前 100 条结果里的比例(recall@100)。我们还通过统计扫描这些簇时执行的距離计算次数,比较了簇的均衡性。OpenAI 数据集的结果汇总在下表中:
| 算法 | 运行时间(秒) | 探测 1% 质心时的平均 Recall@100 | 探测 1% 质心时平均扫描向量数 |
|---|---|---|---|
| Lloyd's k-means(10 次迭代) | 985 | 0.962 | 52 053 |
| SuperKMeans(10 次迭代) | 232 | 0.962 | 51 993 |
| e-means(2 个 epoch) | 203 | 0.967 | 58 184 |
| SuperEMeans(2 个 epoch) | 128 | 0.967 | 58 198 |
| e-means(2 个 epoch,作者实现) | 333 | 0.967 | 58 111 |
e-means 中的 Recall@100 略高。然而,我们最终在搜索过程中多扫描了约 10% 的向量。为了匹配扫描的向量数,我们必须在 e-means 中探测略少一些的簇,约为总簇数的 0.90%。这导致 recall@100 = 0.964,同时扫描 51,962 个向量,最终相比传统 k-means 是更好的权衡。
Cohere 的情况也一样:
| 算法 | 运行时间(s) | 探测 1% 质心时的平均 Recall@100 | 探测 1% 质心时的平均扫描向量数 |
|---|---|---|---|
| Lloyds k-means(10 iters) | 2504.4 | 0.919 | 112 714 |
| SuperKMeans(10 iters) | 623.3 | 0
另一种做法是对量化后的向量进行聚类。例如,在聚类前先把 32-bit 浮点数量化为 8-bit 整数,或量化为 1-bit RaBitQ 编码。我们在另一篇研究论文中对此进行了探索,并取得了显著的结果。
SuperKMeans 和 e-means 的详细技术报告可在 arXiv 上获取。
可复现性
用于复现本博客文章结果的源代码位于:https://github.com/lkuffo/reproducibility-superemeans