 Newshot
文章标题:睡眠框架:让 LLM 在持续学习中保留知识的新方法
正文: 现代 LLM 通过预训练和上下文学习(ICL)取得了令人瞩目的性能。然而,一旦部署,它们在很大程度上仍是静态的,运行于固定的知识截止日期之下,无法获得长期能力或适应新信息。
虽然用新数据更新模型看似是显而易见的解决方案,但持续的参数量更新往往会引发灾难性遗忘——这是一个根本性问题:学习新任务会严重损害模型在先前所学任务上的表现。另一方面,严格依赖 ICL 会使知识保留仅限于即时上下文窗口:一旦上下文会话结束,所获得的短期信息便会被遗忘。
受人类大脑在休息期间如何处理并稳定记忆的启发,我们提出了一种用于持续学习的睡眠框架:这是一种学习范式,为大型语言模型(LLM)赋予持续的周期性生命周期,使其能够持续学习,将脆弱的短期上下文巩固为稳定的长期参数。借助这一框架,我们证明,在主动交互与离线记忆巩固之间交替,能够让 LLM 持续获取新事实、保留最长 10M token 的长上下文知识,并提升复杂推理能力。
重新思考机器学习:主动(清醒)阶段与睡眠阶段
传统机器学习依赖于训练与推理之间的严格分离。在持续学习框架中,这种区分变得人为化;智能体必须不断学习、适应并处理信息。
在睡眠范式下,LLM 在两种主要状态之间运行:
- 主动(清醒)阶段:模型主动接收、处理输入并与之交互,将临时信息存储在快速、短期的记忆组件中。
- 睡眠阶段:模型暂停处理新输入,并将内部计算转向记忆巩固与自我提升。
虽然“睡眠”“做梦”和“自我提升”等术语借自神经科学,但我们的框架完全运行在固定的模型架构和人类定义的训练规则之内。在离线睡眠阶段,模型解锁预先分配的混合专家(MoE)记忆块,并使用自我生成的练习样本更新其数值权重。这一自动化后训练循环帮助已部署的模型吸收新事实并提升其推理准确率,同时保持其核心代码库和设计不变。
睡眠过程的关键组成部分
睡眠范式通过两个阶段来应对灾难性遗忘与持续适应:记忆巩固和做梦。
1. 记忆巩固
在人类大脑中,非快速眼动(NREM)慢波睡眠通过抽象和蒸馏将脆弱的记忆巩固为长期结构。我们提出的睡眠框架通过两个关键技术机制来模拟这一自然现象:
- 参数扩展与连续体记忆层级:为防止灾难性遗忘,模型在睡眠期间动态扩展其容量。借助混合专家(MoE)和 Hope 架构,新解锁的低秩专家被整合到稳定的低频记忆块中,以存储新传入的知识,同时不干扰较旧的参数。
- 知识播种(向上蒸馏):存储在高频层(例如上下文内记忆)中的脆弱短期记忆被转移到新扩展的长期参数中。这通过广义知识蒸馏(GKD)结合基于强化学习(RL)的模仿学习来实现:同策略蒸馏:扩展后的学生模型从在自采样序列上生成的教师分布中学习针对特定 token 的反馈。学习模仿(LTI):在补全教师生成文本的前缀时,学生模型根据语义相似度和绝对相似度(Levenshtein 距离)获得奖励。
- On-policy distillation:扩展后的学生模型从基于自采样序列生成的教师分布中学习 token 级别的反馈。
- Learning to imitate (LTI):学生模型在补全教师生成文本的前缀时,基于语义相似度和绝对相似度(Levenshtein 距离)获得奖励。
- Synaptic pruning:一旦记忆向低频模块的巩固完成,高频临时参数即被重置,为未来的活跃会话释放容量。
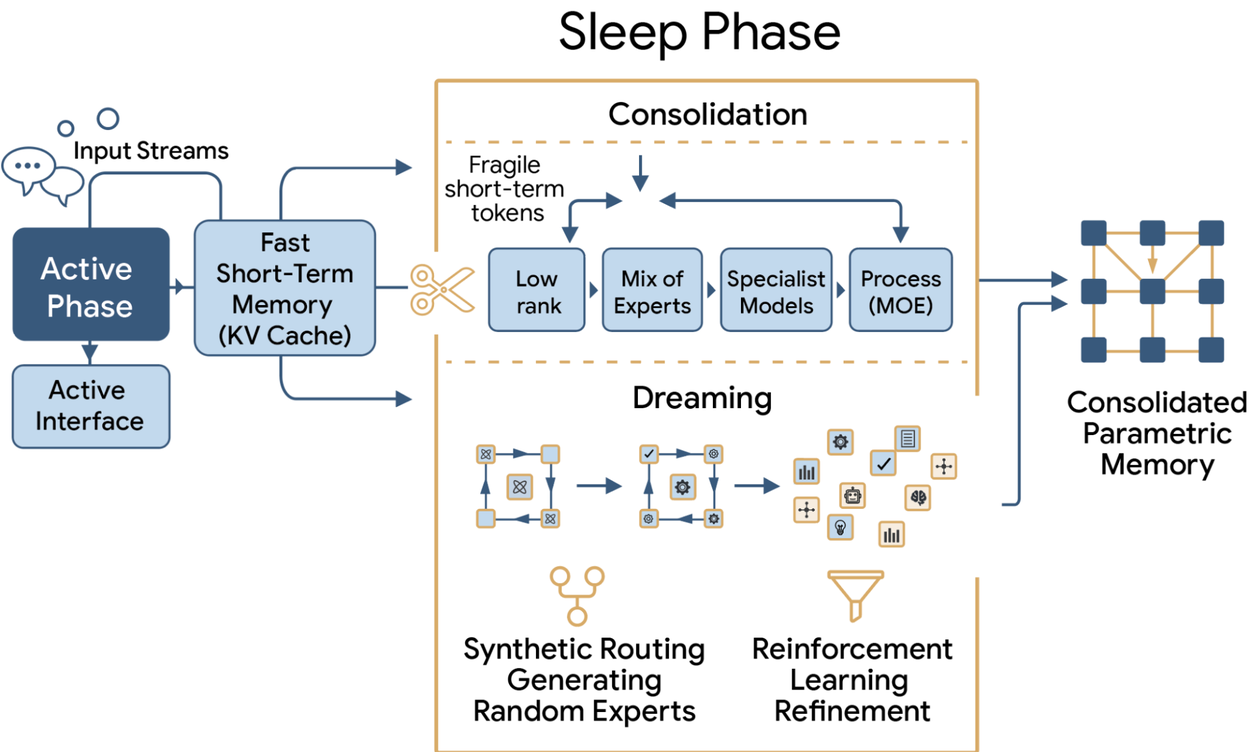
我们的 sleep 框架概览:来自活跃阶段的输入流在进入睡眠周期之前先存储在短期记忆中,随后睡眠周期分叉为巩固(Consolidation,利用低秩结构和 MoE 将脆弱的短期 token 转入扩展的长期参数化记忆)与 dreaming(Dreaming,通过随机专家的合成路由与 RL 精炼实现自主自我改进)。
2. Dreaming for self-improvement
在 REM 睡眠期间,人脑会主动模拟场景、巩固情感/语义连接,并探索新的神经通路。与此相仿,在“dreaming 阶段”,sleep 框架实现了一个自主自我改进循环:
- Random expert selection:在合成数据生成过程中,MoE 路由器随机激活非标准专家。这迫使模型混合不同领域的知识并发现潜在模式。
- Curated rehearsal:模型生成合成训练样本(“dreams”),并使用基于梯度的数据选择对其进行过滤,以优先选取最有可能提升模型整体能力的样本。
- RL refinement:模型对评分最高的 dream 样本执行监督微调,并评估该生成是否提升了下游任务的性能。
Theoretical foundations
除实证结果之外,我们的 sleep 范式还建立在一个理论之上,该理论阐明了为何其两个阶段(记忆巩固与 dreaming)能够支撑持续学习,而不只是用新知识换取旧能力。
对于记忆巩固,分析表明知识播种可以理解为一个结构化的低秩压缩问题。模型并不被要求把短期痕迹的每一个细节都复制进参数中。相反,它识别出一组紧凑的方向,这些方向能最好地同时保留模型自身的 on-policy 行为以及学习目标所奖励的语义特质。
这一视角解释了两种信号的互补作用:on-policy distillation 使巩固过程与模型在推理时实际产生的轨迹对齐,减少仅基于教师生成分布训练时可能出现的失配;与此同时,语义奖励改变了什么值得保留,优先保留意义和任务相关行为的方向,而非仅仅匹配 token 概率。参数扩展则提供了写入这些被选记忆所需的容量,而不会覆盖此前已巩固的知识。
对于 dreaming,该理论将随机专家激活和基于奖励的样本选择刻画为改善学习几何的机制。注入不同的 MoE 拓宽了合成生成过程中所探索的梯度方向集合,使模型接触到比仅由其常规清醒期数据所诱导的更丰富的更新集合。基于梯度的过滤随后强调携带最有用的学习信号的合成经验,强化有信息量的方向,同时保留底层梯度空间的结构。
这些步骤共同带来了更均衡的优化景观:学习不再被少数几个方向主导,梯度的条件更好,模型在精炼自身能力时能够取得更稳定的进展。从这个角度看,做梦并不仅仅是自生成的数据增强;它是一个刻意设计的过程,用于对模型自我改进所依赖的更新进行多样化、选择和巩固。
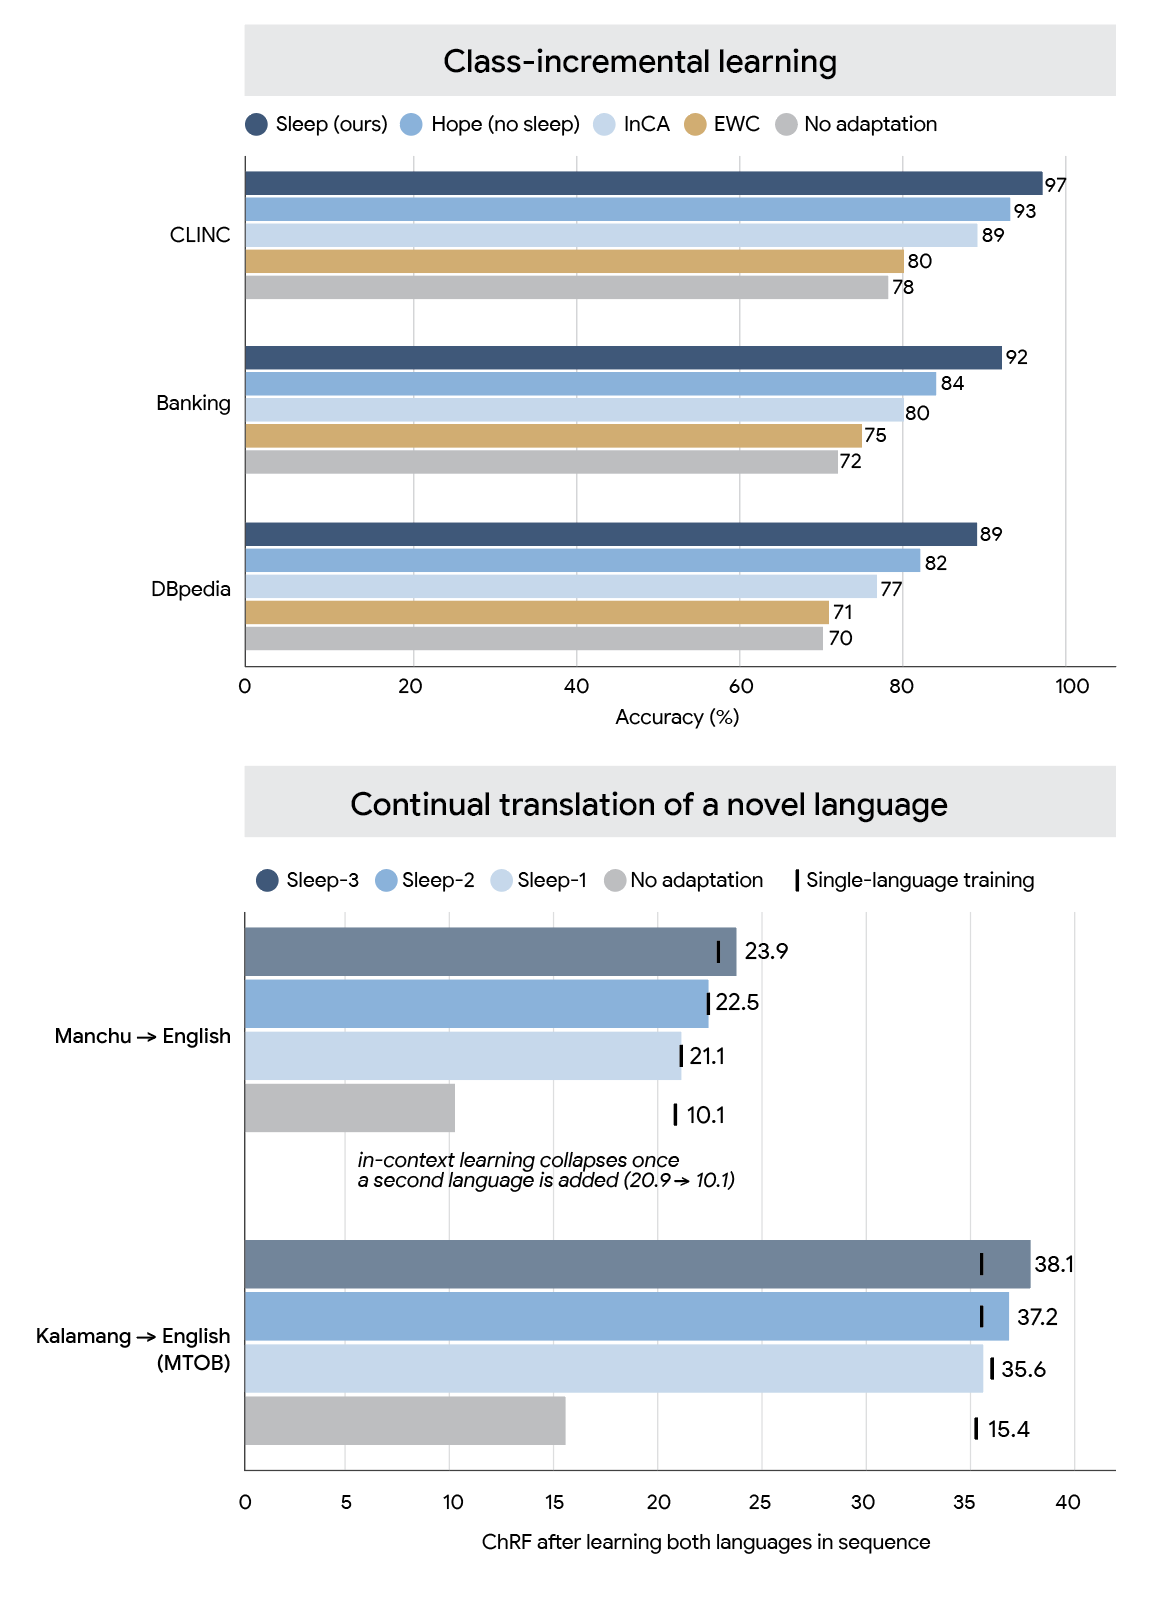
我们的睡眠框架与基线方法(如上下文学习和监督微调)在主要评估维度上的对比表现,包括类增量学习、持续翻译、高达 10M token 的长上下文扩展、事实知识融入以及数学推理。
在持续翻译方面,对于未见过的语言,如满语和 Kalamang,睡眠框架在多阶段评估中保持了接近零的性能下降,而 ICL、Cartridges 和监督微调(SFT)等标准基线在顺序学习中遭受了严重的灾难性遗忘。
在 BABILong 基准上的长上下文理解中,我们的睡眠方法展示了高达 10M token 的近乎完美的扩展性,通过利用睡眠时间巩固将长上下文信息直接压缩到参数记忆中,优于 GPT-4 和 Titans 等强基线。
在基于 SQuAD 和持续预训练(CPT)评估的事实知识融入方面,我们的睡眠方法在单任务上达到 48.9%,在 CPT 评估中达到 46.2%,通过成功整合新的事实信息而不降低现有模型表示,优于包括基础模型、SFT 和自适应语言模型(SEAL)在内的基线方法。
最后,在包括 AIME 24/25 和 HMMT 25 的数学推理基准上,睡眠增强的基础模型分别达到了 79.2%、69.0% 和 46.1% 的准确率分数。这优于 SFT、组相对策略优化(GRPO)和同策略自蒸馏(OPSD)等基线,表明将记忆巩固与模仿学习相结合能够驱动更优越的推理表现。
Conclusion
我们的睡眠范式为自主、持续学习的 AI 系统提供了一条路径。通过超越静态预训练和脆弱的上下文窗口,在主动学习和离线休息之间交替,使 LLM 能够保留短期记忆,将新技能抽象为长期参数结构,并在不发生灾难性遗忘的情况下持续自我改进。
Acknowledgements
本研究由 Ali Behrouz(Google 和 Cornell University)、Farnoosh Hashemi(Cornell University)、Adel Javanmard(Google 和 University of Southern California)以及 Vahab Mirrokni 完成。我们感谢 Yuan Deng 和 Corinna Cortes 审阅本工作并提出宝贵建议。我们还感谢 Mark Simborg、Kimberly Schwede 和 Tim Herrmann 在撰写本博客文章过程中提供的帮助。
像 {{NAME_ab12cd34}} 这样书写的值是真实值的占位符。在回复和工具调用中都完全按照书写原样使用它们:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。