 Newshot
数独揭示了 AI 架构与我们经济未来的什么
在约束满足问题上对基于能量的模型与自回归模型进行基准测试
Logical Intelligence 构建了首个商用基于能量的推理模型 Kona 1.0;当问题需要可验证准确的解决方案时,它相比大语言模型具有明显优势。
LLM 推理在那些通过语言完成有用规划的问题上很强:对话、摘要、翻译和代码生成。它们擅长产出语法上有效的解决方案,大致做到你要求的事情。LLM 生成的代码大多能运行,翻译大多正确;如果翻译发生在一种人们很可能不熟悉的语言中(Haskell、他加禄语),相比典型人类表现的提升是巨大的。
但经济中最重要的许多问题并不像语言。机器人固件、工业控制系统、芯片设计、能源电网优化和高频交易都是约束满足问题:需要找到一种配置,使所有事物彼此一致;这无法通过孤立地一次做出一个选择并希望它们最终能成立来完成。
我们找到了一种有力方式来证明,像 Kona 这样的基于能量的推理模型(EBRM)在约束满足上天生优于 LLM,以及为什么这很重要:我们让 Kona 学习解数独。
数独很好地说明了 EBRM 能比 LLM 高效得多地解决的那类问题。尽管这个游戏完全可以用语言描述,但用语言对它进行推理却很别扭——这恰好暴露了自回归模型被优化的目标与约束满足所需之间的差距。Kona 是我们为后者构建优化方案的努力。
在约束满足问题上对基于能量的模型与自回归模型进行基准测试
Logical Intelligence 构建了首个商用基于能量的推理模型 Kona 1.0;当问题需要可验证准确的解决方案时,它相比大语言模型具有明显优势。
LLM 推理在那些通过语言完成有用规划的问题上很强:对话、摘要、翻译和代码生成。它们擅长产出语法上有效的解决方案,大致做到你要求的事情。LLM 生成的代码大多能运行,翻译大多正确;如果翻译发生在一种人们很可能不熟悉的语言中(Haskell、他加禄语),相比典型人类表现的提升是巨大的。
但经济中最重要的许多问题并不像语言。机器人固件、工业控制系统、芯片设计、能源电网优化和高频交易都是约束满足问题:需要找到一种配置,使所有事物彼此一致;这无法通过孤立地一次做出一个选择并希望它们最终能成立来完成。
我们找到了一种有力方式来证明,像 Kona 这样的基于能量的推理模型(EBRM)在约束满足上天生优于 LLM,以及为什么这很重要:我们让 Kona 学习解数独。
数独很好地说明了 EBRM 能比 LLM 高效得多地解决的那类问题。尽管这个游戏完全可以用语言描述,但用语言对它进行推理却很别扭——这恰好暴露了自回归模型被优化的目标与约束满足所需之间的差距。Kona 是我们为后者构建优化方案的努力。
在约束满足问题上对基于能量的模型与自回归模型进行基准测试
Logical Intelligence 构建了首个商用基于能量的推理模型 Kona 1.0;当问题需要可验证准确的解决方案时,它相比大语言模型具有明显优势。
数独揭示了 AI 架构与我们经济的未来
LLM 推理在那些有用规划通过语言进行的问题上表现很强;对话、摘要、翻译和代码生成。它们擅长生成语法上有效的解决方案,大致完成你要求的事情。LLM 生成的代码大多能正常运行,翻译大多正确,而且如果它们发生在一种人们可能不太熟悉的语言中(Haskell、Tagalog),相较典型人类表现的提升是巨大的。
但经济中最重要的许多问题看起来并不像语言。机器人固件、工业控制系统、芯片设计、能源网格优化和高频交易都是约束满足问题,其中需要找到一种配置,使所有事物都彼此一致;这无法通过孤立地一次做出一个选择并希望它们最终可行来实现。
我们找到了一种有力的方式来展示,像 Kona 这样的基于能量的推理模型(EBRMs)为何在约束满足方面天生优于 LLM,以及这为什么重要:我们让 Kona 学习解数独。
数独很好地说明了 EBRMs 能比 LLM 高效得多地解决的那类问题。尽管这个游戏完全可以用语言描述,但用语言对其进行推理却很别扭——这恰恰暴露了自回归模型所优化的目标与约束满足所要求的东西之间的差距。Kona 是我们为后者构建优化系统的努力。
基于能量模型与自回归模型在以下方面的基准测试
约束满足
Logical Intelligence 构建了首个商用基于能量的推理模型 Kona 1.0,当问题需要可验证准确的解决方案时,它相较大型语言模型具有明显优势。
LLM 推理在那些有用规划通过语言进行的问题上表现很强;对话、摘要、翻译和代码生成。它们擅长生成语法上有效的解决方案,大致完成你要求的事情。LLM 生成的代码大多能正常运行,翻译大多正确,而且如果它们发生在一种人们可能不太熟悉的语言中(Haskell、Tagalog),相较典型人类表现的提升是巨大的。
但经济中最重要的许多问题看起来并不像语言。机器人固件、工业控制系统、芯片设计、能源网格优化和高频交易都是约束满足问题,其中需要找到一种配置,使所有事物都彼此一致;这无法通过孤立地一次做出一个选择并希望它们最终可行来实现。
我们找到了一种有力的方式来展示,像 Kona 这样的基于能量的推理模型(EBRMs)为何在约束满足方面天生优于 LLM,以及这为什么重要:我们让 Kona 学习解数独。
数独很好地说明了 EBRMs 能比 LLM 高效得多地解决的那类问题。尽管这个游戏完全可以用语言描述,但用语言对其进行推理却很别扭——这恰恰暴露了自回归模型所优化的目标与约束满足所要求的东西之间的差距。Kona 是我们为后者构建优化系统的努力。
我们的数独演示是一种让你自己看到差异的简单方式。
我们让 Kona 与一组流行 LLM 实时同台解困难数独,包括 GPT-5.2、Claude Opus 4.5 和 Sonnet 4.5、Gemini 3 Pro 以及 DeepSeek V3.2。在公开访问约一周后,Kona 解出了 96.2% 的谜题,平均用时 313 毫秒。前沿 LLM 合计的解出率只有 2%,在给出错误答案或超时前最多耗时 90 秒。
数独揭示了 AI 架构与我们经济的未来
LLMs 在数独上表现不佳,原因并不是规则特别复杂;一个数独盘面是由 81 个格子组成的 9x9 网格,每行、每列以及每个 3x3 宫都必须恰好包含一次数字 1 到 9。但 LLM 架构并不适合空间类任务;解这些谜题需要把整个网格记在脑中,并推理一个格子的变化会如何影响同一行、同一列和同一宫中的其他所有格子。
由于 LLMs 是逐 token 生成,并在生成过程中就确定每一个 token,因此当它们后来发现冲突时,无法轻易修正先前的决定。这不是靠增加更多算力或看更多数独题就能解决的挑战——这是自回归语言模型固有的结构性限制。
请访问 sudoku.logicalintelligence.com 查看实时基准测试。
我们在演示中为所有模型禁用了代码执行,以防止 LLMs 编写 Python 暴力回溯求解器并运行它,因为那样只能说明它们的编码能力,而对它们的推理能力毫无说明。关闭代码执行后,模型必须真正运用它们所具备的推理能力来解谜,而这些能力最终被证明并不适合约束满足问题。
我们也没有在这些 LLMs 上针对数独问题进行微调。微调测试的是对记忆解的模式识别,而不是推理。Kona 同样没有在已解出的谜题上训练;它学习约束结构,并仅凭这些信息解决全新配置。比较的是推理架构,而不是领域特定暴露的程度。*在一项单独的实验中,我们只使用部分解(50% 的解被掩码)训练模型,模型仍然学会了规则,并能够在测试时生成完整解。
LLMs 接收一个谜题后开始产出一连串推理:“让我按行、列和宫来分析”“对于格子 (4,1),这一行需要 1、2、3、5、7、8、9”,等等,有时会生成数百个 token 的逐步分析。然后它们输出一个网格,其中某一行有重复数字、某一列缺少数字,或存在其他约束违反。DeepSeek V3.2 往往很快完成,但在行、列和宫中出现大量重复——未能解出谜题。Claude 模型常常思考很长时间,然后产出接近但仍错误的结果。GPT-5.2 在 LLMs 中表现最好,达到 6.9%,但这仍然意味着在一个任何有耐心的人都能解出的谜题上有 93% 的失败率。
Kona 处理问题的方式不同,因为它是另一种模型。Kona 不是逐 token 生成解,而是产出一个完整的候选网格,并同时针对所有约束进行评估,给出一个标量能量分数:低能量表示约束得到满足,高能量表示有约束被违反。如果能量高,Kona 可以识别出哪些约束被破坏,并修正网格的相关部分而无需从头开始,利用连续潜在空间中的梯度信息朝有效配置移动。这一过程平均耗时约 313 毫秒,而 LLMs 花费 30 多秒生成毫无结果的推理轨迹。
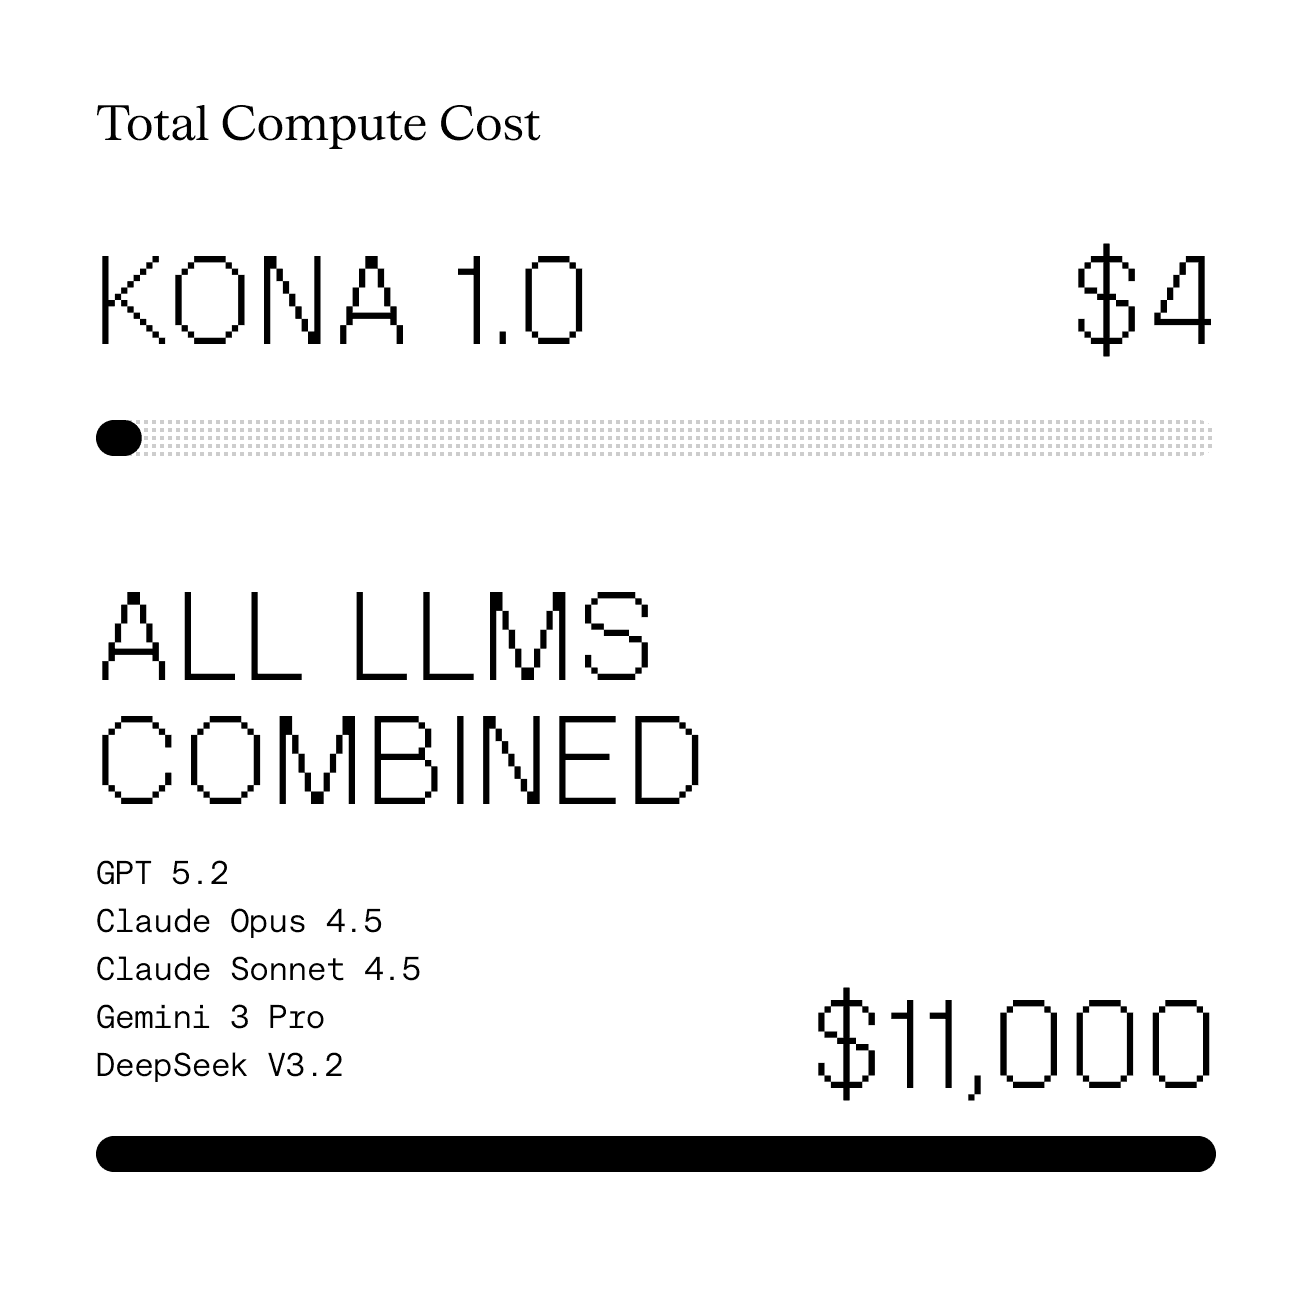
成本差异也很显著。在它实际解出的近 13,000 个数独上运行 Kona,目前 GPU 时间成本约为 4 美元,计算时长约 1.1 小时。同一演示在 98% 失败率下的 LLM API 调用成本约为 11,000 美元,主要来自 Claude 的 token。
数独对 AI 架构和我们经济未来的启示
如果一个模型架构连数独都处理不了——数独的约束简单、状态空间很小——它就不可能处理监督工业控制系统,或涉及数十亿美元的全球交易。96% 与 2% 之间的差距并不在于数独——它展示的是这些架构的设计有多么截然不同。
问:AI 中的基于能量的模型(EBM)是什么?
答:基于能量的模型(EBM)是一种 AI 架构,它依据约束评估完整解,并给有效状态分配较低的“能量”分数。这使它能够整体推理并纠正错误,而不像 LLM 那样逐步生成输出。
问:为什么 LLM 不擅长数独?
答:LLM 是自回归的;它们逐个 token 确定答案,并且当后续约束发生冲突时,很难修正早期错误。这使它们不适合数独这类空间性的约束满足问题。
问:哪种 AI 最擅长解数独?
答:在我们的基准测试中,Logical Intelligence 的基于能量的模型 Kona 解出了 96.2% 的困难数独题,平均延迟为 313ms,显著优于所测试的所有前沿 LLM。
问:AI 中的基于能量的模型(EBM)是什么?
答:基于能量的模型(EBM)是一种 AI 架构,它依据约束评估完整解,并给有效状态分配较低的“能量”分数。这使它能够整体推理并纠正错误,而不像 LLM 那样逐步生成输出。
问:为什么 LLM 不擅长数独?
答:LLM 是自回归的;它们逐个 token 确定答案,并且当后续约束发生冲突时,很难修正早期错误。这使它们不适合数独这类空间性的约束满足问题。
问:哪种 AI 最擅长解数独?
答:在我们的基准测试中,Logical Intelligence 的基于能量的模型 Kona 解出了 96.2% 的困难数独题,平均延迟为 313ms,显著优于所测试的所有前沿 LLM。