 Newshot
在 Close,我们的主要后端服务配有自动化测试。数量相当多,将近 58,000 个。虽然有些东西在纯 Python 里很容易测试,但真正让我们最有信心的测试,通常是 API 或服务级别的集成测试——它们避免 mock,而且一般确实会访问数据存储。
这 58,000 个集成测试在 CI 里跑完要多久?
大约 2 分半钟。
没错,58,000 个集成测试,其中大多数要在多个数据存储之间做 IO,全部在 3 分钟内跑完。
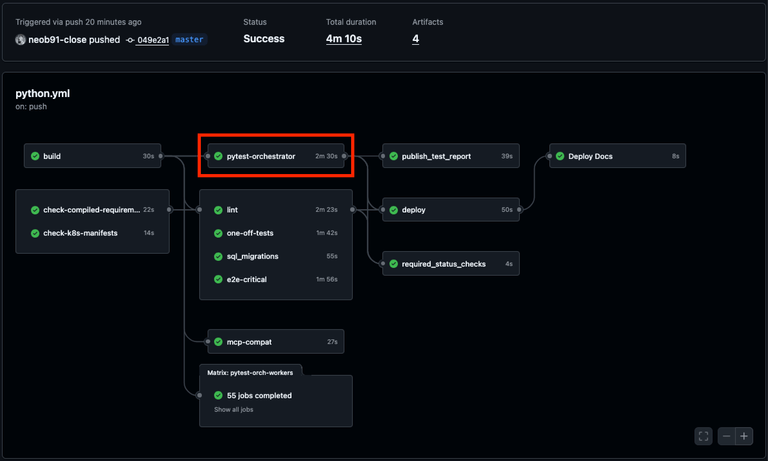
怎么做到的?我们一起来走一遍这段旅程……
学会爬行……
Close 于 2013 年上线,但我们的测试套件其实比公司还老!CI 里的测试在 2012 年就引入了,用的是 Jenkins 构建脚本和 nose 测试库。后来我们迁移到 CircleCI,再迁到 GitHub Actions,期间也换成了 pytest。但很多相同的概念至今仍然适用。一次测试运行的大致形态是:
对于只有少量测试的简单应用,这套设置非常好用!但随着应用开始增长,“运行测试”这一步会慢慢膨胀,直到你开始为等一个绿色对勾等上几十分钟。在开发功能时,你还会受到小妖精们烦人的低语侵扰:“但万一它能更快呢?它肯定能更快吧”
从爬到走……
顺理成章的下一步就是……并行!有几种常见的做法,但最直接的选项要么是多进程并行(比如 pytest-xdist),把工作分发到多个 CPU 上;要么是把工作确定性地拆分到多台机器上(比如 pytest-split)。
多 CPU 并行对我们其实没什么帮助,因为我们大多数测试依赖外部数据库。在同一个数据库上同时运行多个测试,可能导致逻辑冲突,测试最终会读到彼此的数据。虽然可以配置动态创建数据库之类的方案,但实践中,跨多个数据存储正确做到这一点既困难,要做到高性能就更难了。
确定性的工作拆分对我们来说有吸引力得多,因为许多 CI 提供商开始提供矩阵化构建,你可以轻松为每个构建指定不同参数(例如以并行度 4 运行 pytest,每个 runner 知道自己编号是几)。这种策略只是多了一点 CI 配置,但最终只需要安装一个插件,并在 CI 命令里加几个参数。今天它大概长这样:
pytest --splits 4 --group 1
这类逻辑的某个版本长期以来都很容易搭建,我们在 2014 年底把它引入了 Close。有了这个版本的测试拆分,我们的完整测试运行现在看起来像这样:
从走到跑……
早期版本的测试拆分逻辑依赖文件名来拆分测试,导致负载不均衡。最终我们得以稍微调整拆分逻辑,改为跟踪主分支的测试耗时,并对它们做装箱处理,而不是伪随机地拆分。
而这套粗略的设置居然撑了我们大约 12 年!在这段时间里,我们并没有忽视 CI 速度,但主要还是靠相对微小/渐进的改动来提升它:
- 把 unittest 风格的测试重构为 pytest
- 重构 pytest fixture,让测试更容易只依赖它真正需要的东西
- 在架构上重构,避免全局状态,并在测试边界情况时避免 API 开销
- 让全局导入远离共享 fixture
- 在 CI 中避免 pytest 断言重写
- 提高并行度(runner 数量)
- 升级 GitHub Actions runner 的 node 实例类型
但最终我们撞了墙。小妖精们仍在低语,但已经没有唾手可得的果实了。很长一段时间里,我们能把测试套件稳定在 10 分钟左右,但最终即使达到 17 倍并行,我们的 CI 时间还是越来越长。固定成本步骤变得非常难以优化,也很难通过横向扩展摆脱。
你说的“固定成本”是什么意思?
嗯,pytest-split 并行化的那部分测试运行,实际上是运行测试用例。当应用足够大时,仅仅运行测试收集之类的事情就可能需要长达一分钟才能完成。从技术上讲,它不是“固定”成本,但这些操作会随着整个应用/测试套件的规模扩展,而不只是随选中的测试子集扩展。所以即使我们增加 runner 的数量,很多运行时间仍然花在不断增长的设置成本上:
- 拉取镜像和启动数据存储可能需要一分钟
- 数据存储就绪之前,应用容器无法启动
- 应用容器就绪之前,测试收集无法开始
- 测试收集总是需要先收集完整套件,然后才能进行确定性拆分(即使没有启用 pytest 的断言重写,这也要花一分多钟)
尽管我们尽了最大努力,这套设置能获得的最佳性能大约是 12 分钟的实际运行时间。其中大约一半被固定成本步骤吃掉,或者被不完美的测试平衡吃掉——这不完美的平衡导致某些 runner 比其他 runner 多花好几分钟。我们已经在自托管 GitHub Actions runner,以从中榨取更好的性能,但把 N 这个旋钮调得更高,到某个点就会收益递减。而这还只是测试!还有无法并行的构建和部署步骤,它们继续累加到端到端运行时间中。
从运行到……飞?
那么我们从这里往哪里走?嗯……在查看与我们端到端 Playwright 测试相关的某个东西时,我偶然发现了 currents.dev。
currents.dev 为 Playwright 做的事情是,他们维护一个集中式的工作队列,并调整测试运行器逻辑,让它从该队列消费工作,而不是从确定性的 -split 工作划分中消费。他们展示了两大解锁:
- 智能编排:工作被动态拆分,因此负载始终被均匀拆分
- Spot 实例支持:如果某个 worker 的节点被 AWS 抢走,它的工作会被重新分配
这些功能非常巧妙,但这种架构还解锁了一个更微妙的机会:
我们可以更有效地并行化我们的固定成本设置步骤。
如果我们把这些概念应用到 pytest 会怎样?让我们可视化一下共享编排器如何改变我们的测试设置:
有几点值得指出:
- 编排器完全不需要运行数据存储
- 编排器只需要收集文件,这让我们可以跳过 pytest 收集运行时间的很大一部分
- Worker 只收集它们要运行的内容,这意味着它们的收集运行时间会缩减到与自己的工作负载相匹配
- 编排器可以在 worker 启动其后端的同时并行收集和拆分测试
所以现在我们多运行了一个作业(用于编排),但几乎我们所有测试 worker 的步骤的运行时间都会随要求它们运行的测试数量而扩展。接下来呢?
Spot 实例。
实际上,在 GitHub Actions 中实现 Spot 实例支持足够棘手,值得单独写一篇文章,所以目前我们只能把它留作悬念。但考虑到它们带来的节省幅度,我们能够以大致相同的美元成本,把 17 个按需 runner 变成 2 个按需 runner + 54 个 Spot 实例。也就是一个编排器和按需 worker(用于防止被抢的保险),外加 54 个 Spot 实例 worker。不过我们最终确实保留了主要的按需 runner,以保持可预测性。
有了这种并行度和我们改进后的扩展机制,我们的 CI 速度已经足够好……就目前而言。
魔鬼在细节中
如果你正试图复现这种设置,这里有一些更详细的信息可以提供帮助。
工作进程如何与编排器通信?
即使使用自托管 runner,工作进程也需要某种方式与编排器服务器通信。但 GitHub Actions runner 无法从外部寻址。我们通过让 pytest-orchestrator 的 CI 步骤更像一个 k8s operator 来绕过这一点:它在同一个 CI/CD Kubernetes 集群中创建一个临时的、具有确定性名称的 namespace / pod。
每个工作进程根据特定于本次运行的标识符知道要查找哪个 namespace,并有一段连接宽限期来等待它们启动。
失败时重跑
在类似 pytest-split 的设置中,只重跑一部分工作进程,就会重跑同一部分测试。既然测试是动态分布的,只重跑失败的测试就不那么简单了。如果只有一个工作进程失败,重跑失败作业实质上就相当于只用一个工作进程运行完整测试套件。很慢。
我们没有总是重跑所有作业,而是让每个工作进程等到所有批次都完成,然后由编排器决定这次运行是否干净。如果不干净,那么所有工作进程都失败。所有测试失败 / 堆栈跟踪都会出现在编排器的输出中,因此你不需要逐个检查每个工作进程是否有失败。但现在因为它们全都失败,重跑失败作业