 Newshot
设计 Langfuse AI Gateway
用户想要一个运行稳定、对调用它的智能体而言几乎不可见的网关。以下是我们设计它时学到的东西:为什么运行时对这种负载很重要,为什么我们选择了 Rust,以及为什么我们原样透传提供商 API 而不做转换。
Langfuse 是一个 AI 工程平台,提供用于追踪、改进和监控 AI 应用的工具。要追踪一个应用,你可以用 Langfuse
设计 Langfuse AI Gateway
- 吞吐量:一个实例能承载多少请求和打开的流。
- 开销:网关在第一个 token 到达 agent 之前增加了多少时间。
- 峰值期间的内存占用:超过容器内存限制的进程会被杀死,它正在服务的每一条流都会在响应中途被切断。
选择运行时
Langfuse 平台用 TypeScript 编写,运行在 Node.js 上。Python 是 AI 工程大量使用的另一种语言。我们对两者都很熟悉,所以两者都是自然而然的选择。但就这个工作负载而言,两者都对我们不利。我们已经在 Langfuse 的摄入管道中使用 Rust,所以也考虑把它用于网关。
Node.js:一个线程运行所有 JavaScript
Node.js 在单个线程(事件循环)上运行所有 JavaScript。等待 I/O 不会阻塞它,这就是 Node 能很好地处理大量空闲连接的原因。CPU 工作则会阻塞它:当 JSON.parse 处理一个 500 KB 的请求体时,没有其他 JavaScript 运行,因此来自提供方的数据块无法被转发,新请求也不会被读取。在负载下,每个请求都要等待排在它前面的每一个请求的 CPU 工作完成,即使每个请求需要的 CPU 工作量相同,延迟也会随负载增长。
我们在 Langfuse 自身的 Node.js 摄入管道中就亲身遇到过这个问题。网关会让情况更糟:请求体更大,每个请求和每条流都有 CPU 工作,而事件循环一旦停滞,就会延迟连接到该进程的每个 agent 的 token。
Python:全局解释器锁
在标准的 CPython 解释器中,全局解释器锁(GIL)只允许一个线程运行 Python 代码。在线程等待 I/O 时,多线程有帮助,但对于解析请求体这类 CPU 工作则没有帮助,所以一个进程大约只能在一个核上运行 Python。像 Uvicorn 这样的 Python 服务器改用工作进程来扩展,每个进程都有自己的解释器和内存,因此内存会随每个工作进程增长。
流量峰值下的内存
Node.js 和 Python 都替你管理内存,而且两者都不会在请求结束时立即释放内存。V8 是 Node 的 JavaScript 引擎,它通过垃圾回收器回收内存,而垃圾回收器在它自己决定时才运行。在突发流量期间,垃圾累积的速度快于回收速度,进程使用的内存远多于其存活请求所需。CPython 通过引用计数立即释放大多数对象,但其分配器会保留已释放的内存以供复用,很少将其归还给操作系统,因此进程会保持在其最大突发时的规模,容器限制必须覆盖那个峰值。而一个会缓冲响应(例如用于日志记录)的网关,占用会更多。
无论哪种情况,进程使用的内存都不是它当前所服务请求的简单函数,这使它难以预测。这一点很重要,因为容器的失效方式如此。当容器超过其内存限制时,内核会杀死一个进程。对于网关来说,该进程上的每条流都会在响应中途结束,其上的每个 agent 都会看到连接断开,不得不重试一个漫长的轮次。而这发生在流量峰值期间,也就是最不应该丢失流的时刻。
为什么我们选择 Rust
Rust 在语言和运行时层面解决了这些问题:
- 真正的多线程。网关运行在 Tokio(Rust 的异步运行时)上,每个核一个工作线程。请求被分散到所有核上,空闲线程会从繁忙线程那里接手排队的工作。一个请求上的 CPU 工作不会阻碍其他核上的流。更长的任务,例如编码一批遥测数据,运行在单独的线程池上,远离请求处理。
- 廉价的异步任务。每个请求都是一个异步任务:一个小的状态机,在等待时不使用 CPU,占用的内存远少于操作系统线程。成千上万条主要处于等待状态的打开流,代价很小。
标题:设计 Langfuse AI Gateway
正文:
- 内存可确定地释放。Rust 没有垃圾回收器。每个值只有一个所有者,当所有者离开作用域时,其内存就被释放。请求结束时,它的内存当场释放,而不是等回收器来处理。这让内存变得足够可预测,可以用来做预算,我们会在下文回到这一点。
- 单个紧凑的二进制文件。网关编译成一个原生二进制文件。无需安装解释器或运行时,因此容器镜像下载约 25 MB,运行也很简单。
- 纵向与横向扩展。一个进程会使用分给它的每一个核心,因此 CPU 和内存更多的实例能承载更多流量。而且由于网关不保存状态,你还可以在负载均衡器后面增加实例。
面向运维人员的设计
Langfuse 可在 Langfuse Cloud 上使用,也可自托管。对两者,我们都想要一个运行简单、扩展可预测的网关。为了检验设计是否达标,我们把同样的工作负载分别跑在我们的 Rust 网关(运行在 axum 上)、Node.js 网关(运行在 Hono 上)和 Python 网关(运行在 FastAPI 上),每个都是 2 个 vCPU 和 4 GiB 内存。1 Node.js 和 Python 网关是开源项目,配置为每个请求做与我们相同或更少的工作。
用满每一个核心
由于网关在每一个核心上运行请求,一个实例就能承载大量流量,容量随你给的 CPU 增长。
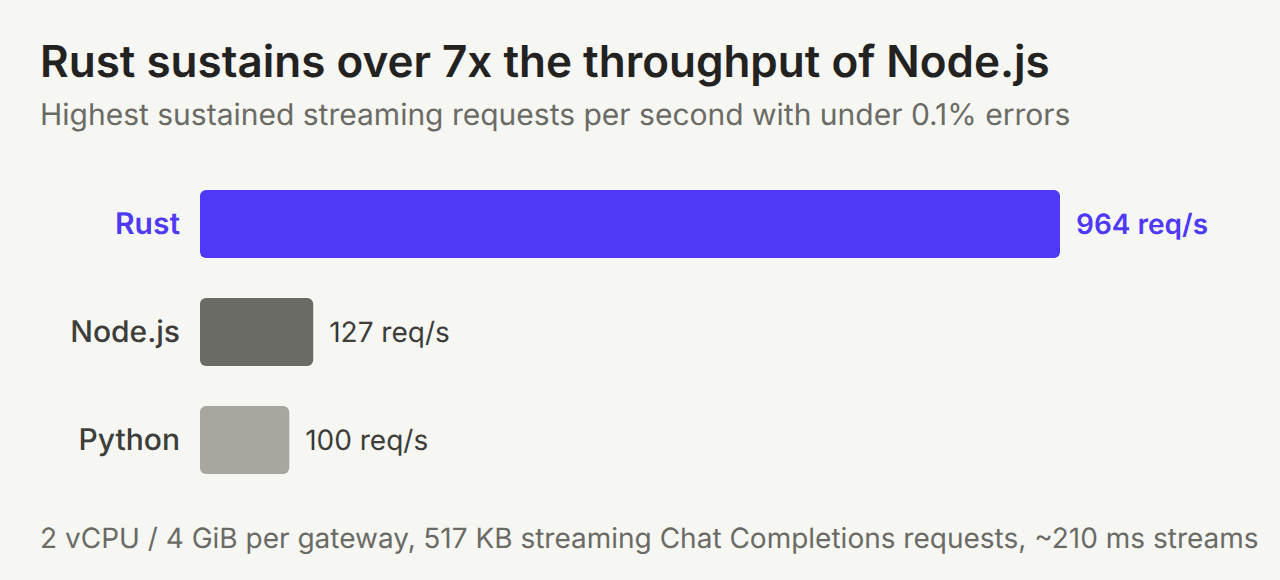
Rust 网关持续达到每秒 964 个请求,Node.js 网关 127 个,Python 网关 100 个。单个 Node.js 进程在其中一个核心上运行它的 JavaScript;以两个各 1 vCPU 的副本运行时,达到每秒 211 个请求。Python 网关的两个 worker 从大约 50 个并发请求起就受 CPU 限制。Rust 网关对每个请求都使用两个核心,CPU 同样是它的限制,只是速率高得多。
用满每一个核心还能让网关的开销随负载增长保持平稳,因为一个请求上的 CPU 工作不会让其他请求等待。
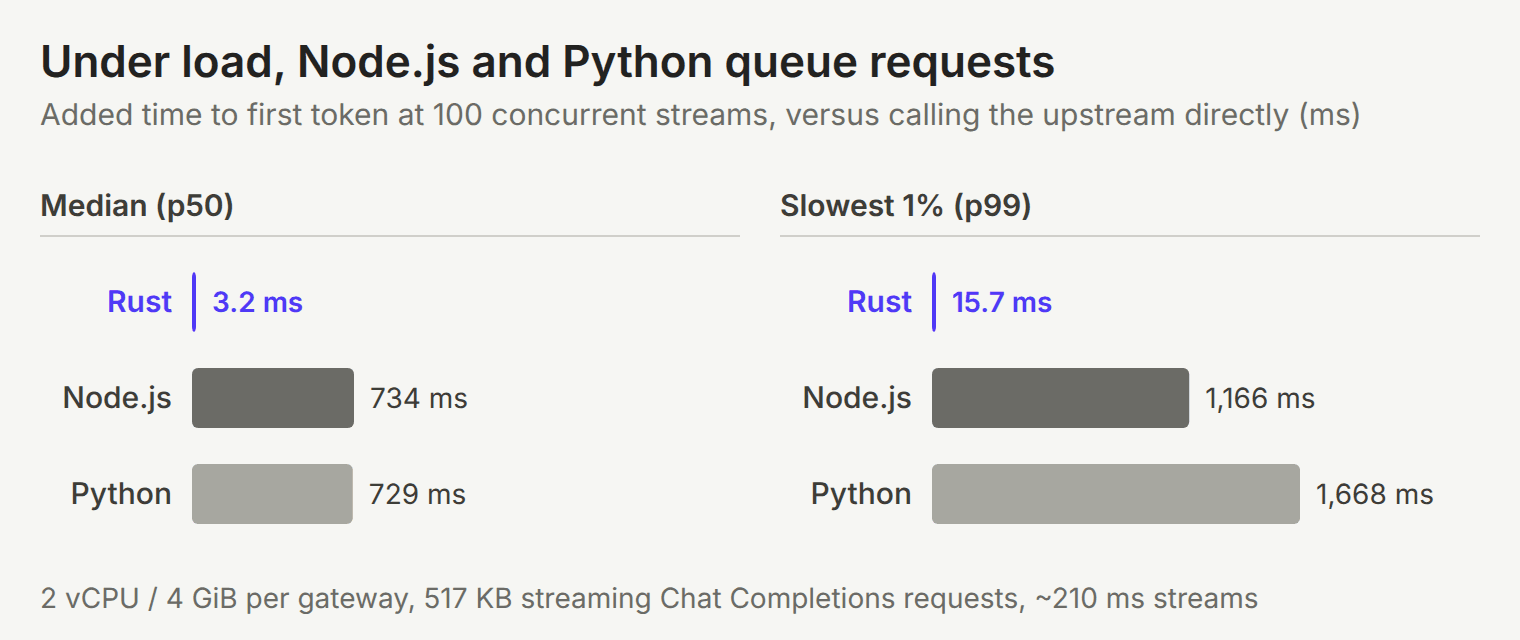
在 100 个并发流下,Rust 给首 token 时间的中位数增加了 3.2 ms,第 99 百分位增加 15.7 ms。Node.js 增加了 734 ms 和 1,166 ms,Python 为 729 ms 和 1,668 ms。一次只发一个请求时,三者都保持在 6 到 17 ms 之间。Rust 增加的时间大部分不是 Rust 本身:在 100 个并发流下,其 3.2 ms 中约 2.2 ms 是网关调用 Langfuse Web 解析 key 和 model,所以图表夸大了网关自身的开销。每个请求在这两个层面都需要同样的工作;多出来的时间是在排队,在 Node.js 里排在事件循环后面,在 Python 里排在 GIL 和繁忙的 worker 后面。一个模型要几百毫秒到几秒才作答,几毫秒在其中就消失了。而每个请求几百毫秒则不会。
把内存当作预算
因为 Rust 在请求结束时释放内存,我们可以对它进行核算。网关维护一个内存预算。默认情况下它根据容器的内存限制来设定,运维人员也可以显式设置。请求运行期间,它按请求体大小预留自己那份预算。预算用完后,下一个请求立刻收到 503。
我们有意选择快速返回 503,而不是排队。队列会为尚未处理的请求占用内存,并把过载变成所有人的延迟。503 会立即告知客户端,负载均衡器可以把重试发送到另一个实例,而编码智能体使用的提供商 SDK 已经会在收到 503 时进行退避重试。达到容量上限的实例保持健康,并继续处理已接受的请求,而不是耗尽内存并丢弃所有请求。
响应直接流式传输。开启完整捕获时,为 trace 记录的输出上限为 1 MiB,因此即使响应很长,也只消耗有界的内存。
这正是让实例在流量高峰期间保持运行的原因,也决定了你需要多少实例才能撑过一次高峰。我们向每个网关发送了五轮、每轮 1,000 个并发请求:一轮中的所有 1,000 个请求在同一瞬间释放,而上一轮的每个请求一完成,下一轮就开始。
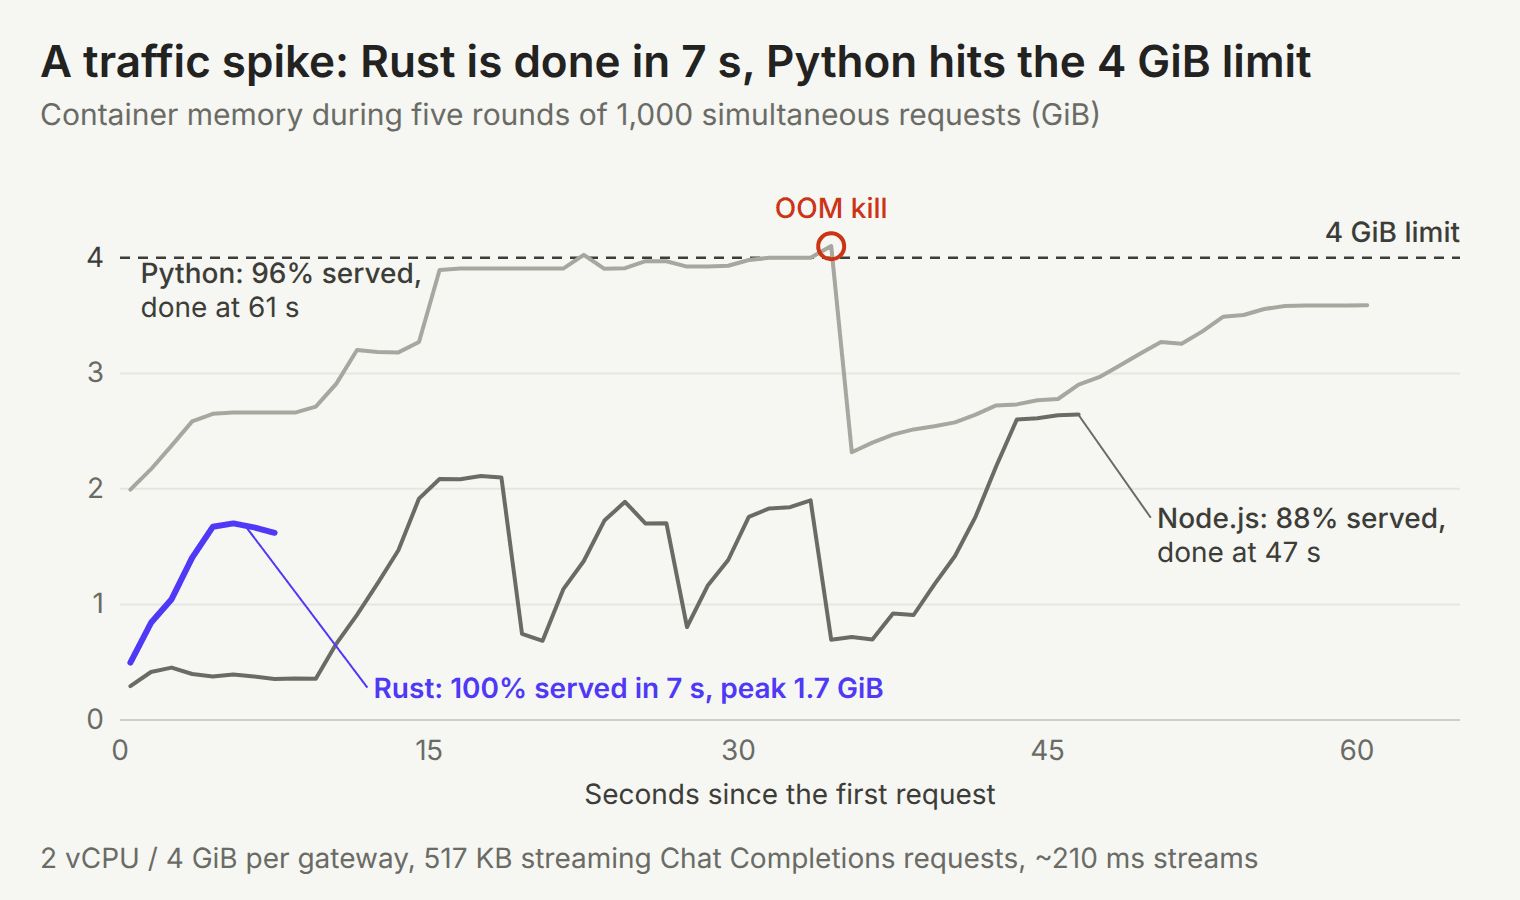
Rust 在 7 秒内处理完所有 5,000 个请求,内存峰值达到 1.7 GiB,因为每个请求的内存在请求结束时就被释放。Node.js 断开了 12% 的连接。Python 达到 4 GiB 上限,在 34 秒时内核杀死了它的两个 worker
文章标题:设计 Langfuse AI Gateway
正文: 在提供商之间做转换是有用的,例如让 Claude Code harness 跑在 OpenAI 模型上,但对于编码智能体来说,要可靠地做到这一点很难。转换型网关会把一种格式与各家提供商的格式互相转换。这对简单的聊天有效,但编码智能体是针对某一个 API 调优的,并且依赖一些无法在提供商之间干净映射的功能。Anthropic 自家的 OpenAI SDK 兼容层记录了其中若干缺口,并指出“大多数不支持的字段会被静默忽略,而不是产生错误”。开源转换网关中的公开 bug 报告也呈现出同样的模式。2
- 提示缓存(Prompt caching):各家提供商标记缓存点的方式不同,如果转换器丢掉了这些标记,长会话的每一轮都会把整段对话以未缓存的方式发送,按全价计费,且首个 token 更慢。
- 扩展思考(Extended thinking):模型的推理过程以提供商签名的数据形式在轮次之间传递,这些数据无法被转换;缺少它,模型会丢失先前的推理,或者在工具调用循环中提供商直接拒绝下一个请求。
- 严格的工具 schema:并非每种格式都有严格 schema,因此转换后的工具调用可能以畸形形式到达,智能体无法解析文件编辑或 shell 命令的参数,于是重试或放弃该步骤。
- 错误与重试:当错误被映射到一套通用集合上时,某个过载提供商带重试延迟的错误会变成一个通用错误,智能体立刻重试;而一个对模型来说过长的请求会变成一个它不断重试、却永远不可能成功的请求。
这些问题大多不会大声报错。智能体继续工作,只是更贵或稍微差一点,而这是最难察觉、也最容易让人弃用网关的一类问题。
保持原生调用可以避开这一整类问题。提供商的新功能通常在发布当天就能用,因为新字段和 beta 请求头会直接透传,网关无需了解它们。提供商的错误保留其状态码、响应体和请求头,因此智能体的重试逻辑无需改动即可工作。Claude Code、Codex、OpenCode、Pi 和 GitHub Copilot 只需一个 base URL 和一个 key。
代价是你无法通过改一个 model 字符串来切换提供商,也没有自动回退到另一家提供商的能力。对编码智能体来说,这是很小的代价:它们本来就说各家提供商的原生 API,而像 OpenCode 和 Pi 这样的智能体为每家提供商都自带一个专用适配器。想在提供商之间切换的人,已经在使用支持多家的智能体,例如 OpenCode、Pi 或 Paseo。省去转换也让我们能把时间花在交付真正的功能上,而不是追逐格式的边缘情况。如果 API schema 稳定下来,我们会重新考虑转换。
也不是每个智能体都能完全通过网关工作。Claude Code 必须退出 claude.ai 订阅登录才能使用网关凭据,而在 Claude Desktop 中,由订阅支撑的连接器届时不可用。Codex 只在 OpenAI 本身作为提供商时才提供其内置的图像生成,因此它无法通过网关生成图像。
不挡流式响应的路
调用方一侧其余的设计都源于同一个目标。网关在收到每个流式数据块时立即转发。它会读取每个事件以获取 token 用量,但从不扣留任何一个,因此只要提供商发出首个 token,它就会尽快到达智能体。遥测不在请求路径上:trace 写入一个有界缓冲区并在后台上传,如果摄入落后,网关会丢弃 trace,而不是拖慢请求。而当网关达到容量上限时,它会立刻用一个智能体早已知道如何重试的 503 告知。
接下来
网关在 Langfuse Cloud 上处于公开测试阶段,你也可以将它自托管在自己的 Langfuse 旁边。开启记录后,每一次到达提供商的调用都会成为一个 Langfuse trace,按 Claude Code、Codex、OpenCode 和 Pi 分组为会话(Pi 需要在 Anthropic 路由上做一项设置),并出现在网关分析中。如果我们的某个决定妨碍了你,请在反馈讨论中告诉我们。代码是开源的,位于 ai-gateway/,如果你喜欢处理这类问题,我们正在招聘。
脚注
- 三张图表都来自一台 8 vCPU 虚拟机上的同一次基准测试会话。每个网关单独运行在两个专用 vCPU 上,内存限制为 4 GiB,且没有 swap;负载生成器和一个通过 TLS 访问的 OpenAI API mock 共享另外两个 vCPU,Langfuse Web(五个副本)及其数据存储运行在剩余四个 vCPU 上。每个请求都是同一个 517,708 字节的流式 Chat Completions 请求,来自一次较长的编码代理回合,并开启用量报告;mock 以相隔 10 ms 的 20 个内容块作答,因此每个流持续约 210 ms。Rust 和 Node.js 网关作为单进程运行,Python 网关作为两个 Uvicorn worker 运行。我们的网关通过控制平面检查每个密钥,执行其内存预算,对每个请求体只解析一次,并向 Langfuse 发送仅含用量的 trace。Node.js 网关解析并重新序列化每个请求体;Python 网关在其透传路由上运行,使用一个静态密钥且不发送 trace。在两者中,token 计数、成本计算、护栏、速率限制、数据库日志记录和缓存均已关闭。吞吐量是在从 1 到 1,000 个客户端的并发扫描中、每级 30 秒、错误率低于 0.1% 时的最高速率。开销是在 100 个并发客户端下,经过网关的首 token 时间减去直接发送到 mock 的首 token 时间。尖峰是五轮、每轮 1,000 个同时请求,每一轮在前一轮结束时开始,容器内存每 250 ms 采样一次,并按每秒峰值绘制。这些结果仅具方向性,并非网关排名:绝对数字在其他硬件上会不同,Python 网关的文档建议每个 worker 4 GiB,而且如果请求体更小,那些会解析请求体的网关会缩小部分差距。 ↩
- 来自 2026 年 7 月至 11 月间提交的、开源 AI 网关和 SDK 中的公开问题。 ↩