 Newshot
文章标题:Just Because You Can, Doesn't Mean You Should: Re-Evaluating Galera Node Weights
正文: 我们都知道,在使用基于 Galera(Codership)的集群(例如 Percona XtraDB Cluster,PXC)时,建议部署奇数个节点。
对这一建议的通用解释是,否则出现集群不一致(如脑裂)的风险会更高。(参见 Get started with Percona XtraDB Cluster – Percona XtraDB Cluster)
提醒一下,当发生脑裂时,集群会停止接受查询,这正是安全方案应当做的,同时等待 DBA 审查并决定两个节点中哪一个是 leader。我甚至不想描述那个臭名昭著的 wsrep_provider_options=”pc.ignore_sb = yes”,它曾导致无数个夜晚被用于尝试调和损坏的数据集。如果你配置了它,请移除。
不过,在 Galera 中,我们还有一个设置 wsrep_provider_options=”pc.weight=N”。通过它,我们可以为每个节点在法定人数计算中定义特定的权重。于是自然产生一个问题:如果我们可以为每个节点分配不同的权重,为什么不能使用偶数个节点并为它们分配不同的权重?
这个问题的答案很简单:是的,我们可以。
不简单的是,确定谁应该拥有不同的权重,以及如何分配。
要理解这个问题,我们需要回顾法定人数是如何计算的(我很久以前在这里谈过这个话题 TusaCentral – Geographic replication and quorum Calculation in MySQL/Galera),以及什么是 View。
在 Percona XtraDB Cluster(PXC)和 Galera 中,View(或集群视图)是集群在任一特定时刻达成一致的成员集合。它表示当前已连接、已同步并正在彼此积极通信的节点的确切列表。
每当有节点加入集群、优雅离开或因网络故障掉线时,其余已连接的节点会协商一个新的 View,并为其分配一个唯一的 View ID。
它与 Primary Component(PC)的关系基于法定人数:
- 法定人数检查:每当新的 View 形成时,其中的节点会计算它们是否持有集群总票数的大多数。
- Primary Component:如果新的 View 持有多数,它就被指定为 Primary Component。只有 Primary Component 才被允许接受和处理事务。
- 非 Primary View:如果发生网络分裂,被隔离的节点会形成它们自己独立的 View。由于这个较小的 View 缺少多数,它会成为非主组件,并立即停止数据库操作,以防止脑裂导致的数据损坏。
本质上,View 定义了当前谁与谁相连,而 Primary Component 是拥有足够成员以安全保持数据库运行的那个特定 View。
计算法定人数的公式是:
Σ p·w < 2·(Σ m·w + Σ l·w)
其中:p = 上一个 PRIMARY 视图的成员 l = 优雅离开(LEFT)的成员 m = 正在评估的组件的成员 w = pc.weight(0–255)。
简而言之,上一个 Primary 视图的总权重必须小于新组件成员的权重加上优雅离开成员权重的两倍。需要明确的是,崩溃/不可达的节点(DOWN 或处于另一个分区)仍然计入 Σ p·w,因此它会推高阈值。相反,优雅离开(LEFT)则计入新组件。此外,任何不在上一个 PC 中的节点都会从计算中剔除,因此刚刚加入或重新加入的节点对此检查没有任何贡献。
查找该函数:
(repo https://github.com/percona/galera/tree/a6b54d887d58bae43ae3f46f5696195329405b7e)
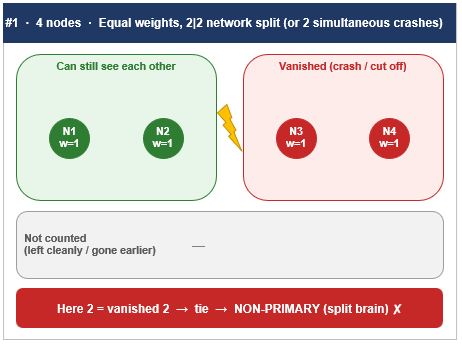
现在假设我们有一个 4 节点的集群,存在许多可能的组合,有些情况下一切正常,而另一些情况下则会严重打击我们。
最常见的是脑裂场景:
文章标题:Just Because You Can, Doesn't Mean You Should: Re-Evaluating Galera Node Weights
正文: 为了防止这种情况,我们可能决定使用一个具有不同权重的节点:
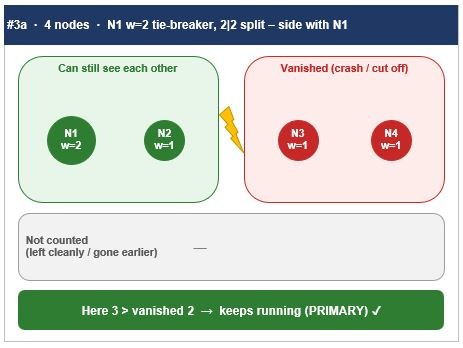
好了,问题解决了……真的吗?
不,因为改变权重可能引发其他问题,例如如果我们相对于节点数量错误地计算了权重:
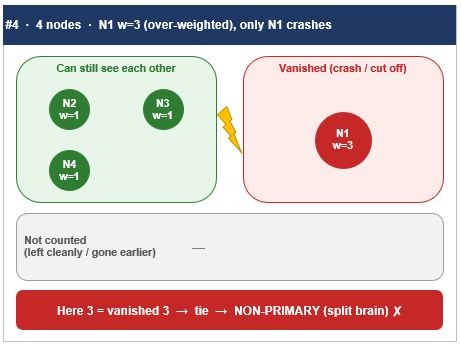
在这种情况下,单个节点就可能拖垮整个集群。
当然,如果我们执行标准操作,或者崩溃是级联发生的并且集群有时间重建 Primary Component,一切都会正常运行:
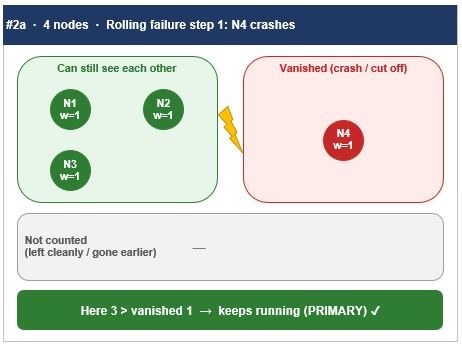
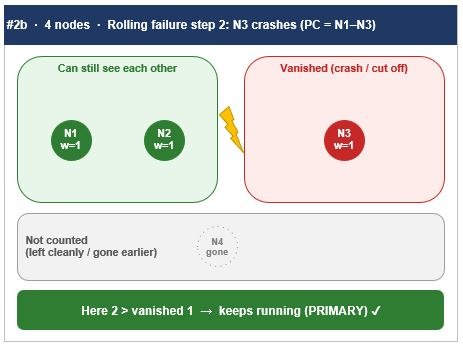
问题在于:
- 集群规模是动态的,并且会随着活跃的 Primary Component 而变化
- 在由 operator 管理的环境中(例如 Kubernetes),节点数量的扩容或缩容更加动态且难以预测。
- 在现实生活中,我们可能遇到极其多样的场景,而我只构建了其中少数几个(见 PDF)
真正的问题不是我们能否这样做,而是这样做是否值得:使用奇数个节点是否有帮助?
答案是部分有帮助。
在简单情况下,奇数节点消除了完全平局的情形。它们并不能完全阻止集群丢失 PRIMARY 状态。
关键在于总权重的奇偶性,而不是节点数量。当 present = partitioned 时就会发生平局,这意味着计票权重(Σw(PC) − Left)恰好被平分为两半。
这只有在计票权重为偶数时才有可能。因此:
- 5 个 w=1 的节点,任意两方分裂:3|2 或 4|1。总有一方严格胜出。
- 6 个节点中有一个节点 w=2(总计 7),其行为与奇数集群完全一样。将 Galera Arbitrator(garbd)作为第 7 个投票者加入也能起到同样的作用。
- 3 个节点权重分别为 2,1,1(总计 4),是奇数节点数但总权重为偶数,因此仍然可能平局。
奇数节点仍然会丢失 PRIMARY 的情况:
- 每次故障后 PC 都会收缩,其奇偶性也会改变。5 个节点丢失 1 个后仍保持 PRIMARY,但新的 PC 有 4 个节点。此后 2|2 的分裂会平局。滚动故障最终仍会剩下 2 个节点,丢失其中之一就会平局。
- 优雅离开会改变奇偶性。如果 5 个中有 1 个正常关闭,计票权重为 4,因此 2|2 的分裂会平局。
- 分裂成三个或更多组。5 个节点 2|2|1 的分裂没有平局,但没有任何一组大于其余组之和(2 < 3),因此每个组都会变为 NON-PRIMARY。
- 失去多数仍然是失去。5 个节点能承受 2 次故障,但承受不了 3 次,所以奇数并不能增加容错能力。5 个和 6 个节点都只能容忍 2 次故障。第 6 个节点增加了成本和平局风险,却没有额外的韧性。
- 两个数据中心。在 3+2 个节点的情况下,3 节点站点在链路中断时能够存活,但如果该站点宕机,2 节点站点就会停止。要承受任一站点丢失,我们需要第三个位置,即使它只运行 garbd。
在实践中:目标是让 PC 的总权重为奇数,并为多 DC 部署使用第三个站点或仲裁者。即便如此,一个已经收缩的集群可能会再次变为偶数,因此最后两个节点的平局无法通过设计消除。
只有 pc.ignore_sb 或手动 bootstrap 才能绕过它。但你不会想走到那一步。
鉴于这一点,并且鉴于重要的不是节点数量而是权重计算中的平衡,使用权重是正确的补偿方式吗?
好吧,这可能是我个人的观点,但根据我的经验,权重会让集群更难管理,而且它们带来的稳定性很有限。
一个权重为 2 的节点就像两个总是一起故障的节点。四个权重为 2,1,1,1 的节点,其行为类似于一个 5 节点集群,其中两个节点共用一个机箱。我们用分裂脑平局换来了一个单点命运:
- 收益:原本 2|2 的平局现在有了固定的赢家,即持有重节点的那一方。
- 损失:丢失重节点再加另一个节点就是致命的。过度加权会让情况更糟:当 w=3 时,仅丢失该节点就会导致平局。
文章标题:能做不等于该做:重新评估 Galera 节点权重
可存活的故障集合是转移而非扩大。我们仍然只能容忍一次任意故障加上某些特定的分裂。
权重给日常运维带来的额外负担:
- 节点不再平等。每个人都必须知道哪个节点是“特殊的”。运维手册、监控和值班决策都依赖于此。
- 维护顺序变得重要。要干净地关闭那个权重大的节点,这样它的权重才不会计入任何一方。如果它在另一个节点维护期间崩溃,集群可能会停止。对它打补丁或重启之前,可能首先需要把它的权重转移到另一个节点,这一步很容易被遗忘。
- 权重是一种可能发生漂移的配置。它必须在配置文件、重建和节点替换之间保持一致。一个重建后以默认 w=1 回归的节点会悄然改变法定人数的计算。
- 决胜站点是固定的。有两个数据中心时,加权的一方总是获胜。这与简单地把 3 个节点放在一个 DC、2 个放在另一个 DC 没有区别,而且两种情况下丢失那个 DC 都会使集群停止。
- 缩减规模仍然会破坏它。故障之后 PC 会变化,所以一个为 4 个节点调优的配置可能在 3 个或 2 个节点时出现平局。
针对同一目标,从最简单到最复杂:
- 奇数个平等节点:对称,没有需要特别管理的东西。
- 偶数个节点加 Galera Arbitrator(garbd):数据节点保持平等,仲裁者持有决胜票。如果它运行在第三个站点,集群就能在丢失任一主站点的情况下存活,这是单靠权重无法提供的。
- 带权重的偶数个节点:仅当你无法添加节点或仲裁者,并且你刻意希望一方在分裂中总是获胜时才使用。
权重并不会让集群总体上更稳定,而且它们增加了运维复杂性。它们作为刻意的决胜手段才有意义,而不是作为偶数节点数量的修复方案。
结论
我坚守那句常青的 KISS 格言:Keep It Simple and Straightforward(保持简单直接)。拥有超过 3 个节点的 PXC 集群只在极少数情况下才有意义,而且只是为了扩展读取,或者如果你计划在 5 个节点的集群上同时杀掉 2 个节点。鉴于增加节点或使用权重带来的显著复杂性,我真不明白为什么一个心智健全的人会自找麻烦。
能做并不意味着“就该做”,尤其是当收益微乎其微而复杂性却在增加的时候。
帮自己一个忙:把集群保持在最低限度,保持在真正需要的规模,不要试图去拉伸它。你会免于度过那些做集群恢复或更糟的数据协调的痛苦夜晚。
祝大家 MySQL 用得愉快。