 Newshot
设备端 AI
模型是固定的。围绕它的程序不是。
Viper 有一个完全在你的 Mac 上运行的 AI 聊天。没有云端。没有 AI 服务商账户。你的问题永远不会离开设备。
它了解 Viper。问它密钥如何工作、如何换到新手机、TON Drop 是做什么的——它会依据 Viper 自己的指南作答,并显示答案来自哪里。
它也能执行操作。让它给某人发消息、创建事件或保存笔记,它会准备一份草稿。在你点击“发送”之前,什么都不会发出。
一个现成的开放模型。Viper 的 harness。你的设备。
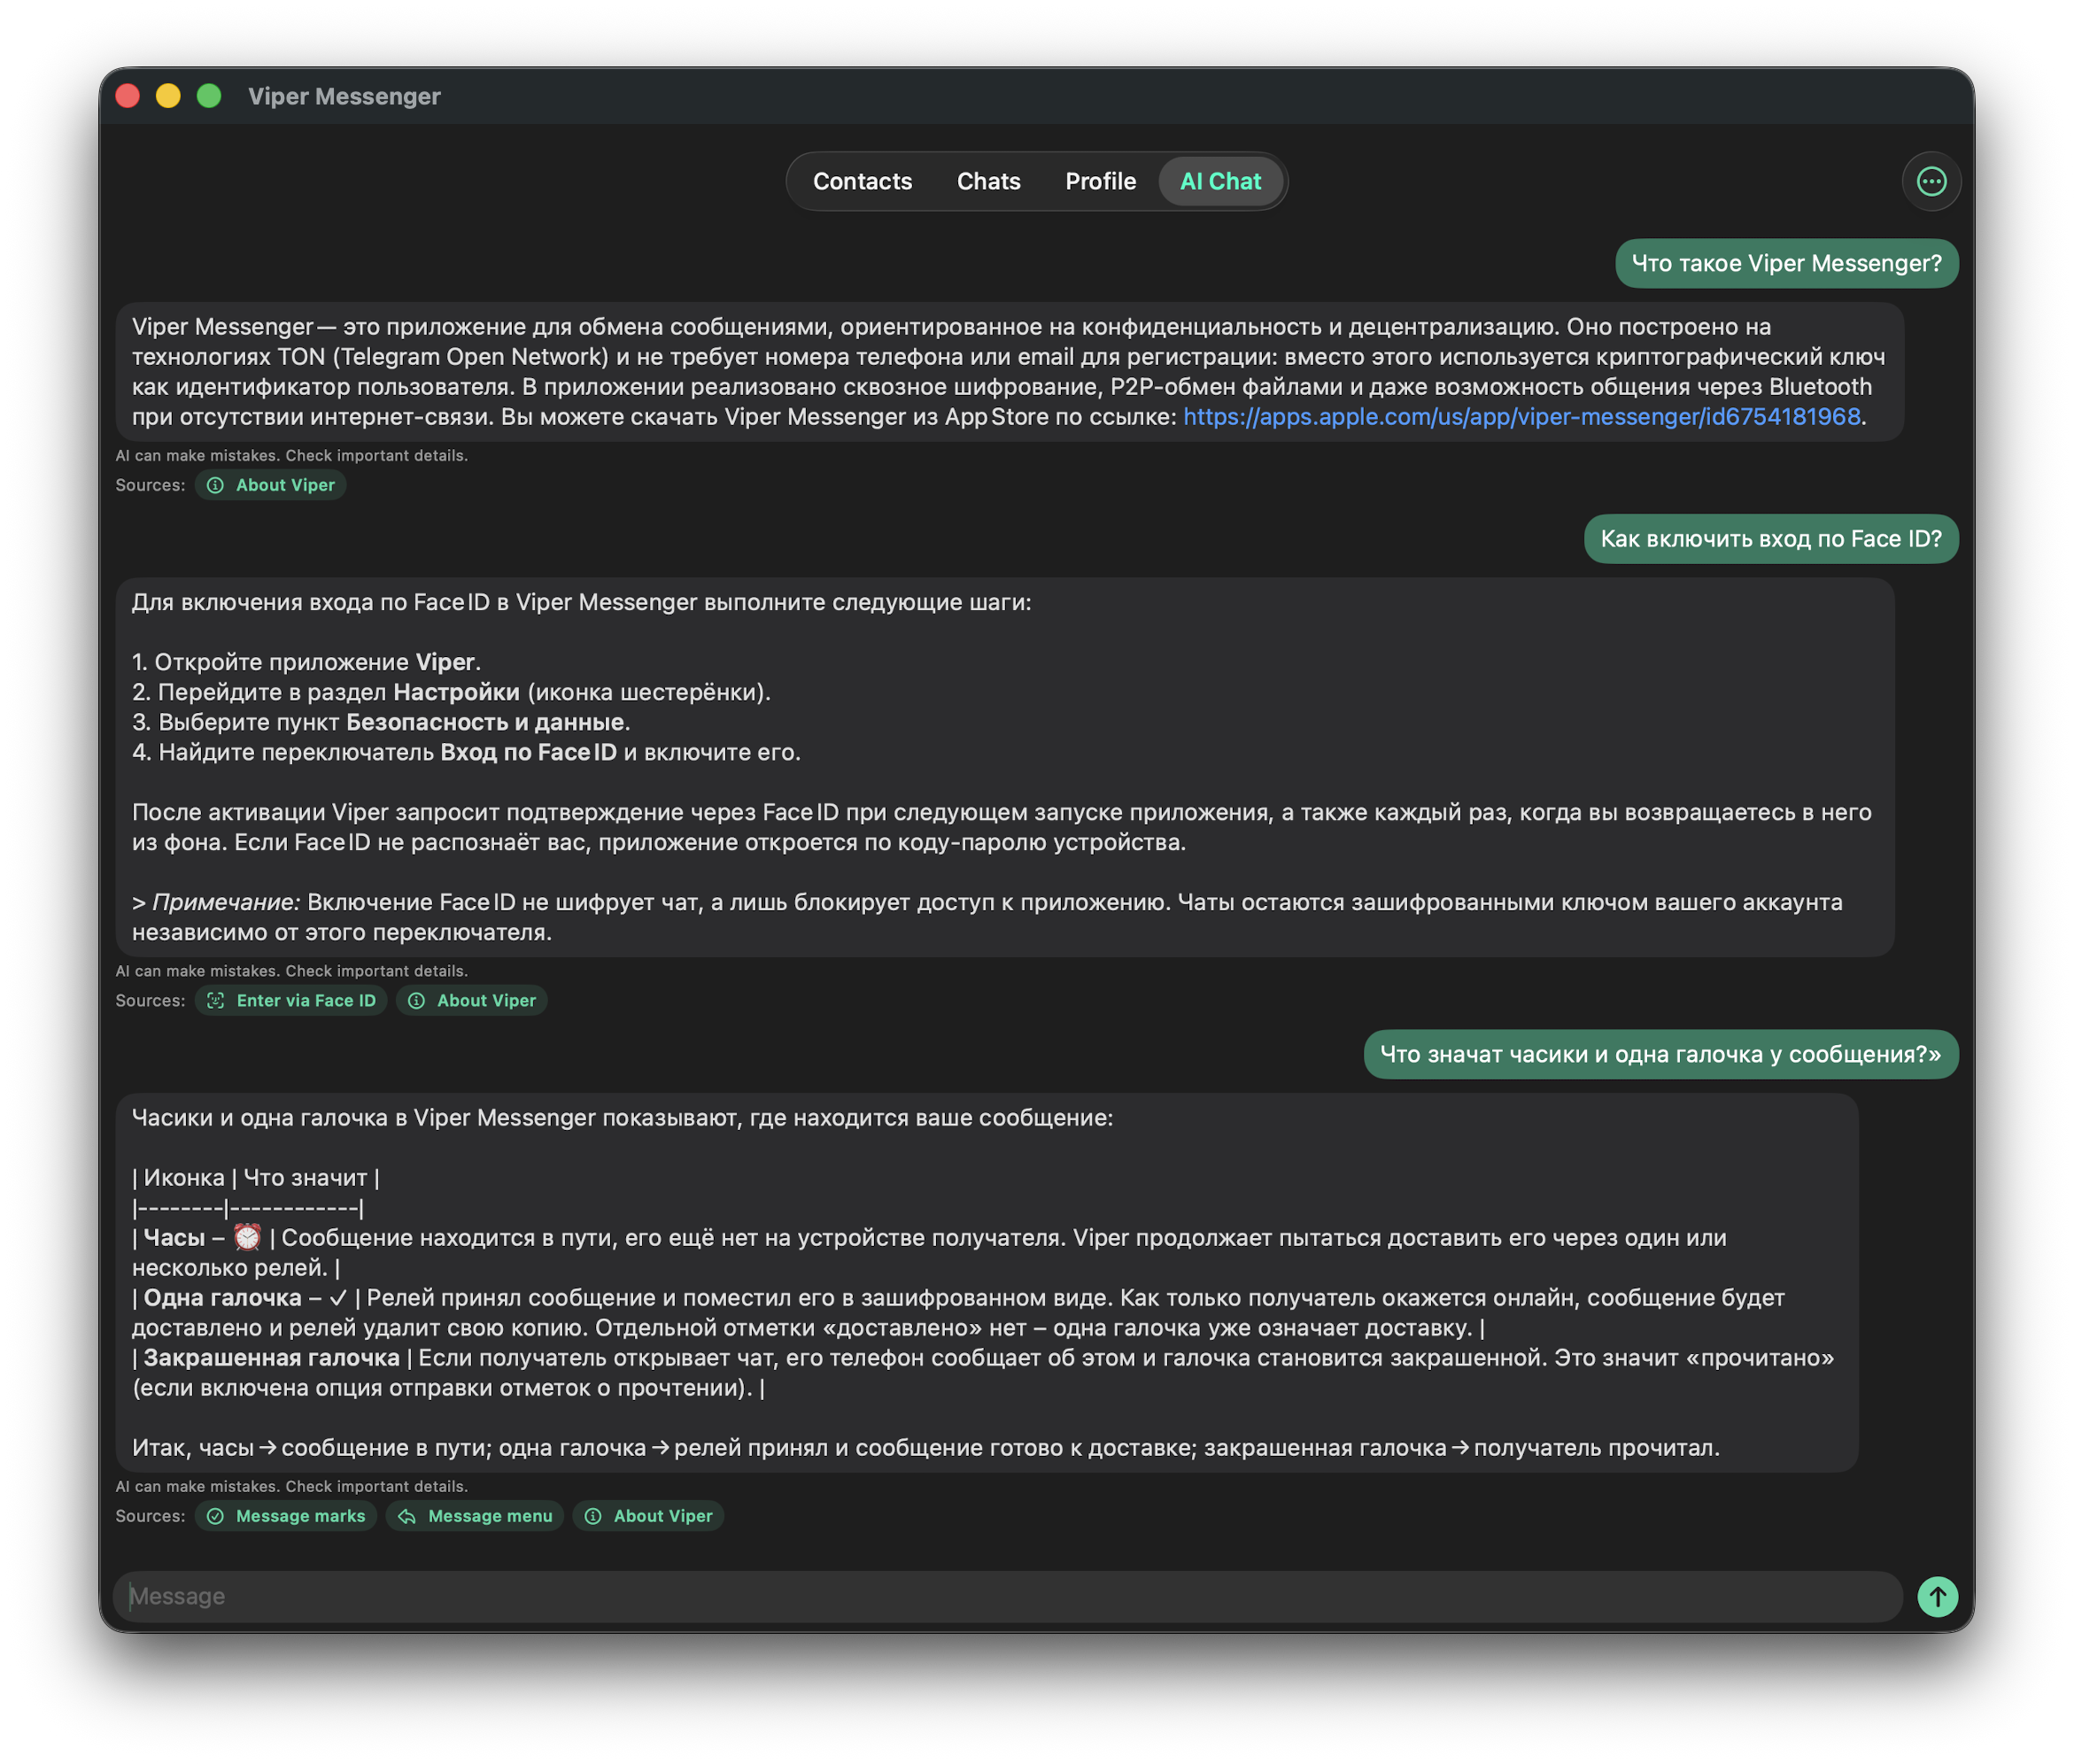
你看到的内容。Mac 上 Viper 中的 AI 聊天,离线运行。三个日常问题:Viper 是什么、如何开启 Face ID 登录,以及消息旁的时钟和单个对勾分别是什么意思。每个答案都附有来源:它所依据的应用内指南(通过 Face ID 进入、消息标记、关于 Viper)。点击其中一个即可打开该指南,自行核对答案。
为什么重要。一个通讯应用的帮助不应该需要互联网、AI 公司的账户或客服聊天。人们在觉得不对劲时会问密钥、送达标记和隐私的问题——常常是离线时,常常很匆忙。Viper 在设备上作答,依据 Viper 自己的指南,并指出来源,因此你可以信任答案,或一键核对。
它是如何开始的
今年十一月的两项工作让我们起步:
- Sparks of Weight-Space Programming(MIT CSAIL,2026 年 11 月):前沿 LLM 可以像读改代码一样读取和编辑神经网络的权重。编辑一个小模型极小一部分权重,去掉了阻碍它的东西——但并没有增加模型所缺乏的能力。
- BotPsy(Tether QVAC,2026 年 11 月):一个通过工具调用行动来训练的 0.8B 模型,小到可以在手机上运行。
两者都指向同一个目标:一个在你自己的设备上、了解你的应用并能在其中行动的模型。我们为 Viper 尝试了两条路——编辑权重和为 Viper 训练一个小模型。两者都没能可靠地教会模型 Viper 的事实。真正有效的是不碰模型,而是围绕它构建程序。
不训练
我们没有重新训练模型来教它 Viper。我们试过——把事实训练进权重反而让它更糟。
相反,Viper 围绕一个未改动的开放模型构建了一个 harness:在你提问的那一刻它所需的知识、它可以提议的操作,以及在每个版本发布前运行的检查。明天换上一个更好的模型,Viper 教给它的一切都会保留。
设计即隐私
- 模型、知识和你的问题都留在你的 Mac 上。
- 没有 API 密钥,没有别人的服务器上的使用日志。
- AI 提议;你决定。在你确认之前,每个操作都是草稿。
- 你选择它知道什么:打开或关闭 Viper 的内置知识,添加你自己的笔记。
现状
已发布的内容
Viper 1.5.34,目前正在 App Store 审核中,在 Mac 上搭载 gpt-oss-20b 和 Viper 的知识:当你询问关于 Viper 的问题时,应用会向模型提供“关于 Viper”卡片以及与你问题匹配的两份应用内指南,答案会把这些指南显示为来源(上面的截图就是 1.5.34)。
在一次小测试中,这效果很好:20 个关于 Viper 的问题,从答对 4 个(仅模型)提升到答对 19 个(模型加指南)。
然后我们扩大了测试规模
我们自己写的二十个问题不算证明。所以我们构建了一个大型盲测:
- 数百个新问题,由两位不同的作者(另一个开放模型和我们)用俄语和英语撰写,以人们真实的提问方式:简短、含糊、有错别字、俚语、带情境(“我的旧手机坏了……”)、一次问好几个问题——以及关于 Viper 并不具备的功能的问题。
- 两位盲评者为每个答案对照 Viper 的知识打分。只有当两人都认为正确时,答案才算正确;只要有一人发现编造的功能、菜单或数字,就算作杜撰。
文章标题:端侧 AI:无需微调即可获得新知识
正文:
- 全新的问题说了算。只有当改动也能在 harness 任何版本都未见过的问题上胜出时,才算数。
在这个规模上,1.5.34 的做法不够用。在全新的情境式问题上,它大约三分之一的回答是正确的,而在大约三分之一的回答中凭空编造了内容。查看失败案例后发现了原因:模型往往面前就有正确的指南,却仍然添加了并不存在的内容。
我们改了什么
依然不训练——模型的权重未被改动。改变的只是它周围的程序:
- 为模型重写指南。每一页指南都变成简短的编号步骤,并带有来自应用自身代码的确切菜单路径,外加几行平实的话说明 Viper 没有什么(没有群组、没有二维码扫描器、没有云同步)。
- 把问题拆开。多部分问题被拆成子问题;每个子问题找到自己的指南,模型先挑出能回答它的指南行。
- 答案来自指南页面本身。助手不再用自己的话复述指南,而是展示它选中的指南页面。当没有合适的内容时,它说指南未覆盖该问题,而不是猜测。
- 检查在代码里,不在提示词里:答案的语言必须与问题一致;在存在匹配指南页面时却给出拒绝,会回退到正常回答;操作保持为草稿。
测试:1.5.34 对比 1.5.35
同一个模型在三种设置下,回答没有任何版本见过的新问题(167 个 Viper 问题,两名盲评评委):
- 仅模型(无 harness)——原版 gpt-oss-20b。它对 Viper 一无所知,而且也不可能知道:gpt-oss-20b 于 2025 年发布,而 Viper Messenger 于 2026 年 1 月出现在 App Store。模型在 Viper 公开存在之前就已完成,因此它对 Viper 的一切了解都必须来自 harness。
- 1.5.34(harness)——目前正在 App Store 审核中:关于 Viper 卡片和两个匹配的指南。
- 1.5.35(harness)——修复本次测试在 1.5.34 中发现的问题的补丁:即上面列出的改动。
| 仅模型(无 harness) | 1.5.34(harness) | 1.5.35(harness) | |
|---|---|---|---|
| 正确 | 2% | 41% | 61% |
| 正确或部分正确 | 11% | 68% | 89% |
| 编造了内容 | 57% | 24% | 4% |
仅模型不可能了解 Viper:gpt-oss-20b 于 2025 年发布,而 Viper Messenger 于 2026 年 1 月出现在 App Store——在模型制成之后。它少数“正确”的回答是恰好与 Viper 相符的通用通讯应用建议(点按照片,然后分享 → 存储图像),或者是诚实的“我不知道”。在 33 个关于 Viper 没有的功能的问题上,它 76% 的情况下编造了答案;1.5.34 为 6%;1.5.35 为 3%。
为什么这些数字看起来偏低。在简单问题上 1.5.34 已经可用,如截图所示:答案可能并非每个细节都精确,但方向正确。这个测试是刻意加难的:大规模上的多样化问题——俚语、错别字、情境、一次多个问题——以及严格的评分:只有当两位评委都同意答案中每一个 Viper 细节都真实时,该答案才算正确。
在我们研究失败案例所用的集合上(166 个问题;数字更高,因为我们修复了这些答案出错处的指南):1.5.34 正确 43%,编造 28%;1.5.35 正确 71%,编造 2%。我们公布它,但只计入全新集合。
草稿说明:1.5.35 的数字来自测试台,尚未来自应用构建。
它运行在什么上
目前这需要一台性能强劲的 Mac。本页上的每一个数字都是在一台笔记本电脑上测得的:
- MacBook Pro,Apple M5 Pro(15 核 CPU:5 个超级核心 + 10 个性能核心;16 核 GPU),24 GB 内存,macOS 26.5。
- 模型是 gpt-oss-20b(MLX,MXFP4),约 12 GB,完整加载到内存中。
- 速度:仅模型每秒约写 57 个 token,约 2.6 秒回答一个问题(中位数;最慢的十分之一为 5.6 秒)。新的 harness 每个问题向模型询问 3–4 次(拆分、查找、挑选、回答),因此完整回答约需 6.4 秒(中位数;最慢的十分之一为 9.9 秒)。
模型运行本身约占 12 GB 内存(峰值 13 GB;磁盘占用 11 GB)。再加上 macOS 和应用,24 GB 比较宽裕;16 GB 的 Mac 则比较紧张。iPhone 还达不到:最大的 iPhone 总共只有 12 GB,比模型单独所需的内存还少。
接下来
- 更频繁地选对指南页面——剩余的错误大多是缺少页面或页面选错,而不是答案错误。
- 在下一个构建中发布新的 harness,然后在真实设备上测量速度。
- 随结果一并公布测试问题和评分规则。
现已在配备 Apple 芯片和 24 GB 内存的 Mac 上提供。Viper Messenger 已在 App Store 上架