 Newshot
AWS News Blog
AWS Lambda 现为 Lambda Managed Instances 上的 Event Functions 支持 GPU 实例
现在,运行在 AWS Lambda Managed Instances(LMI)上的 Event Functions 已可使用 EC2 G 系列 GPU 实例的 GPU 支持。你现在可以在 GPU 实例上以无服务器的简便性运行 GPU 加速工作负载,包括机器学习推理、媒体处理、渲染和科学计算。GPU 加速函数以容器(Open Container Initiative,OCI)镜像的形式部署。你构建一个 OCI 镜像,将函数指向它,然后让 Lambda 负责预置、扩缩容和事件集成。无需协调 GPU 驱动、CUDA 版本或 AMI,也无需运维集群或设备插件。GPU 加速函数运行在与 Lambda Managed Instances 相同的基础之上,这一基础已经为你提供 Amazon EC2 定价和无需管理服务器的专用计算能力。
为什么客户需要这一能力 客户不断要求以无服务器的简便性运行 GPU 工作负载。基于自管理的 GPU 基础设施进行构建,意味着要选择实例、安装并协调 GPU 驱动与 CUDA 库、规划容量、编写扩缩容逻辑,还要手工构建把 GPU 步骤与应用其余部分连接起来的事件集成。而隐藏这些工作的无服务器 GPU 服务往往位于你的 AWS 环境之外,没有原生事件源,也没有身份或网络能力。
成本是第二个问题。GPU 价格昂贵,而利用率通常很低,因为单个工作负载很少能占满一块 GPU。一个小型推理任务可能让已预置 GPU 的大部分处于空闲,而你却要为整块 GPU 付费。
此功能弥合了这两处差距。你提供一个函数,Lambda 会在几分钟内让它在 GPU 上运行,由与其他任何 Lambda Event Function 相同的 AWS 事件触发,并以相同的方式计费和安全防护。它还通过将函数整合到实例上、并让 GPU 在并发请求间保持忙碌,最大化你所付费的每一块 GPU 的利用率。
你可以构建什么 你可以使用 Lambda Managed Instances 上的 GPU 加速计算运行 AI/ML 推理和非 ML 工作负载。此能力针对推理而非训练进行了优化,也针对自定义模型而非 Amazon Bedrock 等服务上已有的大型基础模型。常见工作负载包括:
- 自定义模型推理:决策模型(例如 Strands Decider)、计算机视觉、语音转文本与文本转语音、推荐、文档分析,以及作为应用一部分部署的中小型语言模型。
- 智能体与事件驱动 AI:直接由 AWS 事件触发的自定义推理,与 Lambda 编程模型的其余部分组合使用。
- 媒体处理与转码:在上传时触发的视频和图像流水线。
- 3D 渲染与生成式媒体:帧与资产渲染、扩散,以及文本转视频生成。
- 科学计算与金融建模:模拟、矩阵计算和风险分析。
Lambda 编程模型的一部分 GPU 加速函数是更大应用中的一个步骤,并与 Lambda 的其余部分组合使用。Lambda durable functions 围绕 GPU 步骤编排多步骤、长时间运行的工作流,具备检查点和自动恢复能力。Lambda MicroVMs 在隔离的有状态沙箱中运行不受信任或由模型生成的代码。在智能体工作负载中,MicroVM 在 CPU 上执行工具调用逻辑,然后调用运行在 Lambda Managed Instances 上的 GPU 加速函数进行推理。
GPU 加速函数还支持 Lambda Managed Instances 上的扩展函数超时,对于异步调用和事件源映射调用,最长可达 90 分钟,因此您可以运行批处理和其他长时间运行的 GPU 作业,例如媒体转码或多步推理,而无需重新架构。GPU 加速函数支持最大 32 GB 的容器镜像(每个文件 10 GB)、最大 32 GB 的临时存储、2,048 到 32,768 MB 的内存、3 到 48 GB 的加速器内存、每个执行环境最多 48 个并发请求,以及每个容量提供程序最多 15,000 个 vCPU。
我们来试试 为了展示实际效果,我部署了一个来自 Hugging Face 的开源大语言模型(LLM)作为 Lambda 函数,并向它发送了一个提示。使用 Lambda 提供的 vLLM 基础镜像,我只需在 MODEL_ID 环境变量中设置 Hugging Face 模型 ID,无需编写任何推理代码。我使用了 Qwen/Qwen2.5-1.5B-Instruct,这是一个小型指令微调模型,适合应用内任务,如摘要、分类和提取。流程有四个步骤:创建容量提供程序、构建并推送容器镜像、从该镜像创建函数,然后发布并调用。开始之前,请申请增加您的 G 系列实例配额(列为 Running On-Demand G and VT instances),因为新账户的配额可能为 0。有关更多信息,请参阅 On-Demand Instance quotas。
首先,我创建了一个容量提供程序,在其中指定 Lambda 可以使用的 GPU 实例类型,并让它自动扩缩容。列出多个实例类型可以让 Lambda 选择可用且最具成本效益的一个,并在容量紧张时跨代际回退。
        {
    "CapacityProviderName": "lmi-gpu-cp",
    "VpcConfig": {
        "SubnetIds": ["subnet-aaaa", "subnet-bbbb", "subnet-cccc"],
        "SecurityGroupIds": ["sg-aaaa"]
    },
    "PermissionsConfig": {
        "CapacityProviderOperatorRoleArn": "arn:aws:iam::111122223333:role/lmi-operator-role"
    },
    "InstanceRequirements": {
        "AllowedInstanceTypes": [
            "g5.2xlarge", "g6.2xlarge", "g6e.2xlarge"
        ]
    },
    "CapacityProviderScalingConfig": {
        "ScalingMode": "Auto",
        "MaxVCpuCount": 96
    }
}
        aws --region us-east-2 \
  lambda create-capacity-provider \
  --cli-input-json file://cli-skeletons/create-capacity-provider_gpu.json
Lambda 控制台显示新的容量提供程序 lmi-gpu-cp 处于 Active 状态。注意其 VPC 配置,包括子网和安全组。
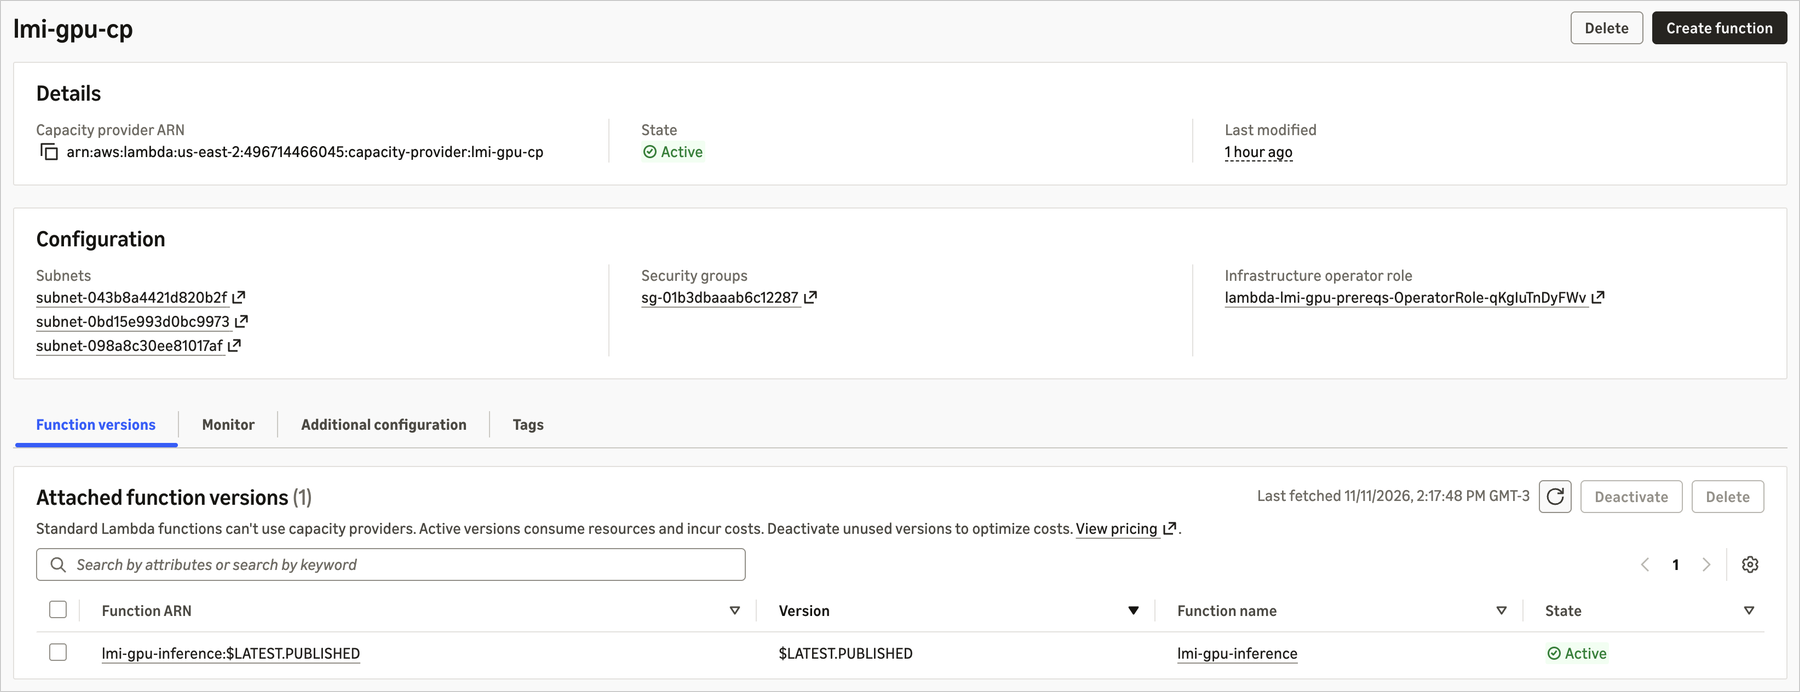
图 1:容量提供程序处于 Active 状态,及其 VPC 配置。
接下来,我构建了容器镜像。Lambda 提供了一个精选的 vLLM 基础镜像,其中包含 vLLM 推理服务器、PyTorch、Transformers 和 CUDA 工具包,以及一个支持并发调用的运行时接口客户端。该镜像为我提供模型服务,因此我不需要编写处理程序或任何推理服务器代码。我的整个 Dockerfile 只有一行:
FROM public.ecr.aws/lambda/deep-learning-containers/vllm:cuda-v1
将镜像推送到 Amazon ECR 后,我创建了函数。我通过 MODEL_ID 环境变量选择模型,该变量接受 Hugging Face 或 ModelScope 仓库、Amazon S3 位置或本地路径。Lambda 会下载模型、管理 GPU 内存并提供请求服务。Qwen2.5-1.5B-Instruct 是一个公开模型,因此我不需要 Hugging Face token。对于私有或受限模型,或者为了获得更高的下载速率限制,您还可以设置 HF_TOKEN。
GPU 加速函数使用 AcceleratorConfig 请求加速器内存。AcceleratorMemorySize 是函数所需的最小 GPU 内存,Lambda 会将执行环境放置在满足该要求的最小可用 GPU 上,因此你实际获得的 GPU 内存可能比你请求的更多。我将 PerExecutionEnvironmentMaxConcurrency 设置为 4,这是默认值。vLLM 服务器会在 GPU 上批处理并发请求,因此各次调用共享同一份模型副本,GPU 始终保持忙碌。我还将 ExecutionEnvironmentMemoryGiBPerVCpu 设置为 4,这为函数提供了其所需的 16,384 MB 内存和 4 个 vCPU,同时在 2xlarge 实例上为 Lambda 的管理组件留出容量。
        {
    "FunctionName": "lmi-gpu-inference",
    "PackageType": "Image",
    "Code": { "ImageUri": "111122223333.dkr.ecr.us-east-2.amazonaws.com/lmi-gpu-inference:latest" },
    "Role": "arn:aws:iam::111122223333:role/lmi-gpu-inference-execution-role",
    "Timeout": 900,
    "MemorySize": 16384,
    "EphemeralStorage": { "Size": 32768 },
    "Environment": { "Variables": { "MODEL_ID": "Qwen/Qwen2.5-1.5B-Instruct" } },
    "CapacityProviderConfig": {
        "LambdaManagedInstancesCapacityProviderConfig": {
            "CapacityProviderArn": "arn:aws:lambda:us-east-2:111122223333:capacity-provider:lmi-gpu-cp",
            "ExecutionEnvironmentMemoryGiBPerVCpu": 4,
            "PerExecutionEnvironmentMaxConcurrency": 4
        }
    },
    "AcceleratorConfig": { "AcceleratorMemorySize": 16 }
}
        aws --region us-east-2 \
  lambda create-function \
  --cli-input-json file://cli-skeletons/create-gpu-llm-function.json
函数概览展示了它为何是 GPU 加速函数:所附加的容量提供程序负责提供 GPU 实例,而从 Amazon ECR 部署的 vLLM 容器镜像,全部接入你已经在使用的同一函数模型。
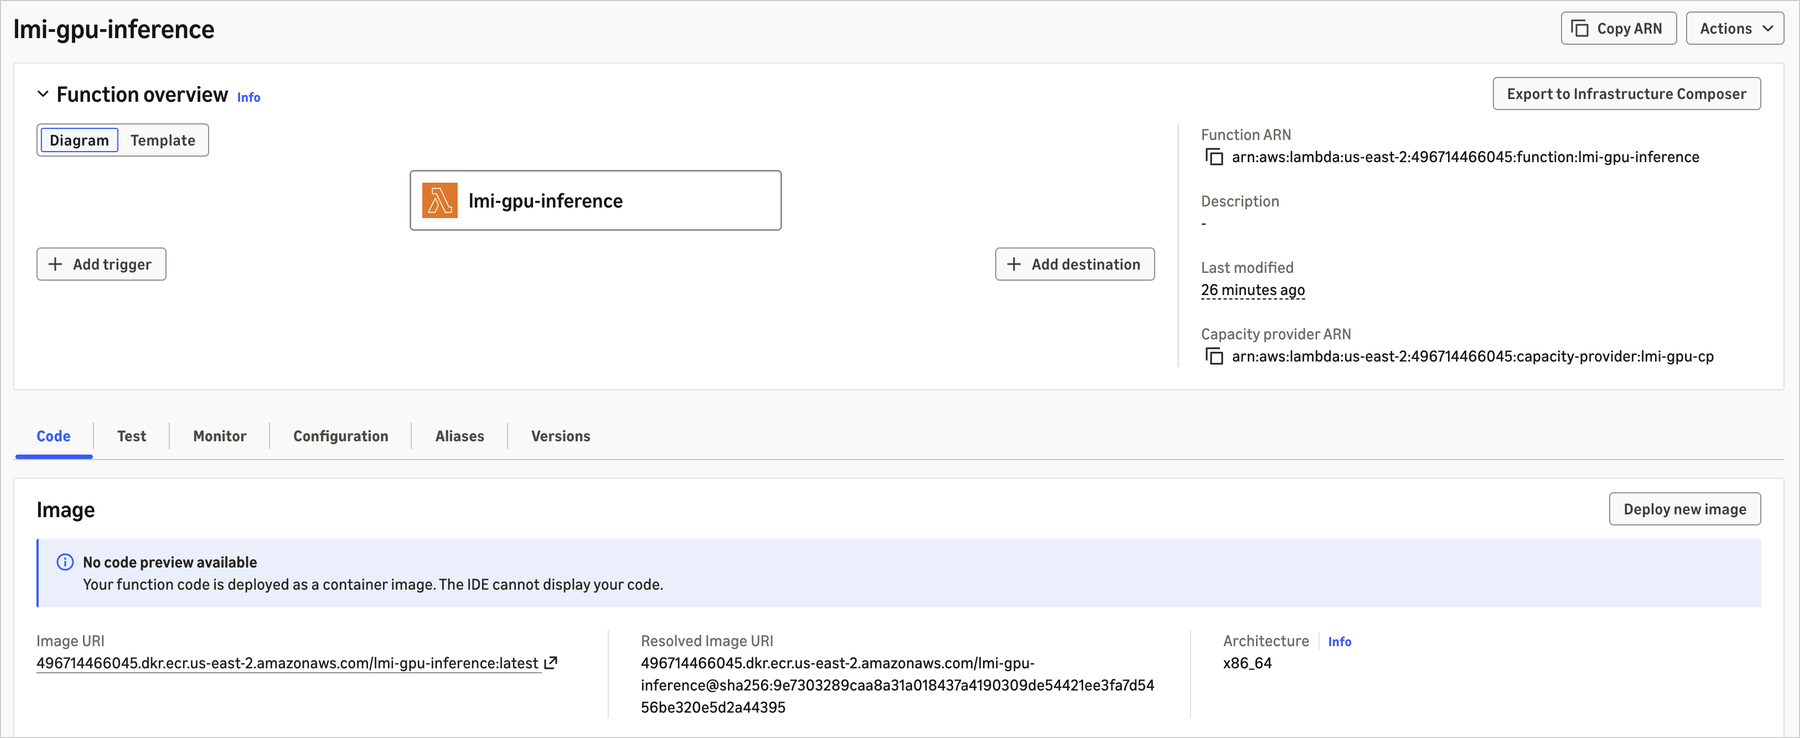
图 2:lmi-gpu-inference 函数概览,显示所附加的容量提供程序以及从 Amazon ECR 部署的 vLLM 容器镜像。
Lambda Managed Instances 上的函数从已发布版本运行,因此我发布了一个版本。发布过程会预置执行环境,每个执行环境都会在版本变为活动状态之前下载模型权重并预热引擎。冷启动发生在发布步骤期间,因此第一个调用者无需等待。
        aws --region us-east-2 \
  lambda publish-version \
  --function-name lmi-gpu-inference \
  --publish-to LATEST_PUBLISHED
然后我向模型发送了一个提示词。请求负载是标准的 OpenAI 请求体:messages 数组路由到聊天补全,prompt 字段路由到文本补全。
        aws --region us-east-2 \
  lambda invoke \
  --function-name 'lmi-gpu-inference:$LATEST.PUBLISHED' \
  --cli-binary-format raw-in-base64-out \
  --payload '{"messages": [{"role": "user", "content": "Explain serverless GPU inference in one sentence."}], "max_tokens": 128}' \
  /dev/stdout
模型从 Lambda 执行环境内的 GPU 作出回答,响应是标准的 OpenAI 补全对象,因此任何兼容 OpenAI 的客户端都可以使用它。
        {
  "model": "Qwen/Qwen2.5-1.5B-Instruct",
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "Serverless GPU inference is a cloud-based service that allows for efficient execution of machine learning models on NVIDIA GPUs without the need for infrastructure management or maintenance."
      },
      "finish_reason": "stop"
    }
  ],
  "usage": { "prompt_tokens": 39, "completion_tokens": 31, "total_tokens": 70 }
}
在一个执行环境中,四个并发调用完成所需时间与单个调用大致相同,该环境在 GPU 内存中共享一份模型副本。从 Hugging Face 模型 ID 到可用的、兼容 OpenAI 的 GPU 端点大约耗时 10 分钟,其中大部分时间无需人工干预,由 Lambda 预置容量并预热模型。
这是一个可用的 LLM 端点,无需推理服务器代码、无需 GPU 驱动,也无需管理集群。要尝试不同的模型,我更新 MODEL_ID 并发布新版本,无需重新构建镜像。每个版本都是不可变快照,因此不同模型可以作为独立版本并行运行。它也是一个 Lambda Event Function,因此我可以从 Amazon SQS 队列触发它来批量处理文档,将 Amazon API Gateway 放在它前面,或在 Lambda durable functions 工作流中将其作为推理步骤调用。
在生产环境中,将模型权重复制到同一 Region 的 S3 存储桶,将 MODEL_ID 指向该存储桶,并设置 VLLM_LOAD_FORMAT=runai_streamer,以便权重直接流式加载到内存中。这样可以加快启动速度,并消除对 Hugging Face Hub 的依赖。如需更多指导,请参阅运行推理工作负载的最佳实践。除了 LLM 推理之外,你还可以运行自定义 ML 推理、媒体处理和其他 GPU 工作负载。请参阅 Lambda 文档了解最佳实践。
配置选项卡显示了 GPU 加速函数的关键设置:16,384 MB 内存、15 分钟超时,以及用于存放已下载权重的 32 GB 临时存储;同时还显示了函数级 capacity provider 设置:每个环境的并发数为 4、内存与 vCPU 的比率为 4:1,以及 16 GB 加速器内存。
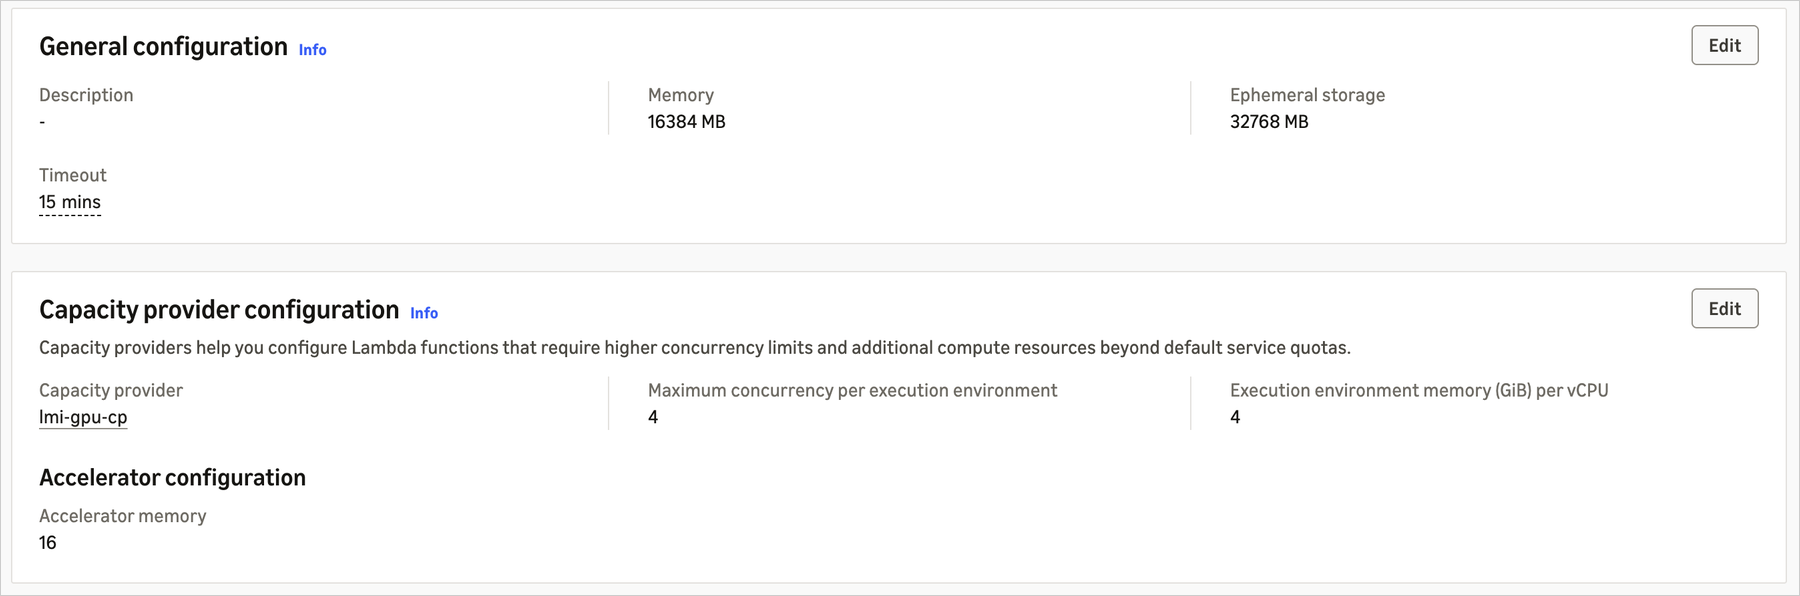
图 3:该函数的配置,包括内存、超时和 32 GB 临时存储,以及函数级 capacity provider 设置:每个环境的并发数、内存与 vCPU 的比率和加速器内存。
完成测试后,先删除函数,再删除 capacity provider,以便 Lambda 停止 GPU 实例并停止为其付费。
工作原理 以下能力开箱即用,每一项都免去了原本需要你自行承担的 GPU 工作。
跳过 GPU 软件设置。精选基础镜像已为你处理框架和工具,因此你无需安装或协调它们:base:cuda(CUDA toolkit 和 runtime)、cupy:cuda(CuPy、NumPy、SciPy、Pandas、Numba)、pytorch:cuda(PyTorch、torchvision、torchaudio、transformers、FFmpeg),以及服务镜像 vllm:cuda 和 sglang:cuda。可以直接使用、扩展它们,或自带完全自定义的镜像。
无需运维 GPU 基础设施。Lambda 负责驱动兼容性、预置、路由和负载均衡,因此你只需交付函数,而无需运行 GPU 集群。可使用与任何 Lambda Event Function 相同的 Console、CLI、AWS CloudFormation、AWS CDK、AWS SAM 和 Terraform 工作流进行部署。
从任何 AWS 事件触发 GPU 工作。触发 Event Functions 的 200 多个事件源同样可以直接触发 GPU 加速函数,包括 Amazon S3、Amazon SQS、Amazon API Gateway 和 Amazon EventBridge,并具有相同的扩缩容、错误处理和重试。无需自定义集成代码。
在每个 GPU 上处理并发请求。每个执行环境都可以在同一 GPU 上处理多个并发调用,你可以通过每个环境的并发数设置进行控制。提高该设置会将更多请求打包到每个 GPU 实例上,从而提升利用率,让你从已付费的容量中获得更高吞吐量。
AWS Lambda 现在为 Lambda Managed Instances 上的 Event Functions 支持 GPU 实例
多种实例类型。指定多个实例类型或代次,Lambda 会选择最具成本效益的可用选项,并在你的列表中回退,以减少 Insufficient Capacity Errors。
容量选项。GPU 实例以 Amazon EC2 按需实例运行,你现有的 Savings Plans 和 Reserved Instances 适用。为了获得可预测的 GPU 可用性,创建与你的容量提供方配置匹配的 EC2 On-Demand Capacity Reservation(ODCR),Lambda 会自动使用该预留容量。
大型容器镜像和存储。支持最大 32 GB 的容器镜像,以及 /tmp 中最大 32 GB 的 NVMe 临时存储。Seekable OCI (SOCI) 延迟加载让你的函数在完整镜像下载完成前开始执行,这可将执行环境启动时间缩短最多 70%。
无需额外设置即可查看 GPU 使用情况。GPU 利用率、GPU 内存利用率、已用 GPU 内存和 GPU 功耗利用率会与标准函数指标一起显示在 Amazon CloudWatch 和 AWS Lambda 控制台中。
调用函数后,控制台会在标准指标旁边显示 GPU 特定指标。跟踪 GPU 利用率、GPU 内存利用率、已用 GPU 内存和 GPU 功耗利用率,以查看每次调用实际使用了多少加速器,这是驱动自动扩缩和成本的信号。
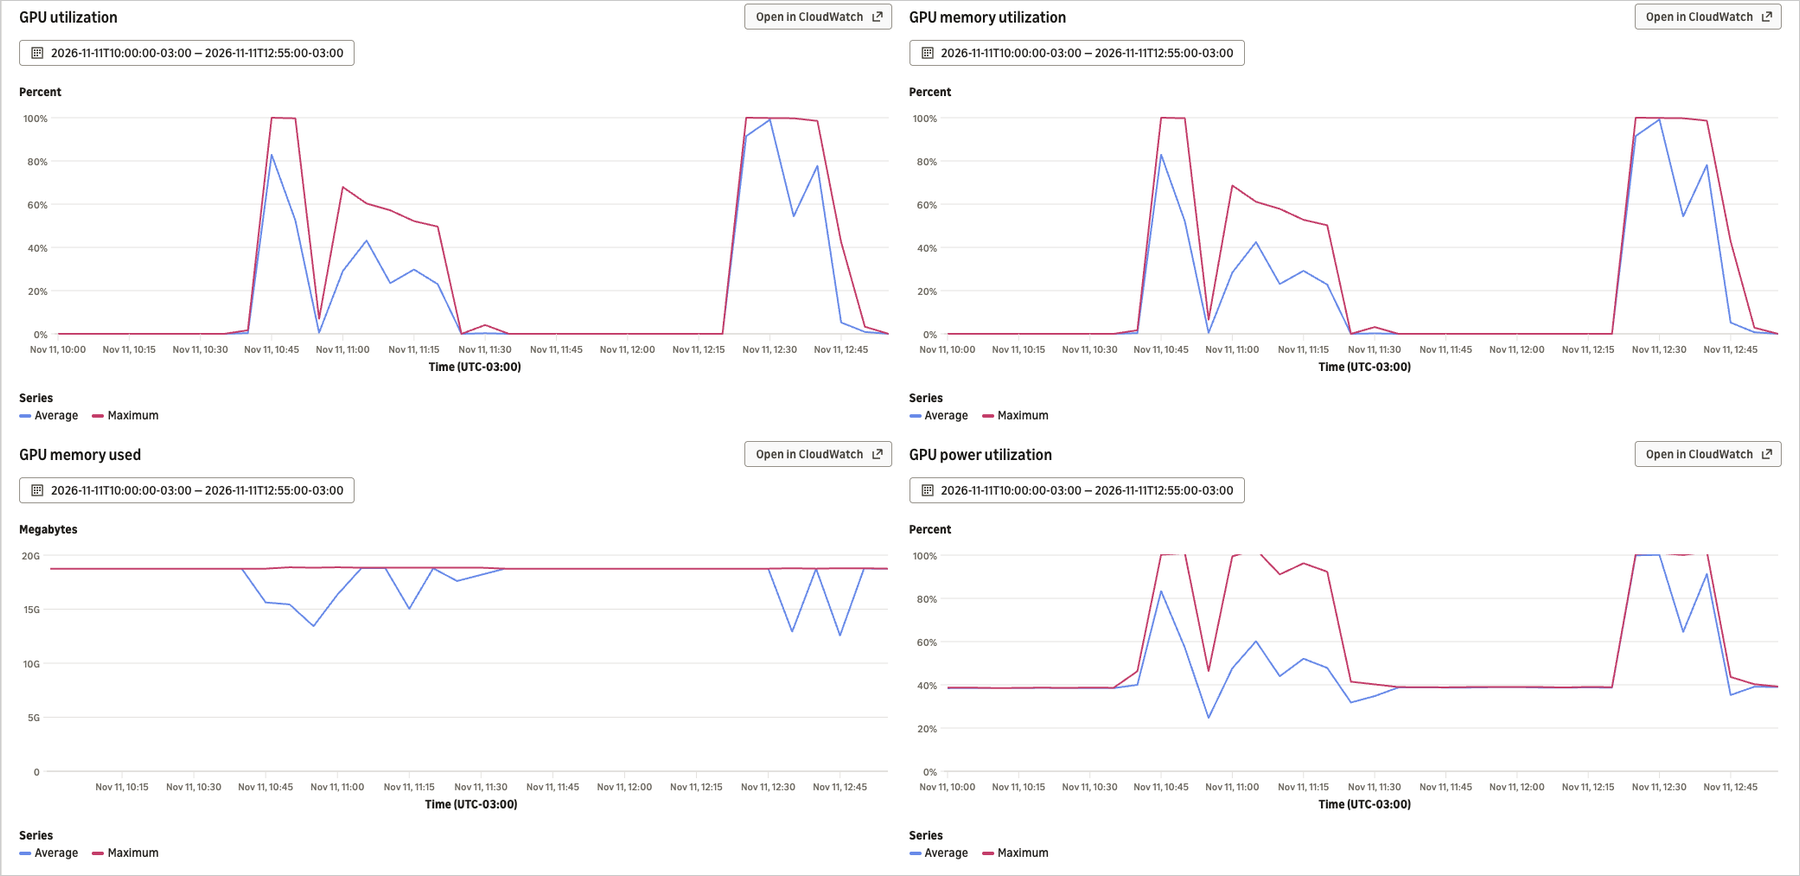
图 4:并发负载下 vLLM 函数的 GPU 利用率、GPU 内存利用率、已用 GPU 内存和 GPU 功耗利用率。
定价和可用性 此功能现已正式可用,发布时支持 Amazon EC2 G 系列(G4dn、G5、G6、G6f、Gr6、Gr6f、G6e),后续会有更多实例系列。你需要支付底层 EC2 实例费用(符合 Savings Plans 和 Reserved Instances 条件),外加 GPU 实例 9.75% 的管理费,以及标准 Lambda 请求费每百万请求 0.20 美元。有关定价和区域可用性,请参阅 AWS Lambda 定价。
你还可以使用 AI 编码助手和代理进行构建:探索 Builder Center,并通过 Agent Toolkit for AWS 连接你的工具,它捆绑了 AWS MCP Server 和精选的代理技能。
要开始使用,请访问 AWS Lambda 控制台并查看 GPU 加速函数文档。