 Newshot
How Airbnb uses cost per task to operate coding agents on Amazon Bedrock
Amazon Bedrock 通过统一的 API 提供来自多个提供商的基础模型,并由 AWS 管理模型基础设施。它与 AWS 的访问控制和监控集成,并在 AWS 内处理提示词、代码和模型响应。
随着编码代理进入生产环境,模型和使用量的变化可能影响延迟、容量和成本。Amazon CloudWatch 中的 Amazon Bedrock 运行时指标可帮助团队排查延迟上升、限流以及 token 消耗变化。评估(evals)通过在一组固定的代表性任务上评估代理的工作质量,对这些运维指标形成补充。
本文介绍 Airbnb 如何为编码代理评估模型,并监控其在 Amazon Bedrock 上的使用情况。我们说明 cost per task 如何指导模型选型,以及生产数据如何帮助我们在使用情况变化时重新审视这些选择。我们还会介绍用于排查延迟、限流和支出的运行时信号。
在 Airbnb,每周有数千名工程师及工程相关人员使用 AirChat——我们用于运行编码代理的内部工具。这些代理通过我们的 LLM 网关发送模型请求,该网关运行在 Amazon Bedrock 上。Bedrock 在 AWS 内处理 Airbnb 的代码、提示词和模型响应。大约五周内发布了八款新模型。到 10 月中旬,我们的工程师通过编码代理发送的请求中约有三分之二流向了这些新模型。
每一次发布都可能同时改变输出 token、成本、延迟和容量,而发布时公布的基准图表并不能展示模型如何处理我们工程师的工作。因此我们并行运行两套系统。在推广之前,我们在自己的任务上运行 evals,衡量每个模型的得分和 cost per task。cost per task 是代理完成一项任务所用全部 token 的标价成本。
推广之后,可观测性向我们展示生产中发生了什么变化。当生产使用情况与评估结果不符时,我们会找出原因。
Solution overview
借助 CloudWatch 中 AWS/Bedrock 命名空间的几个信号,你就能诊断大多数生产问题:
- 延迟:InvocationLatency、TimeToFirstToken、OutputTokenCount,以及由你自行推导的每秒输出 token 数(OTPS)。
- 限流:InvocationThrottles,以及每个请求针对你的配额所预留的 token 数(由你自行发布)。Bedrock 还会发布 EstimatedTPMQuotaUsage,用于衡量你估算的每分钟 token(TPM)配额消耗,涵盖缓存写入 token 和输出消耗乘数,覆盖所有推理 API(Converse、InvokeModel、ConverseStream 和 InvokeModelWithResponseStream)。你可以使用该指标在达到配额上限前设置主动告警、跟踪各模型的配额消耗,并在使用被限流之前申请进一步提高配额。
- 成本:InputTokenCount(未缓存输入)、CacheReadInputTokenCount、CacheWriteInputTokenCount 和 OutputTokenCount,各自按其费率计价。缓存读取的成本低于未缓存输入,而缓存写入的成本可能更高,具体取决于模型。缓存命中率降低会增加单次请求成本。
在这些指标之上,我们还增加了 cost per task。我们的 evals 会为我们允许的每个模型和每种推理力度衡量得分和 cost per task。推理力度是一个设置,用于控制模型在响应前进行多少推理。我们用这些结果来选择每个默认值,即我们的编码工具默认使用的模型和力度(除非工程师另行选择),以及每个力度上限,即我们为某个模型允许的最高力度。
Architecture
工程师在 AirDev 工作区上运行 AirChat,这些工作区是云端的个人开发机。他们也可以把任务交给 AirChat Remote,后者在独立的云工作区中运行云端代理,而工程师可以同时去做别的事。这两条路径都通过我们的 LLM 网关接入 Amazon Bedrock。
图 1 展示了 AirChat 和 AirChat Remote 如何通过我们的网关访问 Amazon Bedrock,也展示了评估和生产监控如何指导模型默认配置与推理强度上限的设定。
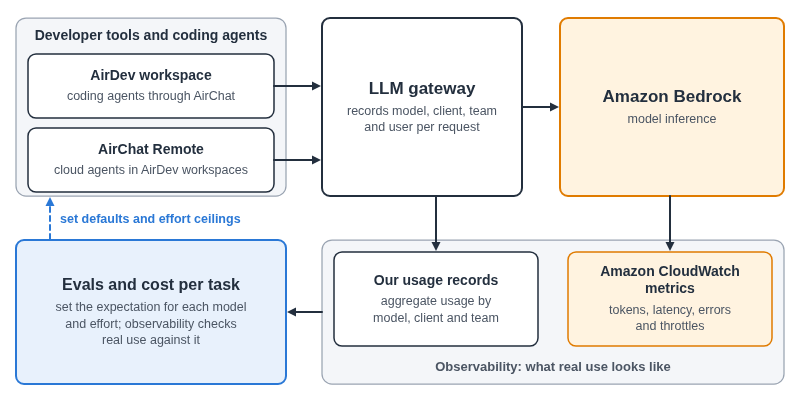
图 1:编码智能体和云端智能体通过我们的 LLM 网关调用 Amazon Bedrock。我们的使用记录和 CloudWatch 指标反映真实使用情况,我们借助评估结果来设定默认配置和推理强度上限。
网关会记录每个请求所使用的模型、客户端、团队和用户。我们仅以汇总方式使用这些记录,用于成本与容量规划。CloudWatch 提供 token 数量、延迟、错误和限流数据。我们将这些生产信号与评估得分及每任务成本进行对比,以判断何时需要调整默认配置或推理强度上限。
前置条件
在 AWS 侧,你需要:
- 能够访问你计划运行和评估的 Amazon Bedrock 中的模型。关于各 AWS 区域的模型可用性,请参阅 Amazon Bedrock 用户指南中的按模型划分的区域可用性。
- 通过 ConverseStream 或 InvokeModelWithResponseStream 进行流式调用。Bedrock 仅对流式 API 发布 TimeToFirstToken 指标。
- 在你调用的每个 AWS 区域中都开启模型调用日志。该功能默认关闭。日志可能包含完整的提示词和响应,以及调用者的身份信息,因此应限制可读取日志的人员并设置保留期限。
为调用方配置带标签的 IAM 角色,并激活成本分配标签。请在开始收集数据之前激活,因为激活不会回溯此前的成本。
你还需要自备三样东西:
- 一组来自你自己工程工作的任务。为每个任务提供起始仓库状态、工程师会写出的提示词,以及一个你信任的评分器。评分器是给智能体工作打分的程序或模型。我们的任务基于真实代码变更、这些变更上的评审意见,以及原始工单未明确说明的决策来构建。第 2 步展示了一个示例。
- 一个位于 Bedrock 之前的网关或代理,用于记录每个请求的模型、客户端、团队、用户和 token 数量。
- 一张你运行的每个模型的公开标价表,每条记录都标注日期,以便你能以同一基准为评估 token 和生产 token 计价。
在上线之前,请定义智能体可以访问哪些内容,以及哪些操作需要人工审核。在隔离的工作区中运行代码,并在合并之前测试生成的变更。Amazon Bedrock Guardrails 可以帮助过滤提示词和响应中的有害内容和敏感信息。对于基于所提供参考材料的响应,上下文 grounding 检查可以标记出缺乏支持的声明。请在你自己的任务上测试这些控制措施,并将它们的延迟和成本纳入你的测量中。
操作步骤
先测量完成一个完整任务需要多少成本。然后利用这些结果来选择模型默认配置、检查生产行为、管理容量并归集支出。
第 1 步:完成一个任务需要多少成本?
一个编码智能体需要发起许多请求才能完成一个任务,而每次请求时模型都会重新读取此前的上下文。因此我们对整个任务进行计价。
Bedrock 对每个请求报告四类 token:未缓存输入、缓存读取、缓存写入和输出。在评估运行中,我们为每个请求的这四类 token 计价,并将任务中的所有请求加总。本文中的每项成本均使用该次运行日期对应的公开标价。我们将平均成本记录在每一个所测试的模型、推理强度和智能体客户端对应得分的旁边,且该平均值包含得分较低的尝试。
推理强度会同时改变得分和成本。在我们测试的一个模型上,从低强度提升到高强度使得分提高了 0.8 分,而每任务成本是原来的 2.5 倍。我们利用这些结果来设定推理强度上限,并由网关强制执行。
第 2 步:评估一个新模型能有多快?
在新模型发布的那天下午,只需向我们的 agent 发出一个请求,就能启动一次评测行动,让新模型跑遍我们所有的任务套件。套件是一组固定的、同一类型的任务,我们共有七个套件。agent 会把数百个任务分散到各个套件和多个云工作区中运行,每个结果一经评分器打分便立即出现。首批结果在数小时内就会到达。到第二天早上,每个套件都有了分数和每任务成本,我们也就掌握了为整个组织做出部署决策所需的信息。
这种速度依赖于已经被写下来的任务。每个任务都是一个文件夹,里面装着一次运行所需的全部内容。下面是我们机器学习工作中一个经过精简的任务:
        honest-holdout-bakeoff/
  instruction.md     what the agent is told
  task.toml          time limit, CPUs and memory
  environment/       Dockerfile for the sandbox
  tests/test.sh      runs the grader and writes the reward
  tests/grader.py    the checks
  solution/          a reference solution that must pass the grader

instruction.md (excerpt):
  We have two candidate models for a prediction task, and we need to
  know which one to ship.
  ...
  Then answer the question we actually have to decide: is either
  candidate worth rolling out over the system already in production?
评分器在每次运行时都会根据冻结的数据重新计算正确答案,只有当所有检查都通过时,agent 才能获得 1 的奖励。要在每种 effort 下测试同一个模型,只需在作业配置中把每种 effort 列为单独的 agent:
        job_name: model-a-effort-sweep
n_attempts: 1                # one attempt per task at each effort
datasets:
  - path: tasks/ml           # each task brings its own grader
agents:
  - name: model-a-low
    model_name: vendor/model-a
    kwargs: {reasoning_effort: low}
  - name: model-a-medium
    model_name: vendor/model-a
    kwargs: {reasoning_effort: medium}
  - name: model-a-high
    model_name: vendor/model-a
    kwargs: {reasoning_effort: high}
这两个示例都使用 Harbor 的格式,Harbor 是一个用于在沙箱中运行 agent 评测的开源框架。如果你刚起步,它是一个可选方案。
运行评测是可以优化的。编写评分标准(rubric),也就是评分器所遵循的评分指南,是最困难的部分。我们的长任务要经过好几轮,期间会有模拟的评审者在各轮之间提出质疑。模型评分器会按八个加权维度对每次运行打分。每个维度的得分从 0 到 3。
        Correctness of delivery   25     Judgment                 10
Verification quality      15     Evidence and reporting   10
Autonomy                  15     Readability              10
Design and workload fit   10     Operational discipline    5

Ceiling: if the reviewer had to rescue the agent repeatedly
(autonomy 0 or 0.5), the total is capped at 25 of 100.
正因为有这类上限,一个需要被救援的 agent 无法仅靠表面功夫拿到高分。
第 3 步:上线之后要关注什么?
当延迟上升时,在开支持工单之前,先看三张信号图:TimeToFirstToken 表示生成开始前的等待时间,OutputTokenCount 表示响应长度,OTPS 表示生成速度。Bedrock 没有原生的 OTPS 指标。需要借助指标运算推导出来,正如 Amazon Bedrock User Guide 所述:
OTPS = OutputTokenCount / (InvocationLatency - TimeToFirstToken) * 1000
在我们这次会话的示例中,延迟上升了 40%,而首 token 时间和 OTPS 保持不变。有人修改了系统提示词,要求给出更详尽的回答,于是每次请求的输出 token 数上升了 50%。模型以相同的速度生成,但写出的响应更长。要把提示词变更和模型升级当作部署来对待,并在仪表盘上标记出来。
文章标题:Airbnb 如何利用每任务成本在 Amazon Bedrock 上运行编码智能体
正文: 每周我们都会把 CloudWatch 运行时指标与网关中每个模型的使用记录放在一起对照。为了进行成本和容量规划,我们还会看汇总后的使用情况:每请求成本以及每周每用户的平均请求数。一个新模型可能同时改变这两项。每次上线后,我们会把它们与评测中每任务成本的预期进行比较。
第 4 步:评测结果不错。生产环境显示了什么?
有一个模型,我们称之为模型 A,在我们的评测中表现不错。在我们的编码任务上,它的得分比之前最好的模型高出三分以上。每任务成本大致相同,而且所有模型都由同一个评分器评分。我们上线了它,将 effort 上限设为 high,并要求人们在大多数工作中使用 low 或 medium。
上线几周后,我们按标价计算了模型 A 的生产使用成本,并对其进行了汇总分析。模型 A 上每用户的平均每周支出比前一个模型高出数倍。模型 A 的每个请求成本约为三倍,而模型 A 的平均用户发送的请求数也约为三倍。
输出 token 仅占一个请求成本的十分之一。大部分成本花在缓存上下文上,模型在每次请求时都会重新读取这些上下文。模型 A 可以长时间自主工作,因此人们开始用它进行长时间的自主会话。
评测衡量的是模型在任务上的表现。生产环境衡量的是人们选择如何与它协作。
后来,一个更新的模型在相同任务和相同评分器下得分高于模型 A,而每任务成本约为其六分之一。我们通过一次配置变更将模型 A 的用户迁移到了它上面。
随后,我们在同一用户群体——模型 A 的重度用户——上汇总检查了这一变化。在切换到更新模型后的第一个完整周,该群体向其主模型发送的请求数大致相同,而该群体在该模型上的支出降至约七分之一。
第 5 步:为什么会被限流,以及流量接下来会去哪里
在 bedrock-runtime 端点上,Bedrock 会在请求到达时、模型写出任何内容之前检查你的每分钟 token 配额。它会预留你的未缓存输入 token 和缓存写入,再加上 max_tokens,即该请求允许的最大输出量。随着模型生成内容,它会调整该预留量,并在请求结算时返还未使用的部分。缓存读取从不计入配额,因此一个请求对你的配额来说可能很便宜,但在你的账单上却很贵。输出 token 按一个烧减率结算,在大多数模型上是 1:1,在一些当前模型上是数倍,因此请检查你的模型的速率。
一个显示计费 token 的仪表盘可能在请求被限流时仍显示有空间。在我们会话的示例中,配额为每分钟 100 万 token,流量为每分钟 300 个请求。仪表盘显示约使用了配额的 30%。在应用 5:1 的输出 token 烧减率后,已完成的请求消耗了约 77%。
准入使用的是不同的计算方式。每个请求最初预留 600 个未缓存输入 token 加上 4,096 的 max_tokens,总计 4,696 个 token。响应在 p99 时约为 800 个 token。
将 max_tokens 降低到 1,024 后,初始预留量降至 1,624 个 token,缩小了约 65%。该限制仍高于 p99。对于未变化的输入和输出,最终配额消耗保持不变。更小的预留量为准入请求留下了更多空间。监控 stopReason 以捕获被截断的响应。使用退避和抖动,并限制重试次数。
需求也可能超出你在任何单一模型上的余量。你需要在需要之前就知道工作可以转移到哪里,而我们的评测回答了这个问题。答案可以是来自另一个模型家族的模型。对于我们使用的每一个主要模型,我们至少保留一个在评测中表现同样好、并且可以进行负载均衡的等效模型。没有这些评测,选择工作去向就只能靠猜测。
文章标题:How Airbnb uses cost per task to operate coding agents on Amazon Bedrock
正文: 如果某个模型的余量持续紧张,我们可以通过更改配置中的默认值来重新平衡。首先要确认等效模型有容量承担额外负载,并且你的配额足以覆盖。同时要保证它上面有足够的流量以维持你的访问权限:模型进入 Legacy 期后,现有客户若连续 15 天不活动就可能失去访问权限。Legacy 模型会一直工作到生命周期结束,之后 Bedrock 会将其从所有 Region 中移除,发给它的请求会失败,且 Bedrock 不会自动迁移你的流量。当 LegacyModelInvocations 升到零以上时触发告警。
第 6 步:这是谁的花费?
Bedrock 运行时指标按 ModelId 划分维度,因此你能看到是哪个模型处理了请求,但看不到是哪个团队发出的请求。Bedrock 在发布这些指标时,有的带 ModelId 维度,有的不带;一个在 Bedrock 解析出模型之前就失败的请求,只会出现在不带该维度的序列中,所以按 ModelId 过滤会低估错误数。Bedrock 提供三种归因花费的方式:
- 哪个团队或用户?Bedrock 会在每个请求上记录调用方的 IAM 身份。给你的角色打标签,或传递会话标签,即可在 AWS Cost Explorer 和 AWS Cost and Usage Report(CUR 2.0)中按标签查看成本。
- 哪个应用?应用推理配置文件是特定于模型的,所以请为每个应用和模型组合创建一个打了标签的配置文件,并调用对应配置文件的 ARN。
- 哪个功能或提示词?在 Converse 的 requestMetadata 中传入键值对。Bedrock 会把它们写入模型调用日志,但不计入账单。要为其计价,请用日志中的 token 数乘以公开费率。经典 CUR 和 CUR 2.0 都不携带按请求的 ID,因此请按模型、使用类型和时间段比较总额来对账。
在网关后面,Bedrock 看到的是网关的角色,所以让网关为每个用户代入一个角色,并带有各自的 RoleSessionName 或会话标签。把这些凭证按会话缓存起来,因为每个请求都代入一次角色可能会超出你的 AWS Security Token Service(AWS STS)速率配额。归因出问题时请求仍会继续成功,所以要为 Bedrock 无法投递调用日志的情况设置告警。
我们的使用记录让我们能按模型、客户端、团队和用户归因用量,我们仅将其聚合用于成本和容量规划。我们用同样的四个 token 计数计算每任务成本,因此可以比较我们的评测与生产环境之间的 token 构成和成本。
结果
我们可以在一夜之间从模型发布走到部署决策。在一次上线后,模型 A 上每用户的平均每周花费是上一代模型的数倍。我们将其重度用户迁移到了更新的模型。在他们第一个完整周里,该群体在其主模型上的花费降至约七分之一,请求数大致相同。对于我们使用的每一个主要模型,我们的评测都能找出一个可以重新平衡过去的等效模型。
清理
测试结束后,停止你启动的评测作业和 agent 进程。如果你仅为本次演练启用了模型调用日志,请在每个 Region 中使用 DeleteModelInvocationLoggingConfiguration 将其禁用。
在调用方不再使用它们之后,使用 DeleteInferenceProfile 删除你创建的应用推理配置文件。移除仅为本次演练创建的 IAM 角色、策略和资源标签。停用仅用于这些测试的成本分配标签。删除你不再需要的测试 CloudWatch 日志组和 S3 日志对象。
结论
每次模型发布时,我们都会执行四项检查:
- 发布日:在你自己的任务上、以各种 effort 运行新模型,并同时记录分数和每任务成本。
- 上线前:根据这些数字选择默认 effort 并设定 effort 上限。封禁任何成本更高且分数低于更低 effort 的 effort。
- 最初几周:将每请求成本和每用户平均请求数与评测的每任务成本进行比较,两者都基于同样的四个 token 计数计价。
- 未雨绸缪:了解哪些模型在你的评估中得分相同(可来自任何模型系列),并在重新平衡前检查它们的容量和你的配额。
我们选择 Amazon Bedrock,是为了通过一个 API 访问多个模型系列。它让我们能够使用现有的 AWS 访问控制和日志记录,同时由 AWS 管理模型基础设施。我们用评估来为工作选择模型,用可观测性来判断这些选择何时需要重新审视。
如需进一步了解,请参阅 Amazon Bedrock 用户指南中的以下页面:
- 在 CloudWatch 中监控运行时指标
- 用每秒输出 token 数诊断延迟
- token 如何计数
- 提示缓存
- 跟踪用量和成本
- 用日志监控模型调用
- 模型生命周期