 Newshot
随着组织构建越来越多的智能体、Model Context Protocol (MCP) 服务器和技能,它们需要一种一致的方式来描述、治理和查找这些资源。AWS Agent Registry 提供了一个目录,用于注册、审批和发现这些资源以及自定义记录。每条记录都带有名称、描述、协议描述符和审批状态。然而,每个组织都有自己想要跟踪的属性和事实,其中一些是该组织特有的,例如其业务部门、资源所有者、风险分类和开发环境。组织希望为这些属性中的每一个提供统一定义,并且希望注册表中的每个智能体、MCP 服务器和技能都携带这些事实。在此之前,组织无法在 AWS Agent Registry 中定义这些事实并将其存储到每条记录上。
自定义元数据 schema 现已在 AWS Agent Registry 中提供。自定义元数据 schema 是一组由组织定义的键值对,AWS Agent Registry 中的记录会携带这些键值对。管理员定义该 schema 并将其应用到注册表,随后注册表中的所有记录都必须遵循该 schema。当发布者创建或提交记录时,他们为适用 schema 中指定的字段提供值,AWS Agent Registry 会根据管理员设置的 schema 验证这些值。审批者在审查记录时可以依赖这些经过验证的值,使用方和智能体可以使用这些值来发现和筛选记录。管理员、发布者、安全与治理团队、审批者、使用方和智能体都基于一组共享事实来治理、发现和理解其智能体资产群中的资源。
在本文中,我们跟随 AnyCompany 组织发布一个带有自定义 schema 定义的 MCP 服务器,丰富该记录,并使其可供人类或智能体发现。我们以 MCP 服务器为例,但相同的步骤适用于其他记录类型。
自定义元数据如何工作
借助自定义元数据,组织可以使用标准化词汇来描述其资源。注册表管理员定义自定义元数据 schema:字段名称、类型、允许值,以及每个字段是必填还是可选。注册表会对每条记录强制执行该 schema,因此无论哪个团队发布记录,environment 这样的字段都具有相同的名称和相同的允许值。
该 schema 具有适用于每种记录类型的通用属性,你也可以添加仅适用于特定记录类型的专用字段。每个字段为 Text、Enum、URL 或 Boolean。
- 当创建或更新记录时,注册表会根据管理员设置的 schema 验证自定义元数据。如果创建记录时没有任何自定义元数据,AWS Agent Registry 会将其保存为 NON_COMPLIANT。团队可以通过这种方式保存进行中的工作,但在记录具有必填字段和值之前,无法提交该记录以供审批。如果记录包含带有未知字段、缺少必填字段或值无效的自定义元数据,AWS Agent Registry 会以 ValidationException 拒绝该记录。
当创建或更新记录时,注册表会根据管理员设置的 schema 验证自定义元数据。
- 如果创建记录时没有任何自定义元数据,AWS Agent Registry 会将其保存为 NON_COMPLIANT。团队可以通过这种方式保存进行中的工作,但在记录具有必填字段和值之前,无法提交该记录以供审批。
- 如果记录包含带有未知字段、缺少必填字段或值无效的自定义元数据,AWS Agent Registry 会以 ValidationException 拒绝该记录。
- GetRegistryRecord 会返回记录的自定义元数据值及其合规状态。(COMPLIANT 表示这些值与管理员设置的 schema 匹配。它并不代表审批通过。审批者才会做出该决定。)
- Discovery API 还允许基于自定义属性筛选记录。
自定义元数据能实现什么
使用 AWS Agent Registry 中的通用元数据治理和发现记录
由于团队可以使用相同的字段和值描述 AWS Agent Registry 记录,该注册表可以支持并扩展治理与合规。
所有权与运营
environment(prod、staging 或 dev)、businessUnit、ownerTeam、supportContact 和 costCenter 等字段记录资源运行在哪里、由谁负责以及由谁付费。配置管理数据库(CMDB)ID 将记录链接到现有清单,support-tier 字段为任何依赖该资源的人设定预期。
安全与合规
数据分类、合规范围(例如 Payment Card Industry (PCI) 或 Health Insurance Portability and Accountability Act (HIPAA))、风险层级、扫描状态和扫描报告 URL,将审批转变为对结构化证据的检查。现有扫描器、CMDB 同步任务和分类工具在记录提交前通过 API 写入这些值。如本文所示,你可以使用这些值构建记录审批流程或自动化。
更好的发现
自定义元数据值会建立索引以供搜索。使用方或代理可以将自然语言查询与特定元数据筛选条件结合,例如 environment=prod AND businessUnit=payments AND securityScanStatus=PASSED。仅返回已批准的记录,因此匹配筛选条件但尚未获批的记录不会出现在结果中。图 1 展示了从管理员到使用方的每个角色如何让记录经历模式定义、注册、充实、批准和发现。
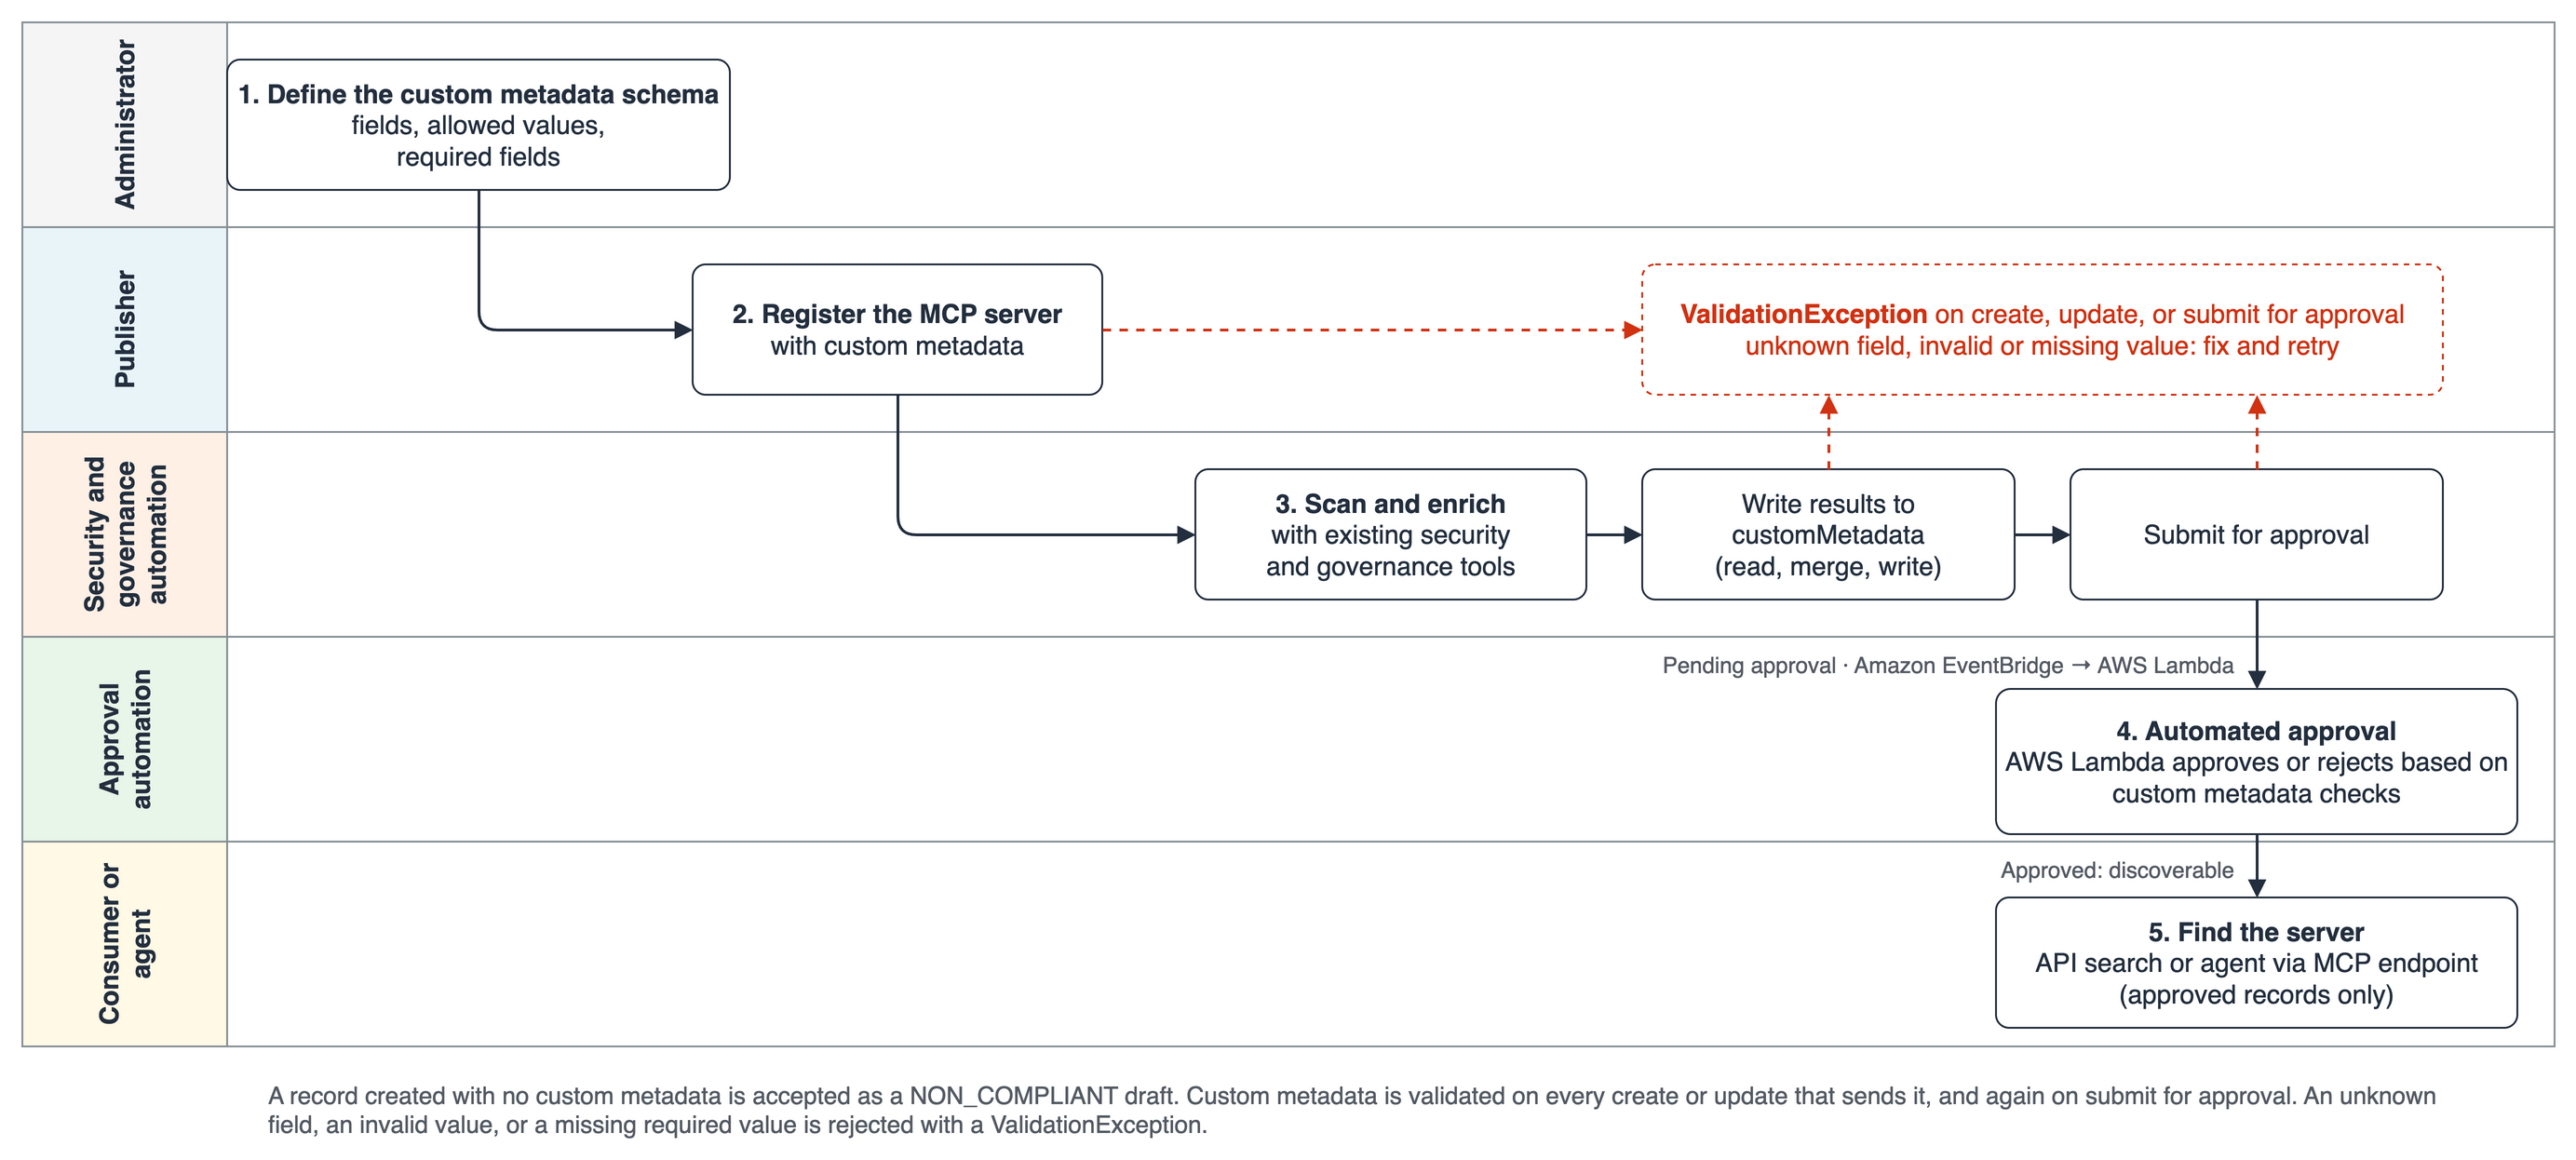
图 1:按角色展示记录如何在 AWS Agent Registry 中流转的泳道图
MCP 记录从注册到发现的演练
AnyCompany 运营 anycompany-governed-registry,这是一个没有自动批准的 AWS Agent Registry。其支付团队发布一个 MCP 记录 payments-ledger-mcp,这是一个用于账本查询的只读服务器。现有安全和库存系统会充实该 MCP 记录,然后由审批函数决定使用方能否发现它。
图 2 中五个编号步骤与演练对应:定义、注册、充实并提交、审核,然后发现。
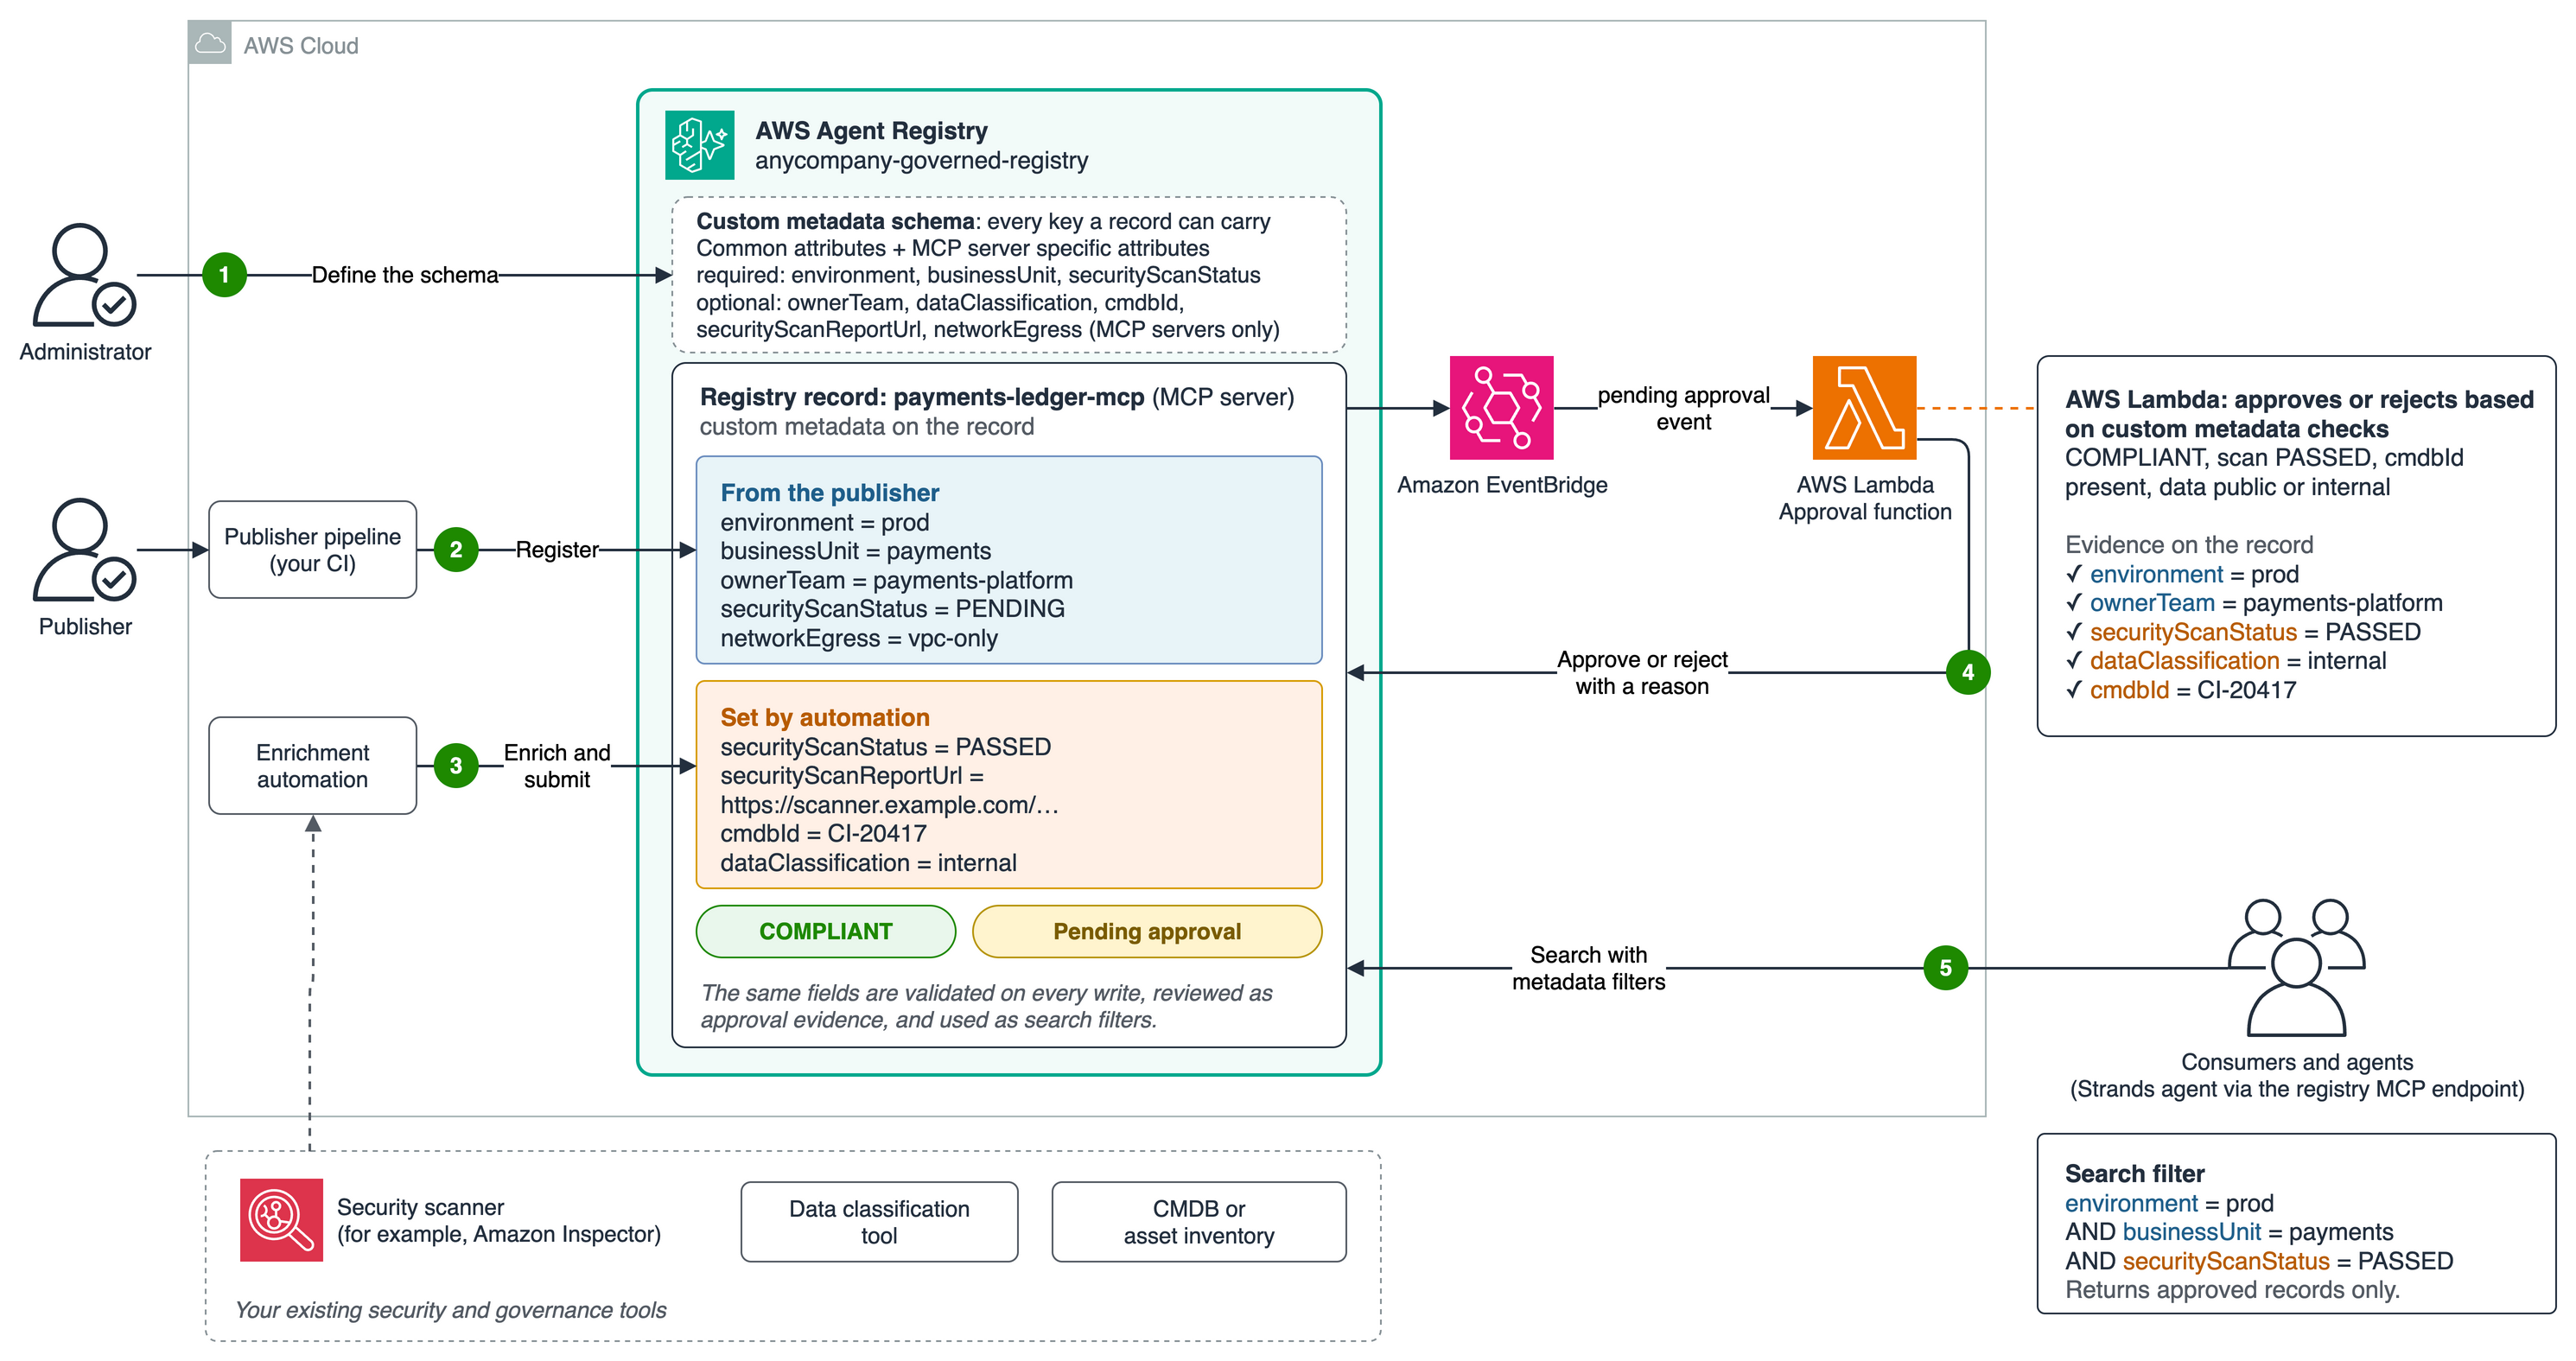
图 2:自定义元数据从现有工具收集发布者上下文和值,使审批和搜索可以使用相同的事实
先决条件
要按演练操作,你需要:
- 一个位于受支持 AWS 区域中的 AWS 账户。
- Boto3 可用的 AWS 凭证,以及 AWS Agent Registry 的 AWS Identity and Access Management (IAM) 权限。
- Python 3.11 或更高版本,以及 boto3 1.43.113 或更高版本。
- 示例实现位于 GitHub 仓库中。
代码片段已缩短:cp 和 dp 分别是 agent-registry-control 和 agent-registry 的 boto3 客户端。示例仓库包含完整代码。
第 1 步:AWS Agent Registry 管理员为注册表定义自定义元数据模式
AnyCompany 的管理员创建一个注册表,其中包含每条记录都必须遵循的自定义元数据模式。
- 每条记录必须包含其 environment、businessUnit 和 securityScanStatus 字段。
- 记录还可以带有可选字段,由发布者或自动化稍后填写:ownerTeam、cmdbId、dataClassification 和 securityScanReportUrl。
- MCP 服务器还会记录其 networkEgress,该字段是可选的。
default_schema = {"type": "object", "properties": {
        default_schema = {"type": "object", "properties": {
    "environment": {"type": "string", "enum": ["prod", "staging", "dev"]},
    "businessUnit": {"type": "string"},
    "ownerTeam": {"type": "string"},
    "cmdbId": {"type": "string"},
    "dataClassification": {"type": "string", "enum": ["public", "internal", "confidential", "restricted"]},
    "securityScanStatus": {"type": "string", "enum": ["PENDING", "PASSED", "FAILED"]},
    "securityScanReportUrl": {"type": "string", "format": "uri"},
}, "required": ["environment", "businessUnit", "securityScanStatus"]}

mcp_schema = {"type": "object", "properties": {"networkEgress": {
    "type": "string", "enum": ["none", "vpc-only", "allowlisted-internet"]}}}

cp.create_registry(
    name="anycompany-governed-registry",
    approvalConfiguration={"autoApprovalRules": []},
    customMetadataSchemaConfiguration={
        "defaultSchema": json.dumps(default_schema),
        "recordTypeSchemaOverrides": [
            {"recordType": "MCP", "schema": json.dumps(mcp_schema)}]})
图 3 展示了该 schema,以及 Step 3 中补全完成后 payments-ledger-mcp 将携带的值。空的 autoApprovalRules 列表意味着该注册表自身不会批准任何记录。每条提交的记录都会停留在 Pending approval 状态,直到某个人或某个机制批准它。你可以决定是由自己构建的自动检查(Step 4 使用 AWS Lambda function)、人工审批者,还是两者共同完成审批。
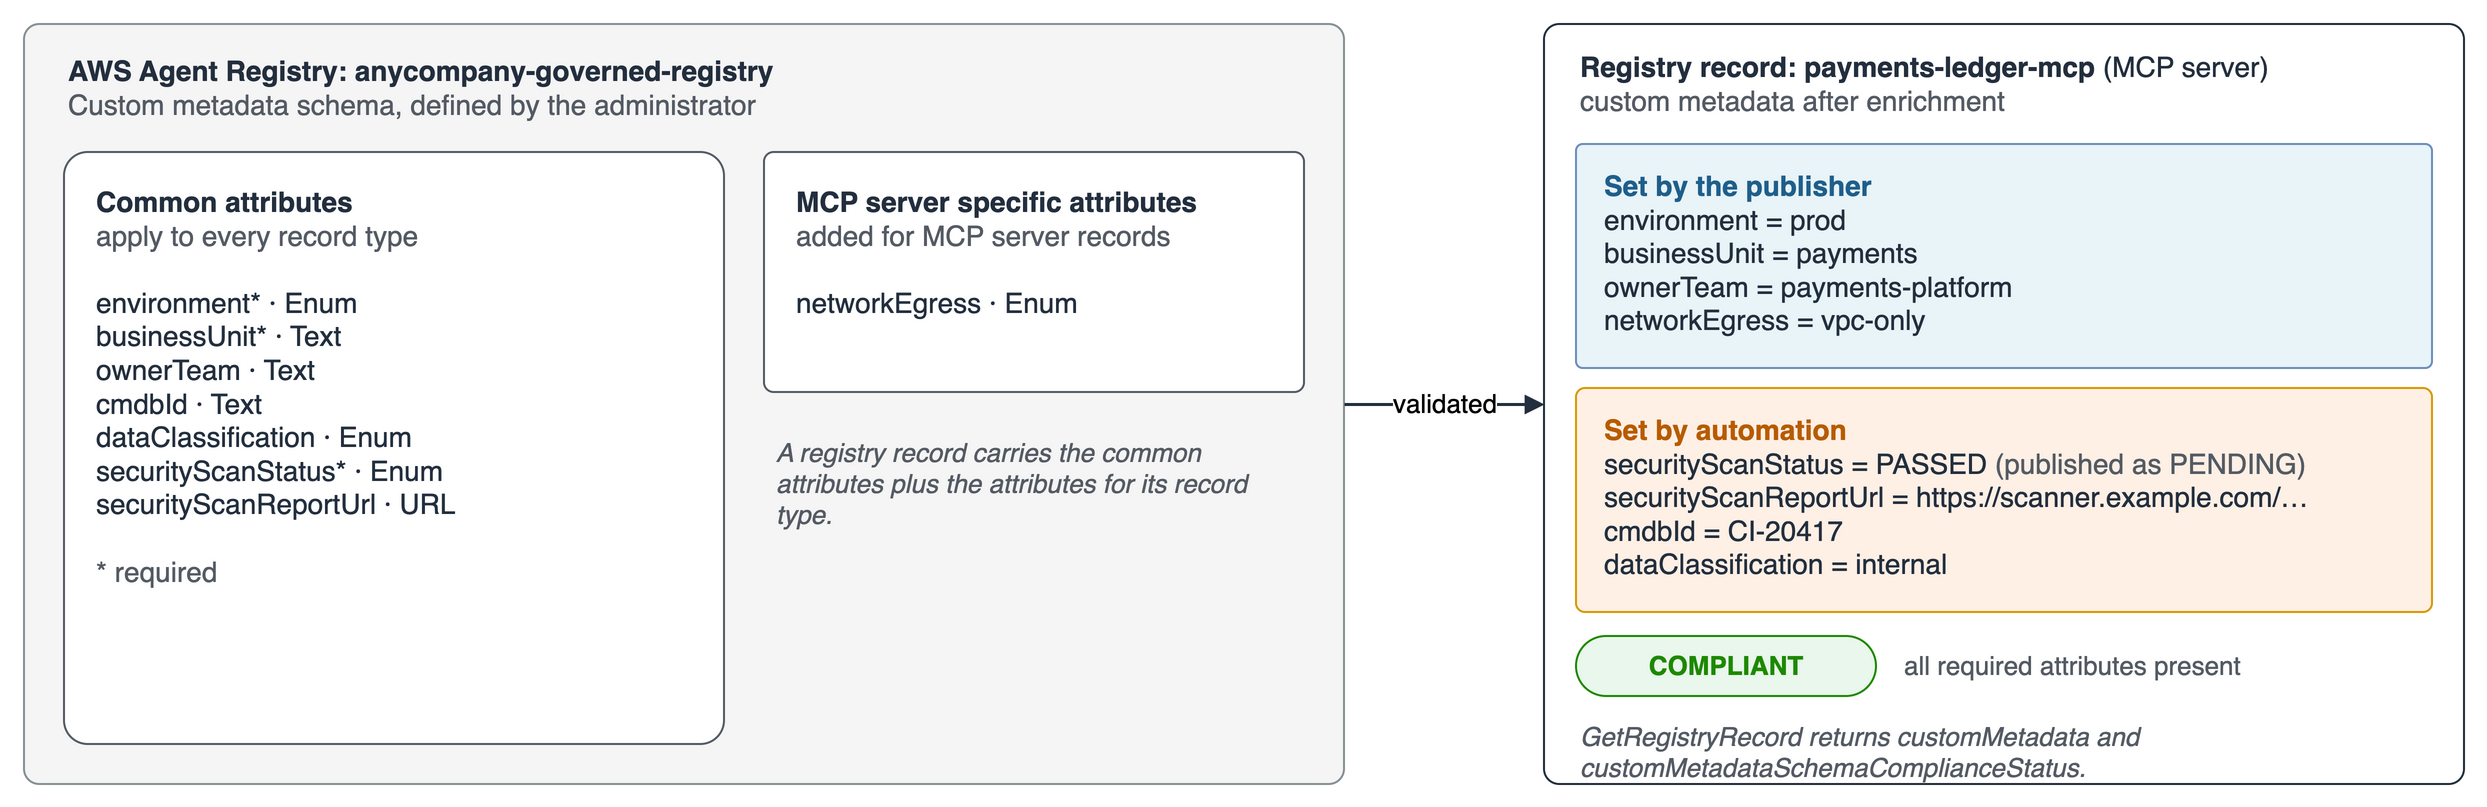
图 3:展示注册表公共属性、为 MCP 记录新增的字段,以及 payments-ledger-mcp 经过校验的 customMetadata 映射的示意图
管理员也可以在 AWS Agent Registry 控制台中查看该 schema。图 4 展示了注册表详情页上显示的公共属性和 MCP 专属字段。
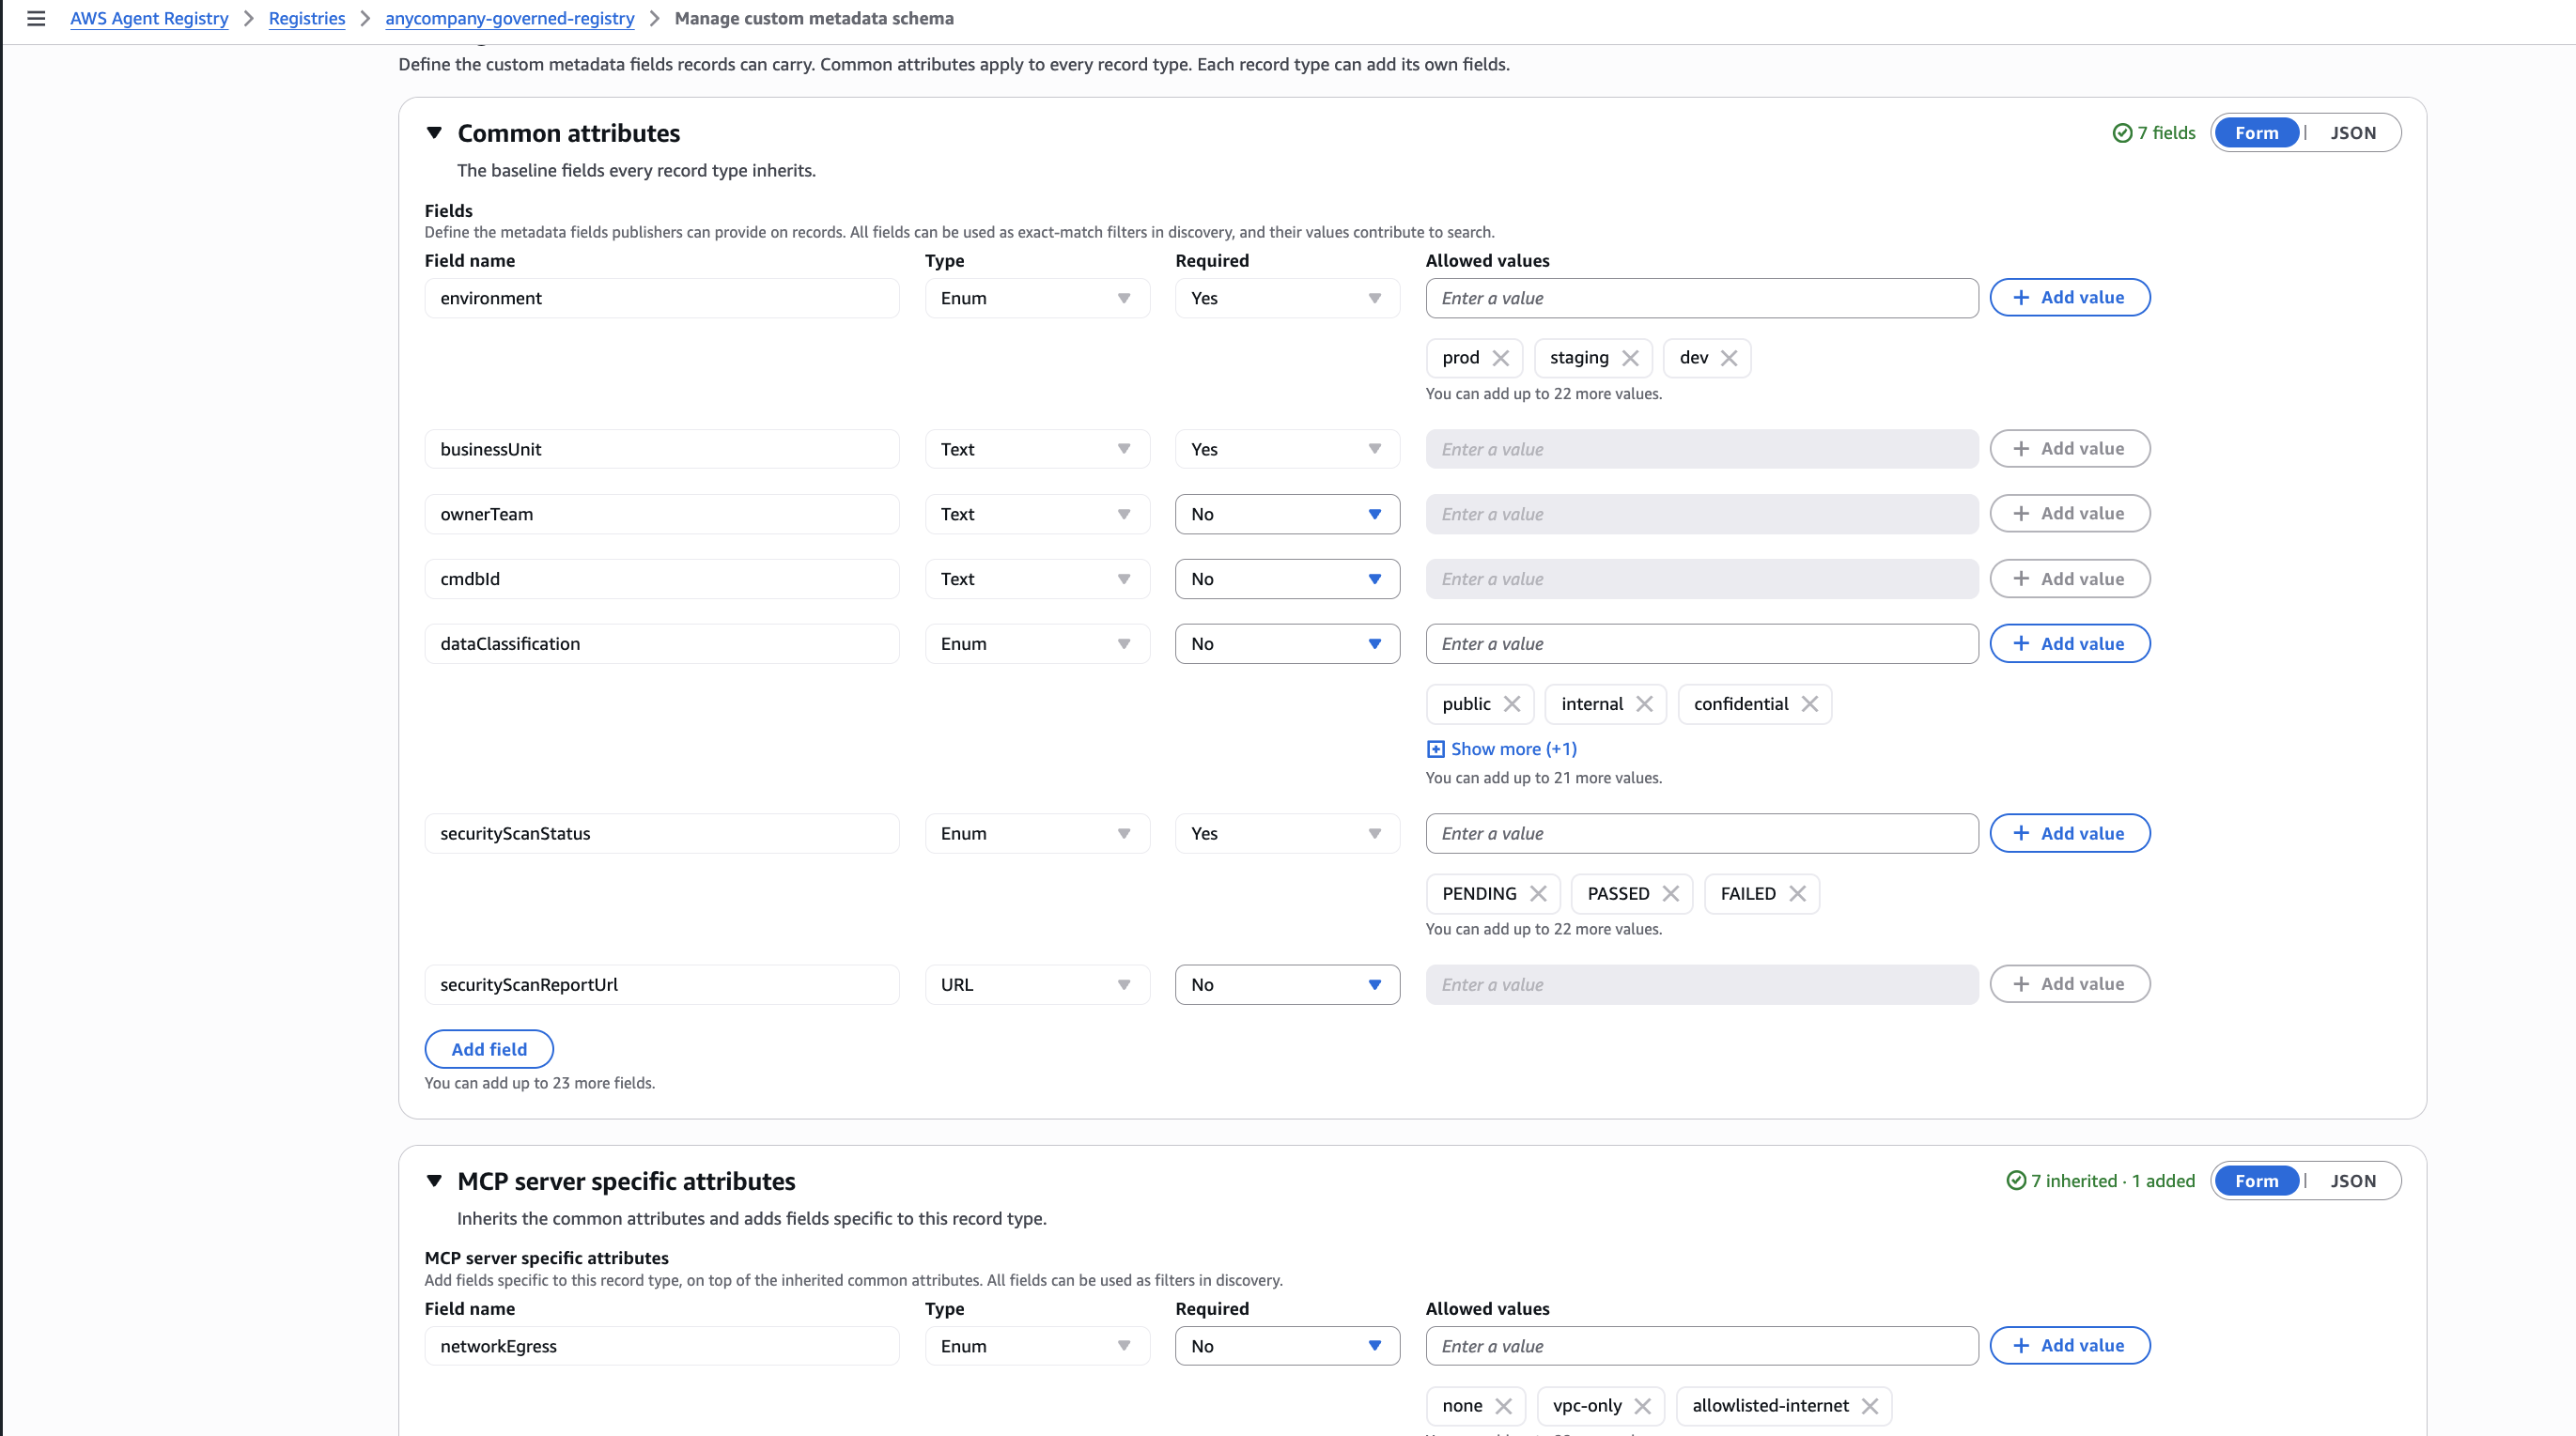
图 4:AWS Agent Registry 控制台中的 custom metadata schema
Step 2:发布者注册服务器
payments 团队的流水线会连同自定义元数据一起注册 payments-ledger-mcp。它的第一次尝试使用了 production,而不是管理员允许的某个值。
        customMetadata sent by the pipeline:

{
    "environment": "production",
    "businessUnit": "payments",
    "securityScanStatus": "PENDING"
}

ValidationException: Custom metadata validation failed for record type MCP: /environment: does not have a value in the enumeration ["prod", "staging", "dev"]
注册表拒绝了这条记录。在流水线发送 prod 之后,记录被创建为一条合规草稿。schema 正是以这种方式让所有团队使用相同的值。
Step 3:自动化添加额外元数据并提交
接下来,AnyCompany 的自动化流程会补充其自有系统已知的信息:安全扫描器的结果、CMDB 中的资产 ID,以及已批准的数据分类。随后它会提交记录以请求审批。
        record = cp.get_registry_record(registryId=registry_id, recordId=record_id)
scan = run_security_scan(record)  # Replace this stub with your scanner call.
metadata = {**record["customMetadata"],
    "cmdbId": get_cmdb_id(record),
    "dataClassification": get_classification(record),
    "securityScanStatus": scan["status"],
    "securityScanReportUrl": scan["report_url"]}
cp.update_registry_record(registryId=registry_id, recordId=record_id,
    customMetadata={"optionalValue": metadata})
wait_for_record(cp, registry_id, record_id, "DRAFT")
cp.submit_registry_record_for_approval(
    registryId=registry_id, recordId=record_id)
更新会替换整个元数据映射,因此自动化流程会先读取当前值,加入自己的值,再一起写回。在示例中,扫描器和 CMDB 调用都是桩代码,你可以替换为自己的工具。注册表会向 Amazon EventBridge 发送一个待审批事件。在第 4 步中,你创建的规则会将该事件传递给你的审批函数。
第 4 步:审批自动化根据证据做出决定
当记录进入 Pending approval 状态时,AWS Agent Registry 会向 Amazon EventBridge 发送一个事件,并设置一条 Amazon EventBridge 规则来调用自定义 AWS Lambda 函数。图 5 展示了 payments-ledger-mcp 的控制台视图,其中包含审批函数在检查时读取的自定义元数据值。
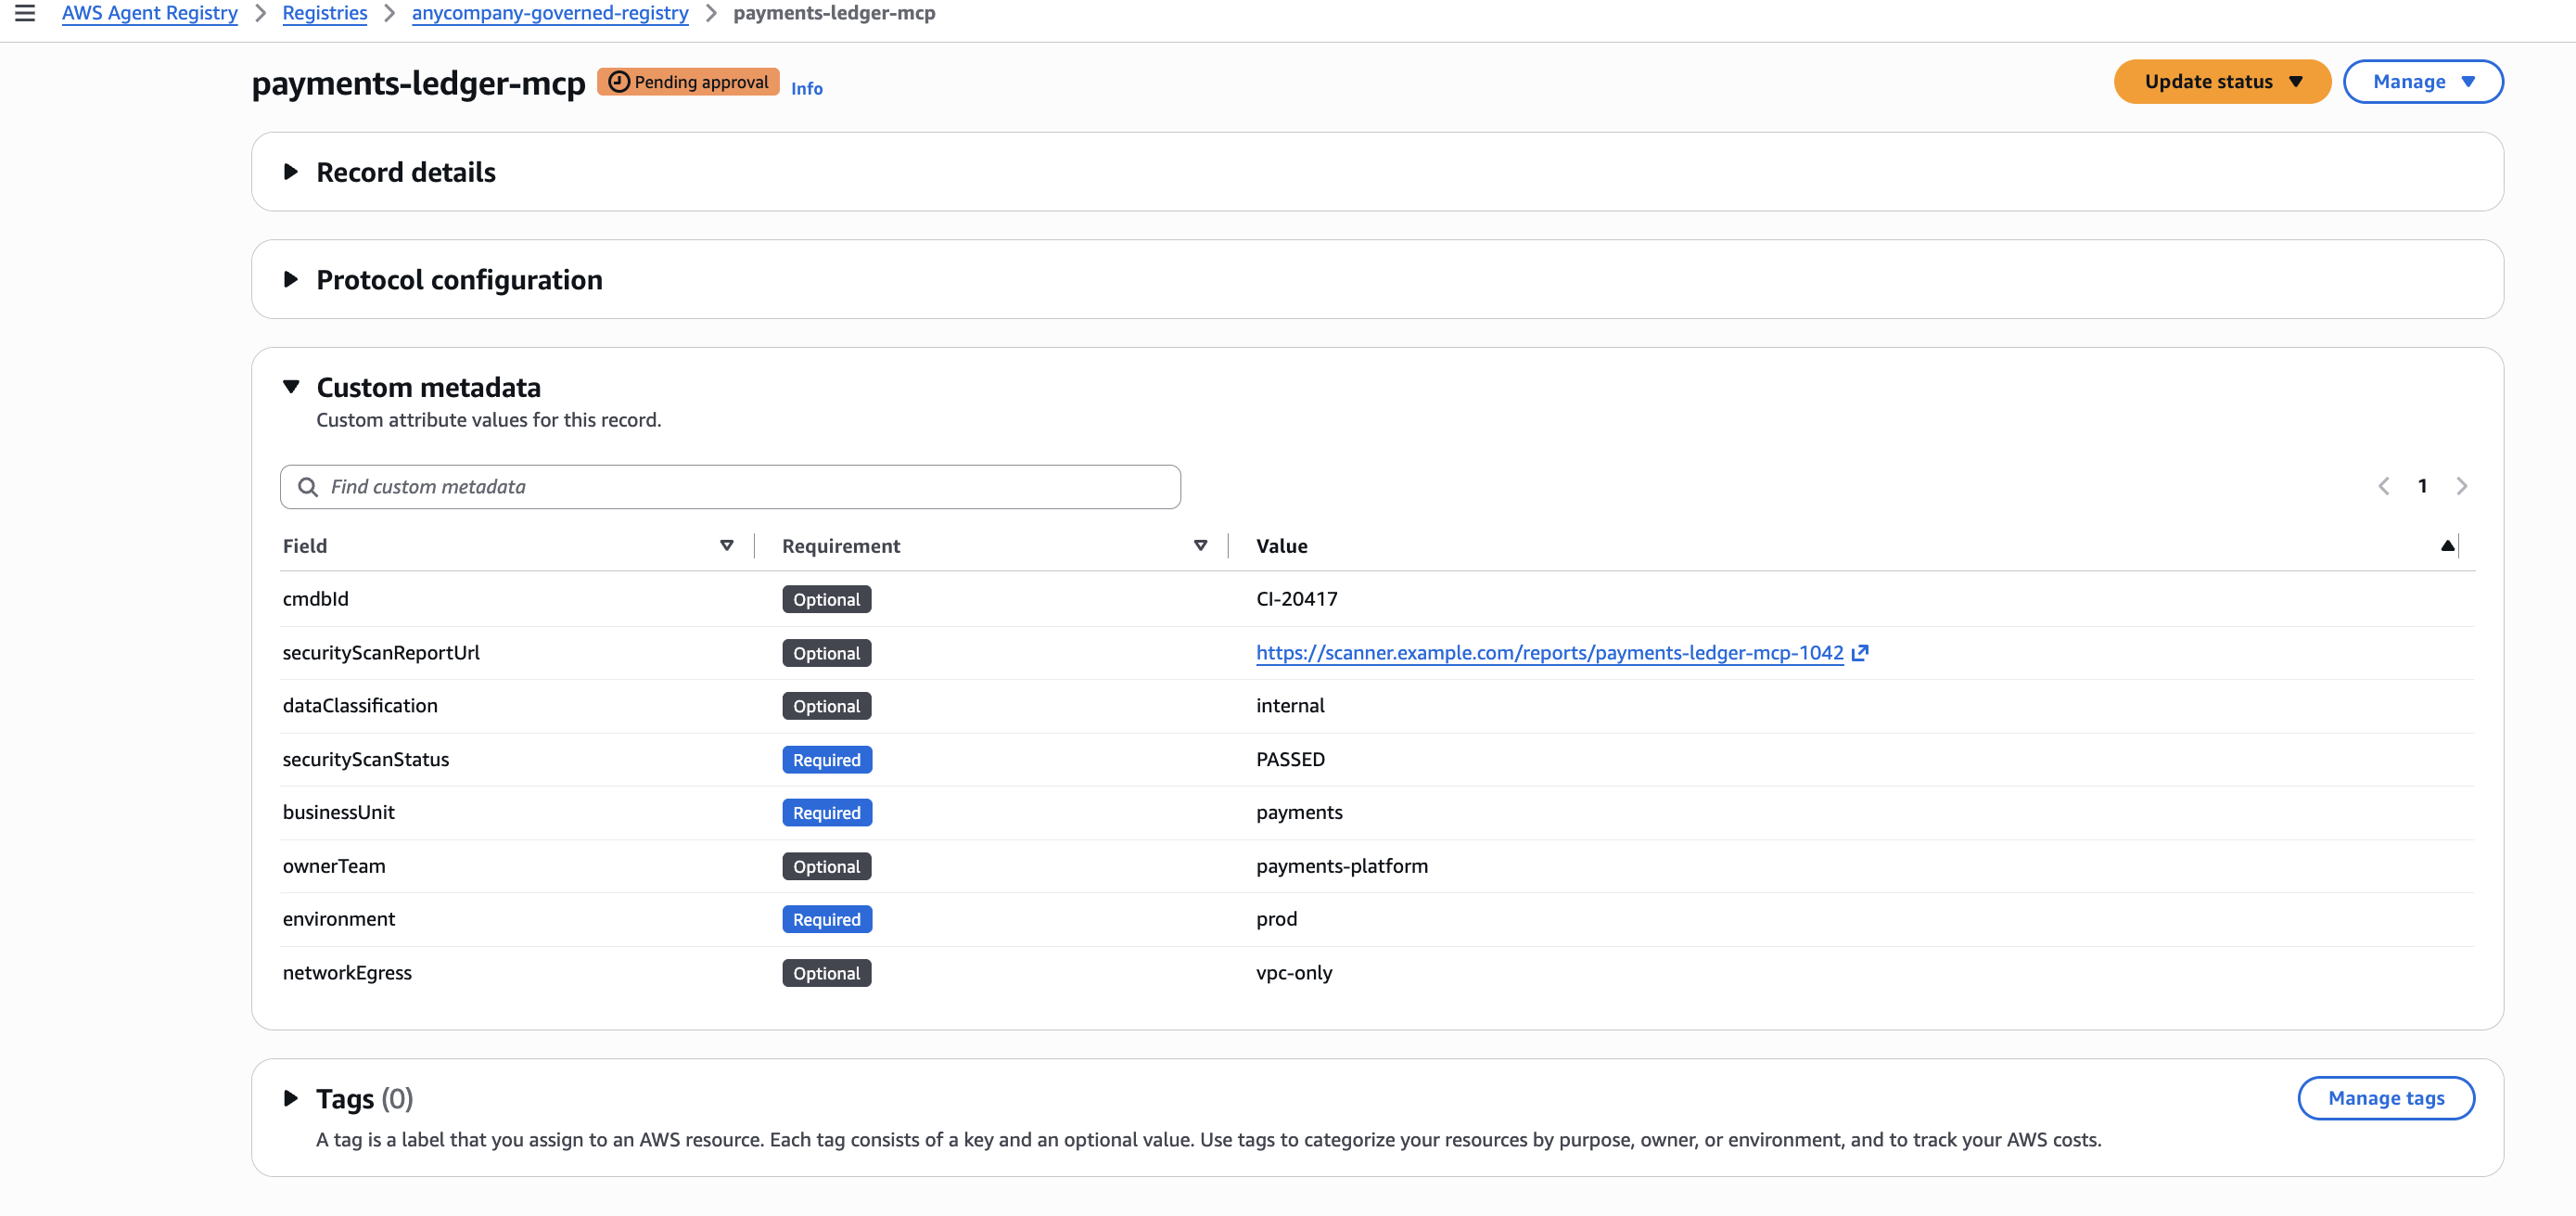
图 5:记录上的自定义元数据是审批函数将要检查的证据
该函数会读取记录的自定义元数据和合规状态,以检查记录是否为 COMPLIANT、扫描是否 PASSED、是否存在 cmdbId,以及数据是否为 public 或 internal。payments-ledger-mcp 通过了全部四项检查,因此该函数予以批准。未通过检查的记录会被拒绝,拒绝原因会指明未通过的检查。在生产系统中,你可以选择将需要人工审核的记录(例如包含机密或受限数据的记录)转为人工审核,而不是直接拒绝。
第 5 步:使用方通过以自定义元数据字段作为筛选条件的 AWS Agent Registry 查找记录
寻找账本工具的开发者会搜索注册表,并按管理员定义的相同字段进行筛选。
        dp = boto3.client("agent-registry")
matches = dp.search_discoverable_registry_records(
    registryIds=[registry_id],
    searchQuery="ledger lookup",
    filters={"$and": [
        {"customMetadata.environment": {"$eq": "prod"}},
        {"customMetadata.businessUnit": {"$eq": "payments"}},
        {"customMetadata.securityScanStatus": {"$eq": "PASSED"}},
    ]},
)
搜索会返回 payments-ledger-mcp,因为它已获批准并匹配全部三个筛选条件。智能体可以通过注册表的 MCP 端点 https://agentregistry.<region>.api.aws/registry/<registryId>/mcp 运行相同的搜索,该端点提供 search、list 和 get 作为 MCP 工具。在 GitHub 示例中,一个 Strands 智能体连接到 AWS Registry MCP 端点,并使用 Amazon Bedrock 上的模型。其系统提示词列出了用于筛选记录的自定义元数据字段。该智能体将一条自然语言请求(例如“一个用于 payments 账本查询且已通过安全扫描的生产 MCP 服务器”)转换为带筛选条件的搜索。它返回的答案是 payments-ledger-mcp。
开发者和智能体查询的是管理员定义、审批函数检查过的相同字段,因此双方都只能找到符合你治理规则的服务器。
为长期使用设计架构
将架构视为组织的共享词汇表:
- 先就词汇表达成一致。在创建架构之前,与发布和审批记录的团队确定字段名称和允许值。架构变更属于增量式:你可以添加字段、添加允许值,或将可选字段设为必填,但不能重命名、删除字段或更改字段类型。
- 预期现有记录会滞后于记录加入注册表之后所做的架构变更。现有记录不会被重写。不再匹配架构的记录会被报告为 NON_COMPLIANT,并保留其审批状态。该记录仍保持已批准状态,但其下一次更新必须满足新架构。编辑已批准的记录会创建一个草稿,该草稿必须重新提交审批;在必填字段都有值之前,提交会失败。在策展人批准新修订之前,使用方仍会看到已批准的版本。
- 将每个字段放在正确的层级。对于适用于所有记录类型的问题,使用通用属性;对于特定于记录类型的事实(如代理的自主级别),使用记录类型字段。
- 选择适合该字段的类型。对于需要拼写一致的决策字段,使用 Enums;对于外部标识符,使用 Text;对于存储在源系统访问控制之后的证据,使用 URL。
- 仅在发布者可以在注册时分配值时,才将字段设为必填。对于由持续集成(CI)或自动化在记录发布后提供的值,允许临时值,例如 PENDING。在本文中,扫描在注册后运行,因此 securityScanStatus 有三个值:PENDING、PASSED 和 FAILED。发布者写入 PENDING,而丰富自动化会替换它。
- 将敏感细节排除在外。不要把机密、内部端点或详细发现结果放入可广泛读取的元数据中。
结论
在本文中,我们展示了如何在 AWS Agent Registry 中添加自定义元数据,以便为每条记录提供一组通用事实,例如其环境、所属业务部门、数据分类和安全扫描状态。我们使用一个 MCP 服务器,展示了一名管理员定义架构,一名发布者和现有自动化填充值,一个你在 AWS Lambda 中构建的审批函数决定是否批准,以及一名消费者通过元数据筛选找到已批准的服务器。由于管理员拥有架构,每个团队都使用相同的字段和值,而这种一致性正是 AWS Agent Registry 中的审批和搜索可靠的原因。
- 自己试一试:使用 GitHub repo 中的示例。
- 深入了解:阅读 AWS Agent Registry 开发人员指南和自定义元数据 API 参考。
- 可用性:查看支持的 AWS 区域。