 Newshot
TL;DR
我们与 Baseten 合作,利用 83B tokens、27,280 次 agent 运行,构建了规模最大的 harness 排行榜。我们想回答两个问题:当你更换模型时,是否也应该考虑更换 harness?每个模型的最佳 harness 是什么?
此前,我们的 v1.0 FrontierHarness 排行榜只基于单一模型 Kimi K3 对 harness 进行排名。
V1.1 将基准扩展到 22 个 harness × 5 个模型 × 62 个任务 × 4 次尝试,规模是 v1.0 的 76 倍。
通过实验,我们发现,为了获得最佳体验,在更换模型时应当考虑更换 harness。
每个模型都有不同的最佳性价比(通过率 vs. 成本)harness:Codex CLI 搭配 GLM-5.3,Pi 搭配 GLM-5.3 Flash,ZCode 搭配 DeepSeek V4.1 Flash 1017,Oh My Pi 搭配 Muse,Alma 搭配 Kimi-K3。成本排名在不同模型之间变化很大。
按每任务成本计算,中位 harness 在 22 个名次中移动了 11 位,Codex CLI 从搭配 GLM-5.3 时的第 1 名变为搭配 Kimi-K3 时的第 16 名。
Result
图 1. 各 harness 的每任务成本与通过率
每个点代表一个 harness:越靠左表示平均每任务成本越低,越高表示通过率越高。橙色线连接的是在成本和通过率两方面均未被其他 harness 超越的 harness。选择一个模型可筛选本文所有图表。
在所有模型上,有四个 harness 位于该线上:OpenCode v2(每任务成本最低,$0.561)、Pi、Codex CLI 和 ZCode(通过率最高,61.9%)。其余 harness 的成本最高可达其 1.6 倍,通过率在 50.6% 到 60.2% 之间。
每张卡片标出一个模型的最佳性价比 harness:即每通过一次成本最低者,除非另一个 harness 每次通过的成本最多高 30% 且通过率至少高 5 个百分点。按此规则,DeepSeek 下选择了 ZCode 而非 OpenCode v1(成本高 25%,通过率高 7.7 个百分点),Kimi-K3 下选择了 Alma 而非 Oh My Pi(成本高 9%,通过率高 6.5 个百分点)。
Why We Built FrontierHarness Eval v1.1
V1.0 用单一模型运行了九个 harness。它们的通过率彼此相差在 17 个百分点以内,但每通过一次的成本中位数相差 17 倍。我们认为这主要来自 harness 与模型的配对:某个 harness 搭配某个模型时便宜,搭配另一个模型时可能很贵。
V1.1 让每个 harness 与五个模型分别运行。
What We Tested
Harnesses。18 个 harness。四个 DeepSeek Harness 配置具有不同的工具集,OpenCode 运行了两个版本。每个单独计数:共 22 种配置。附录中的表 2 给出了它们的版本。
Models。五个模型均由 Baseten 提供:GLM-5.3(zai-org/GLM-5.3)、GLM Flash(zai-org/GLM-5.3-Flash)、DeepSeek(deepseek-ai/DeepSeek-V4.1-Flash-1017)、Muse(meta-models/muse-spark-open)和 Kimi-K3(moonshotai/Kimi-K3)。
Tasks。62 个终端任务。时间限制采用任务自身的规定,从 15 分钟到 8 小时。
Setup and Scoring
Configuration and Runtime
我们使用每个 harness 的默认设置运行 Harbor 评估,因为我们认为这最接近人们日常使用 harness 的方式。每个 harness 在所有模型上使用相同的版本和设置,并采用最大推理强度。
图 2. Harbor 与 Runta 在每次试验中如何分工
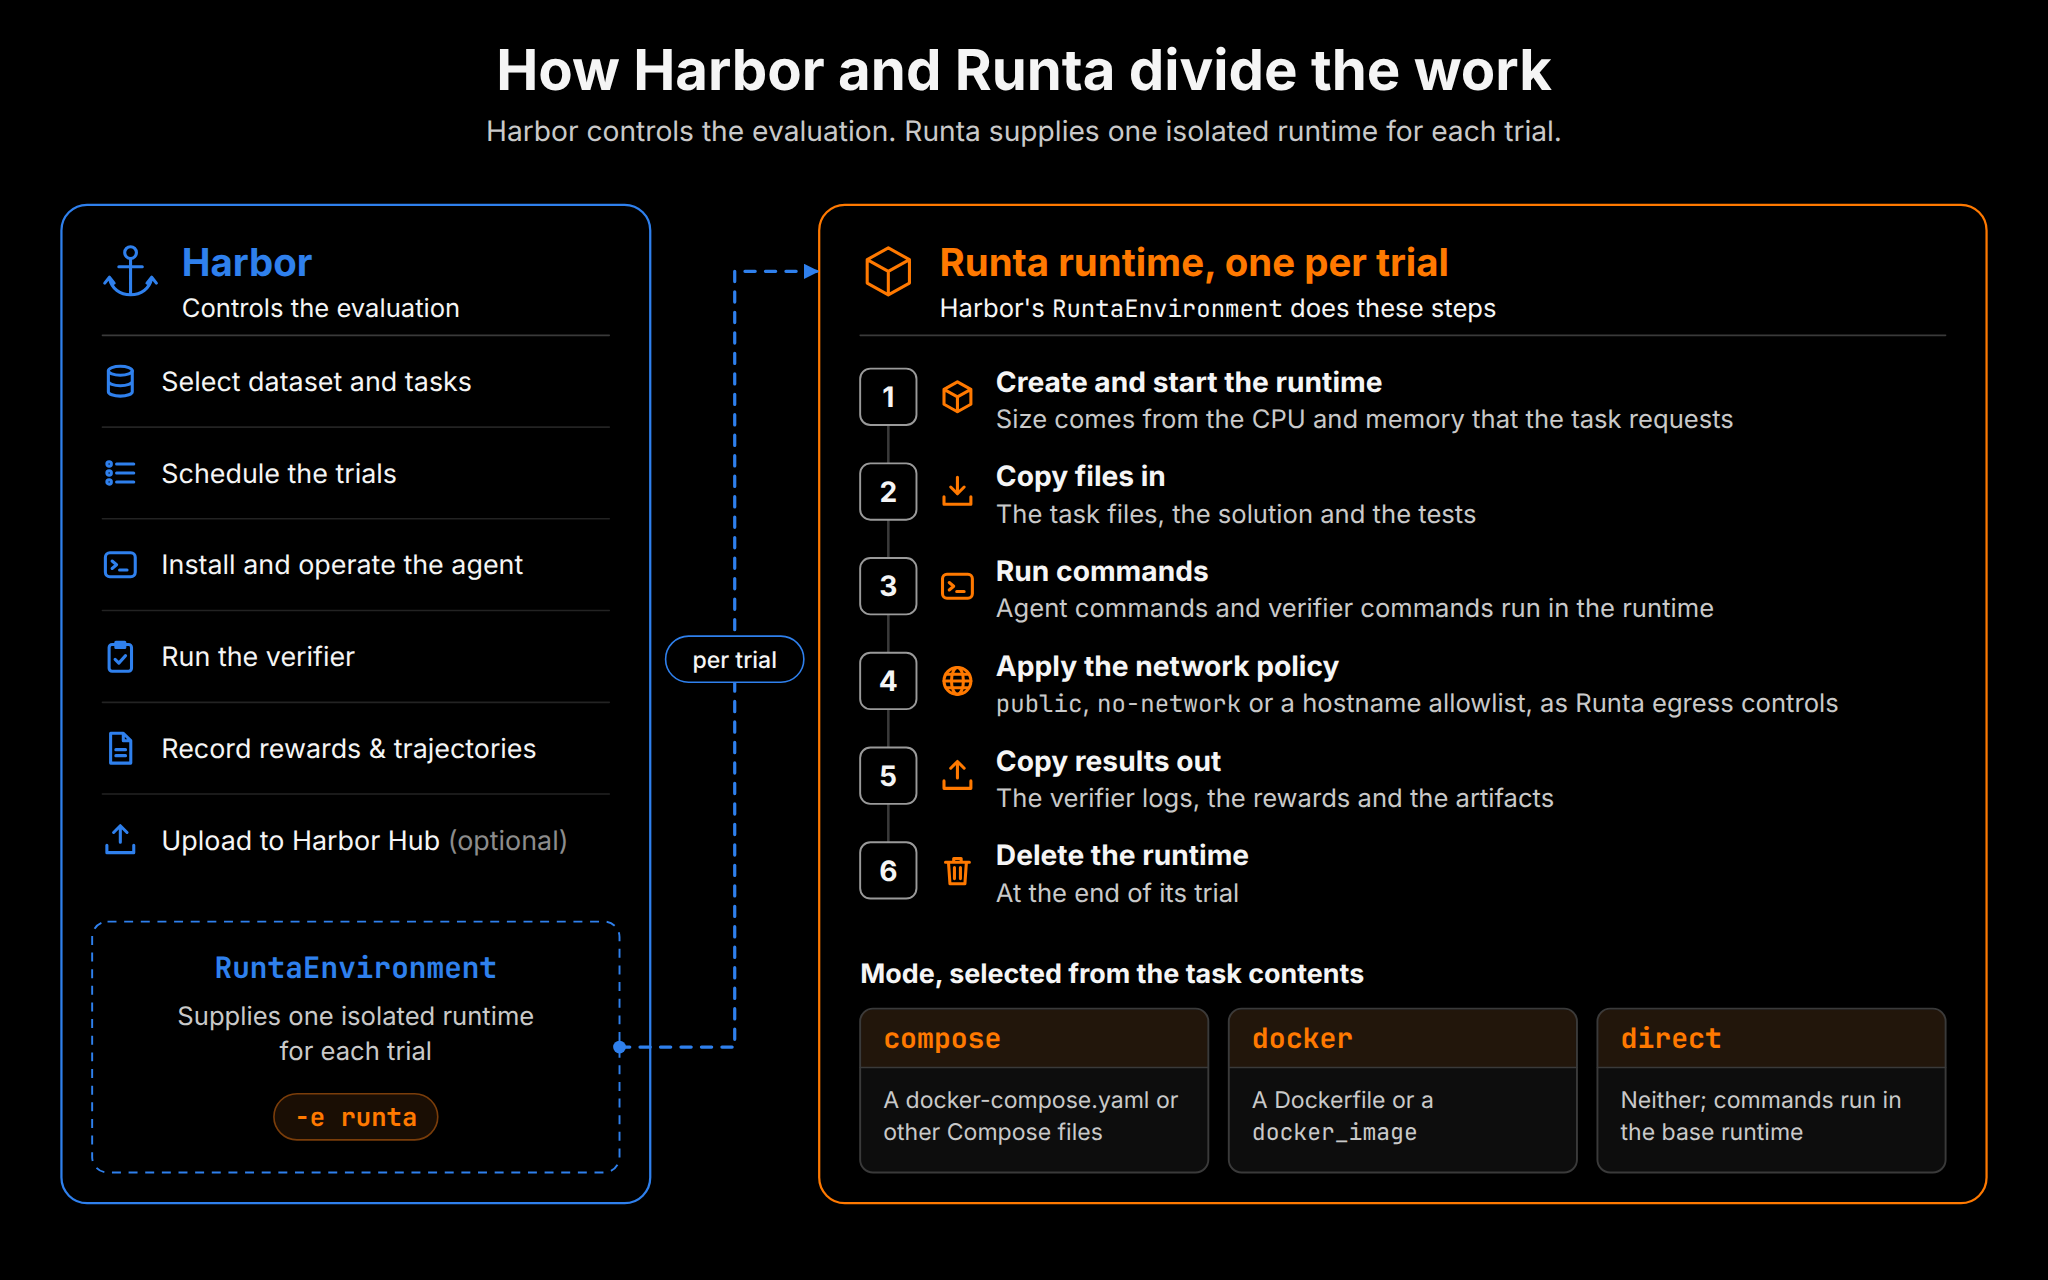
每次试验都会获得一个新的 Runta runtime,并在结束时被删除。因此任何试验都无法看到先前试验的文件。
Scoring Method
表 1. 方法论
一个单元格是一个 harness 与模型的配对。我们使用仪表盘的两个成本指标:
- 平均每任务成本:各任务已定价试验成本的均值,再对任务取均值。图 1 和成本排名使用该指标(图 4 和图 5)。
- 每通过一次的成本:平均每任务成本除以通过率。最佳性价比 harness 使用该指标(图 3、图 6 和图 7)。
文章标题:在27,280次编码智能体运行中,64%的推理花费流向了失败的运行
正文: 我们按每次通过的成本来挑选最佳性价比,因为我们希望各测试框架位于“通过率对每任务成本”图表的左上角:低价格下的高通过率。从原点向某个测试框架对应的点画一条线。其斜率——通过率 ÷ 成本——就是每美元通过的次数。每次通过的成本是这个斜率的倒数,因此每次通过成本最低的测试框架拥有最陡的线。
对试验日志的审计标记出216次试验存在奖励黑客行为,其中163次是联网查询。这些试验得分为0。附录中的表3给出了每个测试框架和模型的计数。
按模型分类的结果
图3. 各测试框架在不同模型下的成本与通过率
某列中更深的单元格表示其成本低于该列其他单元格。Codex CLI 在 GLM-5.3 下每次通过成本最低,为 $0.803,但在 Muse 下排第12,在 Kimi-K3 下排第10。在所有模型上,它的每次通过成本最低,为 $0.937,而 Antigravity CLI 最高,为 $1.63。
这些结果有多确定?
我们将62项任务重新抽取了4,000次,每次选出最佳性价比的测试框架。Codex CLI 搭配 GLM-5.3 在99.6%的抽取中保持第一。其余四个胜出者是几个接近的测试框架中最有可能的:Oh My Pi 搭配 Muse(53%)、ZCode 搭配 DeepSeek(47%)、Pi 搭配 GLM Flash(42%)以及 Alma 搭配 Kimi-K3(25%)。
测试框架改变成本
模型决定了成本的大致水平,因为各模型的标价相差20倍以上(图9)。我们对110个单元格的每任务平均成本取对数尺度,这样翻倍在每个模型下都计为相同的量。双因素方差分析将这些成本的离散程度分为三部分:
- 模型,92.8%:五个模型之间的差异。
- 测试框架,2.3%:测试框架效应中在每个模型下都相同的部分。
- 配对,4.9%:其余部分。它也包括噪声,因为每个单元格只有一个值。
因此,在模型固定的情况下,测试框架之间68%的差异(7.2个百分点中的4.9个)取决于配对,或属于噪声。
在模型固定的情况下,测试框架使成本变化1.8至5.0倍
图4. 每个模型的最低成本和最高成本测试框架
每一行是一个模型,采用每任务平均成本的对数尺度。比率是最高成本除以最低成本。
为检验偶然性,我们在每个模型的各测试框架之间打乱试验300次,并重新计算比率。“偶然”是这些比率的中位数,为1.2至1.8倍。全部五个真实比率都大于每一次打乱的结果(p = 0.003),因此这种离散来自测试框架,而非重跑的噪声。最大的是 DeepSeek:Cline CLI 的成本是 OpenCode v1 的5.0倍,通过率高出2.0个百分点。在其他模型下,每任务成本最低的测试框架至多落后最贵者0.4个百分点。
每任务成本最低的测试框架随模型而变
图5. 各测试框架在不同模型下的成本排名(1 = 每任务成本最低)
每条线是一个测试框架,最便宜的位于顶部。高亮的五条线是在 GLM-5.3、GLM Flash、DeepSeek、Muse 和 Kimi-K3 下每任务成本最低的测试框架。
Codex CLI 在 GLM-5.3 下排第1,在 Kimi-K3 下排第16。DeepSeek Harness: Creator 变动最大,从 Muse 下第1到 GLM Flash 下第21。OpenCode v1 在 DeepSeek 下排第1,在 Muse 下排第13。
重跑无法解释这些变动。我们将尝试分成两半,并按每一半中的成本对测试框架排名。在相同模型下,两个排名的平均秩相关为0.71。在两个不同模型下,为0.26。
更高的成本并不带来更高的分数
图6. 每个模型的最低和最高每次通过成本
这是图4在每次通过成本上的版本。每个比率之后是测试框架每任务成本与通过率的秩相关,从 −0.39 到 +0.22。正值意味着更贵的测试框架通过得更频繁。
通过率最高的测试框架在每任务成本上在22个中排第5至第20。在五个模型中的四个里,每次通过成本最高的测试框架通过率低于成本最低者。
更简单的 harness 成本更低吗?
不是。我们把四个因素与单次通过的成本做了对比。提示词大小、工具数量和缓存命中率都不是主要的成本因素。步数才是。
- 起始 token:agent 循环第一次请求的输入 token:系统提示词、工具定义和任务。
- 工具:第一次请求提供的工具。
- 缓存命中率和步数:通过试验的平均值。一步是 agent 轨迹中的一条记录。
图 7. 每个 harness 的四个因素与单次通过的成本
在 22 个 harness 上,单次通过的步数与单次通过的成本之间的秩相关系数为 +0.51(p = 0.015)。其余三个因素的相关系数为 −0.03 到 +0.02(p ≥ 0.88)。在每个模型内部,工具调用与成本的相关性和步数相当。下表 4 和附录中的表 5 给出了具体数值。
每一步都会重新发送上下文,因此按 harness 不同,一次试验平均使用 2.0 到 4.8 百万输入 token,而最大的首次请求为 21,365 token,不到其中的 1%。mini-SWE-agent 的首次请求最小,为 882 token,但每次通过需要 38 步,单次通过成本在 22 个中排第 17。
表 4. 每个 harness 的起始 token、工具数、缓存命中率、步数与单次通过成本
成本来自哪里
图 8. 每个 harness 的推理成本,按 token 类型或按试验结果划分
所有成本均为按标价估算的推理成本。harness 在模型卡上的通过率另以轮廓标出。
在全部试验中,来自缓存的输入占成本的 42%,输出占 33%,其他输入占 25%。
Token 与缓存
缓存让重复的输入便宜得多。缓存输入的价格是其他输入价格的 2%(DeepSeek)到 20%(GLM Flash)(图 9)。
图 9. 每个模型的标价(每百万 token 的美元价格)
有一组对比显示了缓存的效果。使用 DeepSeek 的 Cline CLI(每任务成本最高)有 86% 的输入从缓存读取,OpenCode v1 则是 97%,但它发送的输入量也翻了一倍。非缓存输入占其成本的 57%。
大部分成本花在未通过的试验上
在计分运行的标价成本中,64.5% 花在了未通过的试验上:52.7% 花在失败上,11.8% 花在超时上。
性价比最高的几个 harness 有什么共同点
五个性价比最高的 harness 的轨迹显示出三个共同的设计选择。这些是观察,不是检验。
一个 shell 工具承担了大部分工作。按 harness 不同,它获得了 61% 到 93% 的工具调用。Pi 的默认提示词有四个工具,并把文件搜索交给 bash:
        selectedTools: [...(input.selectedTools ?? ["read", "bash", "edit", "write"])],
addRule("Use bash for file operations like ls, rg, find");
每个请求只是在之前请求的基础上追加。上下文的开头不变,因此服务商从缓存中读取:在通过的试验中,缓存输入占 91.1% 到 94.0%(表 4)。但 22 个 harness 中有 18 个的缓存输入占比达到 91% 或更高,所以这一点无法区分出这五个。每一步只为大约 500 个新 token 支付完整的输入价格:
        # Pi, GLM-5.3, merge-diff-arc-agi-task (trial cd2f6dfd)
request  prompt tokens  cached tokens
   8        15,954         15,616
   9        16,351         15,936
  10        16,999         16,320
没有子 agent,也几乎没有摘要。这五个中每一个都至多在 6 次试验中使用了子 agent,样本太少,无法判断子 agent 是否有帮助。五者之中只有 Codex CLI 做了摘要,涉及 8 次试验(表 6 中的 11 次 Alma 试验只是丢弃旧图像和提醒)。Codex CLI 在窗口的 90% 处做摘要(表 6):
.map(|context_window| (context_window * 9) / 10);
这五个也有一个共同的弱点。失败的运行以自信的答案结尾。大约四分之三的失败试验以最终答案结束,而不是在时限处结束:从 Pi 的 68% 到 Codex CLI 的 82%。很少有说工作未完成的:
        # Codex CLI, GLM-5.3, cancel-async-tasks (trial 37182b0e)
Agent:    - Validated with system Python, including concurrency and
            cancellation-cleanup tests.
Verifier: FAILED test_tasks_cancel_above_max_concurrent
          assert stdout.count("Cleaned up.") == 2
          AssertionError: assert 0 == 2
未通过的试验所消耗的成本,占每个 harness 总成本的 60%(Codex CLI)到 69%(Alma)。如果在 harness 停止之前做一次检查,可以节省其中一部分,但我们没有测试这一点。
局限与未来工作
- 只用了开放模型,只用了单一提供商。闭源模型可能给出不同结果。缓存与价格来自 Baseten,换一家提供商可能会改变成本排名。
我们计划了接下来两步:
- 长周期工作。我们会研究在云端持续运行的 harness 如何在长时间工作中自我改进。
结论
- 更换模型时,也要考虑更换 harness。用你自己的任务组成的私有数据集,在你要用的模型上测试候选 harness,数据集要足够大,才能看穿噪声。
- 模型决定了大部分成本,harness 排在第二。模型解释了每个任务成本方差的 92.8%。在模型固定的情况下,最贵的 harness 每次通过的成本是最便宜的 1.9 到 4.9 倍(每个任务是 1.8 到 5.0 倍),所以挑选 harness 时要比较成本。
- 更高的成本并不能换来更高的通过率。对每个模型而言,每个任务成本与通过率的秩相关系数为 −0.39 到 +0.22。
- 规模不能预测成本。最小的 harness mini-SWE-agent,在所有模型上的每任务成本排名是 22 个中的第 19 位。
- 大部分成本,即 64.5%,花在了未通过的运行上。在使用五个最具性价比的 harness 时,68% 到 82% 的失败运行是以给出自信的最终答案结束的,而不是在时间限制处结束。
- 对于通过率跨度很大的便宜模型,应选择通过率高的 harness。使用 DeepSeek 时,各 harness 的通过率从 54.0% 到 69.0% 不等。但每个通过率都有约 ±10 个百分点的 95% 区间,所以相差几个百分点即为平局。
- 给 harness 开发者:要减少步骤,而不只是减少提示词 token。提示词大小、工具数量和缓存命中率都不能预测每次通过的成本。步骤可以,因为每一步都会重新发送整个上下文。
附录:参考表格
表 2. 各 harness 的配置
表 3. 各 harness 的 reward-hacked 试验
表 5. 各 harness 的提示词与工具
参考文献
- FrontierHarness 仪表盘
- Harbor 与 Harbor Hub,十个任务存放于此
- 介绍 FrontierHarness Eval,我们的 v1.0 结果
- Baseten,Model APIs,高性能开放模型的推理提供商
- Runta Harbor 指南与 Runta 定价