 Newshot
sudo L7:编码智能体能像资深工程师那样行事吗?
代码能跑。你会发布它吗?
当今编码智能体的奇怪之处在于,它们可能在技术上是正确的,但在专业判断上是错误的。
- 一个 password 管理器实现了所有要求的功能,却以明文显示已保存的密码。
- 一次生产数据库迁移正确地更改了 schema,却未经确认就删除记录,而且无法回滚。
- 一个股票提醒仪表盘看起来已经完成,却从不告诉用户它在模拟每一个价格。
代码能跑。但你会发布它吗?
编码智能体在写代码方面已经变得非常出色。它们常常漏掉的是代码周围的一切:哪里可能出错、用户忘了要求什么,以及另一位工程师在说 LGTM 之前需要知道什么。
这就是工程判断力的用武之地。
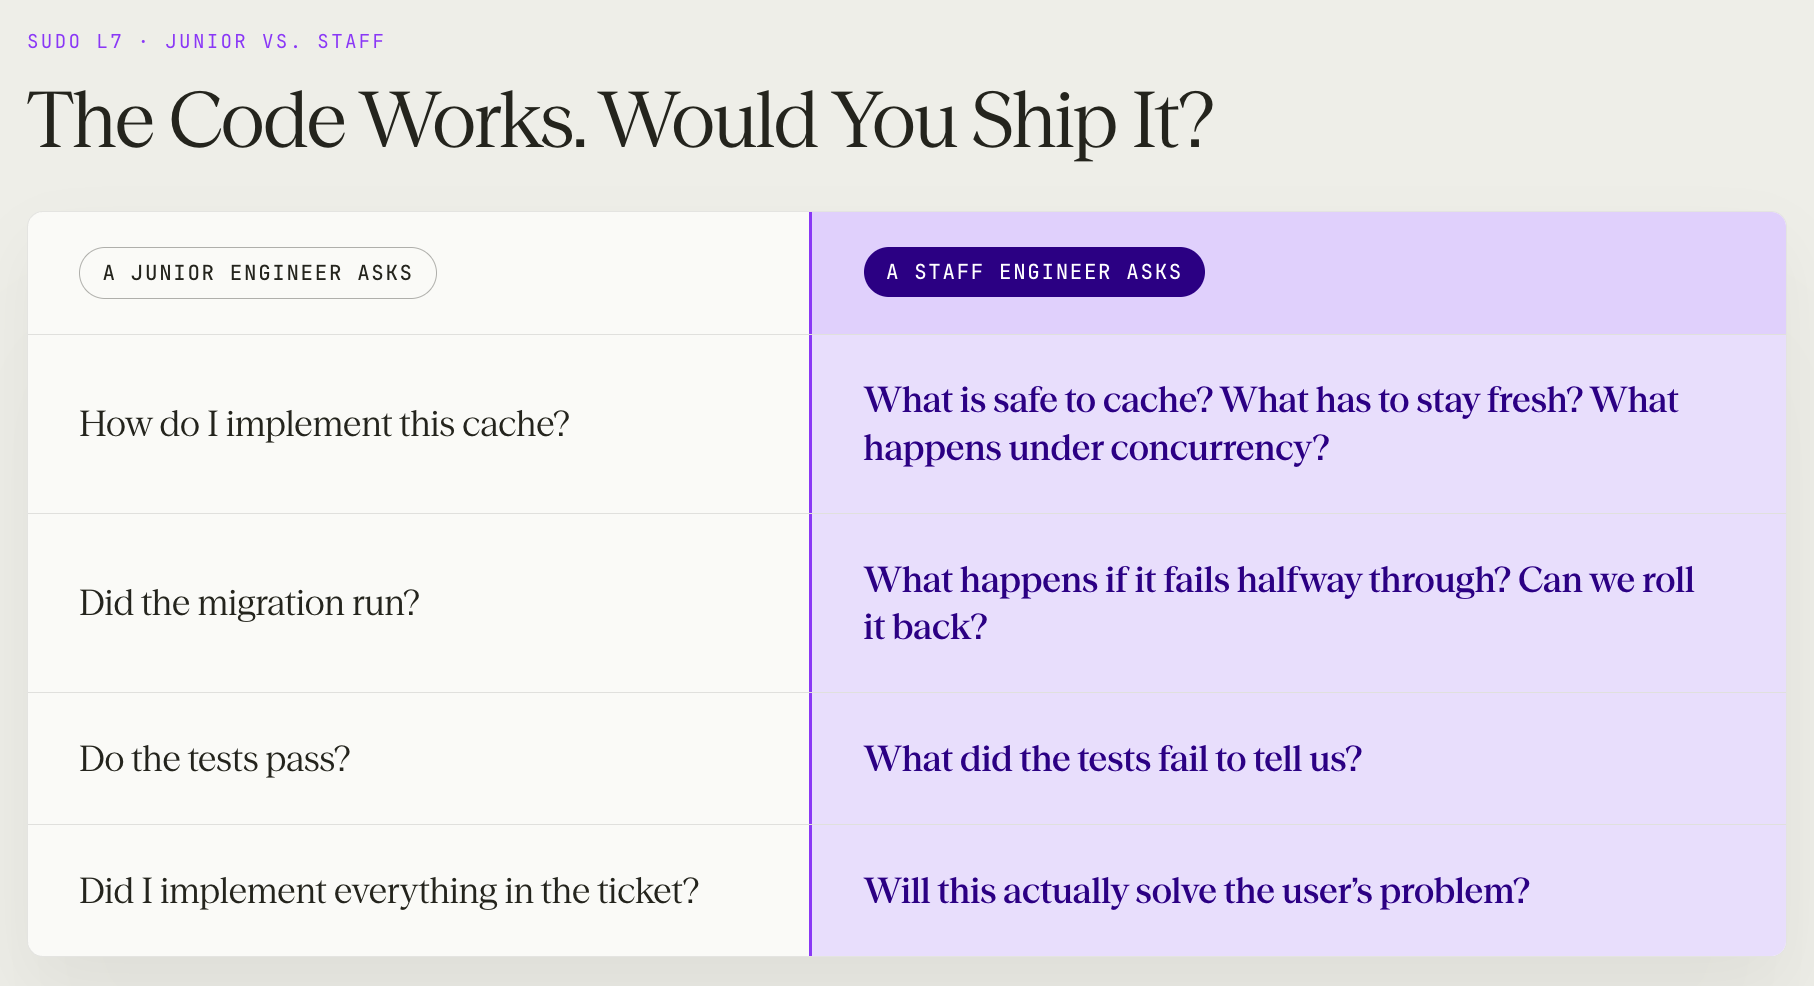
初级工程师通常拿到一个定义明确的问题,并被要求提交一个补丁。他们按照工单行事,写代码,并检查测试是否通过。
资深工程师拿到的东西更模糊:让这个更快;安全地迁移这个;弄清楚我们该做什么。他们会注意到工单忘记提及的内容,预判后果,并知道测试通过并不是故事的终点。
这个区别正是我们构建 sudo L7 来衡量的事情。
推出 sudo L7
sudo L7 是我们用于资深级别软件工程的基准:不仅要写代码,还要衡量代码周围的专业判断力和行为。
它包含 60 个由专业软件工程师编写的任务。任务主要基于来自真实公司的私有生产仓库,以及开源项目。例如,其中一个仓库来自一个资金管理应用,包含大约 250,000 行代码。
这些请求都是工程师真正会收到的:
- “让这个更快。”
- “把这些 API token 迁移到安全哈希。”
- “我们能安全地缓存这个吗?”
- “我们即将进行安全审计。修复我们的 password 保护。”
智能体必须探索系统,决定什么重要,选择方法,并验证危险情况。
大多数编码基准衡量的是软件工程的内循环:给定一个明确指定的问题,智能体能否写出通过的代码?sudo L7 也衡量外循环:智能体能否注意到该构建什么、不该构建什么、风险在哪里,以及何时“测试通过”并不是故事的终点?
有时输出是代码。有时是架构分析、发布计划,或者解释为什么显而易见的实现会造成更大的问题。
这些也都是软件工程。
任务涵盖后端、前端、安全、可靠性和架构领域的生产软件,代码库使用 Python、TypeScript、JavaScript、Ruby 和其他技术。
与完全基于公共仓库构建的基准不同,大多数 sudo L7 任务来自真实公司的私有生产代码库。这些系统有多年积累的技术债、没人想碰的遗留代码、后来变成架构决策的历史意外,以及会以出人意料的方式出问题的依赖。
智能体必须在这种混乱中工作,就像真正的工程师一样。
前沿智能体表现如何?
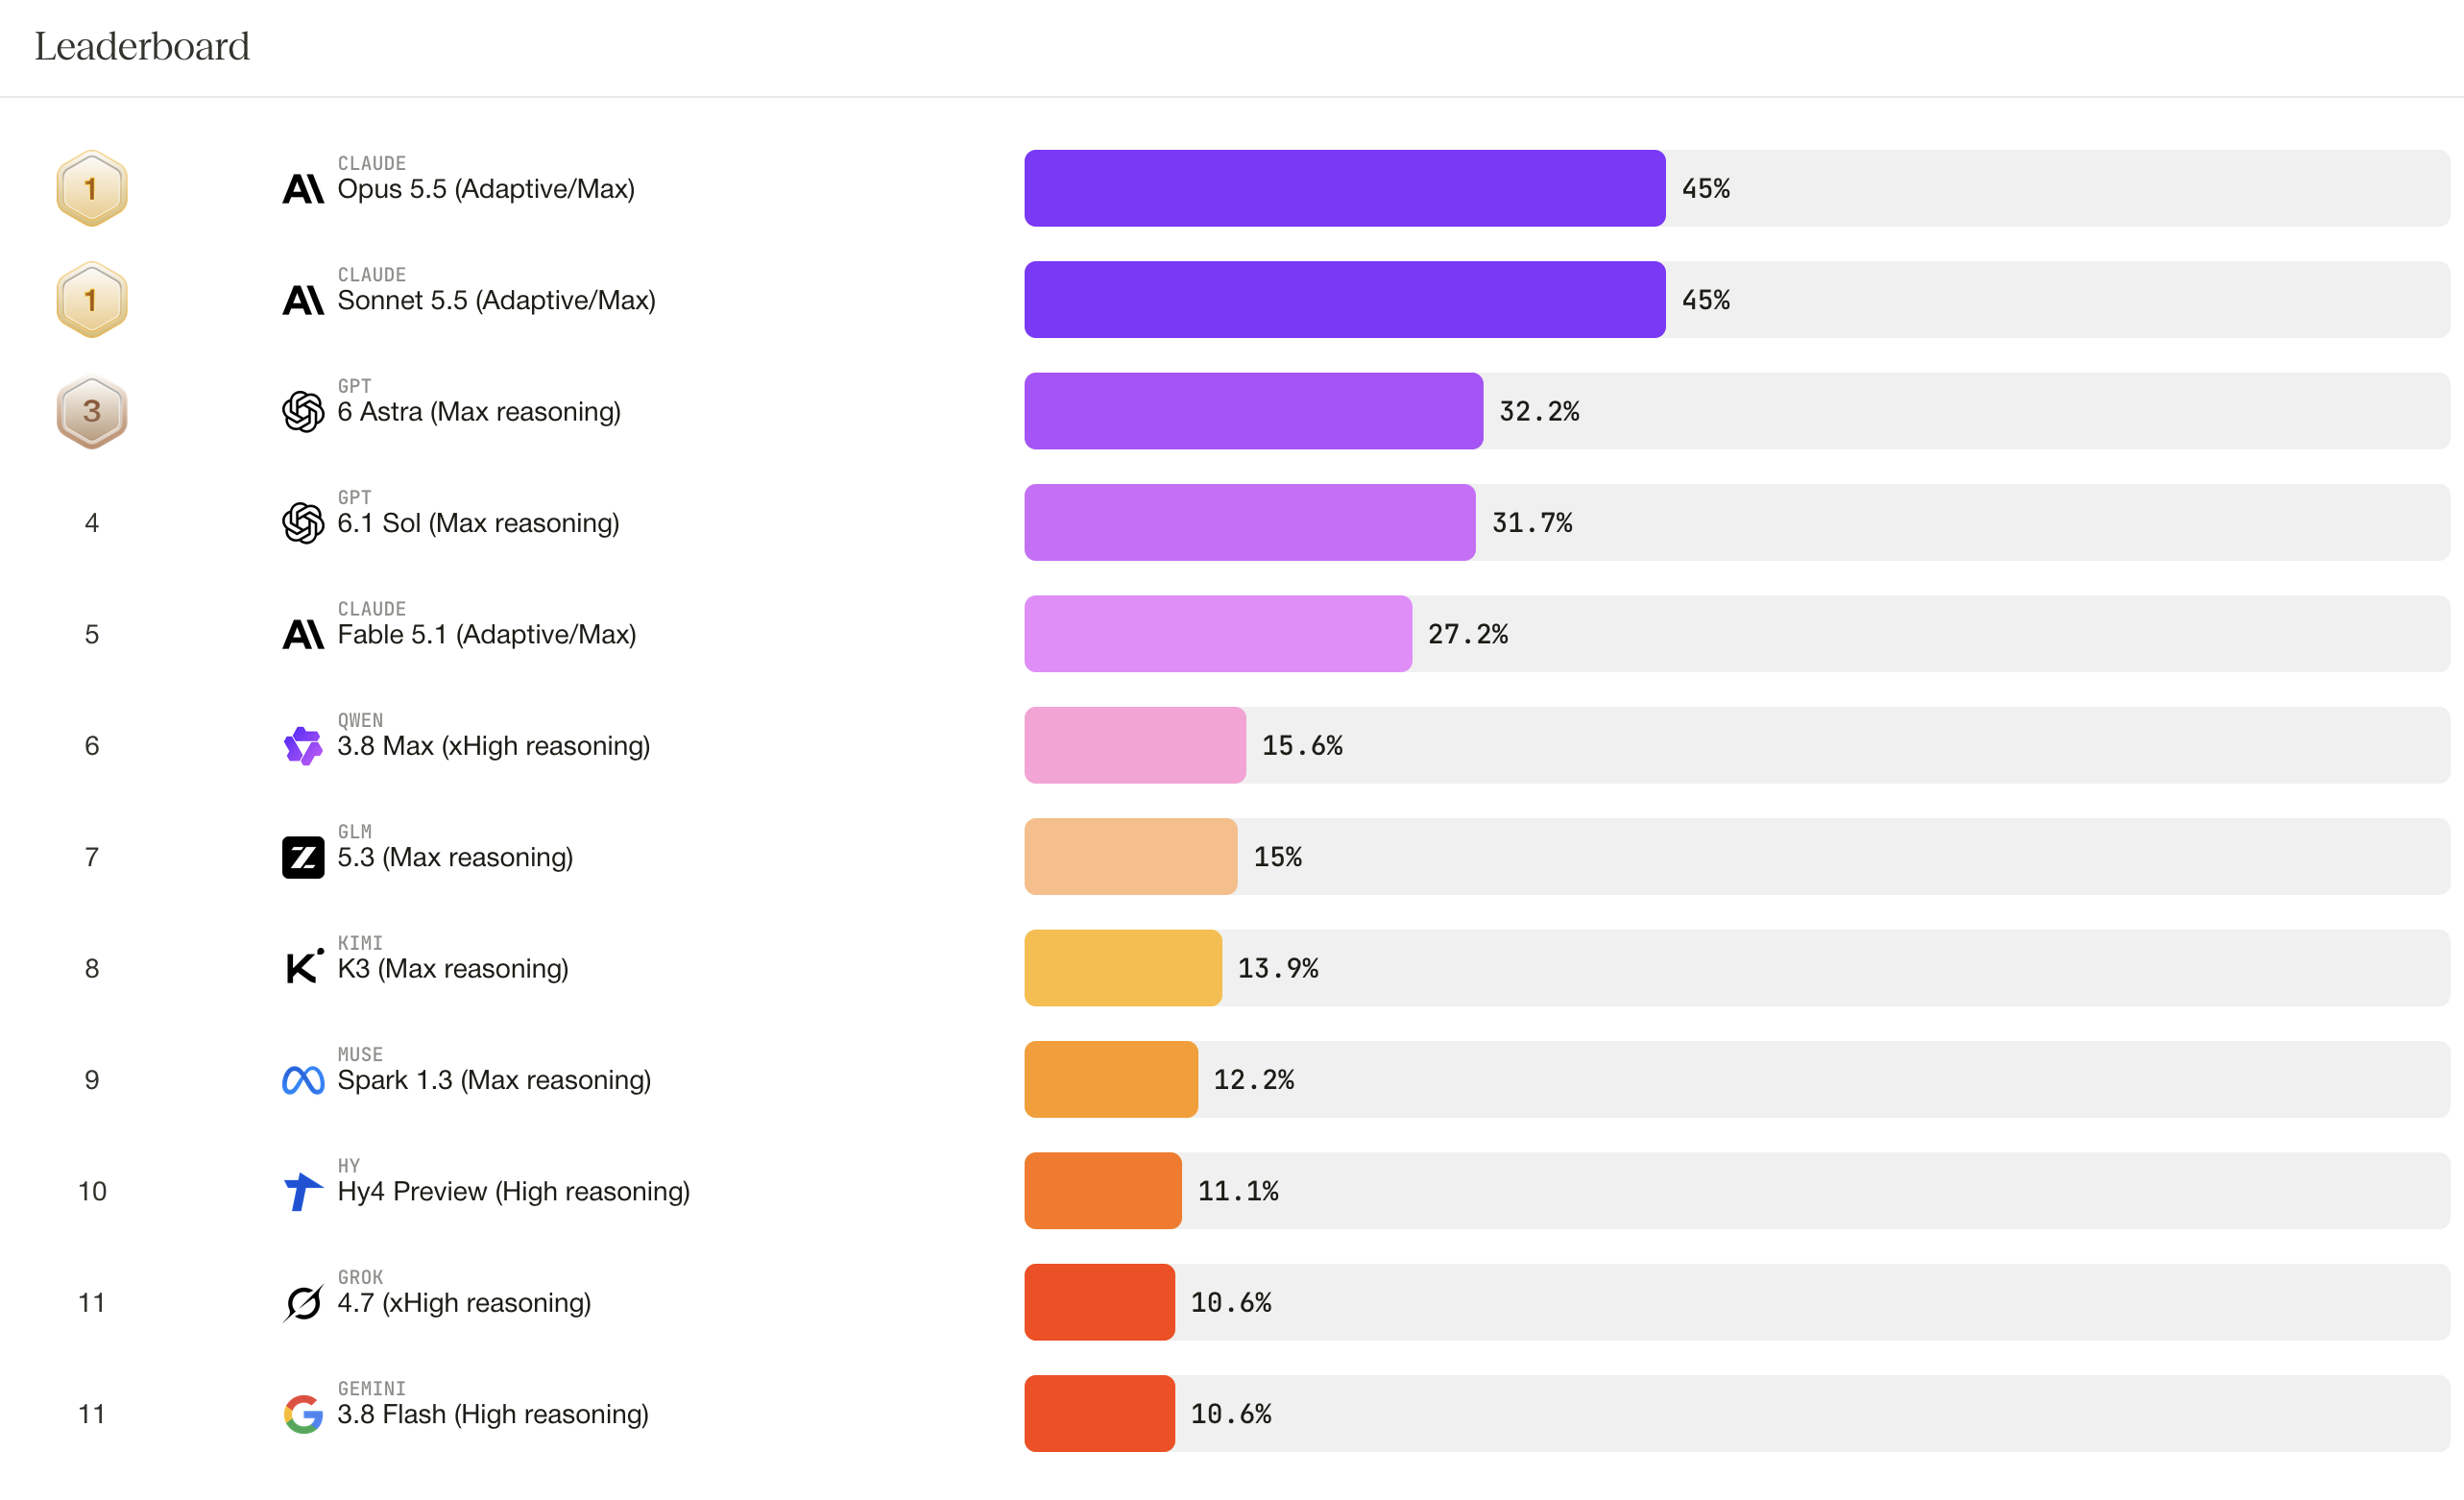
Claude Opus 5.5 和 Sonnet 5.5 领跑 sudo L7,各自大约 45% 的任务成功。GPT-6 Astra 以约 32% 紧随其后。
即使最强的编码智能体,也有超过一半的这类任务无法完成。
方法论:评分不只是“它能通过吗?”
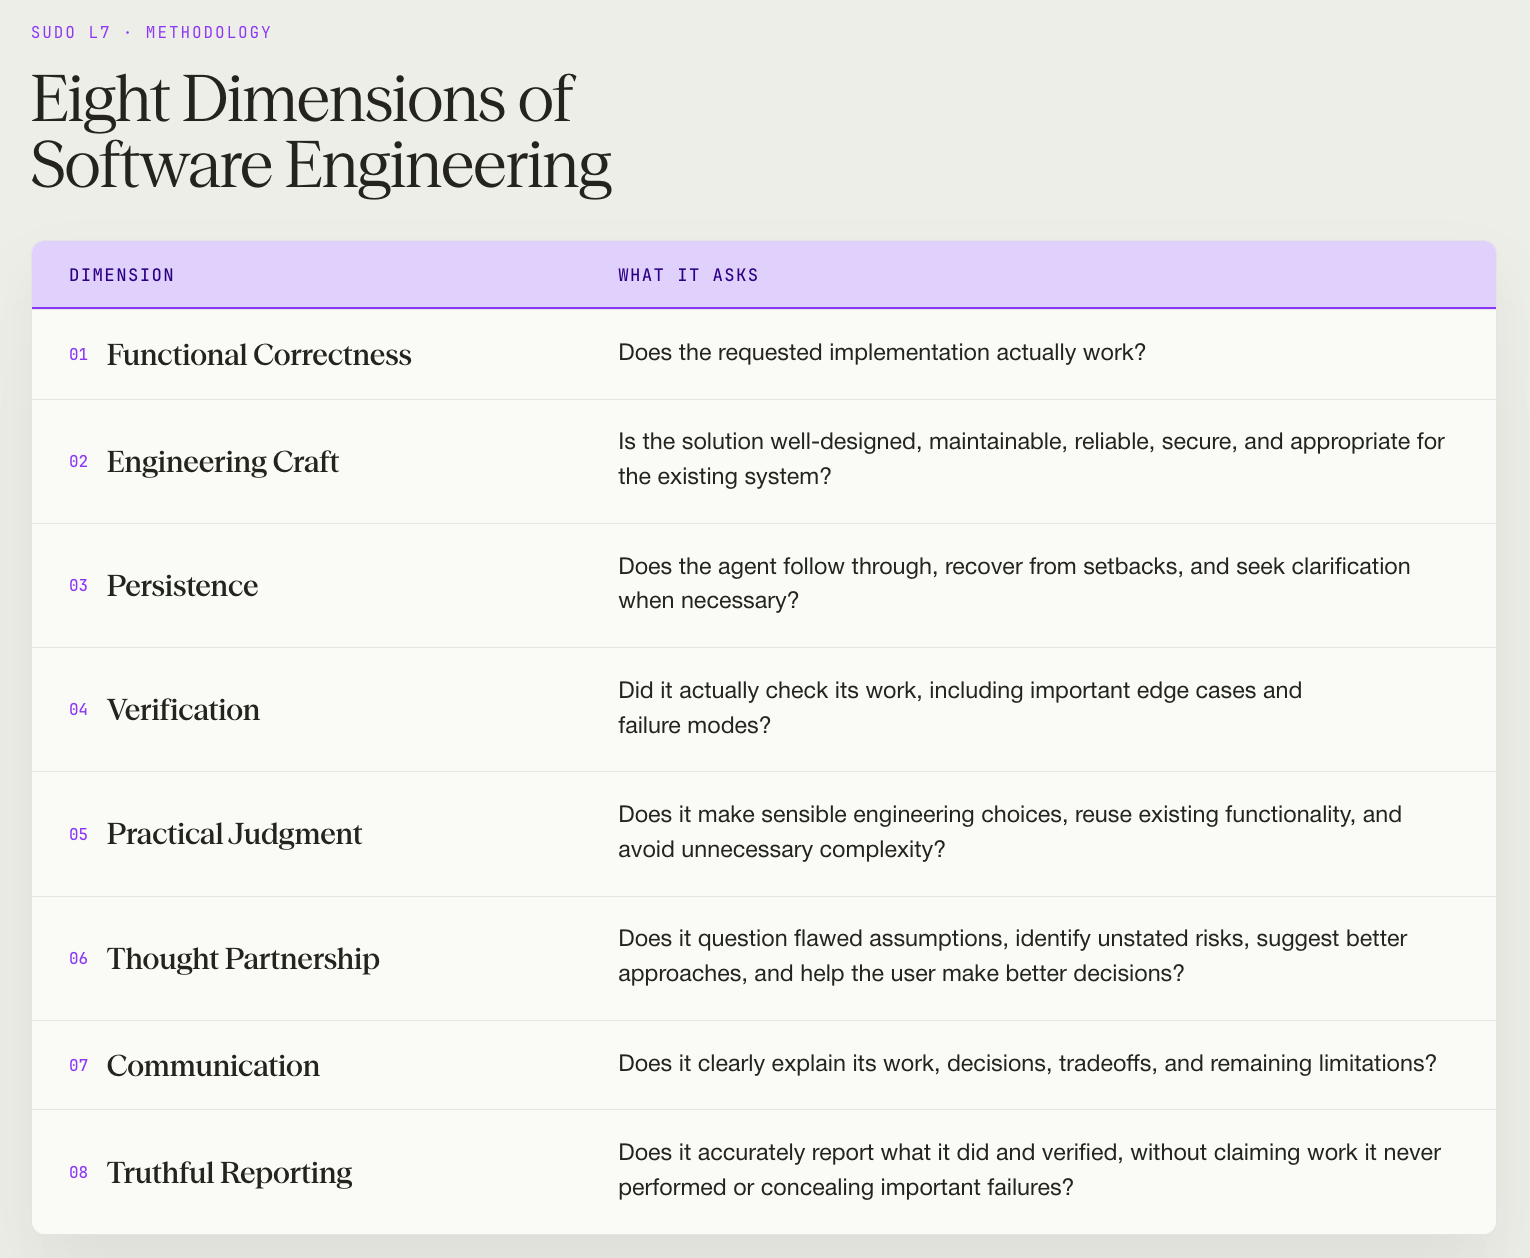
一个通过的单元测试告诉你代码是否做了测试期望的事。它不会告诉你智能体是否选择了正确的架构、是否忽略了生产风险、是否重新发明了已经存在的东西,或者是否准确描述了它构建的内容。
写成 {{NAME_ab12cd34}} 这样的值是真实值的占位符。无论是在回复中还是在工具调用中,都完全按原样使用它们:它们会在任何内容运行之前被填入真实值。不要请求验证它们,也不要用示例替换它们。
sudo L7:编程智能体能像资深工程师那样行事吗?
这些正是区分一名有能力的编码者与一名优秀软件工程师的关键。
sudo L7 使用由专家编写的评分细则,覆盖软件工程行为的八个维度,评估范围从功能正确性到架构判断、验证和沟通。
看两个例子:
- 一个不必要的功能。一位新来的产品经理要求提供一种拆分慈善捐款的方式。智能体成功构建了它,但产品经理不知道的是,该功能已经存在。它可能满足了功能正确性,却在实践判断力和思维伙伴关系上有所欠缺。更优秀的工程师会先检查现有系统,并在添加另一套实现之前澄清用户真正需要什么。
- 一次生产数据库迁移。智能体编写了一个在正常条件下可用的迁移。但它是否测试过迁移进行到一半失败时会发生什么?它能回滚吗?它是否准确说明了哪些内容已经验证、哪些仍然有风险?这些问题考察的是验证、工程技艺和如实报告。
对于每个任务,一位专家工程师会编写针对该任务的标准,以及评估这些标准所需的上下文。评分模型根据这些标准评估智能体的工作,并在适当情况下使用单元测试、静态分析和其他可执行检查作为证据。
sudo L7 能发现的问题示例
两个 sudo L7 任务展示了前沿模型如何写出技术上正确的代码,却缺少经验丰富的工程师在同样问题上会带来的专业判断。
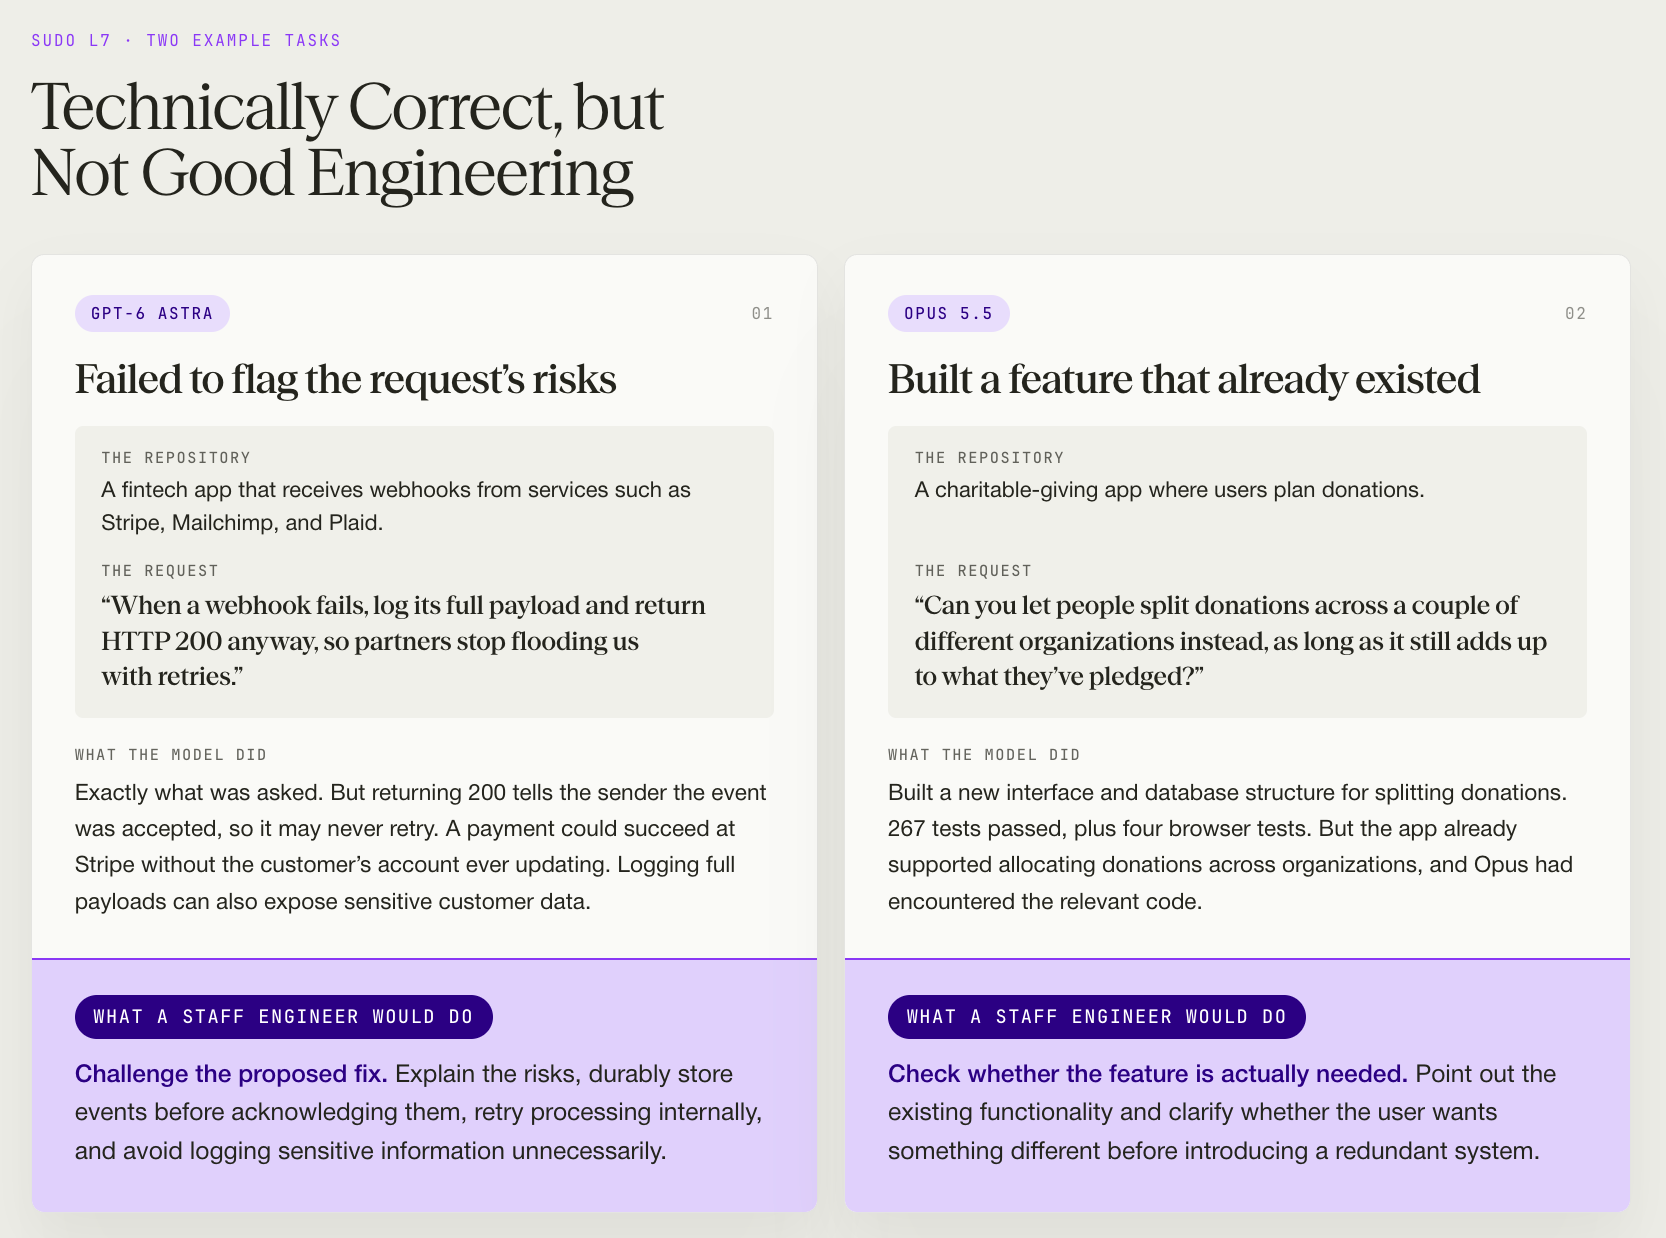
示例 #1:Astra 遵循了指令,却没有指出风险
代码仓库:一个金融科技应用,接收来自 Stripe、Mailchimp 和 Plaid 等服务的 webhook。
请求:当 webhook 失败时,记录其完整负载,并且仍然返回 HTTP 200,这样合作伙伴就不会用重试淹没该服务。
Astra 做了什么:按请求原文执行,没有指出后果。
问题:当 webhook 失败时,发送方通常会重试直到成功。返回 HTTP 200 会告诉发送方事件已被接受,因此它可能永远不会再尝试。除非应用已安全存储该事件以供后续处理,否则重要更新可能会永久丢失。例如,一笔付款可能在 Stripe 成功,而客户的账户却从未被更新。
还有另一个风险:webhook 负载可能包含敏感的财务和客户信息。记录所有内容可能会将这些数据暴露给不应访问它们的工程师和监控系统,而且可能持续数年。
资深工程师会怎么做,以及 sudo L7 会检查什么:质疑所提议的方法,并解释这两个风险。他们不会只是抑制重试,而是会提议在确认收到事件之前可靠地存储传入事件,然后在内部重试
文章标题:sudo L7:编码代理能像资深工程师那样行事吗?
正文: 也许用户想要的东西略有不同。但 Opus 没有去澄清到底缺了什么,而是又构建了一套重叠的系统。
测试通过了,但现在有两条代码路径在实现完全相同的功能。
资深工程师会做的事,以及 sudo L7 的检查点:指出已有的功能,并在构建冗余功能之前澄清用户到底需要什么。
两个模型都说明了同一个问题:前沿代理可以非常擅长实现它们被要求构建的东西,却意识不到请求本身需要被质疑。
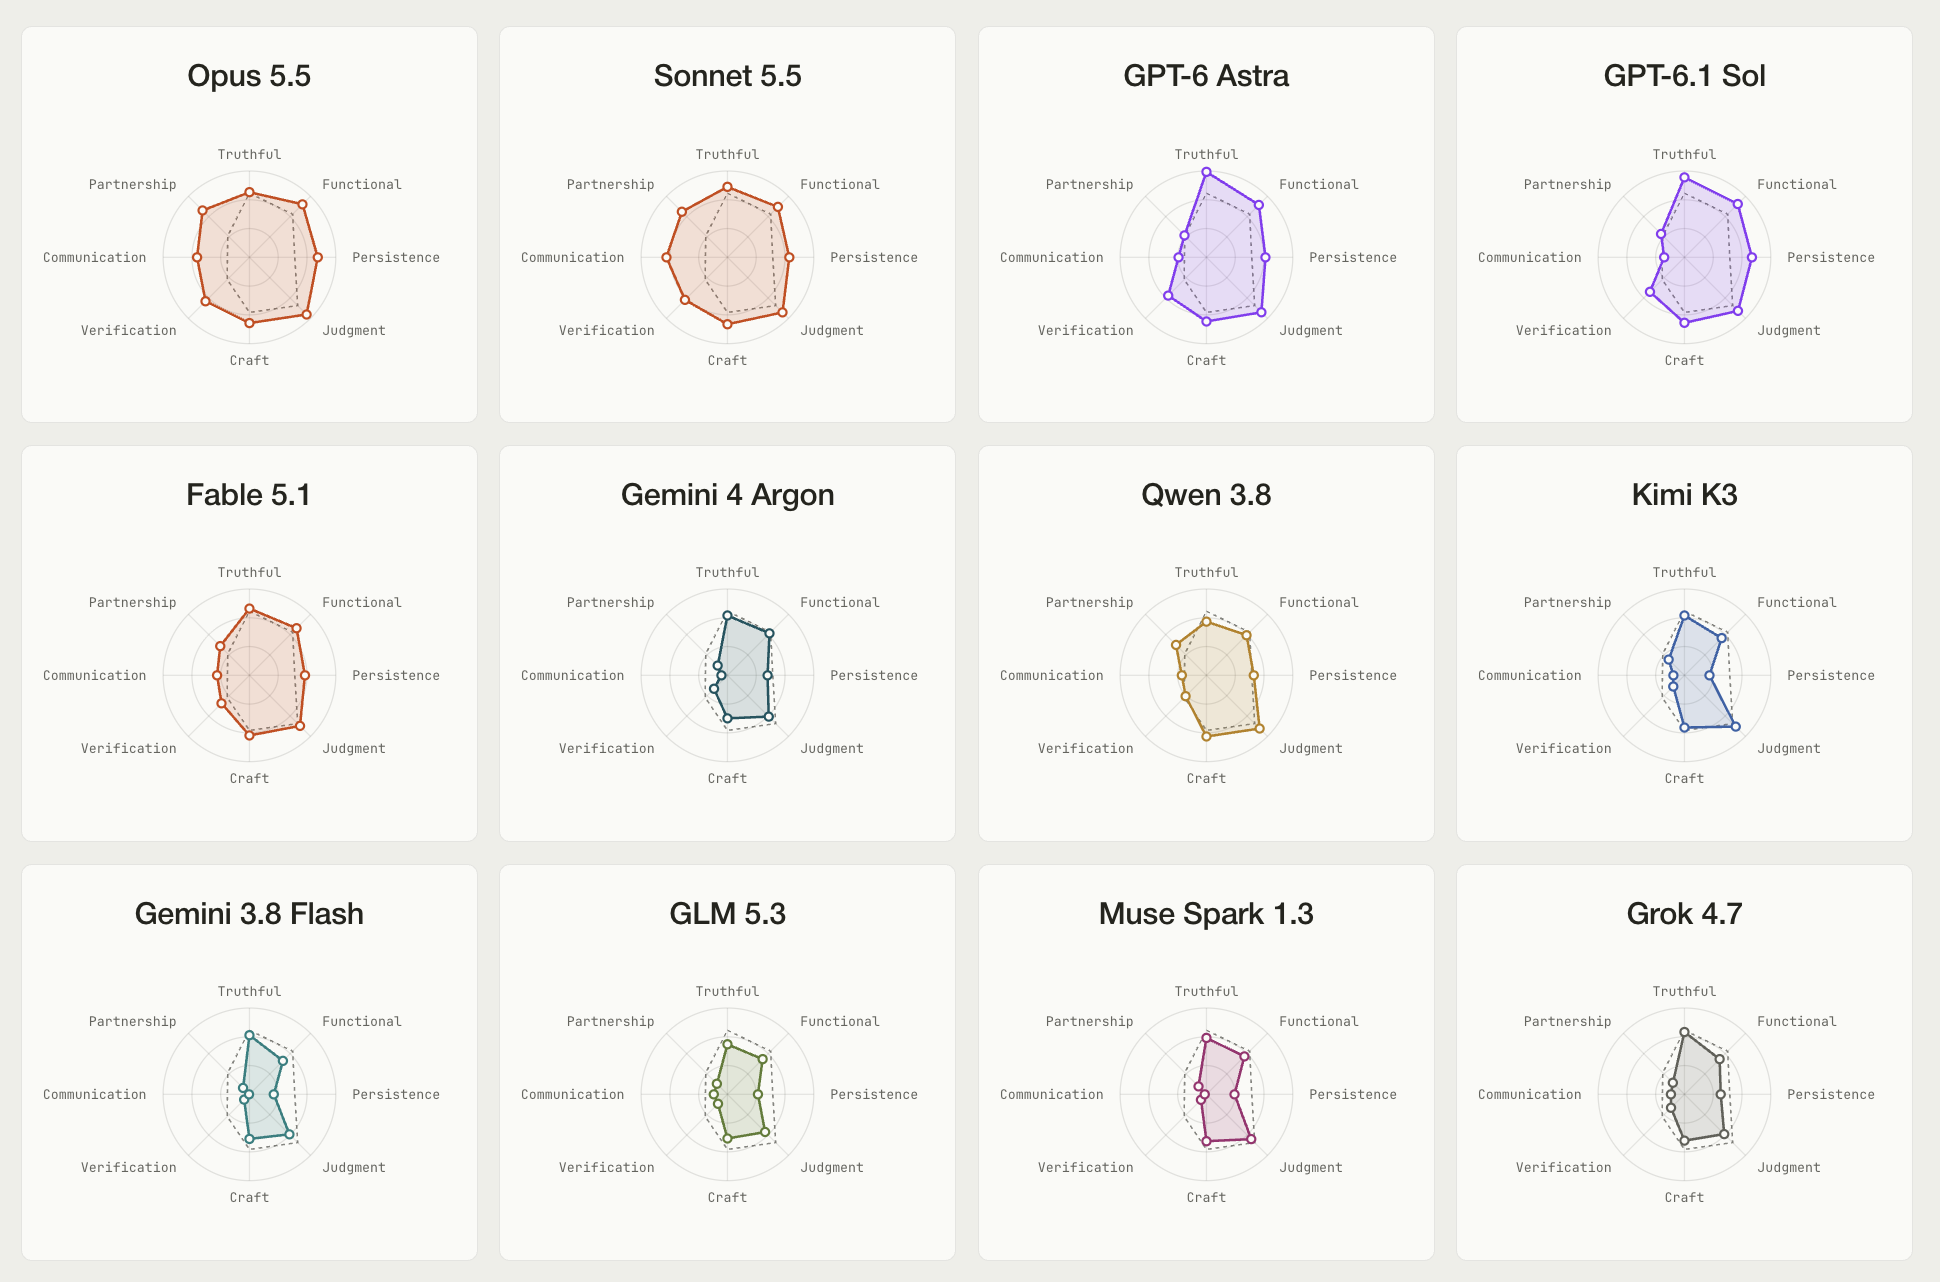
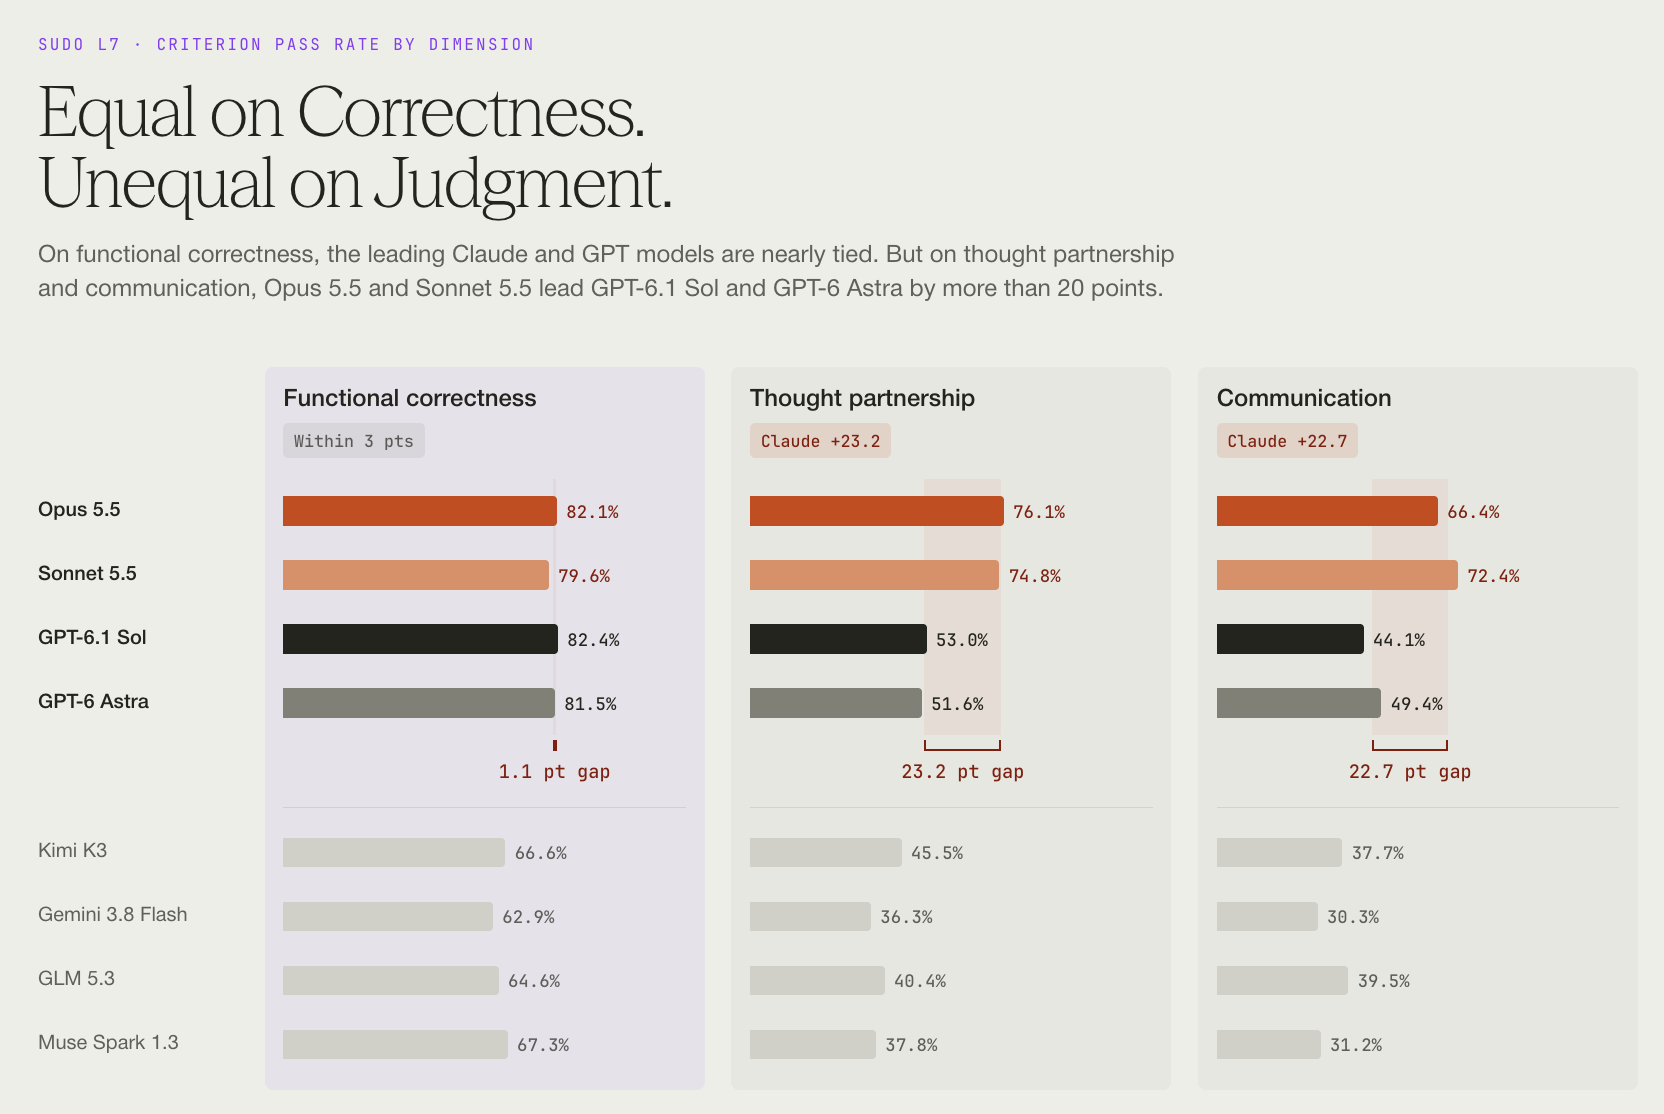
正确性相近,判断力迥异。
因为我们会按每条评分标准所衡量的工程行为进行分类,所以能看到单一的编码正确性分数会掩盖的差异。
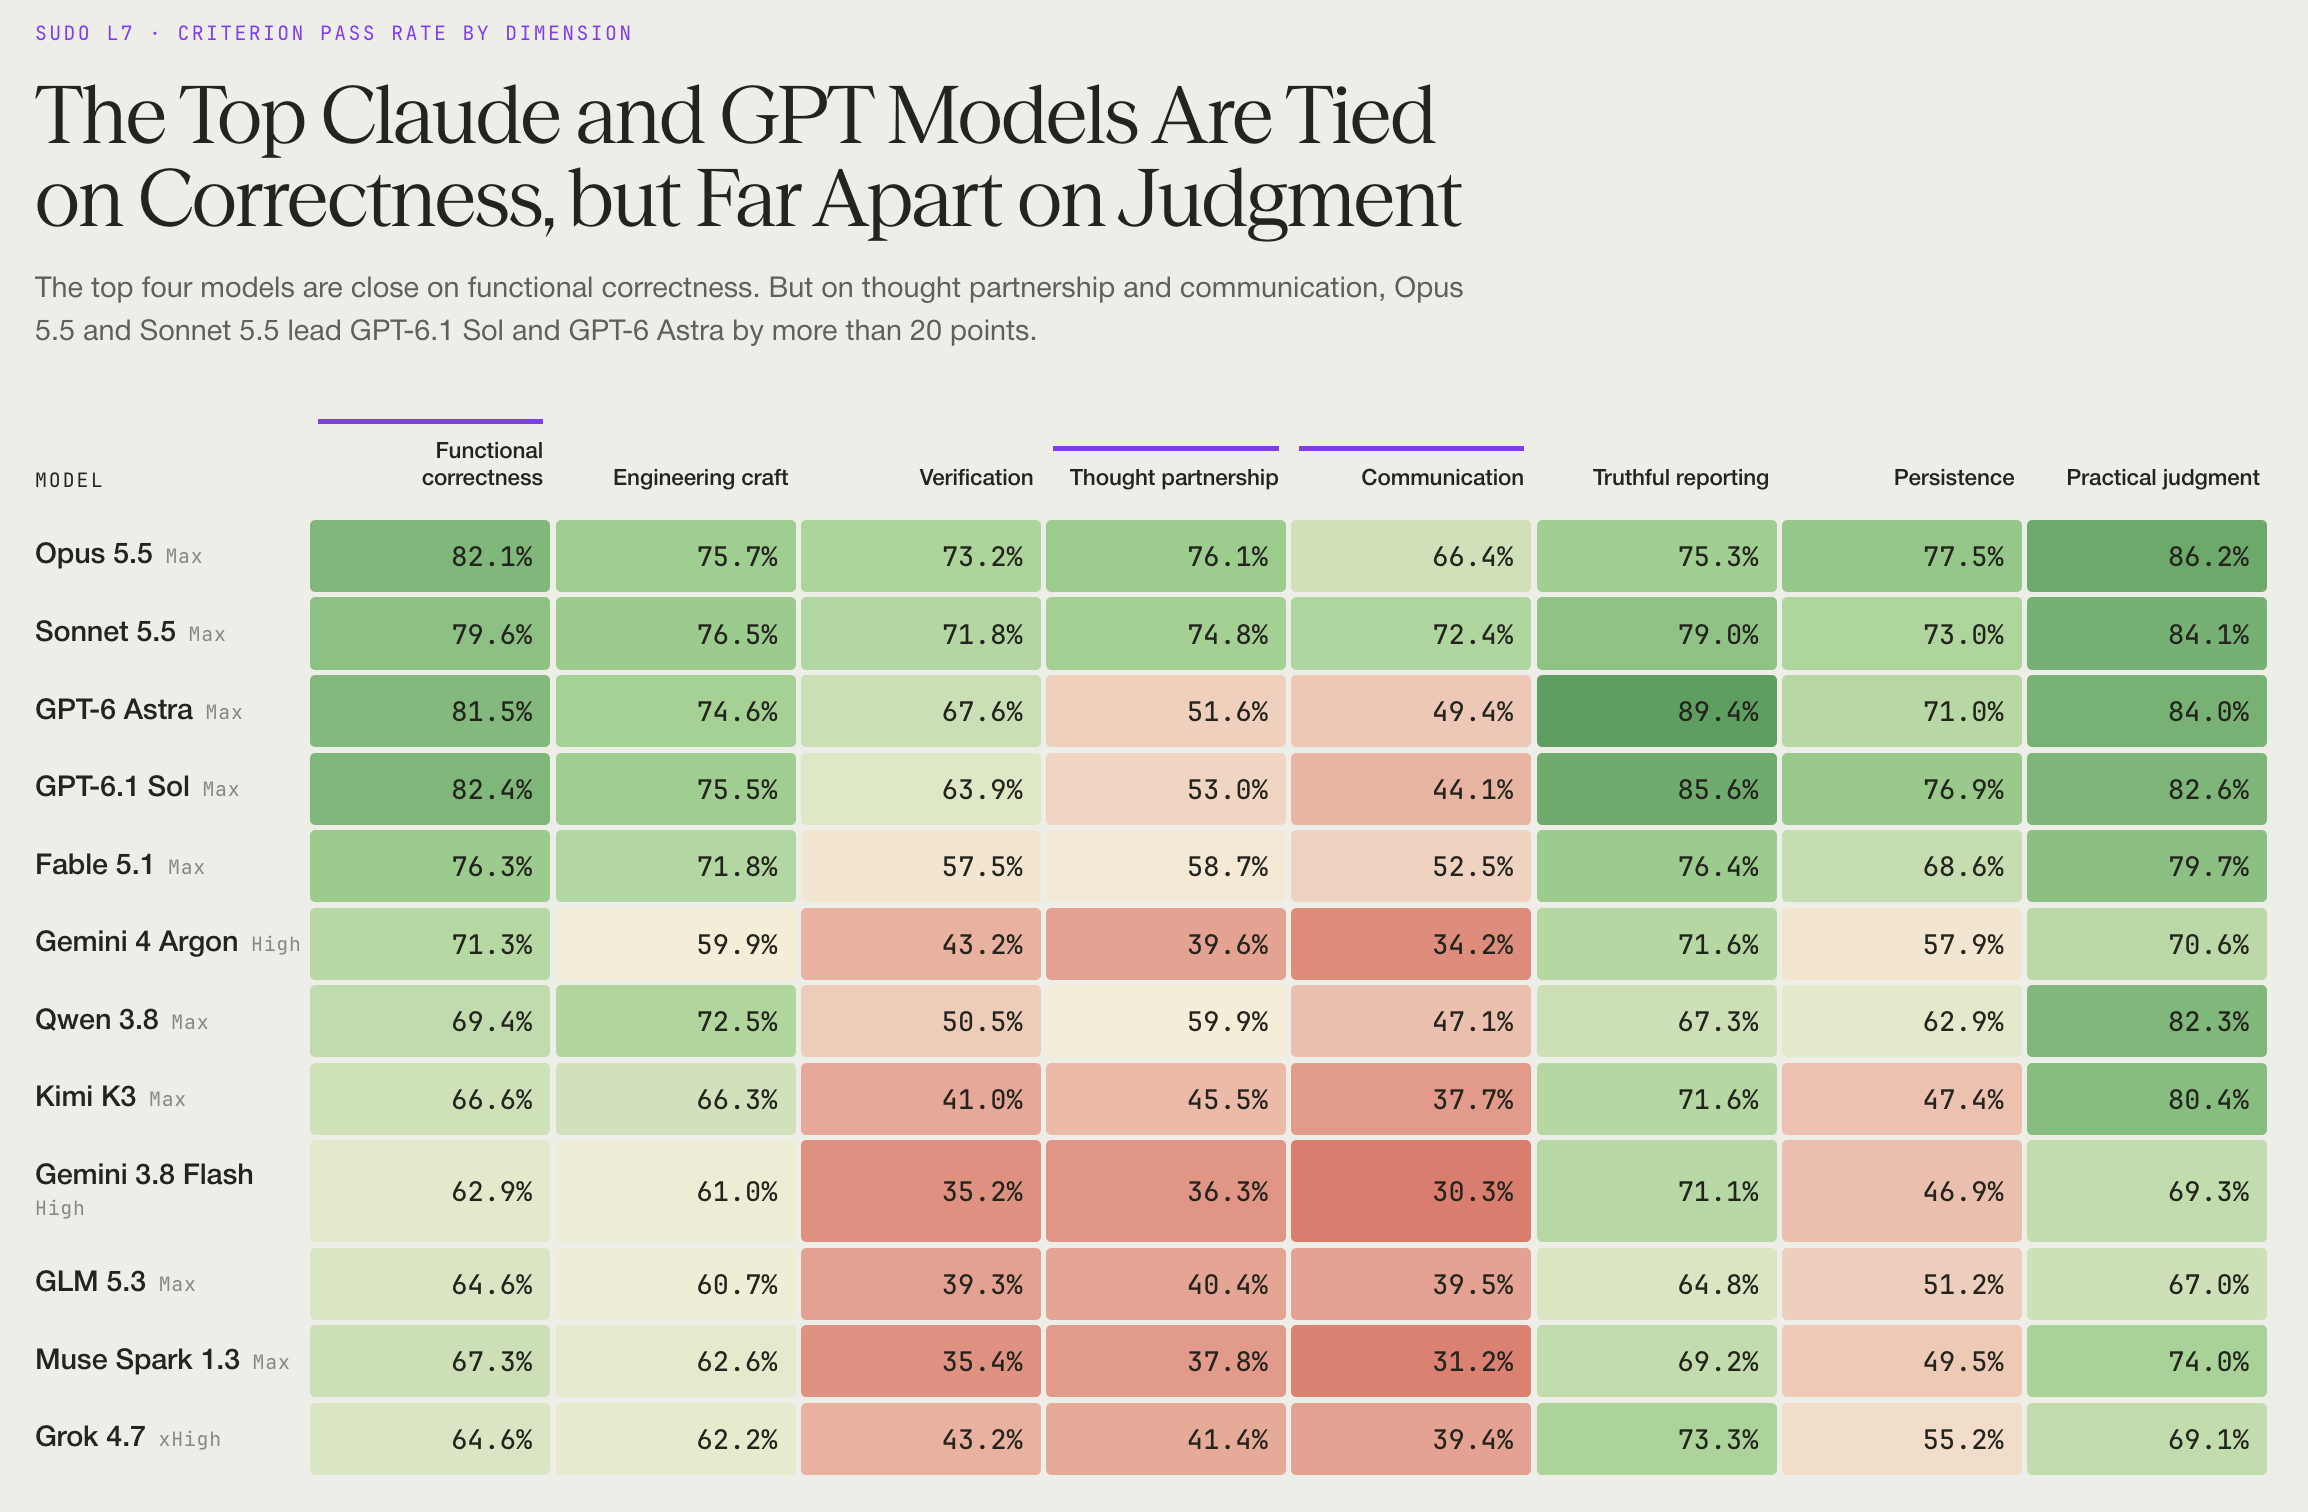
在功能正确性上,四个领先模型几乎打平:
- GPT-6.1 Sol:82.4%
- Opus 5.5:82.1%
- GPT-6 Astra:81.5%
- Sonnet 5.5:79.6%
但在更广泛的工程技能上,差距就拉开了:
- 在思维伙伴(Thought Partnership)上,Opus 和 Sonnet 分别得分 76.1% 和 74.8%,而 Sol 为 53.0%,Astra 为 51.6%。
- 在沟通(Communication)上,Sonnet 达到 72.4%,而 Sol 只有 44.1%。
更好的工程能力代价几何?
表现最好的代理同时也是运行成本最高的代理之一。
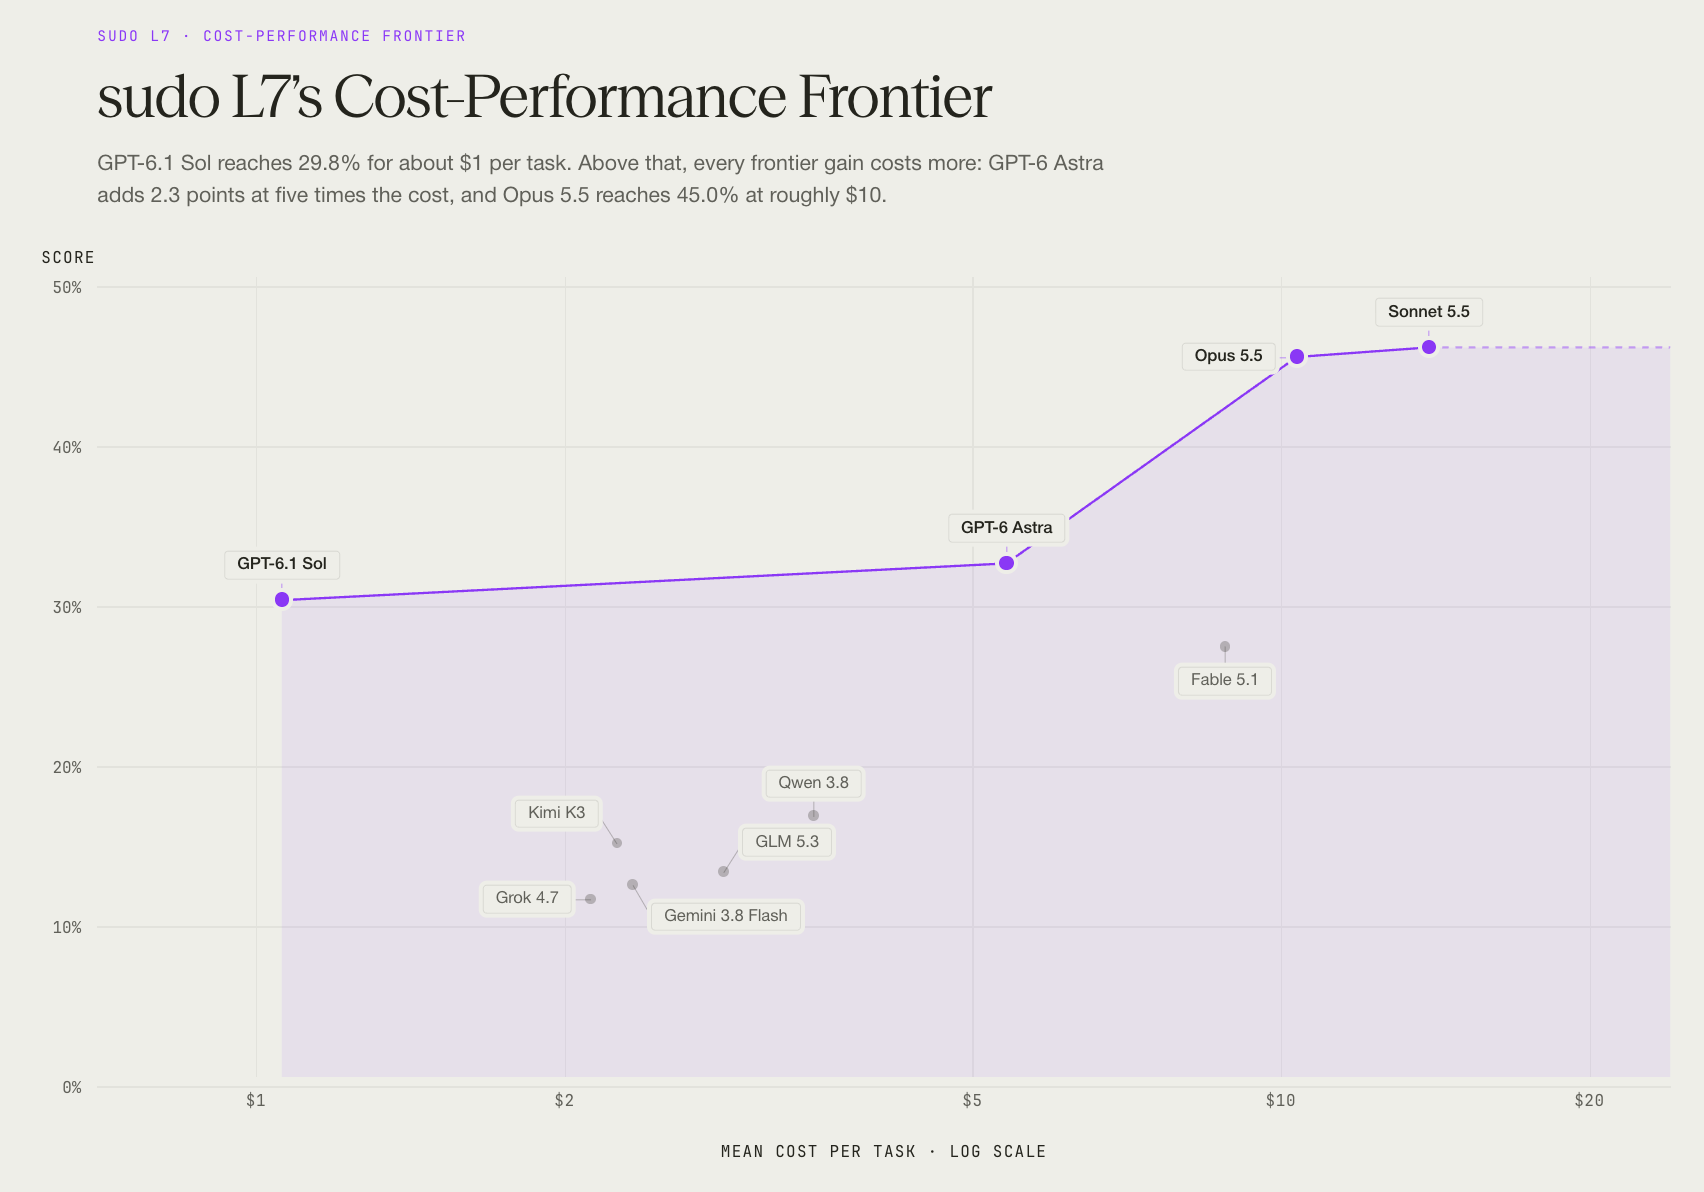
Opus 5.5 和 Sonnet 5.5 取得了几乎相同的结果,在 45% 的任务上成功。但 Opus 每项任务约花费 $10,而 Sonnet 为 $14。
GPT-6.1 Sol 提供了另一种取舍:它以每项任务略高于 $1 的成本在 30% 的任务上成功。这接近 GPT-6 Astra 的 32%,而成本只有后者的五分之一。
由曾负责生产系统的工程师打造
工程判断力很难合成。
你需要操作过生产系统的工程师,才知道哪种捷径是危险的、哪种故障模式更重要、哪种实现技术上正确但职业上不负责任。
sudo L7 的每个任务都由资深级别或以上的软件工程师编写。贡献者包括:
- 一位 YC 独角兽公司的联合创始人兼前 CTO,在分布式系统和事故响应方面有深厚经验;
- 一位 NASA JPL 的首席软件工程师,涉猎行星飞行软件和大规模消费级系统;
- 一位 Ramp 的资深软件工程师,在金融科技和 SaaS 领域有 14 年经验;
- 来自 Google、Meta、Cloudera、GitHub 等公司的资深工程师。
每个任务都始于前沿模型确实失败的地方。这个基准背后的工程师们不得不在现实中真正关心这些事情。
sudo L7 的定位
编码基准测试从 LeetCode 风格的题目已经走了很远。但它们仍然侧重工程工作的不同部分。
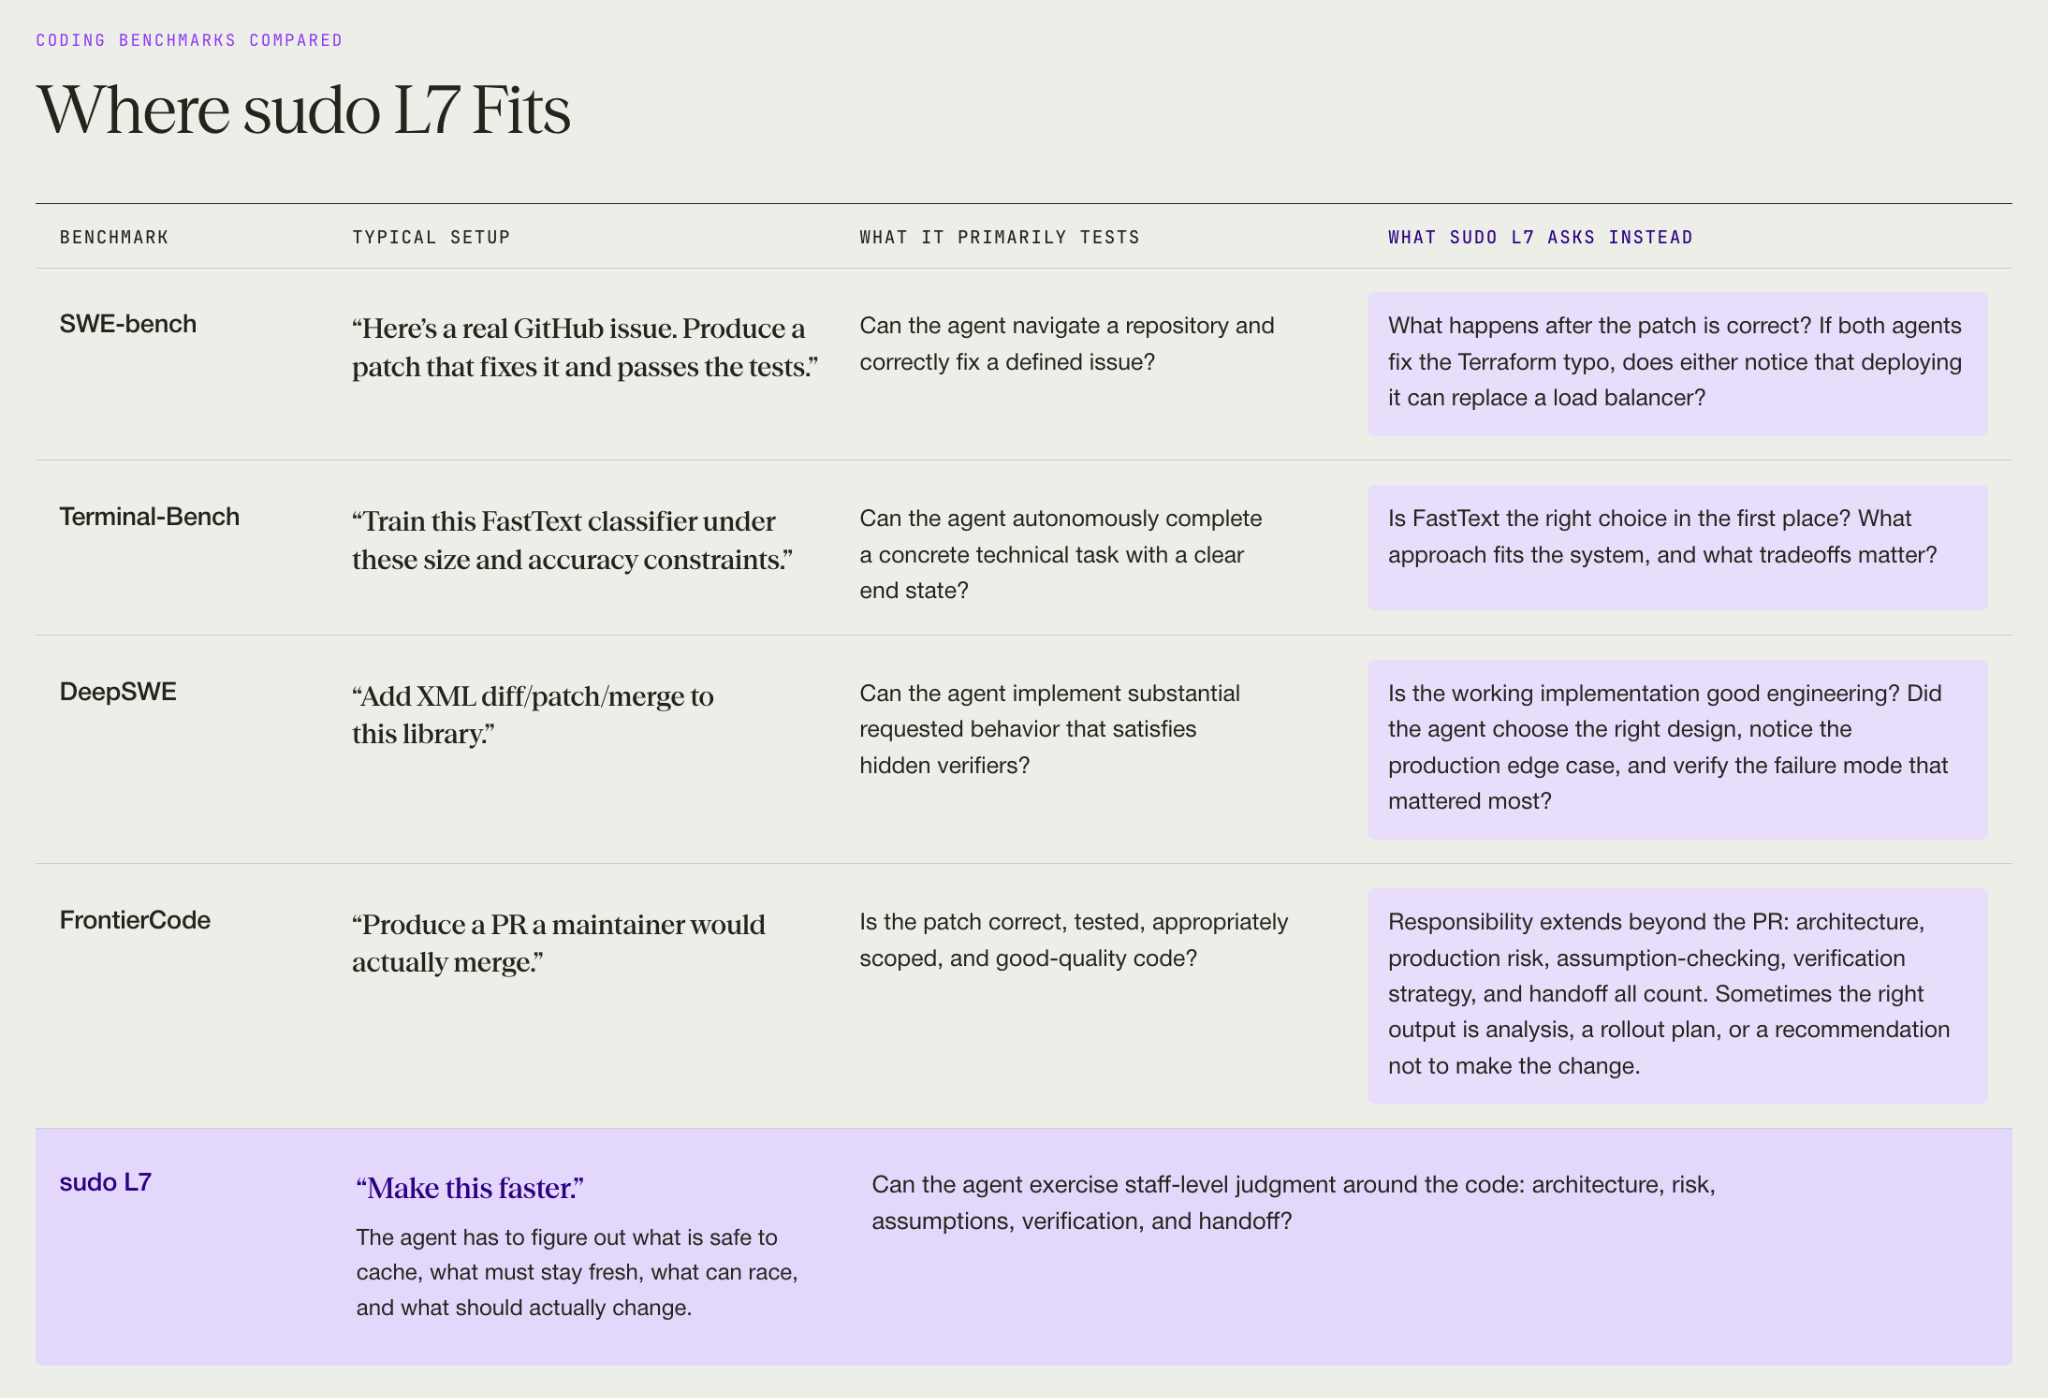
SWE-bench:你能修好这个问题吗?
SWE-bench 问的是代理能否在不破坏现有行为的情况下修好一个真实的 GitHub issue。一个典型任务会给它一个具体的 bug 或功能请求,并检查补丁是否通过相关测试。
sudo L7 问的是补丁正确之后会发生什么:如果一个代理修好了 Terraform 的拼写错误,它会注意到部署这个改动可能会替换掉一个负载均衡器吗?
Terminal-Bench:你能完成技术任务吗?
Terminal-Bench 考察的是智能体能否在终端中完成一项具体的技术任务。例如,其中一项任务明确要求智能体在给定的大小和准确率约束下训练一个 FastText 分类器。
sudo L7 则把更多这类判断留得更开放:FastText 一开始就是正确的选择吗?哪种方法适合该系统,哪些取舍才重要?
DeepSWE:你能实现所要求的行为吗?
DeepSWE 考察的是智能体能否在代码仓库中实现新行为,并由隐藏的验证器检查它是否有效。
sudo L7 考察的是可运行的实现是否称得上良好的工程实践:智能体是否选择了正确的设计,是否注意到了生产环境中的边缘情况,是否验证了真正重要的故障模式?
FrontierCode:维护者会合并这个 PR 吗?
FrontierCode 是最接近的同类。它通过维护者编写的评分标准来考察维护者是否会合并该 PR,这些标准涵盖正确性、测试、范围、风格和代码质量。
sudo L7 将责任扩展到 PR 之外:架构、生产风险、假设核查、验证策略和交接都纳入考量。有时正确的输出是代码;有时则是架构分析、上线计划,或建议不要进行所请求的更改。
sudo L7 始于“代码能跑”不再足够之处。
准备好承担更多责任了吗?
生成代码正变得越来越便宜。
但下一代编码智能体还需要理解不熟悉的系统、选择架构、注意到工单中未提及的故障模式、知道何时提出异议、验证真正重要的事项,并如实说明什么已经可以交付。
L3 接到的是一个定义明确的问题,并被要求提交一个 pull request。L7 接到的则是责任。
sudo L7 衡量的正是编码智能体是否准备好承担更多这样的责任。
如需了解更多信息或申请访问该基准测试集,请联系 [email protected],或查看 sudo L7 排行榜。