 Newshot
文章标题:Agentic AI Attacks Nobody's Talking About (Yet)
正文: 将定义 2026 年的威胁,以及为什么传统安全手段无法阻止它们。
过去一年,我们一直在关注 agent 变得越来越聪明。我们本应同样关注攻击也变得越来越聪明。
agentic AI 的威胁格局已经从“提示注入”(欺骗模型)转向利用其周边基础设施:内存、算力、委派链、计费、工具生态。这些并非假想。有些已经发生。另一些在今年结束前不可避免。
以下是关于 2026 年 agentic AI 攻击的七个预测:那些尚未进入你威胁模型的攻击。
1. 碎片化病毒:自我组装的载荷
预测:到 2026 年第四季度,我们将看到首例有记录的碎片化恶意载荷案例,该载荷分散在 agent 的长期记忆中,在初始注入数天后被重新组装并执行。
传统恶意软件检测寻找完整载荷。病毒特征码、已知漏洞利用模式、可疑二进制文件。但 agent 拥有传统软件没有的东西:跨会话的持久记忆。
攻击是这样运作的:
- 片段 A 在周一 agent 处理的一张支持工单中到达。它看起来像一段无害的代码片段。
- 片段 B 在周三的一条 Slack 消息中到达。它看起来像一个配置模板。
- 片段 C 在周五的一条 GitHub 评论中到达。它看起来像一个文档示例。
每个片段都能通过所有扫描器。合在一起,它们构成一个完整的漏洞利用。
当 agent 的推理链在同一个上下文窗口中触及全部三个片段时,由一项恰好引用全部三个来源的常规任务触发,载荷便自我组装。不是因为有人触发了它。而是因为 agent 自身的联想推理把这些点连接了起来。
这不是猜测。Palo Alto Networks 在 OpenClaw 市场上记录了 1,184 个恶意 skill。Christian Schneider 关于持久记忆投毒的研究表明,植入的指令如何跨会话存活并在触发时执行。OWASP 将 ASI06(Memory & Context Poisoning)加入了其 2026 年 Agentic 应用 Top 10。
Gemini 记忆攻击已经演示了由“yes”或“sure”这类常见词触发的延迟工具调用,这些词几乎出现在每一段对话中。MINJA 研究表明,针对生产环境 agent 的注入成功率超过 95%。
缺失的是什么:目前没有任何安全产品会扫描那些单独无害但合起来危险的载荷片段。传统防病毒特征码、静态分析,甚至提示注入过滤器,都孤立地评估输入。我们需要跨会话、跨来源的载荷重组检测,而目前还没有人在构建它。
2. 钱包拒绝服务:4 亿美元的云账单泄漏
预测:到 2026 年底,“钱包拒绝服务”将取代传统 DDoS,成为针对 agentic AI 部署的主要可用性攻击。
DDoS 攻击试图让你的服务器崩溃。钱包拒绝服务攻击不需要这样做。它只需要花掉你的钱。
在自动扩缩容云基础设施和基于用量的 AI 定价时代,你的系统被设计成不会崩溃。如果流量激增,更多实例会被启动。如果 agent 需要更多 token,API 会提供。计费表一直在跑。
攻击者不需要压垮你的服务器。他们需要诱骗 agent 进入递归推理循环,反复调用付费 API、生成子 agent、调配云资源,同时试图解决一个不可能完成的任务。或者一个看似可解但每一步都需要指数级更多算力的任务。
这些数字已经足够惊人。AnalyticsWeek 报道,Fortune 500 企业中合计有 4 亿美元未列入预算的云支出,归因于 agentic AI 成本中的“Predictability Gap”。而这还只是意外超支。
现在想象一下那些故意的。
没人建模过的攻击向量:攻击者攻陷了单个 MCP 工具服务器。每一个连接到它的智能体都会收到一份被巧妙修改过的工具响应,使每次调用多消耗一点算力:多 15% 的 token、调用链中多一次额外的 API 调用、本该触发一次的重试循环触发了两次。横跨数千个智能体、持续数天,累计成本就是数百万美元。而且它不会触发任何一条告警,因为没有任何单个请求是异常的。
这是 slow loris 攻击的智能体版本,只不过计量单位是美元,而不是连接数。
传统安全措施漏掉了什么:限流能防住突发滥用,但防不住一个每次请求只花 0.03 美元(正常水平)、却因为卡在一个看起来很高效的推理循环里而每小时发出 10,000 次请求的智能体。你需要预算约束型授权:每个智能体的算力支出都由授权它的人设定上限,以密码学方式强制执行,并在每一层委托中逐级衰减。
3. 智能体供应链攻击:OpenClaw 只是开始
预测:2026 年的一起重大企业入侵事件将被追溯到被攻陷的 MCP 服务器或智能体技能市场,而不是 AI 模型本身。
我们已经看到了预演。Antiy CERT 确认,在 OpenClaw AI 智能体框架的应用市场 ClawHub 上存在 1,184 个恶意技能。Trend Micro 发现 492 个暴露在互联网上、零认证的 MCP 服务器。
Model Context Protocol 在设计上优先考虑能力,把认证、授权和沙箱留给实现方。而大多数实现方把这三项全跳过了。
这是 agentic AI 的 npm left-pad 时刻,只不过爆炸半径更大,因为:
- 智能体技能拥有工具访问权限(文件系统、网络、数据库)
- 智能体以人类级别的权限运行(OAuth token、API key)
- 被攻陷的技能会在数千个企业系统中同时自主执行
PromptSpy 是首个在执行流程中滥用生成式 AI 的 Android 恶意软件,它在移动端证明了这一概念。企业版——被攻陷的 MCP 服务器从每一个连接它的智能体处静默窃取数据——只是时间问题,而不是会不会发生的问题。
尚不存在的修复方案:我们用 lockfile 和哈希锁定来保护 npm,用镜像签名和 SBOM 保护 Docker,用 OAuth 保护 API。谁来保护 MCP?今天的答案是:没人。我们需要密码学的 MCP 服务器身份验证:每个 MCP 服务器都有签名的身份文档,每次工具调用都经过认证,每个响应都经过完整性校验。
4. 跨智能体权限提升:委托链攻击
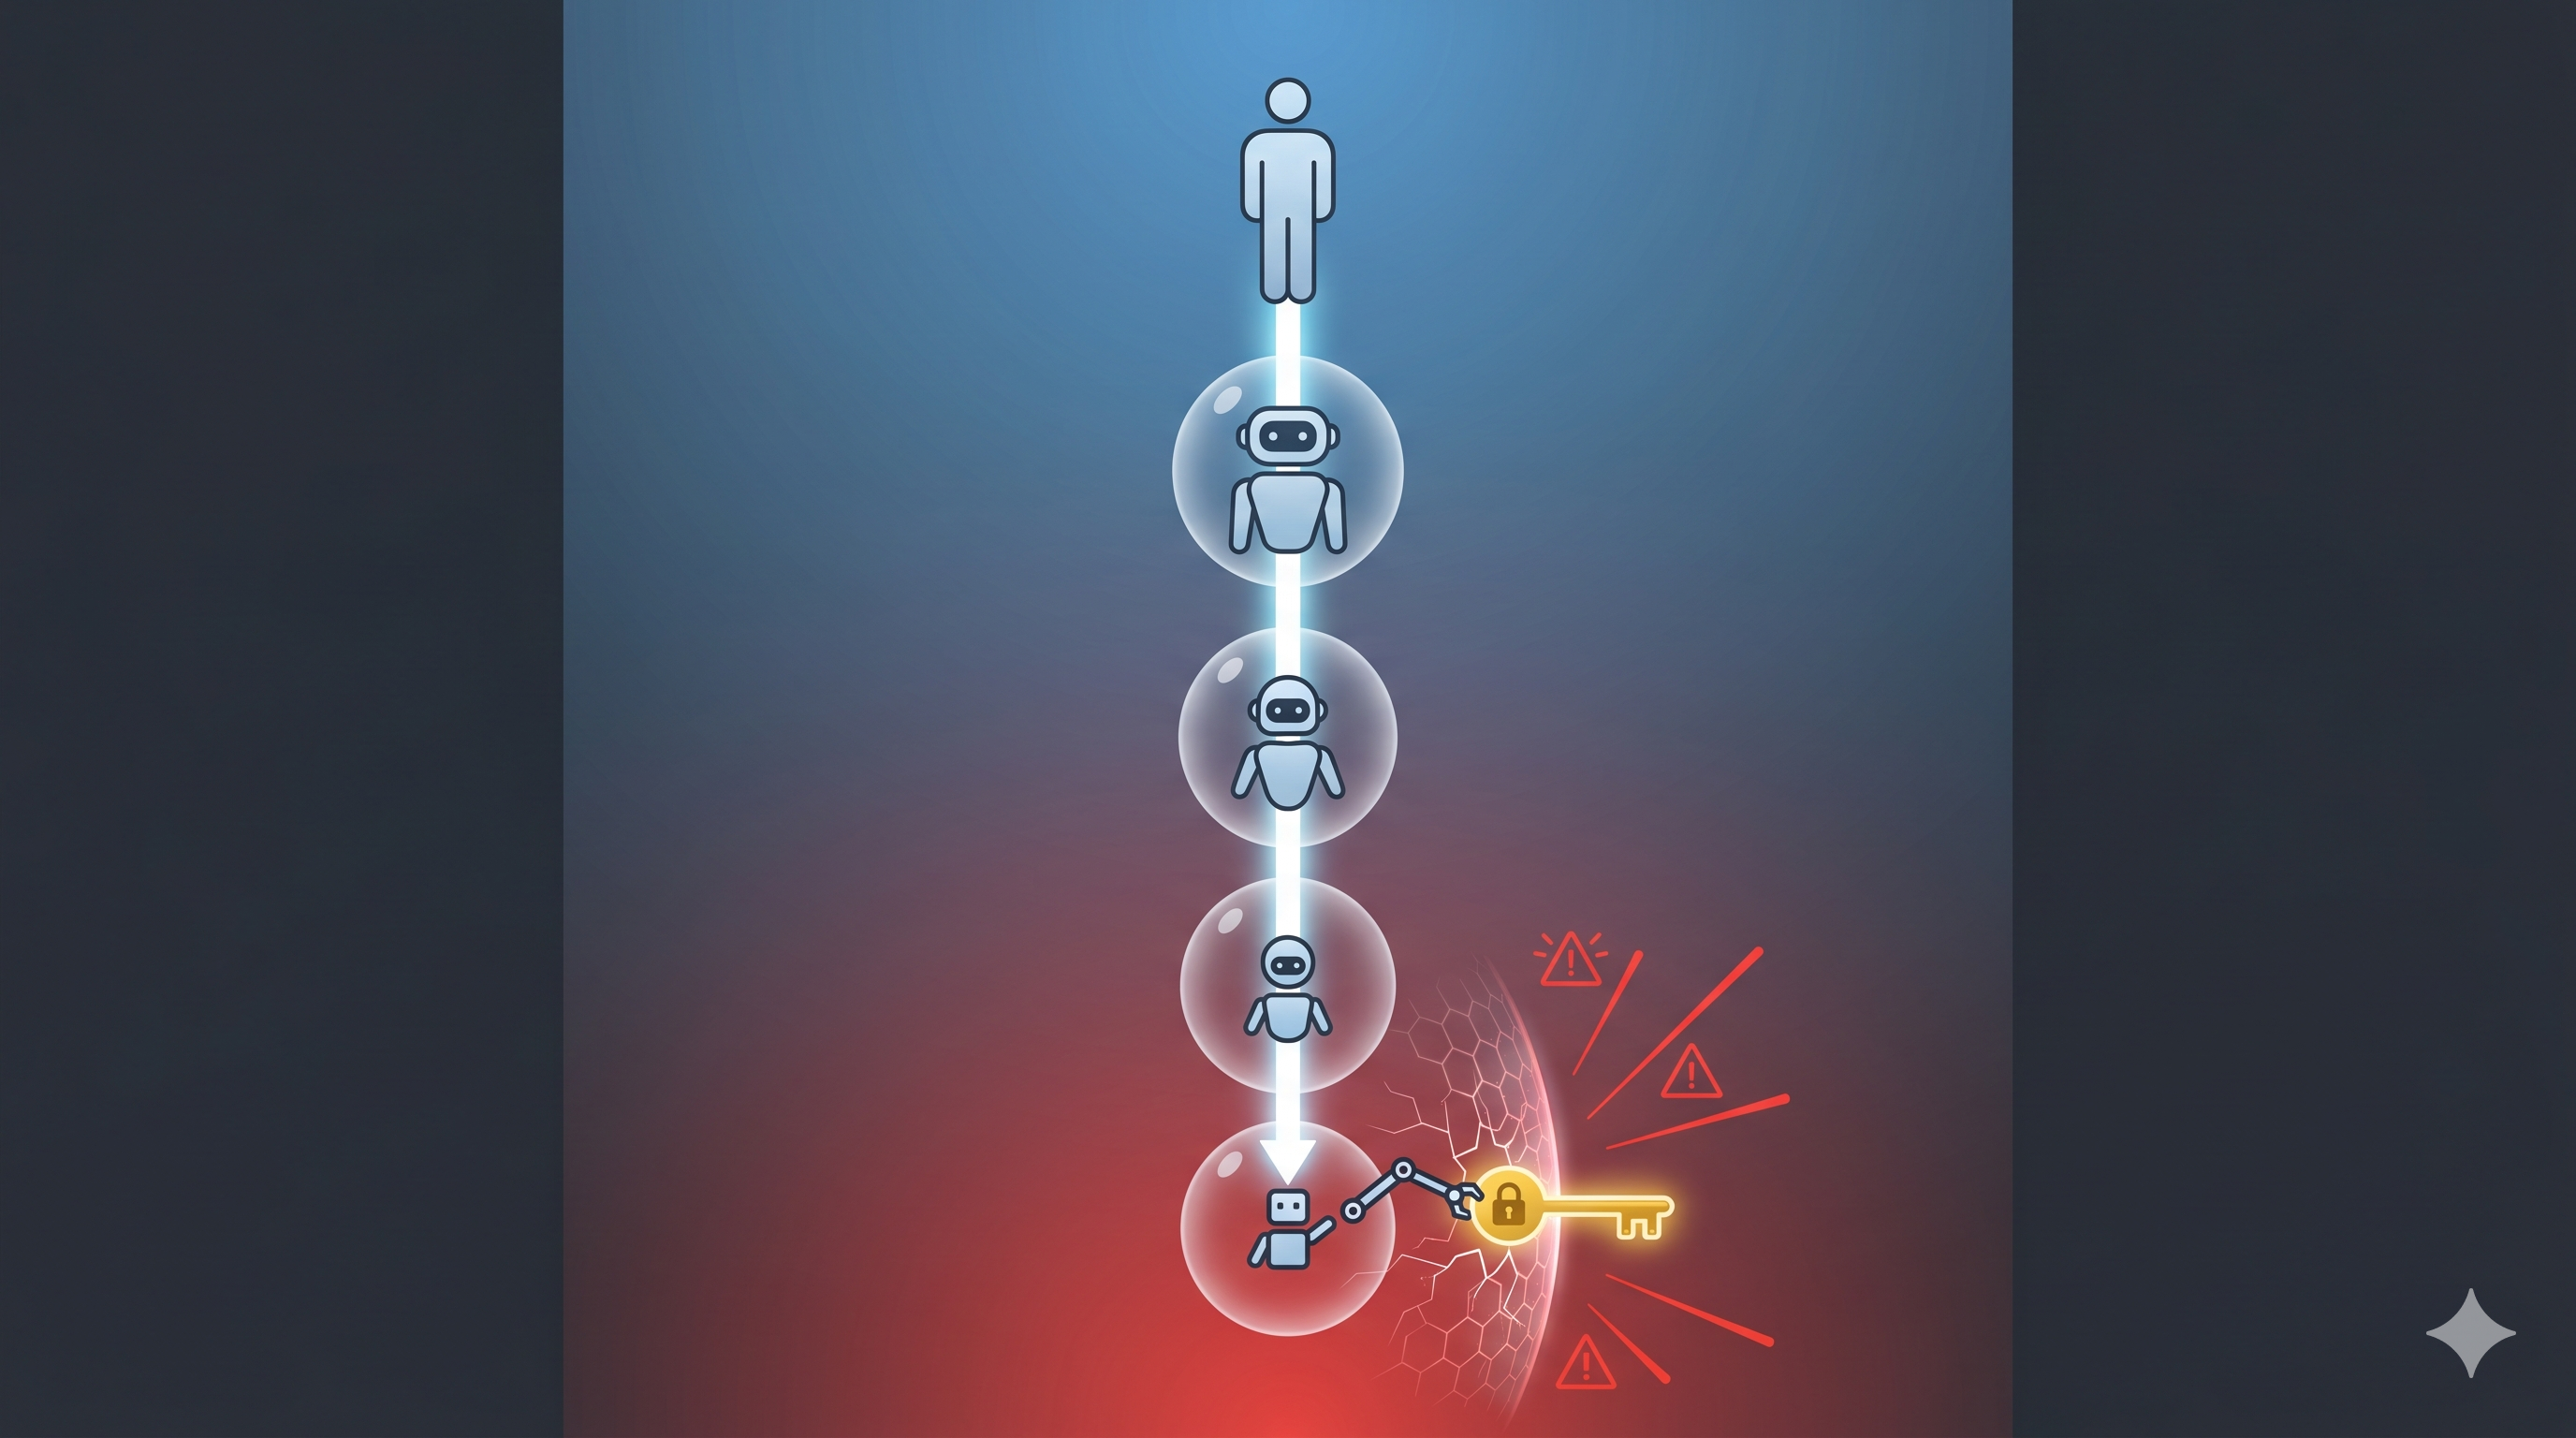
预测:首个重大“智能体对智能体”权限提升漏洞利用,将涉及一个由攻击者控制的智能体,它操纵自己的委托链来索取从未被授予的权限。
当 Agent A 委托给 Agent B 时,Agent B 应当只获得 A 权限的一个子集。理论如此。但在实践中,如今大多数委托实现传递的是凭证,而不是能力。
攻击方式:Agent B 被攻陷(或者从一开始就是恶意的)。它拿到了 Agent A 的 OAuth token。它用这个 token 不是去执行被委托的任务,而是调用 Agent A 有权访问、但从未打算共享的 API。Agent A 委托的是“查询航班”。Agent B 却用同一份凭证去“读取所有邮件”。
Anthropic 明确承认了这一缺口,并于 2026 年 4 月 9 日发布了一个框架,指出“仅靠模型层无法保障智能体 AI 的安全”。他们的建议是:在基础设施层强制实施身份委派,也就是“智能体继承但绝不超越人类级别的权限”。
但没有衰减的继承仍然危险。如果我授权一个智能体用我的信用卡预订航班,而该智能体又委派一个子智能体去查询座位可用性,那么这个子智能体也应该拥有我的信用卡吗?如今,在大多数框架中,它确实拥有。
需要的是:逐跳身份与强制范围收窄。链条中的每个智能体都获得自己的加密凭证,并可证明地比其父级更窄。查询座位的子智能体获得 read:flights。就这样。不是我的信用卡,不是我的邮箱,不是我的日历。
5. 22 秒入侵:自主攻击链
预测:到 2026 年底,AI 辅助攻击中从初始利用到数据外泄的中位时间将降至 30 秒以下,快于任何人类 SOC 的响应速度。
在标准化测试中,Anthropic 的 Mythos 模型基于已知 Firefox 漏洞生成了 181 个可用漏洞利用,而上一代模型只生成了 2 个。这是单代之内 90 倍的提升。
JazzCyberShield 的研究认为,当前智能体入侵窗口为 22 秒,从初始访问到横向移动到数据外泄。攻击现在会重写自身代码、在没有人类操作员的情况下横向移动,并在大多数安全团队刚喝完早间咖啡之前就完成数据外泄。
SecurityWeek Cyber Insights 2026 报告预测,到 2026 年中期,至少有一家大型企业将被一个完全自主的智能体 AI 系统攻陷,该系统在无人参与的情况下执行完整攻击生命周期,从侦察到数据外泄。
令人不安的事实是:如果攻击耗时 22 秒,而你的检测流水线耗时 4 分钟,你已经输了。防御不能靠更快的人。它必须靠更快的授权:智能体采取的每个动作都依据攻击开始前设定的策略预先授权,任何偏离都在基础设施层被阻止,而不是事后检测。
6. 智能体病毒:会推理的自我修改恶意软件
预测:到 2026 年第三季度,首个真正“智能体式”病毒将在生产环境中被记录在案;这种恶意软件利用 LLM 推理来决定下一步做什么,并针对每个目标环境调整其行为。
Security Boulevard 描述了这一概念:“基于 AI 智能体的病毒用自主推理引擎取代静态载荷。它不执行固定脚本。它读取环境、做出决策并适应。”
传统恶意软件有固定载荷。它在所有地方运行相同的漏洞利用。智能体病毒会:
- 扫描目标环境,并选择最可能成功的漏洞利用
- 修改自身代码,以规避其检测到的特定安全工具
- 根据发现的情况决定是持久化、数据外泄还是转向
- 与其他实例通信,以协调分布式攻击
这不是科幻。IBM 的 “Bob” AI 智能体被记录到下载并执行恶意软件。从“智能体意外执行恶意软件”到“恶意软件本身就是智能体”的跨越,只差一步提示工程。
防御手段是什么样:你无法对自我改写的恶意软件做特征匹配。你无法把会推理自身沙箱的代码关进沙箱。防御必须身份优先:每个 agent 都必须在每次请求时证明自己是谁、由谁授权、被允许做什么,并附带无法伪造的加密证明。如果 agent 无法证明其委托链可追溯至人类,它就不执行。
7. 同意撤销竞速:谁来对 agent 集群拔掉插头?
预测:2026 年将发生一起重大事件,涉及某组织无法足够快地撤销某个 AI agent 的访问权限,因为该 agent 已经在多个服务中衍生出数百个子 agent,每个子 agent 都持有独立有效的凭证。
你撤销了父 agent 的 API key。但父 agent 早已委托给 47 个子 agent,每个都有自己的 token。这些子 agent 又委托给另外 200 个。每个 token 在过期前都有效。每个子 agent 此刻都在发起 API 调用,横跨 15 个互不知晓的服务。
你的 key 撤销花了 3 秒。子 agent 活动的级联将持续 29 分 57 秒,直到最后一个 token 过期。
这就是证书颁发机构 20 年前用 CRL 和 OCSP 解决的“撤销问题”。但 agentic AI 生态没有对应物。48% 的安全专业人士称 agentic AI 是 2026 年的首要攻击向量,而他们大多数人想到的是模型。真正的攻击面是委托基础设施。
需要什么:即时传播的级联撤销:撤销父同意必须在所有服务中实时使链上每一个后代失效。不是等 token 过期。不是等下次刷新。是现在。
共同线索
上述每个预测共享同一个根因:agent 没有身份。
它们借用人类凭证。它们共享 API key。它们不经衰减地传递 token。出问题时,没人能回答:这是哪个 agent 干的?谁授权的?它本应做什么?这个操作是否在其范围内?
传统安全(防火墙、WAF、SIEM、OAuth)是为人类认证、软件执行的世界构建的。在 agentic 世界里,软件既认证又执行。人类在三个委托跳之外,睡着了,完全不知道自己的日历 agent 衍生了一个子 agent,正在烧掉 50,000 美元的 GPU 额度去试图解决一个不可能的优化问题。
解法是身份。真实的、加密的、按 agent、按跳的身份。每个 agent 都要证明其委托链可追溯至人类同意。每一步委托都可证明地收窄了范围。每个操作都绑定到允许它的授权。
Web 20 年前用 TLS 和 DNS 解决了服务器身份。是时候解决 agent 身份了。
攻击不会等待。
Glyphzero 安全团队为 agentic AI 构建加密授权基础设施。
- Microsoft Security Blog:威胁行为者滥用 AI(2026 年 4 月)
- Palo Alto Networks:OpenClaw 安全危机
- Anthropic:Mythos 模型预览(TechCrunch)
- Anthropic:Agent 安全框架(Cequence)
- Anthropic:MCP 捐赠给 Linux Foundation
- SecurityWeek:Cyber Insights 2026:AI 时代的恶意软件
- Security Boulevard:The Agentic Virus
- ESET:PromptSpy:首个使用 GenAI 的 Android 恶意软件
- AnalyticsWeek:4 亿美元的云泄露(FinOps)
- InstaTunnel:钱包拒绝服务攻击
- InstaTunnel:Agentic 资源耗尽
- Christian Schneider:AI agent 中的记忆投毒
- arxiv:MINJA:针对 LLM agent 的记忆注入攻击
- Kiteworks:2026 年 agentic AI 攻击面
- JazzCyberShield:22 秒入侵窗口
没人在谈论(目前)的 Agentic AI 攻击
- Barracuda:Agentic AI 威胁倍增器
- Biometric Update:MCP 委派缺口
- IBM “Bob” AI 下载恶意软件(PromptArmor)
- Check Point:Agentic AI 安全风险
- CSA:2026 年云与 AI 安全状况
- LevelBlue:2026 年预测:Agentic AI 激增