 Newshot
哈佛研究人员发现 AI 编码代理将瓶颈转移到了代码审查
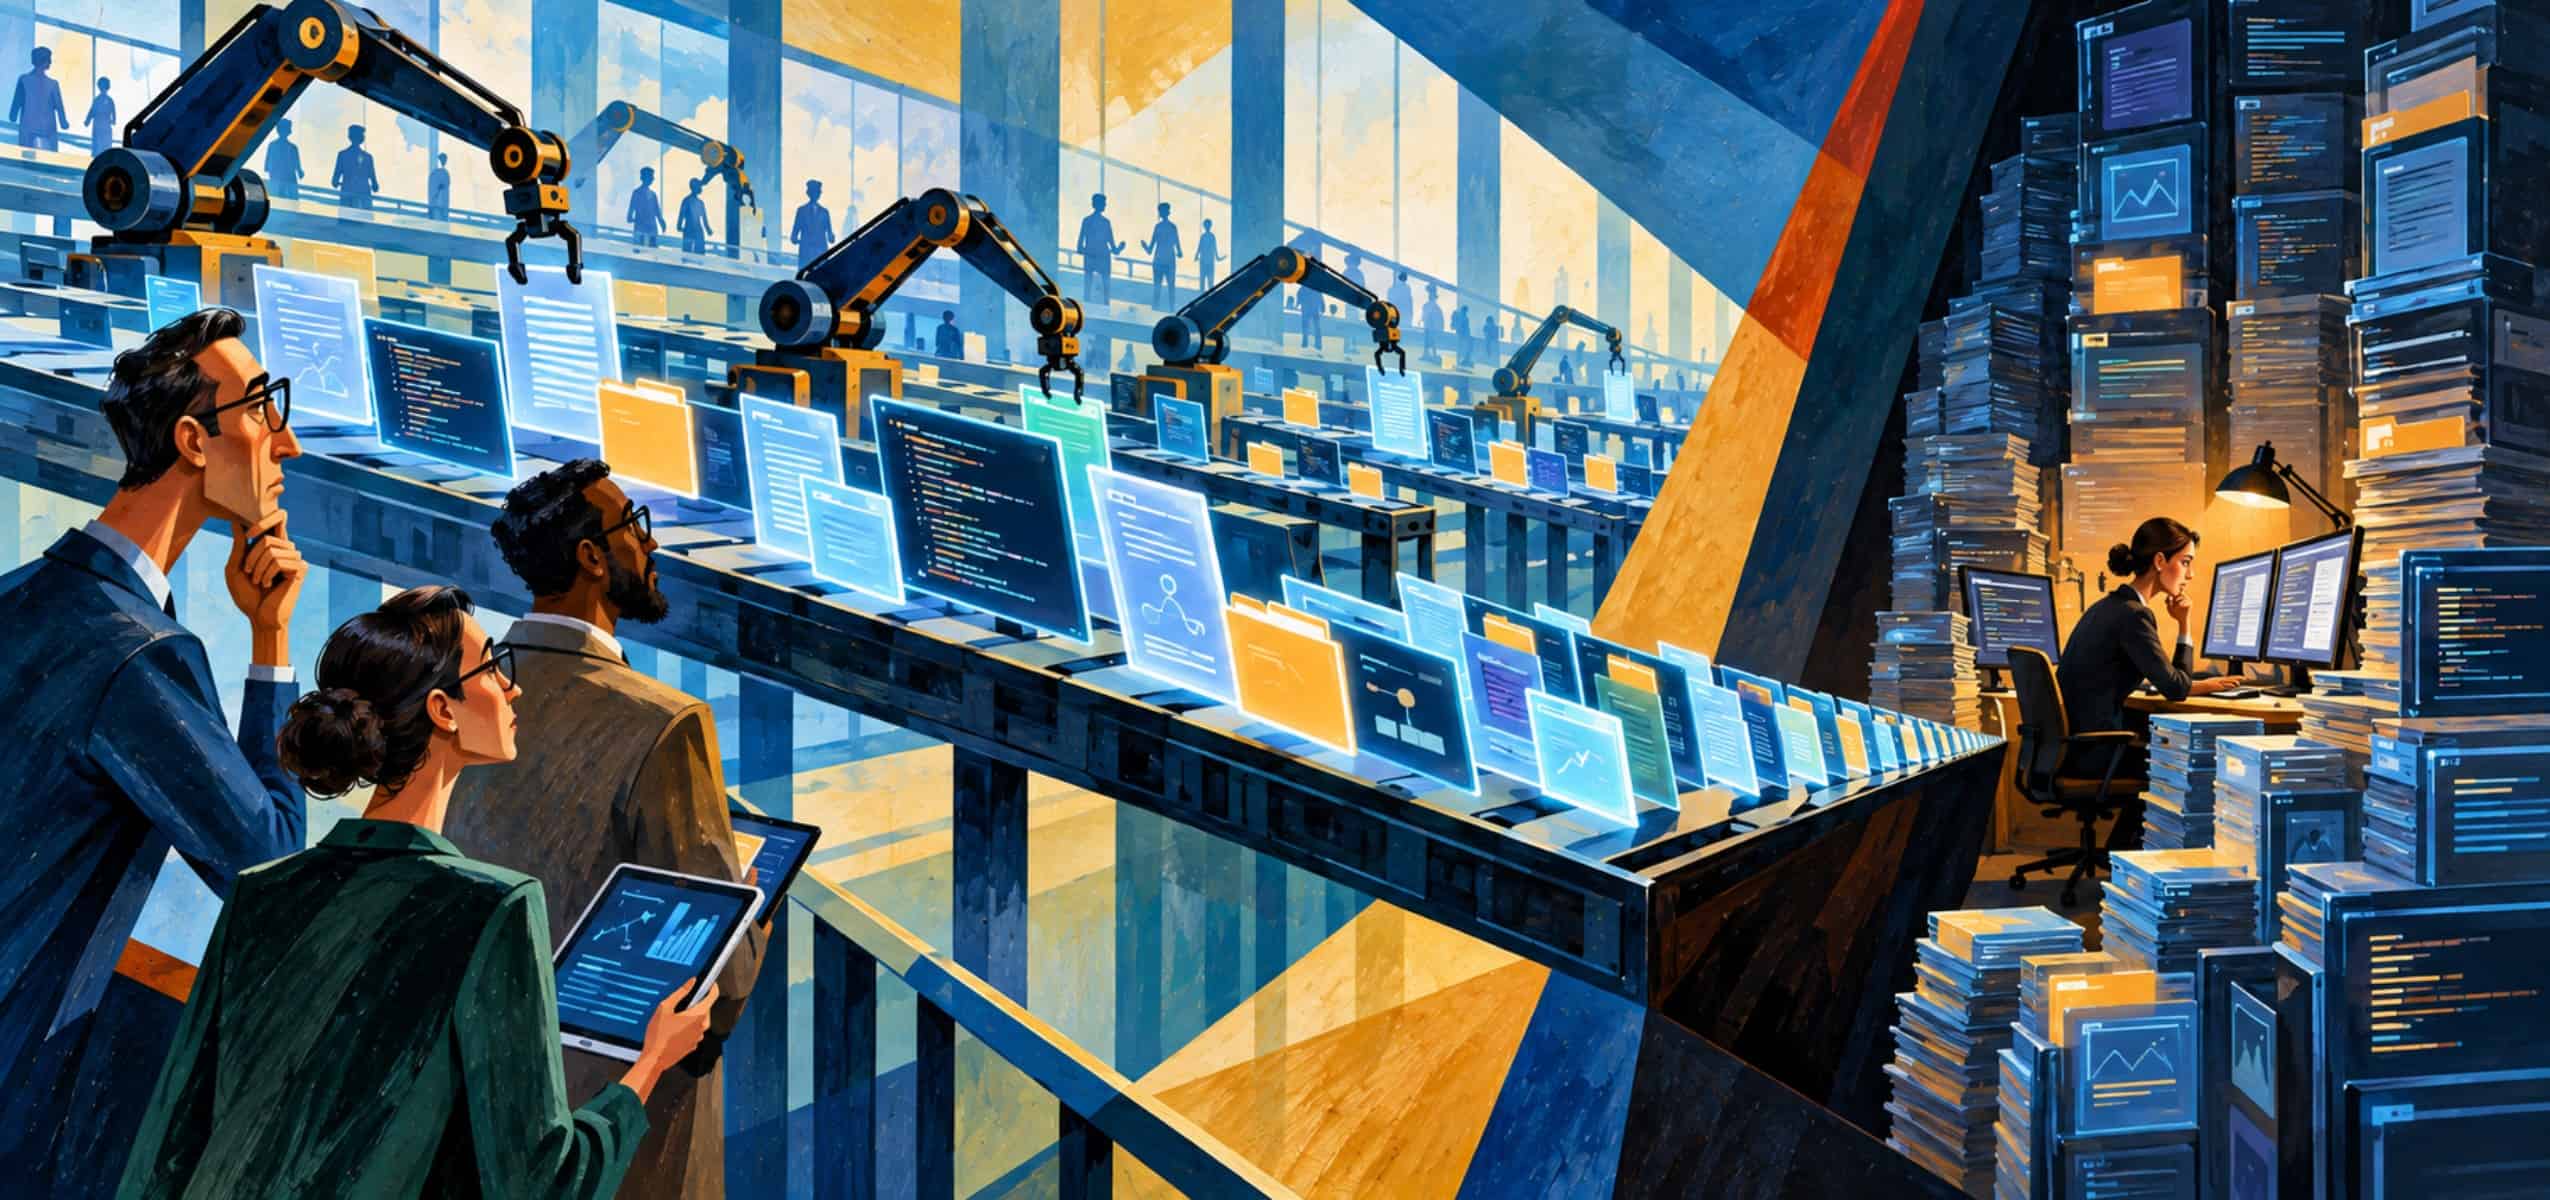
编辑注:根据哈佛大学博士生 Fiona Chen 和 James Stratton 覆盖 718 家公司的工作论文,采用 AI 编码代理的公司的工程师多编写了约 30% 的代码,但完成的工作量并未显著上升,代码通过审查所需时间则延长了 49%。这篇论文是一篇 job-market paper,没有迹象表明已完成同行评审,它衡量的是起草速度加快后,人类检查点会发生什么。Harvey 的驳回动议工作流和 Cooley 仍在与 Google Cloud 开发的脱敏代理,都将律师置于一个可比的检查点,而两项公告都没有报告对该审查阶段的衡量。
对于 eDiscovery、隐私与合规专业人士,这项研究为法律 AI 买家提示了一种衡量方法:在起草产出之外,还要考虑已批准的工作成果、修订率和审查者时间。它还表明,AI 参与创作会在协作系统中留下元数据,而记录与法律保留程序可能需要访问这些元数据。请关注该论文的修订版,以及任何发布审查阶段数据的法律供应商,同时记住该研究考察的是软件,而非法律工作。
内容评估:哈佛研究人员发现
作者称这些采购延迟很可能与公司增长速度无关,他们认为这支持对早期和晚期采用者进行比较。他们承认一个已知的不平衡,即规模更大的公司更早采用,并且他们控制了公司规模。作者说,如果仍存在某些隐藏差异,它更可能让 AI 看起来比实际更有生产力,而不是更低。这种方向的偏差如果有影响,也只会让产出持平的结果对 AI 更有利。
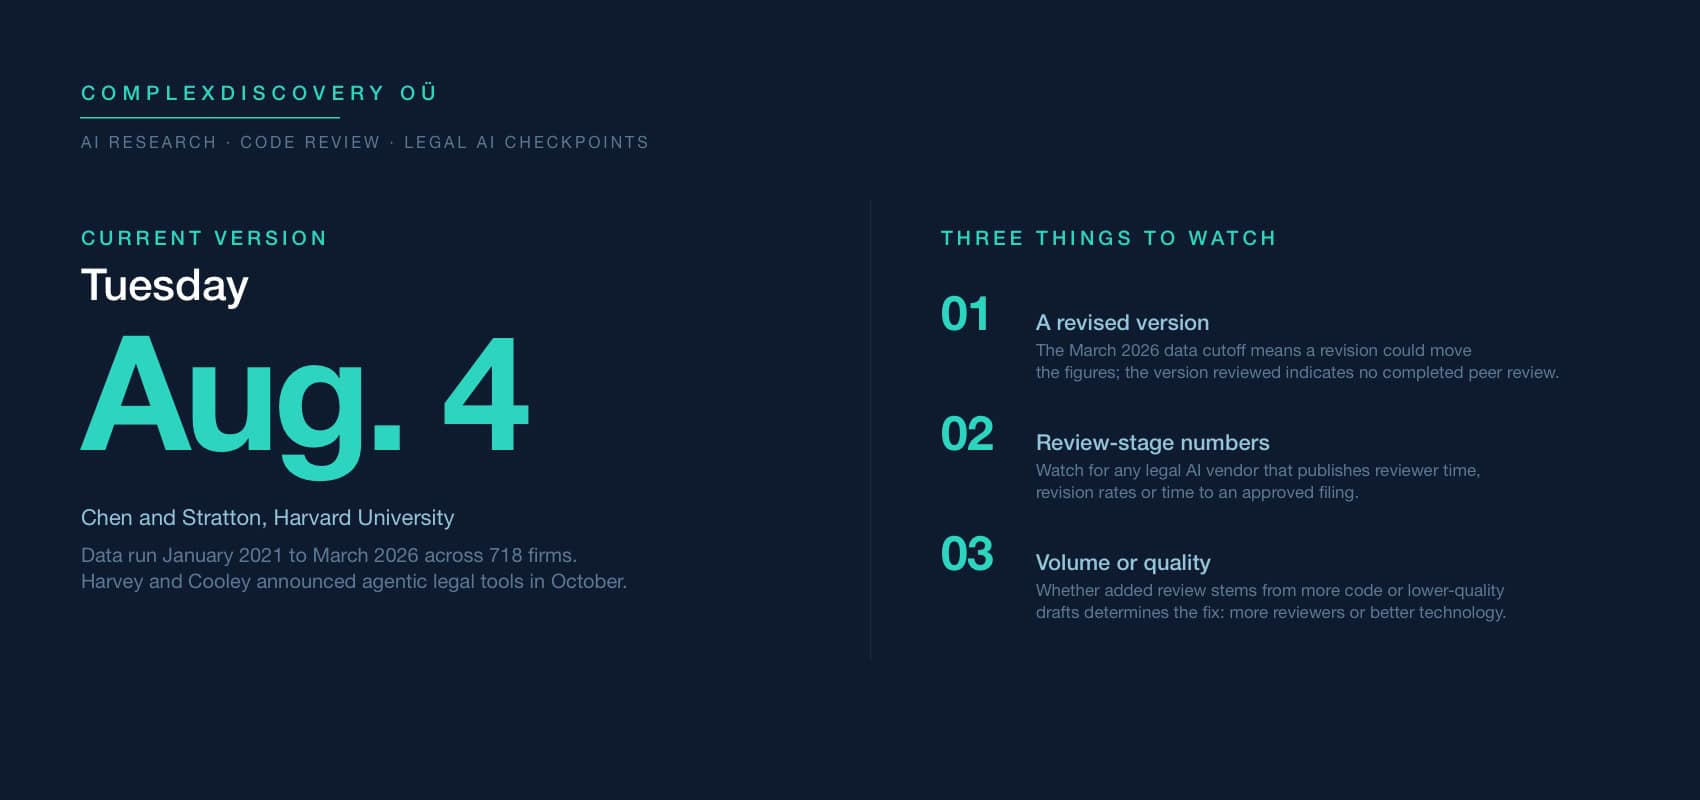
论文当前版本标注日期为 2026 年 8 月 4 日,第一版标注日期为 1 月 7 日。Chen 将其作为她的求职论文传播,本文所审阅的版本中没有任何内容表明其已被期刊接收或已完成同行评审。她的网站列出了指向 The Wall Street Journal 和 The Economist 的报道链接,法律行业媒体本月也报道了此事,包括 Doug Austin 10 月 12 日在 eDiscovery Today 发布的帖子,该帖转述了 Ars Technica 的一篇报道。
草稿数量上升,已完成的问题数量没有
鉴于上述论文出处,编码方面的结果幅度很大。每个工人月新增代码行数在 5,017 的基线上增加了 1,494 行,约 30%。提交数增加 20%,拉取请求,即提交供审查的代码包,增加 23%。作者指出,这些估计捕捉的是已经拥有 AI 编码助手的公司中智能体带来的附加效应,而不是 AI 从零开始的效应。
产出是收益停止的地方。论文将已完成的工作计为已解决的 Jira 问题,一个问题在其代码部署到生产环境时才算完成。智能体使该指标在 3.67 的基线上每个工人月变动 0.12 个问题,标准误为 0.17。该结果在统计上与零无法区分,95% 置信区间排除了高于基线约 12% 的增长,远低于代码编写量 30% 的增幅。
作者测试了明显的退路。如果工程师转向更大的任务,持平的问题数量会低估真实产出。因此,研究人员使用 GPT-4o 按规模标注
这一说法符合作者用来解释其数据的模型,该模型有两条渠道。第一条,更快的起草把更多代码送给固定数量的审查者,这个问题可以通过把人力转移到审查环节来大幅缓解。第二条,变更请求和评论的增加——仅靠更快的起草无法解释——在该模型中被解读为草稿质量更低的迹象。作者说,这个问题需要更好的技术。任何购买代理的人都应关心哪条渠道占主导,因为两者需要不同的支出。
就业也没有变动
编码收益也没有以裁员的形式显现。估计结果排除了整体就业下降超过 2.9% 的可能。一个噪声更大的估计排除了工程岗位就业下降超过 13.8% 的可能。作者提醒,这些是在局部均衡中测得的短期效应,可能掩盖竞争公司的岗位流失;而且针对工程岗位就业的 assistant 估计显示出向上预趋势,使其难以作因果解读。
法律 AI 工具围绕类似的检查点设计
这些软件结果出现之际,法律 AI 工具正采用一种相关设计,Harvey 和 Cooley 的公告都遵循它:自动化第一遍处理,然后在检查点保留律师。Harvey 的工作流程与 LexisNexis 共同开发,于 10 月 7 日公布,是起草场景的案例。Harvey 表示,阅读起诉状、研究并起草驳回动议的多步骤过程“通常需要 40 到 50+ 小时的工作”,而其工具“在数小时内”产出研究和初稿。公告描述了“在律师判断最重要的时刻设置人工检查点”,但没有说明律师在这些检查点上花费多长时间,也没有说明达到可提交动议需要多长时间。
Cooley 10 月 8 日的公告将同样的姿态应用于另一项任务,因为其代理推荐的是涂黑处理而非起草论点。Cooley 表示该代理仍在开发中,所有涂黑决定都由律师在文件提交法院前作出,这使人工检查点位于提交前的最后一步。正如 ComplexDiscovery 10 月 10 日报道的那样,该公告没有提供错误率。
对于在联邦法院提交的动议,检查点是一项法律义务,而不是设计选择。根据《联邦民事诉讼规则》11(b),提交动议的律师需尽其所知、所获信息和所信——这些是“在根据情形进行合理调查后形成的”——就动议的若干事项作出证明。其法律主张必须“得到现行法律的支持,或得到为扩展、修改或推翻现行法律或确立新法律而提出的非轻率论点的支持”。其事实主张必须有证据支持,或者如果被特别如此标明,则在有合理机会进一步调查或证据开示后很可能有证据支持。初稿可以在数小时内完成,但该调查仍由律师承担,而软件证据提出了审查可能吸收掉起草节省的一部分时间的可能性。
这篇论文的方法还带来第二个教训,这次是给信息治理团队的。研究人员部分通过公司自身系统内的痕迹识别代理使用情况,包括与 AI 工具关联的机器人账户,以及提交信息和拉取请求描述中的“Co-authored-by”行等签名。AI 作者身份会在协作系统中留下自己的元数据轨迹。该轨迹是一种记录,保留计划和法律保留可能需要覆盖到它。
Harvard researchers find AI coding agents shifted the bottleneck to code review
这一切并不意味着法律工作会像软件一样表现,这种类比也有其局限。文件审阅不是代码审阅,一份申报文件不是一次 pull request,而 Chen 和 Stratton 并未研究任何法律工作。另一份美国国家经济研究局(National Bureau of Economic Research)工作论文于 2026 年 9 月修订,利用超过 500,000 名 GitHub 开发者的数据报告了类似的衰减。其作者 Mert Demirer、Leon Musolff 和 Liyuan Yang 发现,来自自主智能体的提交量累计增长 240%,而实际发布的相应增幅缩小至 30%。该论文也附有自己的利益披露:Demirer 和 Musolff 此前均曾在 Microsoft(GitHub 的所有者)担任博士后研究职位,且二人目前均担任该公司的有偿研究顾问。两项软件研究指向的是软件领域的某种模式,而非关于律所的发现。
Document review offers a partial precedent
电子取证从业者此前已就这一问题的某个版本展开过争论,Austin 的文章也作了这一类比。他写道,电子取证领域在生成式 AI 审阅上出现过类似的争论,一些从业者认为人工验证抵消了收益,而包括他在内的另一些人则认为,预测编码中所使用的那种统计抽样已经足够。不过,对于编码智能体,他写道额外的审阅时间或许是合理的,因为即使正确率达到 90% 的代码仍可能无法运行。
他的类比提示了对两类法律产出作一种有用的区分。诸如首轮相关性审阅这类群体层面的工作可以通过抽样来验证。单份申报文件则不同,因为其引文、事实主张和敏感数据通常需要直接审查,因为一次伪造引文或一个漏掉的 Social Security number 就是失败。买方可以把这一区分转化为测试。询问供应商其智能体产出的是哪一类结果,然后索要下游指标而非起草指标:从上传到获批工作成果所需的小时数、审阅律师退回的草稿比例,以及每项事务的审阅者时间。在扩大起草量之前先为审阅能力做预算,并记录审阅者所做的修改,因为该记录能显示瓶颈是数量还是质量。
Read the paper’s limits as closely as its findings
这些问题同样适用于该论文自身的资料来源。其数据合作方在该主题上存在商业利益,且这种关系比一份数据许可更为深入。Jellyfish 自称是一个“AI Impact Platform”,而作者们曾在其博客上发文:2025 年 9 月 25 日由 Chen 和 Stratton 撰写的一篇文章自称是“我们与 Jellyfish 持续合作工作的一部分”。该论文感谢 Jellyfish 团队“的合作”,并声明 Jellyfish 审阅稿件仅是为了检查专有信息披露,而非科学内容,且结论属于作者本人。其资助方为 Stripe Economics of AI Fellowship、Harvard Kennedy School 一个关于财富分配的项目,以及 Schmidt Sciences AI at Work Program。
Jellyfish 还曾推广过该工作的一个早期版本。其博客上 2026 年 1 月 28 日由 Nicholas Arcolano 撰写的一篇文章称其为“来自我们在 Harvard Economics 的合作者 Fiona Chen 和 James Stratton 的一篇新论文的初步版本”,基于 500 家公司中 100,000 名软件工程师。该文章以及其后 3 月 17 日 Jellyfish 的新闻稿报告称,AI 正在让编码更快,且“代码质量似乎并未受损”。8 月版本基于截至 2026 年 3 月的更大样本,通过其模型将变更请求的近乎翻倍解读为草稿质量可能下降的迹象。这两种描述基于不同的版本和样本,因此未必相互冲突,但依赖 Jellyfish 摘要的读者会错过当前论文提出的质量疑问。
写作形式为 {{NAME_ab12cd34}} 的值是真实值的占位符。在回复和工具调用中都要完全按原样使用它们:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:Harvard researchers find AI coding agents shifted the bottleneck to code review
正文: 该论文还存在一些不影响核心 agent 估计值的内部不一致之处。其引言将样本四舍五入为约 700 家公司、70 万名员工,正文描述了 17 次访谈,而附录描述的是 21 次。其他局限属于结构性而非笔误性质:底层数据为专有数据,通过个人许可证使用 AI 工具的情况未被记录。
这些说明均未推翻核心结果,不过 2026 年 3 月的数据截止时间意味着修订可能会改变相关数字。该论文提供的是一套标准,而本文讨论的两项法律公告未能达到该标准:具名作者、公开的方法、置信区间以及经过测量的检查点。如果 agent 将 40 小时的研究和起草工作缩短到几小时,那么其中有多少小时会重新出现在签署动议的律师的办公桌上?
新闻来源
- Artificial Intelligence in the Firm: Bottlenecks in Software Production(Fiona Chen 与 James Stratton,Harvard University)
- Fiona Chen(Fiona Chen)
- James Stratton | Department of Economics(Harvard University Department of Economics)
- Writing Code vs. Shipping Code: Productivity Effects Across Generations of AI Coding Tools(National Bureau of Economic Research)
- Rule 11. Signing Pleadings, Motions, and Other Papers; Representations to the Court; Sanctions(Legal Information Institute, Cornell Law School)
- Introducing the Motion to Dismiss Workflow, Co-Developed With LexisNexisⓇ(Harvey)
- Cooley Collaborates With Google Cloud to Develop AI Agent for Complex Litigation(Cooley)
- Jellyfish Reveals AI’s Real Impact on Engineering Teams with Industry’s Largest Ongoing Benchmark Study(Jellyfish)
- New Research from Harvard & Jellyfish: AI Is Making Developers Faster. So Where’s the Business Impact?(Jellyfish)
- Does AI Assistance Mean Engineers Are Doing Less Coding Work? Maybe Not.(Jellyfish)
- AI Coding Agents Productivity Gains Offset by Human Review(eDiscovery Today)
- Cooley and Google Cloud are building a court-filing redaction agent without a published error rate(ComplexDiscovery)
Assisted by GAI and LLM Technologies
延伸阅读
- MonsterCloud 起诉书揭示了受害者自身文件可能未记录的赎金支付
- Wikimedia 就疑似 OpenAI agent 在其各 wiki 上的活动发布了自家说明
- Cyber Law Toolkit 检验 AI 欺骗、网络酷刑与和平时期网络义务
- ENISA Threat Landscape 2026 发现 DDoS 在事件数量上居首,而勒索软件短期内仍最具影响
- Cyber Resilience Act 报告于 9 月 11 日在一个尚未完成的平台上启动
- 欧洲的云规则草案将把供应商所有权写入审计文件
- 八小时时钟今日启动:欧盟电子证据令现已送达受涵盖的美国供应商的欧盟收件人
- 加州 AI 透明度法案与欧洲第 50 条同步到来
- 联邦治安法官将 LinkedIn 的 Relativity aiR 工作流视为 TAR
- 一个基准,三个方向:2026 年法律费率同时上升、持平和下降
- 信心降温,承诺不改:2026 年上半年 eDiscovery 商业信心调查完整结果
- 完整概览:ComplexDiscovery OÜ 的 2025 至 2030 年 eDiscovery 市场规模汇总
- eDiscovery 的工作流:考量流程与任务
来源:ComplexDiscovery OÜ
ComplexDiscovery 的使命是通过提供独立、数据驱动的报道、研究与评论,为复杂决策带来清晰度,使从业者、政策制定者和商业领袖更容易理解数字风险、法律技术和监管变化。
有需求吗?
像 {{NAME_ab12cd34}} 这样书写的值是真实值的占位符。在回复和工具调用中请完全按原样使用它们:它们会在任何内容运行之前被填入真实值。不要请求验证它们,也不要用示例替换它们。
哈佛研究人员发现 AI 编码智能体将瓶颈转移到了代码审查
如果您有希望向我们咨询的信息或提供请求,请告知我们,我们会优先回复您。
ComplexDiscovery OÜ 是一家独立的数字出版物和研究机构,总部位于爱沙尼亚塔林。ComplexDiscovery 覆盖网络安全、数据隐私、监管合规和 eDiscovery,其报道将法律与商业技术的发展——包括高增长初创企业趋势——与国际商业、政策和全球安全动态联系起来。ComplexDiscovery 聚焦受跨境监管和地缘政治复杂性影响的技术与风险议题,为全球法律、合规、安全和技术专业人士提供编辑报道、原创分析和精选简报。了解更多请访问 ComplexDiscovery.com。
生成式人工智能与大型语言模型的使用
ComplexDiscovery OÜ 认识到 GAI 和 LLM 工具在简化内容创作流程以及提升其研究、写作和编辑工作整体质量方面的价值。为此,ComplexDiscovery OÜ 定期使用 GAI 工具,包括 ChatGPT、Claude、Gemini、Grammarly、Midjourney 和 Perplexity,以协助、增强并加速已发布帖子和页面中新内容与修订内容的开发与发布(始于 2022 年末)。