 Newshot
ArisGlobal 如何在 Amazon Bedrock 上扩展生成式 AI 推理
ArisGlobal 是一家生命科学技术提供商,业务涵盖药物警戒、法规事务、医学事务、临床和质量职能。该公司在 Amazon Bedrock 上开发了 NavaX——一个专为生命科学打造的人工智能引擎,用于自动处理不良事件病例。ArisGlobal 选择 Amazon Bedrock,是为了获得对基础模型的托管访问、欧盟地理跨区域推理以及托管提示缓存。随着企业客户不断提出各自的合规要求,共享提示前缀在 6 个月内增长了约 150%,而单例推理成本则上涨了超过 200%。
ArisGlobal 最初缓存的是每份源文档,因为它是请求中占比最大的部分。这样一来,不断增长的共享提示前缀就被排除在缓存之外。通过调换顺序、改为缓存共享前缀,ArisGlobal 降低了有效输入成本,并在不带来成比例成本增长的前提下支持了更多租户。
ArisGlobal 是谁?
ArisGlobal 是 LifeSphere 的创造者。LifeSphere 是一个统一的 SaaS 平台,服务于药物警戒、法规事务、质量和医学信息。LifeSphere 服务于全球范围内的制药公司,其中包括多家按营收排名位居前 20 的制药组织(来源:ArisGlobal 新闻稿)。整个系统运行在 AWS 上。
LifeSphere NavaX 是 ArisGlobal 的人工智能引擎,它将药物安全从记录系统转变为战略优势系统。ArisGlobal 于 2025 年 3 月在 Amazon Bedrock 上使用 Anthropic 的 Claude 将其首个生成式 AI 解决方案投入生产。根据 ArisGlobal 的内部生产遥测数据,他们已在受监管的制药环境中处理了超过 100 万笔真实交易,在多个企业租户中处理了数十亿个 token。模型可用性因区域而异。参见按 AWS 区域划分的模型支持。
NavaX 如何处理不良事件病例
当制药公司收到不良事件报告时——通常是一份描述患者对药物反应的多页 PDF——NavaX 的动态数据提取(DDE)智能体会提取约 130 个字段。这些字段包括患者人口统计信息、可疑药物、报告者信息、事件时间线、严重性标准和监管分类。由于这些内容包含受保护的健康信息,ArisGlobal 将负责任 AI 控制措施作为其生产部署的标准组成部分。它借助 Amazon Bedrock Guardrails 等能力来过滤内容并检测或屏蔽敏感信息。提取出的字段还会依据 schema 进行校验,并锚定在源文档中。
这一提取过程通过对模型的多次顺序请求完成。每个请求聚焦于病例表单的不同部分,且每个请求都携带:
- 系统指令——模型行为规则、输出格式规范以及监管合规约束。
- 客户特定规则——按租户区分的提取逻辑、字段映射以及因制药公司而异的业务规则。
- 提取 schema——约 130 个目标字段,包含类型、校验规则和少样本示例。
- 源文档——不良事件 PDF(通常为 10–200 页)。
有两类输入在不同范围内重复出现。共享提示前缀包括系统规则、提取 schema 和少样本示例,它会在使用同一智能体的不同请求、病例和租户之间重复。源文档则仅在与某一病例相关的请求中重复。
提示膨胀问题
当 NavaX 随其首个企业租户上线时,系统提示还很精简。随着 ArisGlobal 接入更多制药公司,每一家都带来了特定要求:
- 自定义字段映射(租户 A 对反应发生时间的映射方式与租户 B 不同)。
- 监管辖区规则(EU ICSR 与 FDA MedWatch 和 PMDA 的格式要求对比)。
- 针对严重性评估和因果关系的公司特定业务逻辑。
- 按每个租户的历史案例校准的租户专属少样本示例。
在 6 个月内,共享提示前缀从约 72,000 个 token 增长到 180,000 个 token,增幅 150%。由于每个案例需要多次顺序请求,单案例推理成本增长超过 200%。
前缀随每个租户而增长,并且在每次请求时都会被重新处理,因此提示增长与交易量叠加放大。
表 1 对比了最初的文档优先请求顺序与生产环境的提示优先设计。
| 方面 | 第一种方案 | 生产设计 |
|---|---|---|
| 请求顺序 | 单案例文档、缓存检查点、共享提示前缀 | 共享提示前缀、缓存检查点、单案例文档 |
| 缓存前缀 | 文档,每个案例都会变化 | 共享提示前缀,在多次请求间重复 |
| 复用范围 | 仅限单个案例的剩余请求 | 使用同一 agent 的跨案例、跨租户请求 |
| 成本影响 | 不断增长的提示以完整输入费率被反复处理 | 全队列范围的提示复用支持次线性成本增长 |
| EU 路由 | EU 地理跨区域推理保持不变 | EU 地理跨区域推理保持不变 |
Amazon Bedrock 提示缓存策略
Amazon Bedrock 提示缓存通过从请求开头到缓存检查点缓存一段连续的提示前缀,来降低延迟和输入 token 成本。后续具有相同前缀的请求可以以更低的费率读取缓存 token,而无需再次处理它们。缓存条目具有生存时间(TTL),在成功命中缓存后重置。
缓存基于前缀而非基于块。请求各部分按顺序评估——tools、system,然后是 messages——因此更改较早的部分会使后续的匹配内容失效。
缓存检查点(显式控制)
使用显式缓存检查点,你可以选择精确的前缀边界。支持的 Claude 模型允许每次请求最多四个检查点。
- 将每个检查点放在稳定、可复用的前缀之后。
- 满足模型特定的最小前缀大小。对于 Claude Sonnet 4.5,最小值为 1,024 个 token(参见支持的模型和区域)。
- 检查点按以下顺序评估:tools、system 和 messages。
- 更改较早的部分会使后续部分的缓存匹配失效。
- 默认 TTL 为 5 分钟。部分模型通过设置 "ttl": "1h" 支持 1 小时 TTL。较长 TTL 的条目必须位于较短 TTL 的条目之前。
简化缓存管理(自动化)
使用简化缓存管理,你在静态内容之后放置一个检查点。Amazon Bedrock 从该点向后搜索最长匹配前缀,最多约 20 个内容块。
- 一个检查点可以自动定位最长匹配前缀。
- 当稳定内容超出回溯范围时,使用显式检查点。
ArisGlobal 缓存了什么,以及他们刻意不缓存什么
ArisGlobal 在共享提示前缀之后立即使用一个显式检查点,该前缀最先发送。单案例文档位于检查点之后,并在每次请求时被处理。
这反转了最初的请求顺序。由于只有前缀可以被缓存,顺序决定了哪些内容可以被复用。
上线设计:优先考虑文档复用
最初的设计将 10–200 页的源文档放在每次请求的开头,并在其后放置检查点。共享提示前缀和特定章节的问题跟在检查点之后。
文章标题:ArisGlobal 如何在 Amazon Bedrock 上扩展生成式 AI 推理
正文:
        {
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content]..." // <-- Document sent FIRST
        },
        {
          "cachePoint": {"type": "default"} // <-- Checkpoint right after the document
        },
        {
          "text": "[System instructions + compliance rules + schema +
          few-shot examples + customer-specific prompt]..."
          // <-- After the checkpoint: never cached
        },
        {
          "text": "Extract fields for Section 3: Suspect Drug Information"
        }
      ]
    }
  ]
}
该设计在单个案例内复用文档:第一个请求将文档写入缓存,该案例后续的请求以较低费率读取它。
下一个案例使用了不同的文档,需要重新写入缓存,因此复用从未跨越案例或租户。
更重要的是,共享提示前缀位于检查点之后,在每次请求时都按完整输入费率处理。驱动成本曲线的这部分内容被排除在缓存之外。
演进后的生产设计:优先实现共享前缀复用
生产设计改变了顺序,而不是增加另一个检查点:共享提示前缀放在最前,检查点紧随其后,文档放在最后。
同一个检查点现在会创建一个可在整个资源池内复用的缓存条目:
- 之前——缓存的文档前缀对单个案例而言唯一,而共享提示从未被缓存。
- 之后——缓存的共享提示前缀在使用同一 agent 的请求、案例和租户之间重复使用。
ArisGlobal 放弃了单个案例内有限的文档复用,换来了整个资源池内的提示复用。共享前缀也正是随着客户增加而增长的部分。
更新后的实现
        {
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "system": [
    {
      "text": "[Shared system instructions + compliance rules +
      base extraction schema + few-shot examples]..."
    },
    {
      "cachePoint": {"type": "default"} // <-- Checkpoint after the stable prompt
    }
  ],
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content — sits after the
          checkpoint, not cached]..."
        },
        {
          "text": "Extract fields for Section 5: Event Assessment"
          // <-- Only this changes per request
        }
      ]
    }
  ]
}
对于大多数活跃账户,每个租户大约每 5 分钟就有一个案例到达,并且多个租户并发运行。这种流量在营业时间内让共享前缀保持热状态,因为每次缓存命中都会重置 TTL。
同时缓存提示和文档
在文档之后再加一个检查点,会缓存由共享提示和该案例文档组成的组合前缀。该条目对单个案例而言仍然是唯一的。
因此,ArisGlobal 优先选择了能在整个资源池范围内均摊读取成本的前缀。共享提示前缀可在案例和租户之间扩展,而每个案例的文档不能。
在生产环境中,典型请求 65% 的输入 token 由共享提示缓存提供。图 1 显示缓存读取持续超过缓存写入。
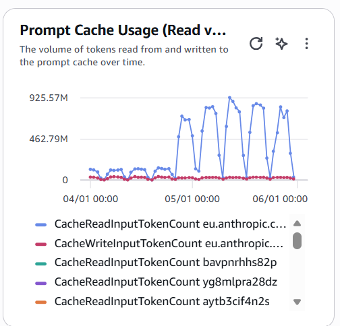
图 1:Amazon CloudWatch 提示缓存使用情况。在生产流量期间,蓝色缓存读取序列上升至缓存写入序列的约 10 倍
结果
在 EU 地理跨区域推理配置文件保持不变的情况下,缓存共享提示前缀产生了以下结果:
- 65% 的输入 token 以较低的读取费率从缓存提供。
- 缓存的生产请求端到端延迟最多降低 25%。
- 有效输入成本降低约 50%。
文章标题:ArisGlobal 如何在 Amazon Bedrock 上扩展生成式 AI 推理
正文:
- 在每月超过 190 亿 token 的情况下,整体月度推理支出降低约 40%。
- 企业租户新增约 15%,且成本没有成比例增加。
- EU 地理路由保持不变。提示缓存运行在现有推理配置之内。
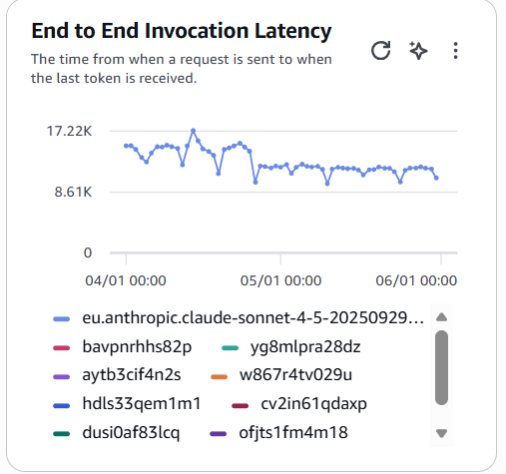
图 2:端到端调用延迟。图表显示采用提示缓存后,延迟范围更低且更稳定
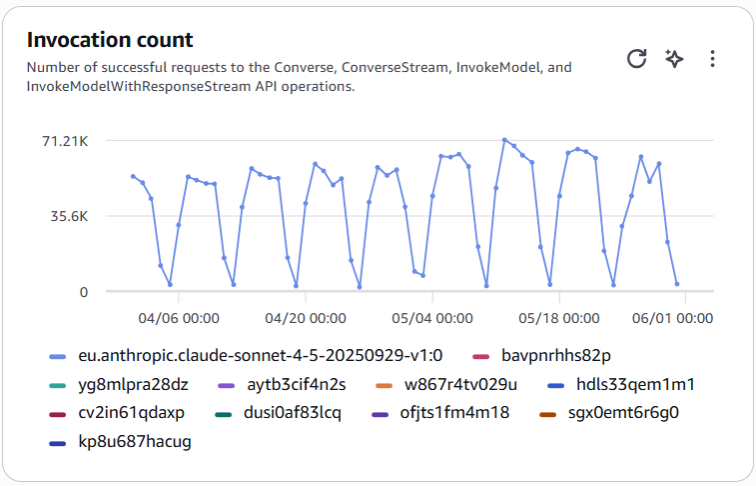
图 3:调用次数。图表显示生产请求量保持稳定,而推理支出增长低于成比例增长
根据 ArisGlobal 的生产计费数据,65% 的输入 token 由缓存提供,使有效输入成本降低约 50%。在每月超过 190 亿 token 的情况下,这带来了整体月度推理支出约 40% 的节省。
注意:本节中的所有性能和成本数据均反映 ArisGlobal 向 AWS 报告的生产指标。结果将因提示结构、流量模式和缓存命中率而异。
生产经验
ArisGlobal 的经验为许多具有大型重复提示前缀的工作负载提供了指导:
缓存重复的内容,而不是最大的内容。每个案例的大型文档可复用性有限,而字节完全相同的共享提示前缀可以服务整个集群的请求。
将稳定内容放在前面。将工具定义、系统指令、schema 和示例排在检查点之前。将租户标识符、案例数据和每次请求的问题放在后面。
利用集群流量分摊缓存写入。来自使用同一 agent 的租户的请求可以读取相同前缀,而缓存命中会重置 TTL。对于零散流量,可评估受支持模型上的 1 小时 TTL。
减少可避免的调用。每次调用仍会处理未缓存文档,因此在输出限制和 schema 要求允许时,将连续问题合并处理。
保持前缀字节完全相同。时间戳、请求 ID、租户名称和重新排序的工具定义都可能导致未命中。将所有动态元素移到检查点之后。
监控生产基线。在 CloudWatch 中跟踪缓存读取、缓存写入和总输入 token。对持续低于正常 65% 缓存命中基线的情况告警,而不是使用不兼容的 80% 阈值。
检查特定模型的限制。前缀最小值和 TTL 选项因模型而异。Claude Sonnet 4.5 要求缓存检查点至少为 1,024 个 token。
结论
ArisGlobal 将 EU 地理跨区域推理与针对正确内容的提示缓存相结合。缓存稳定的共享前缀而非每个案例的文档,使有效输入成本降低约 50%,促成了整体月度推理支出约 40% 的节省,并支持企业租户新增约 15% 且成本没有成比例增加。
关键经验是,缓存价值取决于复用,而非大小。对于多租户 agentic 工作负载,重复的共享提示前缀可能比每个案例都会变化的大型文档更有价值。
如需了解更多,请参阅 Amazon Bedrock 提示缓存文档、跨区域推理指南,以及 AWS 博客文章 Effectively use prompt caching on Amazon Bedrock。