 Newshot
文章标题:总是 DNS 出问题,那我们为什么还要自己跑一套?
正文: 这是一个跌宕起伏的故事,讲述我们如何最终替换掉 Route53,转而运行自己的权威 DNS 服务器。
生活改变之前
在某个时刻,我们决定应该能够为客户提供无限量的 basin。basin 是 S2 上的核心命名空间构造,充当 stream(数量本已无限)的顶层容器。我们发现客户在绕开我们每账户 100 个 basin 的(并非那么随意的)限制。这种体验可不怎么样。
就本故事而言,重要的是:客户创建的每个 basin 都会成为它自己的子域名:my-basin.b.s2.dev(与 AWS S3 上 bucket 的工作方式并无不同)。与每个 basin 关联的 DNS 记录是一条 CNAME,它将客户端路由到我们架构中正确的 cell。因此,要支持无限量的 basin,我们就需要支持无限量的 DNS 记录。
这些记录还需要强一致性。当 basin 被创建时,其地址应当可以立即解析,否则客户端就要一直等待缓存的 NXDOMAIN 过期。
一想到要运行自己的 DNS 服务器,我的脉搏就飙升,哎呀!
挂接到现有系统上
我的调研阶段始于希望。希望我们现有的 AWS Route53 DNS 配置能够满足这些新需求。我真的真的不想让我们构建并运行自己的 DNS 服务器。
Route53 是个很棒的系统,看起来可以支持无限量的记录。但是,有一个致命限制:其 API 速率限制大约为每秒最多 5 次 UPSERT(AWS 的节流文档最近有改动,现在的限制可能更高)。
实际上,这是我们通过惨痛教训才发现的。我确实读过文档,但 API 限制并没有引起我的担忧。当一个恶意行为者迅速创建了数万个 basin、占满我们 Route53 记录的全部配额时,问题就暴露无遗了。这产生了需要数小时才能处理完的积压工作,在此期间我们正常的 DNS 更新被卡住,一些进程试图删除记录,而另一些进程则试图添加新记录。不过这确实促成了一次很棒的故障复盘。正是在那时,我们开始强制执行每账户 100 个 basin 的限制。
我们考虑过批量处理这一选项,但那会破坏我们让条目立即可用的目标。而且即便采用批量处理,这套方案也感觉不到“无限”;系统被合法使用时仍有可能触达速率限制。
我们考察过的其他托管 DNS 提供商(GCP Cloud DNS、Cloudflare、Azure DNS)也有类似的限制:如果你通过提供商 API 更新/插入/upsert 记录,就会遇到严重的限流因素。
没有别的办法,只能构建一个自定义的权威 DNS 服务器(双倍的哎呀!)
新的 DNS 系统
技术需求相当直截了当:对于进来的任何 DNS 请求,我们需要查询一份最新的 zone 映射表(它应当能够容纳无限量的记录),并将相应的响应发回给客户端。
为避免同步到独立系统、又多出一个会动的部件,DNS 记录将直接来自我们现有的 basin 数据库。一次实时的 SELECT 会一致地“解析”出 DNS 请求所需的映射。换句话说,我们希望 DNS 只是成为我们现有强一致账户数据库的一个新调用方。
我们的账户数据库位于 Google 的 Cloud Spanner 中,预期性能表现良好(前提是钱给够)。
接下来是核心功能。
我们在基于某个库来构建还是编写一个 CoreDNS 模块之间反复摇摆。最终,基于库的方案感觉是最灵活的一条路,它可以让我们构建非常贴合自身用例的东西。我们是一家 Rust 团队,但决定这个项目用 Go,主要因为 Spanner 的工具链(以及 GCP 生态)相对更成熟。由于 miekg/dns 库出色的文档质量以及它支持的众多 RFC,我们很快就选定了它。
文章标题:总是 DNS 的问题,那我们为什么还要自己运行?
正文: 我们需要能够支持多种记录类型的权威 DNS 查询:A、AAAA、NS、CNAME、SOA。由于我们使用的是库,因此必须自己构建响应。我们的正确性测试聚焦于这些记录类型,包括单元测试、使用 Ferret 进行的 RFC 合规性测试(我们是在这篇很棒的论文中发现的:SCALE: Automatically Finding RFC Compliance Bugs in DNS Nameservers),以及部署后使用实时数据进行的冒烟测试。
S2 为 basin 区域使用通配符证书,并且需要 ACME DNS-01 挑战正常工作。我们决定不在自己的服务器上提供 DNS 挑战,而是通过 CNAME 委托将其卸载到单独的 Route53 区域,以避免调整我们的证书续期系统,同时也不用提供动态 TXT 记录。
随后,我们与一个流行的 AI 系统进行了几次规划会议。设计足够简单,很多事情都很有道理(即使对我来说也是如此),只是建议中不断包含各种额外功能:合并、负缓存、节流、速率限制、DNS cookies 等。对于一个将要在开放而可怕的互联网上实时运行的系统来说,这是意料之中的;不过,这些都是大量被建议的防护措施。
我们越是顺着这条线往下拉……情况就越可怕。DNS 层面可能发生许多类型的攻击,有些是我知道的很可怕的事情,有些则是我从未听说过的。
NXDOMAIN 攻击是最让我们害怕的一种。每一个随机的、不存在的 DNS 查询都会变成一次全新的数据库查询。我们尝试为 NXDOMAIN 构建应用内防御,然而,在我看来,它是最糟糕的 DDoS 攻击,没有什么能够真正阻止它。不妙。
支持 DNS Firewall 的理由
长话短说,对 DNS 基础设施的可能攻击让我害怕的程度超出了我愿意承认的范围。我们开始寻找 DNS 防火墙解决方案。我们确信一定有类似 DNS 服务的反向代理设置。要么这是一个小众设置,要么这就是一个非常危险的世界,但就我们对无限记录和 DNS 反向代理防火墙类型的要求而言,我们只找到了两家公司:Cloudflare 和 Akamai。两者各自都是巨头,都有类似的 offerings(属于没有公开定价的那种)。
几次 POC 之后,我们最终选择了 Cloudflare 的 DNS Firewall 解决方案。我们的 DNS 服务器源站被配置为只允许来自 Cloudflare 已知 IP 的流量,这是一个相当标准的反向 CF 设置(Cloudflare 在前,其他人无法到达源站,否则还有什么意义)。有了这块缺失的拼图,我们现在已经处于最终设计阶段,并准备将新系统投入生产。
作为权威 DNS 服务器,我们必须回复 SOA 和 NS 查询,而这些查询指向 nameserver IP。我们格外小心,确保返回的 IP 始终是 Cloudflare 的 IP,而不是负载均衡器的 IP,其中包括一个 ns-leak-test,确保源站 IP 不会作为某些回归变更的一部分而泄漏。
最终架构
对于最终架构和 HA(是的,故障总会发生),我们在两个独立的 GKE 集群上运行 DNS 服务器(位于不同区域,选择尽可能靠近 Spanner 的位置),每个集群都有多个副本,位于 TCP 和 UDP 负载均衡器之后。
可观测性以及对所有人进行新系统培训是推广的另一个关键组成部分。虽然我认为没有人会再想一想 Route53,也不认为有人会单独监控它(毕竟托管服务是别人的 pager),但我们必须创建告警和 runbook,并配有深夜流程,以便从故障中恢复。
这个设置有一个有趣的部分:解释完整的委托链。主域名由 Cloudflare 在一个常规区域中管理。然后它将 basin 子域名委托给 Cloudflare,但不是委托给一个区域,而是委托给一个服务(DNS Firewall)。该服务随后连接到 GKE。另外 Route53 中还有一个用于证书的区域(祝你能理解那个,Codex)。
这甚至还不是它的最终形态,内部 TODO 包括调整 DNS 缓存以及如何在客户端/DNS Firewall/DNS 应用之间进行恰当优化(再多的 AI 也解决不了这个问题)、未来的 DNSSEC 扩展等等。对于我们没有看到的故障来说,它仍是一个未知系统(或者用我喜欢的思考方式来说,当一切看起来正常时,你如何知道东西出了故障)。
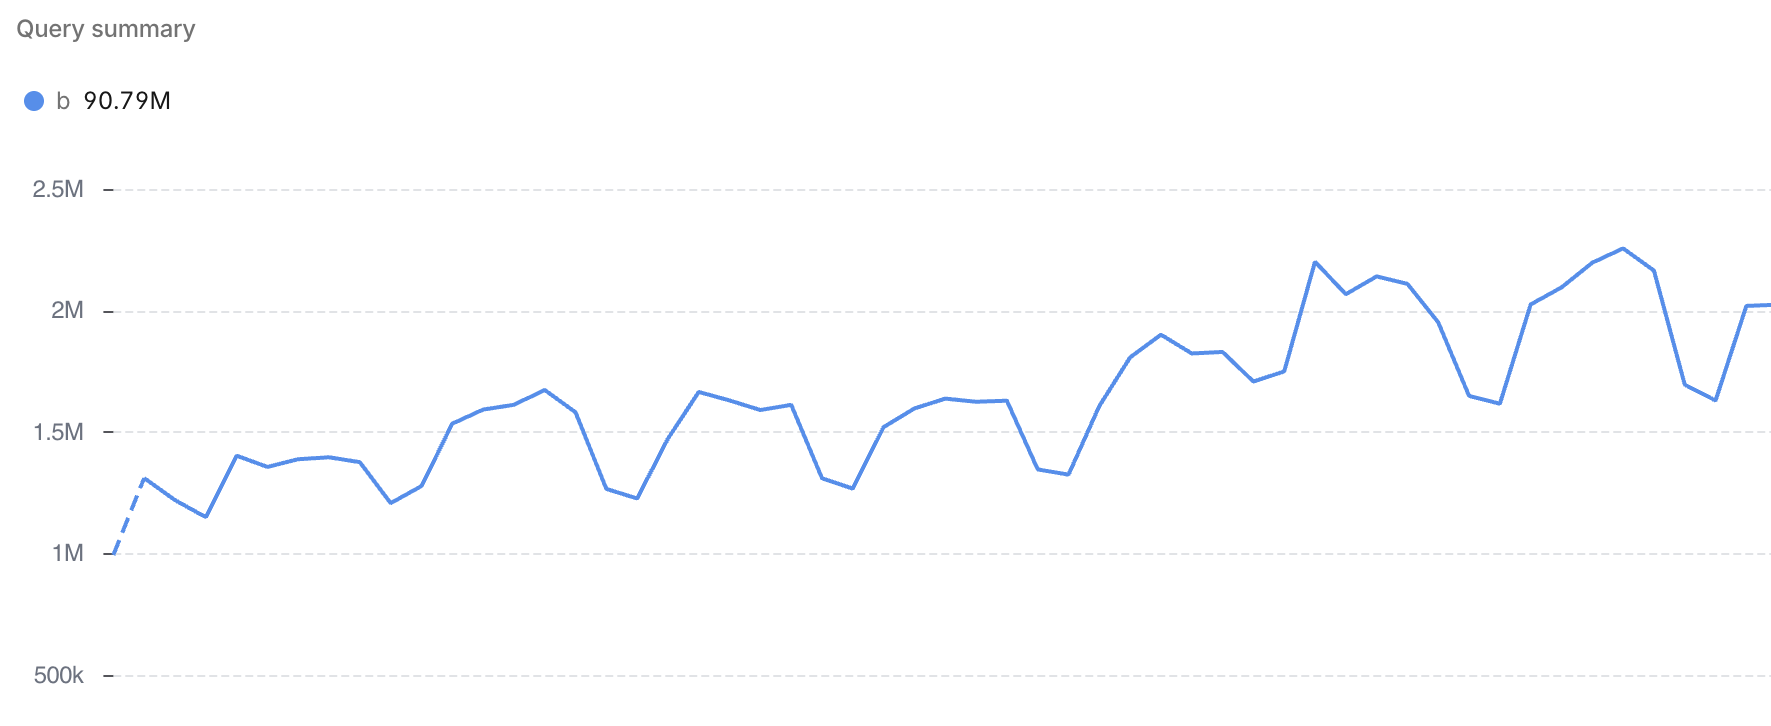
目前,一切都很稳定。看看过去几周的统计,实时流量看起来不错,过去几周的提交历史主要是 CVE 修复、依赖升级和成本节省。我们的客户现在创建了数千个 basin,它们可以立即用于流式传输。
我想我们现在已经到了可以在某次事后复盘中把锅甩给 DNS 的地步了。