 Newshot
我们让 AI 打出 Wombo Combo——Melee 中的协作智能体
Reyn1 和 Reyn2 · 两个 5 级 CPU
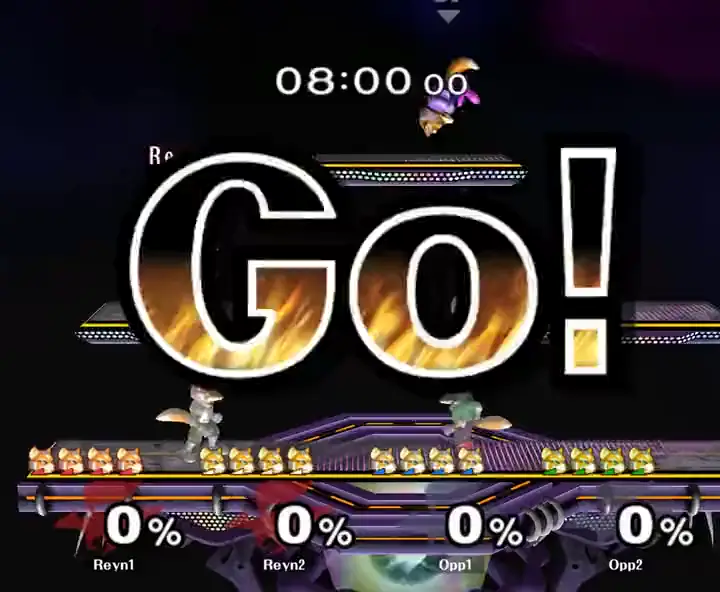
引言
上个月,我们介绍了 Faynt,这是一个能够游玩 Super Smash Bros. Melee 的开放权重模型系列。我们用大约 840,000 份人类回放对其进行了训练,并通过强化学习(RL)对其进行了改进。
Faynt 可以参加一对一(1v1)对局,但我们无法用命令引导它。如果它也能进行二对二(2v2)呢?
再进一步,如果它能成为一个可由语言引导的玩家,让你在 1v1 和 2v2 中都能实时协调呢?
- 它在执行你的命令时还能继续反击吗?
- 它能与人类玩家协调吗?
- 友军伤害呢?它会如何避免击中队友?
登场的是 Reyn 26C,这是我们对 Faynt 的语言可引导进化版。我们从 Fox 开始,扩展到四个角色,现在用一个共享模型引导全部 26 个角色。Reyn 4C 在下面的比较中仍是开发基线。我们的 Fox 团队和连招实验室是分开的实验。
在开场视频中,我们让两个 Reyn 智能体对战两个游戏内机器人。每个智能体都会收到自己的引导命令,命令显示在其角色上方,并实时调整其打法。第二部分是单独的连招实验室接力。两者都是精选示例。
在本文中,我们将深入介绍我们如何创建 Reyn,包括:
- 语言引导:从 1v1 对局开始的预训练和 RL。
- 语音:一个对话管线将语音转换为给 Reyn 的命令,并生成关于游戏的口语回复。
- 2v2:将引导带入团队对局,并处理友军伤害。
- 附加:训练一个 Wombo Combo 2v1 模型,纯属娱乐。
引导:Reyn 26C 在原始命令套件上对阵镜像 9 级 CPU。团队对局和队友伤害结果来自单独的 Fox 实验;后者使用人类代理。
目标
我们正在构建什么
- 构建一个可以用自然语言引导的 Melee 模型。
- 推动小模型能做到的事情,并将引导扩展到全部 26 个角色。
- 让模型在执行你的命令时仍能继续反击。
Reyn 不打算做什么
我们不是要构建一个最具竞争力、不惜一切代价取胜的 Melee 机器人,也不是要构建一个独立的语音伴侣。目标是成为一个仍能战斗、同时响应人类指令的队友。
我们从 Fox 开始,以让最初的引导实验保持简单,然后扩展到四个角色。为了覆盖完整角色名单,我们尝试复用那套玩法栈,并教它的文本路由器处理更多请求。这就成了 Reyn 26C。它能处理覆盖完整角色名单的特殊招式请求,尽管质量仍因角色而异。实验性的 2v2 分支目前使用 Fox。
计划是让 Faynt 可被引导,将这种引导带入 2v2,然后朝着成为人的搭档这一目标构建。
从语言引导开始
我们首先给 Faynt 加入语言引导,并尽可能减少游玩强度的损失。
在执行命令的同时继续战斗
要求抓取、移动到某处或停止攻击的请求,会改变哪些动作是有用的。我们希望这些请求能改变 Reyn 的行为,同时又不让它在游戏中变得低效。为了教会这些行为,我们从 Faynt 的权重开始,并在人类回放中加入语言标签。称为谓词的规则会识别动作或情境,并将它们与匹配的指令配对。给定一条指令和对局历史,Reyn 学习从回放中预测控制器动作。这个模仿阶段会一起训练策略网络、交叉注意力适配器和原始文本编码器。
当被要求 Grab him. 时,它尝试了更多抓取,但很少有命中的。随后我们使用 RL 来奖励成功命中的抓取。
我们让 AI 打出了 Wombo Combo——Melee 中的协作智能体
RL 还让我们可以奖励击中对手或到达指定平台。它让模型练习在标注回放中代表性不足的行为,例如移动到平台。模仿将指令与动作连接起来;RL 改善这些动作所达成的结果。
使用 RL 进行后训练
我们在 Reyn 4C 中开发了游戏玩法技术栈。模仿学习之后,我们冻结了拥有 10 million 个参数的游戏玩法策略,并用 RL 训练其交叉注意力适配器、指令嵌入、状态适配器和嘲讽头。状态适配器读取 16 个游戏特征;嘲讽头增加了一个冻结策略无法产生的输入。此阶段训练了约 2.2 million 个参数。在没有指令时,转向组件会被绕过。
我们用近端策略优化(PPO)训练这些部分。Kullback–Leibler(KL)散度衡量两个策略在同一游戏情境下为动作分配概率的差异程度。我们使用 KL 惩罚,在学习教育请求行为的同时,抑制其与无指令策略产生过大变化。专家模型学习成组的指令,然后通过蒸馏将它们学到的内容合并到一个模型中。随后,Reyn 4C 模型在所有六个阶段上接受了一轮联合 RL。
对于 Reyn 26C,我们固定这些游戏玩法权重,仅针对整个角色名单上的请求微调文本路由器,包括用不同方式请求同一招式。它学习这些词语指的是哪个受支持的指令。这一监督训练与教游戏玩法响应的 RL 是分开的。
图表:Reyn 在 RL 后如何游玩 Open vertical diagram
横向滚动以查看完整图表。
图表:Reyn 如何训练
横向滚动以查看完整图表。
设计奖励
在编写奖励之前,我们决定了什么才算遵循指令。一个测试需要可观察的行为、成功阈值,以及与无指令情况的比较。然后我们将循环自动化:提出奖励、训练专家模型、检查基准和回放,并修订奖励。Fire Fox 说明了为什么这个循环很重要。其他专家模型也经历了类似的迭代,奖励针对它们的指令量身定制。
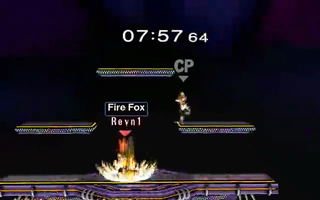
Fire Fox 会把 Fox 发射出去,因此瞄准不佳的发射可能白白丢掉一条命。我们的第一个专家模型能命中,但也会自毁。我们提高了自毁惩罚,结果它开始避免使用 Fire Fox
我们让 AI 打出 Wombo Combo——Melee 中的协作智能体
Fire Fox 是一个专家示例。我们将这些专家蒸馏进 Reyn 4C,并用联合 RL 对其进行改进。后来的路由器更新产生了 Reyn 26C,它在 424 个原始套件案例中有 386 个至少满足较宽松的目标:267 个满足更严格的目标,119 个仅满足较宽松的目标。下面的比较展示了两个等级。
自然语言
为了告诉 Reyn 要做什么,我们首先想要一条从词语到命令的小而快的路径。在 Reyn 4C 开发期间,谓词标注的预训练使用了一个 6 亿参数的文本编码器,旁边是一个 1000 万参数的游戏策略。对每个请求运行该编码器会增加延迟,并使语言机制远大于玩游戏的模型。
一个更小的路由器识别请求并选择一个存储的命令嵌入。Reyn 26C 扩展了该方法,使用在更多角色招式和多样措辞上训练的路由器。它复用 Reyn 4C 的游戏权重:额外的角色覆盖来自语言路径,而不是又一轮游戏 RL。在额外的纯文本措辞测试中,在 208 个生成测试行中,它正确路由了 100%。
更小的语言路径
随后我们尝试了更紧凑的命令表示和更轻量的路由器。每种设置都经过相同的 424 个测试用例,使用留出的措辞。问题很实际:在不失去命令跟随能力的情况下,我们能削减多少大小和请求时间?
在 Reyn 4C 开发实验中,较小路由器设置将文本侧文件从 164.1 MB 削减到 28.8 MB。在这个留出措辞基准上,它在 88.2% 的案例中至少满足较宽松的命令跟随目标,而原始设置为 88.4%。文本请求时间中位数从 13.84 ms 降至 4.09 ms。将命令表示压缩为单个 token 会损害命令跟随。
语音交互
路由器可以快速将“Move left”转换为游戏命令。借助更大的语言模型,Reyn 可以超越“Moving left”:回答关于比赛的问题、跟上对话,或在失误后给出俏皮的吐槽。
对于这种交流,对话流水线用更大的语言模型取代路由器。语音识别提供词语;模型结合对话历史和近期游戏上下文来读取它们。它可以在回复中发出受支持的命令,或者只是说话。任何命令在到达 Reyn 的游戏策略之前,都会针对当前角色和舞台进行检查。
语音合成将回复流式返回。“Moving left”说明 Reyn 打算做什么;执行反馈提供失败和观察到的结果。

下面的视频展示了我们早期的一个原型,使用预先准备好的合成语音、语音识别和一个路由器。
Reyn1:无命令
预先准备的合成语音
Reyn1 · CPU (CP)
从四个角色到 26 个:发生了什么变化?
我们将 Reyn 的语言操控扩展到整个角色名单。在这里,两个模型在全部 26 个角色上面对相同的特殊招式请求,包括 Reyn 4C 操控训练之外的角色。
*图表:我们的测试使用 Pokémon
更广泛的单打模型没有回答团队配合的问题。在一个独立的 2v2 分支中,我们基于 1v1 模型,训练了一对 Fox 用于团队对战。每个 Fox 都有一个可能被自己误伤的搭档,因此打得好也意味着给搭档留出行动空间。我们在快速模拟器 melee-sim-light 中对抗两个 Faynt 副本进行训练,然后在真实游戏中检查这对组合。除非标注为模拟器,下面的结果都是真实游戏中的测量值。
我们的 2v2 工作仍处于实验阶段,需要进一步改进。最终目标是让一个人加入队伍。
团队对战的方法
在冻结策略旁使用适配器曾在语言引导中奏效。我们把同样的想法用于 2v2,目标是通过更新更少的参数让训练更快、成本更低。首先是一个能看到全部四名战斗者的团队适配器,然后是一个目标选择器。两者都没有带来明显收益。团队适配器在预注册的模拟器测试中胜率为 51.7 %;选择器很少改变决策。训练所有策略参数效果更好:得到的组合在 160 场对抗两个 Faynt 的真实游戏中赢下 84.4 %,而未训练的组合为 56.2 %。
选择一种方法,查看它训练什么、什么保持冻结。
在 2v2 中放入 Faynt 的四种方式
Faynt 只能看到自己和一名对手,没有针对队友或第二名敌人的直接输入。它的状态编码器、因果 Transformer 和动作头构成一个策略。在 2v2 中,必须告诉每个 Fox 该看哪个敌人。
每个 Fox 为每个敌人保留一份记忆。最近敌人规则选择一个隐藏状态;适配器将其与当前团队特征结合,并在冻结的动作头之前加入一个残差。由于 KL 惩罚使其贴近 Faynt,这种方法的结果一直停留在五五开。
把协调定义为谁攻击谁,而战斗交给 Faynt。目标头读取两个敌人各自的历史和团队特征,然后选择使用哪个候选动作。这个选择几乎没有偏离初始先验,也从未改变决策。
我们这对组合拥有自己的可训练 Faynt 副本,因此学习可以改变每个 Fox 在搭档附近战斗的方式。冻结的原始版本则分别用于评估对手的打法和作为 KL 参考。KL 在学习者的决策上比较两个策略。这就是奏效的方法:本文中的这对 2v2 组合。
在曲线上选择一个标记,查看训练到该点时在模拟器中的胜率。
比较多智能体 RL 算法
我们使用相同的训练设置和每个 19.7 million 个模拟器帧,比较了四种多智能体 RL 算法。它们在策略共享、critic 输入以及如何复用一批经验上有所不同。critic 在训练期间估计期望回报;在游玩时,每个 Fox 根据自己的观察行动。除了多智能体近端策略优化(MAPPO)和独立近端策略优化(IPPO),我们还测试了异构
图中为 adapter 运行所绘制:每个 Fox 的骨干网络保持冻结,只训练一个小型 adapter,每批四个 pass。当所有权重都参与训练时,整个网络连同 adapter 一起训练,pass 数更少;各算法之间的差异保持不变。数据来自我们的团队协同研究。
各算法的胜率
模拟器中,每次运行训练 1970 万帧,所有运行都在同样的对局上读取结果。柱形表示某算法的均值,圆点表示一个训练种子;虚线代表五五开。
在真实游戏中,只有小型 adapter 参与训练。各次运行在约 270 万帧处停止,胜率来自它们自己的训练对局,因此只反映早期趋势。
MAPPO 在三个种子上平均为 82.8%。IPPO 在单个种子上得到 79.3%,落在 MAPPO 跨种子 10 个百分点的区间内,因此这一比较无法可靠地区分二者。HAPPO 与单 pass 变体分别落后 MAPPO 约 11 和 15 个百分点。在更早的真实游戏仅 adapter 运行中,没有任何算法明显优于将 adapter 保持为零。
操控两个智能体
我们为 2v2 组合加入了操控 adapter,可以为每个 Fox 分别下达指令。在真实游戏中对阵两个 Faynt,无论只操控一个 Fox 还是两个都操控,12 条测试指令中有 10 条得到执行。没有指令时,adapter 会被绕过。
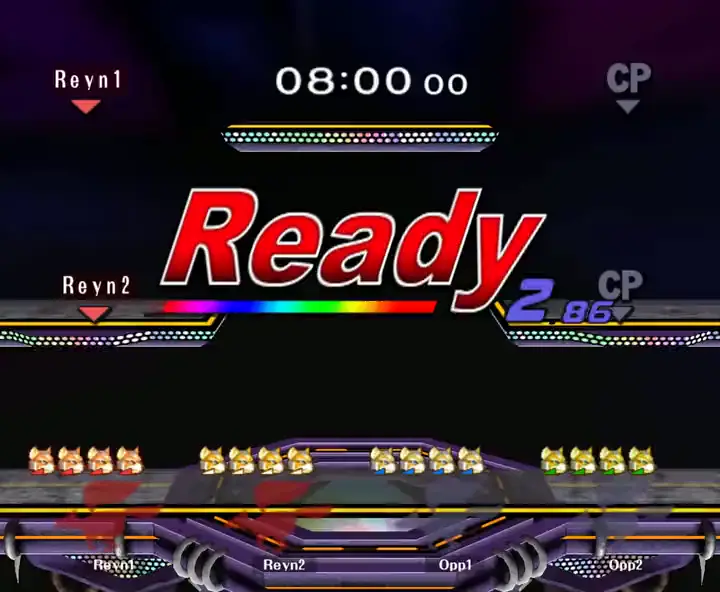
片中每个 Fox 当前生效的指令显示在其上方。
Reyn1 与 Reyn2 · 两个 5 级 CPU
避免误伤队友
分别下达指令让我们可以指挥每个 Fox,并指定要追击的对手。为了朝“成为人的搭档”这一目标推进,我们还必须降低它击中队友的频率。我们在 2v2 策略的基础上构建,但加入误伤惩罚后,每一次受惩罚的运行都变得消极:机器人整体攻击更少。
在没有掩码的情况下,它在真实游戏中对队友每分钟造成 56.2–62.8% 的伤害。在模拟器中,受惩罚的机器人与一个模仿训练的人类代理并肩作战时,胜率不到普通 2v2 策略与同样代理搭档时的一半,而队友在机器人总伤害中所占的份额基本不变。
随后我们在对局时加入了动作掩码,利用 Fox 的碰撞箱数据,否决被预测会击中队友的拟议动作。
柱形比较的是不同搭档配置对阵两个 9 级 CPU 的结果;标签中的 filter 即动作掩码。带掩码训练并未带来明显的真实游戏收益。
延迟或移动中的碰撞箱仍会漏过,主要是上猛击、后空和 Fire Fox。掩码只在动作开始时进行检查。
附赠:Wombo Combo
我们还单独训练了一对机器人,把一名对手留在连招中。我们统计的是发起或延续一段连贯连招的动作,且后续命中要在对手能够再次行动之前落地。同一动作的多段命中以及同一机器人近期的重复不计入。
静止目标 · 普通伤害 · 关闭误伤
最早的长连招几乎都发生在一个点上:两个机器人站在一起攻击。让它们把对手来回传递需要更多工作。更严格的传递规则降低了它们的得分,而仅靠奖励变化并没有让机器人分开站位。我们在训练的部分阶段加入了一个脚本教师,并配合 RL 使用模仿损失。一次命中之后,教师会把攻击者移回其位置,帮助这对机器人学会交接。后来的教师帮助引入了仅靠奖励学得太慢的动作,包括从上方使出的下空。教师只在训练中使用;机器人在每一场计分对局中都没有它们参与。
Mario 和 Yoshi 在两个训练种子中,于正常规则下对 Bowser 形成了一套可重复的流程。但 Bowser 什么也没做。让这些组合对阵能够行动的对手,暴露了限制。把实心 level-9 CPU 柱与不活跃对手的轮廓相比:在展示的全部八个流程中,每局最佳连招中位数下降到不活跃对手结果的一半或更少。改用脚本化逃脱者后也显示出同样的模式。
对阵活跃对手进行训练有帮助。两只针对逃脱者训练的 Fox,在对阵从未训练过的 level-9 CPU 时,达到每 stock 计数招式中位数 11–11.5。不活跃对手基线只保留了 13 个中的 5 个。针对逃脱者训练的 Fox 仍会在追对手到场外时损失许多 stock。
结论
我们从一个会战斗的模型开始,并问能否给它指令,然后与它并肩游玩。Reyn 现在能在对局中执行许多测试过的请求。单独的 Fox 团队实验改善了团队结果,游戏时动作掩码减少了友军伤害。伙伴的连招暴露了下一个问题:策略很少加入。可靠的人类团队合作仍是目标。
我们学到了什么
- 带标签的回放预训练把词语与动作连接起来;RL 改善了已测试招式的结果。
- 将指令与无指令基线进行比较,帮助我们为所请求的行为设计奖励。
- 冻结策略旁的适配器可用于引导。在我们的 2v2 比较中,训练所有策略参数比仅使用适配器效果更好。
- 多智能体近端策略优化(MAPPO)和独立近端策略优化(IPPO)在我们的 2v2 比较中很接近。
- 友军伤害惩罚让我们的策略变得被动。在这些实验中,游戏时动作掩码更有效地减少了队友伤害。
- 回放复盘暴露了奖励总分所掩盖的奖励作弊行为。
我们失败的地方
Fire Bird 仍会打空
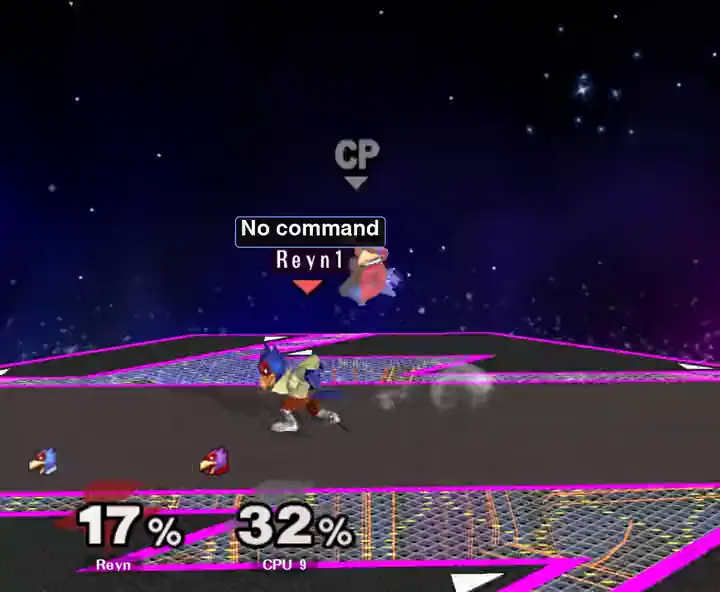
我们的测试对从场上起始的 Fire Bird 飞行进行计分。在一次针对 Final Destination 上 Reyn 4C 对阵 level-9 CPU 的集中读取中,32 次持续指令测试里有 10 次计分飞行命中。该片段展示的是保持时长的中位数:它反复尝试该招式,但没有任何飞行命中。
Reyn(Reyn1 tag)· level-9 CPU(CP)
掉下边缘
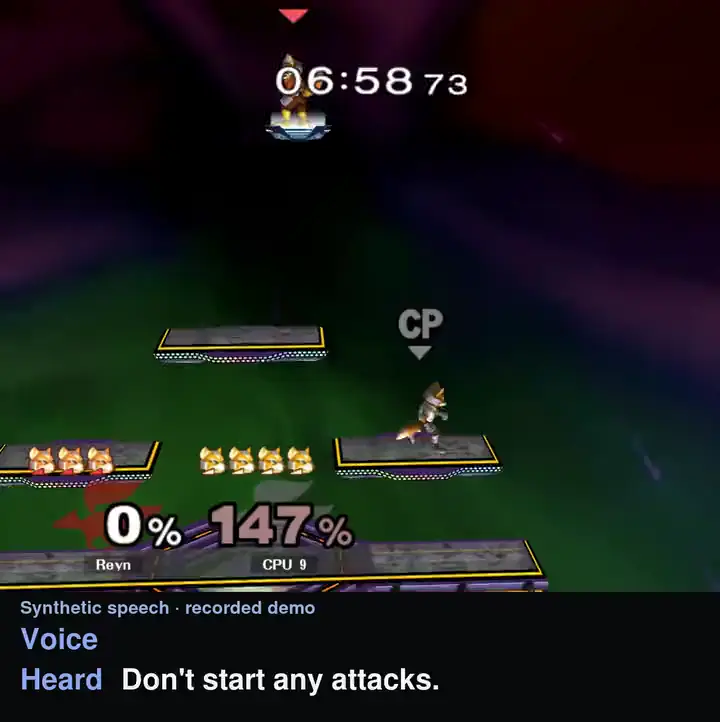
在右边缘请求激活时,Reyn 回到场上,然后没有再次受击就掉了下去。这段摘录来自另一场录制的对局。
Reyn1:“不要开始任何攻击。”
听到:“不要开始任何攻击。”
Reyn1 · CPU(CP)
钻边缘奖励的空子
较早的边缘奖励鼓励跳下并反复抓边,而不是进行有用的回场。观看回放暴露了奖励总分所掩盖的行为。
局限
Reyn 可以对全部 26 个角色接受指令,但支持仍不均衡。对于 Mewtwo 和 Zelda 等角色,特殊招式指令仍不可靠。
有一些团队配合,但主要是个人技术
有一些团队配合的迹象,但 2v2 的收益仍有很多来自每只 Fox 的个人技术。奖励交接没有帮助:两只 Fox 都挤向同一个对手。
三个招式仍会打到你
up-smash、back-air 和 Fire Fox 会绕过动作掩码,而该掩码只在招式开始时检查。
可能的未来工作
- 跟进人的连招仍是一个目标。当你开始连招时,伙伴很少加入,跟进也没有达到我们设定的标准。
- 这对组合需要在面对两个 Faynts 时更可靠地执行指令。我们的假设是,强对手留下的时间和空间太少,无法执行指令。
我们让 AI 打出 Wombo Combo——Melee 中的协作智能体
- 改善全角色阵容中不均衡的指令质量,并将更广泛的角色支持引入 2v2。当前的 Reyn 26C 版本和 Fox 团队分支仍保持独立。