 Newshot
文章标题:我的探索:让原生 Three.js 的画面质量媲美 AAA 游戏引擎
正文: 本文是进度报告:以第二部分推荐的管线为基准,逐阶段对照 Three.js 进行测量。
它沿用第一部分的照明术语:间接漫反射与镜面反射、光源、覆盖、SSR 和 SSGI。并新增五个术语:
- BRDF:材质的着色函数:表面如何将入射光转化为你所看到的光。
- G-buffer:可见表面的逐像素图像(深度、法线、粗糙度),供屏幕空间效果读取。
- TRAA:时间抗锯齿;每一帧都与重投影后的前序帧混合。
- TAAU:带升采样的时间抗锯齿;累积方式相同,但场景以低于输出分辨率渲染,历史缓冲保持在输出分辨率。
- PMREM:为每个粗糙度级别预先模糊的环境贴图,Three.js 正是以此从 cubemap 照明。
管线
管线分为两部分。设置阶段填充三个缓存:静态网格的 lightmap、移动物体的光照探针网格,以及每个房间的反射探针。
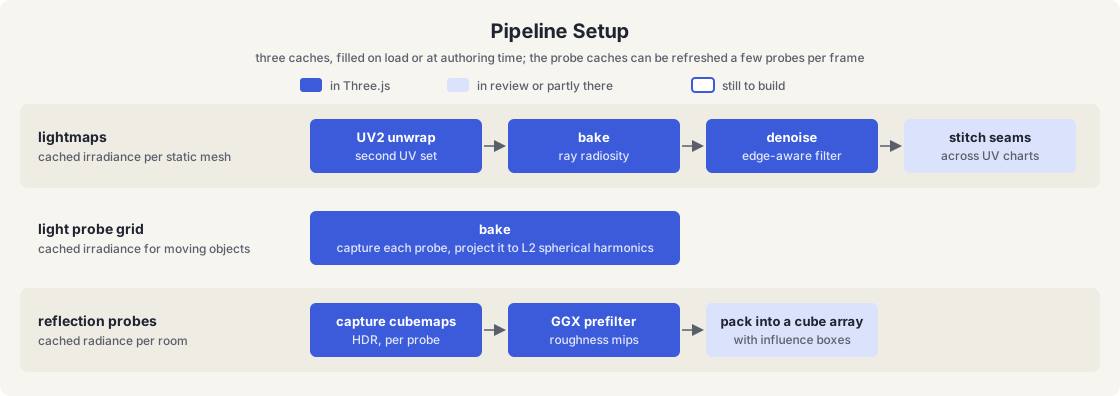
设置阶段:三个缓存。Lightmap 工作量最大,探针网格则是单次烘焙。实心步骤今天已在 Three.js 中;着色步骤正在审核中。
随后每一帧读取这些缓存,并在其上叠加屏幕空间工作:
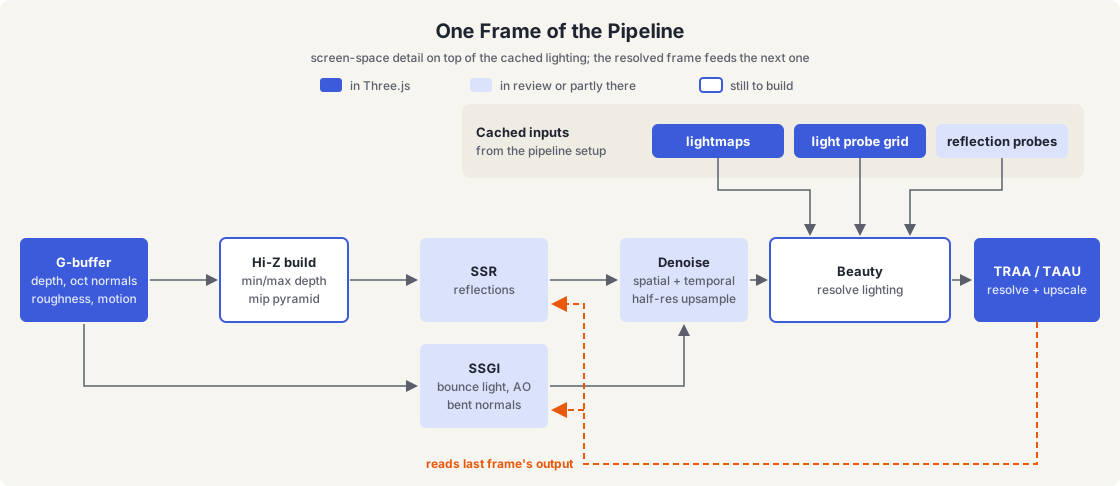
管线的一帧。实心阶段今天已在 Three.js 中,着色阶段正在审核或部分完成,描边阶段仍有待构建。TRAA 的输出,或在升采样时 TAAU 的输出,会馈入下一帧的 SSR 和 SSGI。
现状
以下是每个阶段与游戏所需效果的对比。每一行都在下文各自章节中说明:
| 阶段 | Three.js 中已有 | 审查中或草拟 | 仍需构建 |
|---|---|---|---|
| G-buffer | MRT prepass | Octahedral normals | |
| 烘焙 GI | lightMap , unwrapper , baker , ray radiosity , denoiser , HDR JPEG XL | 接缝缝合 , KHR_lightmap (草稿) | glTF JPEG XL 与 UltraHDR 扩展,运行时 BC6H |
| 动态 GI | LightProbeGrid , 快 8 倍的烘焙,多重反弹,更新分散到各帧 | DDGI 可见性 (草稿) | — |
| 遮蔽 | GTAO, builtinAOContext , 来自 SSGINode 的 AO | Bent normals 与 GTSO (草稿),联合双边上采样 (草稿) | 来自 SSGINode 的 Bent normals |
| SSR | 随机 GGX SSR,时间累积,多重反弹 | 前一帧追踪 | Hi-Z 追踪,覆盖范围输出,时空 SSR 降噪器 |
| SSGI | SSGINode , 一次水平搜索得到反弹光和 AO,合成到最终图像之上 | 前一帧追踪 (草稿) | 覆盖范围输出,BRDF 的漫反射来源 |
| 反射探针 | 单盒投影环境贴图,PMREM | 探针系统 (草稿),立方体数组 | 探针归一化,128² 预滤波 |
| BRDF 积分 | AO 上下文,环境回退 | — | 可插拔的间接镜面与漫反射,覆盖级联 |
| TRAA 与 TAAU | TRAA 节点,TAAU 节点 | Catmull-Rom 历史 (草稿),静止时更宽的裁剪与测试框架 (草稿) | 完整管线中的 TAAU,纹理 mip 偏移,移植到 TAAU 的 TRAA 改进 |
最大的剩余差距在 SSR、SSGI 和 BRDF 这几行:SSR 的 Hi-Z 追踪与覆盖范围,SSGI 的同样覆盖范围,以及最重要的、把两个级联都接入 BRDF 的可插拔间接光照。其余的一切都已在 Three.js 中、在审查中或已草拟。
进展之所以这么快,是因为 Three.js 的维护者们。Michael Herzog(@Mugen87)审查了这些 PR 中的大多数,并且不止一次将其改造成更契合 Three.js 整体构建方式的设计,调整渲染器内部结构为其腾出空间。mrdoob 对其中许多表达了强烈支持。我非常幸运能同时拥有这两位。
不过到目前为止,这些部件都是逐个提出、逐个审查的,各自依据自身的优点。没有人被要求为整体背书。本系列是我尝试将它们拼成一幅连贯图景的努力,以便每个 PR 不仅能依据它做了什么来评判,也能依据它处在什么位置来评判。
管线,逐阶段
本文剩余部分将逐阶段走过一帧。对每个阶段,它都会问三个问题:游戏需要什么,Three.js 已经有什么,以及缺什么。第三个问题的答案,就是工作所在。
G-buffer
游戏需要什么。SSR、GTAO 和降噪器都在光照之前的屏幕空间中运行,因此它们需要对可见表面的逐像素描述:一个 G-buffer。延迟渲染引擎会存储光照所需的一切,包括基础色和自发光,因为它的光照阶段只读取 G-buffer。像 Three.js 这样的前向渲染器在这里有一个优势:beauty pass 直接对每个材质着色,因此 G-buffer 只需要屏幕空间阶段读取的内容。
| 值 | 最小位数 | 读取者 |
|---|---|---|
| 深度 | 24 | 一切;Hi-Z 金字塔的来源 |
| 法线 | 2×12(八面体) | SSR 光线方向,GTAO,降噪器 |
| 粗糙度 | 8(感知) | SSR 波瓣与粗糙度淡出,降噪器核大小 |
| 金属度 | 1–8 | 非金属上的 SSR 淡出 |
| 材质标志 | 2–8 | 在天空、水、透明物上遮蔽 SSR |
| 运动矢量 | 2×16 | TRAA,SSR 命中重投影,降噪器历史 |
基础色、自发光和材质 AO 贴图不在列表中:beauty pass 直接从材质读取它们。
Three.js 有什么。WebGPURenderer 已经用多个渲染目标渲染 G-buffer prepass,SSR 示例今天就在使用它。法线打包进 RGB8,粗糙度在 alpha 中,基础色与金属度在第二个 RGBA8 目标中,速度在第三个中:
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。请完全按照书写的样子使用它们,在回复中和在工具调用中都是如此:它们会在任何东西运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
        const scenePass = pass( scene, camera );
scenePass.setMRT( mrt( {
	output: output,
	diffuseColor: vec4( diffuseColor.rgb, materialMetalness ),
	normal: vec4( packNormalToRGB( normalView ).rgb, materialRoughness ),
	velocity: velocity
} ) );
机制已经存在。缺口在于布局与法线精度。
G-buffer 结构与内存
一个覆盖上表的布局,由三个渲染目标加深度组成:
| 目标 | 格式 | 字节/像素 | 内容 |
|---|---|---|---|
| Depth | D32F,reversed-Z | 4 | 深度 |
| Normal | RG16 snorm(RG16F 回退) | 4 | 八面体法线 |
| Material | RGBA8 | 4 | 粗糙度、金属度、标志位、保留位 |
| Motion | RG16F | 4 | 屏幕空间速度 |
| 总计 | 16 |
按 AAA 标准,每像素十六字节算是精简的。延迟渲染引擎通常要花 20–28 字节,因为它们还会存储基础色、自发光和烘焙光照。
不过 G-buffer 并不是唯一的屏幕尺寸内存。其余帧内容还包括半浮点 beauty 目标(8 B)、TRAA 历史与输出(16 B)、用于重投影的上一帧深度(4 B)、SSR 的 Hi-Z 金字塔(含 mip 约 5 B)、半分辨率 SSR 工作集(6 B)、半分辨率 SSGI 工作集(其中也包含遮蔽,加上其读取的重投影上一帧,总共约 5.5 B),以及场景分辨率上采样后的 SSR 与 SSGI 结果(合计 15 B)。这使得所有效果全开时的规划预算约为每像素 76 字节:1920×1080 下约 157 MB,4K 下约 626 MB。第 2 部分给出了这些数字背后的计算器链接,其中包含 TAAU 和较低档位的示例。这些是针对拟议级联与简单滤波器的估算,并非当前 addons 的实测分配。上采样目标也包含在这份清单中。半分辨率效果仍然需要深度与法线感知的上采样,以免反射和遮蔽在物体边缘处渗色。我已将这个滤波器草拟为 jointBilateralUpsample();更多细节见下文关于遮蔽的部分。
法线精度
如今 Three.js 存储得过于粗糙的字段就是法线。SSR 对法线误差毫不宽容:从稍有偏差的法线反射出的射线,在长距离追踪的终点会落在明显错误的地方。使用 RGB8 法线时,平滑曲面会突然跳到一组有限的量化方向上,其反射会呈现色带和聚集。
AAA 的 G-buffer 用八面体编码解决这个问题:把方向球面折叠到一个八面体上,展开为正方形,然后存储两个坐标。在 Cigolle 等人调研的编码中,以同等大小而言它是最精确的。我们已在 PR #35480 中向 Three.js 添加了 packNormalToOctahedral() 和 unpackOctahedralToNormal():
| 编码(4 字节/像素) | 平均误差 | 最大误差 | 可用性 |
|---|---|---|---|
| RGB8(当前) | 0.17° | 0.38° | 所有设备 |
| Octahedral RG16F | 0.011° | 0.040° | WebGPU 下所有设备 |
| Octahedral RG16 snorm | 0.0013° | 0.0037° | 93% 的 WebGPU 设备 |
在同样的四字节下,半浮点精度提高了十五倍,snorm 则提高了一百倍以上。目标是 RG16 snorm,RG16F 作为回退。
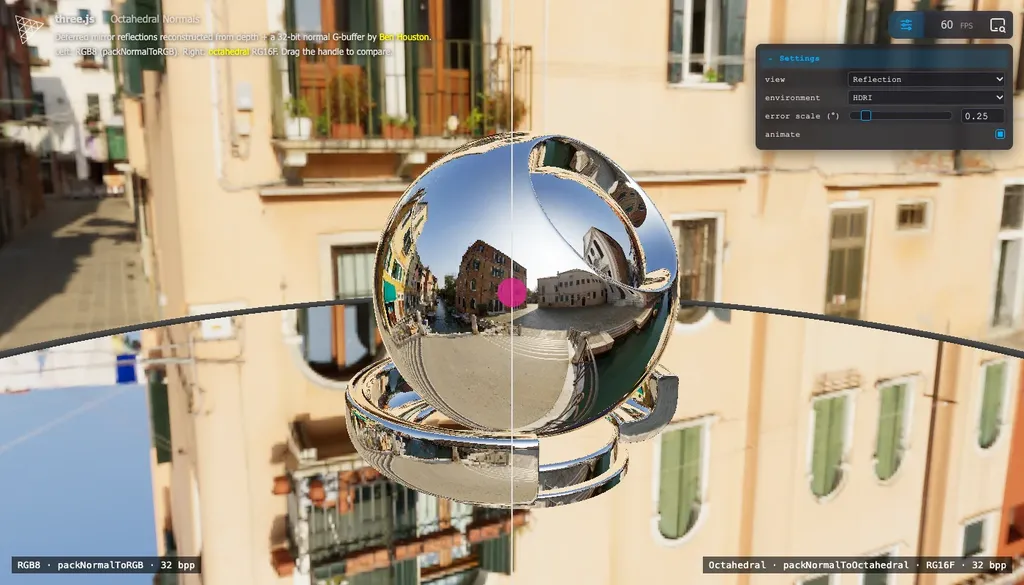
从 RGB8 法线(左)追踪出的反射出现色带;八面体 RG16F 法线(右)是平滑的。
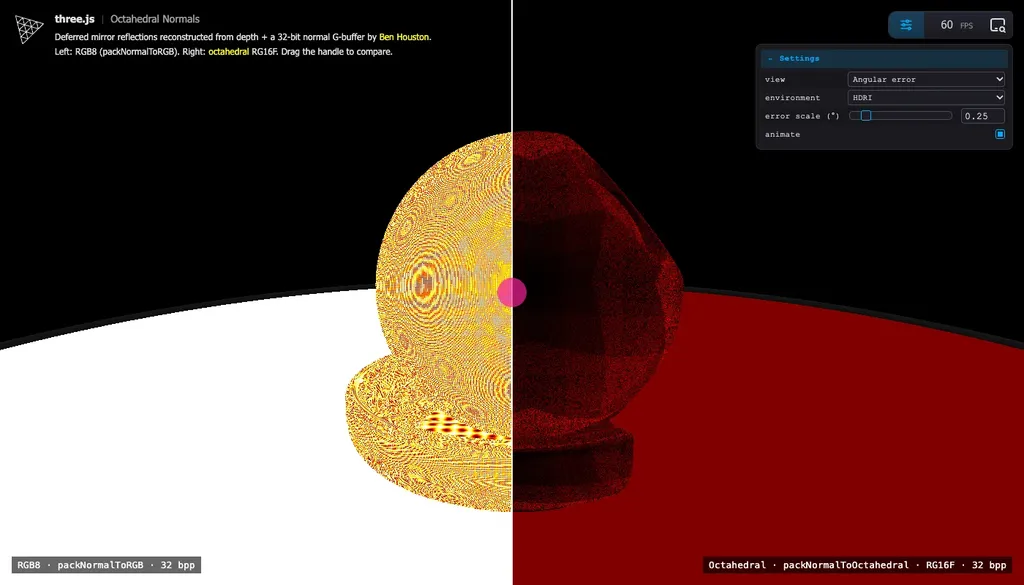
存储法线的角度误差:RGB8(左)与八面体 RG16F(右),同一比例尺。
全局光照
游戏需要什么。来自调研:
- 为所有不移动的物体把反弹光烘焙进光照贴图。
- 一个用于照亮动态物体的探针体积,理想情况下不会穿墙漏光。
光照贴图。运行时这一侧在 Three.js 中已经存在多年:每个标准材质都接受一个 lightMap,从第二套 UV 读取。缺少的是制作光照贴图所需的一切:一个展开器、一个烘焙器、一个值得使用的求解器,以及一种存储和发布结果的方式。这些如今加在一起,构成了一条在浏览器中运行的完整烘焙管线。这个话题足够大,以至于它有自己的文章,第 4 部分《为 Three.js 添加稳健的光照烘焙》。
光照探针。对于动态物体,LightProbeGrid 在场景中放置一个探针网格,每个探针以 L2 球谐函数存储入射光,并用周围的探针照亮每个物体(示例)。它运行良好;限制在于一次捕获需要多长时间。
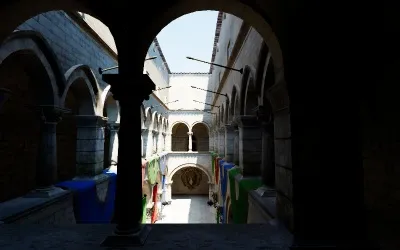
由 LightProbeGrid 照亮的 Sponza。
探针捕获速度。批量化探针捕获让 LightProbeGrid 快了四倍,之后的改动又将其翻倍:它现在的烘焙速度大约是九月初的八倍,并支持多次反弹的光照。性能分析显示,烘焙受限于 CPU 提交渲染通道,而不是 GPU,因此批量捕获使用一个阵列相机每通道渲染八个探针:分辨率 12 的网格从 5.6 秒降至 1.2 秒。精确积分球谐函数还将其误差从 2.4% 降至 0.08%。第二次翻倍来自针对各自的子相机对每个绘制进行剔除。
探针漏光。墙一侧的探针可以照亮另一侧的物体,于是暗房间会被隔壁明亮房间的光照亮。DDGI 的解决办法是,为每个探针存储每个方向上到最近表面的距离,并忽略那些看不到被照亮点的探针。LightProbeGrid 的 DDGI 风格可见性加权以草稿 PR 的形式工作。对全部八个周围探针测试可见性在每个像素上开销很大,因此该草稿可以改用四面体插值,它只混合四个。在 Sponza 上,这增加约 10% 的渲染时间,而八个探针会增加 30%。
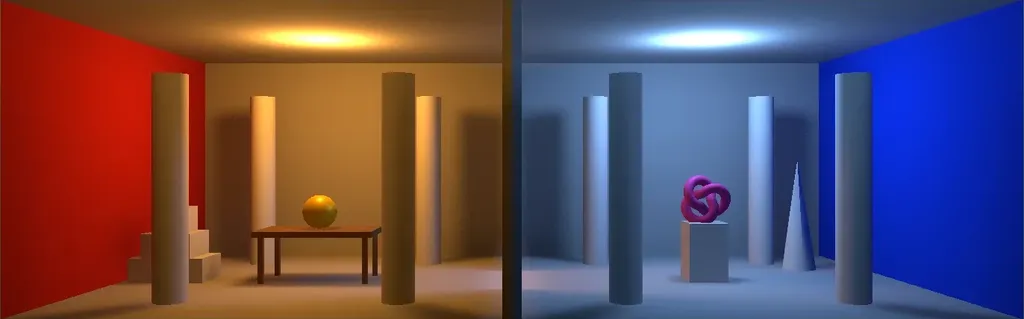
探针可见性加权:暖色房间和蓝色房间不再透过墙互相照亮。
环境光与镜面遮蔽
游戏需要什么。光照贴图对于接触阴影来说太粗糙,而且它们对动态物体一无所知。游戏在其上叠加屏幕空间遮蔽,而 Activision 的 GTAO 是标准。它还会产生一个弯曲法线,即平均开放方向,由此给出镜面遮蔽(GTSO):指向表面褶皱内部的反射被遮蔽,指向开口外的反射则不被遮蔽。
GTAO 通过在每个像素周围的地平线搜索深度缓冲来找到遮蔽。基于地平线的 SSGI,即 Three.js 所拥有的,运行同样的搜索并沿途收集它找到的光,因此一次通道同时返回两者。因此,该管线从不将两者并排运行:开启 SSGI 时,它的通道提供遮蔽和弯曲法线,只有当 SSGI 关闭时 GTAO 才单独运行。
遮蔽适用于哪种光,与它如何计算同样重要。在此管线中,遮蔽不是任一 cascade 的步骤。它是一个共享缓冲,像现在一样通过 builtinAOContext 设置,需要它的来源读取它并加深自己的结果:
文章标题:我如何让原生 Three.js 的画质比肩 AAA 游戏引擎
正文:
- 光照贴图、探针网格和环境对其间接漫反射应用 AO,并与材质的 AO 贴图以 min( materialAO, gtao ) 组合。
- 反射探针和环境对其间接镜面反射应用 GTSO。
- SSR 和 SSGI 两者都不应用。屏幕空间命中是光线实际找到的东西,因此它已经被正确遮蔽。
- 在 SSGI 背后,漫反射源跳过 AO。SSGI 的覆盖率是半球中被屏幕上某物遮挡的份额,也就是遮蔽本身。级联已经按 1 − 覆盖率缩放光照贴图或探针网格,因此再应用 AO 会把它们变暗两次。
- 直接光不受影响,因为它有阴影。
级联从不接触这些;它们只按覆盖率组合颜色,别无其他。一个源必须遵守的唯一规则是:遮蔽使它的颜色变暗,绝不使它的覆盖率变暗。被遮蔽的探针仍然回答该像素,只是更暗;反过来降低它的覆盖率会让下一个源未遮蔽的光泄漏进角落。
对光照贴图表面应用 AO 会把它们稍微变暗两次,因为烘焙已经包含静态自遮蔽。我们仍然这样做,因为动态对象仍然需要遮蔽静态对象。
Three.js 已有的。GTAO 已经存在,而且它已经馈入光照,而不是被乘到最终图像上。AO 示例渲染一个预渲染通道,在其上运行 GTAO,并通过光照上下文把结果交给最终渲染通道:
        const aoPass = ao( prePassDepth, prePassNormal, camera );
scenePass.contextNode = builtinAOContext( aoPass.getTextureNode().sample( screenUV ).r );
这正是管线其余部分所需的模式,它在下面还会再次变得重要。
差距。有三个。
- 镜面遮蔽。今天 GTAO 输出单个可见性值,物理光照模型用基于视角和粗糙度的启发式把它转成镜面遮蔽。它不知道哪些方向被遮挡,所以金属在褶皱里仍然反射天空。弯折法线和 GTSO 已作为草稿 PR 提交。弯折法线来自同一个地平线搜索,不增加额外的深度采样;代价是 AO 目标从每像素一个字节增长到四个。
- 边缘感知上采样。半分辨率 GTAO 用双线性滤波器上采样会在物体周围留下暗色轮廓,因为来自后方表面的遮蔽会跨越每个剪影渗漏。jointBilateralUpsample() 使用全分辨率深度和法线作为引导进行上采样(Kopf 等 2007),因此结果止于边缘。它已起草但尚未提交,AO 示例是其第一个用户;半分辨率 SSR 需要同样的滤波器。
- 来自 SSGINode 的弯折法线。草稿把弯折法线加到 GTAONode。SSGINode 需要同样的输出,取自其搜索发现开放的方向,这样当 SSGI 开启时镜面遮蔽就不需要第二个通道。
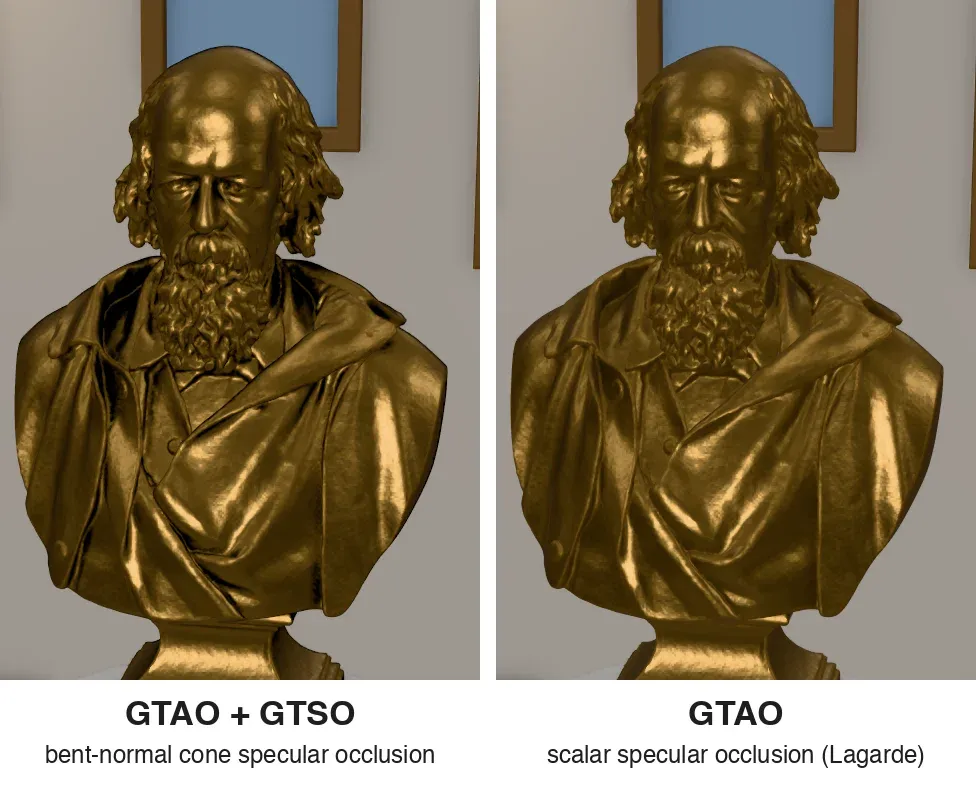
使用 GTSO(左)时,褶皱和凹陷停止反射天空。使用标量镜面遮蔽(右)时,它们仍然发光。
反射:屏幕空间反射
游戏的要求。来自 DOOM、Frostbite 及其他游戏,级联中的 SSR 必须:
- 使用 Hi-Z 深度金字塔,在任何距离上高效追踪。
- 输出覆盖率,以便探针填充它遗漏的部分。
- 追踪上一帧的已光照图像,使其结果可以馈入当前帧的光照。
- 在空间和时间上降噪,使每像素一条光线就足够。
Three.js 原本具备的能力。九月时,Three.js 的 SSR 是为另一项任务构建的:在紧凑场景中为已完成的图像叠加反射。它采样数很少,因此粗糙表面噪点明显。它是叠加合成到图像之上的,因此没有经过 BRDF。而且它的光线在固定距离处终止,所以远处物体的反射会缺失。
此后情况已有很大变化。SSRNode 现在对完整 GGX 波瓣进行重要性采样并带有正确的 Fresnel,对命中点进行验证与细化,并使用 Houston Stratified Noise(也称 HHW,即 Hierarchical Hashed Weyl 噪声)替代蓝噪声纹理。其结果会被重投影并随时间累积,并反馈回去,使反射中能看到反射。
它尚未做到的是融入级联。以下是 SSR 示例将其与场景结合的方式:
const litColor = scenePassColor.rgb.add( denoisedReflections.rgb );
beauty pass 先渲染,SSR 追踪同一张图像,然后反射叠加在上面。上述每一项要求都是从这一点出发的差距。
Hi-Z 追踪。SSRNode 目前以最多 64 步在深度缓冲上步进,最远到 maxDistance,并用厚度容差来判定命中。长光线开销很大,且这两个值都需要按场景调校。Hi-Z 金字塔是一个 mip 链,每个纹素存储其下方四个纹素的最小深度。光线在粗层级上以大步长穿过空白区域,只在接近表面时使用细步长,因此开销随光线长度的对数增长。这样每条光线都能走到屏幕允许的远处,无需调校最大距离。在金字塔中同时存储最小和最大深度也有助于厚度测试:单一深度层无法判断光线是从物体后方经过还是进入了物体内部,而额外的边界缩小了这种歧义。该技术来自 Uludag 的 GPU Pro 5 中的 Hi-Z Screen-Space Cone-Traced Reflections,建立在 McGuire 和 Mara 的屏幕空间光线步进之上。Frostbite(用于光滑表面)、AMD 的 FidelityFX SSSR 和 Killing Floor 2 都使用了它。一个初步原型在 48 个 GPU 测试用例中与线性步进逐位一致,但尚未成为净收益:遍历最多节省约 7%,而构建金字塔的开销超过这一节省。在 GTX 1050 上,一个测试场景从 199 fps 降到 159 fps,另一个从 126 降到 97。下一步是更廉价的金字塔构建,在单次 compute dispatch 中完成,如 AMD 的 SPD 那样,并与遍历一起测量。
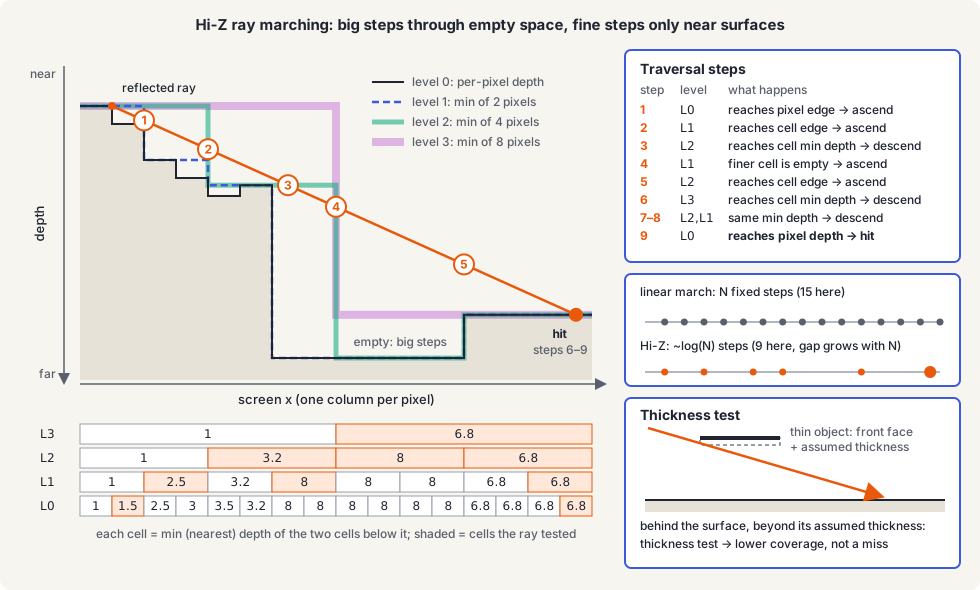
Hi-Z 光线步进:空白区域用大步长,接近表面用小步长。
覆盖。目前,未命中的光线在 SSR 内部自行采样环境贴图:作为 environmentNode 传入的 equirectangular 纹理,它不可能是经 PMREM 过滤的 scene.environment,更不可能是局部探针。在图像上叠加 SSR 还会把环境反射计算两次:一次在 beauty pass 中,一次在 SSR 自己的回退中。在级联中,SSR 应当改为输出其反射和覆盖率,并在屏幕边缘、掠射角、薄几何体后方以及非常粗糙的表面上降低覆盖率,其余交给探针。我们已经对此做了原型;它会与下面的 BRDF 集成一起落地。
追踪上一帧。SSR 在读取光照输出时无法成为光照的一部分。DOOM 的答案是追踪当前深度缓冲,但从上一帧读取颜色:将每个命中点重投影到上一帧的 TRAA 输出并在那里采样。上一帧的图像已经包含了上一帧的反射,因此面对镜子的镜子每帧都会增加一次反弹。上一帧追踪正在评审中。
文章标题:My Quest to push native Three.js quality match AAA Game Engines
正文: 有两条规则维持着这个循环的健康。第一,SSR 读取的图像必须是线性 HDR 辐射度,在 TRAA 之后、色调映射、bloom 和其他后处理之前取得;否则反射会染上色调映射后的颜色和 bloom 光晕。第二,回馈的辐射度必须经过钳制。每一帧的反射都会成为下一帧的输入,因此降噪器里的一只萤火虫噪点或轻微的能量增益会逐帧累积,而不是逐渐消退。
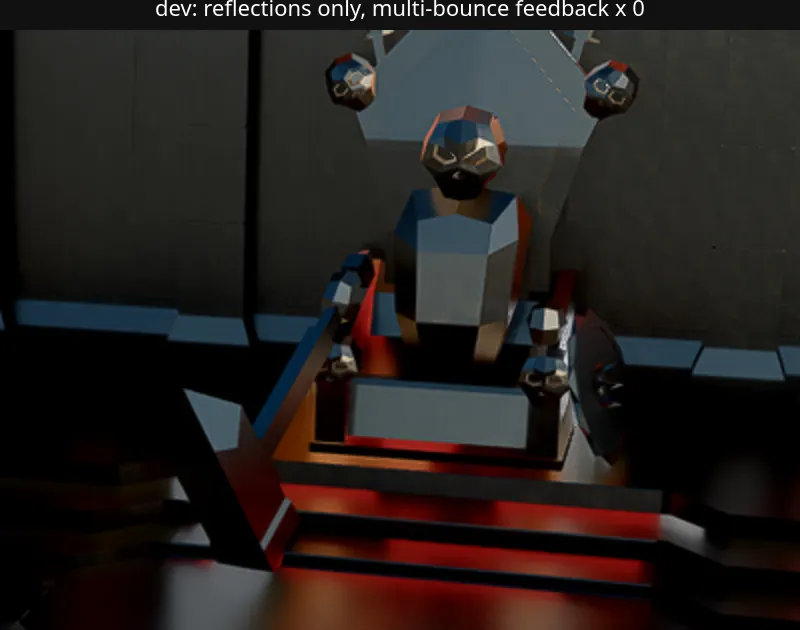
仅反射。启用上一帧反馈后,反射中会显现出反射。
降噪。粗糙的反射需要每个像素拥有超过一条光线的信息量,而 Three.js 目前还没有为 SSR 设计的时空降噪器。Frostbite 的实现是范本:复用相邻像素的光线,按每个像素自身的 BRDF 加权,再随时间累积,历史重投影时使用反射命中点的运动而非表面的运动,因为反射的移动方式与显示反射的表面不同。zalo 正在做这件事。他基于 SVGF 的 DenoiseNode 已经合并,但在为反射重做期间,SSR 示例已回退到之前的降噪器。下一次尝试将用一套调试工具来评判。其中一块已经做出了原型:解调,即在滤波前把表面颜色从信号中除去,滤波后再乘回去,这样降噪器模糊的是光照而不是纹理细节。
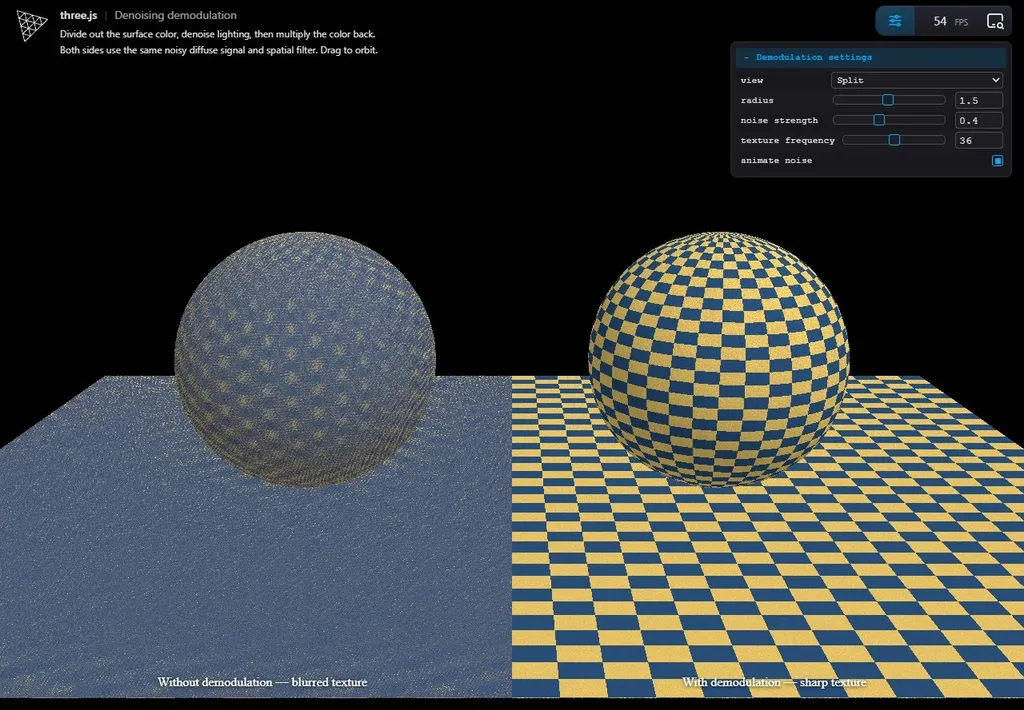
同样的噪声信号、同样的滤波器,左侧没有解调,右侧使用了解调。
屏幕空间全局光照
SSGI 是 SSR 的漫反射对应物。它补上了烘焙无法得知的反弹光,几乎复用了 SSR 所需的一切,并且一旦开启就会取代 GTAO。
游戏所要求的。把 SSGI 作为光照一部分的引擎,会按照第 1 部分所述,把它放在烘焙光照之前,作为级联的第一级。这意味着 SSGI 必须:
- 输出覆盖度:它在屏幕上找到表面的半球占比。其余部分则落到光照贴图或探针网格上。
- 追踪上一帧的照明图像,这样其结果可以供当前帧的光照使用,反弹光也能每帧多弹一次。
- 以半分辨率随时间累积,并使用与 SSR 相同的边缘感知上采样。
Three.js 现有的。SSGINode 已经存在,建立在 SSRT3 的可见性位掩码方法之上,该方法将 GTAO 的地平线搜索扩展为在收集遮蔽的同时收集光照。对每个像素,它沿半球的一个切片向外步进,标记该切片中哪些扇区被深度缓冲遮挡,并收集遮挡它们的内容的颜色。默认 24 个深度采样的一次搜索即可产出一张 GI 纹理和一张 AO 纹理,而且比单条随机光线噪声小得多,因为每个采样覆盖了一整段方向弧。这就是为什么这条管线只为它分配一份时间历史,而不单独做空间滤波。SSGI 示例追踪当前帧的 beauty pass 并叠加合成:
const composite = vec4( scenePassColor.rgb.mul( ao ).add( scenePassDiffuse.rgb.mul( gi.rgb ) ), scenePassColor.a );
差距。与 SSR 的相同,原因也相同。
- 覆盖率输出。搜索标记为阻挡的区域,正是它找到表面的方向,因此覆盖率是 1 − ao,而节点已经计算了这个值。缺的是把 GI 和该覆盖率作为一对交给级联。没有这一点,SSGI 只能在烘焙反弹之上叠加,这会重复计算一次,并且无法替代它。
- 上一帧追踪。读取当前帧的 beauty pass 会迫使 SSGI 在其之后作为合成步骤运行。为 SSR 添加的上一帧追踪在这里适用同样的规则:色调映射之前的线性 HDR,并且进行钳制。有一点不同。SSR 每个像素读取上一帧一次,即其光线落点处,而 SSGI 在每一个找到表面的采样处读取它,因此每次读取时重投影会在每像素上被多次付出代价。一份草案在 Apple M3 上测量了这一点:按相机运动对每个采样重投影会消耗帧率的 14–22%,而按逐像素速度(这也跟随移动物体)重投影则消耗 32–44%。因此,上一帧改为按速度重投影一次,存入与当前帧对齐的半分辨率缓冲区,搜索直接读取该缓冲区。其运行帧率与追踪当前帧相同,且在测试场景中没有可见伪影。
- 一个漫反射源。一旦两者齐备,SSGINode 就成为下文所述漫反射列表中的第一项,且材质无需任何改动。
反射:局部探针与级联
游戏需要什么。Three.js 成长于渲染一个漂浮在空间中的单一物体,由一个环境贴图照亮,在这方面它非常出色。在室内,一个环境贴图就是错的:从红色房间走入蓝色走廊,地板应该反射红色,然后是蓝色,而不是天空。
调查中的每一款游戏,以及 Unreal 的反射捕获,都用局部反射探针解决这个问题:在每个房间内部捕获 cubemap,每个都带有一个描述其影响体积的盒子。在其盒子内部,探针进行盒投影:反射光线首先与房间的盒子求交,然后朝向该命中点采样 cubemap,而不是沿原始光线采样。这一步消除了 cubemap 的大部分视差误差,因此当你行走时,远处墙壁的反射会留在地板上(Lagarde 的文章是经典解释)。盒子重叠处,探针会混合,而它们之外的天空就是最外层的探针:一个具有无限盒子且无盒投影的探针。
Three.js 有什么。原料都在。CubeCamera 捕获 cubemap,PMREMGenerator 为其粗糙度进行预过滤,getParallaxCorrectNormal() 对其进行盒投影,正如盒投影环境贴图示例所示。但那是每个材质一个探针,手动设置。没有场景中一组探针、影响体积或它们之间混合的概念。
差距,以及我们如何填补它们。
- 探针系统。用于 WebGPURenderer 的盒投影反射探针添加了场景级探针、影响盒和混合,已作为草案 PR 提交。
- 快速访问大量探针。每个探针绑定一个 cubemap 无法扩展。Cube 阵列纹理将所有探针放入一个纹理;对它们的采样被合并,纹理类正在审查中。
- 探针归一化。探针在房间中的一个点捕获,因此它在被使用的任何地方都看到该房间明亮、开阔的视野。黑暗角落或橱柜内部于是反射出一个明亮照明的房间。Call of Duty 的修复方法,在 Black Ops II 中引入并延续到 Infinite Warfare,是按像素处的漫反射光与探针处漫反射光的比率来缩放探针的反射。光照贴图和探针网格已经提供了两者,因此几乎不花费什么。这确实意味着反射探针需要看到像素处的漫反射结果,可插拔设计允许这一点。这仍待完成。
我对让原生 Three.js 画质比肩 AAA 游戏引擎的探索
- 小探针。PMREMGenerator 的最小尺寸是 256²。对于模糊的室内反射来说,128² 的探针已经足够,因为其前方的 SSR 会处理锐利的反射,而且它只占用四分之一的显存。128² 的预过滤仍有待完成。
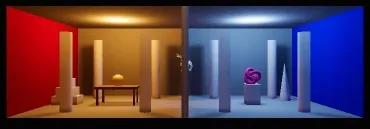
两个相连的房间,各自反射出自己的墙壁,来自三个盒投影探针。
BRDF 中的间接光照
游戏的要求。级联只有在反弹光经过材质的 BRDF 时才有效,因此 Fresnel、粗糙度和金属度对它作用的方式与直射光完全相同。在正向渲染器中,这意味着 beauty pass 需要两个输入:
- 间接漫反射:在有覆盖的地方使用 SSGI;然后在静态网格上使用光照贴图;在其他所有地方使用探针网格,并按覆盖率回退到网格体积之外的环境贴图。
- 间接镜面反射:SSR,按覆盖率回退到盒投影探针,再回退到环境贴图。
需要遮蔽的来源会自行应用遮蔽,如上所述。
两者随后与直射光一起经过通常的 split-sum 近似(Karis 2013)。
不同引擎在这件事发生的位置上有所不同。像 Unreal 这样的延迟引擎在填充 G-buffer 时采样光照贴图,并在单独的全屏 pass 中合成反射。Three.js 采用正向渲染,所以自然的做法是在 beauty pass 之前把所有屏幕空间的东西——SSR、SSGI 和 AO——都算好,让每个材质在着色时读取。追踪上一帧正是让这个顺序成为可能的原因。
Three.js 现有的。间接漫反射基本已经就位:lightMap、LightProbeGrid 和 scene.environment 都为它提供输入,而 AO 已经通过 builtinAOContext 影响到它。间接镜面反射只来自 scene.environment,或材质自身的 envMap。
差距。这是最大的缺失部分。目前没有办法把屏幕空间的结果,或一串级联来源,接入材质的间接镜面反射,就像 AO 接入其漫反射那样。我们想要的是 AO 的模式,扩展到两个项,并把今天的 环境贴图作为不变的默认值。提议的设计见 Pluggable Indirect Lighting for Three.js。
TRAA 和 TAAU 闭合回路
游戏的要求。时间抗锯齿在每个现代引擎中都是标配。在这里它承担双重职责:它的输出是下一帧 SSR 的输入,所以它必须在运动下保持锐利,并且不能把鬼影或萤火虫回馈到反射中。
Three.js 现有的。一个不错的 TRAA 节点,带有 Halton 抖动、运动矢量重投影和历史方差裁剪。
TRAA 状态良好,没有重大差距挡路。还剩两项改进:
- 更锐利的历史。用双线性滤波器采样的历史在相机移动的每一帧都会多模糊一点。Catmull-Rom 历史采样(一个草稿 PR)能让它保持锐利。
- 静止时更宽的裁剪。方差裁剪是阻止鬼影的手段:它拒绝不再匹配当前帧的历史。但它也会拒绝好的历史。TRAA 在快速运动下已经把裁剪盒收紧到 0.5σ,但在静止时盒子是 1σ,紧到会裁掉已收敛的亚像素细节,所以静止图像永远无法完全解析,更长的历史实际上得分更差。一个已起草但尚未提交的改动在静止时把盒子放宽到 2σ,并添加了 historyLength 控制。用 TRAA harness 测量,静态视图相对于超采样参考获得 2.15 dB 的 PSNR 提升,有移动物体的静止相机获得 1.3 dB 提升,而快速相机运动的变化在 0.06 dB 以内。
使用 TAAU 进行升采样
这个系列用来对标比较的每个引擎,都会以低于输出分辨率进行渲染,再随时间重建差异:Unreal 中的 TSR、Godot 中的 FSR 2、Cyberpunk 2077 中的 DLSS 和 FSR。这是现代一帧中最大的单项性能杠杆,因为 resolve 之前的每一个 pass 都会同时变便宜。
Three.js 有什么。TAAUNode 已经做到了这一点,TAAU 示例以四分之一像素展示了它。它遵循 Karis 的时间超采样和 FSR 2。场景 pass 以降低后的分辨率渲染,通过 setResolutionScale() 设置。该节点抖动相机,从每个输出像素周围 3×3 的抖动输入样本中重建该像素,并将其与以输出分辨率保存的历史混合,使用与 TRAA 相同的深度拒绝和方差裁剪,外加一个保护细薄特征的锁定:
        scenePass.setResolutionScale( 0.5 );

const taauNode = taau( scenePassColor, scenePassDepth, scenePassVelocity, camera );
它如何融入。TAAU 取代 TRAA 成为帧的最后一个阶段,帧中其他部分的结构不变:
- 它之前的所有内容都以渲染分辨率运行。G-buffer 预 pass、Hi-Z、SSR、SSGI 和 beauty pass 都采用相同的分辨率缩放。该节点对整个渲染管线向相机施加抖动,因此预 pass 和 beauty pass 保持对齐。
- 它的输出是下一帧的 SSR 和 SSGI 读取的图像。该图像是以输出分辨率保存的线性 HDR,因此反射以渲染分辨率追踪,但读取的颜色比追踪它们的那一帧更清晰。SSR 部分的两条规则仍然适用:在色调映射之前读取它,并对其进行钳制。
- Bloom、色调映射和其余后处理在它之后以输出分辨率运行。
它还改变了上面的内存预算。开启 SSR 和 SSGI 时,76 字节的原生分辨率 TRAA 预算中约有 60 字节用于场景分辨率资源,16 字节用于历史和 resolve。TAAU 则使用约 24 个画布大小的字节,包括其锁定历史,因此其模型为每画布像素 60 × resolution scale² + 24 字节。在缩放为 0.5 时,这约为 39 字节而非 76 字节:4K 帧从约 626 MB 降至 322 MB,并且只着色四分之一的像素。额外的 TAAU 历史意味着内存减少量小于像素减少量。第 2 部分链接了计算器,其中包含针对 upscaler 的临时流量配额。
TAAU 和联合双边上采样不是替代方案。它们上采样的是不同的东西。jointBilateralUpsample() 是空间性的,在一帧之内工作:它接收半分辨率的中间缓冲区(AO 或 SSR 或 SSGI),在 beauty pass 读取之前将其提升到渲染分辨率,由深度和法线引导。这些缓冲区平滑且带有噪声,没有细节可恢复,只有边缘需要遵循。TAAU 是时间性的:它将完成的图像从渲染分辨率提升到输出分辨率,并从抖动帧中恢复真正的亚像素细节。一帧可以同时使用两者。不过当两者都设置为 0.5 时,SSR 和 SSGI 在每个轴上都以输出分辨率的四分之一运行,因此在开启 TAAU 的情况下,更好的做法可能是让它们以完整的渲染分辨率运行,并跳过双边步骤。
- 将其接入完整管线。该示例上采样的是单个场景 pass。此处的管线有一个预 pass、半分辨率效果和一个 beauty pass,它们必须在分辨率和抖动上保持一致,并且 SSR 对上一帧的读取必须采用 TAAU 的输出。这些还从未一起尝试过。
- 纹理 mip 偏置。以半分辨率渲染会让 GPU 选择比输出应得的更模糊的纹理 mip。每个时间性上采样器都搭配约 log2 分辨率缩放的负 mip 偏置。Three.js 尚未应用这样的偏置。
- TRAA 的改进。TAAU 采样和裁剪其历史的方式与今天的 TRAA 相同,因此 Catmull-Rom 历史和静止时更宽的裁剪也适用于它,并且 TRAA 测试框架应使用相同的超采样参考来测量它。
- 更省内存的锁。锁是每像素一个值,但存储在第二个半浮点 RGBA 历史目标中。单个 8 位通道将为每个输出像素节省 7 字节。
Future work
一旦管线完成,有几条线索值得深挖。
- 更廉价的噪声。Houston Stratified Noise 让 SSR 无需下载纹理就能获得出色的采样,但每个样本大约需要 400 次操作,而且每个像素每一帧都要付出这个代价。对于如此基础的东西来说,这太多了。有前景的取舍是将一部分工作转移到一张小型预计算图:几百千字节,在启动时 50 ms 或更短时间内生成,既保留 HSN 的特性,又让每个样本变成一次查找加几次加法。
- 自动曝光。从暗室走到明亮庭院需要眼睛适应,每个游戏都有。Three.js 还没有。
- 基于物理的太阳和天空。Three.js 的天空是为艺术控制而构建的,不是为物理光照水平。一个通过窗户照明的房间需要太阳和天空彼此一致,并与曝光一致:在 GPU 上计算大气散射,太阳的颜色和强度从大气中以真实单位推导出来。一个原型做了单次散射;多次散射和云仍有待完成。
- glTF 中的反射探针。KHR_lightmap 承载光照贴图,但没有标准方式来交付反射探针。最低限度是每个探针的位置和影响盒,这样加载器可以在加载时捕获探针;更完整的版本还会携带预过滤的 cubemap,这样根本不需要捕获任何东西。
- 方向光照贴图。这里的光照贴图每个 texel 存储一个辐照度值,因此法线贴图无法对烘焙光照做出响应。方向光照贴图以每个 texel 多几个字节的代价恢复这种响应:一个环境项加一个主导方向,如 The Last of Us 和 Call of Duty 中那样;L1 球谐函数,如 Frostbite 中那样;或球面高斯,如 The Order: 1886 中那样。
What is left
最大的缺口是一帧所需的最后一步:一种将两个级联都接入材质 BRDF 的方法。它比这里的任何其他阶段都更多地改变了 Three.js,所以它有自己的一篇文章。