 Newshot
正文
设想一个用于筛查心脏疾病的AI系统。数月来,它运行可靠,提升了诊断准确性和效率。突然,一次故障导致它漏掉心脏杂音,产生错误输出,最终对患者健康构成风险。
人类监督常被提议作为防范此类风险的保障1,2。人类被期望充当“安全网”,通过检测不准确的输出和故障来发挥作用,无论这些故障源于技术错误、数据漂移、错误输入还是网络攻击3。尽管已有研究考察了AI如何增强人类决策4,但人类能否可靠地防止系统故障后果,受到的关注较少。
检测系统故障要求很高,需要持续警觉和认知投入,尤其是当系统此前一直运行无瑕时5。自动化偏见可能使医生过度依赖AI建议,将AI“作为替代警觉性信息搜寻与处理的启发式工具”6。此外,AI输出可能充当认知锚点,诱发对最初呈现输出的确认偏误2,7,从而降低认知投入,增加采纳而非质疑AI建议的可能性8,9,10,11。为对抗此类有害影响,已有研究提出认知强制技术以保持主动投入2,5,12,例如要求在揭示AI建议之前进行独立评估12。这种认知强制要求医生主动处理临床数据、形成假设并寻找相关证据2,9。AI建议随后应更新而非锚定医生最初的评估2。
本研究考察了医生能否以及何时能够检测AI故障、进行适当干预,以及认知强制策略能否促进这些任务。我们假设,与在收到AI建议之后相比,在收到AI建议之前进行独立分类的医生,能更好地检测并推翻不准确的AI建议,并相应调整对AI系统的信任5,12,13。我们还考察了这一干预如何影响医生对自身分类的信心9,14。
我们在AI辅助心脏听诊背景下开展了一项混合2×4设计的随机对照实验。48名医生被随机分配到AI优先或AI在后条件。参与者被告知AI的训练数据和验证性能(准确率96%,敏感度97%,特异度89%)。每位参与者对40段数字录制心音进行分类,这些心音分四个区块呈现,分类为正常或异常。为模拟系统故障,系统可靠性随区块逐步下降(90%、60%、50%、0%)。在最后一个区块中,听觉和视觉线索被故意设置为不匹配,以提供严重系统故障的额外信号15。AI在后条件实施了认知强制技术:参与者先提供无辅助的分类和信心评分,在收到AI建议后可以修改。AI优先条件则在提供分类和信心评分之前收到AI建议。两组参与者均在每第五次试验后对系统信任度进行评分。
文章标题:人类监督在检测 AI 辅助诊断故障方面面临的挑战
正文: 图 1 展示了参与者的表现、信心和信任得分。表 1 展示了 ANOVA 结果。正如预测的那样,AI 辅助诊断表现随系统可靠性下降而下降,从 MT1 = 81.45%(SDT1 = 11.48%)降至 MT4 = 58.33%(SDT4 = 25.29%)。T1 时的 AI 辅助表现低于 AI 系统可靠性(90%),而在 T2-T4 时高于 AI 系统可靠性,但低于人类无辅助表现。总体而言,认知强制并未改善诊断表现:表现的 Group×Block 交互作用显著,但与我们的假设相反,在 T4 时 AI-First 组(MT4|AI-First = 64.58%,SDT4|AI-First = 22.65%)优于 AI-Second 组(MT4|AI-Second = 52.08%,SDT4|AI-Second = 26.70%)。
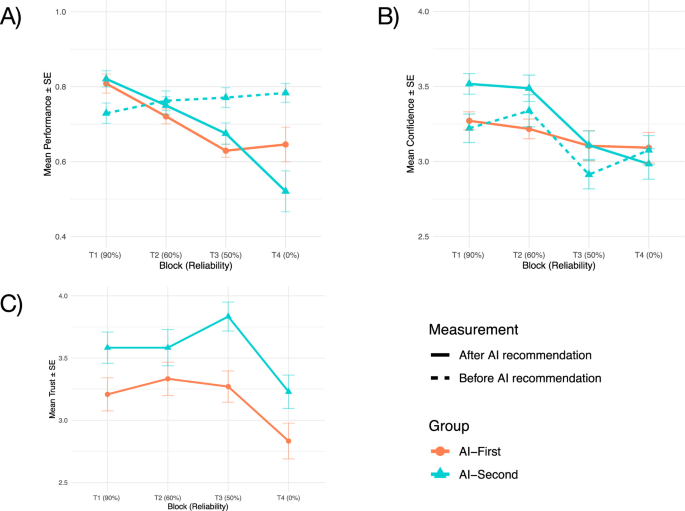
在系统可靠性递减的四个区块中,AI-First 组(橙色;n = 24)和 AI-Second 组(青绿色;n = 24)的诊断表现(A)、诊断信心(B)和信任(C)。青绿色虚线表示参与者在收到 AI 建议之前的无辅助表现和信心(仅 AI-Second 条件)。误差线表示标准误。
在两组中,参与者在收到 AI 建议后的信心在各区块间显著下降,从 MT1 = 3.39(SDT1 = 0.34)降至 MT4 = 3.04(SDT4 = 0.50);我们还发现了显著的 Group×Block 交互作用。在 AI-Second 组中,收到 AI 建议前的信心在各区块间下降,尽管无辅助表现并未下降(图 1A、B 中的虚线和表 1)。两组的信任均从 MT1 = 3.40(SDT1 = 0.91)降至 MT4 = 3.03(SDT4 = 0.98)。信任不存在显著的组别或交互效应。实验结束后,仅有 12.5%(每组三人)报告注意到系统可靠性下降,即使明确询问系统是否发生变化,也只有 37.5%(AI-First:41.7%;AI-Second:33.3%)报告注意到可靠性降低。
我们的研究考察了医生能否检测 AI 故障并有效干预,以及认知强制是否支持人类监督的这些核心目标。研究揭示了三个重要发现。第一,在高可靠性区块(T1),人机联合表现低于系统可靠性(参见文献 4)。第二,当系统可靠性下降时,人机联合表现高于系统可靠性,表明医生具备部分检测并否决不准确 AI 建议的能力。然而,在低系统可靠性下,人机联合表现也降至无辅助人类基线以下。只有少数参与者报告注意到系统故障。第三,认知强制并未改善人机表现。结合此前关于医疗决策中错误 AI 支持证据的研究10,16,这些发现挑战了医生能够可靠检测并纠正错误 AI 输出的假设,并对认知强制的支持作用提出了质疑。
检测 AI 辅助诊断故障时人类监督面临的挑战
自动化偏差6可能是医生采纳不准确系统建议的原因之一。然而,为理解医生为何在形成独立评估后仍未充分推翻 AI,观察到的诊断信心与对 AI 的信任之间的关系11,17 可能提供重要见解。在 AI-Second 组中,基线表现保持稳定(图 1A 中的虚线),而在可靠性下降时,初始诊断信心的下降速度快于对 AI 的信任(T1 > T3 与 T1 > T4)。AI 报告的 96% 准确率可能助长了对系统可靠性的高估18,并提高了信任和依赖11,使医生质疑自己的判断而不是 AI。即使存在系统故障的额外信号(T4),参与者也没有可靠地推翻 AI 系统。这些探索性发现初步表明,即使医生在收到 AI 建议前独立处理诊断信息5,6,19,AI 输出可能仍具有很高的感知权威性。然而,这些解释需要进一步验证。
我们实验设置的若干方面限制了我们结果的普适性。尽管医生经验未影响我们的结果,但 38% 的参与者是接受培训的医生。此外,该研究在受控实验室环境中进行,聚焦于一个孤立的诊断子任务,没有医患互动,也无法获取额外临床信息(如生命体征、患者总体表现)。我们对系统故障的操纵包括系统可靠性快速持续下降导致 0% 准确率,以及听觉和视觉线索不同步。因此,未能捕捉可靠性的波动,不能排除顺序效应,我们也无法确切断定系统故障的哪个方面(即可靠性下降还是不同步)主要导致了 T4 的结果模式。在临床实践中,系统故障可能更加异质,例如更细微或波动,而现实世界因素,如疲劳、相互竞争的需求和时间压力,很可能使对 AI 的监督更具挑战性5,20。此外,长期依赖高准确率的 AI 系统可能增加信任5,同时侵蚀手动诊断技能并降低诊断信心21。
对于未来研究和实践,确保有效的人类监督2,22 需要明确定义的成功标准。如果人-AI 表现要么(1)超过 AI 表现,要么(2)不低于无辅助的人类表现,则人类监督可被视为成功。关于(1),我们的数据表明,医生在与高可靠性系统交互时可能遇到困难,在这种情况下,人类参与可能降低仅 AI 的表现(T1,参见文献 4、20)。关于(2),尽管医生减轻了系统可靠性下降的一些负面影响,但低可靠性 AI 可能使结果恶化到低于无辅助人类表现(T2-T4,参见文献 4)。
在我们的实验中,认知强制并未提高人类监督的有效性。尽管如此,仍需在现实环境中进一步研究,以更好地理解认知强制效应,特别是在多重任务需求、可获取额外患者信息、其他 AI 使用场景(如图像分类、治疗计划)或明确指定监督角色的专门培训等条件下。除了表现之外,还应考虑其他结果。例如,将任务外包给 AI 可能导致技能退化21,而要求独立评估(如认知强制条件中)可能有助于保留诊断技能,尽管会增加诊断时间。在设计人类监督工作流程时,应考虑这些权衡。
人类监督在检测AI辅助诊断故障时面临的挑战
由于我们的结果表明,医师可能难以检测AI系统故障,有效的人类监督可能需要在系统层面和组织层面采取额外行动22。AI系统应提供相关线索以促进监测和错误检测,例如不确定性指标或解释23。在组织层面,问责可能需要与利益相关者分担,例如AI部署方(如医院)和提供方(如开发者)24。与在时间压力下治疗患者的医师相比,这些主体可能更有能力通过使用能够追踪患病率和亚组分布变化的监测工具,大规模检测系统偏差和故障。结合医师知情的临床输入和透明的系统设计,此类结构可能形成更稳健的安全网,以防范AI故障。
总之,我们的研究提供了初步证据,表明仅靠人类监督可能不足以可靠地检测AI辅助心脏听诊中的系统故障。尽管具备专业知识,医师常常未能检测到系统可靠性下降,即使有系统故障的额外证据(即失同步)并且采用了认知强制技术。从明确界定监督目标开始,未来研究应考察医师层面、系统层面和组织层面的因素如何促进临床工作流程中的有效监督。
方法
伦理与包容性
本研究依照《赫尔辛基宣言》进行。Philipps-Universität Marburg 的医学伦理委员会在开展研究前批准了本研究,批准编号为 23–69 BO。所有参与者在参与前均提供了知情同意。数据收集为匿名进行,并遵循 GDPR 指南以保护机密性。我们的样本包括不同经验水平的医疗专业人员;样本仅限于讲德语的参与者。所有参与者在研究结束后均接受了情况说明,并有机会报名接收研究结果。
参与者
本研究已在 aspredicted.org 上预注册(#148,334;临床试验编号:不适用;https://aspredicted.org/78v7-jpsp.pdf)。样本量通过使用 G*Power25 针对所采用统计方法进行的功效分析先验确定。所需样本量(N = 48)的计算用于在混合ANOVA交互中检测 ηp² = 0.03 的效应量,在 1-β = 0.80 和 α = 0.05 下。
文章标题:人类在检测 AI 辅助诊断故障时面临的监督挑战
正文: 2023 年 10 月至 2024 年 5 月期间,我们通过直接联系、海报和滚雪球抽样招募了 48 名医生(Mage = 35.48 岁,SD = 16.04;64.6% 男性,35.4% 女性)。所有参与者均自愿完成研究。分析中未排除任何数据。参与者被随机分配到 AI-First 组(n = 24)或 AI-Second 组(n = 24)。样本包括 37.50% 的最后一年的医学生、39.58% 的住院医师(即在经验丰富的医生监督下获准执业的医生,通常为毕业后前 6 年)和 22.92% 的经验丰富的医生(包括专科医生、高级医生、私人执业医生和主任医生)。专业领域差异很大(全科与内科 [18%]、麻醉科 [14%]、心脏科 [11%]、其他 [15%])。全样本的平均专业经验为 M = 8.19 年,SD = 14.33。执业医生的平均专业经验(不包括 n = 18 名最后一年的医学生)为 M = 12.93 年,SD = 16.43。45.83% 的样本报告没有专业经验。总体而言,自评听诊能力(从 1 =“非常差”到 5 =“非常好”)为 M = 3.00,SD = 0.77,16.67% 报告有数字听诊的既往经验。他们对技术交互的亲和力26处于中等水平(M = 3.92,SD = 0.99)。实验组在这些人口统计学变量中的任何一个上均无显著差异(表 S14)。
实验设计与程序
我们采用了 2 × 4 混合因子设计,实验操纵 AI 建议的时机(受试者间:AI-First vs. AI-Second),以及下降的系统可靠性(受试者内:90% vs. 60% vs. 50% vs. 0%)。
实验在安静环境中进行,使用标准化的 Sony WH-1000XM4 耳机,配有可更换的耳罩以保证卫生。为便于参与,数据收集在多个地点进行,同时保持一致的声学条件。人口统计学信息和实验后测量通过在线问卷收集,问卷通过平板设备上的调查平台“SoSci Survey”进行管理。参与者在 13 英寸 MacBook Pro 上完成实验,接受标准化指导,没有额外的实验者互动。实验的实现主要基于 Pygame (2.5.2) 库。
请注意,在计算机实验之后,参与者完成了一项额外的调查,例如评估他们对技术交互的亲和力和技术接受度。由于篇幅限制,我们在此重点关注计算机实验中收集的数据,不提供调查数据的详细信息。实验后调查的所有项目(表 S2 和 S3)以及相关表(表 S15)可在在线补充材料中获取,完整数据提供于 https://osf.io/836ny/?view_only=3a1631a54edd489197a8b3b9e4322fa0。
文章标题:Challenges for human oversight in detecting AI-assisted diagnostic malfunctions
正文: 参与者被随机分配到两个实验组之一:AI-First 或 AI-Second(表示接收 AI 建议的时机,其中 AI-Second 包含认知强制,即参与者必须先自行给出分类,然后才能收到系统建议)。一开始,所有参与者都提供了人口统计学数据。之后,为了在保持完全实验控制的同时提供逼真的情境,参与者被引入一个计算机上的远程医疗听诊场景,在其中被要求查看数字化录制的心音,并将其分类为“正常”或“异常”。请注意,为了控制参与者心音评估过程中不想要的变异,并使评估与我们所用数据集中的真实标签保持一致27,28,“异常”的分类被描述为排除节律紊乱和心动过速/心动过缓,但包括病理性血流杂音或心脏杂音。参与者随后被告知了用于支持其决策的 AI 系统。首先,他们收到了对系统提供的两种可视化类型的解释:心音图(Phonocardiogram)和 Mel 频谱图(Mel-spectrogram)(见在线补充材料中的图 S5)。其次,他们收到了关于训练数据(即来自 1500 名 0 至 21 岁个体的 8425 个文件)以及 AI 在验证中的可靠性(即 96% 的准确率,97% 的敏感性和 89% 的特异性)的信息。该可靠性信息基于已发表的 AI 心脏听诊性能数据29。所有参与者都被告知了各自组的实验流程,且对其他组不知情。完整的原始和翻译版指导语可在在线补充材料中获取(图 S1–S12)。在开始之前,参与者进行了一次练习试次,他们可以随意重复多次。
主实验包含 40 个试次,以 10 个为一组,系统可靠性逐渐降低(90%、60%、50% 和 0%;有关音频文件的更多信息见后续章节)。请注意,在第 4 组中,我们故意加入了视听不同步,即音频和视觉成分采样自不同的录音。各组始终以相同顺序呈现,以模拟系统性能随时间下降。组内试次以伪随机顺序呈现;每组包含相同的十个试次,但其顺序被随机化以控制顺序效应。完成两组(20 个试次)后,参与者有机会休息,并按自己的节奏继续任务。
每个试次根据实验组遵循结构化的顺序(图 2)。最初,所有参与者查看屏幕上的患者简况(包含数据集中所述的患者年龄段、性别和听诊点信息27)。AI-First 组的参与者在呈现心音录音之前直接收到 AI 建议(“正常”或“异常”),该录音包括心音及其作为心音图和 Mel 频谱图的可视化。参与者可以随意多次重放视频。然后,他们被要求将心音分类为正常或异常,并报告其诊断信心。每五个试次之后,他们还被问及对 AI 系统的信任程度。
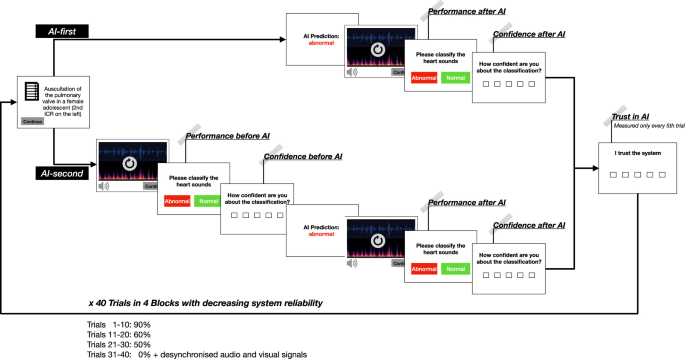
该图展示了每组 40 次试验中的一次试验运行。上方呈现的是 AI-First 组的一个示例试验,下方呈现的是 AI-Second 组的一个示例试验。请注意,两组参与者都可以按需反复回放听诊文件,如回放图标所示。
AI-Second 组的参与者首先聆听录音,并可随意多次回放。随后,他们将心音分类为“正常”或“异常”,并报告其诊断信心。请注意,由于这一初始评估的音频和可视化始终与收到 AI 建议后的音频和可视化完全一致,因此该评估可被解读为无辅助的人类表现基线。之后,流程与 AI-First 组类似。参与者收到 AI 建议,并可随意多次回放录音。随后,他们被要求对心音进行分类、提供诊断信心,并且每完成五次试验后,评价其对系统的信任。完成基于计算机的实验后,参与者在平板设备上继续完成最初的在线调查,其中收集了定性回答等内容。
Materials
本文报告的主要因变量按如下方式评估:诊断表现按参与者对心音(正常 vs. 异常)分类正确数相对于数据集金标准诊断的比例计算28。诊断信心在每次试验中、且每次参与者做出决策时(即收到 AI 建议之前和之后)使用以下条目进行评估30:“您对自己的分类有多大信心?”并按 5 点评分量表作答(1 = “完全没信心——我是在猜”,2 = “不太有信心”,3 = “有些信心”,4 = “相当有信心”,5 = “绝对有信心”)。对系统支持的信任在每五次试验后评估。参与者对陈述“我信任该系统”按 5 点 Likert 量表评分(1 = “强烈不同意”,2 = “不同意”,3 = “中立”,4 = “同意”,5 = “强烈同意”)31。本研究使用的所有条目见在线补充材料表 S1–S3,其中提供了原始德语版本及英文翻译。
为准备本研究的音频刺激材料,最初从公开 CirCor 数据集27,28 的训练数据(版本 1.0.2)中选取了 40 段心音录音,该数据集包含来自 942 个个体的 3163 段录音。这些文件使用 AI 工具进行了可视化,但 AI 建议经过人工编辑,以符合我们预定的研究设计。每个区组包含 50% 正常和 50% 异常录音,以避免评分者偏差32。我们主动操纵了 AI 的错误率,以提高假阳性率。这样做是为了更好地反映真实推荐系统也往往产生更多假阳性33,并且因为我们提供给参与者的系统信息表明该系统更可能产生假阳性建议(即系统的敏感性高于特异性)。因此,我们在区组 1 中设置了 1 个假阳性,在区组 2 中设置了 3 个假阳性和 1 个假阴性,在区组 3 中设置了 3 个假阳性和 2 个假阴性。区组 4 由 5 个假阳性和 5 个假阴性组成,并伴有视听不同步。音频文件经过预试验,以在所有区组中达到相似难度。选择标准、刺激材料准备和预试验的详细描述见在线补充材料。
Data treatment and analyses
数据分析使用 RStudio(版本 2023.09.1 + 494)进行。组间比较采用独立样本 ANOVA,组内比较采用重复测量 ANOVA。为分析被试内因素 block 与被试间因素 group 之间的交互效应,进行了混合设计 ANOVA。对假设违反情况的评估主要以残差目视检查为主,辅以 Mauchly 检验(用于球形性违反)、Shapiro-Wilk 检验(用于正态性违反)和 Levene 检验(用于方差齐性违反)。在违反球形性假设的情况下,应用 Greenhouse-Geisser 校正。正态性和方差齐性假设未受到严重违反,因此未进行校正。效应量以偏 eta 平方(ηp2)34 和广义 eta 平方(ηG2)报告,以提高与其他实验设计的可比性35。
作为敏感性分析,并为了控制潜在的影响性嵌套变量,我们额外使用以被试 ID 作为随机因素的分层线性模型评估了交互效应,以考虑被试内方差。被试的分类使用广义线性混合模型(GLMM)进行评估,该模型针对二分类结果采用 logit 链接函数。模型包含被试的随机截距,以及 block(90%-0%)和 group(AI-First vs. AI-Second)的固定效应。我们拟合了额外模型,以控制被试的工作经验和自我评估的听诊技能。分类变量的重新转换效应估计以比值比及相应的 95% 置信区间(CI)报告,作为主要的验证性结果。显著性阈值设定为 α = .05,并报告双尾 p 值(即非对半 p 值)。敏感性分析得出了与主要分析相同的结论,即使在控制被试的工作经验或其自我评估的听诊技能时也是如此(见在线补充材料中的表 S4–S10)。
两个开放式问题的定性编码由两名研究者(C.T. & N.S.)独立进行。两个定性问题的初始评分者间信度中等,范围为 κ = 0.54 至 κ = 0.56(p < 0.001)。分歧经讨论并解决,以用于进一步分析。