Newshot
文章标题:NVIDIA 横扫 MLPerf 训练与端侧基准,Vera Rubin 首秀即展现领先性能
正文: 在 MLPerf 基准测试的首次亮相中,随着今日结果公布,NVIDIA Vera Rubin 平台在训练、后训练和智能体推理方面均交付领先性能。
NVIDIA 横扫了每一项 MLPerf Training v6.1 基准测试,并在其首次 MLPerf Endpoints 提交中,为智能体 AI 带来了超过 10 倍的每瓦吞吐量代际提升——该指标衡量系统每消耗一瓦电力能交付多少智能体工作量。
这些结果只是开始。Vera Rubin 的性能将通过 NVIDIA CUDA 驱动的软件栈持续优化而不断攀升,因此客户今天投资的基础设施将随时间推移交付更多价值。
NVIDIA 横扫 MLPerf Training v6.1
AI 智能体如今无处不在,它们在编写代码、运行业务工作流、回答客户问题,并且正如本周 SC26 大会所强调的,还在推进科学研究。
更快的训练意味着更聪明的智能体可以更早触达用户,药物发现模型可以跟上新的实验室数据,欺诈检测模型可以更快适应新威胁。
MLPerf Training 衡量系统将一系列 AI 模型训练至目标精度水平的速度。
NVIDIA 平台是本轮唯一在每一项基准测试上都有结果的平台,涵盖大语言模型、图像生成、推荐系统和强化学习后训练。Vera Rubin NVL72 在首秀中,每 GPU 性能最高达到高度优化的 NVIDIA GB300 NVL72 系统的 2 倍——这些早期结果展示了代际创新的步伐。
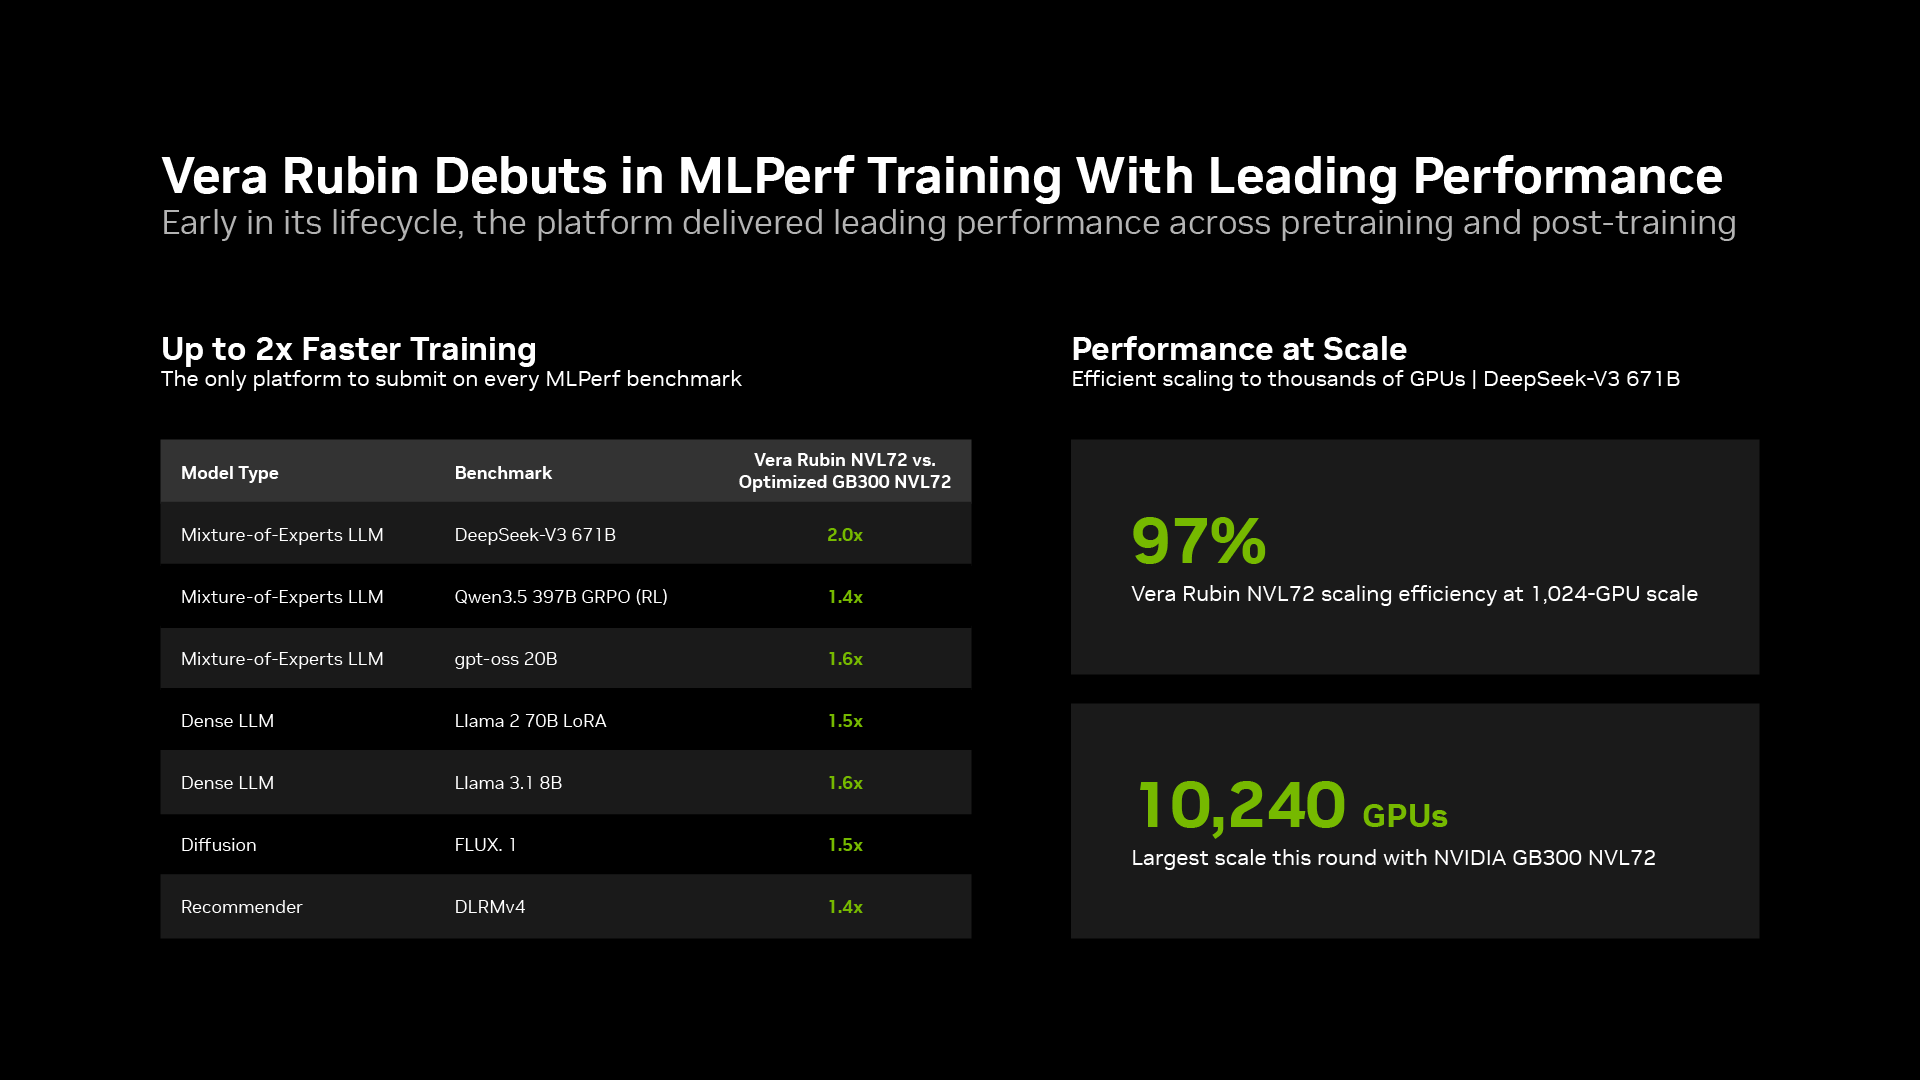
NVIDIA 还展示了规模化性能。在 DeepSeek-V3 基准测试中,Vera Rubin NVL72 从 256 个 GPU 扩展至 1,024 个 GPU,效率约为 97%:GPU 数量翻两番,训练时间从 16 分钟缩短至约 4 分钟。
NVIDIA 还在 10,240 个 GPU 上使用 GB300 系统运行了该基准测试,代表本轮最大规模。Microsoft Azure 使用 GB200 系统以 10,240 个 NVIDIA GPU 匹配了该规模。
这一规模下的结果之所以重要,是因为只有当 GPU 能够高效协同工作时,增加 GPU 才能加速训练。NVIDIA NVLink scale-up 网络连接每个系统内的 GPU,使其作为一个整体运行;而 NVIDIA Quantum-X800 InfiniBand 和 Spectrum-X Ethernet scale-out 网络则将这些系统跨数据中心连接起来。结合优化的软件,这使数千个 GPU 协同工作,帮助开发者构建更智能的模型,同时缩短训练时间。
NVIDIA Vera Rubin 在 MLPerf Endpoints 上领跑智能体推理
一个规划并预订整个行程的旅行 AI 智能体——或者一个在任何人提交工单之前就发现并修复问题的 IT 智能体——可能需要多次推理、调用工具并检查其工作,才能完成单个任务。
其中每一步都会生成 token。由于 AI 数据中心受电力限制,系统每瓦电力每秒能生成的 token 越多,它就能服务更多智能体,创造更多价值。
MLPerf Endpoints 在真实智能体编码和企业工作流上测试系统,并检查智能体是否仍能正确完成任务。NVIDIA Vera Rubin 在其所有智能体基准测试中均领先。
例如,在为智能体工作流构建的大型开放模型 Kimi K3 的暂定结果中,Vera Rubin NVL72 系统在相同响应速度下,每瓦吞吐量超过 NVIDIA GB300 NVL72 的 10 倍。
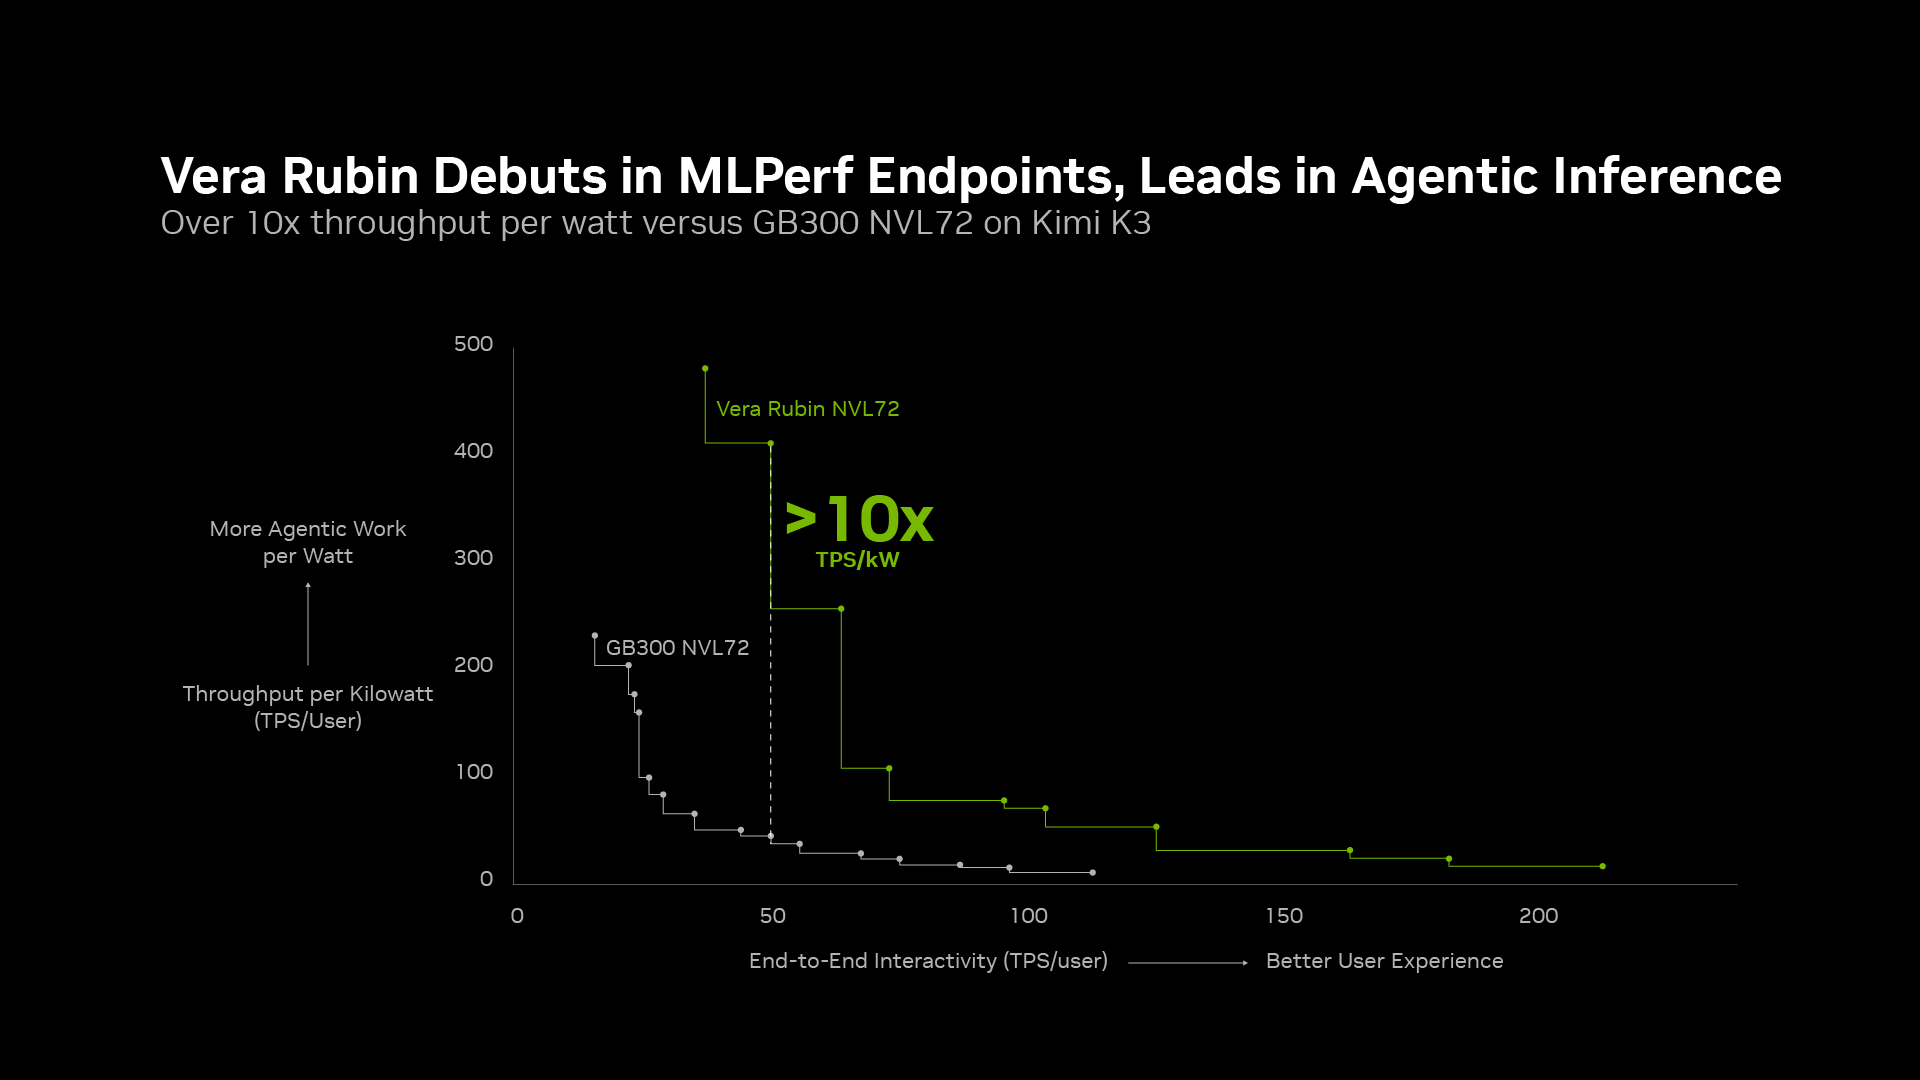
每个 AI 服务都必须同时服务众多用户与快速响应每一位用户之间取得平衡。Vera Rubin 将整条曲线平移,在服务更多用户的同时响应更快。
跨基准测试与工作负载的领先地位
NVIDIA 在 MLPerf 训练与终端测试中全面领先,Vera Rubin 首秀即展现领先性能
NVIDIA 合作伙伴广泛参与了 MLPerf 训练测试,共有 20 家机构提交了结果:ASUS、Azure、Cisco、CoreWeave、Crusoe、Dell Technologies、Firmus、Fujitsu、Giga Computing、Google Cloud、HPE、Inventec、Krai、Lambda、Nebius、Oracle、Quanta Cloud Technology(QCT)、Supermicro、TTA 以及佛罗里达大学。
这些提交结果展示了 NVIDIA 的可编程平台如何借助开源库和框架,让庞大的合作伙伴生态得以创新并优化 AI 训练性能。
这一领先优势不止于 MLPerf。
Vera Rubin 在包括 SemiAnalysis AgentX 和 Artificial Analysis AgentPerf 在内的独立基准测试中同样取得了领先性能,表明同一套 NVIDIA 基础设施能够高效运行从预训练、后训练到智能体推理的各类工作负载,以及 AI 之外的工作负载,例如本周在 SC26 上展示的高性能计算。
如需深入了解结果,请参阅 MLPerf 训练与 MLPerf 终端测试的技术博客。
- AI 基础设施
- NVIDIA Vera Rubin
相关新闻
NVIDIA 在 MLPerf 训练与终端测试中全面领先,Vera Rubin 首秀即展现领先性能
NVIDIA 发布 Rubin HPC —— 一款加速科学、工程与分析领域智能体的全新 GPU