 Newshot
funkycache:一个用 SQLite 缓存函数的 Python 库
- 发布于 2026年11月16日
- 归档于 Python、关于博客的博客
六个月前,我写了一个基于 SQLite 的缓存,用来加速这个站点的构建系统。静态站点生成器是缓存的理想候选,因为其中有许多步骤具有确定性行为且没有副作用。在一个有数百个页面的站点上,即使每个步骤只花几毫秒,累积起来也是可观的改进。
最初的缓存相当基础。它支持获取和设置字符串,带有一个用于区分不同函数的命名空间,仅此而已:
        from mosaic.cache import SQLiteCache

cache = SQLiteCache("example.db")

cache.set(namespace="fibonacci", key="10", value="55")
print(cache.get(namespace="fibonacci", key="10"))
这体现了缓存的价值,但它提供的是缓存存储,而不是缓存逻辑。如果我想缓存一个函数,就必须为每个函数编写把值保存到缓存以及之后取回的代码。这些代码中有很多难以测试,而且存在隐蔽的缺陷。我对这些代码太没把握,以至于每次为发布而构建站点时都会把缓存删掉。
我想要更好的东西,于是上周我写了 funkycache,一个新库,封装了我所有的缓存逻辑,使用和测试都容易得多。它可以存储任意 Python 对象作为输入和输出,对调用者来说接口也简单得多。
要缓存一个函数,你创建一个 FunkyCache 实例,并给函数加上一个装饰器:
        from funkycache import FunkyCache

cache = FunkyCache(storage="sqlite")

@cache.register
def expensive_function(arg1: str, arg2: int, arg3: date) -> tuple[str, date]:
    ...
这是参照标准库中的 functools.cache 设计的。这个耗时函数的输出会写入一个 SQLite 数据库,因此在 Python 进程退出后仍然可用。
缓存在失效处理上尽量做得聪明。如果包含 expensive_function 的源文件发生变化,该函数的缓存就会失效,并在下次调用时重建。
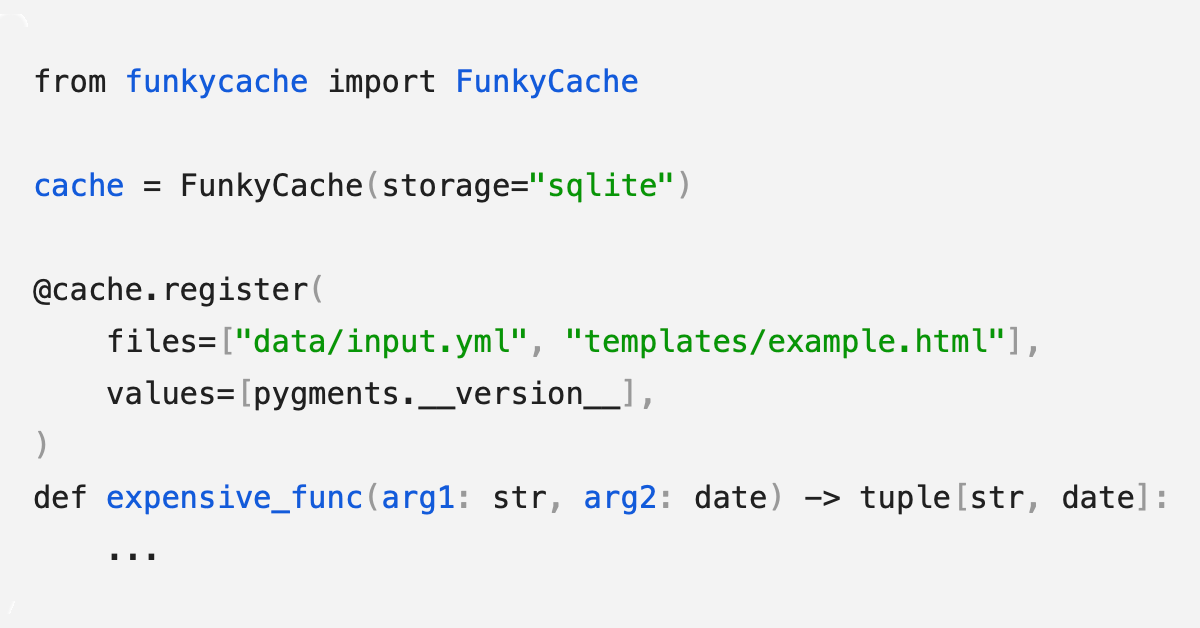
你还可以指定对其他文件和静态值的依赖,这些内容的变化也会触发缓存失效:
        from funkycache import FunkyCache

cache = FunkyCache(storage="sqlite")

@cache.register(
    files=["data/input.yml", "templates/example.html"],
    values=[pygments.__version__],
)
def expensive_function(arg1: str, arg2: int, arg3: datetime) -> tuple[str, datetime]:
    ...
在编写 funkycache 时,我想花一周时间认真思考缓存逻辑,彻底测试它,然后几个月都不再想它。你应该能够在不理解其工作原理的情况下使用 funkycache——但如果你想了解,那就是我在本文剩余部分要解释的内容。
如果你想自己试试,funkycache 在 PyPI 上,源代码在这个网站上。
缓存键是函数参数,经过哈希和 JSON 编码
获取函数的完整参数集合
缓存适用于对给定输入总是产生相同输出的函数,因此输入就是缓存键。当我们装饰一个函数时,可以看到每次调用传入的参数:
        from functools import wraps

def my_decorator(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        print({"args": args, "kwargs": kwargs})
        return func(*args, **kwargs)
    return wrapper
这没有考虑调用同一函数的不同方式——例如,位置参数与关键字参数,或者省略或覆盖默认参数。
要获得完整、一致的参数集合,我使用 inspect 模块:
        import inspect

sig = inspect.signature(func)
bound = sig.bind(*args, **kwargs)
bound.apply_defaults()
cache_key = bound.arguments  # {"arg1": val1, "arg2": val2, ...}
文章标题:funkycache:一个用 SQLite 缓存函数的 Python 库
正文: 这给了我一个 Python 字典,包含函数的完整参数集,无论调用方式如何,得到的都是同一个字典。
把参数转换为 JSON
Python 字典不可哈希,所以它们不能用作字典的键,也不能用作 SQLite 数据库的键。我们需要把它们序列化为字符串或字节序列。
对于这种序列化,我考虑过两个选项:pickle 和 JSON。在我有限的测试中,JSON 比 pickle 更快,所以我选择了 JSON。使用 JSON 还让我在加速序列化方面有了更多灵活性。
我最初的序列化就是一次朴素的 json.dumps 调用,加了几个选项来确保顺序一致,并处理标准库不知道如何编码的类型:
json_key = json.dumps(cache_key, sort_keys=True, default=str)
当我开始使用 funkycache 时,这个编码步骤很快就成了最慢的部分,所以我开始“缩减”参数,让这一步更快。这种缩减包括:
- 递归遍历函数参数,对大字符串做哈希
- 用 Pydantic 把 Pydantic 模型和 dataclass 转换成 Python 对象,而不是做字符串转换
- 重构我的代码,让每个函数只接收最小集合的必需数据
这些都是有损变换,但对于缓存键来说没关系——我们永远不需要取回原始值。理论上不同的值有可能得到碰撞的哈希键,但在我的规模下不太可能。(我网站的一次干净构建只用到 32,000 个键。)
哈希以获得更小的键
我的静态网站生成器中的函数要处理文章内容之类的东西,所以单个函数参数可能有几千字节。你可以在 SQLite 中使用几千字节的键,但大概不应该——键越大,性能损失越大。
我写了一个小型基准测试来比较三种做法:直接存储 JSON 编码的参数、用 MD5 哈希、用 XXH64 哈希。结果表明,对于小键尺寸,三者不相上下;但对于较大的键,XXH64 明显更快,而 MD5 比直接把键存进 SQLite 还慢:
基于这个基准测试,funkycache 在把 JSON 缓存键插入 SQLite 之前,会先用 XXH64 对它做哈希。
xxHash 这一系列哈希算法是我在这个项目中的一次愉快发现。它们被明确设计为快速,而非密码学安全。以前我为此使用 MD5,因为它广泛可用,而我把“弱”和“快”混为一谈。实际跑一下基准测试,揭示了我的错误。
缓存值以 JSON 编码
缓存键的序列化可以是单向操作,但缓存值需要能够取回。为此,我用 inspect 模块获取被缓存函数的返回类型,然后把序列化工作交给 Pydantic。
        import inspect
import pydantic

# Get the return type of the function.
sig = inspect.signature(func)
return_type = sig.ret_annotation

# Create a Pydantic type adapter
adapter = TypeAdapter(return_type)

# Serialise as JSON
json_str = adapter.dumper_json(value)

# Deserialise from JSON
retrieved_value = adapter.validate_json(stored_value)
我的所有 Python 代码都使用类型提示和类型注解,所以这些信息保证是存在的。这在无类型的 Python 中行不通,但对我来说够用了。
另一种选择是使用 pickle,它可以存储任意 Python 对象。我不必担心安全风险,因为我只会对可信数据进行 pickle 和 unpickle,但我继续使用 JSON,因为我已经在用它做缓存键,而且它更容易调试。
缓存惰性生成器
我想缓存的一个函数是惰性生成器,这稍微棘手一些。
使用 functools.cache 会缓存生成器对象,所以每次调用都得到同一个生成器实例,它们会一起步进。这让我觉得可能令人困惑:
        import functools

文章标题:funkycache:一个用 SQLite 缓存函数的 Python 库

正文:
@functools.cache
def even_numbers():
    for i in range(10):
        yield i * 2

n1 = even_numbers()
n2 = even_numbers()
print(next(n1))  # 0
print(next(n1))  # 2
print(next(n2))  # 4
funkycache 采用了不同的做法:它把生成器物化成一个列表,并存储这个列表。取回时,列表会通过 iter 包装,重新转换回生成器。
为了防止大型或无限生成器造成无界的内存占用,这里设有一个软性内存预算。如果物化后的列表超出这个预算,我就停止将输出收集到列表中,也不向缓存保存任何内容。该列表以及随后生成的任何项都会直接从原函数传递给调用方。
跟踪依赖关系
跟踪依赖文件
我的静态网站生成器中有一些函数依赖模板文件的内容。当这些文件发生变化时,我希望使缓存失效,并重新构建使用这些模板的页面。
当你向 funkycache 注册一个函数时,可以指定它所依赖的文件或文件夹列表:
        @cache.register(files=["mosaic/text", "templates"])
def render_html(content: str, content_vars: dict[str, Any],) -> str:
    ...
funkycache 会读取这些文件各自的内容,并将它们包含在缓存键中。当文件发生变化时,它会重新评估文件列表,并决定是保留还是使缓存失效。
我决定不在 funkycache 本身中加入任何文件变更跟踪。我已经有相关代码了,而且我想让这个项目保持小巧和专注。
跟踪依赖值
函数的缓存也可以基于静态值。我用这一点来包含重要库的版本,这样当我更新库时缓存就会失效。下面是一个简短的例子:
        import pygments

@cache.register(values=[pygments.__version__])
def apply_syntax_highlighting(src: str, lang: str) -> str:
    ...
响应式编程的愿景
这个项目始于我对响应式编程的思考。
响应式编程有点像使用电子表格。你有用于输入数据的输入单元格,以及其他读取这些数据、并在输入变化时自动更新的单元格。这些单元格又可以是其他单元格的输入,依此类推。
想象构建一个静态网站:你的 Markdown 文件充当输入单元格,而渲染出的 HTML 页面是依赖单元格。你的任务构成一个有向无环图(DAG),更新会沿着图传播。
例如,在上图中,当 article1.md 发生变化时,系统知道它需要重新构建 article1.html,并将该更新波及到 list_of_articles.html。但由于它们的输入没有变化,渲染 article 2 和 article 3 的任务根本不会运行。
如果做得好,这可以是一种非常高效的编程风格,因为只有在输入发生变化时,步骤才会运行。
有一些工具可以为你做到这一点,比如 Apache Airflow,但我想构建自己的。我的网站是一个沙盒,我喜欢自己动手构建东西作为学习练习,而不是使用别人的库。
我花了几周时间尝试设计一个 API,但没能想出令人满意的方案。不过,我试验了一种基于装饰器的 API,这促使我构建了 funkycache,它以较低的复杂度带来了许多好处。
现在用热缓存构建我的网站大约需要半秒钟,其中相当大一部分时间花在遍历文件系统查找 Markdown 文件上。我也有加快这一步的想法,但那是改天的事了。
funkycache 只有几百行代码,包括测试在内。如果你觉得这个问题有意思,我鼓励你读一读它,即使它并不是你预期会使用的库。