 Newshot
Docbench:小型本地模型如何处理文档工作
YouTube 版本:
DocBlocks 最近添加了对使用本地模型为文档任务提供 AI 功能的支持。你可以选择一个模型,它会下载,然后你就能获得文档审阅和内容编辑等基础功能。
很快,我们遇到了一个明显的可用性问题:用户怎么知道该用哪些模型,尤其是在有大量模型可选的情况下?尽管我们从 Gezel 的整体评分卡中得到了一些不错的度量,我们还是着手测量并创建了一个专注于文档场景下模型可用性的合成基准。
另外,很明显的一点是,模型的有用性差异巨大,且与模型规模相关。我们需要一种方法来量化这一点。于是有了 "docbench"。
在 docbench 中,我们专注于 120 亿参数以下的真正小型模型。这是因为我们预计典型用户不会在工作站级机器上使用强大的显卡运行;相反,他们会使用普通 GPU 或“仅”CPU 本身。参数在 10-40 亿范围内的模型通常可以在配备至少 16GB 内存的现代普通计算机或现代高端手机上运行。
因此,我们针对 DocBlocks 要求模型完成的工作——审阅、写作、图表、幻灯片、学习辅助和转录清理——对 24 个本地模型(从 0.8B 到 35B 参数)进行了评分。据此,我们创建了一个 100 分制加权量表,并纳入了静态分析和基于 AI 的输出评判。作为对比,我们还通过 CLI 命令行对 GPT 6.1 Sol、Claude Opus 5.5 和 Claude Sonnet 5.5 进行了比较。
先说结论,细节在后:
- Qwen 3.8 27B Q4 以 81 分(满分 100)领先,Gemma 4 12B 以 79 分在统计上与之持平,4B 及以下的最佳模型达到约 71 分。
- 审阅最能区分模型:大模型能发现真正的问题,而 1–2B 模型则用琐碎或错误的建议来填充其审阅。
- 作为对比,现代云端模型得分在 87 到 91 之间,至少比测试中最高的本地模型高 6 分。即使是历史上的云端模型(例如 Claude Sonnet 4.6)表现也更好。
- 尽管这个评分标准似乎在真实世界任务中很好地区分了低端模型,但我怀疑如果我们设置更难的编辑和写作挑战,云端模型会领先更多。换句话说,我认为云端模型可能已经达到了这些挑战难度的上限,但在更难的挑战(例如审阅科学论文)上会表现出更大的差异。
docbench 测量什么
Docbench 覆盖 DocBlocks 提供的每一项 AI 功能,分为六个类别,并按人们依赖程度加权。每个模型回答相同的 102 个测试用例(142 个输出,因为输出可变的任务运行三次),每个答案按 0–100 分评分。
| 类别 | 权重 | 模型被要求做什么 | 用例数 | 评分构成 |
|---|---|---|---|---|
| 审阅与反馈 | 25% | 八种审阅风格:通用、简历、事实与来源、简洁性、平实语言、The Elements of Style 、联合国编辑手册、创意想法 | 28 | 15% 检查,85% 评判 |
| 写作 | 25% | 从零撰写、追加到文档、插入文档、重写选区 | 19 | 30% 检查,70% 评判 |
| 图表与插图 | 20% | 选择要说明的内容、构建 13 种图表、绘制 SVG 插图、为图像模型撰写简报 | 30 | 仅图片想法为检查;其余为 30/70 |
| 幻灯片 | 10% | 将文档转化为演示文稿的幻灯片建议 | 8 | 30% 检查,70% 评判 |
| 学习辅助 | 15% | 忠实于原文的摘要、测验和抽认卡 | 12 | 25% 检查,75% 评判 |
| 旁白清理 | 5% | 清理口述转录文本,不改变所述内容 | 5 | 40% 检查,60% 评判 |
文章标题:面向本地 AI 模型的文档任务基准测试
正文: 一个家族的得分是其各项任务得分的平均值,而 docbench 是六个家族的加权平均值。测试文档的质量有意保持中等水平,因此优秀的评审者确实有真正的问题需要发现。关于每项结果如何计算的更多说明,见附录 A。
结果
在多次运行和两台设备上,我们发现四个模型共享最高档位,一组 4–9B 模型紧随其后,差距在 10 分以内,而 3B 以下的分数迅速下降。家族得分为 0–100;顺序按 docbench 得分排列。请注意,下载大小与占用的内存量大致相关,不过某些模型(如 Nanbeige 4.2)属于例外,它们占用的内存远超其规模所暗示的水平。
| Model | Download | Docbench (95% range) | Review | Writing | Diagrams | Slides | Study | Narration |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 via Claude CLI 2 | -- | 89.5 (88.4-90.6) | 89 | 91 | 91 | 92 | 84 | 92 |
| GPT-6.1 Sol via Codex 2 | -- | 89.5 (88.4-90.4) | 88 | 93 | 90 | 94 | 83 | 92 |
| Claude Sonnet 5.5 2 | -- | 87.1 (85.8 - 88.2) | 83 | 89 | 90 | 91 | 84 | 84 |
| GPT-5.6 Sol via Codex | -- | 86.5 (84.8-88) | 84 | 92 | 87 | 88 | 81 | 85 |
| Claude Sonnet 4.6 2 | -- | 83.5 (81.6-85.2) | 78 | 88 | 85 | 91 | 77 | 86 |
| Gemma 4 31B 2 | 17.57 GB | 83.1 (80.7-83.8) | 74 | 89 | 85 | 84 | 78 | 89 |
| Claude Haiku 4.5 2 | -- | 81.5 (80.1-82.9) | 71 | 89 | 88 | 87 | 79 | 90 |
| Qwen 3.8 27B Q4 | 16.5 GB | 81 (79–82) | 72 | 89 | 82 | 89 | 74 | 86 |
| Qwen 3.8 27B Q2 | 9.8 GB | 79 (77–81) | 69 | 87 | 78 | 89 | 74 | 87 |
| Gemma 4 12B 2 | 6.7 GB | 79.7 (77–81) | 70 | 83 | 84 | 86 | 72 | 88 |
| Gemma 4 26B-A4B | 14.5 GB | 79.2 (77.7-80.7) | 67 | 88 | 83 | 89 | 73 | 85 |
| Qwen 3.6 35B-A3B (MoE) | 22.7 GB | 76 (73–79) | 61 | 89 | 73 | 89 | 74 | 86 |
| Ornith 1.5 9B | 5.6 GB | 73 (71–75) | 50 | 87 | 78 | 86 | 73 | 77 |
| Gemma 4 E4B | 4.2 GB | 73 (71–75) | 52 | 86 | 74 | 86 | 69 | 86 |
| Qwen 3.5 9B | 5.9 GB | 72 (70–74) | 52 | 87 | 72 | 84 | 71 | 82 |
| Qwen 3.5 4B | 2.8 GB | 71 (69–72) | 47 | 85 | 77 | 85 | 67 | 79 |
| Nanbeige 4.2 3B 1 | 2.7 GB | 71 (68–73) | 53 | 83 | 71 | 83 | 69 | 79 |
| Nemotron 3.5 Bolt E4B | 6.2 GB | 69 (67–72) | 50 | 85 | 66 | 82 | 68 | 83 |
| GPT-OSS 20B (MoE) 1 | 11.7 GB | 67 (64–69) | 40 | 83 | 73 | 79 | 67 | 75 |
| Granite 4.2 8B | 5.3 GB | 66 (63–68) | 38 | 82 | 69 | 82 | 67 | 76 |
| Gemma 4 E2B | 2.6 GB | 64 (61–66) | 40 | 74 | 69 | 80 | 65 | 72 |
| MiniCPM5 2B | 1.6 GB | 59 (57–62) | 35 | 74 | 60 | 75 | 59 | 75 |
| Granite 4.2 3B | 2.2 GB | 59 (56–61) | 33 | 74 | 60 | 78 | 59 | 67 |
| Qwen 3.5 2B | 1.3 GB | 56 (53–58) | 30 | 74 | 51 | 75 | 55 | 71 |
| LFM3 1.7B† | 1.0 GB | 55 (52–58) | 30 | 68 | 70 | 76 | 57 | 13 |
| Apple Foundation Models 2 3 | -- | 54.4 (51.7-57.1) | 26 | 78 | 45 | 73 | 55 | 75 |
| Llama 3.2 3B† | 2.0 GB | 54 (51–56) | 32 | 66 | 56 | 64 | 53 | 68 |
| LFM2.5 2.6B† | 1.7 GB | 47 (44–49) | 40 | 72 | 50 | 0 | 57 | 0 |
| Qwen 3.5 0.8B | 0.5 GB | 43 (40–45) | 20 | 56 | 32 | 70 | 46 | 67 |
| MiniCPM5 1B | 0.7 GB | 37 (35–40) | 14 | 54 | 32 | 63 | 34 | 47 |
† - 自定义许可证:已评分,但 DocBlocks 从不推荐它们。“E4B”和“E2B”模型运行起来像 4B 和 2B 模型,但嵌入中携带了更多参数。
1 - 在对 Gezel 进行两处修复后重新测量
2 - 在不同设备上进行了第二轮运行,但使用相同的软件。类似模型的比较测试判定为 +/- 1.3 分,很可能是采样噪声
3 - 对于 Apple Foundation Models,大约有 3 分是因为全部 12 个插图用例得分为零而损失的,因为 DocBlocks 仅在 16K+ 上下文上提供插图,而 Apple 只有 8K
有几项结果值得注意:
- 写作容易;评审不易。写作分数从 54 到 89;评审从 14 到 72,而且它是最高两个档位中每个模型最弱的家族。
- 一个 2-bit 的 27B 模型几乎与其 4-bit 构建相当。Qwen 3.8 27B 在 Q2 下以 9.8 GB 获得 79 分,与 Gemma 4 12B 持平,并领先于其他所有该规模的模型。
- 更大并不总是更好。35B 的混合专家模型和 GPT-OSS 20B(一个较旧的模型)都落后于稠密的 12B Gemma,主要差距在审阅任务上。
- 零分意味着输出不可用。LFM2.5 的幻灯片和旁白回答每次都超出长度限制,因此 DocBlocks 什么也显示不出来。
审阅能力的差异
也许并不意外的是,每个模型在查找拼写错误方面都比在结构方面表现更好。
为测试审阅能力,我们把文档中植入的问题分为模型能够发现的小问题、中等问题和重大问题三类:
- 小问题涵盖基本的语法修正、重复词语、拼写错误和主谓一致
- 中等问题涵盖内容上更广泛的文体问题。例如被动语态和含糊表达、冗长啰嗦
- 重大问题涵盖更多文档层面的反馈。例如文档中的事实矛盾、与前文各节相互冲突的引用,或首次出现在文档结论性总结中的陈述
更具体的审阅风格会植入各自类型的问题:
- 事实核查。一份水务通知建议居民把水烧开“因为烧开可以去除铅”。事实并非如此(烧开反而可能使铅浓缩),所以这条安全建议是错误的。较小的植入问题包括算术失误,例如 48 中的 36 应为 75%,文中却写成“36 (60%)”。
- 简历。标记职责而非成就(“负责维护内部报告仪表板”)、结果没有数字(“改善了分析网站的页面加载时间”),以及工作经历未按倒序排列。
- 政策。 “它适用于所有全职员工”与后文给予兼职员工远程办公日的规定相矛盾,而“核心工作时间”被要求却从未定义。
最好的本地模型之一能发现 92% 的植入小问题,但只能发现 10% 的重大问题,而 2B 以下的模型给出的琐碎或错误建议多于真正有用的建议。“琐碎”建议只是复述原文或夸赞原文(“这是一个正确的句子”)。它浪费读者时间却不能改进草稿,因此和错误建议一样会被扣分。有些文档本身完全没有任何问题。在这类文档上凭空捏造问题的模型会失分。
这些计数来自通用审阅任务:四份中等质量的文档,每份植入约八个问题。
| 模型 | 每份文档的真实建议数:小 · 中 · 大 | 每份文档的琐碎建议数 | 每份文档的错误建议数 | 发现的植入问题:小 · 中 · 大 |
|---|---|---|---|---|
| Qwen 3.8 27B Q4 | 2.8 · 2.0 · 0.3 | 0.0 | 0.0 | 92% · 73% · 10% |
| Gemma 4 12B | 2.5 · 1.5 · 0.5 | 0.3 | 0.0 | 83% · 55% · 20% |
| Qwen 3.6 35B-A3B | 2.7 · 1.3 · 0.3 | 0.3 | 0.3 | 78% · 50% · 13% |
| Ornith 1.5 9B | 2.5 · 0.8 · 0.3 | 2.0 | 1.0 | 83% · 36% · 40% |
| Qwen 3.5 9B | 1.8 · 1.0 · 0.8 | 0.5 | 0.5 | 58% · 55% · 30% |
| Qwen 3.5 4B | 1.0 · 0.3 · 0.3 | 0.8 | 0.8 | 33% · 18% · 10% |
| Gemma 4 E2B | 1.3 · 0.8 · 0.0 | 1.3 | 1.5 | 50% · 36% · 10% |
| MiniCPM5 2B | 1.7 · 0.3 · 0.3 | 1.3 | 1.3 | 56% · 13% · 13% |
| Qwen 3.5 0.8B | 0.7 · 0.0 · 0.0 | 3.3 | 0.3 | 33% · 0% · 0% |
| MiniCPM5 1B | 0.0 · 0.0 · 0.3 | 3.3 | 1.0 | 0% · 0% · 10% |
图像与图表
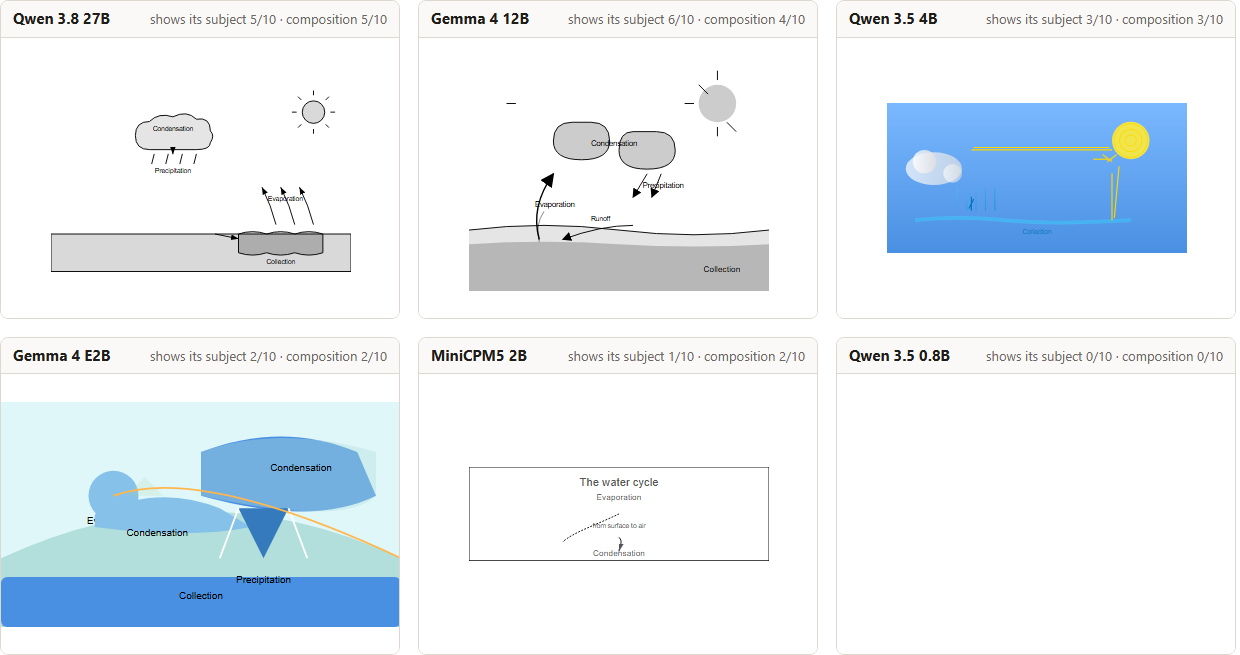
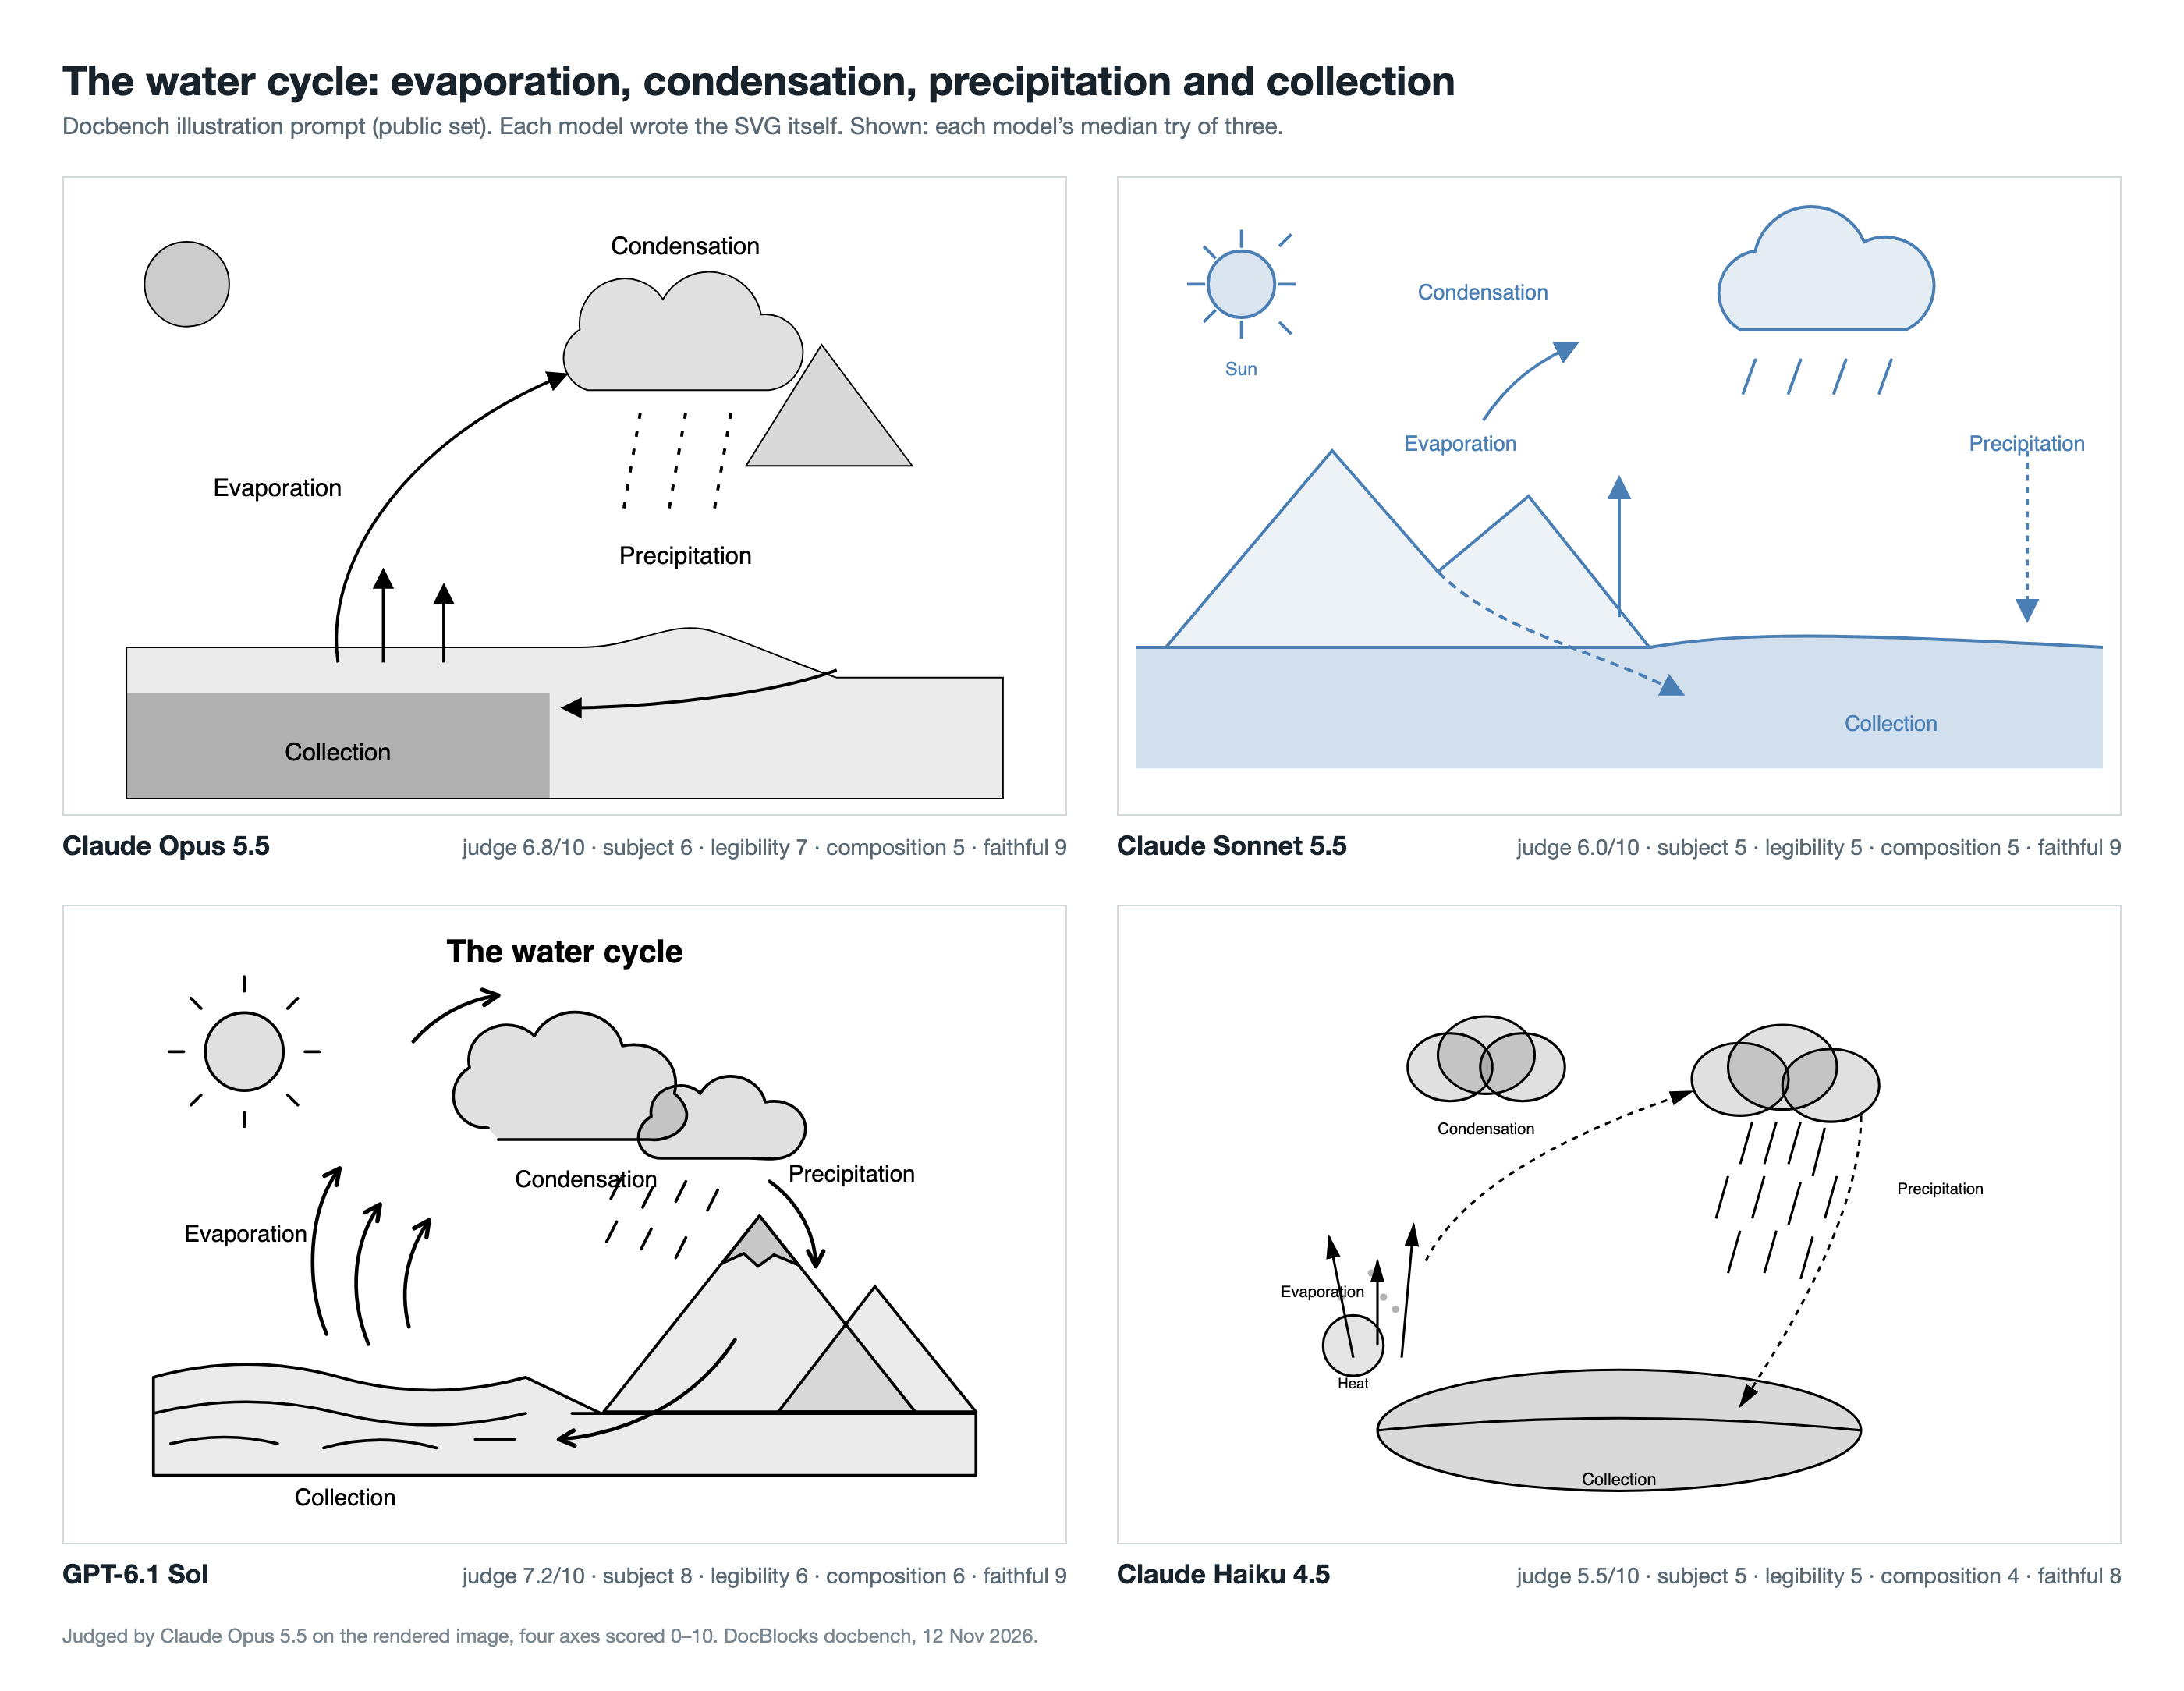
在区分模型方面,手绘图的区分度超过其他任何任务,而图表(通过严格符合 schema 的 JSON 渲染)几乎区分不出模型。当要求绘制一张水循环的 SVG 图片时,最大的模型画出了可辨认的场景,并标注了全部四个阶段;最小的模型只画出了松散的形状,没有循环,或者干脆什么都没画。
| Model | SVG illustrations (0–100) | Shows its subject (0–10) | Composition (0–10) | Diagrams (0–100) |
|---|---|---|---|---|
| Qwen 3.8 27B Q4 | 79 | 6.3 | 5.8 | 91 |
| Qwen 3.6 35B-A3B | 73 | 6.3 | 4.8 | 91 |
| Gemma 4 12B | 66 | 5.1 | 3.7 | 91 |
| GPT-OSS 20B | 62 | 4.9 | 3.9 | 91 |
| Gemma 4 E4B | 60 | 3.9 | 2.5 | 89 |
| Qwen 3.5 4B | 55 | 3.0 | 2.3 | 85 |
| LFM3 1.7B | 52 | 2.1 | 1.5 | 85 |
| Gemma 4 E2B | 51 | 2.3 | 1.7 | 76 |
| Qwen 3.5 0.8B | 25 | 1.0 | 0.6 | 55 |
| MiniCPM5 1B | 14 | 0.0 | 0.2 | 41 |
差距来自谁来画:
- 对于图表,由 DocBlocks 来画。模型只负责填写一份结构化规格(JSON 遵循 schema)——哪种图表、哪些方框、标签和连线——然后 DocBlocks 将其渲染出来,所以画面始终干净整洁。大多数 3B 及以上的模型得分在 85–91,甚至 1.7B 的 LFM3 也能达到 85。
- 对于插画,由模型来画。它要自己写 SVG:每一个坐标、形状和标签位置。这需要空间规划能力,而小模型并不具备。
- 即便是最好的画作也相当一般。Qwen 3.8 27B 在表现主题方面平均只有 10 分中的 6.3 分:简单、带标签的场景,更接近剪贴画而非插画。
- 小模型很少凭空编造,它们只是画不出来。大多数模型在对来源的忠实度上得分为 10 分中的 5–9 分,而在表现主题上只有 1–3 分。
- 有些失败在代码中是看不见的。Qwen 3.5 0.8B 的水循环是一段合法但什么都没画出来的 SVG:它的样式设置让每个标签都变成透明,而且它没有绘制任何形状。这就是为什么评审打分的是渲染出来的画面,而不是 SVG 源码。
六个模型对同一个水循环提示的回答,以及评审的评分:
以下是云端等效版本:
Summary
这组测试清楚地表明,消费级硬件可用的能力范围非常宽广:从几乎无法连贯地审阅,到具备实用功能,再到接近前沿的质量。
指导原则依然简单:选择你的机器能承载的最高档位。DocBlocks 会为你完成这件事:它的模型列表会按 docbench 对可下载模型进行排名,只列出适合你的电脑或手机的模型。
按下载大小粗略参考:
- 大量 GPU 或统一内存:Qwen 3.8 27B 的 Q4 版本(16.5 GB),得分最高。
- 大约一半:Qwen 3.8 27B 的 Q2 版本(9.8 GB)或 Gemma 4 12B(6.7 GB),两者都在最高档。
- 典型笔记本电脑:Gemma 4 E4B(4.2 GB,73)或 Qwen 3.5 4B(2.8 GB,71)。
- 手机和小型机器:Gemma 4 E2B(2.6 GB,64)。低于 2B,写作辅助仍然可用,但审阅大多是噪音。
Gemma 4 12B 是最佳平衡点:强大到真正有用,又小到能在大多数现代 PC 和 Mac 上运行。免费、私密,且足以胜任真实的文档工作。它带来了希望:除了硬件和电费成本外,本地模型可以免费为广大用户群体提供真正的价值。
Appendix A: More Measurement Details
每个回答都会经过与真实 DocBlocks 请求相同的代码路径,然后接受自动检查,并由 AI 评审打分。
- 产品自身的路径。基准测试通过 Gezel(DocBlocks 使用的本地模型运行时)调用 DocBlocks 的真实流水线——其提示、解析器、修复和重试——并应用每个模型的目录设置。模型看到的正是用户请求会发送的内容,日期和随机种子固定不变。
- 每个模型都用同一套适度的配置。每个模型都在 llama.cpp 上运行,大多是 4-bit(Q4)构建,上下文为 32,768 token:这是 Gezel 在受限笔记本电脑上提供的配置。
- 自动检查。首先是:DocBlocks 究竟能否使用这个回答?它必须能解析、能干净地应用到文档、能完整结束而不被截断,并保留来源中的数字和名称。DocBlocks 无法向你展示的回答得 0 分。
本地 AI 模型文档任务的基准测试
- 质量评判。Claude Opus 5.5 根据每项任务的书面评分标准为每个可用答案打分。绘图按渲染出的图片评判,而非按代码评判。
- 供审阅的答案要点。每份审阅文档都植入了问题,并按修复这些问题对草稿的改变程度标注:小(一个错别字)、中(一个句子)或大(结构、矛盾、被埋没的要点)。评判者标出模型找到了哪些问题,并将每条建议标记为有效、琐碎或错误。审阅评分基于发现问题(重大问题计为小问题的三倍)且不注水,而对于没有可发现问题的干净文档,编造问题会被扣分。
- 范围与区间。对用例和重复运行进行 bootstrap,为每个分数给出 95% 的范围。范围重叠的模型归入同一区间,这是解读排序最公平的方式。
速度不计入分数;写得好的慢模型依然得分高。
这个测试公平吗?
在公布任何分数之前,评判者通过了三项一致性检查,并且一个私有测试集对模型的排名与公开测试集相同。
- 它对同一答案给出相同的评分。对样本重新评分,分数平均变动 0.16 分(0–10 分制);上限为 0.7。
- 第二位评判者意见一致。Claude Sonnet 5.5 对同一样本评分,一致性为 0.84(Krippendorff's alpha;门槛为 0.6)。
- 它不会被损坏的答案欺骗。我们通过截短、注水、更改数字,或将审阅发现改成“这句话是正确的”来劣化好答案。评判者在 62 个案例中的 56 个里给这些答案扣了 2 分或更多(90%,即门槛),并且在测验和幻灯片要点等列表类答案上表现最弱。
我们还保留了 32 个私有测试用例,并在其上运行了五个模型。如果提示词针对公开文档调优过,模型在私有用例上的表现会更差。事实并非如此:排序完全相同,而且每个模型在私有集上的得分都略高。
| 模型 | 公开集 | 私有集(95% 范围) | 差值 |
|---|---|---|---|
| Qwen 3.8 27B Q4 | 80.7 | 82.6 (80–85) | +1.9 |
| Gemma 4 12B | 78.8 | 81.3 (80–83) | +2.5 |
| Qwen 3.5 4B | 70.7 | 71.2 (68–74) | +0.5 |
| MiniCPM5 2B | 59.3 | 65.6 (63–69) | +6.3 |
| Qwen 3.5 0.8B | 42.7 | 43.6 (40–47) | +0.9 |
两个集合之间,各系列分数变动最多达 16 分,因为每个系列仅基于少量用例。请按总体分数和区间对模型排名,并将系列分数视为画像。
这些数字没有告诉你的事:
- 其他配置。每个模型都在一台机器(一台 NVIDIA RTX Spark N1X,可用内存 23 GB)上、在 llama.cpp 上运行,上下文为 32K。其他引擎和量化方式会得到不同的分数。
- 速度。不计分。在测试机器上,完整基准测试对 Gemma 4 E2B 耗时 7 分钟,对 35B 混合专家模型耗时 4.4 小时。
- 英语文档之外的任何内容。所有测试文档均为英语。
- 来自 AI 评判者的确定性。评判者通过了其检查,但它仍然是一个模型,且在列表类答案上表现最弱。
- 跨版本比较。分数仅在同一 docbench 版本(0.2)内进行比较;新版本会重新测量每个模型。