 Newshot
在 Amazon Bedrock Managed Knowledge Base 中使用表格搜索从表格中获取答案
Amazon Bedrock Managed Knowledge Base 现在支持表格搜索,因此你可以通过 agentic retrieval 从表格中获取答案。当问题需要来自 CSV、XLSX 或 XLS 文件的数据时,表格搜索会查找数值,并跨一个或多个表格或工作表中的每一相关行进行计算。随后,它会把结果与相关文档中的事实结合起来,回答需要多个步骤的分析性问题。
一个正在结账的财务团队需要知道“哪些部门必须撰写差异说明?”没有任何单个文件包含答案。答案取决于差异政策的阈值、季度结账备忘录中的预算修订,以及对损益(P&L)工作簿中每个部门进行的计算。
与这个财务团队一样,大多数团队把叙述性材料和数据放在同一个地方。例如,一个 Microsoft SharePoint 站点把工作簿与政策放在一起,一个 Amazon Simple Storage Service(Amazon S3)存储桶把 CSV 导出文件与 PDF 放在一起。表格搜索通过你已在用于文档的同一个 AgenticRetrieveStream 请求,跨这些文件回答问题。它会在隔离沙箱中针对原始文件运行代码,因此答案使用整张表,而不只是检索返回的那些行。对财务团队来说,一次请求就会返回必须撰写差异说明的部门。答案会引用政策和备忘录,跟踪记录会指明代码读取的工作簿。
在本文中,你将了解表格搜索如何回答既需要表格数据又需要文档事实的问题,以及什么时候其他工具更合适。你还将使用示例财务文件构建一个知识库,并使用跟踪记录查看代码读取了哪个文件。
为什么表格对检索来说很难
检索增强生成(RAG)会返回与问题最匹配的固定数量段落,这对散文很有效。表格在被拆分成段落时会丢失信息,丢失方式取决于表格的形状:
- 长表——一张有数千行的表会跨越许多段落,而检索只返回与问题最匹配的少数段落。基于这些段落构建的答案只使用少量行,因此总计、比较或阈值检查可能不完整。
- 宽表——在一张有数百列的表里,一行包含的文本可能超过一个段落或搜索模型一次能接收的量。因此,后面列中的值更难匹配。来自宽表的长段落也可能匹配许多无关问题,并把更相关的段落挤出结果。
检索还必须把问题匹配到正确的表。问题使用业务术语,例如“controllable spend”,但表格中存放的是成本中心代码、账户名称和数字。草稿工作簿和最终工作簿在搜索看来几乎一样。赋予数字含义的规则通常位于单独的文档中,例如政策。
因此,表格搜索把工作拆分开。检索只需从正确的表格文件中返回一个段落,然后由代码读取整张表。由于检索仍然必须先找到该文件,因此在问题中写明文件名会有帮助。
表 1 展示了普通检索和表格搜索分别如何处理财务团队的问题:“哪些部门必须撰写差异说明?”
| 比较项 | 仅检索 | 带表格搜索的 agentic retrieval |
|---|---|---|
| 你得到什么 | 来自政策、备忘录、业务回顾和工作簿的段落,但没有完整答案 | 一个答案,列出 Sales、Engineering 和 Operations,以及每个部门相对其修订预算的差异 |
| 修订后的差异百分比 | 不可用。没有文件存储这些数据,因此任何段落都不可能包含它们 | 根据最终工作簿中的每个部门行计算得出 |
| 来源 | 每个段落链接到自己的文件,但其中没有一个包含答案 | 引用财务政策和结账备忘录。跟踪记录指明代码读取的工作簿 |
文章标题:在 Amazon Bedrock Managed Knowledge Base 中使用表格搜索从表格中获取答案
正文: 表 1:同一个问题分别用普通检索和表格搜索得到的结果。
表格搜索在 agentic retrieval 中的工作方式
在 agentic retrieval 中,agent 通过检索来判断哪些文档重要,然后撰写答案。表格搜索是这一流程的一部分,因此无需开启任何开关。
当问题需要表格中的数据时,请求会经过以下阶段:
- 检索(Retrieve)– 返回若干段落,其中包括来自表格文件的段落。
- 规划(Plan)– agent 利用问题和表格结构来判断是否要在一个或多个已检索到的表格上运行代码。
- 暂存(Stage)– 表格搜索把原始文件复制到一个无网络访问权限的隔离沙箱中。
- 计算(Compute)– 由模型编写的代码在整个表格或工作表上运行。
- 返回(Return)– agent 只拿回代码打印出的内容,例如合计值或匹配的行。
- 作答(Answer)– agent 根据计算结果和段落作答,并附上引用。
当检索到的段落来自 CSV、XLSX 或 XLS 文件,且问题需要对多行进行计算或查找特定值时,就会启动表格搜索。
知识库、连接器与 API
一个 AgenticRetrieveStream 请求可以搜索一个或多个知识库。Retrieve API 则持续返回段落,不运行代码。
无论使用哪种连接器把文件导入知识库(包括 Amazon S3、Microsoft SharePoint、Atlassian Confluence 等),表格搜索的工作方式都相同。
适用范围与取舍
表格搜索是为那些需要对其检索到的表格文件进行计算或查找的问题而构建的。运行代码至少会增加一轮 agent 交互,因此使用表格数据的答案会比纯文本答案更慢。受治理的指标、周期性仪表板、仓库级联接和报表控制仍然属于你的商业智能(BI)工具。表格搜索作用于与文档存放在一起的表格文件,且你无需定义 schema。
解决方案概览
在本方案中,一个 Amazon Bedrock Managed Knowledge Base 存储你的 CSV 和 Excel 文件,以及相关文档(如 PDF 和 Word 文件)。你的应用程序把每个问题都交给 agentic retrieval 处理。当问题需要表格数据时,答案会把对表格的计算与文档中的事实结合起来。它会引用所用的段落,且 trace 会指出代码读取了哪些表格文件。
在图 1 中,Amazon S3 数据源把这些文件同步到知识库,知识库保存嵌入、文本、元数据以及原始文件。当你的应用程序用 AgenticRetrieveStream 发送问题时,agentic retrieval 会规划工作并从知识库检索段落。如果问题需要表格文件中的数据,它会把要读取的文件发送到一个无网络访问权限的隔离沙箱。在那里,由模型编写的代码在原始文件上运行并返回打印结果。带有引用和 trace 事件的答案会流式返回给应用程序。
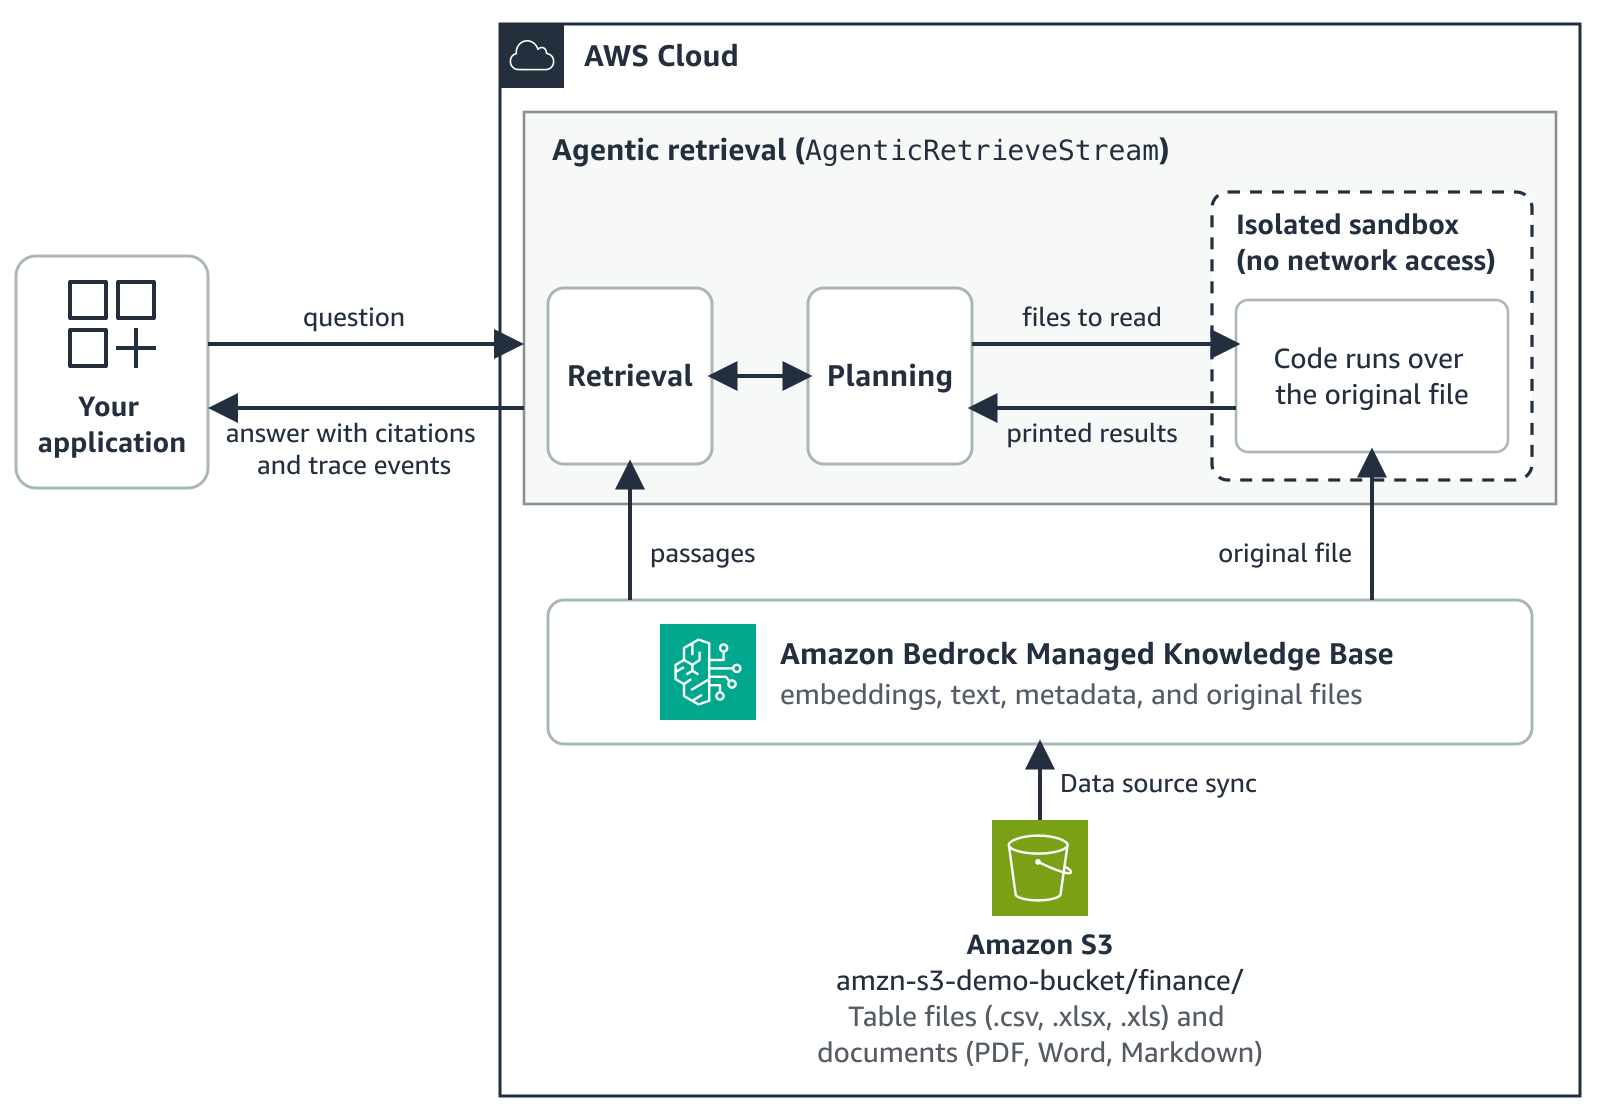
图 1:Amazon Bedrock Managed Knowledge Base 中的表格文件和文档,表格搜索位于 agentic retrieval 内部。
这个实操示例使用虚构的 AnyCompany Retail 财务文件:
- Final P&L 工作簿(anycompany-pnl-fy2026.xlsx)。它包含 Notes、Actuals、Budget 和 Summary 工作表,其中 Actuals 和 Budget 工作表按月份、成本中心和科目各占一行。
- 草稿工作簿。包含不同第三季度数字的初步副本。
- 财务差异政策(PDF)。定义可控支出和已批准预算,并设定审查阈值。
- 第三季度结账备忘录(Word)。列出已批准和被拒绝的预算修订。
- 业务回顾(Markdown)。说明主要差异。
这些文件位于 sample-managed-knowledge-base-patterns GitHub 仓库的 tabular-search 文件夹中。该文件夹还包含一个 AWS Cloud Development Kit(AWS CDK)应用程序,用于部署本文中的资源,以及提出这些问题的 Python 脚本。
先决条件
您需要以下内容:
- 创建 AWS Identity and Access Management(IAM)角色、S3 存储桶和 Amazon Bedrock 知识库的权限。
- 对于调用 AgenticRetrieveStream 的身份,需要具备代理式检索的权限,包括 bedrock:GetDocumentContent。代理会使用调用者的凭证读取原始表格文件。
- 在支持表格搜索的 AWS 区域中使用 Amazon Bedrock。有关区域可用性,请参阅支持的 AWS 区域。
- 您自己的 CSV、XLSX 或 XLS 文件及相关文档。
- 要跟随本演练操作:Python 3.10 或更高版本,以及 AWS SDK for Python(Boto3)版本 1.43.123 或更高版本。您也可以在 Amazon Bedrock 控制台的知识库测试窗口中或使用 AWS Command Line Interface(AWS CLI)向知识库提问。
调用身份需要具备以下策略(来自代理式检索文档):
        {
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "bedrock:AgenticRetrieveStream",
      "Resource": "*"
    },
    {
      "Effect": "Allow",
      "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
      "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/*"
    },
    {
      "Effect": "Allow",
      "Action": "bedrock:InvokeModelWithResponseStream",
      "Resource": "*"
    }
  ]
}
有关费用,请参阅 Amazon Bedrock 定价。
将文件上传到 Amazon S3
将表格文件和相关文档放在同一个前缀下。
- 打开 Amazon S3 控制台并选择创建存储桶。
- 输入一个全局唯一的存储桶名称(本文使用 amzn-s3-demo-bucket),保持选中“阻止所有公有访问”,然后选择创建存储桶。
- 选择该存储桶,选择创建文件夹,然后输入 finance。
- 打开 finance 文件夹并选择上传。
- 选择添加文件,选择您的表格文件和文档,然后选择上传。
创建知识库和数据源
知识库需要一个 Amazon Bedrock 可以代入的 IAM 角色。该信任策略仅允许 bedrock.amazonaws.com 服务主体,并且仅限您账户中的知识库。
        {
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BedrockKnowledgeBaseAssume",
      "Effect": "Allow",
      "Principal": {"Service": "bedrock.amazonaws.com"},
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {"aws:SourceAccount": "111122223333"},
        "ArnLike": {
          "aws:SourceArn": "arn:aws:bedrock:<region>:111122223333:knowledge-base/*"
        }
      }
    }
  ]
}
接下来,设置其余资源:
- 使用该信任策略创建一个名为 kb-finance-role 的角色。
- 附加一个内联策略,允许对该存储桶执行 s3:ListBucket,并对其中的对象执行 s3:GetObject。
- 创建一个类型为 MANAGED 的知识库,使用托管嵌入模型。
- 为该存储桶创建一个 MANAGED_KNOWLEDGE_BASE_CONNECTOR 数据源,范围限定为 finance/ 前缀。
- 将 maxFileSizeInMegaBytes 设置为大于您最大文件的值。
第 2 步的内联策略仅允许读取此存储桶:
        {
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "ListBucket",
      "Effect": "Allow",
      "Action": "s3:ListBucket",
      "Resource": "arn:aws:s3:::amzn-s3-demo-bucket",
      "Condition": {"StringEquals": {"aws:ResourceAccount": "111122223333"}}
    },
    {
      "Sid": "ReadObjects",
      "Effect": "Allow",
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::amzn-s3-demo-bucket/*",
      "Condition": {"StringEquals": {"aws:ResourceAccount": "111122223333"}}
    }
  ]
}
此脚本执行步骤 3 到 5,并打印出 ID:
        import time
import boto3

agent = boto3.client("bedrock-agent")

kb = agent.create_knowledge_base(
    name="finance-kb",
    roleArn="arn:aws:iam::111122223333:role/kb-finance-role",
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {"embeddingModelType": "MANAGED"},
    },
)
kb_id = kb["knowledgeBase"]["knowledgeBaseId"]

# Wait until the knowledge base is ACTIVE before adding a data source.
status = "CREATING"
while status in ("CREATING", "UPDATING"):
    time.sleep(10)
    status = agent.get_knowledge_base(knowledgeBaseId=kb_id)["knowledgeBase"]["status"]
if status != "ACTIVE":
    raise RuntimeError(f"Knowledge base status is {status}")

ds = agent.create_data_source(
    knowledgeBaseId=kb_id,
    name="finance-s3",
    dataSourceConfiguration={
        "type": "MANAGED_KNOWLEDGE_BASE_CONNECTOR",
        "managedKnowledgeBaseConnectorConfiguration": {
            "connectorParameters": {
                "type": "S3",
                "version": "1",
                "connectionConfiguration": {
                    "bucketName": "amzn-s3-demo-bucket",
                    "bucketOwnerAccountId": "111122223333",
                },
                "filterConfiguration": {
                    # In MB. Set this above your largest table.
                    "maxFileSizeInMegaBytes": "200",
                    "inclusionPrefixes": ["finance/"],
                },
                "aclEnabled": False,
            }
        },
    },
    vectorIngestionConfiguration={
        "parsingConfiguration": {"parsingStrategy": "SMART_PARSING"}
    },
)
print("knowledge base:", kb_id, "data source:", ds["dataSource"]["dataSourceId"])
同步数据源并检查文件类型
只有当知识库为其分配了正确的文件类型,表格搜索才能启动,因此请在首次同步后检查文件类型。
- 为该数据源启动一个 ingestion 作业。
- 轮询该作业,直到其状态为 COMPLETE。
- 查看作业统计中失败文档的信息。
- 用你的问题运行一次 Retrieve 调用。
- 确认表格片段显示的 _file_type 为 CSV(针对 CSV 文件)或 MS_EXCEL(针对 XLSX 和 XLS 文件)。
第一个脚本执行步骤 1 到 3:
        import time
import boto3

agent = boto3.client("bedrock-agent")
KB_ID, DS_ID = "<your-knowledge-base-id>", "<your-data-source-id>"

job_id = agent.start_ingestion_job(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)[
    "ingestionJob"]["ingestionJobId"]
while True:
    job = agent.get_ingestion_job(
        knowledgeBaseId=KB_ID, dataSourceId=DS_ID, ingestionJobId=job_id
    )["ingestionJob"]
    if job["status"] in ("COMPLETE", "FAILED", "STOPPED"):
        break
    time.sleep(15)
print(job["status"], job.get("statistics"), job.get("failureReasons"))
第二个脚本执行步骤 4 和 5,让你可以在用 agentic retrieval 提问之前检查表格文件类型。使用你自己的文件时,请提出一个将你某个文档中的规则与对你表格的计算结合起来的问题,并同时点明这两者。
        import boto3

runtime = boto3.client("bedrock-agent-runtime")
question = (
    "In fiscal Q2 of FY2026, which cost center had the largest overspend in "
    "controllable spend, as the finance policy defines it? Compare the Actuals "
    "and Budget sheets of the FY2026 P&L workbook and give the cost center and "
    "the overspend in US dollars."
)
response = runtime.retrieve(
    knowledgeBaseId="1234567890",
    retrievalQuery={"text": question},
    retrievalConfiguration={"managedSearchConfiguration": {"numberOfResults": 10}},
)
for result in response["retrievalResults"]:
    print(result["metadata"].get("_file_type"), result.get("documentId"))
跨表格和文档提问
通过 AgenticRetrieveStream 发送同一个问题。该脚本会打印答案、每一个 CodeExecution 状态,以及代码读取过的文件。
        import boto3

runtime = boto3.client("bedrock-agent-runtime")
question = (
    "In fiscal Q2 of FY2026, which cost center had the largest overspend in "
    "controllable spend, as the finance policy defines it? Compare the Actuals "
    "and Budget sheets of the FY2026 P&L workbook and give the cost center and "
    "the overspend in US dollars."
)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": question}}],
    retrievers=[{"configuration": {"knowledgeBase": {"knowledgeBaseId": "1234567890"}}}],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
    },
)

for event in response["stream"]:
    if "traceEvent" in event:
        attributes = event["traceEvent"]["attributes"]
        # CodeExecution steps report IN_PROGRESS, then SUCCEEDED or FAILED.
        if attributes.get("step") == "CodeExecution":
            print(attributes["status"], attributes.get("message"))
        # A Planning event lists the files the code will read.
        for action in attributes.get("actions", []):
            for doc in action.get("codeExecution", {}).get("documents", []):
                print("code read:", doc["documentId"])
    elif "responseEvent" in event:
        print(event["responseEvent"]["text"], end="")
对于这些文件,答案把两张工作簿表格与两份文档结合起来:
- 来自文档。财务政策将可控支出定义为 Contractors、Travel、Software 和 Marketing Programs 这几个科目,因而不包含 salaries 和 facilities。业务回顾则解释了主要的差异。
- 来自表格。代码使用 Actuals 和 Budget 表中的每一行,将两者筛选到 fiscal Q2 和这四个科目,然后比较各个成本中心。
- 答案。CC-3010(Platform)超支 124,559.90 美元,实际支出为 394,859.90,预算为 270,300.00。业务回顾将这一差异归因于为数据平台迁移而引入的承包商。如果把所有运营费用科目都计算在内,则得到 133,434.05。
阅读 trace
Trace 事件按以下顺序到达:
- Planning。一个状态为 SUCCEEDED 的 Planning 事件包含一个 codeExecution 动作,其中列出了代码将要读取的文档。
- 代码步骤。一个状态为 IN_PROGRESS(“Running code over 1 document(s)”)的 CodeExecution 事件,然后是一个状态为 SUCCEEDED 的事件。SUCCEEDED 消息会列出代码读取的每个文件及其大小。
- 答案。第二轮 planning 和响应文本之后是一个包含引用的最终结果事件。引用指向答案所用的段落,因此代码读取过的表格文件不一定总在其中。
在此示例中,Planning 事件只列出了最终的工作簿,因为政策和业务回顾是以检索到的段落形式到达的。
        {
  "traceEvent": {
    "attributes": {
      "step": "Planning",
      "status": "SUCCEEDED",
      "message": "Agent planning completed",
      "actions": [
        {
          "retrieve": {},
          "codeExecution": {
            "documents": [
              {
                "documentId": "s3://amzn-s3-demo-bucket/finance/anycompany-pnl-fy2026.xlsx",
                "sourceRetriever": {"identifier": "1234567890"}
              }
            ]
          }
        }
      ]
    }
  }
}
在较长的调用中,流会每 10 秒重复一次 IN_PROGRESS 事件,因此读取超时不会触发。无法完成的代码步骤会报告 FAILED,代理通常会重试或回退。
表格搜索作为响应生成的一部分运行,该功能默认开启,因此脚本将 generateResponse 保持未设置。如果将 generateResponse 设为 false,代理会返回检索结果而不运行代码。详情请参阅代理式检索。
尝试更多问题
以下每个问题也都将一个文档与工作簿配对。
将备忘录修订应用到季度总计
此问题需要一个仅在备忘录修订后才存在的预算:
        Did total operating expense for fiscal Q3 of FY2026 stay within the Q3 budget
as revised in the Q3 close memo? Give the actual Q3 operating expense, the
revised Q3 budget and the difference, in US dollars.
答案使用备忘录中的修订以及工作簿中的 Q3 实际值和原始预算。支出比修订后预算低 49,572.40 美元,因此答案是肯定的,尽管同样的支出超出了原始预算。普通 Retrieve 会返回备忘录和工作簿段落,但其中没有任何段落包含这些数字。
在预算修订后应用策略阈值
以下是引言中财务团队问题的完整版本。它需要策略的阈值、备忘录的修订以及工作簿:
        Applying the budget revisions approved in the Q3 close memo, which
departments must write variance commentary for fiscal Q3 of FY2026 under
the finance policy?
该策略要求当差异超过已批准预算的 5% 时提供说明,已批准预算包含已批准的修订,而备忘录批准了 Marketing 的增加和 Engineering 的削减。答案是 Sales(-6.50%)、Engineering(+5.79%)和 Operations(+6.20%)。Engineering 仅因批准的削减降低了其预算才跨过阈值。
继续对话
表格搜索也适用于多轮对话。在 messages 中发送较早的轮次,它会在需要表格的那一轮运行。第一个问题要求从工作簿进行计算:
        Calculate the Customer Support department's actual operating expense and its
budget for fiscal Q2 of FY2026 from the Actuals and Budget sheets of the final
FY2026 P&L workbook, in US dollars.
对于后续问题,在 messages 中发送第一个问题、其答案("role": "assistant")和新问题:
        Under the finance policy, does that variance need written commentary, and does
anyone besides the Controller have to review it?
差异超出预算 12.40%,因此需要书面说明。由于超过 10%,策略还要求由 CFO Nikki Wolf 审核。在这里,第一轮通常对工作簿运行代码,第二轮根据历史回答策略问题。
对于较长的会话,你可以通过设置请求中的 memoryConfiguration 将对话历史保存在 Amazon Bedrock AgentCore 内存资源中,而无需重新发送较早的轮次。详情请参阅代理式检索。
针对表的问题的最佳实践
措辞要谨慎,因为检索会选择代码读取哪张表。指明来源的聚焦问题有助于检索选择正确的表。
- 将一条规则与一张表配对。指明包含该规则的文档,例如“as revised in the Q3 close memo.”
像 {{NAME_ab12cd34}} 这样写的值是真实值的占位符。在回复和工具调用中都完全按原样使用它们:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base
正文:
- 当存在多个版本时,请指明文件名。例如,“使用最终的 FY2026 P&L 工作簿,anycompany-pnl-fy2026.xlsx。”
- 需要计算时,请明确提出计算要求。如果某个汇总表中存有某个数字,agent 可以据此作答。说“根据 Actuals 和 Budget 工作表计算每个部门的差异”,以从明细行进行计算。
- 提出聚焦的问题。在多个回合中构建更大的分析。
一些数据和应用程序方面的选择也会有所帮助:
- 将表格保存在 CSV、XLSX 或 XLS 文件中。先从 PDF 或 Word 文档中导出表格。
- 将文件大小过滤器设置得高于你最大的表格。大于 maxFileSizeInMegaBytes 的文件不会被摄取,因此代码无法读取它们。
- 将 Excel 工作表保持在 200 MB 以内。截至本文撰写时,tabular search 对 CSV 文件运行的代码上限为 500 MB(即摄取上限),但对 Excel 工作表仅支持到 200 MB。你仍然可以摄取更大的 Excel 文件,因此在依赖全表计算之前,请检查工作表大小。
- 使用 tabular search 进行分析。运行代码会增加一个 agent 回合,因此对于文本中的快速查找,请继续使用普通的 Retrieve。
- 使用元数据过滤器限定文件范围。retrievalOverrides 下的过滤器(例如针对 _document_title 的过滤器)控制代码可以读取哪些文件。
- 使用 trace 进行审计。生成的代码按设计不会返回,因为它可能回显单元格值。trace 会显示代码读取了哪些文件。
清理
为避免持续产生费用,请按顺序删除这些资源:
- 在 Amazon Bedrock 控制台中,选择 Knowledge Bases,然后选择 finance-kb。
- 选择 finance-s3 数据源并选择 Delete。
- 删除 finance-kb 知识库。
- 在 Amazon S3 控制台中,选择该存储桶,选择 Empty,然后选择 Delete,除非其他工作负载使用它。
- 在 IAM 控制台中,选择 Roles,选择 kb-finance-role,然后选择 Delete。
如果你使用仓库中的 AWS CDK 应用进行部署,请在其 infra 文件夹中运行 npx cdk destroy,而不是执行这些步骤。它会删除该堆栈创建的所有内容。
结论
财务团队成员需要知道“哪些部门必须编写差异说明?”借助 Amazon Bedrock Managed Knowledge Base 中的 tabular search,你可以通过一个 agentic retrieval 请求同时使用工作簿、政策和备忘录来回答这个问题。
在本文中,你了解了 tabular search 如何回答既需要表格数据又需要文档事实的问题,以及何时其他工具更合适。你还使用示例财务文件构建了一个知识库,并使用 trace 查看代码读取了哪个文件。
要开始使用,请参阅 Amazon Bedrock 用户指南中的 Build a managed knowledge base and agentic retrieval,以及 Amazon Bedrock API Reference 中的 AgenticRetrieveStream。要了解更多信息,请阅读 AWS Artificial Intelligence Blog 上的 Build enterprise search for agents with Amazon Bedrock Managed Knowledge Base。