 Newshot
perfectclone:1:1 复制真实网站的网站克隆工具
约 15 秒内抓取任意公开网站的真实前端。没有 AI,不消耗 token。
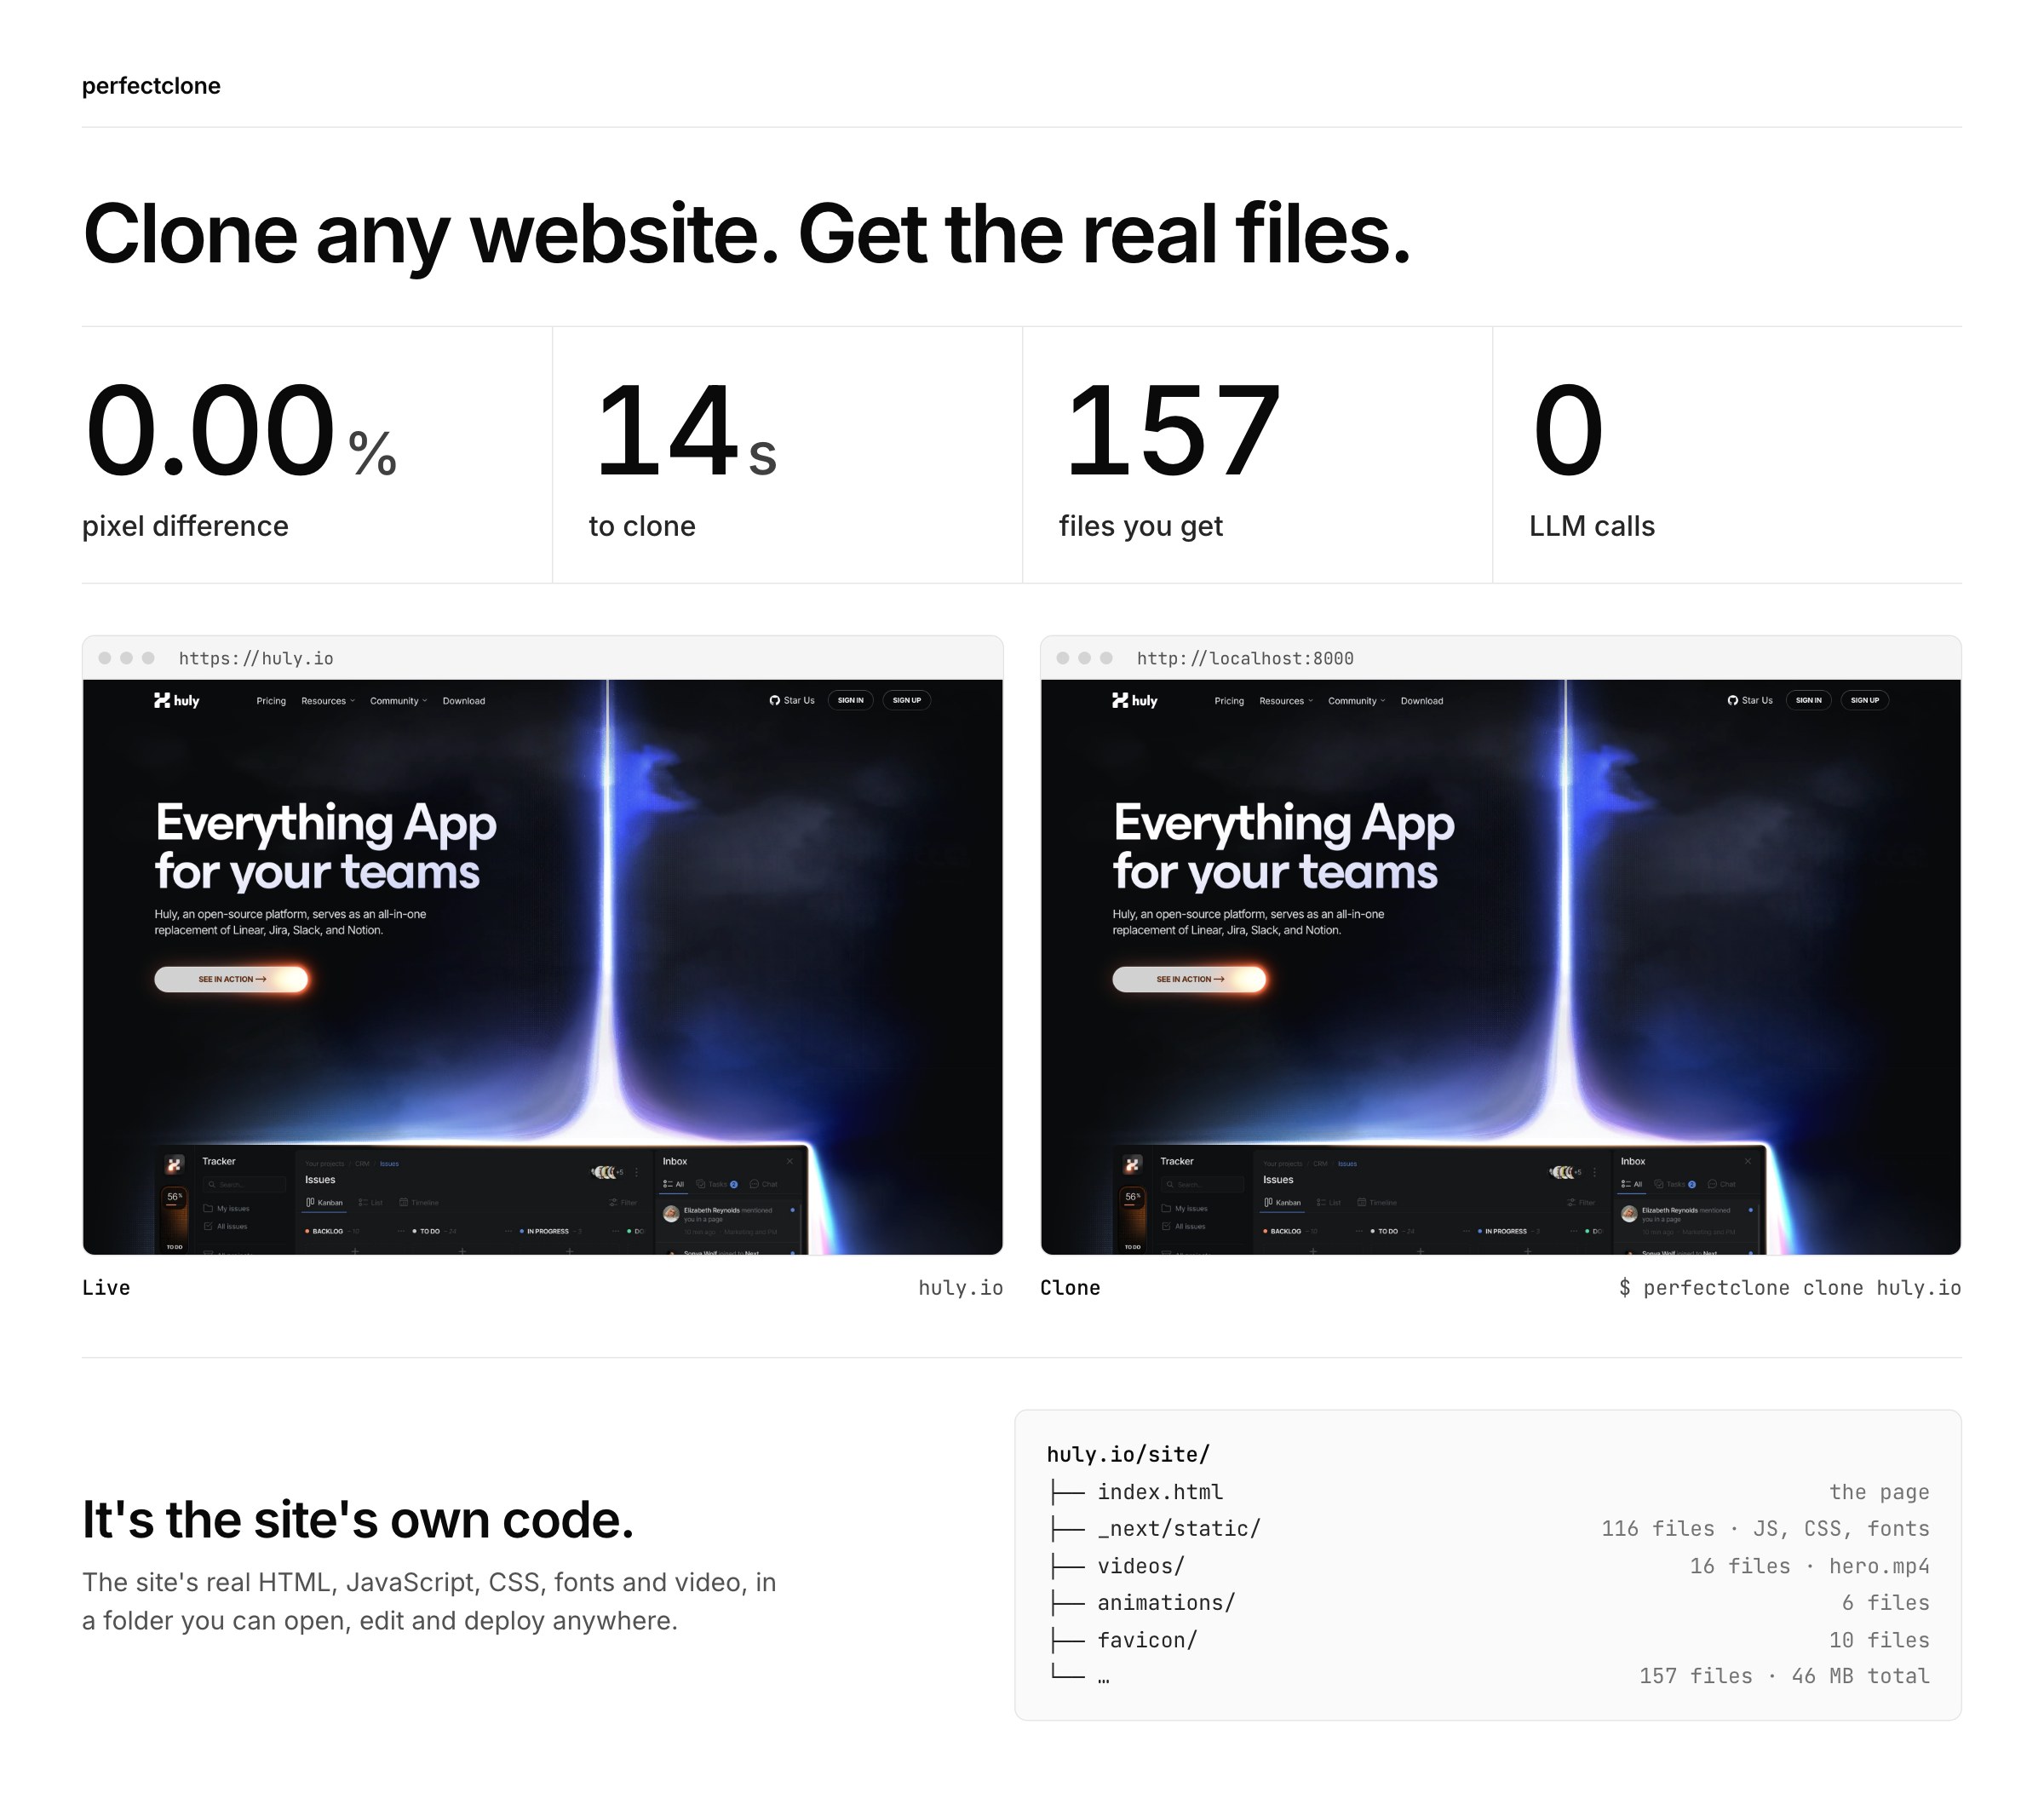
perfectclone 可以 1:1 克隆任意网站。它用真实浏览器(Playwright)爬取站点,下载网站自己的 HTML、JavaScript、CSS、字体和图片,交给你一个可以直接托管、编辑和部署的文件夹。然后你可以给它换品牌、换托管地址,并在不弄坏它的前提下剥离原站所有者的追踪器,包括那些加载时会在客户端 hydrate 的 Next.js 站点。
        pip install perfectclone

perfectclone clone example.com
perfectclone serve example.com             # → http://localhost:8000
就这么简单。首次克隆时会自动下载 Chromium。需要 Python 3.10+。
或者什么都不用装,直接用 uv 试用:
uvx perfectclone clone example.com
为什么不用 AI 克隆器?
如今大多数“克隆任意网站”的工具都是重新生成站点:AI agent 看着截图或抓取下来的标记,写一个全新的 React/Next.js 应用,再用视觉相似度分数把结果和原站比对,直到足够接近为止。这样得到的是一个“长得像”的东西。代码是新的,行为是近似的,而且总有差距。
perfectclone 不重新生成任何东西。它镜像的是网站实际返回的那些字节,所以克隆出来的就是那个站点:同样的标记、同样的打包文件、同样的动画、同样的 JavaScript 在运行。有时候真正的解决方案就是简单的那一个。
| AI 克隆器 | wget / HTTrack | perfectclone | |
|---|---|---|---|
| 复制网站的真实文件 | ❌ | ✅ | ✅ |
| 在现代 JS 站点上像素级一致 | ❌ | ❌ | ✅ |
| 抓取懒加载的 JS、字体、图片 | — | ❌ | ✅ |
| React / Next.js 站点仍能运行 | — | ❌ | ✅ |
| 换品牌而不弄坏网站 | ✅ | ⚠️ | ✅ |
| 剥离原站的追踪器 | — | ❌ | ✅ |
| 无需 LLM 或 API key | ❌ | ✅ | ✅ |
在真实网站上测试过
每张卡片是一个网站从中间劈开的对比:左边是线上站点,右边是克隆。
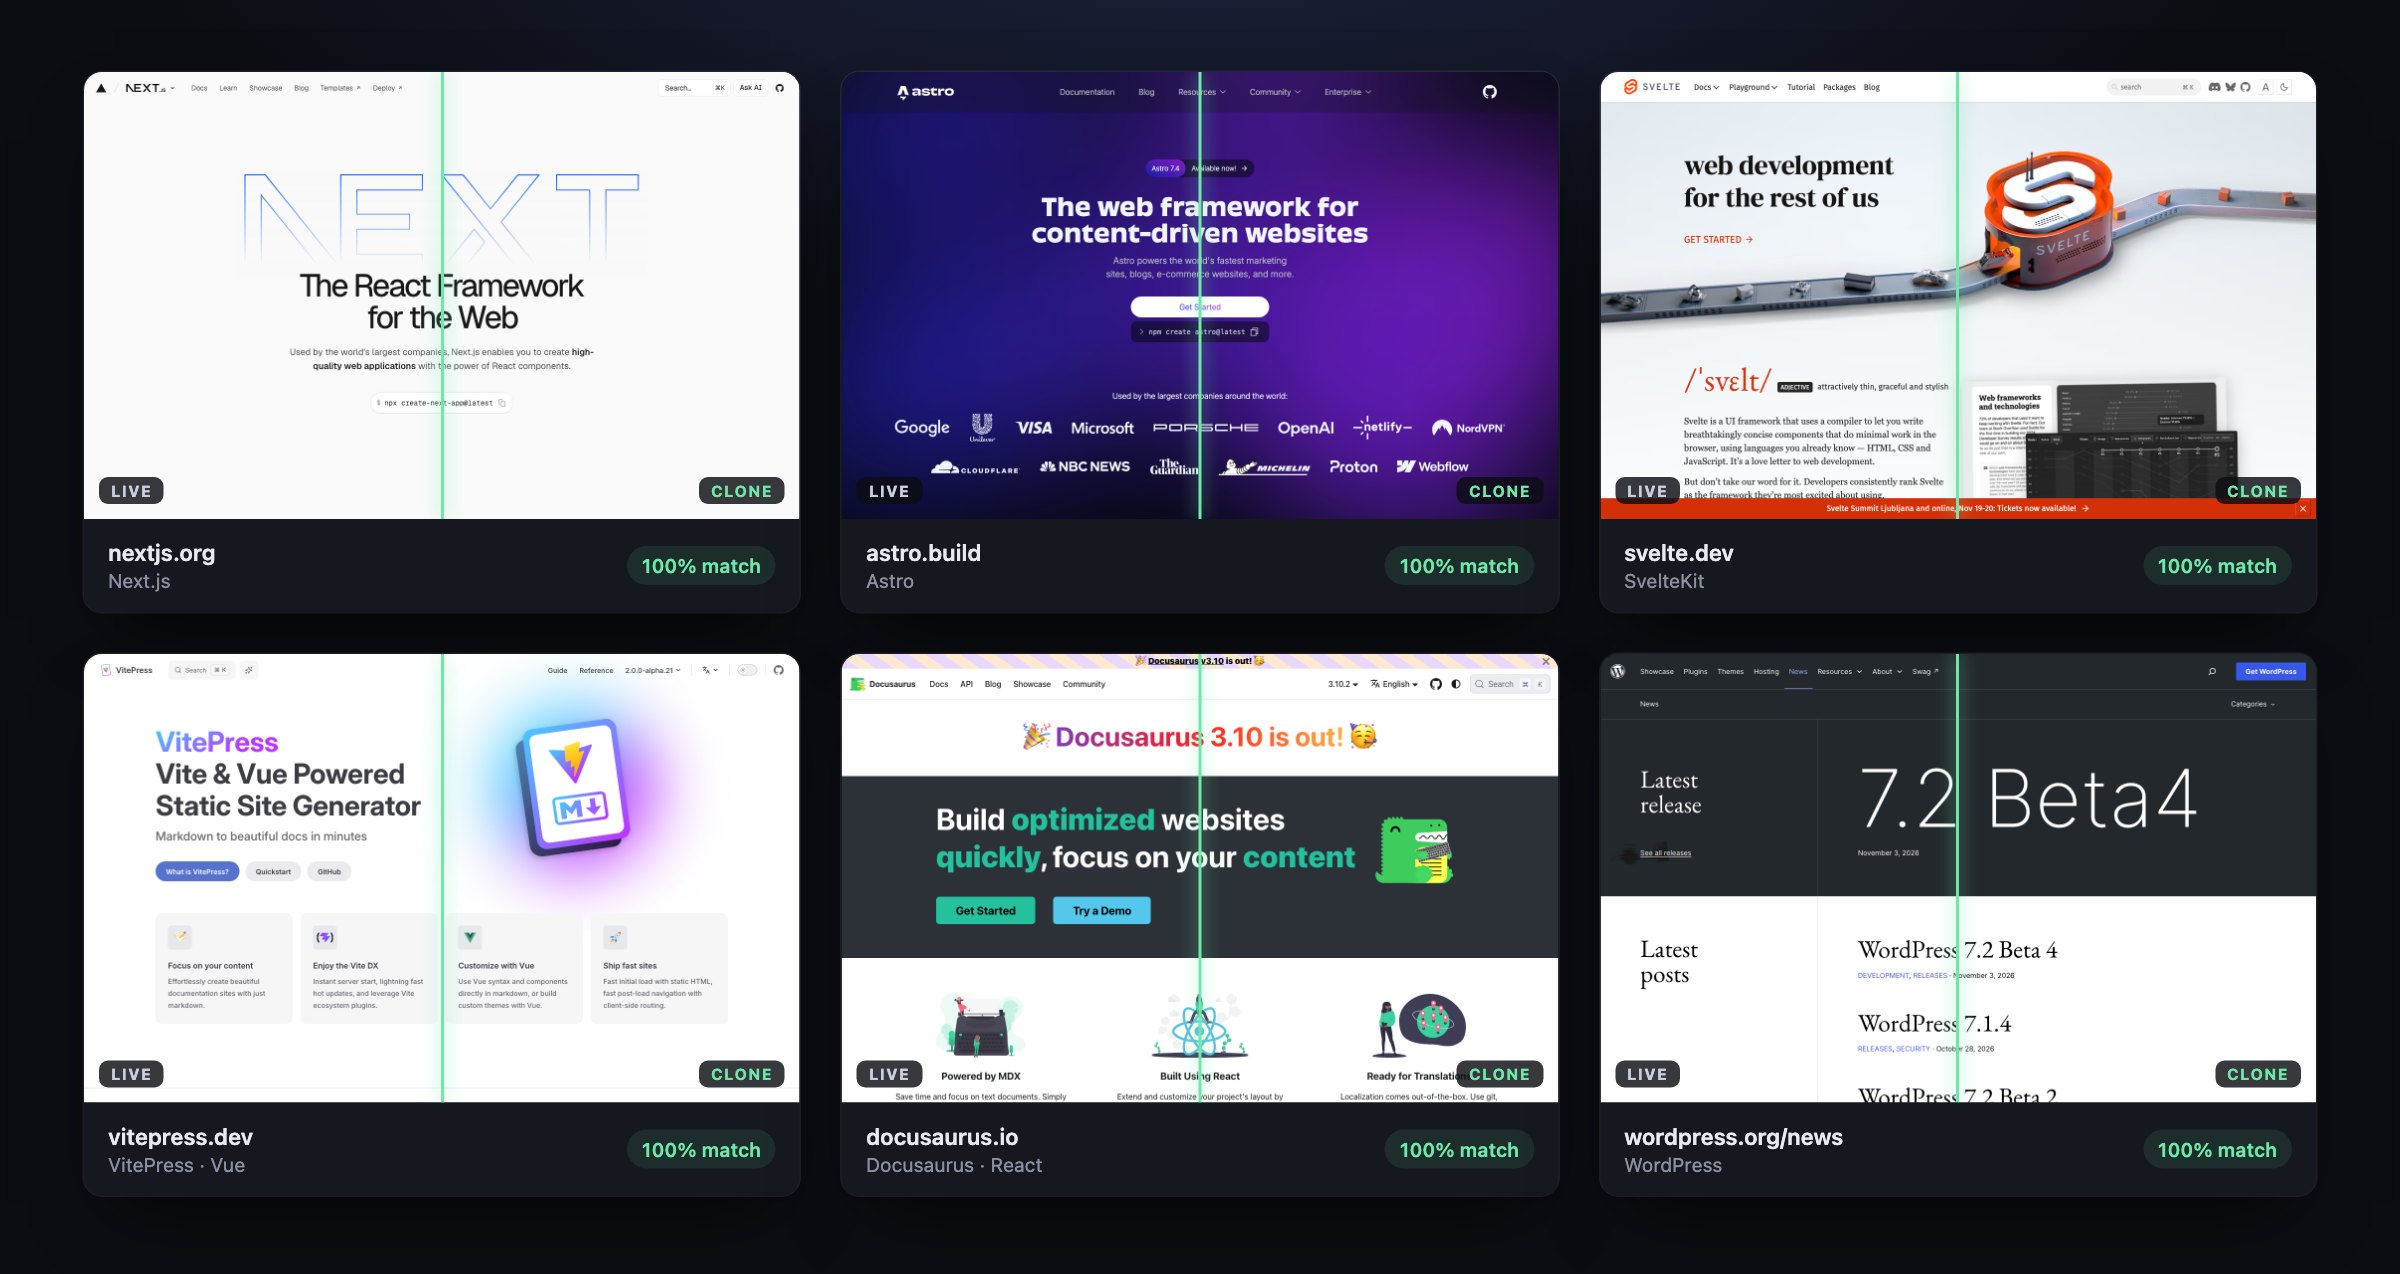
scripts/compat.py 会克隆每个站点、托管副本,并在 1440×900 下将其首页与线上首页对比,动画和视频都暂停在同一帧:
| 站点 | 技术栈 | 像素匹配 | Hydration 错误 | 备注 |
|---|---|---|---|---|
| huly.io | Next.js | 100% | 0 | |
| nextjs.org | Next.js | 100% | 0 | |
| astro.build | Astro | 100% | 0 | |
| svelte.dev | SvelteKit | 100% | 0 | |
| vitepress.dev | VitePress (Vue) | 100% | 0 | |
| docusaurus.io | Docusaurus (React) | 100% | 0 | |
| wordpress.org/news | WordPress | 100% | 0 | |
| paulgraham.com | 手写 HTML | 100% | 0 | |
| example.com | 静态 HTML | 100% | 0 | |
| framer.com | Framer | 96% | 0 | Cookie 横幅需要 Framer 的后端 |
| webflow.com | Webflow | 93% | 0 | Cookie 横幅在 localhost 上跑不起来;轮播图被抓在滚动中途 |
每个克隆加载时都没有向追踪器发出任何请求。你可以自己运行 python scripts/compat.py 试试,如果哪个站点克隆得不对,请开 issue。
命令
        perfectclone clone <url> [-o out] [--max-pages 200] [--extract] [--keep-trackers] [--ignore-robots]
perfectclone serve <site> [-p 8000]
perfectclone replace <site> <old> <new> [--exact-case] [--substring]
perfectclone rehost <site> <old-origin> <new-origin>
perfectclone strip-trackers <site>
- clone 会写出 out/site/(工作副本)和 out/manifest.json(页面、失败项、站点使用的第三方主机)。
--extract还会把每个页面的文本、元数据(标题、链接、图片、表单、JSON-LD)和整页截图保存到 out/extract/。跟踪器默认会被剥离。
- replace 会在所有位置重命名文本:HTML、JS、CSS、JSON、SVG。它还会处理 UPPER、lower 和 Capitalized 变体,并且不改动 URL 和资源路径,因此不会出现 404。
- rehost 会把 canonical、Open Graph、JSON-LD 和 sitemap 的 URL 指向你的域名。
- serve 的行为类似静态主机:干净的 URL(/about → /about/index.html),并且 /_next/image 请求会由镜像的原始文件提供。
为一个克隆重新品牌并上线:
        perfectclone clone acme.com -o acme
perfectclone replace acme "Acme" "Globex"
perfectclone rehost  acme https://acme.com https://globex.com
npx netlify-cli deploy --dir acme/site --prod      # or any static host
工作方式
- 用真实浏览器抓取。每个页面都在 Chromium 中渲染并滚动到底部,每个响应都会被记录下来。这样能捕获静态镜像漏掉的内容:代码分割的 JS chunk、从 CSS 请求的字体、懒加载背后的图片。链接按广度优先跟随,种子来自 sitemap。除非传入 --ignore-robots,否则会遵守 robots.txt。
- 镜像服务器返回的字节。页面保存为服务器发送的 HTML,而不是渲染后的 DOM,因为站点的 JavaScript 需要它来 hydrate。资源保留其 URL 路径,并且会扫描 CSS/JS 以寻找更多引用(url()、srcset、chunk 路径),直到不再出现新内容。
- 在不破坏 hydration 的前提下编辑。Next.js App Router 页面会同时输出 HTML 和 React 树的序列化副本,后者位于 self.__next_f.push(...) 脚本 chunk 中。只改其中一个而不改另一个,React 会抛出 hydration 错误并从 payload 重新渲染,从而撤销你的修改。perfectclone 会解码 payload 流,逐行编辑,重新计算长度前缀文本行的 UTF-8 字节长度(<id>:T<hex>,…),重新拼接跨 chunk 的行,并将其写回与对应 HTML 修改相邻的位置。
- 剥离跟踪器。Google Analytics/Tag Manager、Meta pixel、LinkedIn Insight、Hotjar、Clarity、Segment、PostHog、HubSpot、TikTok、Reddit、X、Cloudflare Web Analytics、RB2B 等。它们会从 <script>/<noscript> 标签、preload 提示以及仅存在于 payload 中的 Next.js next/script 元素中移除。
限制
- 没有后端。表单、登录、搜索和 API 调用仍然会发往原始服务器(或者失败)。perfectclone 只复制前端。
- Next.js 客户端导航需要为 ?_rsc= 请求返回每个页面的 RSC payload。perfectclone 会镜像它们,perfectclone serve 会路由它们。在普通静态主机上,内部链接会退化为整页加载:一切仍然可用,只是没有即时过渡。
- 只有在点击后才会请求的 chunk(例如某个模态框的代码)会在抓取触发它们、或有 bundle 以字符串形式命名它们时被捕获。bundle 也可能在运行时拼接出 chunk URL,那一种可能会被漏掉。
- 机器人防护(CAPTCHA、严格的 Cloudflare 规则)可能会阻止抓取。perfectclone 不会尝试绕过它。
- 嵌入内容(YouTube、Cal.com、地图)和第三方 CDN 仍会从它们自己的主机加载。
路线图
克隆登录后的应用,比如仪表盘。目前 perfectclone 看到的是匿名访客看到的内容,页面渲染后从 API 加载的数据不会被保留。对于你拥有账号的应用,计划如下:
- 以你的身份抓取。在浏览器窗口中登录一次;perfectclone 会保存会话并用它抓取。
- 记录 API 响应。保留应用在抓取期间获取的每个 JSON 响应,并让 perfectclone serve 重放它们,这样图表、表格和列表就能离线显示真实数据。
- 通过点击探索。点击浏览导航、标签页和菜单,以到达仅存在于客户端路由中的视图。
结果是一个可点击的快照,包含捕获时刻的 UI 及其数据。保存、服务端筛选和实时更新仍然需要真实的后端。
其他想法:针对 Nuxt、SvelteKit 和 Remix payload 的 hydration 感知编辑,以及一个部署辅助工具,它会写入 _redirects / vercel.json 规则,让 ?_rsc= 和 /_next/image 在静态主机上正常工作。欢迎贡献。
参与贡献
perfectclone 以 MIT License 开源。欢迎提交 issue 和 pull request,尤其是那些无法干净克隆的网站的报告。请参阅 CONTRIBUTING.md,并请遵守 Code of Conduct。按照 SECURITY.md 中所述的方式私下报告安全问题。