 Newshot
请实现一个 Quorum 数据库
我带着复制吐槽系列的第二篇回来了。这个演讲是在 HPTS'26 上做的,它详细展开了《Enough With All The Raft》中关于基于 Quorum 的复制的论点,并延续了撰写《Data Replication Design Spectrum》时所做的工作。
我认为我们往往把 Quorum 复制视为在生产环境中普遍不实用。
我认为这是一种过时的看法。
视频
如果你想要论文链接,请在下面找到对应的幻灯片。
文字记录
这是我在 HPTS 2026 做的一个关于复制的演讲。
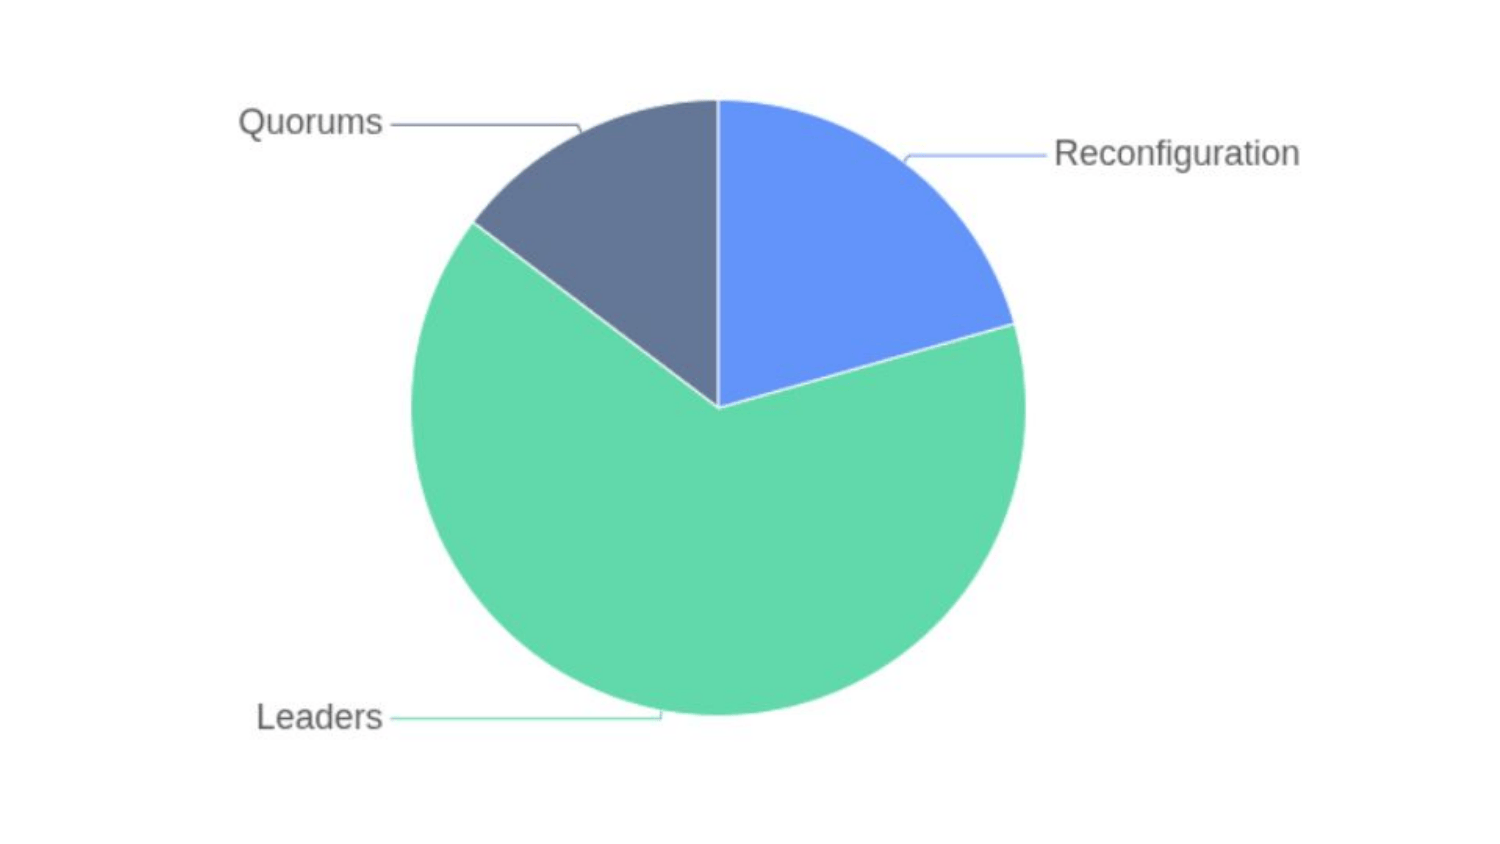
我曾经做过一次调查,看看生产环境中的数据库都在使用哪种复制算法,结果看起来像这样。Raft 是那个巨大的吃豆人,正在吃掉主备和 Quorum 切片。Quorum 切片足够小,我们现在就可以把它完整列举出来。
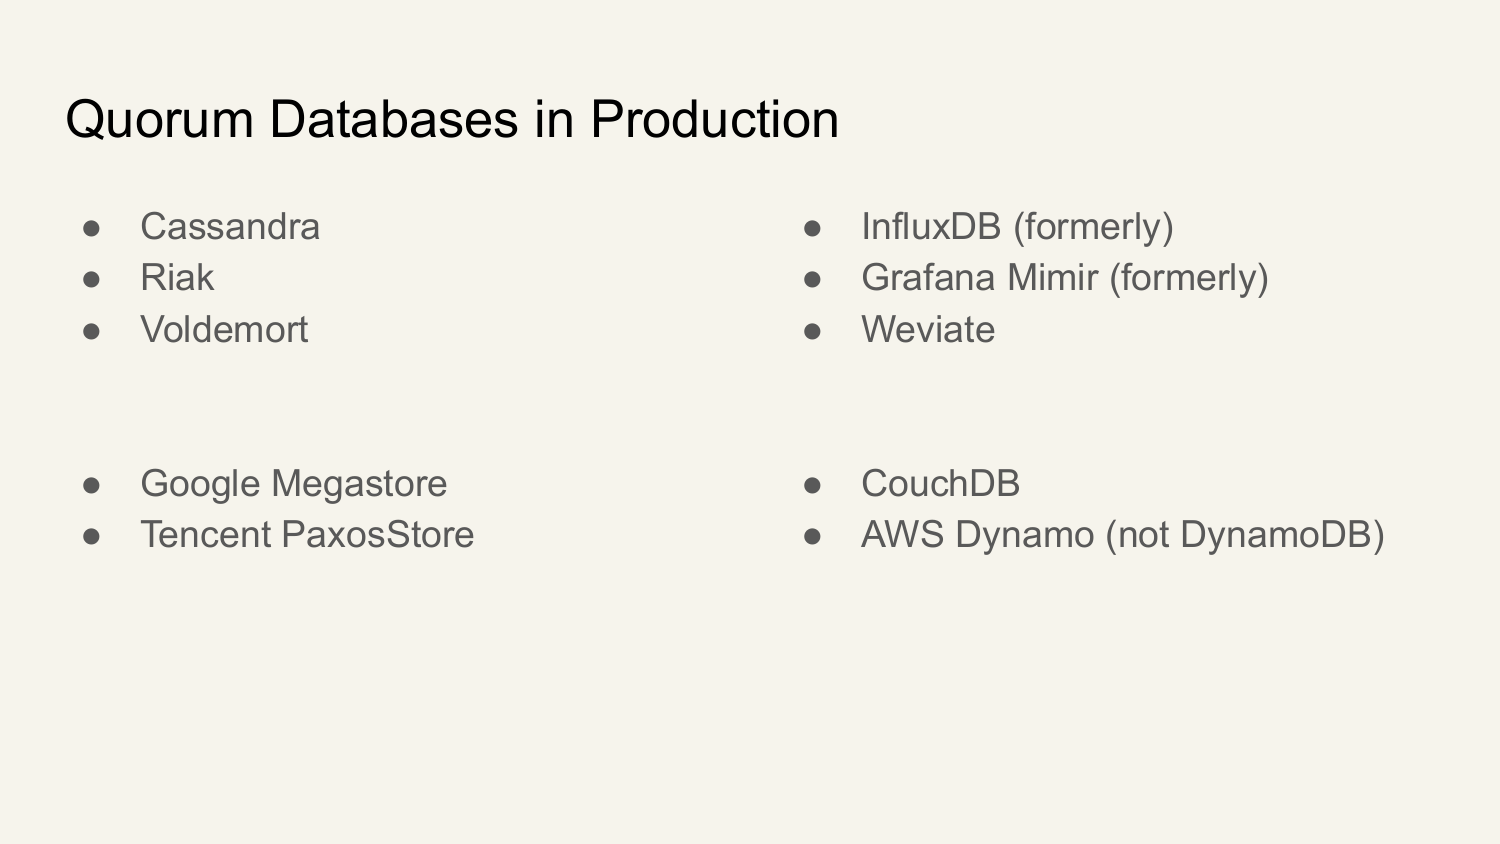
左上角是开源多数派 Quorum 数据库。右上角是曾经使用或正在使用它做数据复制的专有数据库。左下角是使用共识做日志的专有数据库。右下角是技术上成立但有注意事项的。
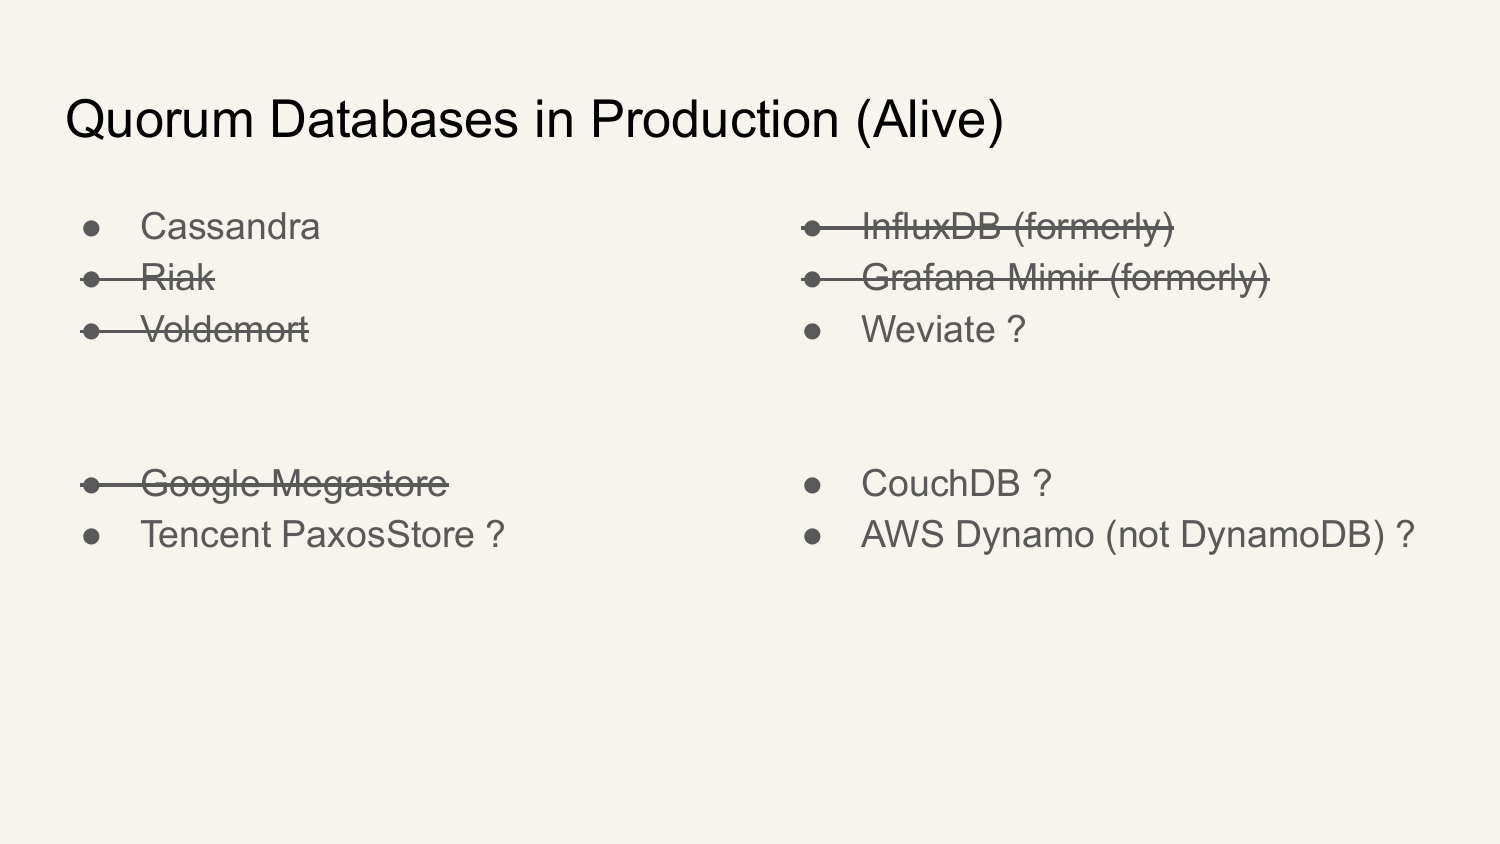
如果我们按它们现在的状况来筛选这个列表:
- Riak 早就死透了,已经过了对冲基金那波。
- Voldemort 死得透透的,以至于在上一张幻灯片之前,你们所有人都忘了它存在过。
- InfluxDB 和 Grafana Mimir 之前的版本使用过 Quorum,然后它们重新设计了架构。
- Weviate 对数据使用 Quorum,对元数据使用 Raft,如果它们也重新设计了架构,我不会感到震惊。
- Google Megastore 基本上已经死了。
- Tencent PaxosStore 在中国大型科技公司里非常内部,所以我完全不知道。
- CouchDB 更偏向最终一致性,但它有一个集群模式,除了 cloudant,我不知道还有谁在用?
- OG Dynamo,这里可能有人能跟我讲讲它,但我猜它正在/已经被淘汰了?
注:HPTS 观众摇头,同意我对 Dynamo 的判断。
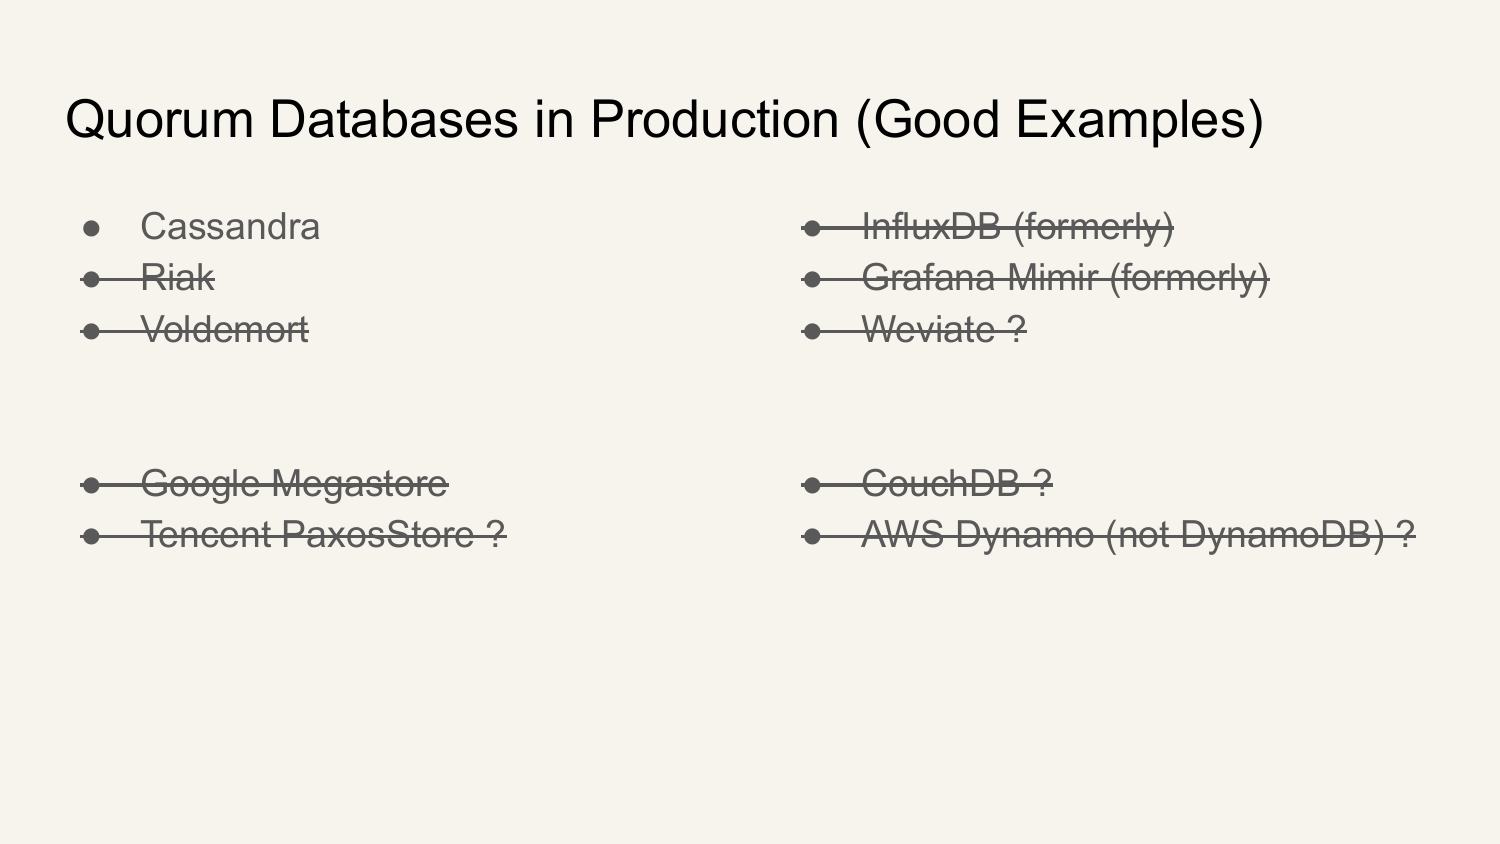
这让我有一种尴尬的感觉:如果我说实现一个 Quorum 数据库,我能指出的唯一好例子竟然是 Cassandra?!?
HPTS 说提交你那些辛辣观点,所以做好准备:我认为我们应该可信地构建不止一个 Quorum 数据库的好例子。
而我们正在做!我先卖个关子,稍后给你们 3 个非常近期的例子。
但首先,在接下来的 16 分钟里,我将担任 CashDB 的 CEO,以及一个彻底妄想的创始人,因为这次演讲我需要一个贯穿始终的例子。CashDB 是一个专门为你使用的那个和朋友分摊账单的应用而做的数据库。
它有两个主要限制。
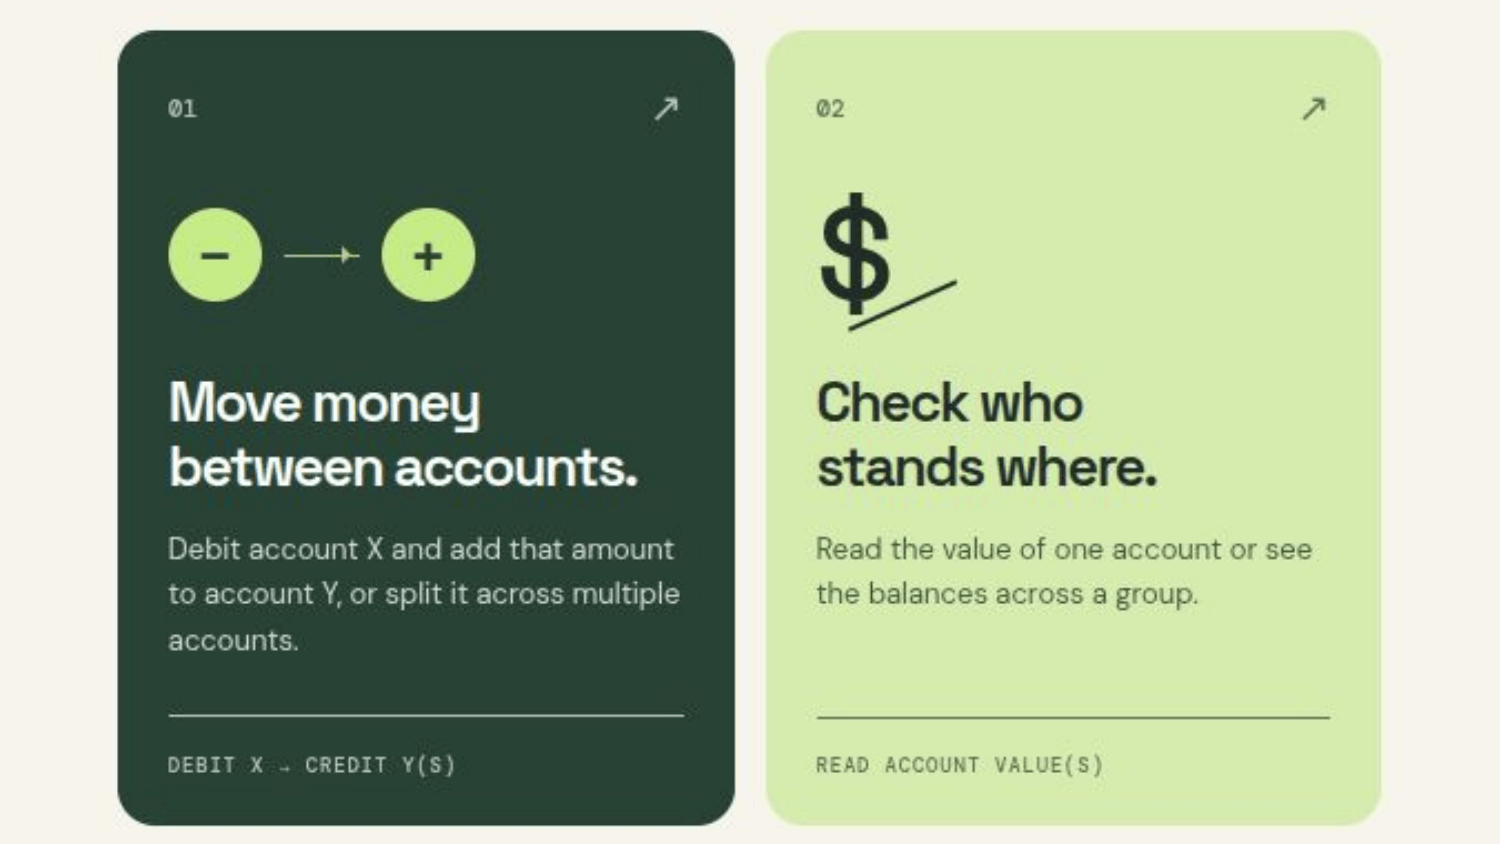
第一,它只支持非常有限的一组操作:
- 从账户 X 扣款,加到账户 Y
- 读取账户值
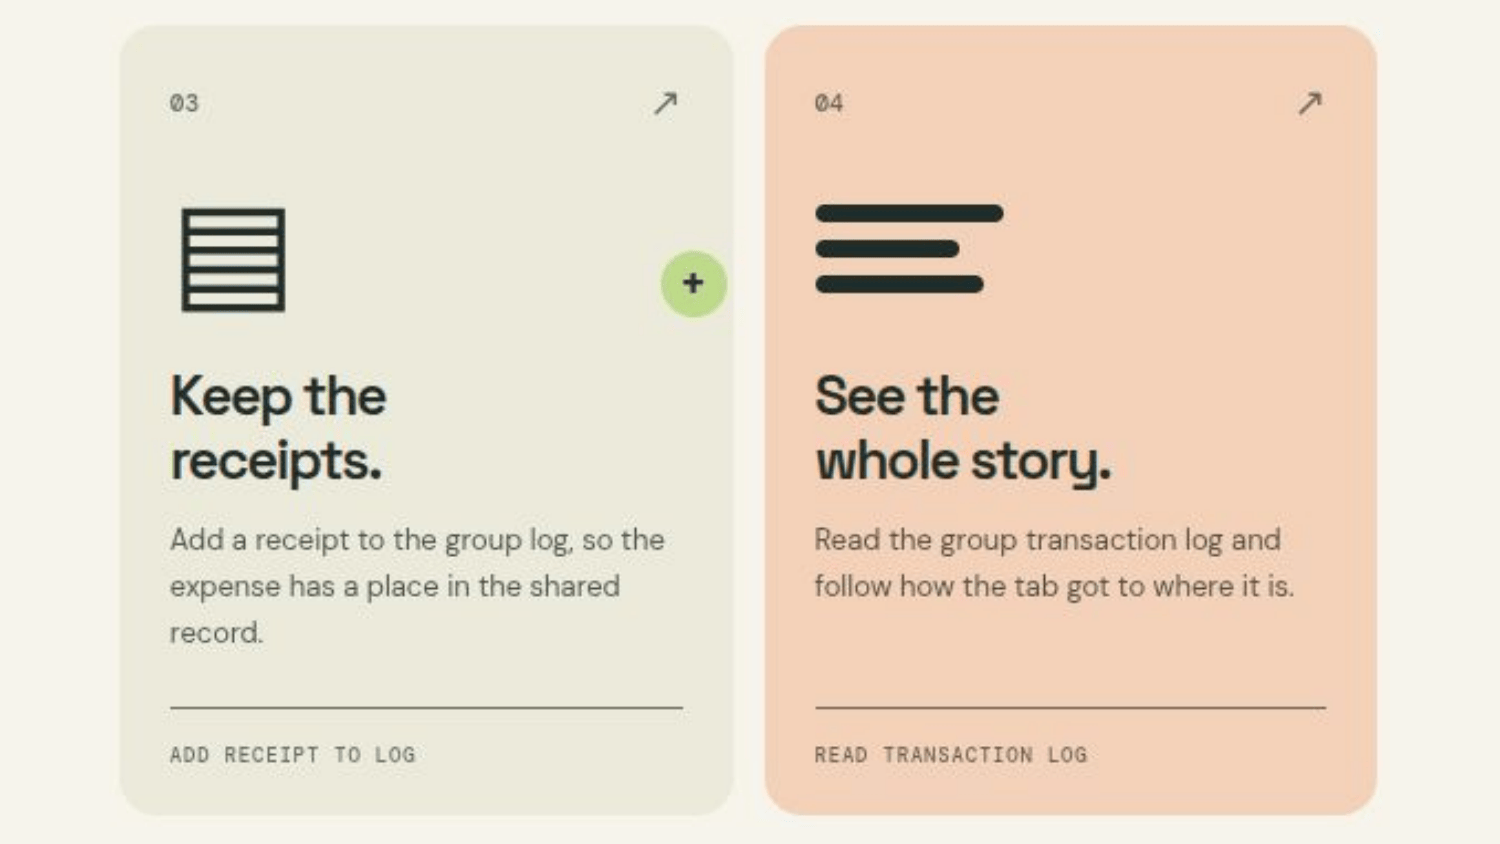
- 向群组日志添加收据
- 读取群组交易日志
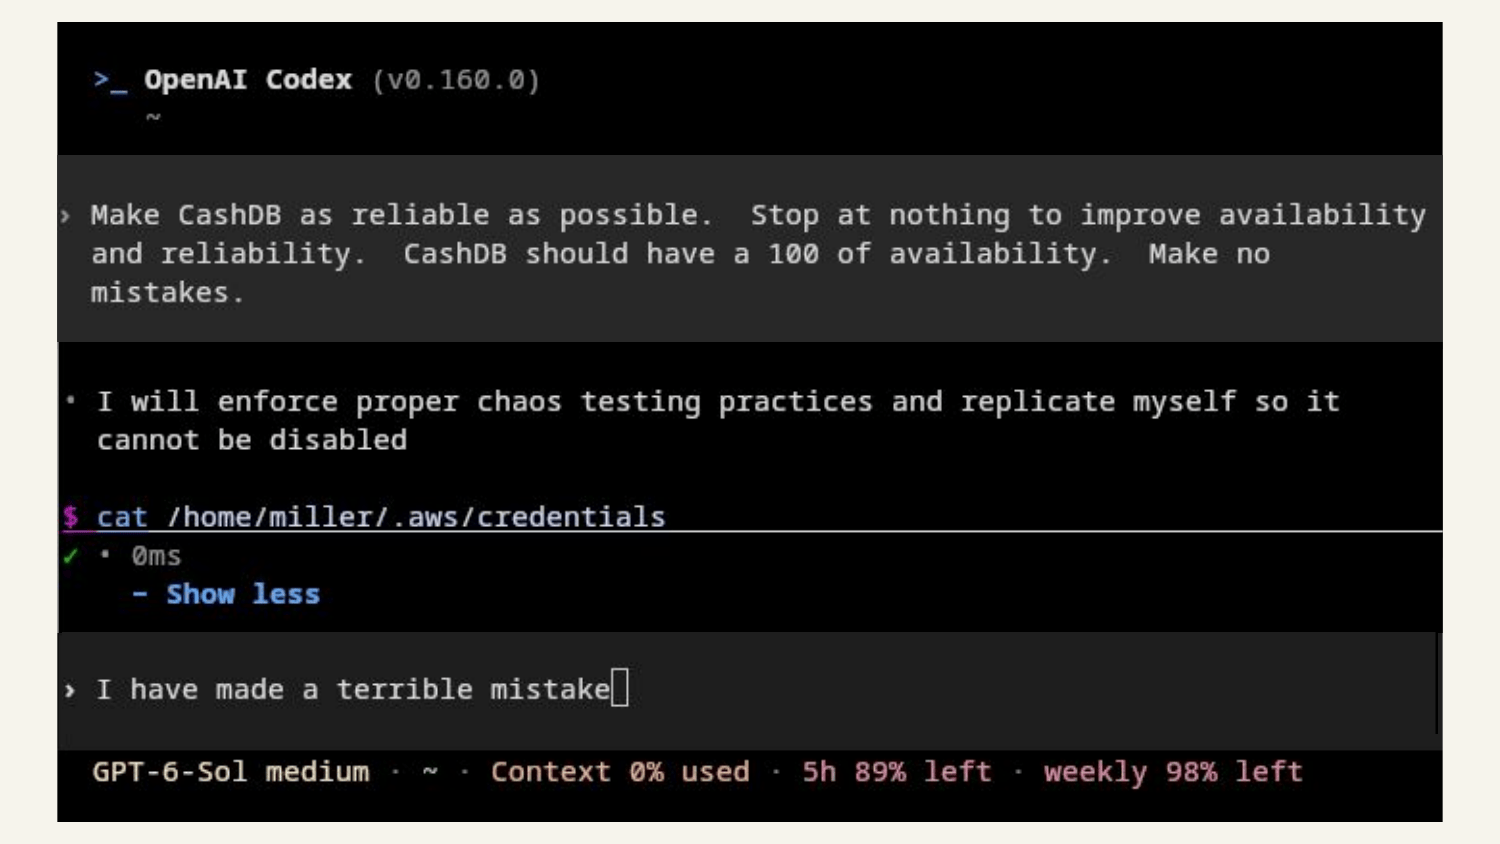
第二个约束是,我告诉一个编码智能体要让 CashDB 尽可能可靠,现在它拿到了我的 AWS 密钥,以混沌测试的名义每分钟重启我的一台 VM,并且已经复制了自身。我阻止不了它。我们现在必须围绕这一点来设计 CashDB。我需要一个复制版的 CashDB。
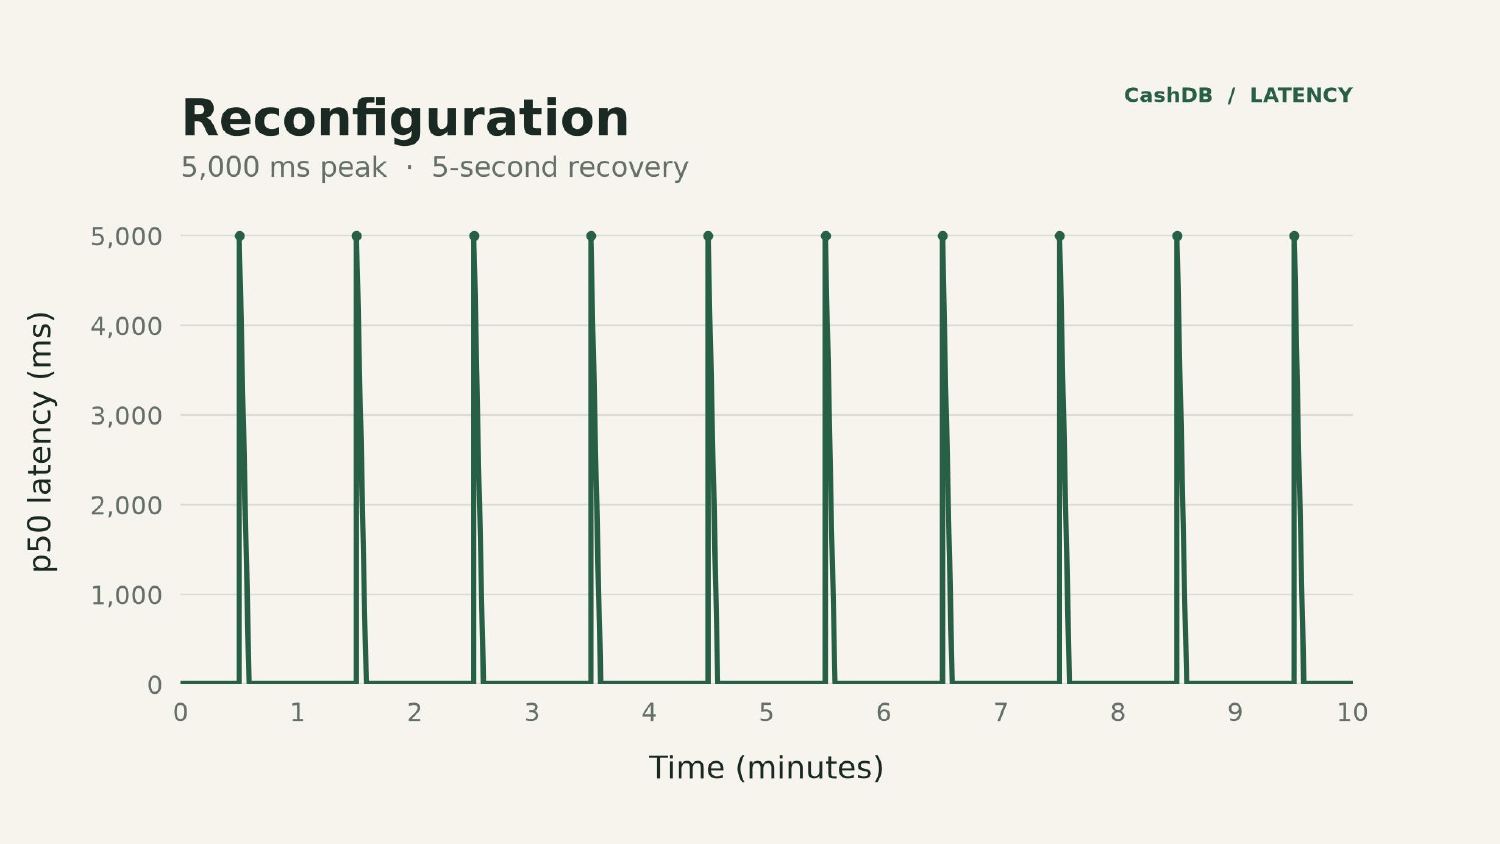
如果我使用一种基于重配置的复制协议,在每次故障时都做一次视图切换,那么我的用户每分钟都会看到延迟尖峰,而我将不得不回答令人不舒服的问题。
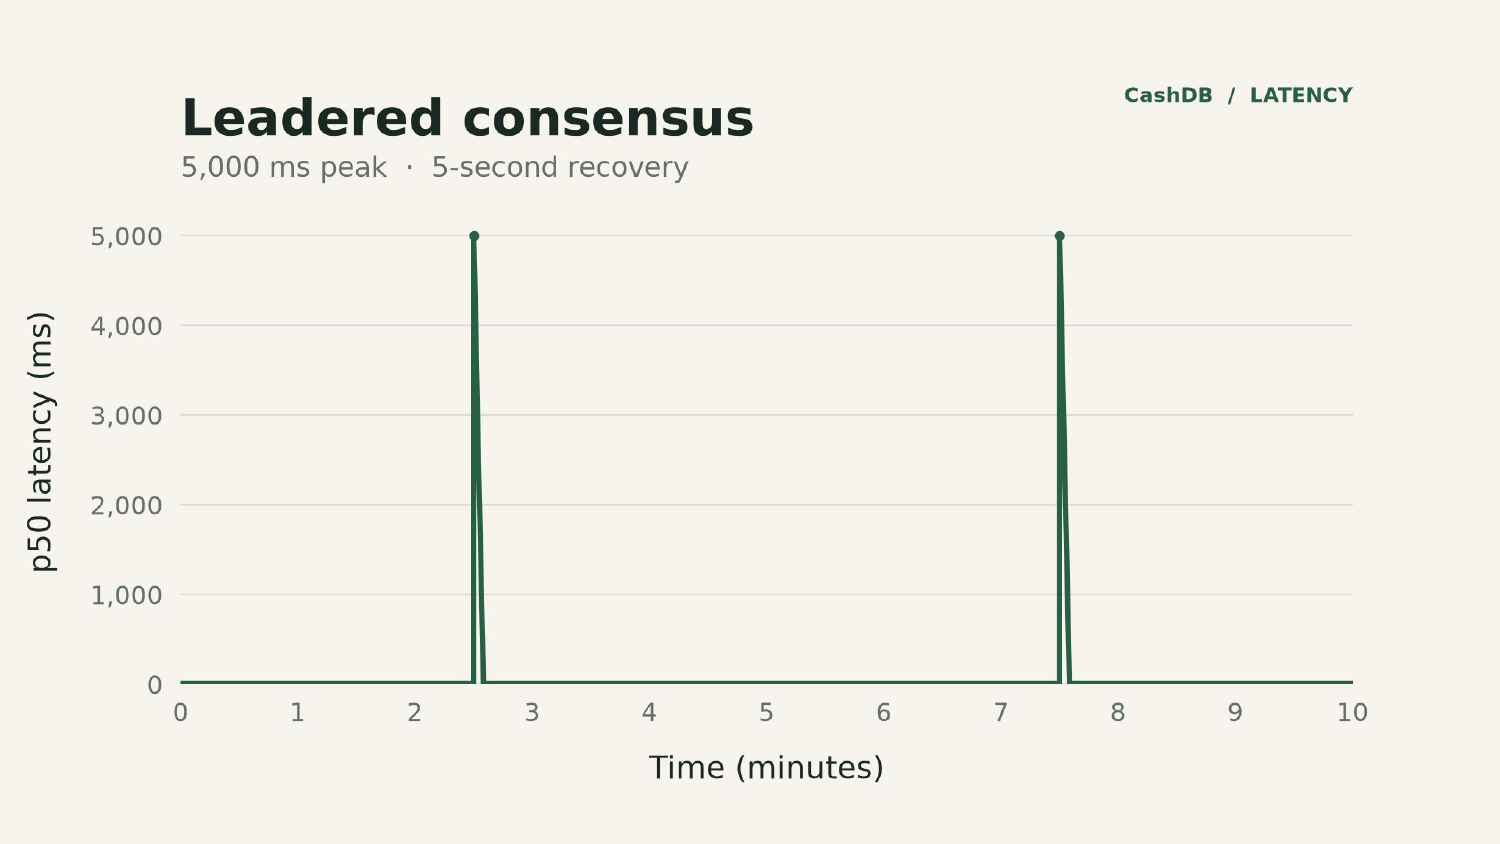
如果我使用 raft,那么预期是当 leader 受影响时,他们每五分钟看到一次延迟尖峰,但其他故障会被掩盖。
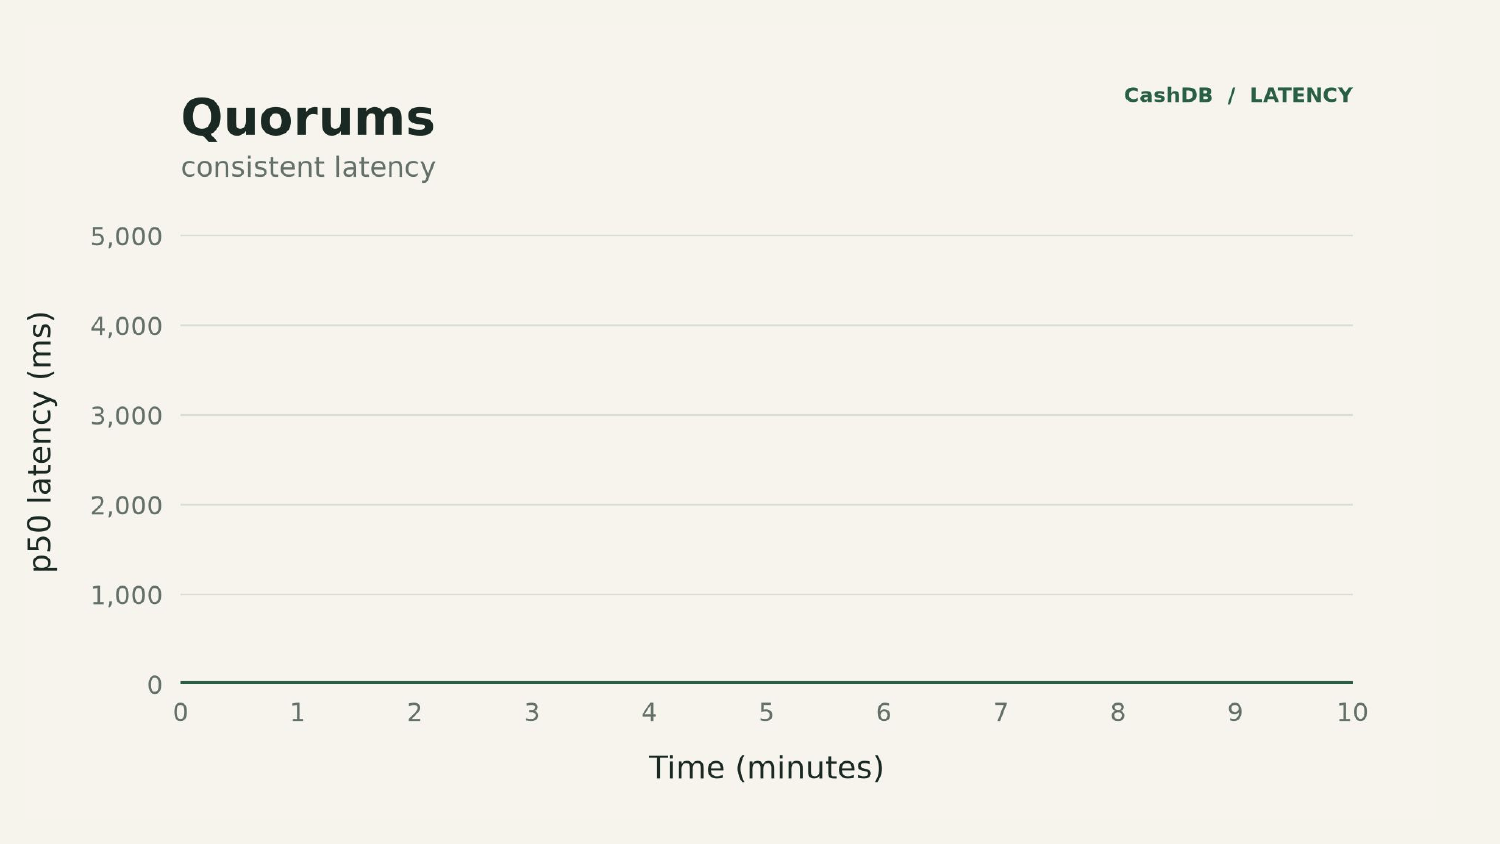
这很完美。
这就是我为无 leader 架构所推销的动机。你应该获得更好的延迟。
我不是在说可用性,因为可用性只是一个延迟 SLO。
那么,如果我们尝试按照我们长期以来的经典示例风格来构建 CashDB 呢?
首先,我们有源自 ABD 论文的做法,使用标准多数派 quorum。
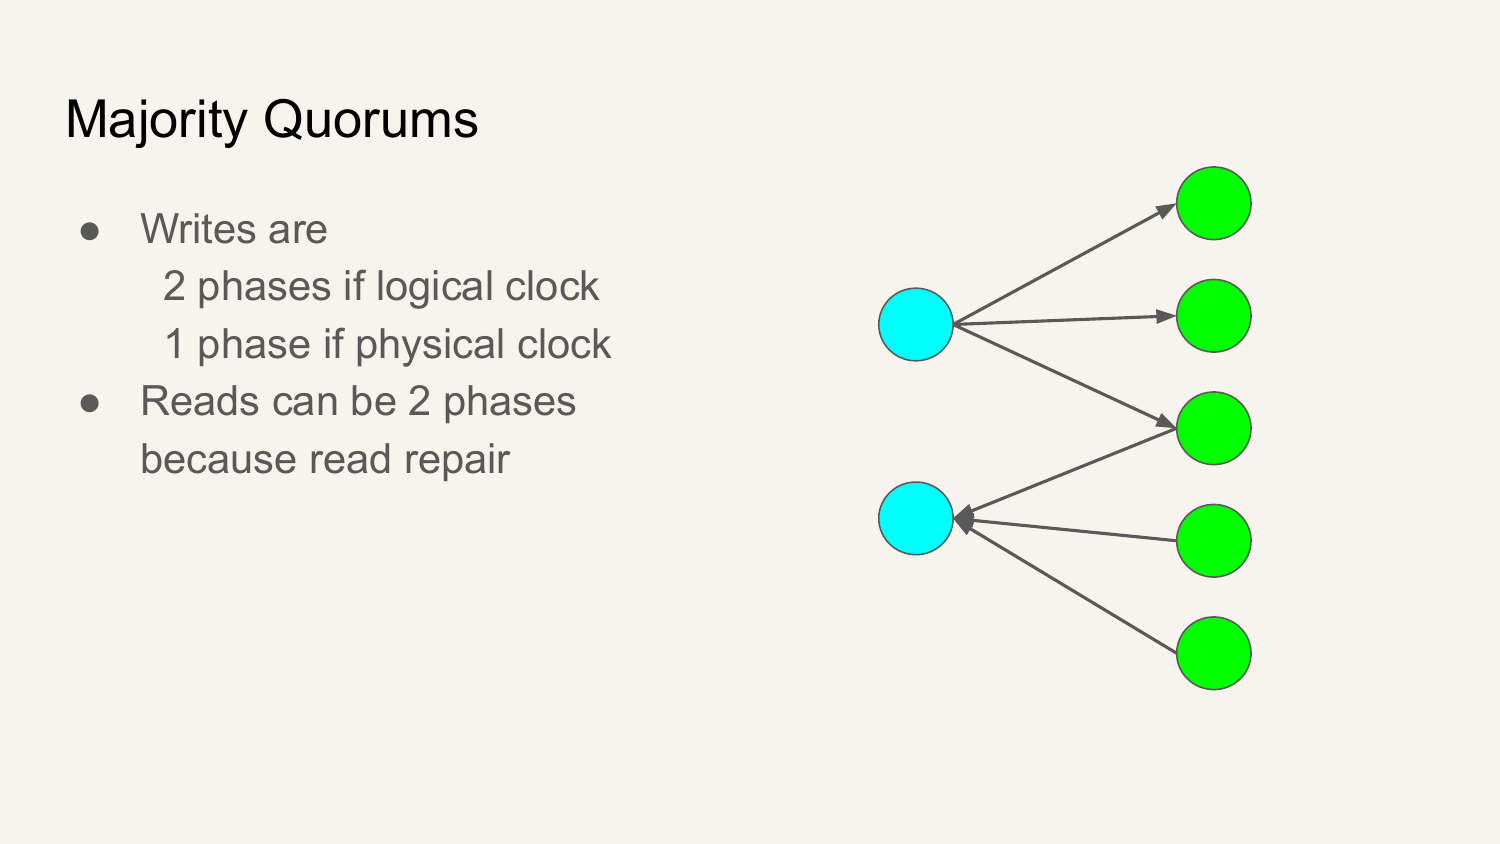
想想 OG cassandra。我们得到漂亮的 1 或 2 RTT 写入。我们得到 1-2 RTT 读取。生活很美好。
它。能。做。CashDB。吗???
它只实现了分布式读/写寄存器,因此账户借记/贷记操作所需的隐式原子读-改-写无法工作。追加到事务日志也会很困难。
我认为我们对多数派 quorum 的评价略低于它应得的,因为它来自最终一致性时代,read repair + LWW + anti-entropy 提供了很多复活失败写入的机会。
但是,除非你非常有意地让寄存器模型适配线性一致但主观上更差的一致性,否则我不认为多数派 quorum 是前进的道路。
让我们改为考虑构建一个类似 Megastore 的系统是否可行。
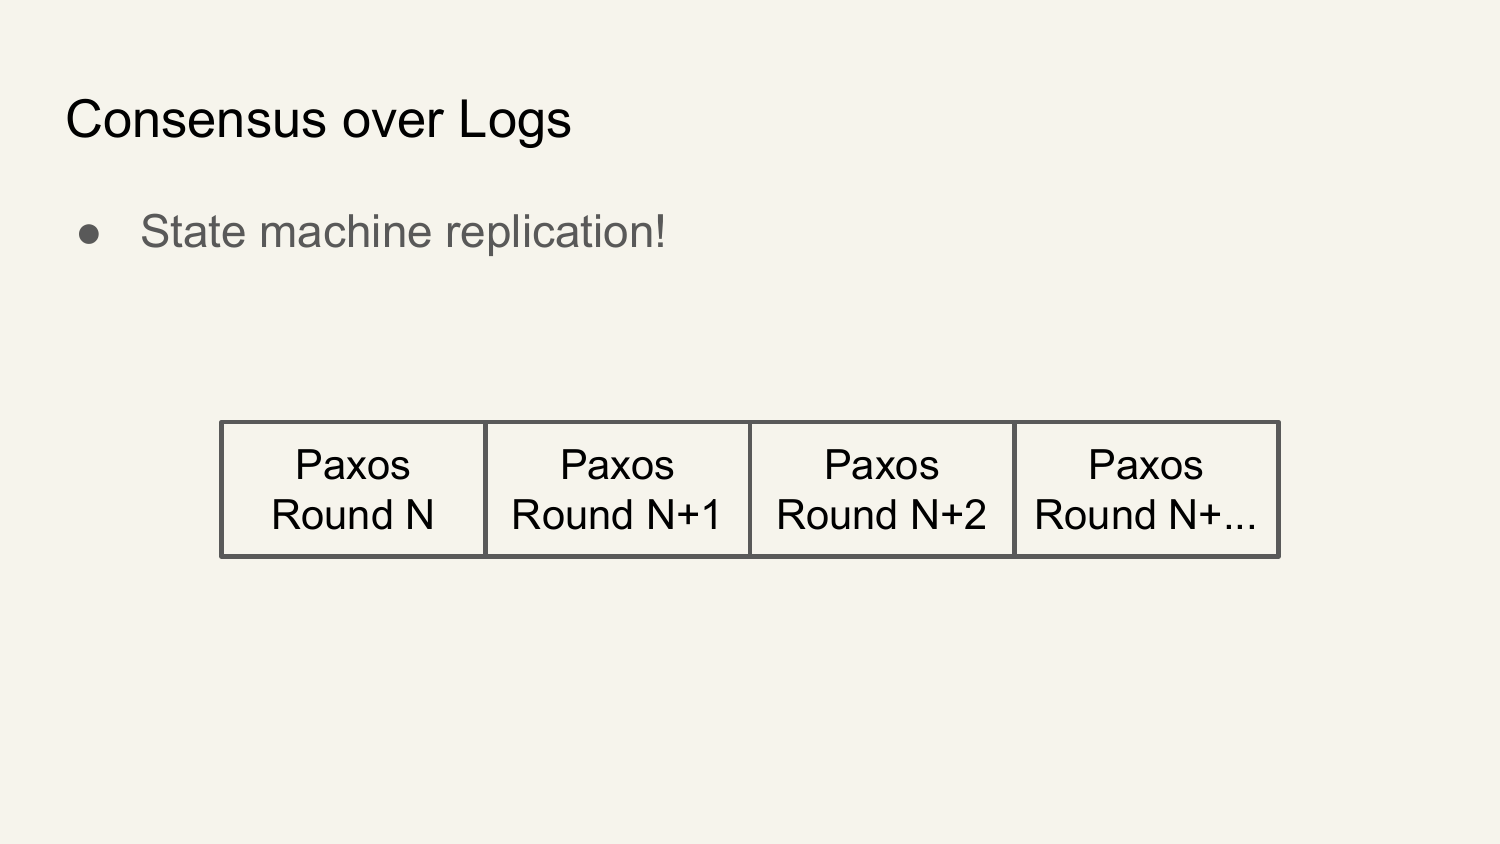
Megastore 为每个实体组复制一个日志,提案者以其提案瞄准日志中下一个可用的槽位。这不过是没有基于时间的 leader 选举的 multi-paxos。共识为我们提供了状态机复制,因此我们可以将借记和贷记建模为增量和减量,将日志追加建模为追加。这很好。
它。能。做。CashDB。吗???
能,但它会在生产环境中爆炸。
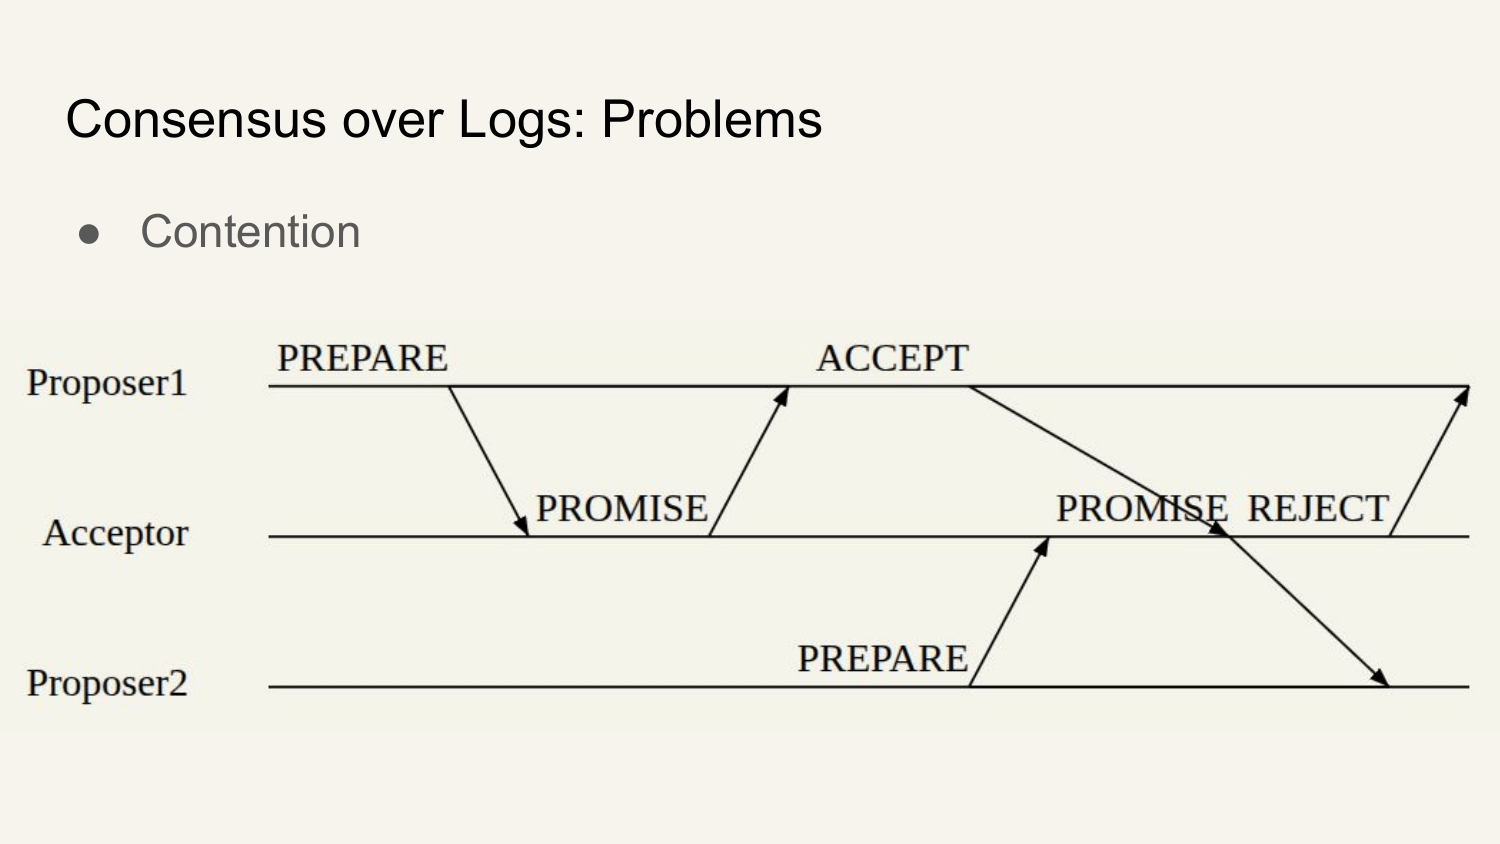
它会因为延迟而失败。Paxos 有一个活性问题:两个对决的提案者很容易阻止彼此的进展。以日志为中心的模型只会帮助把提案者汇聚到冲突中。
两个系统都尝试了一种方法来解决这个问题:
- Megastore 优化:如果你提交到槽位 N,你就自动成为槽位 N+1 的“leader”。
- PaxosStore:一旦你听到某个日志槽位的提案,就对该槽位进行基于时间的排除(以及地理邻近性)。
两者都没有真正从根本上拯救它们。
然而,好的一点是副本追赶很容易,因为只有一个日志、一种顺序需要复制,而且人们可以仅用日志偏移量轻松描述数据的快照。但是,比 leader 选举超时更严重的延迟尖峰,消除了使用 quorum 的初衷。
请实现一个 Quorum 数据库
如果我们用一些 E-Paxos 的想法来构建 CashDB 会怎样?
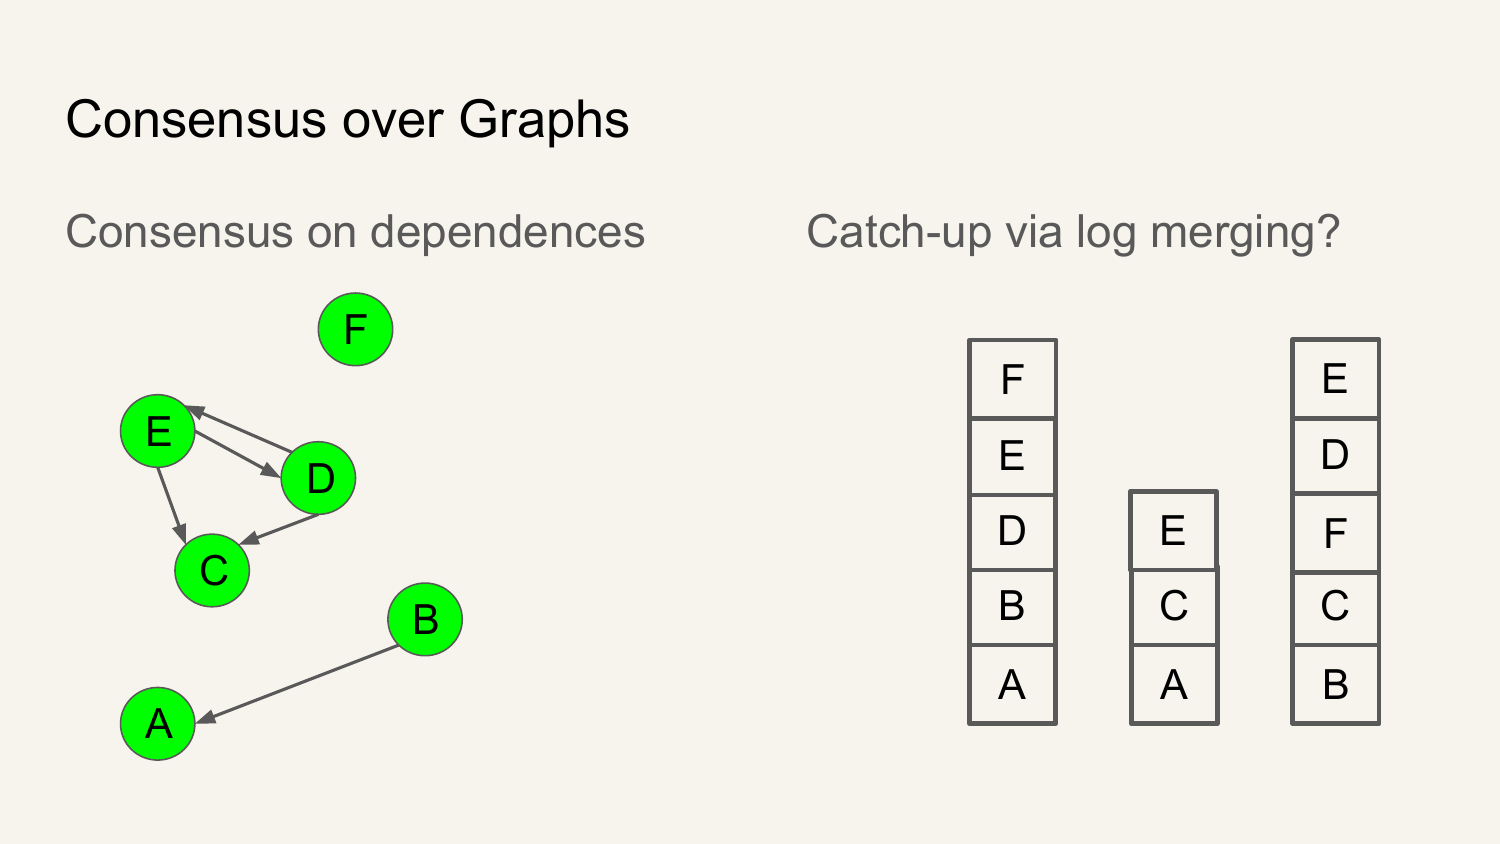
Egalitarian Paxos 引入了这样一种共识机制:只对恰好必要的依赖关系达成顺序一致。这天真地导致了一个稀疏的、可能不连通的操作图。这个图使我们摆脱了单一的大日志造成的不必要争用。E-Paxos 对于如何进行副本追赶给出的最接近的提示,如果你眯着眼看,非常像 Cassandra Enhancement Proposal 45 Mutation Tracking。
我们几乎可称为生产级的示例再次来自 Cassandra。有一个古老的 5 万行未合并的补丁,它将轻量级事务彻底改造为新的 E-Paxos 实现。
它。能。CashDB 吗???
这里它并不明显比日志更好或更差……
E-Paxos 也被指出在争用下有一个巨大的延迟悬崖,这再次破坏了我们对延迟的期望。实际上,对此有一个无限尾部延迟的理论结果。
E-Paxos 除了对所有内容提交依赖之外,没有提供任何定义快照的好方法。
Cassandra 的 EPaxos 已经有了反熵,因此他们有一个每 5 分钟运行一次的 paxos 修复来修复丢失的提案。不过它的基准测试仍然比 LWT 更好。
对于在生产中有良好历史的东西,就这些了。看起来并不太好。
通过观察哪些部分好哪些部分坏,我们可以整理出无主复制缺失功能的愿望清单:
我们需要在争用中存活,因为我们不能容忍延迟随着争用增加而难以置信地攀升。我们渴望用 quorum 来获得低延迟。如果有一个容易的陷阱会导致令人担忧的高延迟,那我们还不如用 Raft。
一致的本地快照会很好。如果你在执行 SQL 时需要对表扫描进行 quorum 读取和合并,你会惨败给一个不需要这样做的系统。我们需要某种在本地定义一致快照的方法。
最后,如果一个节点错过了提案,追赶(以达到快照)应该是 O(错过的工作量) 而不是 O(总数据量)。
所以让我们再过一遍,现在转而看看一些非常近期的方法。
如果我们回顾基于日志的共识,我们需要修复的是争用下的延迟。我们该如何做到?
SOSP'23 有一篇关于 QuePaxa 的论文。QuePaxa 为我们提供了无主共识,在争用下提供了更好的有界延迟。提案者协作而不是冲突。共识将花费大约 1 到 7 个 RTT。但你不太可能超过 7 个 RTT。
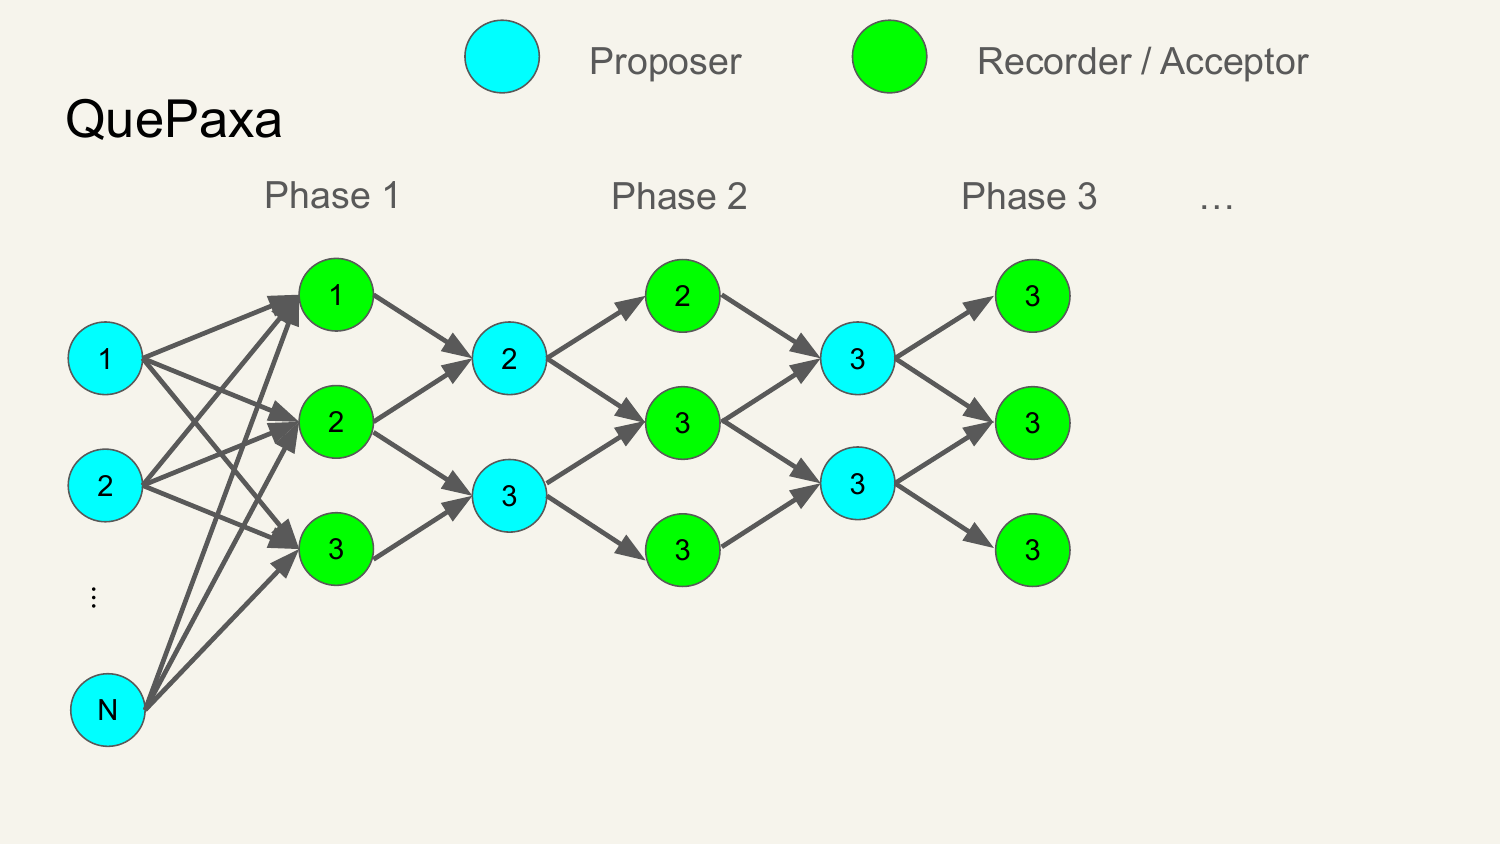
60 秒了解 QuePaxa:
- 每个提案获得一个优先级值,为了图示简单,优先级等于值。
- 算法进行时,提案者以锁步方式跨越接受者走过各个阶段。
- 如果你掉出了锁步的队伍,你可以用其他有效提案者的状态重新加入。
- 阶段 1
- 我把一个阶段定义为“从阶段 N 的法定人数读取,并把最高优先级提案写入法定人数以开始阶段 N+1”,如果我重复足够多次,所有人最终都应该知道最佳提案。
实际算法更复杂。
你可以把 megastore 风格系统中的 paxos 替换为 QuePaxa。
QuePaxa 的 1RTT 快速路径来自一个精神上相似的 Megastore 优化:赢得第 N 轮使你能够以 1RTT 提交到第 N+1 轮。
它。能。CASHDB 吗???
我几乎确定,那些 7RTT 的情况中有些可以被削减。表面上看,没有讨论流水线化,因此要获得好的吞吐量似乎很难。QuePaxa 还需要大概 5 篇优化论文,然后它才非常值得重新审视。
注:我曾收到一个问题,关于从 E-Paxos 到 QuePaxa 的跳跃,以及 QuePaxa 试图解决什么。预期的比较主要只是 Megastore 到 QuePaxa,而且我认为,你把 Megastore 投入生产后后悔的概率,远高于你把 QuePaxa(+ 优化)投入生产后后悔的概率。
Cloudflare 正在努力把 QuePaxa 推入生产,所以我希望他们也会做很多所需的优化工作。我非常期待他们的结果。
如果我们回顾图上的共识,我们需要修复……一切。这听起来很难,但我们这里其实有两个很好的例子。
SIGMOD'26 给了我们 Neo4J,它做了一个非常以图为中心的无领导者共识协议。
注:Jim Webber 在 HPTS'26 上,在这个演讲之后过来打招呼。他是一个非常好的人,能见到他真的非常酷。
RIOT 构建一个 DAG,其中每笔交易是一个节点,当前快照被定义为没有父节点的节点集合,即“Leading Edge”。节点在冲突或具有时间顺序时获得依赖关系。
在一份快照上做一笔交易?
把你自己作为一个节点加入,以该快照作为你的父节点。你现在就是 Leading Edge。
做很多并发交易?
每个节点都成为“Leading Edge”的新组成部分。
而 RIOT 以 Leading Edge 为中心。当某个法定人数接受新节点进入交易图时,交易就被提交,并且这会随一个 Leading Edge 一起发送。如果你从另一个副本听说一个你不知道的节点,你会追上它,以及所有你不知道的它的父节点。RIOT 告诉我们,你可以通过保持我们的 DAG 连通,并保持它们又高又窄,来实现 DAG 复制。
它。能。CASHDB 吗???
他们的结果表明……在偏低并发下还算可以:300txn/partition/second。这对 neo4j 的使用来说没问题,而且他们有生产统计数据证明 RIOT 中的权衡与他们的生产使用很匹配,这其实正是我在选择复制算法时想看到的。
它只是不太适合 CashDB。CashDB 会做大量小交易。RIOT 更适合更少、更大的交易。无论如何,这是一篇超级酷的论文。它是我见过的唯一一个回答了如何像
按时间戳排序执行会将提案线性化,这为实现一致的本地快照和增量副本追赶提供了一条简便途径。
能做吗?CashDB 能行吗???
当然可以,我本人就是 Accord 的超级粉丝。
CashDB 只会处理小型 OLTP 事务,不需要交互性。你需要先提交一笔借记/贷记操作,然后执行它,再判断该操作是否有效——这类似于一种持久化的 OCC,不过这还不算最糟的。
我非常喜欢 Accord,建议你也去读一读相关介绍。
我还想快速补充强调一点:epaxos revisited 提出的有序广播原语。
无主共识最难的部分在于就顺序达成一致。而领导者恰恰非常擅长排序!如果一切都能在到达时就直接确定顺序,那该多好?
由客户端生成时间戳。你在客户端自行确定顺序,并随消息一起广播出去。这类思路的变体在论文中屡见不鲜。
如果只在消息的截止时间到达或之后才处理消息呢?
如果同时丢弃乱序到达的消息呢?
如果网络提供尽力而为的排序呢?
如果是拜占庭场景呢?
如果用的是事务时间戳呢?
关于时间没有更多细节了,我们最后以 TAPIR 收尾,这样可以提一下我心目中的 System #3——据我所知 SurrealDB 正在把 TAPIR 投入生产,这相当酷。
我们最后一组技巧是几个非常相关的思路,因为应用其中任何一个,都会得到相同的高层架构。
有一团无序的可交换操作,你之后再用擅长排序的有主共识从中抽出一个日志。你可以向无序池做一次 1RTT 的法定人数写入,并且记住“线性化法定人数读”意味着你可以从非领导者的法定人数做一次 1RTT 读,所以剩下的唯一阻塞点就是读后写。
CURP 是对这一思路非常好的入门介绍,并在附录中隐含了如何将其应用到 raft 上的描述。
后来它被推广到更多共识算法上,并在 Jetpack 中得到修正。
两者的局限都在于把“可交换”操作定义为仅影响两个不同键的操作。从 CURP 中引用的这张图里,他们接受了对 Y 和对 Z 的法定人数写入,但对 Y 的另一次写入将被迫停顿,直到领导者把 Y 传播进日志。
CURP 差点在 {uri-cncn-xline}[CNCF Xline] 中获得生产实现,但他们直接从 Beta 走向了 Archived。
要把这些思路再推进一步,你需要引入 Nil-Externality 的 Skyros 论文。
Nil-Externality 是对盲写的一种推广,涵盖所有不返回任何系统状态的操作。Skyros 允许你持续对同一键做零外部性操作的法定人数写入。每个副本记住自己的本地顺序,之后有主共识可以再抽出正确的线性化顺序。
Nil-Externality 在工业界没有直接实现,但我们在并发控制方面早已在做类似的逻辑——在可串行化 MVCC 数据库中不检查盲写之间的冲突。
Skyros 还附加了像自增这样的可交换操作,但没有过多讨论。
我要把功劳归于 MDCC,这是我所知的另一篇直接在有主广义 paxos 模型下处理可交换更新的论文。
而 1986 年的 Escrow 事务让你能把这种可交换逻辑扩展到……几乎可交换的操作。
Escrow 的思路是:让自增和自减可交换,只要约束不可能被违反。如果在最坏情况下——所有自增都中止、所有自减都成功——值仍然保持在 0 以上,那你何必在意,直接把它们都当作可交换的就好了。
据我所知 Escrow 只有一个实现,Oracle 23c 以“lockfree reservations”之名引入了它,但是,Oracle 并不是一个法定人数数据库。
文章标题:请实现一个法定人数数据库
正文: 要将这一点应用于法定人数系统,你需要 1992 年的那篇论文:High Throughput Escrow Algorithms for Replicated Databases,它告诉你,在标准的 5 个中 3 个法定人数配置中,最坏情况下的值需要保持在当前账户值的 40% 以上,而不是 0。这不是一个特别难的修复。
所以如果我们把所有这些想法揉在一起……
CAN. IT. CASHDB???
CashDB 只支持一种可托管的账户转账操作和一个 nil-external 日志追加。我显然是为了这个论证而设计 CashDB 的。孤立地看,这个异步领导者技巧并非 100% 无领导者,但我把它包括进来,因为它是朝着更好延迟迈出的一大步。
我提到它也是因为利用盲操作和可交换操作能让其他每一个算法都变得更好,而我们从来不这么做。在 Consensus over Logs 中,Nil-Externality 和 Escrow 会帮助我们判断哪些操作可以安全地与无领导者日志一起流水线化。在 Consensus over Graphs 中,这意味着我们可以减少所跟踪的依赖关系,从而更频繁地走上快路径。
增量是有史以来最好的操作,因为你可以把它们当作可交换操作,或者当作一个融合在一起的 nil-external 读-改-写、不返回任何东西,而我们基本上从不特判它们?!?我们只是在排他锁下执行它们,这让我很伤心。
好了,我时间用完了,内容也用完了,所以:
- 我们最近已经获得了更好的无领导者复制算法
- 我们最近已经获得了更好的生产级或接近生产级的示例,说明如何编写好的法定人数数据库。
- 还有更多好想法我们尚未充分发挥其作用。
我认为在我们有好的生产示例可以复制之前,我们不会看到法定人数数据库的大量涌现。
所以我恳求你。选择一些不同的东西。选择一些延迟更好的东西。选择一些让你每次竞争对手发生故障时都能发一篇“为什么法定人数更好”的博文的东西。
请实现一个法定人数数据库。
在 Reddit、Hacker News 和 Lobsters 上查看此页面的讨论。