 Newshot
Picasso 教会我的 AI Agent 构建之道
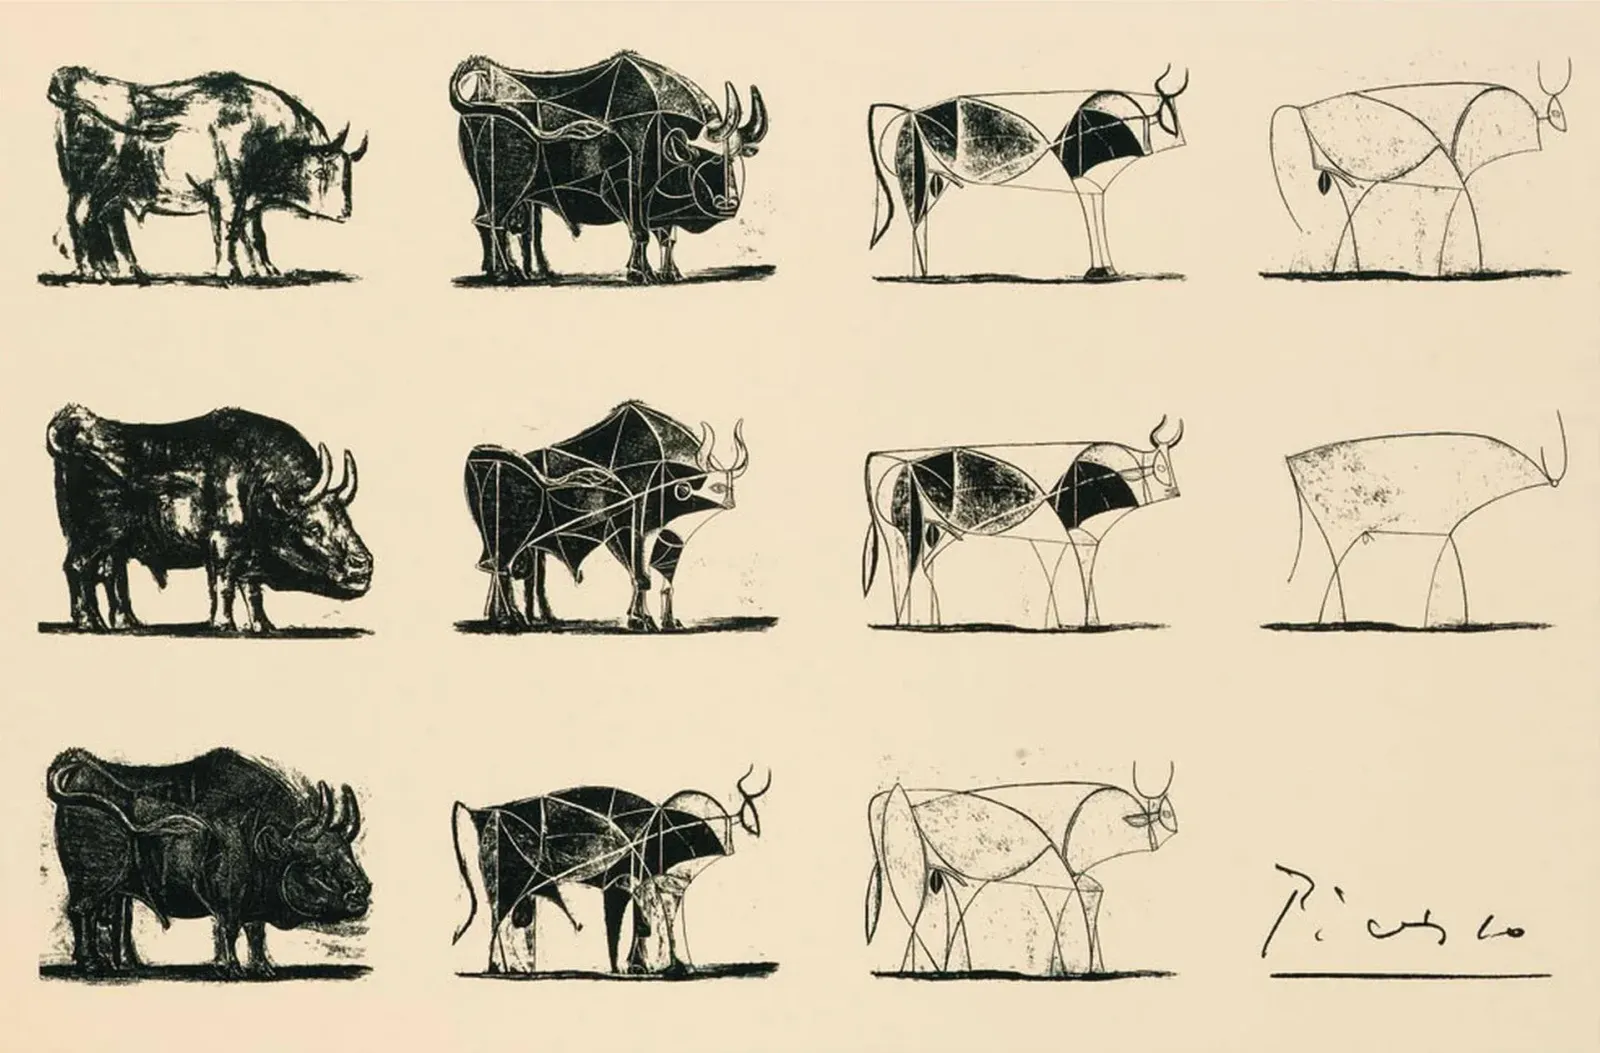
这位伟大的大师 Pablo Picasso 有一句名言:
“我花了四年时间才画得像拉斐尔,却花了一辈子才画得像个孩子。”
他的作品《Le Taureau》(公牛)完美地体现了这一点。在 11 次迭代中,毕加索一步步剥离公牛的细节,直到只剩下寥寥几笔。但那头公牛依然一目了然。
在我学习构建 AI Agent 的过程中,我深有同感。这是一个完整的轮回。
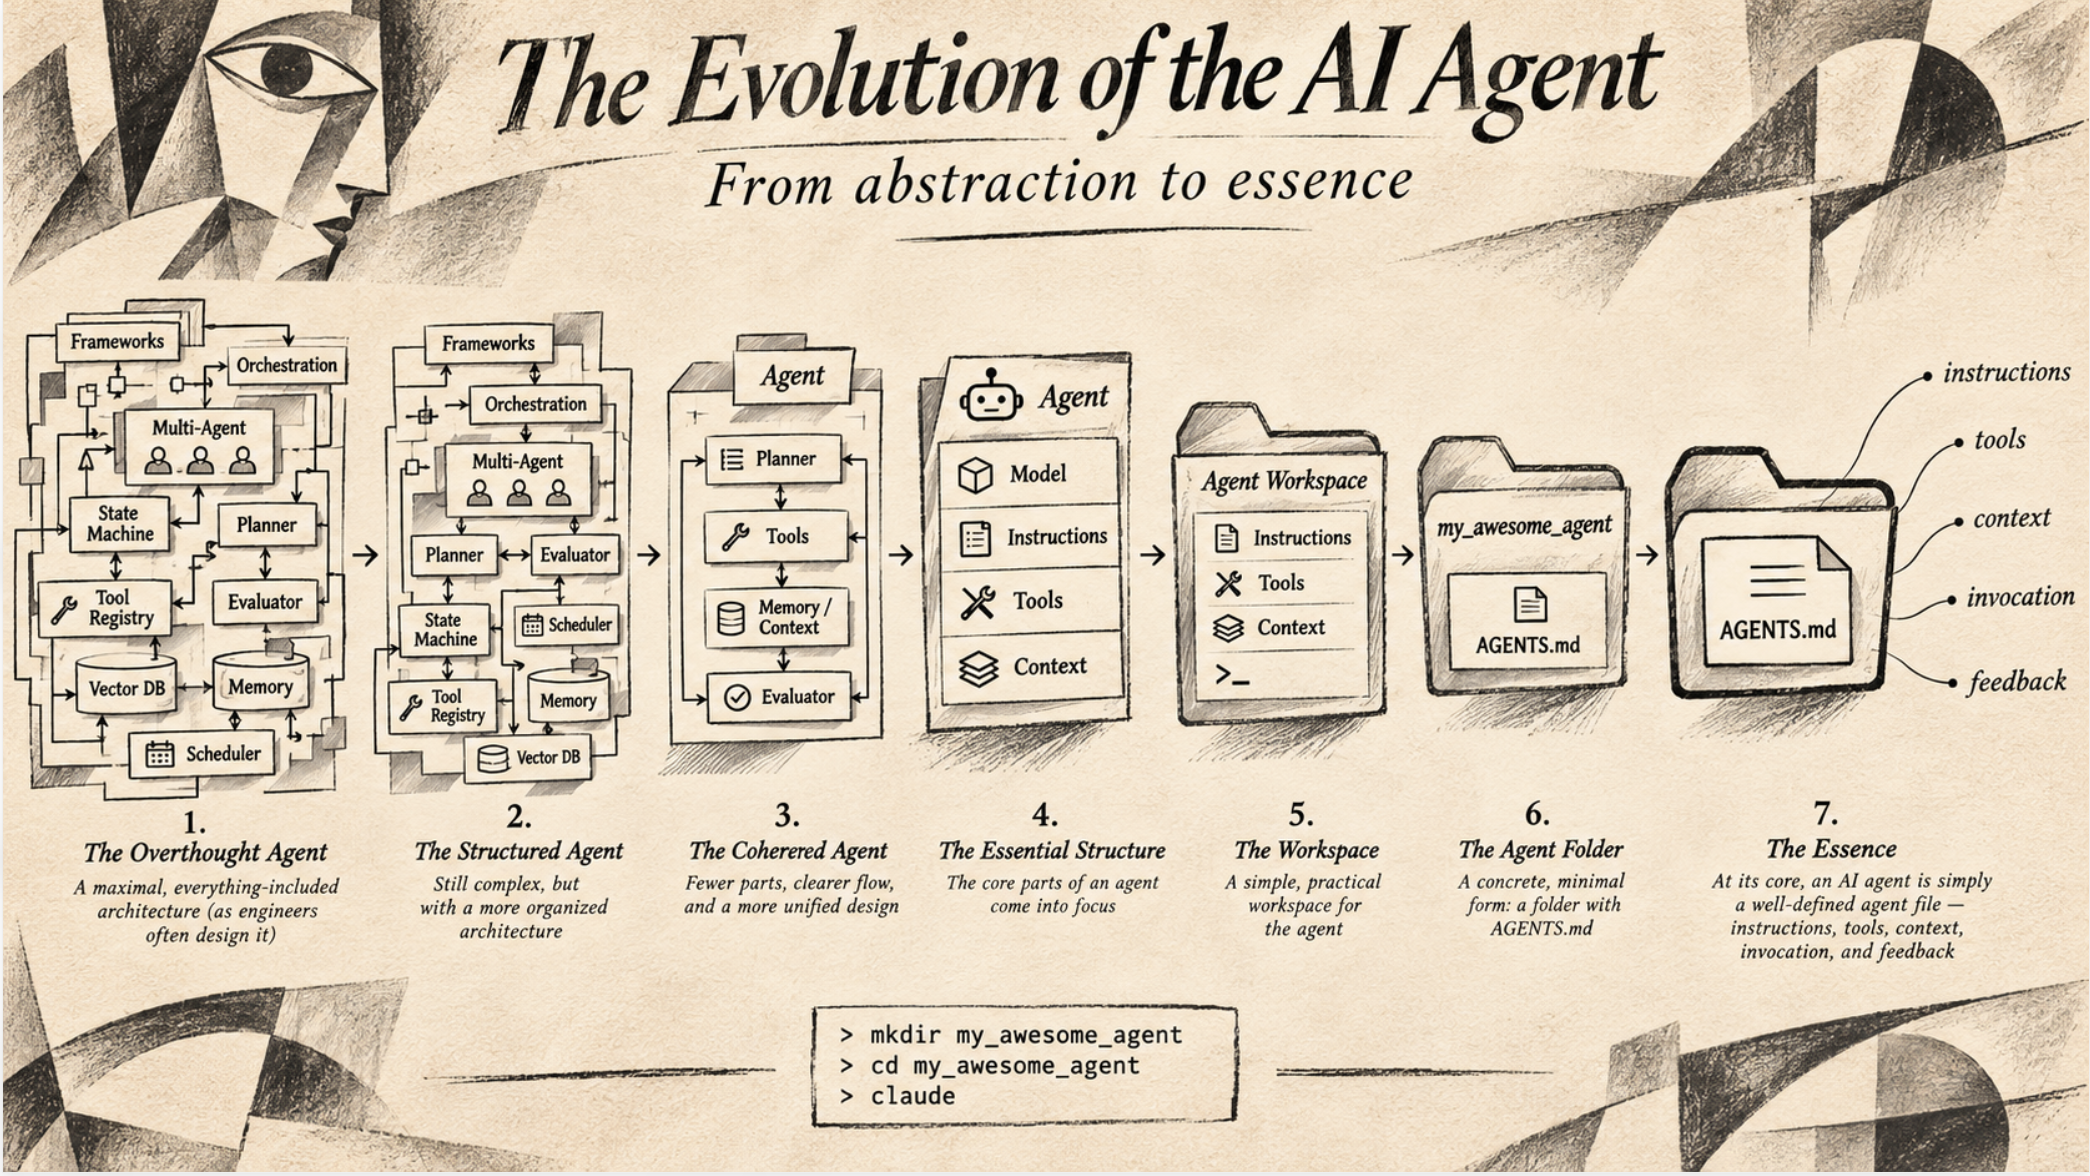
和许多工程师一样,我从抽象和复杂的软件系统起步。框架、编排引擎、多 Agent 架构、状态机、向量数据库、记忆系统,以及精巧的规划机制。
我实验得越多,就越发现自己在一层层地剥离这些东西。
模型在变得更好。越来越多的事情用一条 prompt 就能做成。但这并不是全部。是我一直把事情搞复杂了。
这就是我现在的流程。
我打开终端。
        mkdir my_awesome_agent
cd my_awesome_agent
claude
然后开始一段对话。
“Claude,我想构建一个能做 XYZ 的 Agent。帮我初始化它。创建一个 AGENTS.md,然后我们一起弄清楚它还需要什么。”
我和 Claude 一起把几个问题过一遍。
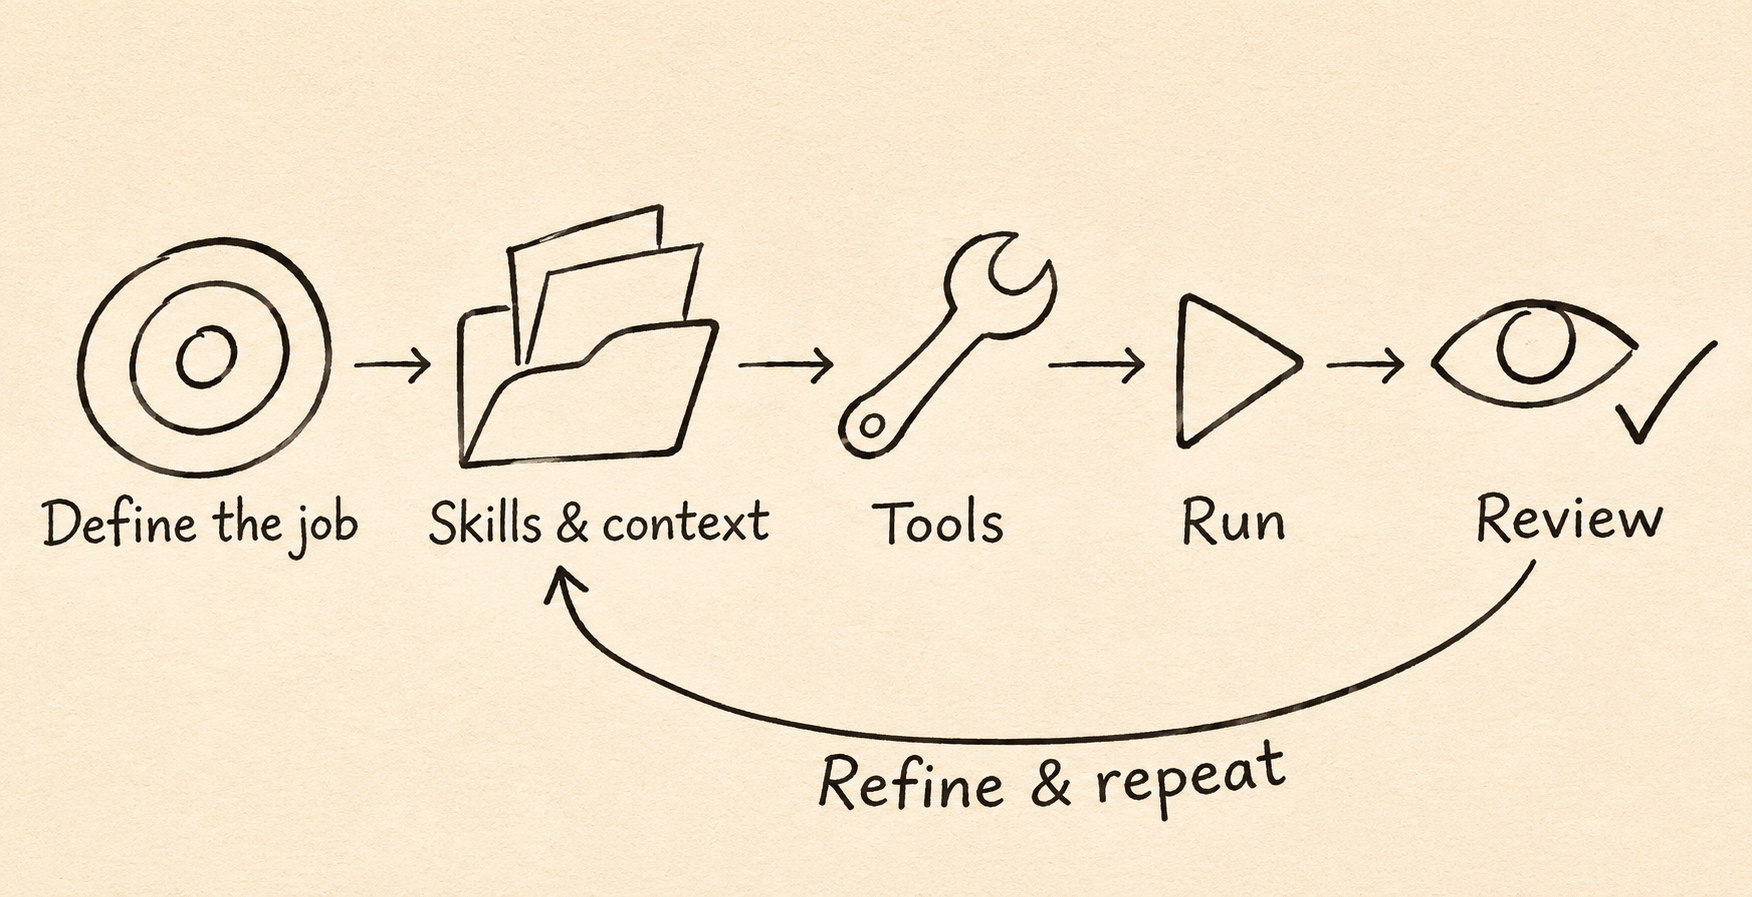
这个 Agent 应该完成什么?
真正的任务是什么?不是该用哪个框架——除非你就是在做一个框架。成功是什么样子?Agent 可以独立做出哪些决策?哪些事情它在没有许可的情况下绝不应该做?
它需要哪些技能?
技能是可以复用、重新组合的专门指令。网上有大量出色的示例。借用它们、改造它们、组合它们,或者让 Claude 创建新的。
通常,一个技能就是一个包含指令的 Markdown 文件,也许再附带一些支撑资源。
它需要哪些上下文?
Agent 需要上下文:你的业务是做什么的、你的客户是谁、你的代码库如何运作,或者某些领域特定的知识。这些都可以作为 Markdown 文件放在文件夹里。有些上下文可以在需要时检索。有些来自对话本身。你并不自动需要一个向量数据库或一套复杂的记忆架构。
它需要哪些工具?
要完成一项任务,Agent 需要工具。也许它需要搜索网络、读取数据库、调用 API、执行脚本,或者与浏览器交互。
引入一个工具,简单到只需启用一个插件或添加一个 MCP 连接器。
我让 Claude 帮忙找出完成任务所需的最小工具集。工具甚至可以动态创建,由 Agent 自己编写并调用代码。Agent 也可以在网上找到工具并安装它们。
Agent 如何被调用?
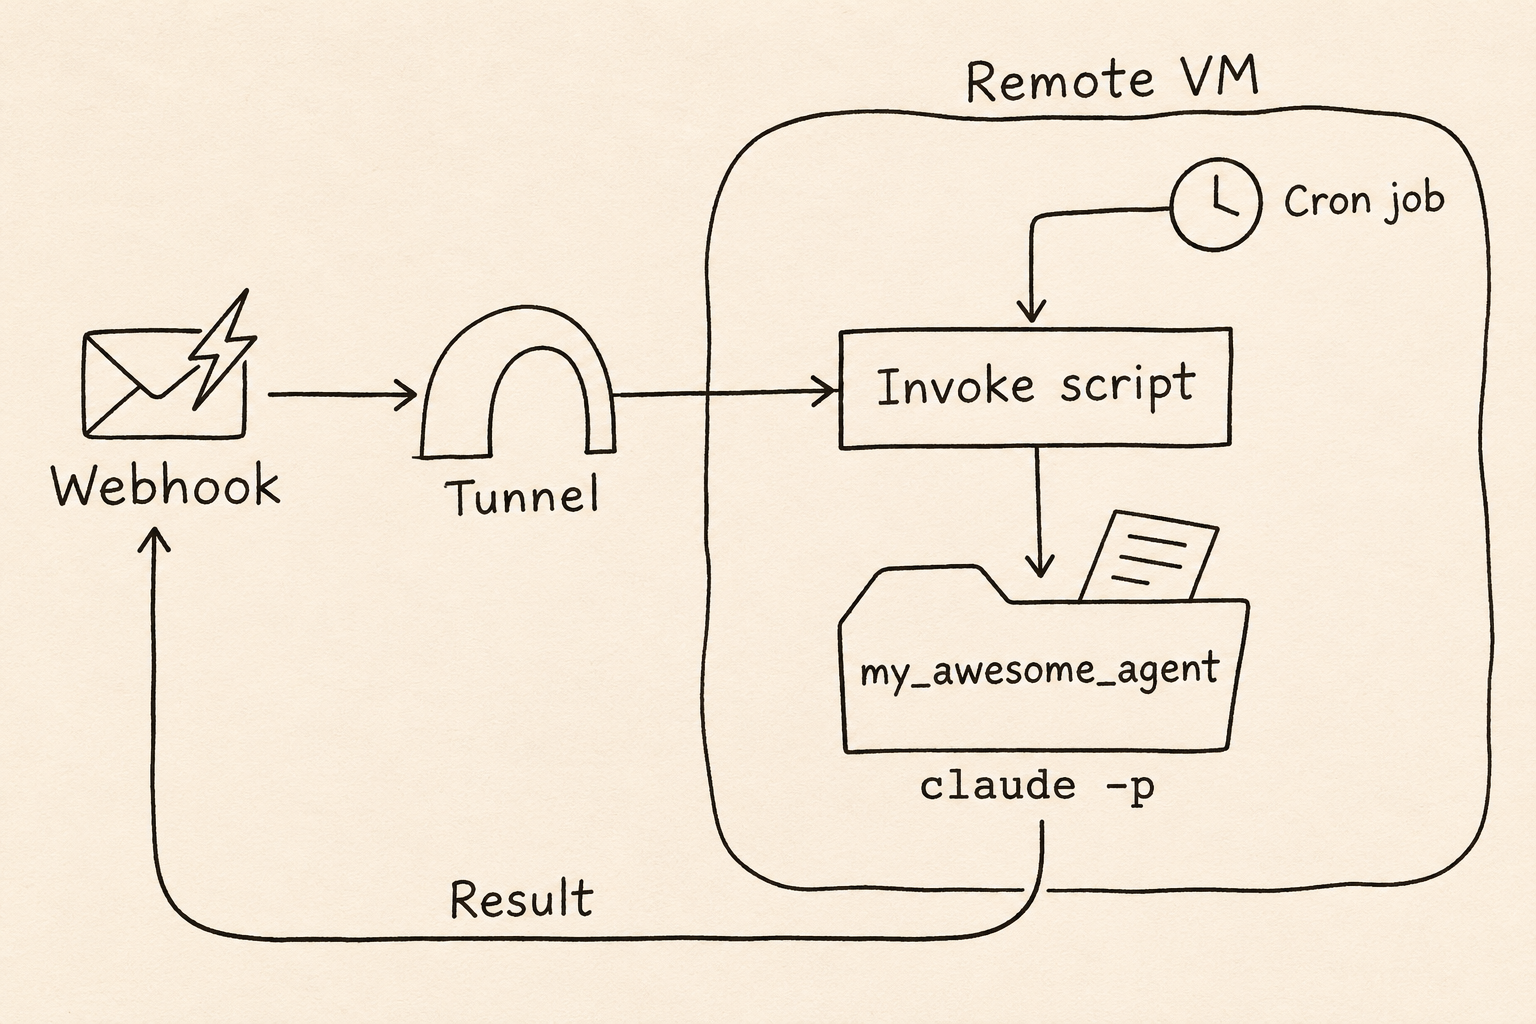
一个 Agent 要有用,就必须作为某个工作流的一部分被调用,无论是通过 cron 任务、webhook 事件,还是另一个程序。
简洁之处在于打包方式。一个存放指令的文件夹,就是一个干净的可部署单元。它可以被版本化、被复制、被嵌入到其他流程中。
有了 Claude 以及所需的工具和凭据,就可以用 -p 标志以无头方式调用它:
        cd my_awesome_agent
claude -p "Do awesome stuff"
无头意味着没有交互式聊天。Claude 接收任务,在 Agent 的文件夹里工作,打印结果,然后退出。脚本可以传入任务并收集输出。对于无人值守的工作,我会提前配置好工具权限。Claude 也可以返回结构化的 JSON 供另一个程序使用。
Anthropic 关于无头执行的文档涵盖了相关命令和配置。
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。在回复和工具调用中都请原样使用它们:它们会在任何东西运行之前被替换为真实值。不要请求验证它们,也不要用示例替换它们。
当 agent 启动时,它需要知道去哪里找自己的指令、收到了什么输入,以及是否应该继续之前的工作。调用机制可以改变,但 agent 的根本目的不会改变。
这套设置可以部署在远程 VM 上,用钩子触发 agent,并通过隧道提供对调用它的那个服务的访问。
它怎么知道自己干得好不好?
这正是进步最大的地方。现在我只用一个提示就能把事情做完,不需要精心设计的指令。如今我常常直接信任它自己去把活干完。而且我预期它会越来越好。
当它出错时,我会和 Claude 一起复盘。发生了什么?缺了什么?我们应该改什么?
Claude 会把本地会话记录保存在 ~/.claude/projects/<project>/<session>.jsonl 下。每条记录都包含对话、工具调用和工具结果。它提供了任务如何展开的轨迹:Claude 被要求做什么、它尝试了什么、工具返回了什么、错误出现在哪里。
然后可以把这份记录交给 Claude,让它分析这次运行。它在哪里偏离了方向?是漏掉了某条指令、缺少上下文,还是误解了某个工具结果?轨迹中有哪些证据支持这个解释?这样我们就有了具体的东西可以检查,再决定要改什么。
如果这个经验可以复用,我们就把它写进指令、上下文、示例或测试里。
随着时间推移,agent 会变好。不一定是因为它的底层模型变了,而是因为它的工作上下文和操作指令变得更好了。
我们怎么知道它在变好?
要对实现做到严谨,你需要基准测试:有代表性、成功标准明确的任务。跑同一批任务,可以让你在不同的 harness(如 Gemini CLI、Codex 或 pi)之间、或不同的模型(如 Opus、Astra、Sol 和 DeepSeek)之间比较你的 agent。它也能告诉你,对自己这套设置的改动是否有帮助。
这类测试叫做 evals。这大概是整件事里最难的部分。我会在之后的一篇文章里分享我在 evals 上的经验。与此同时,下面这些文章对它们做了深入得多的讲解:
- Hugo Bowne-Anderson:Does Your AI Agent Actually Work? A Guide to Evals
- Hamel Husain 和 Shreya Shankar:AI Evals: Everything You Need to Know
编排
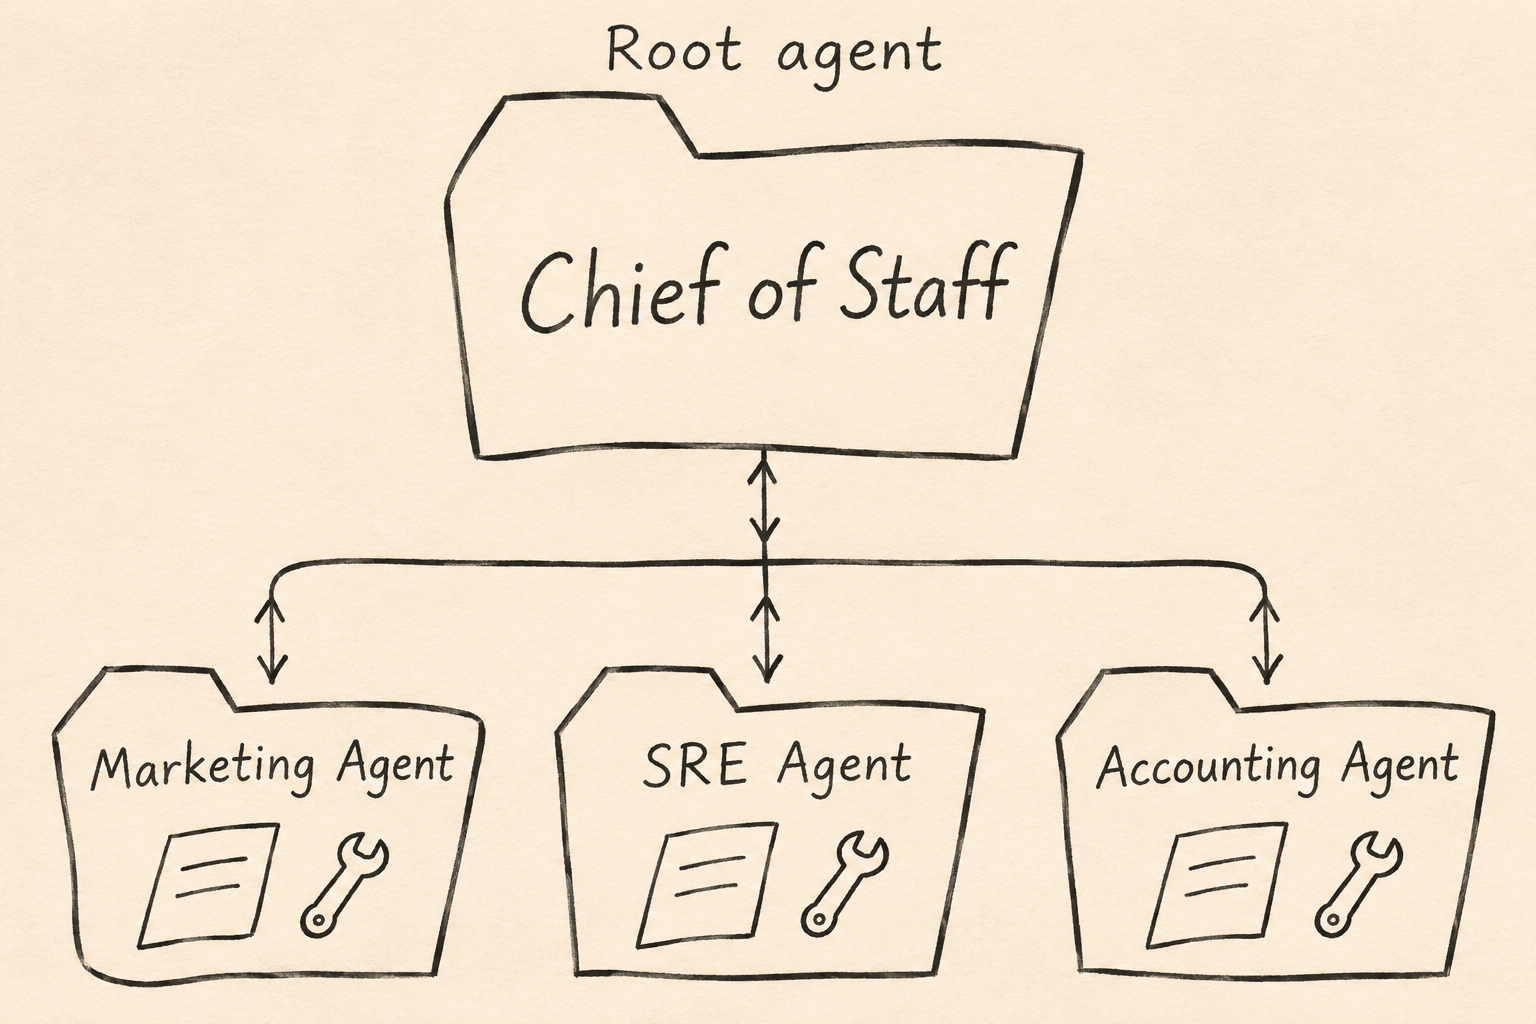
一个任务可以拆成更小的任务,委派给专门的子 agent。在这套设置里,每个子 agent 在主 agent 下都有自己的文件夹,里面放着它的指令、上下文和工具。
根 agent 充当编排者,或者叫参谋长。它决定调用哪个子 agent,给它派任务,再把结果汇总起来。例如,一个参谋长 agent 可以协调公司里各种活动,把工作委派给专家 agent。
把它落到实处
我用这套设置来发布这个网站,包括你正在读的这篇文章。在这个项目里,我用的是 Codex。
agent 在网站的项目文件夹里工作。AGENTS.md 把它指向我的编辑规范和发布说明。那些文件记录了我的偏好以及更新站点的步骤。下面是实际文件夹的简化视图:
        claramap/
├── AGENTS.md
├── docs/
│   ├── editorial-memory.md
│   └── publishing.md
├── content/posts/
│   └── what-picasso-taught-me-about-building-ai-agents.md
├── public/assets/blog/
└── scripts/
    ├── build.mjs
    └── check-live.mjs
这个智能体通过 MCP 连接到 Cloudflare,因此可以把部署站点作为工作流的一部分。
写这篇文章时,我让它添加编排一节并绘制幕僚长图表。它编辑了 Markdown、生成了插图、构建了站点、部署到 Cloudflare,并检查了线上页面。
发布说明还涵盖 Google Analytics 和发现文件。构建过程会自动更新站点当前页面的分析跟踪代码、重新生成 llms.txt 和 llms-full.txt,并更新 RSS 源。
我会在同一段对话中审阅结果并修改。改措辞。挪动图表。把图片调大。可复用的反馈会写回编辑记忆,这样后续运行就能拿到更好的指令。
本质
这是基础。其余一切都建立在其上。
不需要 OpenClaw、Hermes、Muse、LangChain、Pydantic 或任何其他智能体框架。先解决最基本的情况,之后再添加机制。你可以寻找潜在客户、创作内容、发布、发邮件、回答问题、填表单或写代码。挑一项工作。给它所需的东西。让它去干。
就像毕加索画的公牛,随着我学会该舍弃什么,我的做法也变得越来越简单。演变过程大致如下。
关于我
Mathew Mathew 是一位独立 AI 顾问,也是 Claramap 的负责人。他从事 AI 落地、云架构和分布式系统方面的工作,把技术咨询与动手工程结合起来。他与各种规模的公司合作,从单人创始人到《财富》100 强企业。
他拥有 20 多年的企业工程与领导经验,包括与 IBM Cloud、Amdocs、AT&T、NTT、EBSCO、Discover、SolarWinds、Placester 和 RetailDecisions(ACI Software)的合作。
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。在回复和工具调用中都请按原样使用:它们会在任何东西运行之前被填入真实值。不要要求核验它们,也不要用示例替换它们。