 Newshot
用于微控制器的 JIT 位图文本渲染
Raph Levien,2026年11月7日
我一直在开发 vic-2350,这是在 RP2350 微控制器板上对一台 80 年代家用电脑的重新构想。当然,这样的项目需要文本渲染。尽管位图字体如今已不受青睐,但我选择它们既是出于效率,也是因为在低分辨率下,我更偏爱清晰、经过刻意设计的位图字体的美感,而不是抗锯齿字体渲染那种模糊的一团。它们仍然有一席之地,尽管很狭窄。
我还想要比例间距和字距调整,同样是因为我喜欢早期 Macintosh 及其前身的美感。RP2350 项目中的大多数文本渲染都基于固定字符单元,因为要获得良好性能很棘手。
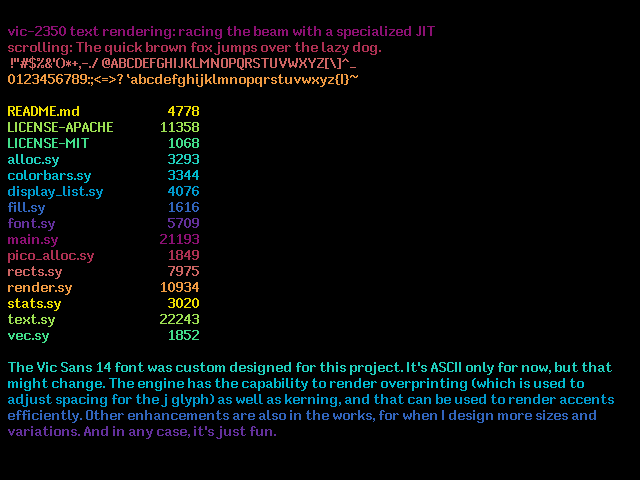
这篇博文介绍一种在 RP2350 等微控制器上极快渲染位图文本的技术。我已将其作为我的 race-the-beam 渲染器的一部分实现,但同样的技术也适用于写入帧缓冲的情况。核心思想是使用 JIT 即时生成高度优化的代码来渲染字符串。
光束竞速
大约在 80 年代中期,计算机显示文本的方式出现了分化。既有的技术是固定单元大小,以及硬件在图像扫描输出到显示器时即时从字体 ROM 中查找字符。其优势是在有限硬件下实现非常快的更新和响应速度。许多终端都是这样工作的,家用电脑也是如此。缺点是缺乏灵活性。特别是只支持等宽字体。
较新的技术是位图帧缓冲,它最早出现在从 Xerox Alto 开始、经 Apple Lisa 延续、最终在 Macintosh 上流行起来的一系列计算机上。帧缓冲灵活得多,但保持更新需要多得多的计算能力。在 80 年代早期,你通常会看着文本逐步渲染出来。我还应该提到,家用电脑通常提供图形模式,但它们的分辨率通常低于文本模式,而 1MHz 的 6502(或类似芯片)根本不够强大,所以像文字处理器和电子表格这样的严肃文本程序使用文本模式。
快进到 RP2350。它借助 HSTX 外设能够输出 DVI 视频,但填充视频缓冲仍然完全取决于软件。有些项目选择帧缓冲,但芯片上只有 520kB 的 SRAM,因此帧缓冲必须在分辨率或位深或两者上受到限制,而且让那块 RAM 可供应用用于其他目的也会更好。我选择的是与光束赛跑,逐扫描线填充视频缓冲。这允许更丰富的视觉效果和低得多的延迟,但对渲染器是硬性性能约束。预算大约是每像素 6 个周期。我们在预算内压得越低,就能为渲染其他图形对象和其他应用功能留出越多空间。
Rust 无法满足性能要求,所以我开始编写 ARM 汇编语言。渲染器以及 vic-2350 的许多部分现在都用 symbolasm 编写,这是我为极高性能 Cortex-M33 编程创建的一种编程语言。采用 JIT 进一步加速渲染。
渲染管线
渲染通常被建模为管线,vic-2350 渲染器也不例外。应用与渲染器之间的接口是显示列表。本质上,它就是字面所说的东西:一个显示对象列表。显示列表是双缓冲的;一个正在被渲染并扫描输出,另一个由应用构建。在每个 vsync 时,如果应用准备好,显示列表就会交换。构建显示列表在计算上并不密集,但当然应用可能正忙于做其他事情。
像 {{NAME_ab12cd34}} 这样书写的值是真实值的占位符。请完全按原样使用它们,在回复和工具调用中都是
由于显示列表在编译时大小未知,因此它会进行分配。显示对象被装入两个向量中;一个保存显示对象本身,另一个保存指向第一个向量的索引列表。一个显示对象由 vtable、边界矩形以及对象特定的负载组成。分配是可以接受的,因为构建显示列表并非时间关键。渲染则是另一回事。尽管如此,显示列表保持内存高效很重要,尤其是因为存在两份副本。
呈现之前,索引按 y0 升序排序。
渲染期间,渲染器维护一个活动列表,它只是与当前扫描线相交的显示对象的子集。在每条扫描线处,y1 = y 的对象从活动列表中删除,y0 = y 的新对象被插入,这就是前面排序的原因;这正是对象插入活动列表的顺序。活动列表按显示对象顺序保存。
然后渲染器只需为活动列表中的每个显示对象调用 render 方法。我很快会做更多优化,跟踪不透明区间,并省略对之后会被覆盖的像素区间的渲染工作,但这对于这里介绍的文本渲染并不是根本性的。
在对象的开始和结束时(即它被插入和删除时),渲染器会在显示对象上调用 start 和 end 方法。这些方法可以分配暂存空间,并做其他工作来为对象的渲染做准备。有一个专用的位图分配器,既快又具有确定性。
文本显示对象
所有这些为我们提供了所需的一切,以便将文本渲染实现为显示对象的一个实例。
文本对象本身包含字符串(每个字符 1 字节)、指向字体的指针,以及前景色和背景色。RAM 很宝贵,对于显示列表更是如此,因为它是双缓冲的。在渲染器的早期迭代中,我曾将文本的展开版本存储在显示列表中,当屏幕充满文本时,这造成了不可接受的内存压力。
start 方法为 JIT 代码和每像素 1 位的中间缓冲区分配暂存空间,并调用 JIT 编译器,将字符串展开为代码。
render 方法调用该代码,该代码填充每像素 1 位缓冲区,然后运行第二遍,将该每像素 1 位缓冲区扩展为每像素 16 位 RGB(565 格式)。第二遍以每像素 1.75 个周期的持续速率运行。
字体以极度紧凑的格式存储。字形的所有“墨水”都存储在一幅宽位图图像中,高度与字体相同。这种打包还确保没有字形跨越 32 像素块边界,因此一行字体像素始终可以通过单次 32 位加载读取。如果字形两侧有空白,该空白不会存储在打包位图中;相反,空白位于每个字形的元数据中。
本着微优化的精神,打包算法还会检测重叠,因为并不要求像素对单个字形唯一。这项优化将字体位图的大小从 1140 字节减少到 960 字节。每个字节都很重要,随着我们添加更多字体更是如此。字体位图需要驻留在 SRAM 中,因为将其放在 flash 中可能会在视频速率下渲染时导致停顿。
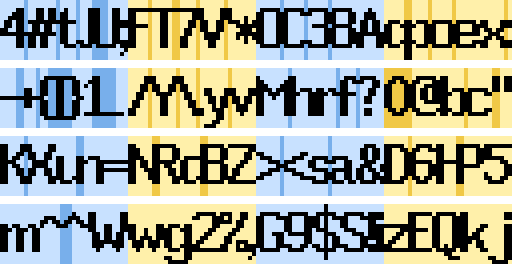
我特别喜欢 {][} 这个序列(靠近第二行的开头)。任何包含在另一个字形内的字形都不需要单独打包。有几个例子,有些令人惊讶。例如,l 是 U 的左侧部分,而 0 与去掉中间空格的 () 相同。
每个字形的元数据(不计字距调整)在概念上分为四个字段:位图中墨迹的 x 位置和宽度、左侧空白,以及前进量。所有这些都紧凑地打包进一个 32 位整数中。
JIT
在生成的 JIT 代码中,寄存器的分配如下:
- r0 指向打包字体位图行的起始位置
- r1 是输出缓冲区,即一个每像素 1 位的一行图像缓冲区
- r2 是输出位图的累加器
- r3 保存从 r4 中提取的一个字形的位
- r4 保存从字形位图加载的 32 位
在最简单的情况下,我们向累加器中加入一个字形。代码如下:
        ldr r4, [r0, #(x_offset / 32 * 4)]
    ubfx r3, r4, #(x_offset % 32), #(width)
    orr r2, r3, lsl #(x % 32)
还有额外的代码用于在完成时输出一个字(stmia r1!, {r2}),以及处理字形跨越 32 位边界的情况。这些在 text.sy 中有记录。但这里有一个我确实想提到的技巧:上述代码在 ldr 和 ubfx(无符号位域提取)之间存在结果使用延迟。这通过稍微调整指令顺序来解决:把字形 i 的最后一条指令重排到字形 i + 1 的第一条指令(ldr)之后,填充延迟槽,并将周期开销从 4 降到 3。
下面是代码生成器的内层循环,只关注字形不跨过累加器的情况。对于每个字形,若干个值被打包进 g 变量,然后在下面解包:打包字体位图中的偏移(进一步分解为位偏移和字偏移)、着墨部分的宽度、左侧边距以及前进量。
        loop {
        g @r12 = *(glyphs + c * 4)
        // the next character, reading one past the end
        c = *text++
        width @r7 = g[20..26]
        bit_offset @r4 = g & 31
        if width == 0 goto blank
        // ubfx r3, r4, #offset % 32, #width
        ubfx_instr @r11 = *(ubfx_table + bit_offset * 4)
        // ldr r4, [r0, #offset / 32]; the font is narrower than 32 words,
        // so the offset fits, and strh leaves out what's above it.
        word_offset @r4 = g >> 5
        ldr @r4 = ldr_base + (word_offset << 6)
        ubfx_instr += width << 16
        *slot = ldr
        // left side bearing
        left @r4 = (g as i32)[16..20]
        *(code as *u32) = ubfx_instr
        // shift: where the glyph starts, relative to the word in r2. Branch is
        // also taken if negative.
        shift @r4 = pen + left
        room @r7 = 32 - width
        pen += g >> 26
        #(shift - room)
        if #hi goto off_word
        // the delay: orr r2, r2, r3, lsl #shift
        d @r12 = *(orr_table + shift * 4)
        *((code + 6) as *u32) = d
        slot = code + 4
        code += 10
        #(n -= 1)
        if #ne goto loop
    }
下面是上述 symbolasm 代码编译出的 ARM 汇编代码,以及来自 symbolasm 分析工具的周期计数分析:
        134: f859 c028           1 ldr r12, [r9, r8, lsl #2]
  136: f811 8b01           1 ldrb r8, [r1], #1
  137: f3cc 5705           1 ubfx r7, r12, #20, #6
  138: f00c 041f           1 and r4, r12, #31
  139: b387              1/2 cbz r7, .Ljit_text.blank
  141: f855 b024           1 ldr r11, [r5, r4, lsl #2]
  144: ea4f 145c H         1 lsr r4, r12, #5
  145: eb0a 1484           1 add r4, r10, r4, lsl #6
  146: eb0b 4b07           1 add r11, r11, r7, lsl #16
  147: 801c                1 strh r4, [r3]
  149: f34c 4403           1 sbfx r4, r12, #16, #4
  150: f8c0 b000 H         1 str r11, [r0]
  153: 1934                1 adds r4, r6, r4
  154: f1c7 0720           1 rsb r7, r7, #32
  155: eb06 669c           1 add r6, r6, r12, lsr #26
  156: 42bc                1 cmp r4, r7
  157: d821        K     0/2 bhi .Ljit_text.off_word
  159: f85e c024           1 ldr r12, [lr, r4, lsl #2]
  160: f8c0 c006           1 str r12, [r0, #6]
  161: 1d03                1 adds r3, r0, #4
  162: 300a                1 adds r0, r0, #10
  163: 3a01                1 subs r2, r2, #1
  164: d1da        K     0/2 bne .Ljit_text_0_loop
   loop 134-164: 23 cycles per iteration
K 标志表示分支可能产生延迟,因为直到分支前一个周期才能知道条件。这里,0/2 表示如果分支不跳转则为 0 个周期,如果跳转则为 2 个周期。这两者都无法优化。H 标志表示该指令是 32 位而不是 16 位,因为使用了“hi”寄存器(r8-r15)。这些寄存器在 LSP 中也可用。
没有 JIT 的话,也可以把文本渲染写成循环,但在比例间距的情况下,需要大量准备工作来确定移位量,还要用分支处理跨越 32 位边界之类的情况。这个想法在 pico-dvi-rs 中的早期实现很难显示整屏文本。当然,对于固定宽度文本,所有这些都可以静态得知,因此没有 JIT 的紧凑循环也没问题。
性能
基本循环对于 JIT 是每个字形 23 个周期,再加上位图生成的每高度 3 个周期。每 32 位输出宽度,JIT 还有约 20 个周期的额外开销,以及每高度 2 个周期。
这快得惊人。vic-2350 中的 textdemo 运行 JIT 约需 21k 个周期,运行 JIT 代码约需 42k 个周期。加起来约占 RP2350 单核可用吞吐量的 2.6%。扩展到 565 实际上大约贵 3 倍。因此可以说它已经尽可能优化了。
虽然这是为 race-the-beam 渲染设计的,但写入帧缓冲区也同样可行,尤其是每像素一位的帧缓冲区。只需生成代码,然后
基本上,每个字形有两个位向量,分别对应左侧和右侧。要对两个字形做字距调整,取第一个字形右侧位向量与第二个字形左侧位向量的按位与,然后计算其 popcount(1 的位数),得到需要调整的像素数。这实际上就是两个向量的点积,其中位被解释为 0 和 1。字距表每个字形只需要两个字节,而且字距调整的求值非常快。
即使如此,字距调整的求值是在显示列表构建时完成的,而不是在扫描束运行时实时进行。当字距值非零时,会在文本显示对象的字符串中插入一个特殊的负空间字符。
对于这个字体,我手动构建了字距表。每一位都是一个特定特征,例如第 0 位表示第一个字形的右上角向外突出,而下一个字形的左上角相应地缺少墨迹。因此,T 和 Y 的右侧会置位,大多数小写字母以及 A 的左侧也会置位。不难想象可以有一个工具帮助自动化这件事,也许可以把以其他方式准备好的字距信息提炼出来。
我还没有做真正的实现,但我怀疑这个想法可能可以扩展到真实字体:向量不再存储位和一个整数字距量,而是存储连续值(经过合理量化)。在乘法之后、求和之前增加一个非线性步骤也可能有帮助。当然,点积在 GPU 上计算起来效率高得离谱,而在 OpenType 表中做索引追踪则不是。但那种探索是改天的事了。
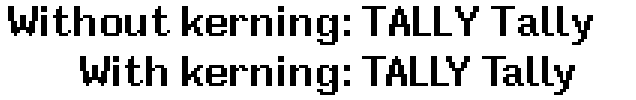
字距调整显著提升了质量:
AI 披露
这项工作是对 pico-dvi-rs 中文本渲染的改进,而该渲染是手写的。我的 JIT 核心草稿是用 Rust 手写的,然后我用 Claude 把它翻译成 symbolasm,并对其进行了改进和优化。这篇博客是手写的。
symbolasm 编译器和分析工具在很大程度上由 LLM 辅助,不过它也是从最初的手写版本演变而来的。
我做了一个微排版实验,结果相当酷,但决定不把它包括进来,部分原因是它会增加 LLM 内容的比例。
和业内大多数人一样,我也在质量与 LLM 带来的加速之间挣扎着寻找平衡。Claude 非常擅长低层编码任务;它轻松地在我草稿版的 JIT 编译器中找到了一个边缘情况。我发现,如果使用得当,LLM 可以提高质量,而我也在努力做到这一点。
相关工作
我没能找到多少专门针对文本渲染的 JIT 先例。当然,关于 JIT 的总体文献浩如烟海。用于 bitblt 的即时代码生成大约在 1982 年为 Blit 实现过。更多内容参见 Bitmap Graphics SIGGRAPH 84。一个有趣的细节是,他们声称大约每秒 2500 个字符;而这件事在 RP2350 硬件上的原始性能几乎高出 3 个数量级,这里只计算输出到 1bpp 的部分(Blit 的帧缓冲就是这样配置的)。
后来补充的编辑:David Fuchs 指出了 [US Patent 6377261],该专利于 1996 年提交,将字形编译为机器码。它针对速度进行了高度优化,并且与这里的想法有很多共同点,但依赖缓存才能有合理的 RAM 效率。即便如此,它绝对算作现有技术。
在 Hacker News 上讨论。