 Newshot
AI 的价格通常按 token 报价,但企业真正付费购买的是在特定质量水平下完成的任务。Village 的 LLM Atlas 对两者都做了估算:每个模型及每种推理设置的 capability 分数,以及每种设置完成一个典型 agentic 任务(例如在终端中修复代码或起草一份专业文档)的成本。这样我们就能追踪每一笔预算随时间推移能买到什么,以及用最低成本达到某个 landmark 模型能力水平的方式。如今,达到任何 landmark 模型的能力水平,成本都只是其发布价的一小部分,而达到近期 landmark 模型水平的成本下降得最快。
同样的钱每年能买到好得多的 AI
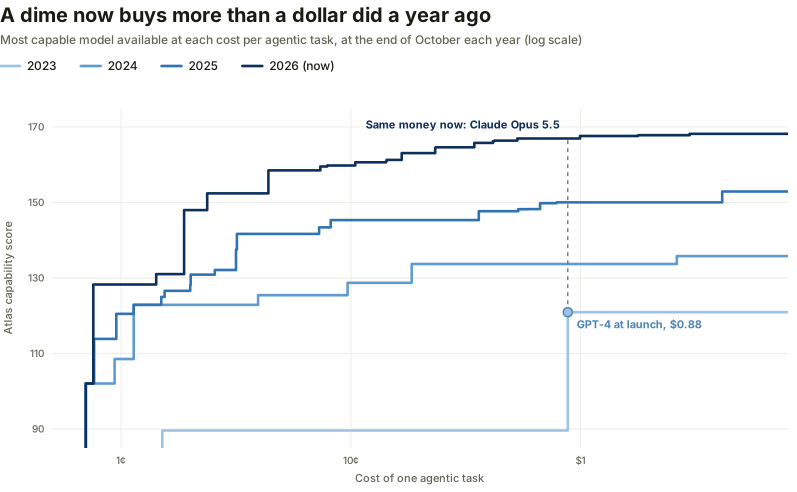
- GPT-4 的发布价如今能买到 Claude Opus 5.5。2023 年 GPT-4 每个任务成本为 88 美分;Opus 5.5 是 Atlas 中能力最强的模型之一,在 high 推理强度下成本低于这个数。
- 这种变化每年都在发生。在过去两年中的每一年里,花一角钱能买到的最佳模型,得分都高于一年前花一美元能买到的最佳模型。
如今匹配任何 landmark 模型都很便宜
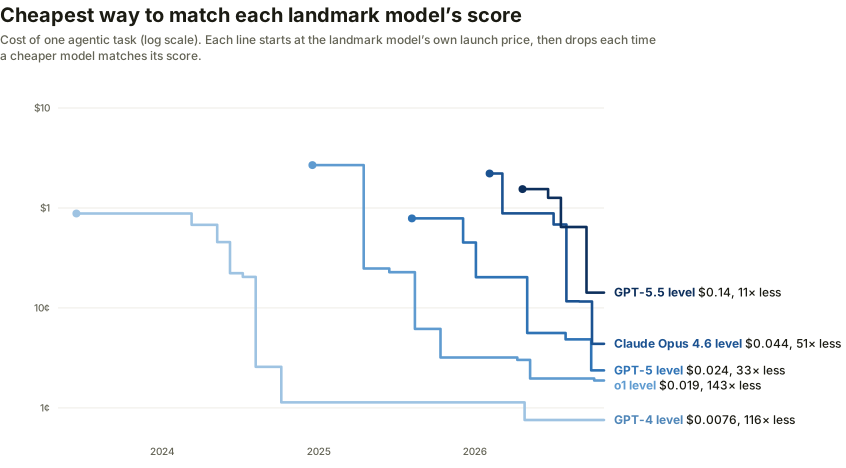
- GPT-5 水平的工作成本只有发布时的三十三分之一。2025 年 8 月用 GPT-5 完成一个 agentic 任务需要 79 美分,如今用 OpenAI 的 GPT-6 Luna 只需约 2 美分。
- o1 水平的工作便宜了 143 倍。OpenAI 的首个推理模型在 2024 年 12 月每个任务成本为 2.68 美元;如今同样的水平成本不到 2 美分。
- 甚至连今年的前沿模型也已经是划算买卖。达到今年 2 月发布的 Claude Opus 4.6 的水平,如今便宜 51 倍。
这一降幅很大程度上来自更便宜的档位,它们只需更少的推理就能达到相同质量:如今匹配 o1 的最便宜方式是把推理关闭的 GPT-6 Luna。短问题的降幅甚至比 agentic 任务更大,GPT-5 水平的问题相比发布时便宜了 171 倍。
更新的水平降价更快
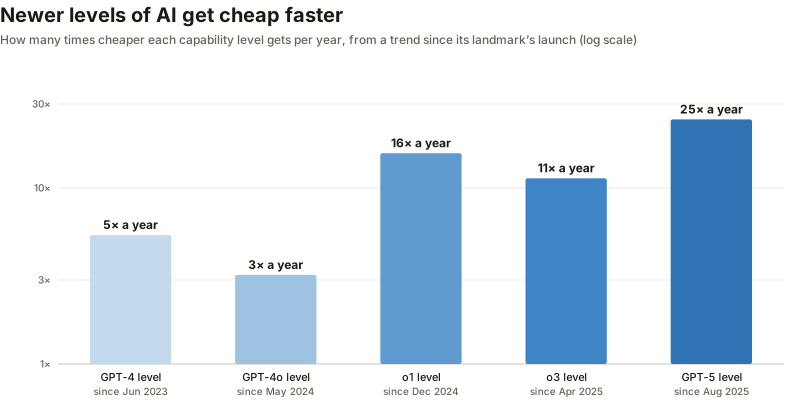
- 由 GPT-4 和 GPT-4o 设定的水平每年下降 3 到 5 倍。
- 自 2024 年底 o1 以来设定的水平每年下降 11 到 25 倍。
前沿与廉价层级之间的差距也在更快缩小,尽管并非每个水平都如此。GPT-4 水平的工作变得便宜 10 倍用了 14 个月,o3 水平的工作用了 13 个月,但自 GPT-4 以来的其他五个里程碑在 4 到 9 个月内就达到了这一水平。
我们如何构建这个
本研究使用 Village 的 LLM Atlas,它根据公开基准结果估计每个模型和推理设置的能力分数,并通过一个单独的成本模型,根据评估者的运行估计任务的典型美元成本,其方法论中有描述。智能体任务是该成本模型的 Terminal-Bench 2.1 和 GDPval 工作负载。给定日期上的前沿,是截至该日期已发布的模型中,在每个成本上最有能力的设置。一个水平是某个里程碑模型的能力分数;在每个日期,其成本是截至该日期已发布的、得分至少达到该水平的任何模型中最便宜的设置。年化速率是自每个里程碑发布以来对数成本上的直线趋势,适用于至少有一年历史的水平。分数和成本来自 2026 年 10 月 31 日;Atlas 会在新结果到来时更新。
每个模型在评估者支付的价格下只有一个成本估计,因此它不会跟踪之后对旧模型的降价。仅当一个模型分数不确定性范围的下限超过该水平时才计入该模型,或者仅使用在至少 10 个基准系列上评分的模型,会得到相同的图景,尽管各个水平的年化速率最多会变动几倍。