 Newshot
GitHub 可用性报告:2026 年 10 月
我们继续每月分享 GitHub 可用性与可靠性背后的工作进展。
10 月的简要版本:我们新增了大量可独立扩展的 Azure 容量,并消除了若干故障可能升级的途径。然而,写入中断、数据迁移期间的监控缺口以及一次区域网络中断,进一步说明容量增长必须与更安全的运维、更强的隔离和经过验证的区域恢复能力相配套。
截至 11 月 9 日,151 个生产服务中的 140 个、以及 50 个 MySQL 主库中的 32 个已在 Azure Central US 运行。Azure 承载了已迁移服务读取量的 63%、单体应用读取量的 66%,以及 Git 读取量的 52%。我们还完成了 Central US 全部九个 Kubernetes 集群的计算扩容,容量增加了一倍以上。
这些容量已经在承载真实的增长。自 3 月以来,已迁移服务的流量增长了 82%,Central US 吸收了此前由我们现有数据中心承载的最高周平均负载之外的增量。这为 GitHub 提供了更多增长空间,同时不会把原有环境推高到其以往运行范围之外。
我们还做了一些有针对性的可靠性改进。Actions 的变更提升了关键 Azure 控制面请求的容量。另一项 NAT 网关缓解措施将使用量降低了 85%;变更期间有四个生产任务失败,而如果不采取该缓解措施,预计会有约 800 个任务失败。连接限制及其他客户端改进现在也降低了依赖中断演变为更大范围重连风暴的可能性。
我们还消除了集中的数据库负载来源。一个每天处理超过 2.5 亿次请求的高流量 GitHub Actions 端点迁移到了更高效的服务路径,使数据库峰值读取量降低了 85%。在搜索仓库话题前要求至少输入三个字符,使该模式的慢查询或被终止查询减少了约 98%。
可靠性仍未达到应有的水平。10 月 7 日的写入中断暴露了数据库编排与生产路由之间不安全的交互。10 月 29 日的 Azure 网络中断影响了 Central US 全部三个可用区,以及至少 34,128 名已登录用户。以下是这些事件及其他事件的更多细节。
East US 3 的建设比计划落后约一周。下一阶段将从 12 月第一周的首次经过验证的流量爬坡开始,同时我们继续加固迁移安全性、依赖隔离和区域恢复能力。
原则保持不变:先可用性,再容量,然后才是功能。
10 月 05 日 19:11 UTC(持续 3 小时 38 分钟)
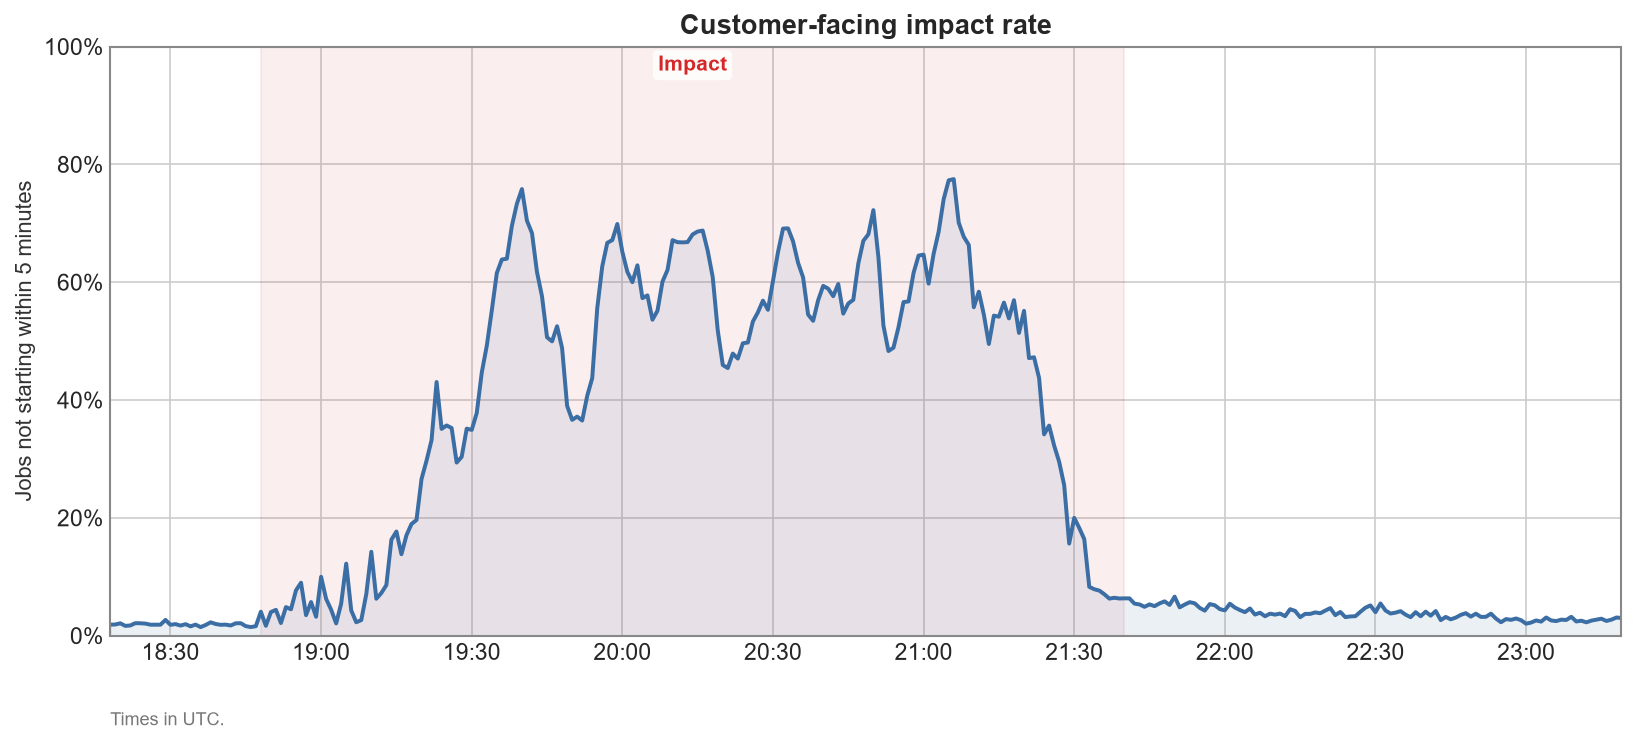
持续时间:约 3 小时 45 分钟。
客户可能看到 GitHub 托管运行器上的 GitHub Actions 任务排队时间远超平常,部分工作流运行未能启动。在约 90 分钟的最严重时段,GitHub 托管运行器上的大多数任务未能在五分钟内启动。随着我们故障转移到健康区域并增加容量,影响得到缓解。自托管运行器未受影响。使用 actions 构建的 GitHub Pages 站点更新缓慢,但现有站点继续正常提供服务。部分客户还在仓库列表、许可与账单页面以及部分 Copilot 功能中看到错误。
出了什么问题,原因是什么?
Actions 作业一直处于排队状态或无法启动,因为将作业分配给 GitHub-hosted runner 的服务无法稳定运行。我们云服务提供商一侧的部分网络故障,扰乱了我们的一个数据中心区域与该服务所依赖的云托管数据库之间的部分连接。该服务没有快速失败,而是等待这些调用超时。等待中的调用不断堆积,直到服务内存耗尽并重启。
随后,作业转移到健康区域中的同一服务,而该区域没有足够容量应对额外需求,也开始出现故障。与此同时,连续数分钟未收到作业的 runner 会关闭,且替换速度很慢,因此可用于接收作业的 runner 更少了。
我们如何响应?
- 部分网络故障开始出现,Actions 作业开始积压。
- 警报标记了错误和作业分配缓慢,我们宣布进入事件状态。
- 我们重新部署了将作业分配给 GitHub-hosted runner 的服务,但它没有恢复。我们将故障定位到网络问题。
- 我们逐个服务地将受影响的数据库和存储故障转移到健康区域,并增加了容量。Actions 恢复了,但其他一些受影响的服务在故障转移后仍然失败。
- 我们与云服务提供商合作解决了网络故障。其余服务恢复,我们解决了该事件。
我们如何让此类事件更不容易发生或影响更小?
- 我们正在让将作业分配给 GitHub-hosted runner 的服务更好地处理负载突然增加,以便当另一个区域将额外作业转移给它时能够跟上。
- 当可用 runner 容量下降时,我们现在已扩大基于客户配置文件(如果可用)的 runner 分配优先级。
- 我们正在改变 GitHub-hosted runner 的行为,以减少作业分配服务在一段时间内降级时的恢复时间。
- 我们正在改进检测和定位我们的数据中心与其依赖的云托管服务之间部分网络故障的速度。
10 月 06 日 19:57 UTC(持续 3 小时 43 分钟)
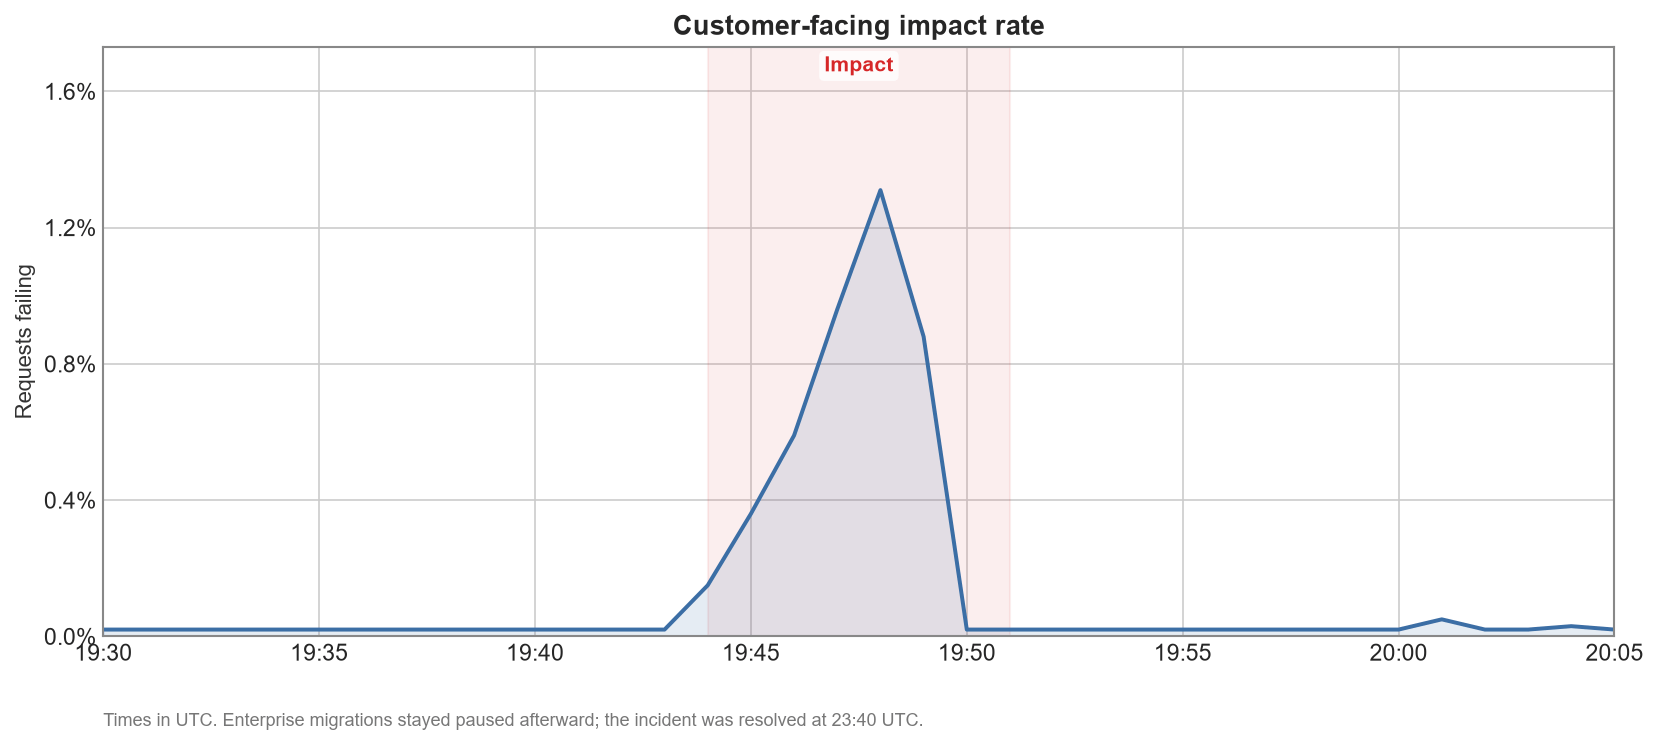
持续时间:github.com 上大约 6 分钟的失败或缓慢请求,随后大约 3 小时 30 分钟期间企业迁移处于暂停状态。
客户在登录、使用仓库和拉取请求、调用 API 或使用 GitHub Codespaces 时,可能看到了服务器错误或响应缓慢。稍后重试本会成功,延迟的 webhook 投递也很快赶上。峰值时,约 1.3% 的所有请求失败或超时,约 6.4K 个组织至少经历了一次失败或缓慢请求。
使用 GitHub Enterprise Importer 的客户,其迁移被暂停;在部署修复后已恢复。
哪里出了问题,原因是什么?
迁移活动的激增导致 GitHub Enterprise Importer 向共享数据库发送了一批非常大的查询。这些查询耗时远超平常,并与正常流量一起用尽了数据库的所有可用连接,使依赖同一数据库的其他 github.com 功能无法完成请求。
当数据库过载时,导入器没有降低其负载。一旦导入器完成其排队查询并释放数据库连接,影响在几分钟内结束。
为防止再次发生,我们暂停了迁移,直到部署了一项缓解措施,将这些查询
GitHub 可用性报告:2026 年 10 月
- 大量迁移工作使共享数据库过载,导致 github.com 上各处请求失败或变慢。
- 自动监控检测到失败,并呼叫了我们的值班工程师。
- 错误在几分钟内自行停止。
- 我们宣布进入事故状态,并暂停企业迁移以防止再次发生,同时调查原因。
- 缓解措施部署后,我们恢复了迁移并解决了事故。
我们如何让这类事故更不可能发生或影响更小?
- 我们优化了 GitHub Enterprise Importer 发送到数据库的查询,使每个查询都保持小且固定大小。
- 我们正在实现导入器在数据库承压时自动退避,在负载影响其他 GitHub 服务之前予以缓解。
- 我们正在添加数据库告警,用于标记工作量远超寻常的查询并识别出是哪个查询,从而更快地发现并修复此类问题。
10 月 07 日 15:14 与 17:17 UTC(分别持续 1 小时 11 分钟与 47 分钟)
持续时间:两次独立的写入中断分别持续约 10 分钟和 9 分钟,总计约 19 分钟。第二次是第一次的复发,原因相同。
客户在推送代码、登录、更新拉取请求或议题,或通过 API 进行更改时可能遇到错误。Webhooks、GitHub Apps 与 OAuth、Actions、代码扫描、Codespaces 和 Copilot 也受到影响。查看内容基本不受影响。已保存的数据没有丢失,中断期间失败的操作在恢复后重试即可成功。
Web 与 API 请求失败率在第一次中断中峰值达到 8.9%,第二次达到 9.3%,分别影响超过 12,000 个和超过 11,000 个组织。部分组织可能同时受到两次中断影响。
出了什么问题,原因是什么?
在例行维护期间,我们更换了管理数据库写入路由目标的机器。有一台新机器启动时带有过时的记录,其中仍列有已退役的数据库服务器。当它被自动选为 leader 后,它发布了路由设置,将若干核心数据库的写入发送到那些已退役的服务器。错误设置在通过我们现有校验后立即生效。之后,一个自动维护任务没有遵守维护暂停,触发了另一次选举;由于新机器尚未被移除,它再次成为了 leader。
我们如何应对?
- 自动监控提醒我们写入失败,我们宣布进入事故状态。
- 当一台记录正确且成熟的机器成为 leader 并发布正确设置后,写入恢复。
- 我们将原因追溯到那台新机器,解决了第一次事故,并暂停了自动维护以防再次发生。
- 当一个维护任务没有遵守暂停并导致中断重演时,我们宣布了第二次事故。
- 当一台成熟机器再次成为 leader 后,写入恢复。我们移除了新机器并解决了第二次事故。
我们如何让这类事故更不可能发生或影响更小?
- 我们改进了退役数据库服务器的方式,以免遗留过时记录。
- 我们加强了对新增数据库路由管理机器的管控,并确保自动维护遵守暂停。
- 我们加强了对数据库路由设置的校验,使错误设置在生效前就被发现。
10 月 19 日 15:49 UTC(持续 1 小时 7 分钟)
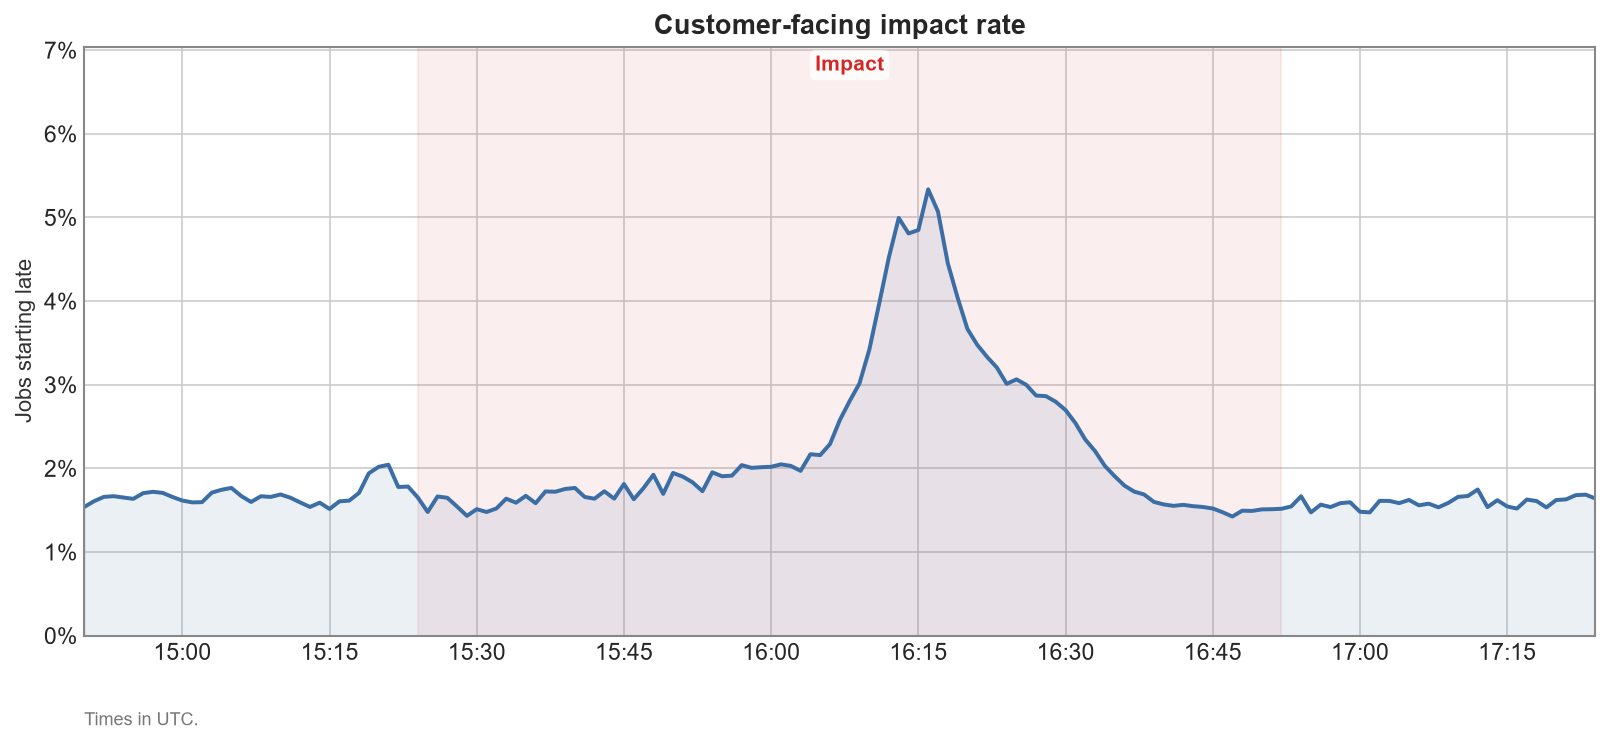
持续时间:约 1 小时 28 分钟。
GitHub 可用性报告:2026 年 10 月
客户可能遇到了 GitHub Actions 工作流状态更新、日志和检查的延迟。在 GitHub 托管的运行器上,约 5% 的作业启动延迟,极小比例的工作流运行失败,并且对 actions jobs REST API 的一些请求返回了错误。GitHub Pages 部署以及由 actions 运行生成的工作流和检查 webhook 事件也出现了延迟。部分时间内,github.com 上的实时更新和代码搜索出现了降级。
出了什么问题,为什么?
一个存储工作流日志和运行状态的内部 actions 服务在一个云区域中失去了与部分缓存服务器的连接。运行该服务的每台服务器随后同时重试了这些连接。这些重试共同饱和了 GitHub 数据中心与该区域之间的网络连接,干扰了使用同一链路的其他服务。
我们如何响应?
- 自动警报检测到了故障,我们宣布了事件,并将问题追踪到共享网络链路。
- 我们将 actions 服务从该区域的部分缓存服务器上转移开,但链路仍然超出容量。
- 我们将其从其余那些缓存服务器上转移开,链路恢复了。
- 我们提高了处理限制以清理 actions 积压,并在所有受影响服务恢复后解决了事件。
我们如何使此类事件更不可能发生或影响更小?
- 我们限制了该 actions 服务打开到其缓存服务器的新连接的速度。
- 我们正在对该服务新连接的峰值进行警报,以便更早识别并解决问题源头。
10 月 21 日 14:52 UTC(持续 4 小时 30 分钟)
持续时间:约 6 小时 46 分钟。
客户可能遇到了拉取请求更新、GitHub Actions 工作流状态更新和 webhook 交付的延迟。推送后,新提交在拉取请求上出现缓慢。由推送触发的工作流启动延迟。来自 actions 工作流的状态检查可能在拉取请求上看起来卡住,这阻碍了需要这些检查通过的合并。这些功能在约 2 到 3.5 小时内恢复。
审计日志事件受影响时间最长。当客户
- 我们在审计日志延迟恢复到健康范围后解决了该事件,剩余积压随后也清除了。
我们如何降低此类事件发生的可能性或影响?
- 我们在请求失败后的重连中加入了随机延迟,这样已经变慢的服务器就不会被突发的新连接冲击。
- 我们正在更早地对服务器内存使用情况发出警报,以便在服务器变慢之前转移流量。
- 我们正在为 webhook 投递数据添加第二个可切换的目的地,以便在事件流平台变慢时保持 webhook 投递继续进行。
- 我们改进了 playbook,以便将来在类似情况下迁移热分区。
October 28 14:12 UTC(持续 1 小时 16 分钟)
持续时间:约 1 小时 32 分钟。
客户在 Copilot 中使用多个 GPT 系列模型时可能遇到了错误。在 IDE 和 github.com 上的 Copilot Chat、Copilot CLI、Copilot code review 以及 Copilot coding agent 中使用这些模型的请求返回了错误或未能完成。对受影响模型的请求中约有十分之一失败。其他模型继续工作,选择另一个模型可以避免这些错误。自动模型选择通过将部分请求发送到未受影响的模型来减少错误。
代码扫描自动修复和代码质量构建在某个特定模型上,没有可切换的替代模型,因此受到的影响更严重。
出了什么问题,原因是什么?
Copilot 通过上游模型提供商访问这些模型,并使用凭证向该提供商进行身份验证。该凭证失效了,提供商开始以未认证为由拒绝我们的请求,而我们的服务将这些拒绝作为身份验证错误返回给客户端。使用这些模型的 Copilot 功能通过该提供商发送请求,因此它们同时开始失败。
我们如何应对?
- 我们用于某个上游模型提供商的凭证停止工作,对受影响模型的请求开始失败。
- 警报标记了受影响模型上不断上升的错误,我们宣布发生事件。
- 我们发布了公开状态更新,并建议在此期间选择另一个模型。
- 我们将错误追踪到我们自己的凭证,并创建了一个替代凭证。
- 我们开始部署新凭证,第一个环境更新后请求开始恢复。
- 我们在剩余环境中完成了部署,确认对受影响模型的请求已恢复,并解决了事件。
我们如何降低此类事件发生的可能性或影响?
- 我们改进了服务处理来自上游模型提供商的身份验证失败的方式,以便请求可以重试而不是失败。
- 我们正在加强上游模型提供商凭证的管理方式。
- 我们正在添加上游模型提供商身份验证失败的警报,以便更快地识别和解决此类问题。
October 30 14:31 UTC(持续 31 分钟)
![14:10 至 14:40 UTC 失败 API 请求的折线图。在阴影影响时段内,失败率从接近零上升到约 3.5%,然后在 14:29 左右急剧回落到接近零。](https://github.blog/wp-content/uploads/2026/11/oct30-api-requests-f
文章标题:GitHub 可用性报告:2026 年 10 月
正文: 许多 github.com 服务使用的一个数据库连接池达到了其上限,在几分钟内没有可用连接。需要连接的新请求一直等待,直到连接超时过期,然后失败。
当一些更新请求开始以远超预期的时间持有其连接时,连接池已经接近容量上限运行。每个请求开始写入更改,然后运行一个可能需要几秒钟的单独查询,在此期间一直保留其连接却未使用。由于余量很小,这些被持有的连接帮助连接池越过了极限。
我们如何响应?
- 请求耗尽了共享数据库池中的每一个连接,github.com 上的请求开始失败。
- 我们在看到失败后宣布了一起事件,受影响服务的值班工程师被呼叫。
- 连接池排空,错误率恢复正常。不久之后,我们确认完整的连接池导致了这些错误,并发布了公开状态更新。
- 我们验证数据库连接已恢复正常,并在监控稳定性后解决了该事件。
我们如何让此类事件更不可能发生或影响更小?
- 我们现在在这些更新请求开始写入更改之前运行缓慢查询,因此它们不再在等待时持有数据库连接。
- 我们正在评估对池化数据库连接可被持有时间的限制,因此缓慢的请求模式不太可能占用连接池。
关注我们的状态页面,获取状态变化和事件后回顾的实时更新。要了解更多关于我们正在做的工作,请查看 GitHub Blog 上的工程部分。
标签:
- GitHub 可用性报告